
Observabilityは、ログ、メトリクス、トレースを関連付けることでシステムの内部状態を推測する能力です。なぜ何かが失敗したのかを答えるのではなく、ただそれが失敗したことを知るのではなく なぜ何かが失敗したのか、 それが失敗した.
あなたのモバイルリリースはすでに生産環境に到達しました。アラートはアップデートサービスが正常、API ダッシュボードが緑、エラーレートが正常と表示しています。すると、サポートはユーザーが一部のデバイスモデルで古いバンドルに詰まっていることを報告し、また別のグループは起動後に白画面が表示されることを報告します。症状は見ることができますが、生産したパスは見ることができません。
それが監視とObservabilityの違いです。メトリクスはダウンロードが遅れていることを示すかもしれませんが、遅延の原因がクライアント、アップデートサービス、APIのどちらであるかを明らかにすることはできません。トレースは、チェックサムミスマッチ、受け入れられないバンドル、またはJavaScript例外が原因で失敗したことを明らかにするかもしれません。ログは、チェックサムミスマッチ、受け入れられないバンドル、またはJavaScript例外が原因で失敗したことを明らかにするかもしれません。
モダンなアプリケーションでは、このコンテキストを維持するのが難しくなっています。Capacitorアプリはネイティブcode、Web層、リモートAPI、認証、分析、ライブアップデートサービス、特定のデバイスまたはOSバージョンを含む可能性があります。Electronアプリケーションでは、独自のデスクトップランタイムと環境の差異を追加します。リリースが頻繁に変更されると、事前に定義されたアラートはすべての失敗モードを予測することができません。
Observabilityはエンジニアが不明な状況を調査する方法を提供します。 これは、チームがインシデントを迅速に診断し、明確な証拠とともに変更を実装し、ユーザーが経験する技術的動作と接続するのに役立ちます。 以下の例は、定義と3つのクラシックの柱から実践的な実装、ビジネス価値、Live Updateまで、CapacitorとElectronアプリケーションに適用されます。
目次
- ソフトウェアシステムにおけるObservabilityの実際の意味
- システムを観察できる3つの柱
- Observabilityと監視の違いとどのように組み合わせるか
- Observabilityは今ビジネス能力
- 実装パターン、ベストプラクティス、トレードオフ
- Capacitor Electron と Capgo Live Update のための実践的な観測可能性
ソフトウェアシステムにおける観測可能性の本当の意味
観測可能性 observability 観測可能性の歴史 1960s2013年 観測可能性観測可能性 観測可能性 観測可能性のスタックを説明する。ログ、メトリクス、トレースの三柱モデルは標準化されました。 2018同様のリファレンスに従ってください。
A car dashboard offers a useful comparison. The speedometer tells you how fast you’re moving, the fuel gauge shows remaining fuel, and a warning light signals a known condition. That’s useful monitoring. An engine diagnostic system goes further. It combines sensor readings and error records to help explain why the engine is misfiring.
自動車のダッシュボードは便利な例です。速度計はあなたがどれくらい速く移動しているかを示し、燃料計は残りの燃料を示し、警告灯は知られている条件を示します。そうした監視は役立ちます。エンジンの診断システムはさらに進んでいます。センサーの読み取りとエラーの記録を組み合わせて、エンジンがミスファイアしている理由を説明するのに役立ちます。
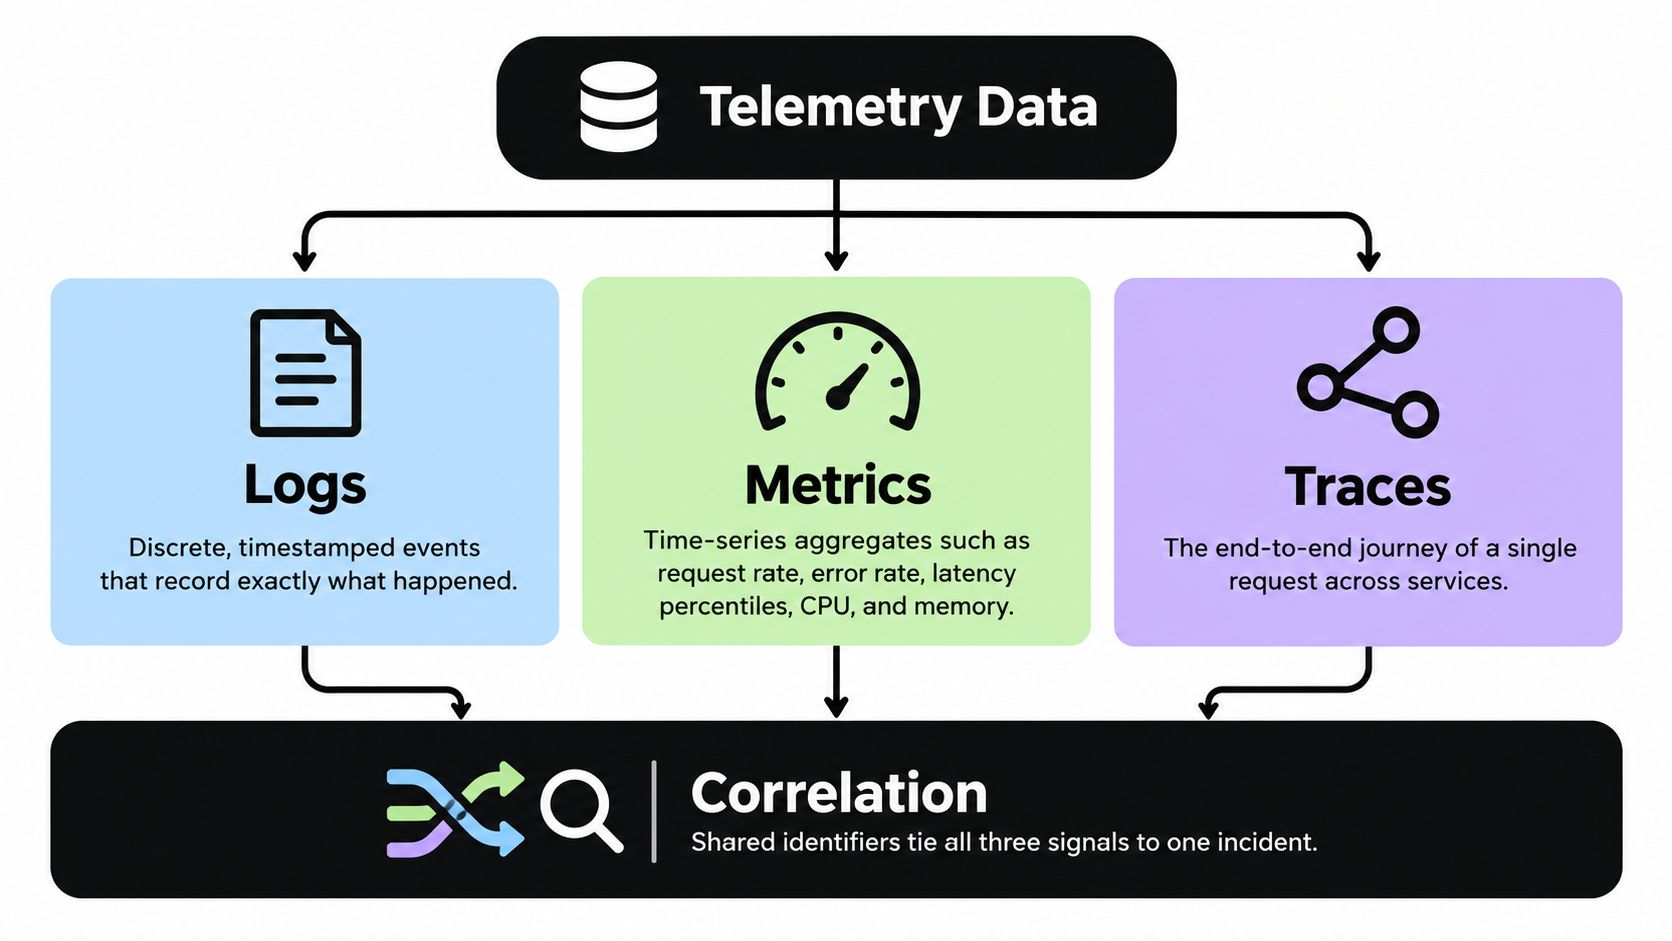
観測可能性を示す図:ログ、メトリクス、トレースを関連付けるためのテレメトリーデータの図。
You often can’t pause a production system and step through every line of code. Requests move between components, containers change, users run different versions, and failures may disappear before you reproduce them locally. External outputs become your evidence.
生産システムを一時停止して、すべての行をステップスルーすることはできません。要求はコンポーネント間で移動し、コンテナは変化し、ユーザーは異なるバージョンを実行し、ローカルで再現する前に失敗は消えます。外部出力は証拠になります。 クラウドネイティブアーキテクチャのガイドです。 ガイドは、依存関係を推論するためにチームが依存関係を決定する前に、インストルメントするものを決定するのに役立ちます。
For a Capacitor application, useful outputs might include:
- クライアントイベントアプリケーション起動、バンドルダウンロード、検証、有効化、ロールバックなど
- パフォーマンスメトリック起動遅延、リクエスト遅延、更新失敗、クラッシュカウントなど
- 分散トレースユーザー アクションとアプリを接続し、API ゲートウェイ、バックエンド サービス、データベースまで。
- 構造化ログデバイス、アプリケーションバージョン、チャネル、トランザクションID、エラー コンテキストなど
プロパティは関連性です。デバイスIDまたはトレースIDは、更新試行、ダウンロード結果、実行時エラーの関係を示します。関連性がなければ、各ダッシュボードは一部しか表示されません。
For a mobile-specific perspective, Capgo’s アプリケーション観察性ガイド アプリケーションのテレメトリがリリース診断をサポートする方法について調べます。より広い原則は単純です: 観測可能なシステムでは、既にキャプチャされた証拠を使用して、動作に関する新しい質問を立てることができます。.
観測可能なシステムの3つの柱
ログ、メトリクス、トレースは異なる形状を持ち、異なる質問に答えます。観測性は、エンジニアがそれらを同じリクエスト、リリース、ユーザージャーニー、またはデバイスに関連付けることで有用になります。
メトリクス 時系列の合計値です。例として、リクエストレート、エラーレート、レイテンシーペルセントイル、CPU、メモリなどがあります。多くのイベントを1つの値に圧縮し、グラフ化およびアラートに簡単に使用できます。メトリクスは、バンドルアクティベーション失敗がデプロイ後に増加したことを示すかもしれませんが、特定のデバイスまたは例外を特定することはできません。
トレース リクエストのエンドツーエンドパスをサービス間で再構築します。各パートはスパンで表されます。アップデートリクエストがアプリ、エッジサービス、認証レイヤー、ストレージサービス、APIを通過した場合、トレースは時間が蓄積された場所やリクエストが失敗した場所を示します。
ログ イベントレベル詳細を提供します。スタックトレース、トランザクションID、レスポンスcode、バンドルバージョン、または検証結果など、ログはメトリクスがまとめたローカル状況を説明し、トレースが特定するものを説明します。
実用的なルール: メトリクスは問題の存在を示します、トレースは発生する場所を示し、ログは発生した理由を説明します。
ライブアップデートの失敗を考えてみましょう。メトリクスはアップデートの検証エラーが増加したことを報告します。トレースは1つの失敗したリクエストを追跡し、バンドルがデバイスに到達したが、検証のスパンが失敗したことを示します。対象のログはチェックサムの結果を記録し、バンドルバージョンを特定します。共に、それらの信号は、監視が隔離できない実行コンテキストを復元します。
関連性は機能するメカニズムです。
関連性には共有された識別子と一貫した属性が必要です。トレースIDはサービス境界を超えて移動する必要があります。ログにはそのIDを含める必要があります。メトリクスは、エンジニアが影響を受けたリリース、チャネル、デバイスファミリー、またはアプリケーション バージョンを特定するのに役立つディメンションをサポートする必要がありますが、ユニークなタイムシリーズの数が管理不能になることを防ぐ必要があります。
クライアント側でも同じアプローチが機能します。ユーザーが特定の機能をタップし、タイムアウトが発生した場合、クライアントはアクションとアプリケーション バージョンを記録し、トレースはネットワークリクエストを追跡し、バックエンドのログはリクエストが認証またはデータ取得で失敗したかどうかを示します。エンジニアは単一のエラーメッセージから全体のストーリーを推測する必要がありません。
大規模なログボリュームを扱っているチームは、構造化されたフィールドとクエリツールを使用するのではなく、フリーテキスト検索に頼るのではなく、Capgoの ログ分析ツールは 調査中にログをより有用にするために必要な背景を提供します。
3つの柱は競合する製品ではありません。 それらは因果関係の連鎖を形成します。 メトリクスは広範な信号を提供し、トレースは検索範囲を絞り込み、ログは詳細な証拠を提供して修正が必要な場合に必要です。
監視と観察性の違いとその関係
監視と観察性は互いに補完的なものですが、同義語ではありません。 監視は既に重要と判断した条件を監視します。 観察性は予想外の行動を調査するために十分な接続されたデータを提供します。
監視ルールは API ラテンシーの閾値を超えたときや、更新失敗が予想されるレベルを超えたときに警告するかもしれません。 その警告は、対応を開始するための貴重なものですが、原因がバックエンドのリグレッション、悪いバンドル、地域配信の問題、またはデバイス固有のランタイムの問題であるかどうかを明確にしません。
| 機能 | 監視 | 観察性 |
|---|---|---|
| 目的 | 既知の健康指標を監視する | システムの動作と不明なエラーを調査する |
| 質問の種類 | 「この閾値が超えられているか?」 | “なぜこの動作が起きているの?” |
| データアプローチ | 事前定義されたダッシュボードとアラート | 関連付けられたログ、メトリクス、トレース、コンテキスト |
| 障害モード | 設定されていない条件をミスする | 有用なインストルメンテーションがなければ、費用が高くなるか、ノイズが増える |
インシデントループで両方を使用する
正常な運用パターンは、次のようになっている:
- モニタリングは信号を検出する。 アラートは、異常な遅延、エラー率、クラッシュ活動、または更新失敗を特定する。
- オブザーバビリティはインシデントを枠組みにする。 エンジニアはリリース、チャネル、デバイス、プラットフォーム、地域、またはユーザージャーニーでフィルタリングします。
- トレースは故障を特定します。 リクエストパスは、動作が変化したコンポーネントまたはスパンを明らかにします。
- ログは状況を説明します。 詳細なレコードは、例外、検証結果、依存関係の応答、または構成に関与したものを示します。
- チームは結果を確認します。 メトリクスは、修正が正常な動作を復元したかどうかを確認します。
監視のみが安定した、予測可能な条件で機能することができます。システムが頻繁に変更される、障害がサービス境界を越える、またはユーザーが多数のバージョンとデバイスの組み合わせを実行する場合など、オブザビリティは重要になります。
モバイルチームはクラッシュフリーのセッションとアップデートの採用を監視します。アラートが発生すると、オブザビリティはチームに問題が特定のチャネル、特定のアプリケーション バージョン、またはデバイス クラスに影響を与えるかどうかを尋ねることを許可します。その調査は、すべてのリリースを停止するのではなく、対象化された修正措置を講じることの差です。
Capgo’s アプリケーションヘルスモニタリングアプローチ は、この区別に関連しているのは、健康信号がリリースとデバイスのコンテキストに接続できるようになると、より有用になることです。ツールは一般的なインフラモニタリングを置き換えません。アプリケーションライフサイクルにおける運用的証拠を追加します。
モニタリングの観察性は今、ビジネス能力として必要です。
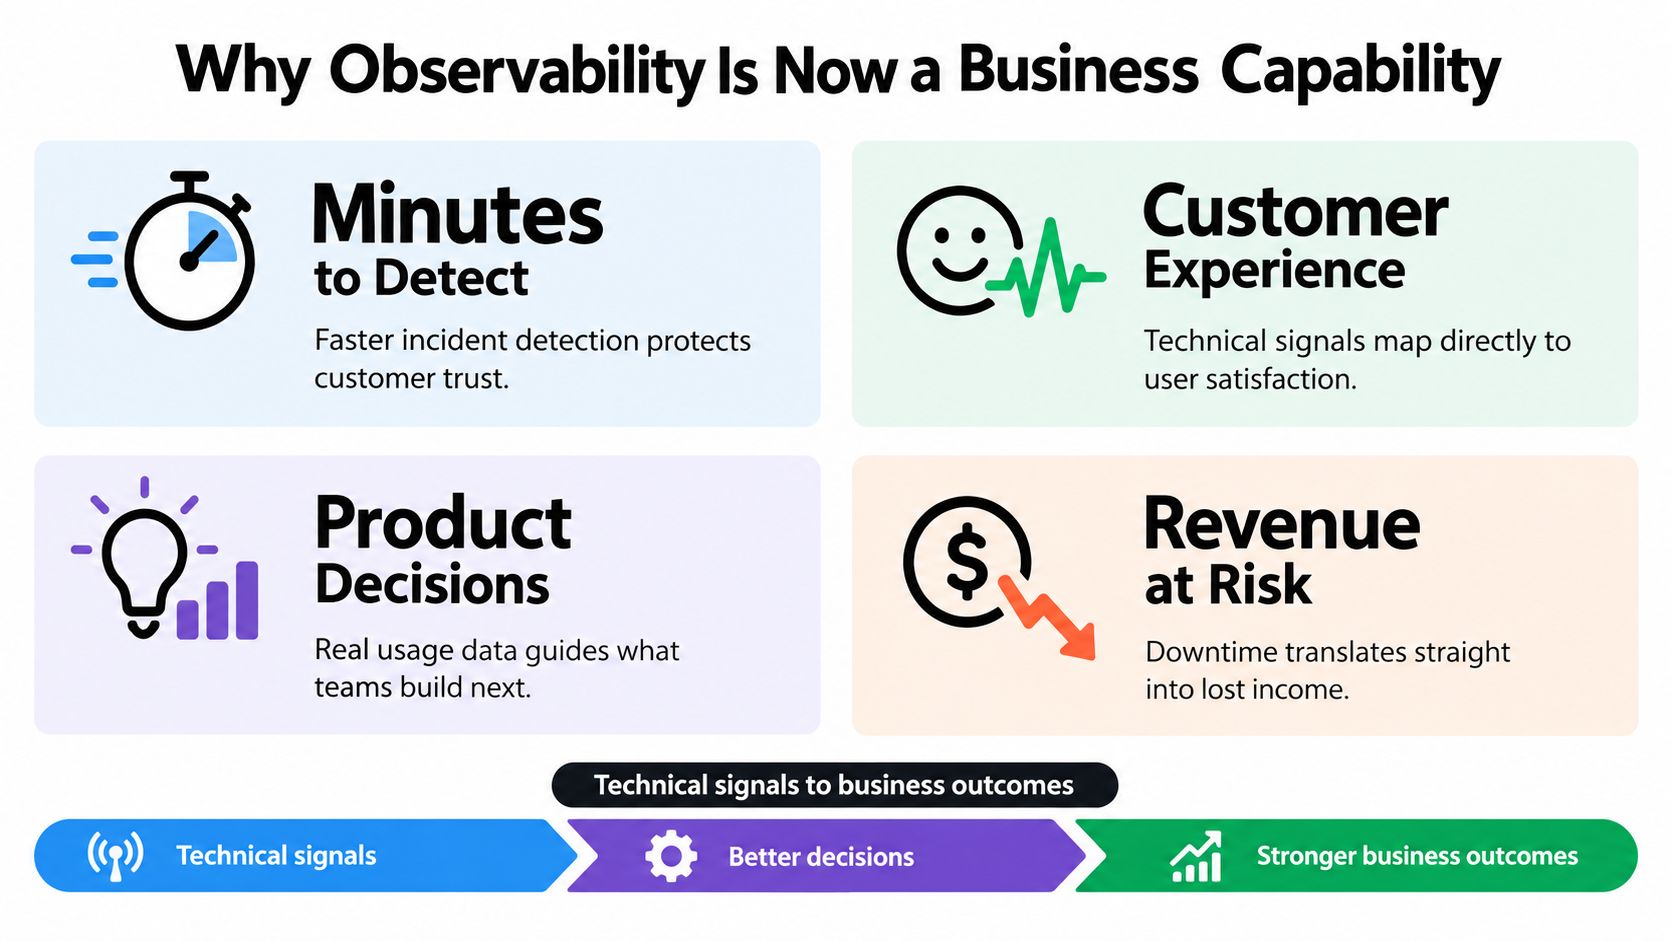
エンジニアリングダッシュボードは、信号が顧客体験と製品結果に接続することでビジネストールになる。エラー率が上昇すると、購入を完了できない、サインインできない、メッセージを送ることができない、または新しい機能を使用できないようになる可能性があるため、重要です。
その接続には、意図的な設計が必要です。チームは、プライバシーを尊重し、不要な個人データを避けながら、技術イベントを意味のあるビジネスコンテキストと関連付ける必要があります。リリースヘルスビューは、採用状態、失敗した要求、ユーザージャーニーの完了、サポートレポートを組み合わせることができます。製品マネージャーは、機能が意図された対象者に機能するかどうかを確認できますが、単にサービスが応答するかどうかだけを確認するのではなく。
インシデント対応以外の証拠
Splunkは 2025 が報告した 74% の調査で、 65% の回答者が監視する重要なビジネスプロセスに対して を重要視していると報告しました。また、の
State of Observability 2025レポートで説明されているように、ユーザージャーニーを理解する上で重要な役割を果たしているとも報告しました。 68% 組織が観測性を採用した後で、検出までの平均時間が改善されたことを測定した 2025 この New Relicの発表で入手可能
異なるグループは同じ証拠を異なる方法で使用します。
- 同じ証拠を使用するグループは異なる方法で使用します: サポートチーム
- は、不満が特定のデバイス、バージョン、またはロールアウトチャネルに限定されているかどうかを判断できます。 製品チーム
- は、機能の動作をリリースコホート間で比較し、実際の使用状況の信号に基づいて作業を優先できます。 エンジニアリングチーム
- は、顧客向け症状を特定のサービス、リクエスト、またはクライアントイベントに結び付けることができます。 運用上のリスクを評価するには、重要なジャーニーを考慮するのではなく、抽象的なインフラのステータスを考慮するのではなく、評価する必要があります。
A live-updateのロールアウトは、連鎖を示しています。採用が増加した場合でも、ユーザーの一部がアクティベーションに失敗した場合、更新エンドポイントが利用可能であるかどうかという質問ではなく、影響を受けたユーザーがタスクを完了できるかどうかという質問です。オブザーバビリティは、その質問に必要な証拠を提供し、ロールアウトを続行するか、停止するか、ロールバックするかを決定するのに役立ちます。
実装パターン、ベストプラクティス、トレードオフ
良いオブザーバビリティは、ダッシュボードではなく、質問から始まる。インストルメンテーションを追加する前に、データが支持する必要がある決定を書き留めることから始めましょう。モバイルのリリースの場合、その質問は次のようになります。デバイスがバンドルをダウンロードしたか、検証が成功したか、アクティベーションが完了したか、更新されたアプリが正しく動作したかどうか?
実際にユーザーが取るパスをインストルメントする
開始するのは境界と結果です:
- クライアントライフサイクル: 起動、更新チェック、ダウンロード、検証、アクティベーション、ロールバックイベントを記録する。
- サービス境界: アプリ、ゲートウェイ、バックエンド、依存サービスを通じてトレースIDを伝播する。
- エラーのコンテキスト: アプリバージョン、バンドルバージョン、チャネル、OSバージョン、デバイスクラス、エラーカテゴリを適切な場合に含める。
- ビジネスアクション: 技術要件を安全で意味のあるイベントに接続する。サインインの完了やチェックアウトの失敗など。
構造化ログを使用する。人間が読むために書かれた段落ではなく。フィルタリングが可能なように、定数のフィールドを使用する。機密情報をテレメトリから除外し、収集が拡大する前に、保持期間の規則を定義する。
トレースの完全性は、有効な基準である。分布トレースデータから、エンドツーエンドで再構築できる全リクエストの割合を表す。観測可能性評価の研究では、欠陥検出の遅延、リソースオーバーヘッド、偽陽性率、偽陰性率、コストなども重要な指標として挙げられている。この 観測可能性評価調査.
診断の深さとオーバーヘッドをバランスさせる
より多くのテレメトリは、自動的に良くない。収集は、特にモバイルデバイスや高ボリュームサービスで、CPU、メモリ、帯域幅、ストレージを消費する。サンプリングは、ボリュームを制御するのに役立つが、意図的にサンプリングする。エラー、異常な遅延、ロールアウトコホート、重要なワークフローなど、詳細なトレースを保持し、低コストの広範なメトリクスを保持することで、傾向の可視性を確保する。
有効な信号は、次の正しい決定を下すために、レスポンダーに必要な最小の証拠である。
インシデントの後、データを確認する。誰もフィールドを参照しなかった場合、フィールドを削除するか、その目的を変更する。エンジニアが問題を手動で再現する必要がある場合、ログのレベルを上げるのではなく、欠落しているコンテキストを追加する。
Capacitor チームにとって、フォーカスされた パフォーマンスモニタリング設定ガイド はクライアントサイドのインストルメンテーションにこれらの原則を翻訳することができます。 一つの重要なユーザージャーニーから始め、正常な動作を確立し、チームが繰り返し出現する質問を学ぶにつれてカバレージを拡大してください。
のアクションでCapacitor ElectronとCapgo Live Updates
A Capacitor or Electron team may need to correct JavaScript, CSS, copy, configuration, or web assets while users continue running installed applications. A live-update lifecycle creates its own observable path: a device checks for an update, receives a bundle from a channel, verifies it, activates it, and reports the result.
チームはJavaScriptの修正を準備します。 そのチームは、ステージングまたはベータチャンネルにバンドルを公開し、制御されたアウディエンスに割り当てます。 アドプションメトリックは、デバイスがリリースを受信しているかどうかを示します。 失敗メトリックは、ダウンロード、検証、または有効化が失敗しているかどうかを示します。 バージョンヒストリは、各デバイスが実行すべきバンドルのバージョンを示します。
チームはデバイス固有の問題を発見します。 デバイス固有のログは、影響を受けるインストールがバンドルをダウンロードしたが検証に失敗したことを示します。 エンジニアは、成功したインストールと比較して、デバイスの現在のバージョン、チャンネル、更新履歴を調べることができます。 これは、問題を一般的なダウンタイムとして扱うのではなく、デバイス固有の問題として扱うことを意味します。
ロールアウトにはガードレールが必要です
安全なロールアウトでは、同じ「知らせる」、「位置する」、「説明する」パターンを使用します。
- メトリックは アドプションと失敗の動作が変化したかどうかを知らせます。
- デバイス固有のレコードは 影響を受けたコホートまたはインストールを位置します。
- ログは ダウンロード、チェックサム、有効化、実行時イベントの失敗。
- チャンネル制御の限界。 チームが調査中の間に、影響範囲を最小限に抑える。
- 新しいリリースが安全でない場合、前の正常なバンドルを復元する保護機能。 新しいリリースが安全でない場合の前のワークングバンドル。
チームは、更新イベントとともに製品イベントをトラッキングすることもできます。__CAPGO_KEEP_0__のカスタムイベントトラッキングプラグインは、リリースのテレメトリが、展開状態とアプリケーション動作を関連付けるより広い原則をサポートしています。プラットフォームは、JavaScriptの更新に対して、デバイスごとのログ、採用率と失敗率のメトリクス、バージョン履歴、ターゲットチャンネル、自動ロールバック保護を提供します。
チームはまた、更新イベントとともに製品イベントを計測することもできます。Capgoの __CAPGO_KEEP_0__はCapacitorJSとElectronアプリケーションに対してライブアップデートを提供し、ターゲットチャンネル、デバイスごとのリリースの可視性、採用率と失敗率のメトリクス、バージョン履歴、ロールバック保護を提供します。そのリリースの観察性を使用して、変更されたものとユーザーが経験したものを関連付けます。その後は __CAPGO_KEEP_0__
を訪問してください。
Capgo Capgo アップデートワークフローで評価するには。





