

Deine TypeScript API sah am Release-Tag wahrscheinlich solide aus. Die Routes kompilierten, das Frontend importierte Shared Types und der Editor gab das gute Gefühl, dass alles „safe to ship“ ist.
Dann hat das Backend ein Response-Feld geändert, ein Nullable tauchte auf, wo niemand damit gerechnet hat, oder ein Mobile-Client verwendete weiterhin eine ältere Payload-Struktur. Genau dort bricht der größte Teil des API in TypeScript work breaks. Not in syntax. In drift.
Inhaltsverzeichnis
- Warum typisierte APIs nach dem Launch scheitern und wie man das verhindert
- So setzt du dein TypeScript API-Projekt richtig auf
- DTOs designen und Input an der Boundary validieren
- Generieren und Nutzen eines voll typisierten API Clients
- Error Handling, Testing und Observability, die wirklich helfen
- Mit Vertrauen und Kontrolle in die Production
Warum typisierte APIs nach dem Launch scheitern und wie man das verhindert
Ein typisierter API bricht meist bei einem normalen Release. Ein Team benennt ein Response-Feld um. Ein anderes fügt einen Nullable-Zweig für eine Teilmigration hinzu. Ein älterer Client sendet weiterhin das alte Payload, da Mobile-Updates dem Web hinterherhinken. TypeScript kompiliert in jedem Repo weiterhin fehlerfrei, das die lokalen Typen aktualisiert hat. Der Contract in der Production ist jedoch bereits falsch.
Dieser Fehler hat einen Namen: Contract Drift.
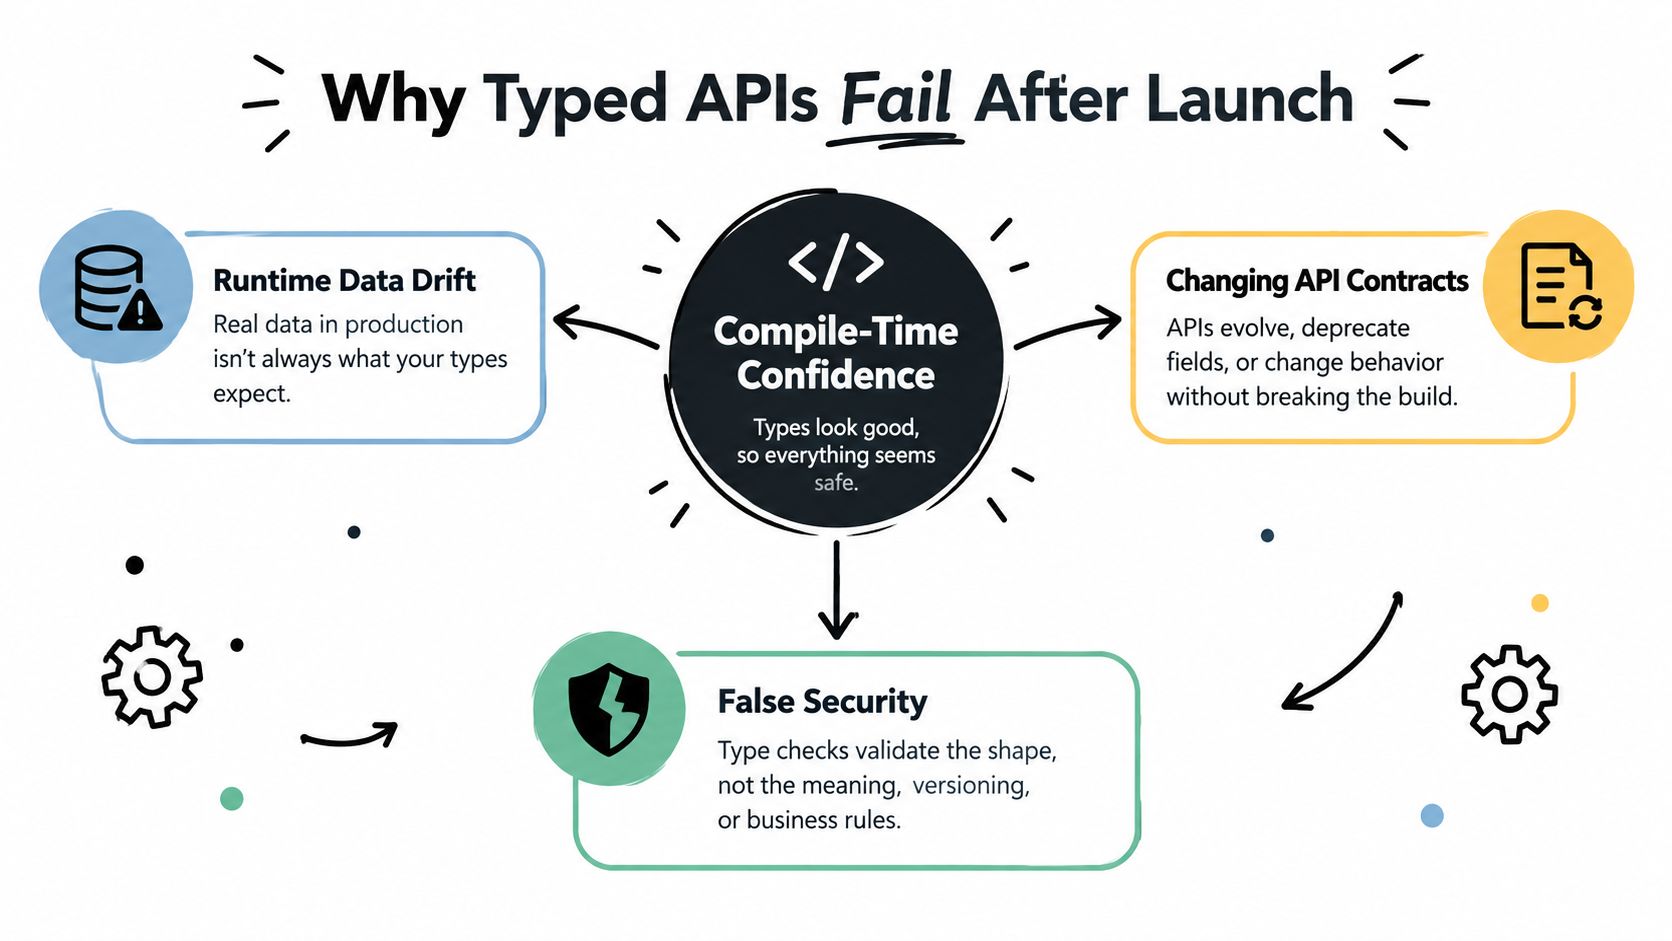
TypeScript hat die Arbeit mit API angenehmer gemacht, aber auch dazu geführt, dass man schwachen Contracts zu leicht vertraut. Shared Interfaces, Route Generics und ein typisierter fetch Wrapper helfen während der Entwicklung. Sie beweisen jedoch nicht, dass das JSON, das über das Netzwerk fließt, nach dem zweiten oder zehnten Release immer noch diesen Typen entspricht.
Die Regel, die in der Production standhält, ist simpel.
Wenn unvalidiertes JSON direkt in die Anwendungslogik fließt, beschreiben deine TypeScript-Typen die Absicht, nicht die Realität.
Die Lösung liegt weniger in cleverer Type-Gymnastik als vielmehr in der Frage, wo die Wahrheit liegt:
- An der Boundary validieren. Parse Request-Bodies, Params, Header und sogar Responses von Downstream-Services, bevor der Rest von code sie berührt.
- Mappe DTOs auf Domain-Models. Halte Transport-Strukturen von Business-Objekten getrennt, damit sich API-Änderungen nicht über die ganze Codebase ausbreiten.
- Generiere Typen aus einem Contract. OpenAPI, JSON Schema oder ein Schema-first-Framework geben Clients und Servern eine gemeinsame Source of Truth.
- Behandle Breaking Changes als öffentliche Ereignisse. Ändert sich die Struktur eines Feldes, versioniere es gezielt und kommuniziere es wie jede andere Änderung an einem externen Contract.
DTO-Mapping ist der Schritt, den Teams am häufigsten überspringen. Anfangs fühlt er sich redundant an. Nach ein paar Releases wird er zur Schicht, die dich davor bewahrt, string | null Legacy-Field-Aliases durch jeden Service und jeden Frontend-Screen zu schleppen. Ein kleiner Translation-Schritt an der Boundary ist günstiger als ein großer Refactor später.
Typisierte APIs scheitern oft, weil Error-Contracts meist nur ein Nebengedanke sind. Success-Payloads erhalten Aufmerksamkeit. Failure-Payloads werden zu dem, was eine Exception gerade so serialisiert hat. Clients bauen dann Retry-Logik, User-Messaging und Monitoring auf Strukturen auf, die nie so geplant waren. Das Ergebnis ist dasselbe Problem in einer anderen Form: Drift.
Versioning verdient dieselbe Disziplin. Teams zerstören Clients selten durch ein einzelnes, dramatisches Rewrite. Sie zerstören sie durch eine Serie von vernünftigen lokalen Änderungen, die in der Summe zu Inkompatibilität führen. Eine klare API Versionierungsstrategie für sich entwickelnde Contracts macht diese Änderungen sichtbar, bevor sie die Consumer erreichen.
Das Ziel ist nicht, TypeScript überall einzusetzen. Das Ziel ist es, den Contract nach dem Launch konsistent zu halten, wenn mehrere Deploys, verschiedene Clients und echte Produktionsdaten gegen die sauberen Types vom ersten Tag drücken.
So setzt du dein TypeScript API-Projekt richtig auf
Ein typisierter API sieht am ersten Tag meist sauber aus. Sechs Monate später akzeptiert eine Route ungeprüften Input, eine andere liest Raw-Daten process.envund eine dritte gibt eine Struktur zurück, auf die kein Client programmiert wurde. Das Gerüst bricht selten auf einmal. Es lässt genug Spielraum, damit Contract Drift schleichend in das normale Feature-Work einfließt.
Beginne mit einer Projektstruktur, die es schwer macht, den Contract zu umgehen.
Wähle das Framework, das zu deinem Team passt
Für ein API in TypeScript geht es bei der ersten Framework-Entscheidung weniger um die Syntax als vielmehr darum, wo die Disziplin bei den Contracts verankert wird.
- Express passt zu Teams, die minimale Abstraktion bevorzugen und das Middleware-Modell bereits kennen. Es hält sich im Hintergrund, was nützlich ist, bis jede Route ihre eigene Validierung, Error-Struktur und Response-Konventionen erfindet.
- Fastify ist eine starke Standardwahl für kleine bis mittelgroße Backend-Teams. Das Plugin-System ist sauber und schiebt die Schema-Arbeit näher an die Route-Ebene, was hilft, das Runtime-Verhalten mit den Types in Einklang zu halten.
- Nest eignet sich gut für größere Codebases mit vielen Contributoren, Shared Modules und expliziten Ownership-Grenzen. Der Preis dafür ist Ceremony – und dieser Preis ist real, wenn der Service selbst klein ist.
Ich vermeide es meist, mehr Framework zu kaufen, als das Team tatsächlich nutzt. Ein kleiner Service mit Fastify, einer Validierungs-Library und generierten Contract-Types übersteht Refactors oft besser als ein schwerer Stack mit inkonsistenten Konventionen.
Nutze ein Folder-Layout, das Boundaries schützt
Ordnernamen sind weniger wichtig als der Import-Druck. Wenn Routes direkt auf Database-Models zugreifen können oder Services ORM-Entities direkt an Clients zurückgeben, lädt das Gerüst bereits zu Drift ein.
Ein Layout, das in der Produktion standhält, trennt Transport-Belange meist von Application-Belangen:
src/routesnur für das HTTP-Wiringsrc/schemasfür Request- und Response-Schemassrc/dtofür Transport-Typen und das Mapping von codesrc/servicesfür Use Cases und Orchestrierungsrc/domainfür Business-Modelle, die über einzelne Endpoints hinausgehensrc/clientsfür Downstream-Integrationensrc/errorsfür gemeinsame Error-Typen und Narrowing-Helpersrc/configfür das Parsen der Konfiguration beim Startup
Dass src/dto diese Schicht keine Fleißarbeit ist. Sie bietet API einen Ort, um externe Änderungen abzufangen, ohne sie in die Domain-Logik oder über andere Endpoints nach außen zu tragen.
Die Konfiguration verdient die gleiche Behandlung. Parse Umgebungsvariablen einmal beim Startup, fehle sofort bei ungültigen Werten und exportiere ein typisiertes Config-Objekt an den Rest der App. Teams, die weiterhin process.env innerhalb von Handlern lesen, enden meist bei verzweigten Runtime-Verhalten, bei dem TypeScript nicht helfen kann. Dieser Guide über Umgebungskonfiguration ist eine gute Referenz, wenn du dieses Pattern standardisieren willst.
Den Compiler strenger machen, bevor neue Features kommen
Ein API in der Produktion sollte es nervig machen, unsichere code zu schreiben.
Nützliche Defaults sind:
strictaktiviertuseUnknownInCatchVariablesaktiviertnoUncheckedIndexedAccessaktiviert, wenn das Team die nötige Disziplin mitbringt- Keine Path-Aliases, außer Node, Tests, Bundling und Tooling lösen sie identisch auf
- Getrennt
build,typecheck, und Lint-Scripts in der CI
Ein schwaches tsconfig lässt Drift unbemerkt entstehen. Ein striktes sorgt dafür, dass Mismatches sichtbar werden, bevor sie zum Production-Verhalten werden.
Auch Lint-Rules helfen, besonders solche gegen any, floating promises und versehentliche Exports aus öffentlichen Contract-Modulen. Nichts davon ersetzt die Runtime-Validierung, aber es reduziert die Stellen, an denen sich Contract-Fehler verstecken können.
Eine weitere Entscheidung beim Scaffolding ist früh wichtig. Lege fest, woher deine OpenAPI-Spec kommt, und halte diese Entscheidung nah an der Route-Layer. Manche Teams generieren sie aus code-first Schemas. Andere generieren zuerst Server-Stubs und Types aus der Spec. Beides funktioniert. Was scheitert, ist die Spec als bloßes Nebenprodukt zu behandeln, das nach dem ersten Release niemand mehr prüft.
Nach dem initialen Scaffold hilft es zu vergleichen, wie sich typisierte Contracts außerhalb von einfachen Request-Response-Services verhalten. Der Streamkap Flink TypeScript Guide ist nützlich für Teams, die mit Streams oder event-lastigen Systemen arbeiten, wo Contract Drift in längeren Pipelines auftritt, nicht nur in HTTP-Handlern.
DTOs designen und Input an der Boundary validieren
Ein typisierter API sieht am ersten Tag meist korrekt aus. Sechs Monate später tauchen die Bugs an den Schnittstellen auf. Ein Mobile-Client sendet immer noch ein altes Feld. Ein Partner lässt eine Property weg, von der dein Frontend annahm, sie sei immer vorhanden. Ein Refactor legt eine interne ORM-Spalte in einer öffentlichen Response offen. TypeScript hat seinen Job im Codebase erledigt. Der Contract ist trotzdem abgewichen.
Deshalb ist DTO-Design wichtig. Es geht nicht darum, Request-Bodies ordentlich aussehen zu lassen. Es geht darum, öffentliche Types auch nach dem ersten Release konsistent zu halten.
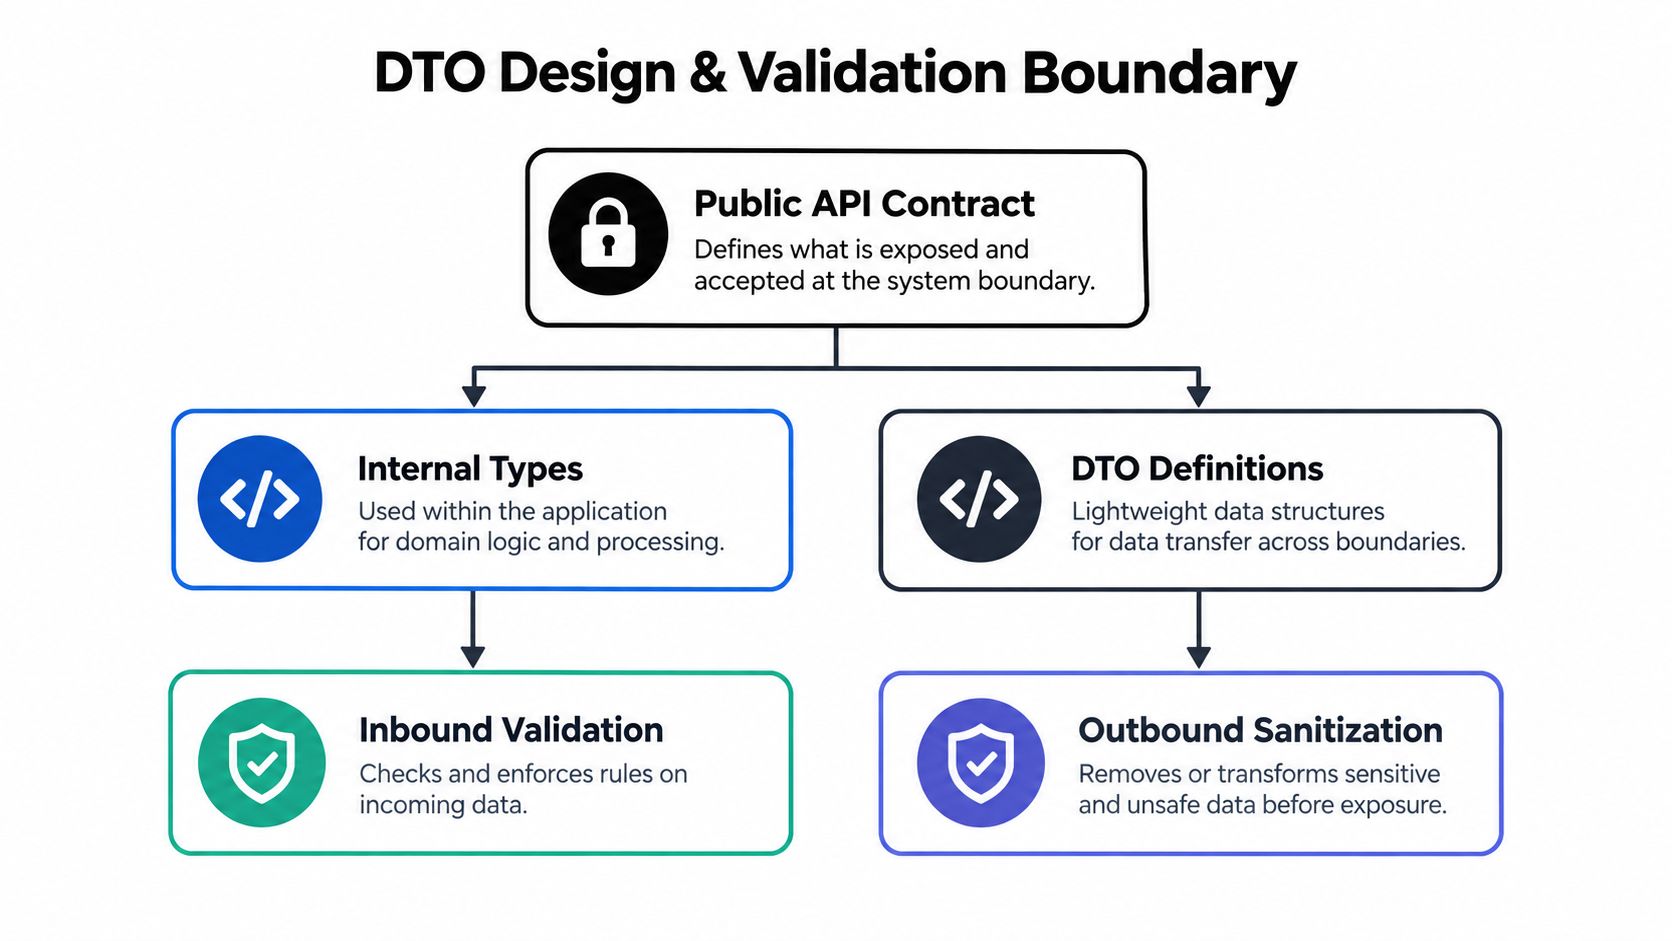
Public Contracts und interne Models sollten nicht identisch sein
Ein DTO beschreibt, was über die Leitung geht. Ein Domänenmodell beschreibt, was die Anwendung für die eigentliche Logik benötigt. Diese Anliegen zu vermischen, spart zwar anfangs ein paar Zeilen, führt aber später zu teuren Kopplungen.
Wenn deine Route dies erhält:
type CreateOrderRequestDto = {
  customerId: string
  items: Array<{ sku: string; quantity: number }>
  note?: string | null
}
deine Service-Schicht sollte weiterhin etwas Engeres und Saubereres akzeptieren, wie zum Beispiel ein OrderDraft mit normalisierten Strings, validierten Mengen und Defaults, die an einer Stelle angewendet werden.
Die Boundary braucht normalerweise diese Schritte:
- Das eingehende Payload parsen
- Struktur und Feld-Constraints validieren
- Das DTO auf ein Domain-Objekt mappen
- Business-Logik auf dem Domain-Objekt ausführen
- Das Ergebnis auf ein Response-DTO mappen
- Die ausgehende Response vor dem Senden validieren
Schritt sechs wird oft übersprungen. Dabei ist es genau der Schritt, der private Felder, Nullable-Werte, die in eine stabile Response geleakt sind, und versehentliche Schema-Änderungen bei Refactors abfängt.
Validieren, bevor die Business Logic die Daten berührt
Compile-time-Typen validieren kein JSON aus dem Netzwerk. Sie schützen dich auch nicht davor, dass ein anderer Service eine Struktur zurückgibt, die immer noch erfüllt unknown und deine Annahmen zur Laufzeit widerlegt.
Für API in TypeScript ist Zod eine gängige Wahl, da es zur Laufzeit parst und die Typen für den Rest des code ableitet. Valibot, io-ts und ähnliche Libraries funktionieren ebenfalls. Die Library ist weniger wichtig als die Regel: Nicht vertrauenswürdige Daten werden geparst, bevor irgendetwas anderes sie verwendet.
Ein Pattern, das auch Refactors übersteht, sieht so aus:
- Inbound-Schemas lehnen fehlerhafte Request-Daten ab
- Dependency-Schemas validieren Responses von Drittanbieter-APIs und internen Services
- Outbound-Schemas verifizieren die Response, die dein API gerade veröffentlichen will
Genau in dieser Zwischenschicht scheitern viele typisierte APIs nach dem Launch. Teams validieren Requests, lassen die Validierung von Downstream-Responses aber weg – und wundern sich dann, warum eine Umbenennung eines Vendor-Felds zum Production-Incident wird.
Hier ist die praktische Regel, die ich nutze: Raw JSON stoppt auf der Route-Ebene.
Mapping von code ist keine Verschwendung. Hier wird Drift sichtbar
Teams wehren sich oft gegen DTO-Mapping, weil es sich repetitiv anfühlt. Ich habe in der Produktion das Gegenteil erlebt. Eine dünne Mapping-Schicht sorgt dafür, dass Contract-Änderungen offensichtlich, reviewbar und lokal begrenzt sind.
Zum Beispiel:
- Transport ermöglicht
note?: string | null - Domain-Modell kann speichern
note: stringmit""als Standard - Response-DTO kann weglassen
notekomplett, wenn es leer ist
Das sind drei verschiedene Wahrheiten für drei verschiedene Zielgruppen. Sie als eine gemeinsame Schnittstelle zu behandeln, verschleiert die Unterschiede, bis ein Client abstürzt.
Ein Webhook macht das sogar noch deutlicher, da Konsumenten dein Payload-Format über Jahre hinweg beibehalten können. Wenn dein Team gerade an diesem Problem arbeitet, ist dies Beispiel für das Design von Webhook-Payloads eine hilfreiche Unterstützung.
Shared Types helfen nur bei einer expliziten Source of Truth
Backend-Interfaces in das Frontend zu kopieren, führt zeitverzögert zu Drift. Shared Packages können helfen, aber nur bei Typen, die bewusst öffentlich sind.
Ein Setup, das in größeren Codebases besser funktioniert, sieht so aus:
- öffentliche Request- und Response-Schemas getrennt von Persistence-Modellen definieren
- OpenAPI aus diesen öffentlichen Schemas generieren, oder zuerst Server-Typen aus OpenAPI generieren
- generierte Contract-Typen nah an Handlern und Clients halten
- Domain-Typen und ORM-Modelle intern halten
- DTOs bewusst versionieren, wenn Kompatibilität entscheidend ist
Diese Trennung steht auch im Einklang mit den TypeScript-Designrichtlinien des Azure SDK Teams, die stabile öffentliche Schnittstellen und die Trennung von internen Implementierungsdetails vom Contract betonen.
Eine wartbare Boundary ist absichtlich langweilig
Die gute Version ist weniger „clever“.
Zuvor vertraut das Frontend fetch().json() den Backend-ORM-Objekten blind als Wahrheit, während ein gemeinsames Interface alle Layer repräsentiert. Danach parst jede Grenze die Daten: DTOs bleiben schlank, Domain-Models bleiben intern, generierte Typen decken den öffentlichen Contract ab und das Mapping via code macht Änderungen explizit.
Das bedeutet mehr Aufwand. Aber es bietet dir einen zentralen Ort, um Abweichungen zu prüfen, bevor sie die Clients betreffen.
Generieren und Nutzen eines voll typisierten API Clients
Ein typisierter Client wirkt am Release-Tag oft perfekt. Drei Monate später liefert ein Endpoint plötzlich ein nullable Feld, ein anderer führt Cursor-Pagination ein und eine Mobile App nutzt eine ältere Version des Contracts. Die TypeScript-Typen kompilieren weiterhin. Die Clients brechen trotzdem.
Das ist die Aufgabe der Client-Layer. Sie muss den veröffentlichten Contract nach dem ersten Release konsistent halten, statt nur das Autocomplete im Editor hübsch aussehen zu lassen.
Strategie für den typed Client wählen
Die Client-Struktur sollte der tatsächlichen Komplexität von API entsprechen und nicht der Präferenz des Teams.
| Ansatz | Ideal für | Trade-off |
|---|---|---|
| Selbstgebauter Fetch-Wrapper | Kleine Apps, ungewöhnliche Auth-Flows, schnelle Iteration | Schneller Start. Fragmentiert mit der Zeit leicht über die Call-Sites hinweg |
| OpenAPI-code-Generierung | Geradlinige REST-APIs mit stabilen Schemas | Starke Basis. Braucht Unterstützung bei Custom Auth, Streaming oder ungewöhnlicher Pagination |
| typed Client im SDK-Stil | Multi-Team-Plattformen, öffentliche APIs, langfristige Integrationen | Höchster Wartungsaufwand. Beste User Experience, wenn die API ein Produkt ist |
Selbstgeschriebene Clients reichen für kleine Oberflächen aus
Ein eigener fetch Wrapper ist eine sinnvolle Wahl, wenn die API intern ist, die Fläche klein bleibt oder das Transportverhalten wichtiger als die Schema-Generierung ist. Ich nutze diesen Ansatz noch immer für Admin-Tools und Services in der Frühphase.
Das Fehlerbild ist Drift. Ein Team fügt eine Retry-Regel im Wrapper hinzu. Ein anderes umgeht sie. Ein drittes kopiert einen Response-Typ ins Frontend und erweitert ihn zu any nach dem ersten Mismatch. Am Ende hast du „typisierte“ Aufrufe, die nicht mehr widerspiegeln, was der Server zurückgibt.
Nutze einen selbst geschriebenen Client, wenn folgende Bedingungen zutreffen:
- die API ist klein und intern
- der Contract ändert sich so oft, dass das Regenerieren von code nur noch störend ist
- Custom-Transport-Verhalten den Großteil der Arbeit ausmacht
- du bist bereit, das Runtime-Parsing im Client beizubehalten und nicht nur auf TypeScript-Annotationen zu setzen
Der letzte Punkt ist entscheidend. response.json() gibt zur Laufzeit unknown-Daten zurück, auch wenn die Funktionssignatur etwas anderes sagt.
OpenAPI-Generierung ist der praktische Standard
Für stabile REST-APIs liefern generierte Types das beste Verhältnis von Wartbarkeit zu Sicherheit. Sie sparen viel doppeltes Type-Schreiben und machen Contract-Änderungen in Pull Requests sichtbar.
Das Pattern, das Refactorings übersteht, ist simpel: Generiere aus dem öffentlichen Contract, halte den generierten Layer dünn und füge einen kleinen Wrapper hinzu, wo deine Consumer bessere Ergonomie brauchen. Der OpenAPI-TypeScript-Generierungsworkflow passt gut zu diesem Modell.
Eine sinnvolle Aufteilung sieht so aus:
- der generierte code verantwortet Request- und Response-Shapes
- ein dünner SDK-Wrapper übernimmt Auth-Injection, Retries und Pagination-Helper
- Runtime-Validierung passiert weiterhin an der Server-Grenze und überall dort, wo nicht vertrauenswürdige Eingaben wieder ins System gelangen
- DTO-Mapping bleibt explizit, damit interne Modelländerungen nicht in den Client-Contract durchsickern
Dieser hybride Ansatz hält den generierten code langweilig, was gut ist. Langweiliger code lässt sich leichter regenerieren, reviewen und ersetzen.
Generierte Clients wrappen, bevor code der Anwendung sie berührt
Generierte Funktionen sind für den breiten Einsatz in einer Codebase meist zu roh. Sie legen Transport-Details offen, die jeder Aufrufer dann neu lernen muss.
Ein dünner Wrapper gibt dir eine zentrale Stelle, um Policies konsistent zu halten:
- Default-Header und Request-IDs anhängen
- Error-Shapes normalisieren
- Pagination als Iterator oder Helper-Methode bereitstellen
- Per-Request-Auth-Overrides für Multi-Tenant-Szenarien unterstützen
- Generierte Request- und Response-Typen beibehalten, statt sie manuell neu zu schreiben
Zum Beispiel sollte die Anwendung code aufrufen, client.orders.listAll() oder client.orders.list({ cursor }), anstatt Query-Strings manuell zusammenzubauen und Pagination-Metadaten bei jedem Aufruf zu parsen.
SDK-Style-Clients sind sinnvoll, wenn API ein Produkt ist
Öffentliche APIs und gemeinsame Plattform-Services benötigen mehr als nur generierte Endpoint-Funktionen. Konsumenten erwarten konsistente Benennung, vorhersehbare Fehler und Transportdetails, die hinter domänenspezifischen Methoden verborgen bleiben.
Gute Client-Ergonomie sieht meistens so aus:
client.orders.list()returns a typed page or async iteratorclient.files.stream()handhabt Streaming, ohne das Low-Level-Fetch-Setup in jedem Aufruf zu exponieren- Auth kann global gesetzt und pro Request überschrieben werden
- Aufrufer erhalten stabile, typisierte Error-Objekte statt ad hoc geworfener Payloads
Das erhöht den Wartungsaufwand. Es verhindert außerdem, dass jedes konsumierende Team dieselben Boundary-Regeln etwas anders neu aufbaut – genau so breitet sich Contract Drift aus.
Ein vollständig typisierter Client ist nicht das Ziel. Das Ziel ist ein Client, dessen Typen nach der Weiterentwicklung von API noch zur Realität passen, weil die Generierung vom Public Contract ausgeht, Runtime-Validierung die Boundary schützt und DTO-Mapping verhindert, dass interne Änderungen nach außen dringen.
Error Handling, Testing und Observability, die wirklich helfen
Die meisten TypeScript-API-Beispiele sind zu optimistisch. Requests gelingen, JSON passt zum Interface, und Fehler werden zu throw new Error("something went wrong"). In der Production verhält sich nichts so höflich.
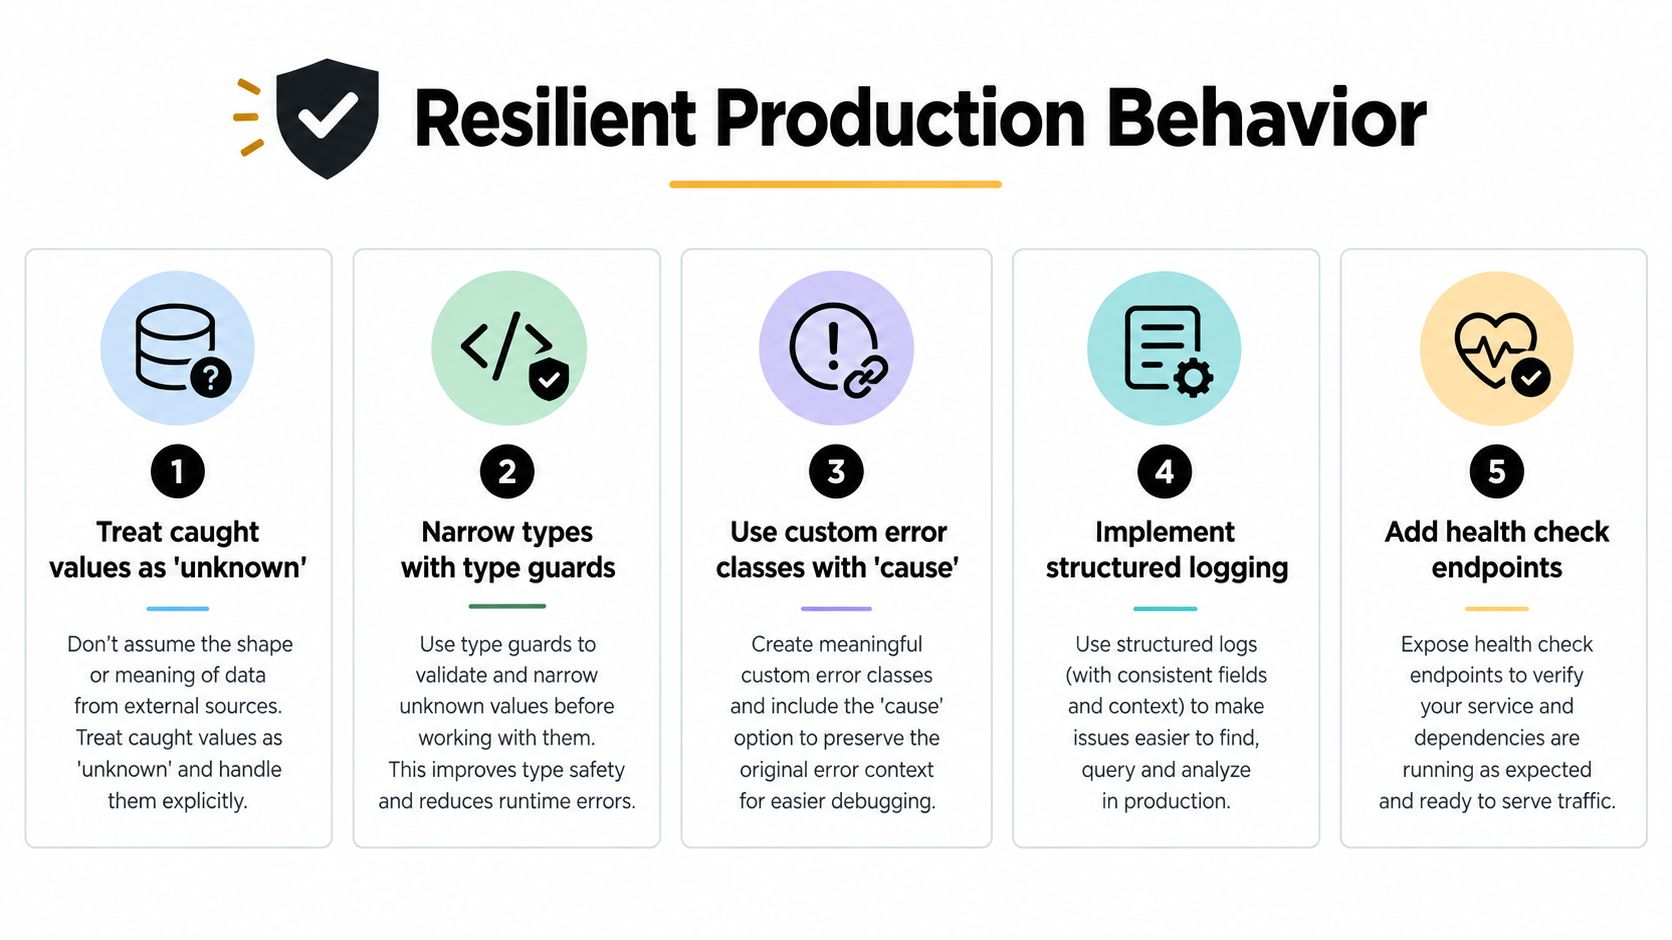
Der erste Fix ist mechanisch. In TypeScript sollten abgefangene Werte als unknown, dann eingegrenzt werden, bevor man sie liest message, stackoder auf Response-Properties zugreift. Experten empfehlen außerdem eigene Error-Klassen, die den ursprünglichen Fehler bewahren, sowie causeValidierung an Boundaries, Normalisierung von Non-Error Throws und das Anhängen von Request-Kontext für Observability (Leitfaden zum Error Handling in TypeScript).
Errors eingrenzen, bevor man sie anfasst
Unsichere catch-Blöcke sind immer noch verbreitet:
try {
  await client.orders.create(input)
} catch (error) {
  logger.error(error.message)
}
Das setzt zu viel voraus. error ist vielleicht kein Error at all.
Ein sichereres Pattern:
try {
  await client.orders.create(input)
} catch (error: unknown) {
  if (error instanceof Error) {
    logger.error({ message: error.message, stack: error.stack })
    throw new OrderSyncError("Order sync failed", { cause: error })
  }

  logger.error({ error })
  throw new OrderSyncError("Order sync failed", { cause: new Error("Non-Error thrown") })
}
Das wirkt etwas aufwendiger. Dafür hält es deutlich besser durch, wenn Fehler von Third-Party-SDKs, fehlgeschlagenem JSON-Parsing oder unerwarteten Throws kommen.
Retries nur bei transienten Fehlern
Die zweite große Verbesserung ist die Fehlerklassifizierung. Die Leitlinien für TypeScript SDK und API-Operationen laufen auf eine klare Regel hinaus: transiente Fehler wie Netzwerkfehler oder HTTP 429 und 503 retryen, früh validieren, den Error-Kontext bewahren und bei Business-Rule-Fehlern keine Retries machen. Dieselbe Anleitung empfiehlt auch Promise.all für Fail-Fast-Parallelverarbeitung und Promise.allSettled wenn Teilerfolge akzeptabel sind (SDK Error-Handling-Patterns).
Ich unterteile das in drei Kategorien:
- Validierungsfehler bedeuten, dass die Anfrage bereits vor dem Absenden fehlerhaft war.
- Temporäre Fehler may succeed on retry with backoff.
- Permanente Fehler spiegeln Business-Regeln, Berechtigungen oder fehlende Ressourcen wider und sollten direkt gemeldet werden.
Diese Klassifizierung ermöglicht ein besseres code als ein generischer „Retry on Failure“-Helper es je könnte.
Die Grundregel: Retries gehören zur Transport-Unsicherheit, nicht zu Domain-Konflikten.
Observability sollte Fehler erklären, nicht nur aufzeichnen
Logs ohne Kontext sind keine Observability. Für API in TypeScript: Hänge eine Correlation ID, den Routennamen, Request-Metadaten und eine normalisierte Error-Struktur überall dort an, wo ein Request eine Grenze überschreitet.
Ein nützlicher Baseline-Ansatz:
- Correlation-IDs verknüpfen einen Inbound-Request mit Downstream-Calls
- Strukturierte Logs Felder speichern, keine Text-Blobs
- Boundary-Logs Parsing-Fehler separat von Business-Exceptions erfassen
- Alerting basiert auf Error-Class und Route, nicht nur auf Status code Volumen
Wenn deine Mobile- oder Client-Apps diese APIs nutzen, ist Observability ebenfalls wichtig. Eine praktische Option in der Release-Layer ist Capgo, das typisierte APIs für das Versenden und Tracking von Live Updates in Capacitor und Electron-Umgebungen bietet. Das ist nützlich, wenn ein Client-seitiger Contract-Fix ein kontrolliertes Rollout und Sichtbarkeit pro Version benötigt, statt wieder blind auf den App Store zu warten. Für Teams, die den Feedback-Loop optimieren, passt dieser Guide zu App Observability ideal zum Server-side Logging.
Teste den Contract, nicht nur die Implementation
Unit-Tests allein verhindern keinen Drift. Füge Tests dort hinzu, wo Drift entsteht.
- Boundary-Validation-Tests: Füttere Schemas mit fehlerhaften Inputs und prüfe die Form der Fehlermeldung.
- Contract-Tests: Confirm actual HTTP responses match the published contract.
- Typed Error Assertions: Prüfe, ob transiente und permanente Fehler korrekt normalisiert werden.
- Client-Integrationstests: Stelle sicher, dass generierte oder wrapped Clients echte Responses korrekt parsen.
Eine starke Testsuite für typed APIs beweist nicht nur code Pfade. Sie beweist, dass dein Contract weiterhin die Wahrheit sagt.
Mit Vertrauen und Kontrolle in die Production gehen
Release-Qualität entsteht durch einen wiederholbaren Loop, nicht durch Heldenmut.
Eine zuverlässige API in einer TypeScript-Pipeline hat meist ein paar Essentials: Schema-Checks in der CI, Type-Checks für generierte Artefakte, Contract-Diff-Review vor dem Merge und einen Deployment-Pfad, der sich drosseln oder zurückrollen lässt, wenn eine Client-Population noch nicht bereit ist.
Der Release-Loop, der standhält
Ich halte die Production-Checkliste bewusst kurz, damit Teams sie auch wirklich befolgen:
- CI bei Contract Drift fehlschlagen lassen: Ändert sich OpenAPI, müssen generierte Types und Clients im selben Change aktualisiert werden.
- Shared Contracts bewusst versionieren: Public DTO-Packages brauchen Release-Disziplin, keine Refactors nebenbei.
- Rollout nach Channel oder Cohort: Setze nicht alle Consumer gleichzeitig einem Breaking Change in der Integration aus.
- Rollback einfach halten: Das Zurückrollen von Contract, Client oder Web-Bundle sollte operativ langweilig sein.
Für Teams, die Infrastruktur und Deployment-Workflows gleichzeitig umstellen, ist dieser Guide zu Cloud-Migration für Entwickler ist eine hilfreiche Planungshilfe, da die API Zuverlässigkeit oft während Plattformwechseln sinkt, nicht nur bei code Änderungen.
Kontrolle ist genauso wichtig wie Korrektheit
Die entscheidende Gewohnheit für die Produktion ist die Sichtbarkeit pro Version. Du musst wissen, welcher Client-Build welchen Contract aufruft, welche Releases erfolgreich übernommen wurden und wo nach dem Rollout Fehler gehäuft auftreten. Das ist besonders wichtig für Mobile- und Edge-Clients, die sich nicht alle sofort aktualisieren.
Wenn dein Stack Capacitor oder Electron umfasst, kann live update Tooling die Verzögerung zwischen dem Fix eines Contract-Bugs und der Bereitstellung für die Nutzer verringern. Dabei geht es nicht nur um abstrakte „schnellere Updates“, sondern darum, zu haben: Channel-basiertes Rollout, Rollback-Schutz und Observability auf Versionsebene damit Contract-Fixes unter Kontrolle bleiben.
Typed APIs bleiben stabil, wenn Schema, Runtime-Validierung, Client-Generierung und Release-Operations Hand in Hand gehen. Fehlt eine Ebene, gleichen die anderen das nur schlecht aus.
Capgo gibt Teams, die Capacitor und Electron-Apps ausliefern, einen typisierten Weg, Web-Bundle-Fixes auszuliefern, Rollout-Channels zu steuern und Adoption sowie Fehler pro Version zu überwachen. Wenn deine API Contract-Fixes auch schnell beim Client ankommen müssen, ohne auf das Store-Review zu warten, besuche Capgo.





