

Tu API en TypeScript probablemente se veía sólido el día del lanzamiento. Las rutas compilaban, el frontend importaba los tipos compartidos y el editor daba a todos esa sensación limpia y verde que normalmente significa “seguro para desplegar”.
Luego el backend cambió un campo de respuesta, apareció un valor nullable donde nadie lo esperaba, o un cliente móvil seguía llamando a una forma de payload más antigua. Ahí es donde la mayoría de los API en TypeScript fallan. No en la sintaxis. En la deriva.
Tabla de contenidos
- Por qué las APIs tipadas fallan tras el lanzamiento y cómo evitarlo
- Cómo estructurar correctamente tu proyecto API con TypeScript
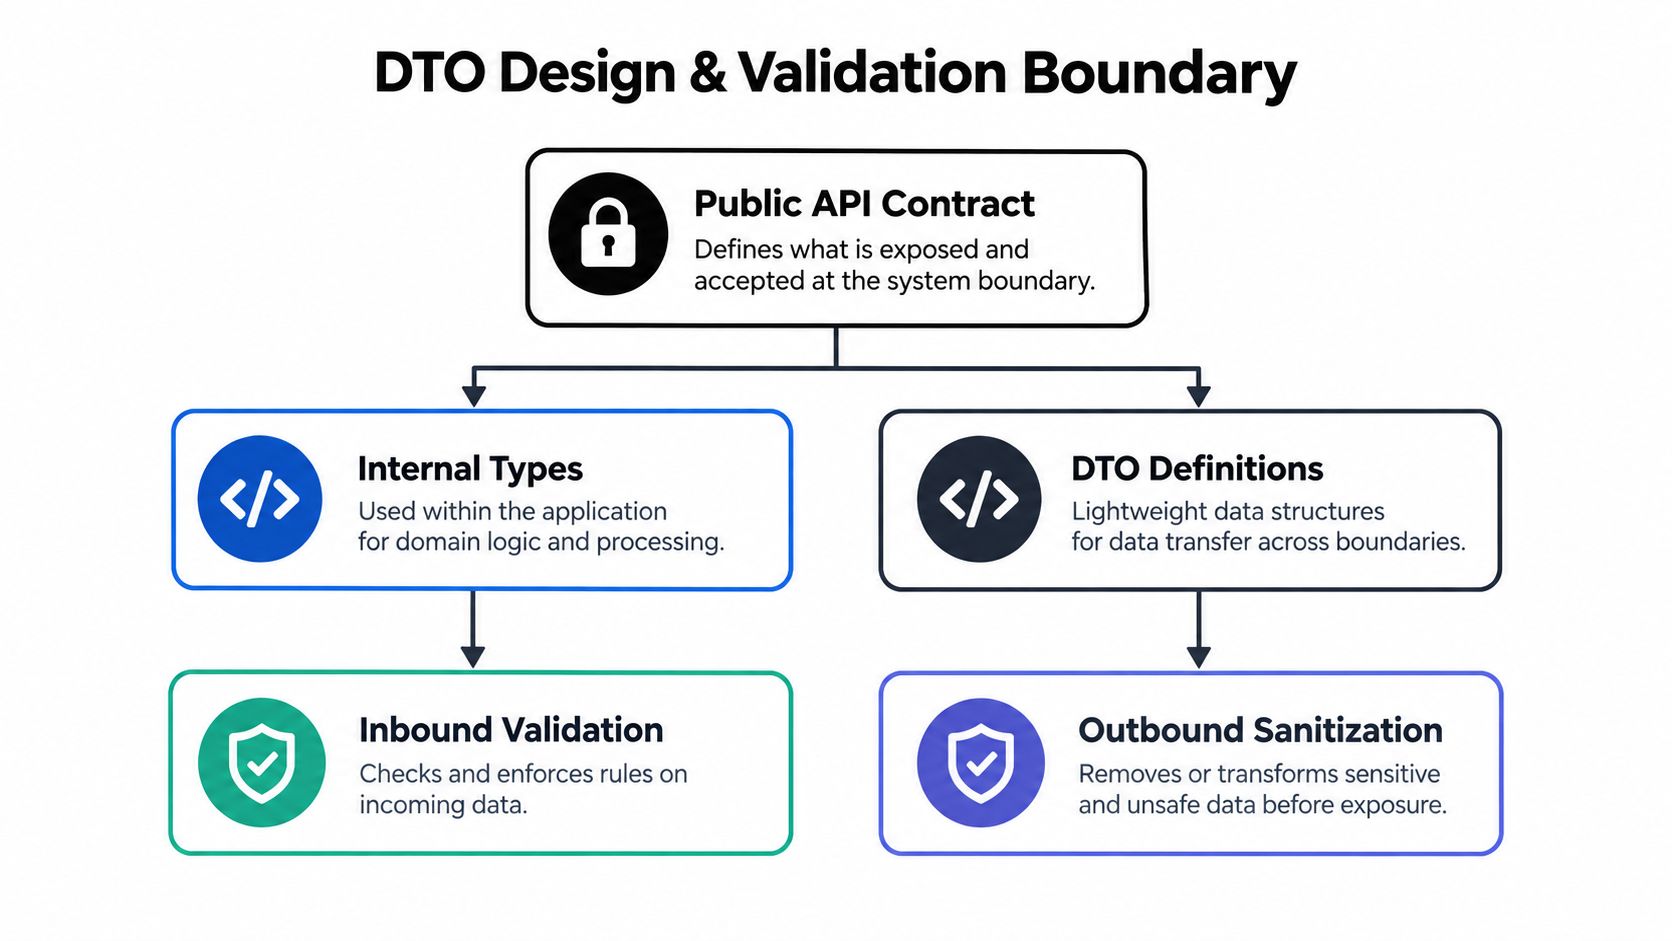
- Diseño de DTOs y validación de entrada en el límite
- Los contratos públicos y los modelos internos no deberían ser los mismos
- Valida antes de que la lógica de negocio toque los datos
- Mapear code no es un desperdicio. Es ahí donde el drift se hace visible
- Los tipos compartidos solo sirven si la fuente de verdad es explícita
- Un límite mantenible parece aburrido a propósito
- Generar y consumir un cliente API totalmente tipado
- Testing de manejo de errores y observabilidad que realmente ayudan
- Lanza a producción con confianza y control
Por qué las APIs tipadas fallan tras el lanzamiento y cómo evitarlo
Una API tipada suele romperse durante un lanzamiento normal. Un equipo renombra un campo de respuesta. Otro añade una rama nullable para una migración parcial. Un cliente antiguo sigue enviando el payload anterior porque las actualizaciones móviles van por detrás de las web. TypeScript sigue compilando en cada repo que actualizó sus tipos locales. El contrato en producción ya no se cumple.
Ese fallo tiene nombre: contract drift.
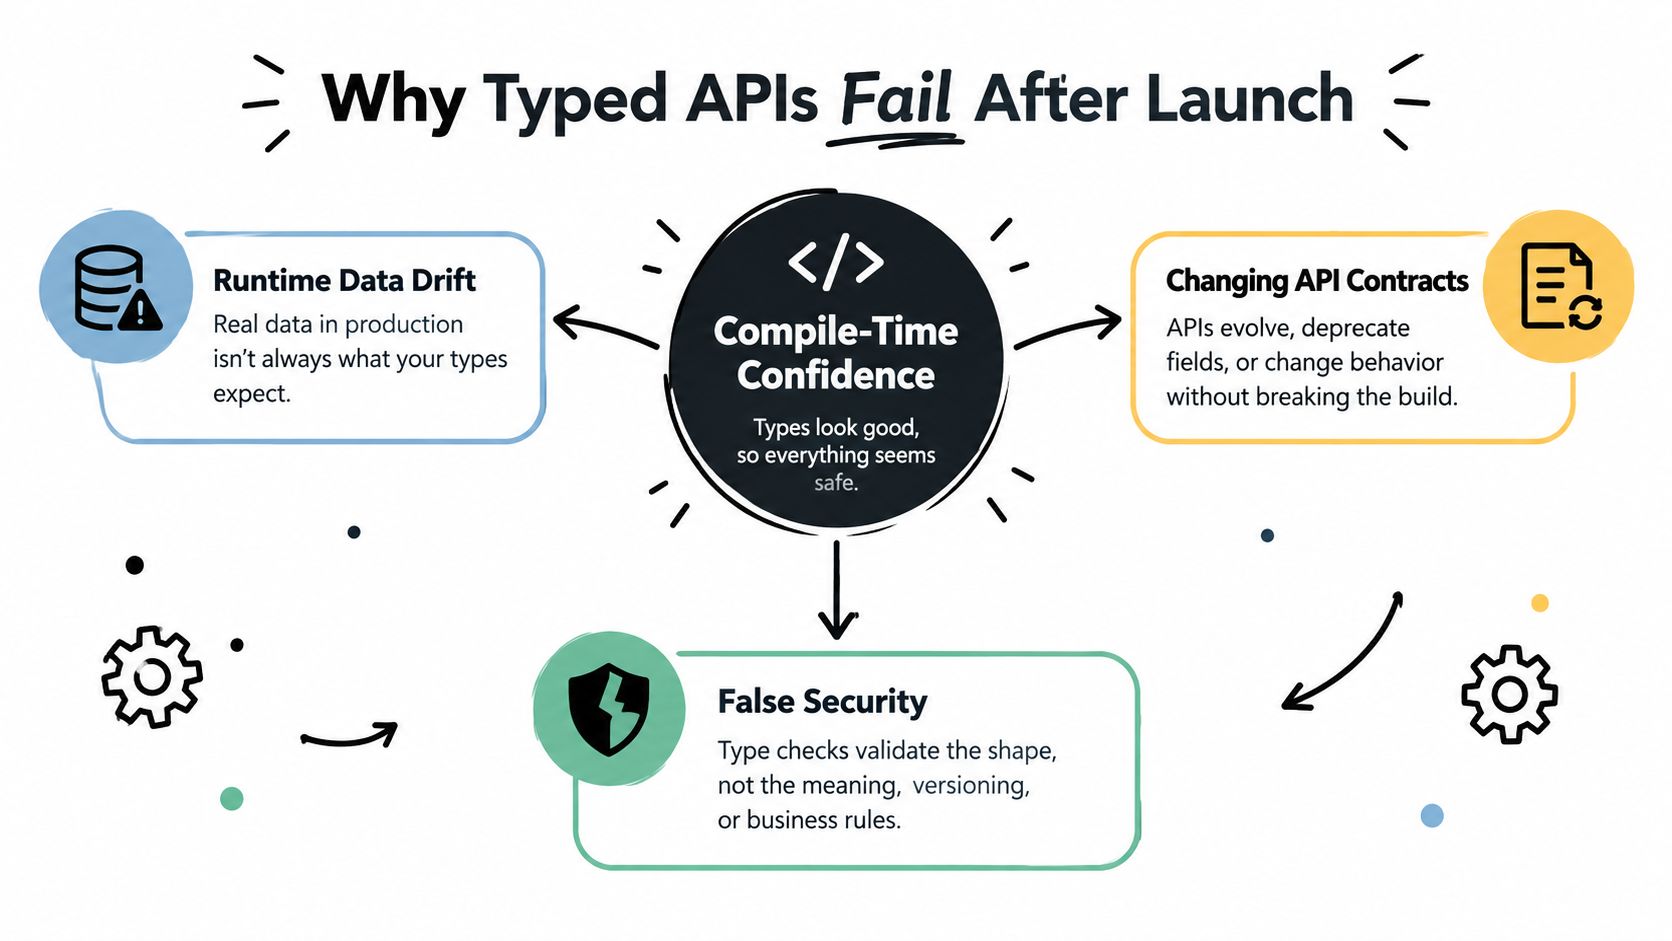
TypeScript hizo más agradable trabajar con API, pero también hizo más fácil confiar en exceso en contratos débiles. Interfaces compartidas, genéricos de ruta y un fetch wrapper tipado ayuda durante el desarrollo. No demuestran que el JSON que cruza la red siga coincidiendo con esos tipos tras el segundo o décimo release.
La regla que se sostiene en producción es simple.
Si un JSON sin validar llega directo a la lógica de la aplicación, tus tipos de TypeScript describen la intención, no la realidad.
La solución no está tanto en acrobacias de tipos como en dónde vive la verdad:
- Valida en el límite. Parsea el body de las peticiones, los params, las cabeceras e incluso las respuestas de servicios downstream antes de que el resto de code los toque.
- Mapea los DTOs a modelos de dominio. Mantén los transport shapes separados de los objetos de negocio para que el churn de API no se filtre por todo el codebase.
- Genera tipos a partir de un contrato. OpenAPI, JSON Schema o un framework schema-first ofrecen a clientes y servidores una fuente de verdad compartida.
- Trata los breaking changes como eventos públicos. Si un campo cambia de forma, versiónalo de forma deliberada y comunícalo como cualquier otro cambio de contrato externo.
El mapeo de DTO es la pieza que los equipos se saltan más a menudo. Al principio parece redundante, pero tras unos lanzamientos se convierte en la capa que te salva de propagar string | null y alias de campos legacy por cada servicio y pantalla del frontend. Un pequeño paso de traducción en el límite es más barato que un refactor masivo después.
Las APIs tipadas también fallan porque los contratos de error suelen ser algo secundario. Se presta atención a los payloads de éxito, pero los de error terminan siendo lo que sea que la excepción lanzada haya serializado ese día. Los clientes construyen su lógica de reintento, mensajes de usuario y monitoreo sobre formas que nunca fueron diseñadas. El resultado es el mismo problema con otra cara: drift.
El versionado merece la misma disciplina. Los equipos rara vez rompen clientes con un rewrite dramático; los rompen con una serie de cambios locales razonables que acumulan incompatibilidad. Una clara estrategia de versionado de API para contratos en evolución hace que esos cambios sean visibles antes de que lleguen a los usuarios.
El objetivo no es tener TypeScript en todas partes, sino que el contrato siga siendo fiel a la realidad tras el lanzamiento, cuando los despliegues, los clientes y los datos reales de producción empiezan a chocar con los tipos tan limpios que tenías el primer día.
Cómo estructurar correctamente tu proyecto API con TypeScript
Un API tipado suele verse limpio al principio. Seis meses después, una ruta acepta inputs sin validar, otra lee datos crudos process.env, y una tercera devuelve una estructura para la que ningún cliente fue programado. El scaffold rara vez se rompe de golpe; deja margen suficiente para que la desviación del contrato se cuele en el trabajo normal de features.
Empieza con una estructura de proyecto que dificulte saltarse el contrato.
Elige el framework que mejor se adapte a tu equipo
Para un API en TypeScript, la primera decisión de framework no trata tanto de la sintaxis, sino de dónde residirá la disciplina del contrato.
- Express encaja con equipos que buscan una abstracción mínima y ya conocen el modelo de middleware. No estorba, lo cual es útil hasta que cada ruta empieza a inventar su propia validación, estructura de error y convenciones de respuesta.
- Fastify es una opción por defecto muy sólida para equipos de backend pequeños y medianos. Su sistema de plugins es limpio y acerca el trabajo de esquemas a la capa de rutas, lo que ayuda a mantener el comportamiento en runtime alineado con los tipos.
- Nest funciona bien para codebases grandes con muchos colaboradores, módulos compartidos y límites de propiedad explícitos. El coste es la ceremonia, y ese coste es real si el servicio en sí es pequeño.
Suelo evitar comprar más framework del que el equipo va a usar. Un servicio pequeño con Fastify, una librería de validación y tipos de contrato generados suele sobrevivir mejor a los refactors que un stack más pesado con convenciones inconsistentes apiladas encima.
Usa una estructura de carpetas que proteja los límites
Los nombres de las carpetas importan menos que la presión de las importaciones. Si las rutas pueden acceder a los modelos de la base de datos, o los servicios pueden devolver entidades ORM directamente a los clientes, el scaffold ya está invitando a la deriva.
Un layout que resiste en producción suele separar las preocupaciones de transporte de las de la aplicación:
src/routessolo para el cableado HTTPsrc/schemaspara esquemas de solicitud y respuestasrc/dtopara tipos de transporte y mapeo codesrc/servicespara casos de uso y orquestaciónsrc/domainpara modelos de negocio que deben sobrevivir a cualquier endpoint individualsrc/clientspara integraciones downstreamsrc/errorspara tipos de error compartidos y helpers de narrowingsrc/configpara el parseo de configuración al arranque
Esa src/dto capa no es trabajo innecesario. Le da a API un lugar para absorber cambios externos sin filtrarlos a la lógica de dominio ni devolverlos a través de endpoints no relacionados.
La configuración merece el mismo tratamiento. Parsea las variables de entorno una vez al arranque, falla rápido ante valores inválidos y exporta un objeto de configuración tipado al resto de la app. Los equipos que siguen leyendo process.env dentro de los handlers suele terminar en lógica de ejecución ramificada que TypeScript no puede resolver. Esta guía sobre configuración de entorno es una buena referencia si necesitas estandarizar ese patrón.
Endurece el compilador antes de añadir funcionalidades
Un API de producción debería hacer que escribir code inseguro sea tedioso.
Los valores predeterminados útiles incluyen:
strictactivadouseUnknownInCatchVariablesactivadonoUncheckedIndexedAccesshabilitado si el equipo puede manejar la disciplina extra- Sin path aliases a menos que Node, tests, bundling y tooling los resuelvan de la misma manera
- Separar
build,typecheck, y scripts de lint en CI
Débil tsconfig deja que la deriva se acumule sin que nadie la note. Una estricta convierte las discrepancias en trabajo visible antes de que se conviertan en comportamiento en producción.
Las reglas de lint también ayudan, sobre todo las que evitan any, promesas flotantes y exportaciones accidentales desde módulos de contratos públicos. Nada de eso sustituye la validación en tiempo de ejecución, pero reduce el número de lugares donde pueden esconderse errores de contrato.
Otra decisión de scaffolding es clave desde el inicio. Define de dónde vendrá tu especificación OpenAPI y mantén esa decisión cerca de la capa de rutas. Algunos equipos la generan a partir de esquemas code-first. Otros generan stubs del servidor y tipos a partir de la especificación primero. Ambos enfoques pueden funcionar. Lo que falla es tratar la especificación como un subproducto que nadie revisa después del primer release.
Tras el scaffold inicial, ayuda comparar cómo se comportan los contratos tipados fuera de servicios de solicitud-respuesta simples. El Guía de TypeScript para Streamkap Flink es útil para equipos que trabajan con streams o sistemas intensivos en eventos, donde la deriva de contratos aparece en pipelines más largos, no solo en handlers HTTP.
Diseño de DTOs y validación de entrada en el límite
Una API tipada suele verse correcta el primer día. Seis meses después, los bugs aparecen en la frontera. Un cliente móvil sigue enviando un campo antiguo. Un socio omite una propiedad que tu frontend daba por siempre presente. Un refactor expone una columna interna de la ORM en una respuesta pública. TypeScript hizo su trabajo dentro del codebase. El contrato, sin embargo, derivó.
Por eso importa el diseño de DTOs. No se trata de que los cuerpos de las peticiones se vean ordenados. Se trata de mantener los tipos públicos honestos tras el primer release.
Los contratos públicos y los modelos internos no deberían ser los mismos
Una DTO describe lo que cruza la red. Un modelo de dominio describe lo que la aplicación necesita para hacer trabajo real. Mezclar esas responsabilidades ahorra unas líneas al principio y genera un acoplamiento caro después.
Si tu ruta recibe esto:
type CreateOrderRequestDto = {
  customerId: string
  items: Array<{ sku: string; quantity: number }>
  note?: string | null
}
tu capa de servicio debería seguir aceptando algo más acotado y limpio, como un OrderDraft con strings normalizados, cantidades validadas y valores por defecto aplicados en un solo lugar.
El límite suele requerir estos pasos:
- Parsear el payload entrante
- Validar la estructura y las restricciones de cada campo
- Mapear el DTO a un objeto de dominio
- Ejecutar la lógica de negocio sobre el objeto de dominio
- Mapear el resultado a un DTO de respuesta
- Validar la respuesta saliente antes de enviarla
El paso seis se suele omitir. Es también el paso que detecta campos privados, valores anulables que se filtraron en una respuesta estable y cambios accidentales en el esquema durante refactors.
Valida antes de que la lógica de negocio toque los datos
Los tipos en tiempo de compilación no validan el JSON de la red. Tampoco te protegen si otro servicio devuelve una estructura que sigue cumpliendo con unknown y rompe tus suposiciones en tiempo de ejecución.
Para que API funcione en TypeScript, Zod es una opción habitual porque parsea en tiempo de ejecución e infiere los tipos para el resto de code. Valibot, io-ts y librerías similares también sirven. La librería importa menos que la regla: los datos que no son de confianza se parsean antes de que nada más los use.
Un patrón que sobrevive a los refactors se ve así:
- Schemas de entrada rechazan datos de peticiones malformados
- Schemas de dependencias validan respuestas de APIs de terceros y servicios internos
- Schemas de salida verifican la respuesta que tu API está a punto de publicar
Esa capa intermedia es donde muchas APIs tipadas fallan tras el lanzamiento. Los equipos validan las peticiones, se saltan la validación de las respuestas downstream y luego se preguntan por qué el renombrado de un campo en un proveedor acaba en un incidente en producción.
Esta es la regla práctica que aplico: el JSON puro se detiene en la capa de rutas.
Mapear code no es un desperdicio. Es ahí donde el drift se hace visible
Los equipos suelen resistirse al mapeo de DTO porque parece repetitivo. Yo he visto lo contrario en producción. Una capa de mapeo ligera es donde los cambios de contrato se vuelven obvios, revisables y locales.
Por ejemplo:
- el transporte permite
note?: string | null - el modelo de dominio puede almacenar
note: stringcon""como valor por defecto - el DTO de respuesta puede omitir
notecompletamente cuando esté vacío
Esas son tres verdades distintas para tres audiencias diferentes. Tratarlas como una única interfaz compartida oculta la diferencia hasta que un cliente falla.
Un webhook lo deja aún más claro porque los consumidores pueden mantener la estructura de tu payload durante años. Si tu equipo está lidiando con ese problema, este ejemplo de diseño de payload de webhook es un buen complemento.
Los tipos compartidos solo sirven si la fuente de verdad es explícita
Copiar interfaces del backend al frontend genera desajustes con el tiempo. Los paquetes compartidos pueden ayudar, pero solo con tipos que sean intencionalmente públicos.
Una configuración que aguanta mejor en codebases grandes es la siguiente:
- define esquemas públicos de request y response separados de los modelos de persistencia
- genera OpenAPI desde esos esquemas públicos, o genera primero los tipos del servidor desde OpenAPI
- mantén los tipos de contrato generados cerca de los handlers y clientes
- mantener los tipos de dominio y los modelos ORM internos
- versiona los DTOs públicos deliberadamente cuando la compatibilidad importe
Esa separación también es coherente con las guías de diseño de TypeScript del equipo SDK de Azure, que enfatizan superficies públicas estables y evitar exponer detalles de implementación interna en el contrato.
Un límite mantenible parece aburrido a propósito
La buena versión es menos ingeniosa.
Antes, el frontend confiaba fetch().json() como si fuera la verdad, el backend devuelve objetos ORM directamente y una interfaz compartida intenta representar cada capa. Después, cada límite parsea los datos, los DTOs se mantienen acotados, los modelos de dominio se quedan internos, los tipos generados cubren el contrato público y el mapping de code hace explícitos los cambios.
Añade ceremonia. También te da un solo lugar donde revisar el drift antes de que lo encuentren los consumidores.
Generar y consumir un cliente API totalmente tipado
Un cliente tipado suele parecer terminado el día del lanzamiento. Tres meses después, un endpoint empieza a devolver un campo nullable, otro añade paginación por cursor y una app móvil fija una versión antigua del contrato. Los tipos de TypeScript siguen compilando. Los consumidores siguen rompiéndose.
Ese es el trabajo de la capa del cliente. Debe mantener fiel el contrato publicado después del primer release, no solo hacer que el autocompletado del editor se vea bien.
Elegir tu estrategia de cliente tipado
La estructura del cliente debe ajustarse a la complejidad real de API, no a la preferencia del equipo.
| Enfoque | Ideal para | Compromiso |
|---|---|---|
| Wrapper de fetch hecho a mano | Apps pequeñas, flujos de autenticación inusuales, iteración rápida | Rápido de empezar. Fácil de fragmentar entre llamadas con el tiempo |
| Generación de code OpenAPI | APIs REST sencillas con esquemas estables | Base sólida. Requiere ayuda para autenticación personalizada, streaming o paginación inusual |
| Cliente tipado estilo SDK | Plataformas multi-equipo, APIs públicas, integraciones de larga duración | Mayor coste de mantenimiento. Mejor experiencia de usuario cuando el API es un producto |
Los clientes hechos a mano funcionan para superficies pequeñas
Un fetch wrapper personalizado es una opción razonable cuando el API es interno, la superficie es pequeña o el comportamiento de transporte importa más que la generación de esquemas. Sigo usando este enfoque para herramientas de administración y servicios en etapas tempranas.
El modo de fallo es la deriva. Un equipo añade una regla de reintento en el wrapper. Otro se lo salta. Un tercero copia un tipo de respuesta en el frontend y lo amplía a any tras la primera discrepancia. Terminas con llamadas “tipadas” que ya no representan lo que devuelve el servidor.
Usa un cliente hecho a mano cuando se cumplan estas condiciones:
- el API es pequeño e interno
- el contrato cambia con tanta frecuencia que regenerar code es puro ruido
- el comportamiento de transporte personalizado domina el trabajo
- estás dispuesto a mantener el parsing en runtime en el cliente, no solo anotaciones de TypeScript
Ese último punto es clave. response.json() devuelve datos desconocidos en runtime, aunque la firma de la función diga lo contrario.
La generación con OpenAPI es el estándar práctico
Para APIs REST estables, los tipos generados ofrecen la mejor relación entre mantenimiento y seguridad. Eliminan mucha duplicación de tipos y hacen que los cambios en el contrato sean visibles en los pull requests.
El patrón que sobrevive a los refactors es simple. Genera desde el contrato público, mantén la capa generada ligera y añade un pequeño wrapper donde tus consumidores necesiten mejor ergonomía. El Workflow de generación de TypeScript desde OpenAPI encaja bien con ese modelo.
Una división útil sería esta:
- el code generado define las estructuras de request y response
- un wrapper ligero de SDK gestiona la inyección de auth, reintentos y helpers de paginación
- la validación en runtime sigue ocurriendo en el límite del servidor y donde sea que entre input no confiable al sistema
- el mapeo de DTO se mantiene explícito para que los cambios en el modelo interno no afecten al contrato del cliente
Ese enfoque híbrido mantiene el code generado simple, lo cual es bueno. Un code simple es más fácil de regenerar, revisar y reemplazar.
Envuelve los clientes generados antes de que los toque el code
Las funciones generadas suelen ser demasiado crudas para un uso generalizado en un codebase. Exponen detalles de transporte que cada caller tiene que volver a aprender.
Un wrapper ligero te permite centralizar la consistencia de tus políticas:
- adjuntar headers por defecto y request IDs
- normalizar la forma de los errores
- exponer la paginación como un iterador o método auxiliar
- soportar overrides de auth por petición en casos multi-tenant
- preservar los tipos de request y response generados en vez de reescribirlos a mano
Por ejemplo, la aplicación code debería llamar a client.orders.listAll() o client.orders.list({ cursor }), no armar query strings a mano ni parsear metadatos de paginación en cada llamada.
Los clientes estilo SDK tienen sentido cuando el API es un producto
Las APIs públicas y los servicios de plataforma compartidos necesitan más que funciones de endpoint generadas. Los consumidores esperan nombres consistentes, errores predecibles y que los detalles de transporte queden ocultos tras métodos que encajen con el dominio.
Una buena ergonomía del cliente suele verse así:
client.orders.list()devuelve una página tipada o un async iteratorclient.files.stream()gestiona el streaming sin filtrar la configuración de fetch de bajo nivel en cada llamada- auth se puede configurar globalmente y sobrescribir en cada request
- quienes llaman reciben objetos de error tipados y estables en lugar de payloads lanzados ad hoc
Eso añade coste de mantenimiento. También evita que cada equipo consumidor reconstruya las mismas reglas de frontera con ligeras diferencias, que es como se propaga la deriva del contrato.
Un cliente totalmente tipado no es la línea de meta. La meta es un cliente cuyos tipos siguen coincidiendo con la realidad después de que API evolucione, porque la generación parte del contrato público, la validación en runtime protege la frontera y el mapeo de DTO impide que los cambios internos se filtren hacia fuera.
Testing de manejo de errores y observabilidad que realmente ayudan
La mayoría de los ejemplos de API en TypeScript son demasiado tranquilos. Las peticiones funcionan, el JSON coincide con la interfaz y los fallos se throw new Error("something went wrong"). La producción nunca se comporta con tanta cortesía.
La primera corrección es mecánica. En TypeScript, los valores capturados deben tratarse como unknown, y luego estrecharse antes de leer message, stack, o propiedades de la respuesta. La orientación experta también recomienda clases de error personalizadas, conservando el fallo original con cause, validando en los límites, normalizando lanzamientos no-Error y adjuntando contexto de solicitud para observabilidad (Guía de manejo de errores en TypeScript).
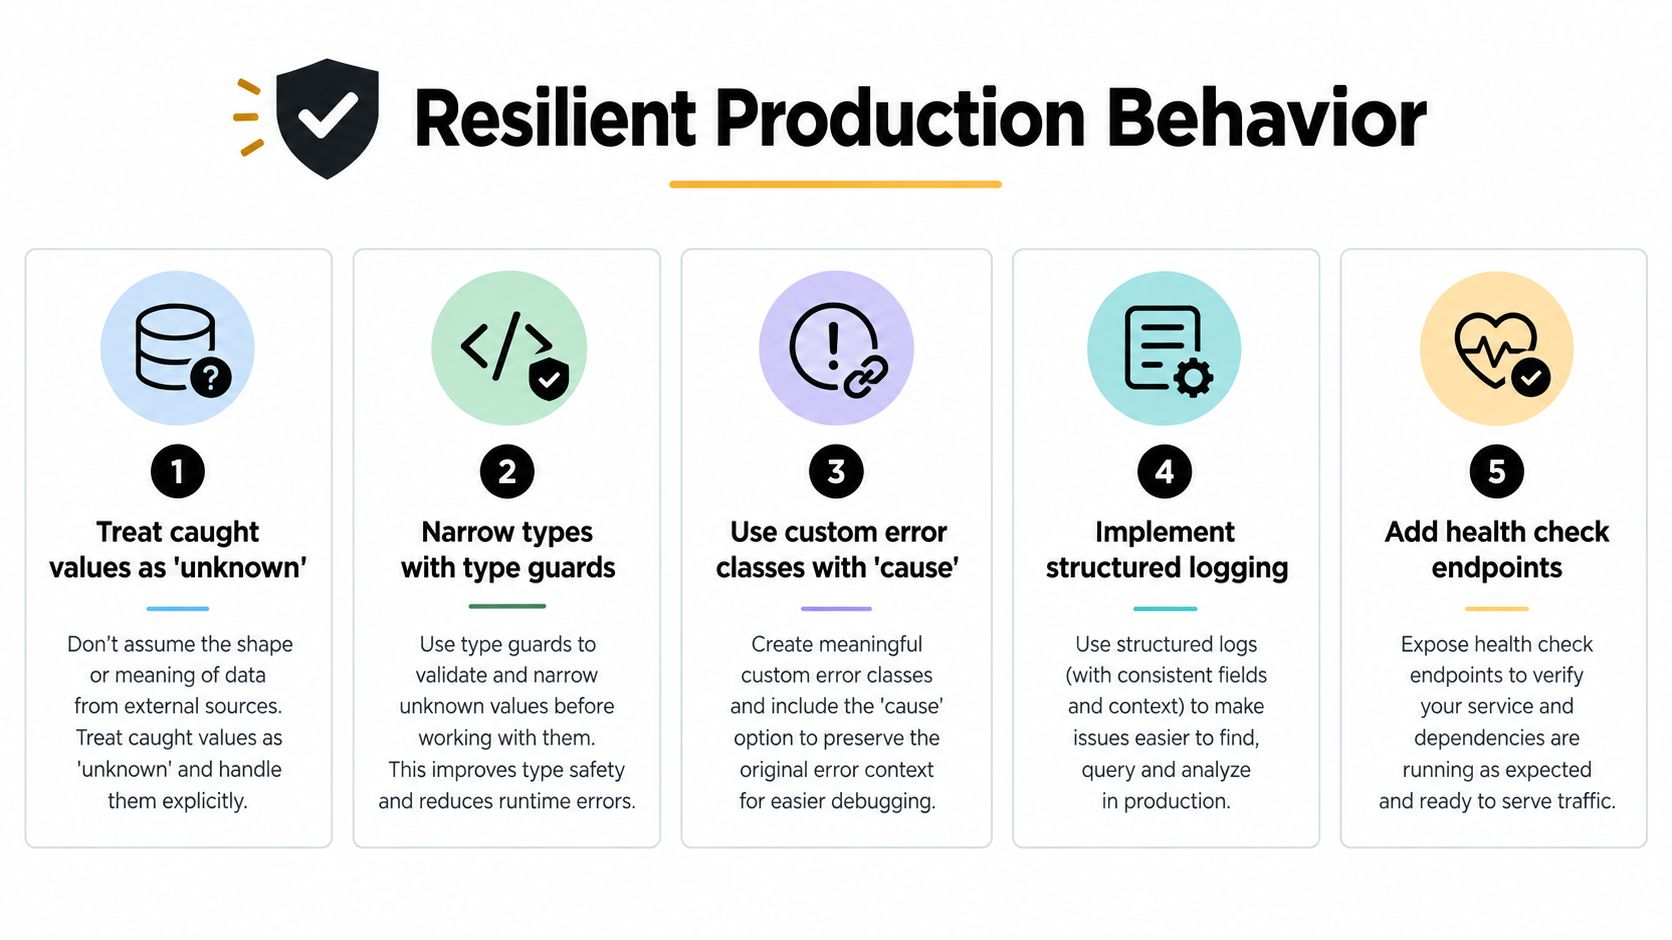
Acota el tipo de error antes de usarlo
Los bloques catch inseguros siguen siendo comunes:
try {
  await client.orders.create(input)
} catch (error) {
  logger.error(error.message)
}
Eso asume demasiado. error podría no ser un Error en absoluto.
Un patrón más seguro:
try {
  await client.orders.create(input)
} catch (error: unknown) {
  if (error instanceof Error) {
    logger.error({ message: error.message, stack: error.stack })
    throw new OrderSyncError("Order sync failed", { cause: error })
  }

  logger.error({ error })
  throw new OrderSyncError("Order sync failed", { cause: new Error("Non-Error thrown") })
}
Parece un poco más pesado. Sin embargo, resiste mucho mejor cuando hay fallos en SDKs de terceros, errores al parsear JSON o excepciones inesperadas.
Reintenta solo si el error es transitorio
La segunda gran mejora es la clasificación de errores. La guía para operaciones de SDK y API en TypeScript converge en una regla clara: reintenta fallos transitorios como errores de red o respuestas HTTP 429 y 503, valida pronto, preserva el contexto del error y evita reintentos en fallos de reglas de negocio. Esa misma guía también recomienda Promise.all para trabajo paralelo fail-fast y Promise.allSettled cuando el éxito parcial es aceptable (patrones de manejo de errores de SDK).
me gustan tres categorías:
- Errores de validación significan que la petición ya estaba mal antes de salir de tu proceso.
- Errores transitorios pueden tener éxito al reintentar con backoff.
- Errores permanentes reflejan reglas de negocio, permisos o recursos faltantes y deben mostrarse directamente.
Esa clasificación genera un mejor code que cualquier helper genérico de “retry on failure”.
Regla de campo: Los reintentos pertenecen a la incertidumbre del transporte, no al desacuerdo del dominio.
La observabilidad debe explicar fallos, no solo registrarlos
Los logs sin contexto no son observabilidad. Para API en TypeScript, adjunta un ID de correlación, el nombre de la ruta, metadatos de la solicitud y una forma de error normalizada en cada punto donde una solicitud cruza un límite.
Una línea base útil:
- IDs de correlación vinculan una solicitud entrante con las llamadas aguas abajo
- Logs estructurados almacenan campos, no bloques de texto
- Logs de límites capturar fallos de parseo por separado de las excepciones de negocio
- Alertas Claves según la clase de error y la ruta, no solo el volumen code
Si tus aplicaciones móviles o de cliente consumen estas APIs, la observabilidad también es clave. Una opción práctica en la capa de release es Capgo, que ofrece APIs tipadas para publicar y hacer seguimiento de actualizaciones en vivo en entornos de Capacitor y Electron. Es útil cuando una corrección de contrato en el cliente necesita un despliegue controlado y visibilidad por versión, en lugar de otra espera ciega en la app store. Para equipos que buscan cerrar el bucle de retroalimentación, esta guía sobre observabilidad de la app se integra bien con el registro en el servidor.
Testea el contrato, no solo la implementación
Las pruebas unitarias por sí solas no detectan la deriva. Añade pruebas donde ocurre.
- Pruebas de validación de límites: Introduce entradas malformadas en los esquemas y verifica la forma del fallo.
- Pruebas de contrato: Confirma que las respuestas HTTP reales coinciden con el contrato publicado.
- Aserciones de errores tipadas: Verifica que los fallos transitorios y permanentes se normalicen correctamente.
- Pruebas de integración del cliente: Asegúrate de que los clientes generados o envueltos parseen respuestas reales.
Una suite de pruebas sólida para APIs tipadas no solo demuestra las rutas de code. Demuestra que tu contrato sigue siendo la verdad.
Lanza a producción con confianza y control
La calidad del release viene de un loop repetible. No de hazañas.
Un API confiable en un pipeline de TypeScript suele tener unos esenciales: checks de schema en CI, type checks en artefactos generados, revisión de diff de contrato antes del merge, y una ruta de despliegue que pueda ralentizar o hacer rollback cuando la población de clientes no esté lista.
El ciclo de release que no falla
Me gusta mantener la checklist de producción lo suficientemente corta para que los equipos la sigan:
- Fallar en CI por drift de contrato: Si OpenAPI cambia, los tipos y clientes generados deben actualizarse en el mismo cambio.
- Versionar contratos compartidos deliberadamente: Los paquetes de DTO públicos necesitan disciplina de release, no refactors casuales.
- Desplegar por canal o cohorte: No expongas a todos los consumidores a un cambio de integración rompedor a la vez.
- Mantén el rollback simple: Revertir el contrato, el cliente o el web bundle debería ser una operación aburrida.
Para equipos que migran infraestructura y flujos de despliegue a la vez, esta guía de migración a la nube para desarrolladores es una referencia útil de planificación, porque la fiabilidad de API suele degradarse durante transiciones de plataforma, no solo durante cambios de code.
El control importa tanto como la corrección
El último hábito de producción es la visibilidad por versión. Necesitas saber qué build del cliente llama a qué contrato, qué releases se adoptaron con éxito y dónde se agrupan los fallos tras el rollout. Esto es especialmente importante para consumidores móviles y distribuidos en el edge que no se actualizan todos de inmediato.
Si tu stack incluye Capacitor o Electron, las herramientas de live update pueden reducir el desfase entre corregir un bug de contrato y llevar la corrección a los usuarios. La parte importante no son las “actualizaciones más rápidas” en abstracto. Es tener despliegue por canales, protección contra rollback y observabilidad a nivel de versión so contract fixes stay controlled.
Las APIs tipadas se mantienen sanas cuando el schema, la validación en runtime, la generación de clientes y las operaciones de release se refuerzan mutuamente. Si fallas en una capa, las demás terminan compensando mal.
Capgo ofrece a los equipos que publican Capacitor y aplicaciones Electron una forma tipada para entregar correcciones de bundles web, controlar canales de despliegue y monitorizar la adopción y los fallos por versión. Si tus correcciones de contrato API también deben llegar a los clientes rápidamente sin esperar a la revisión de la tienda, visita Capgo.





