

Votre API en TypeScript semblait probablement solide le jour de la release. Les routes compilaient, le frontend importait les types partagés, et l'éditeur donnait à tous cette impression de vert impeccable qui veut généralement dire « prêt à déployer ».
Puis le backend a modifié un champ de réponse, une valeur nullable est apparue là où personne ne l'attendait, ou un client mobile a continué d'appeler un ancien format de payload. C'est là que la plupart du API en TypeScript travail casse. Pas dans la syntaxe. Dans le drift.
Table des matières
- Pourquoi les API typées échouent après le lancement et comment l'éviter
- Bien structurer votre projet API en TypeScript
- Concevoir les DTO et valider les entrées à la frontière
- Les contrats publics et les modèles internes ne doivent pas être identiques
- Validez avant que la logique métier ne touche aux données
- Mapper code n'est pas une perte de temps. C'est là que le drift devient visible
- Les types partagés ne sont utiles que si la source de vérité est explicite
- Une frontière maintenable est volontairement ennuyeuse
- Générer et consommer un client API entièrement typé
- Gestion des erreurs, tests et observabilité vraiment utiles
- Déployer en production avec confiance et contrôle
Pourquoi les API typées échouent après le lancement et comment l'éviter
Une API typée casse généralement lors d'une release classique. Une équipe renomme un champ de réponse. Une autre ajoute une branche nullable pour une migration partielle. Un ancien client continue d'envoyer le payload précédent car les mises à jour mobiles sont en retard sur le web. TypeScript compile toujours dans chaque repo qui a mis à jour ses types locaux. Le contrat en production est déjà faux.
Cette défaillance porte un nom : le contract drift.
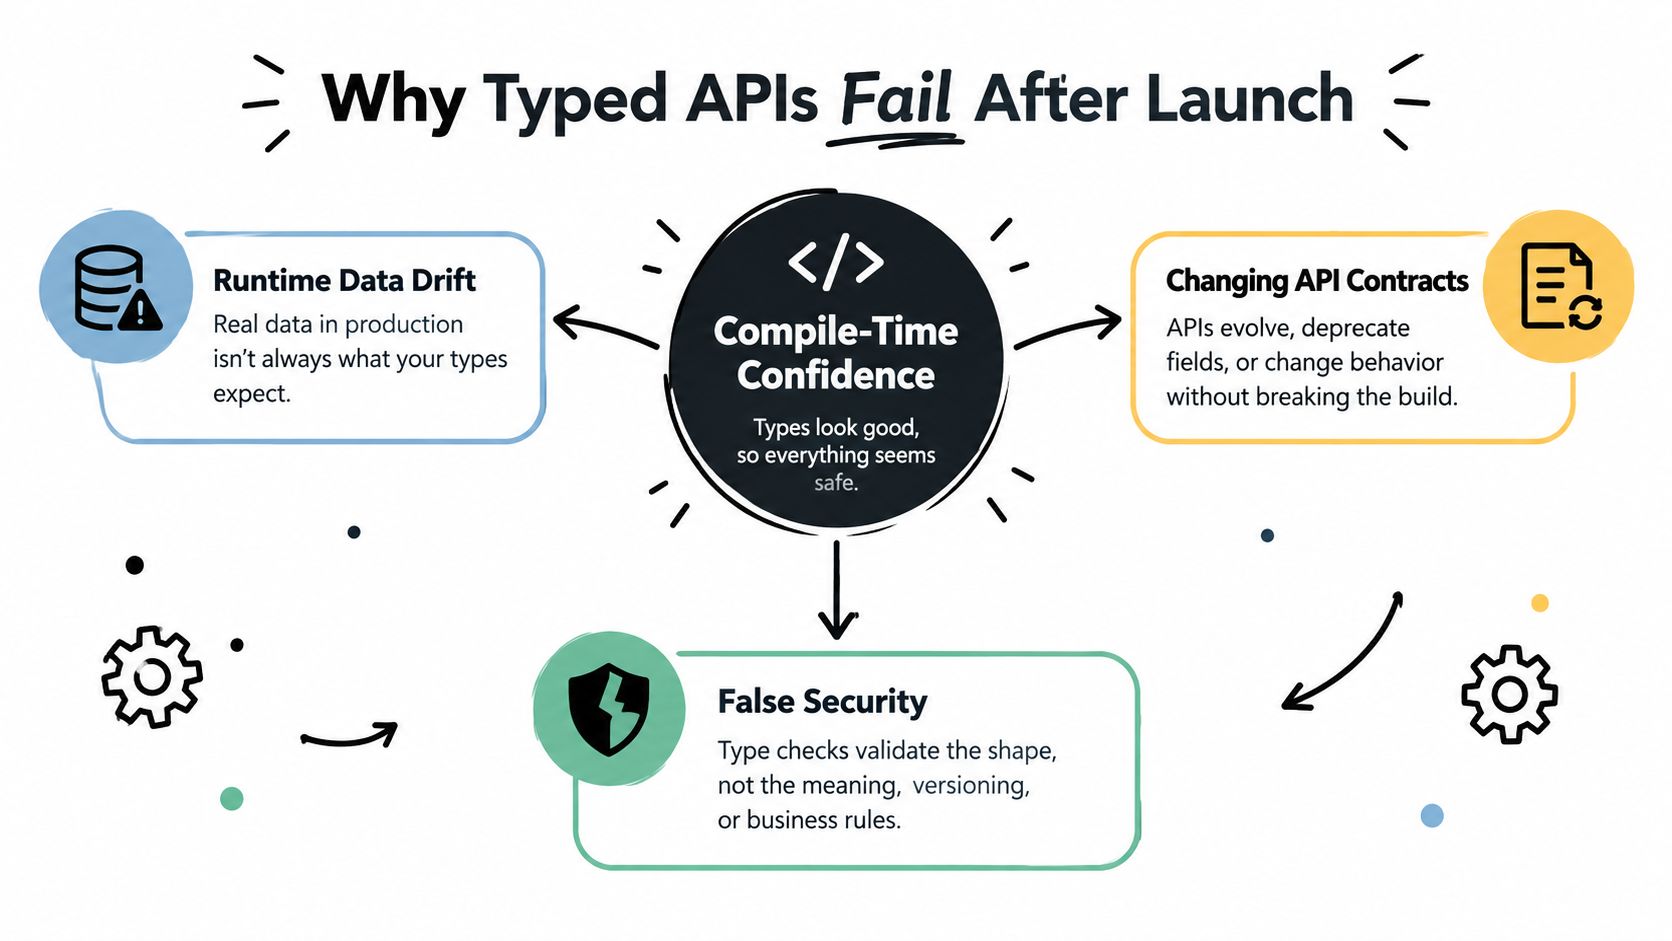
TypeScript a rendu le travail sur API plus agréable, mais il a aussi facilité la confiance excessive envers des contrats fragiles. Interfaces partagées, génériques de routes et un typage... fetch aident pendant le développement. Ils ne prouvent pas que le JSON qui traverse le réseau correspond toujours à ces types après la deuxième ou la dixième release.
La règle qui tient la route en production est simple.
Si du JSON non validé peut arriver directement dans la logique applicative, vos types TypeScript décrivent une intention, pas la réalité.
La solution tient moins à une gymnastique de types astucieuse qu'à l'endroit où se trouve la vérité :
- Validez à la frontière. Analysez les corps de requête, les paramètres, les headers et même les réponses des services en aval avant que le reste de code n'y touche.
- Mappez les DTO vers les modèles de domaine. Gardez les formes de transport séparées des objets métier pour que les changements de API ne se propagent pas à tout le code.
- Générez les types à partir d'un contrat. OpenAPI, JSON Schema ou un framework schema-first offrent aux clients et serveurs une source de vérité partagée.
- Traitez les breaking changes comme des événements publics. Si un champ change de structure, versionnez-le délibérément et communiquez-le comme tout autre changement de contrat externe.
Le mapping de DTO est l'étape que les équipes sautent le plus souvent. Au début, cela semble redondant. Après quelques releases, c'est la couche qui vous évite de propager string | null et les alias de champs legacy à travers chaque service et écran frontend. Une petite étape de traduction à la frontière coûte moins cher qu'un gros refactor plus tard.
Les API typées échouent aussi parce que les contrats d’erreur sont souvent une après-pensée. Les payloads de succès reçoivent toute l’attention. Les payloads d’échec deviennent ce qu’une exception levée a bien voulu sérialiser ce jour-là. Les clients construisent ensuite la logique de retry, les messages utilisateur et le monitoring sur des structures jamais conçues. Le résultat est le même problème sous une autre forme. La dérive.
Le versioning mérite la même discipline. Les équipes cassent rarement les clients avec une réécriture spectaculaire. Elles les cassent avec une série de modifications locales raisonnables qui finissent par créer une incompatibilité. Une API stratégie de versioning pour faire évoluer les contrats rend ces modifications visibles avant qu’elles n’atteignent les consommateurs.
L'objectif n'est pas d'avoir du TypeScript partout. Le but est de garder un contrat fiable après le lancement, quand les déploiements multiples, les clients multiples et les vraies données de production commencent à bousculer les types bien nets que vous aviez au premier jour.
Bien structurer votre projet API en TypeScript
Un API typé semble généralement propre le premier jour. Six mois plus tard, une route accepte des entrées non vérifiées, une autre lit des données brutes process.env, et une troisième renvoie une structure pour laquelle aucun client n'a été codé. Le squelette casse rarement d'un coup. Il laisse juste assez de place pour que la dérive du contrat s'infiltre dans le travail normal sur les fonctionnalités.
Commencez par une structure de projet où le contrat est difficile à contourner.
Choisissez le framework adapté à la structure de votre équipe
Pour un API en TypeScript, la première décision de framework concerne moins la syntaxe que l'endroit où la discipline du contrat sera appliquée.
- Express convient aux équipes qui veulent une abstraction minimale et maîtrisent déjà le modèle middleware. Il reste en retrait, ce qui est utile jusqu'à ce que chaque route invente sa propre validation, sa propre forme d'erreur et ses propres conventions de réponse.
- Fastify est un excellent choix par défaut pour les petites et moyennes équipes backend. Son système de plugins est propre et il rapproche le travail de schéma de la couche route, ce qui aide à garder le comportement au runtime aligné avec les types.
- Nest fonctionne très bien pour les bases de code importantes avec de nombreux contributeurs, des modules partagés et des frontières de responsabilité explicites. Le coût, c'est la lourdeur de mise en œuvre, et ce coût est bien réel si le service est petit.
J'évite généralement d'acheter plus de framework que ce que l'équipe utilisera réellement. Un petit service avec Fastify, une bibliothèque de validation et des types de contrat générés survit souvent mieux aux refactors qu'une stack plus lourde avec des conventions incohérentes superposées.
Utilisez une structure de dossiers qui protège les frontières
Le nom des dossiers importe moins que la pression des imports. Si les routes peuvent accéder directement aux modèles de la base de données, ou si les services renvoient des entités ORM directement aux clients, la structure invite déjà à la dérive.
Une structure qui tient la route en production sépare généralement les préoccupations de transport des préoccupations applicatives :
src/routesuniquement pour le câblage HTTPsrc/schemaspour les schémas de requête et de réponsesrc/dtopour les types de transport et le mapping codesrc/servicespour les cas d'usage et l'orchestrationsrc/domainpour les modèles métier qui doivent survivre à n'importe quel endpointsrc/clientspour les intégrations en avalsrc/errorspour les types d'erreur partagés et les helpers de narrowingsrc/configpour l'analyse de la configuration au démarrage
Cela src/dto Cette couche n’est pas une corvée. Elle donne au API un endroit pour absorber les changements externes sans les laisser filtrer dans la logique métier ou ressortir par des endpoints non liés.
La configuration mérite le même traitement. Parsez les variables d’environnement une seule fois au démarrage, échouez rapidement sur les valeurs invalides et exportez un objet de config typé vers le reste de l’application. Les équipes qui continuent de lire process.env dans les handlers, on finit souvent avec un comportement d’exécution conditionnel que TypeScript ne peut pas aider à résoudre. Ce guide sur la configuration d’environnement est une bonne référence si vous avez besoin de standardiser ce motif.
Durcissez le compilateur avant d'ajouter des fonctionnalités
Une production API devrait rendre les code non sécurisés pénibles à écrire.
Les valeurs par défaut utiles incluent :
strictactivéuseUnknownInCatchVariablesactivénoUncheckedIndexedAccessactivé si l’équipe peut gérer la discipline supplémentaire- Aucun alias de chemin, sauf si Node, les tests, le bundling et les outils les résolvent de la même manière
- Séparez
build,typecheck, et les scripts de lint dans la CI
Un faible tsconfig laisse la dérive s’accumuler sans être détectée. Un typage strict transforme les incohérences en travail visible avant qu’elles ne deviennent un comportement en production.
Les règles de lint aident aussi, surtout celles qui interdisent any, les promesses flottantes et les exports accidentels depuis des modules de contrat public. Rien de tout cela ne remplace la validation au runtime, mais cela réduit le nombre d’endroits où les erreurs de contrat peuvent se cacher.
Un autre choix de scaffolding est déterminant très tôt. Décidez d’où viendra votre spec OpenAPI et gardez cette décision proche de la couche de routes. Certaines équipes la génèrent à partir de schémas code-first. D’autres génèrent d’abord les stubs serveur et les types à partir de la spec. Les deux approches peuvent fonctionner. Ce qui échoue, c’est de traiter la spec comme un artefact secondaire que personne ne vérifie après la première release.
Après le scaffolding initial, il est utile de comparer le comportement des contrats typés en dehors des services requête-réponse classiques. Le guide TypeScript de Streamkap Flink est utile pour les équipes travaillant avec des streams ou des systèmes riches en événements, où la dérive de contrat apparaît sur des pipelines longs, et pas seulement dans les handlers HTTP.
Concevoir les DTO et valider les entrées à la frontière
Un API typé semble correct au premier jour. Six mois plus tard, les bugs apparaissent aux frontières. Un client mobile continue d'envoyer un ancien champ. Un partenaire omet une propriété que votre frontend supposait toujours présente. Un refactoring expose une colonne ORM interne dans une réponse publique. TypeScript a fait son travail dans le codebase. Le contrat a quand même dérivé.
C'est pourquoi la conception des DTO compte. Il ne s'agit pas de rendre les corps de requête plus propres, mais de garder des types publics honnêtes après la première release.
Les contrats publics et les modèles internes ne doivent pas être identiques
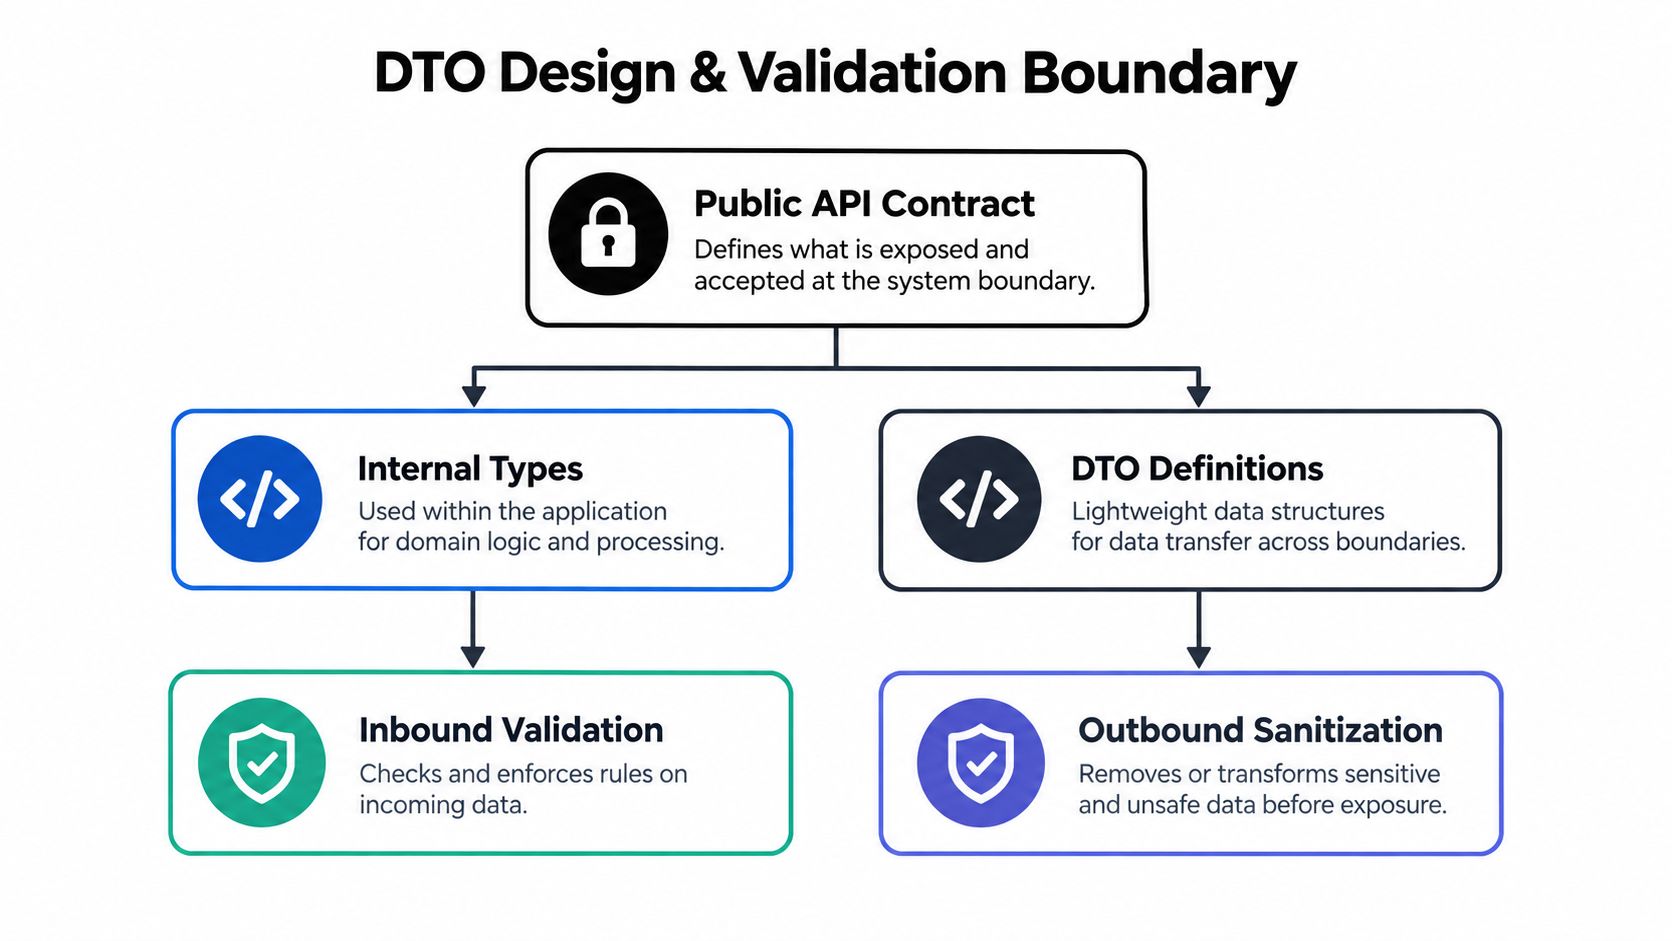
Un DTO décrit ce qui transite sur le réseau. Un modèle de domaine décrit ce dont l'application a besoin pour faire le vrai travail. Fusionner ces préoccupations économise quelques lignes au début, mais crée un couplage coûteux par la suite.
Si votre route reçoit ceci :
type CreateOrderRequestDto = {
  customerId: string
  items: Array<{ sku: string; quantity: number }>
  note?: string | null
}
votre couche de service devrait toujours accepter quelque chose de plus précis et de plus propre, comme un OrderDraft avec des chaînes normalisées, des quantités validées et des valeurs par défaut appliquées en un seul endroit.
La frontière nécessite généralement ces étapes :
- Parser le payload entrant
- Valider la structure et les contraintes par champ
- Mapper le DTO vers un objet métier
- Exécuter la logique métier sur l'objet métier
- Mapper le résultat vers un DTO de réponse
- Valider la réponse sortante avant de l’envoyer
L’étape six est souvent sautée. C’est pourtant celle qui détecte les champs privés, les valeurs nullables qui se sont glissées dans une réponse stable, et les changements de schéma accidentels lors des refactors.
Validez avant que la logique métier ne touche aux données
Les types au moment de la compilation ne valident pas le JSON reçu du réseau. Ils ne vous protègent pas non plus si un autre service renvoie une structure qui satisfait unknown et brise vos hypothèses à l'exécution.
Pour du travail de API en TypeScript, Zod est un choix courant : il parse à l'exécution et infère les types pour le reste de votre code. Valibot, io-ts et des bibliothèques similaires font aussi l'affaire. La bibliothèque compte moins que la règle : les données non fiables sont parsées avant tout autre usage.
Un pattern qui survit aux refactorings ressemble à ceci :
- Schémas entrants rejettent les données de requête malformées
- Schémas de dépendances valident les réponses des API tierces et des services internes
- Schémas sortants vérifient la réponse que votre API s'apprête à publier
C'est dans cette couche intermédiaire que beaucoup d'API typées échouent après le lancement. Les équipes valident les requêtes, sautent la validation des réponses en aval, puis s'étonnent qu'un renommage de champ chez un fournisseur se transforme en incident de production.
Voici la règle pratique que j'applique. Le JSON brut s'arrête à la couche de routage.
Mapper code n'est pas une perte de temps. C'est là que le drift devient visible
Les équipes résistent souvent au mapping de DTO, qu'elles trouvent répétitif. En production, j'ai constaté l'inverse. Une couche de mapping fine, c'est là que les changements de contrat deviennent évidents, relisibles et localisés.
Par exemple :
- le transport permet
note?: string | null - le modèle de domaine peut stocker
note: stringpar""par défaut - le DTO de réponse peut omettre
noteentièrement s'il est vide
Ce sont trois vérités distinctes pour trois publics différents. Les traiter comme une interface unique masque les différences jusqu'à ce qu'un client casse.
Un webhook rend cela encore plus clair, car les consommateurs peuvent conserver la structure de votre payload pendant des années. Si votre équipe travaille sur ce problème, ce exemple de conception de payload webhook est un complément utile.
Les types partagés ne sont utiles que si la source de vérité est explicite
Copier les interfaces du backend dans le frontend, c'est une dérive différée. Les packages partagés peuvent aider, mais uniquement pour les types volontairement publics.
Une configuration plus robuste pour les bases de code plus importantes ressemble à ceci :
- définir les schémas de requête et de réponse publics séparément des modèles de persistance
- générer l'OpenAPI à partir de ces schémas publics, ou générer d'abord les types serveur depuis l'OpenAPI
- garder les types de contrat générés proches des handlers et des clients
- garder les types de domaine et les modèles ORM en interne
- versionner délibérément les DTO publics quand la compatibilité compte
Cette séparation est également cohérente avec les directives de conception TypeScript de l'équipe Azure SDK, qui mettent l'accent sur des surfaces publiques stables et sur l'exclusion des détails d'implémentation internes du contrat.
Une frontière maintenable est volontairement ennuyeuse
La bonne version est moins maline.
Avant, le frontend fait confiance fetch().json() comme s’il s’agissait de la vérité, le backend renvoie directement des objets ORM, et une interface partagée tente de représenter toutes les couches. Après, chaque frontière analyse les données, les DTO restent étroits, les modèles de domaine restent internes, les types générés couvrent le contrat public, et le mapping code rend les modifications explicites.
It adds ceremony. It also gives you one place to review drift before callers find it for you.
Générer et consommer un client API entièrement typé
Un client typé semble souvent terminé le jour de la release. Trois mois plus tard, un endpoint commence à retourner un champ nullable, un autre ajoute une pagination par curseur, et une application mobile est épinglée sur une version plus ancienne du contrat. Les types TypeScript se compilent toujours. Les appelants, eux, cassent.
C'est le rôle de la couche client. Elle doit garder le contrat publié fidèl’après la première release, pas seulement rendre l'autocomplétion de l'éditeur plus jolie.
Choisir votre stratégie de client typé
La forme du client doit refléter la complexité réelle de l’API, et non les préférences de l’équipe.
| Approche | Idéal pour | Compromis |
|---|---|---|
| Wrapper fetch fait main | Petites apps, flux d’authentification atypiques, itérations rapides | Rapide à démarrer. Facile à fragmenter entre les appels au fil du temps |
| Génération OpenAPI code | API REST simples avec des schémas stables | Base solide. Besoin d’aide pour l’authentification personnalisée, le streaming ou la pagination atypique |
| Client typé de type SDK | Plateformes multi-équipes, API publiques, intégrations durables | Coût de maintenance le plus élevé. Meilleure expérience consommateur lorsque l’API est un produit |
Les clients faits maison conviennent aux petites surfaces
Un fetch wrapper personnalisé est un choix raisonnable lorsque l’API est interne, que la surface d’API est limitée, ou que le comportement de transport prime sur la génération de schéma. J’utilise toujours cette approche pour les outils d’administration et les services en phase de démarrage.
Le mode d'échec, c'est la dérive. Une équipe ajoute une règle de retry dans le wrapper. Une autre le contourne. Une troisième copie un type de réponse dans le frontend et l'élargit pour any après le premier écart. Vous vous retrouvez avec des appels « typés » qui ne représentent plus ce que le serveur renvoie.
Utilisez un client écrit à la main quand ces conditions sont réunies :
- l’API est petit et interne
- le contrat change assez souvent pour que régénérer code devienne du bruit
- le comportement de transport personnalisé domine le travail
- vous êtes prêt à garder du parsing à l'exécution dans le client, pas seulement des annotations TypeScript
Ce dernier point compte. response.json() renvoie des données inconnues à l'exécution, même si la signature de la fonction dit le contraire.
La génération OpenAPI est le choix par défaut pragmatique
Pour les API REST stables, les types générés offrent le meilleur ratio maintenance/sécurité. Ils suppriment beaucoup d'écriture de types en double et rendent les changements de contrat visibles dans les pull requests.
Le pattern qui résiste aux refactorings est simple. Générez à partir du contrat public, gardez la couche générée légère, et ajoutez un petit wrapper là où vos consommateurs ont besoin d'une meilleure ergonomie. Le Workflow de génération TypeScript OpenAPI s’inscrit bien dans ce modèle.
Une découpe utile ressemble à ceci :
- généré, code gère les formes des requêtes et des réponses
- un wrapper SDK fin gère l'injection de l'authentification, les retries et les helpers de pagination
- la validation au runtime a toujours lieu à la frontière du serveur et partout où des données non fiables réintègrent le système
- le mapping des DTO reste explicite pour que les changements du modèl’interne ne fuitent pas dans le contrat client
Cette approche hybride garde le code généré simple, ce qui est bien. Un code simple est plus facile à régénérer, à relire et à remplacer.
Enveloppez les clients générés avant que code ne les manipule
Les fonctions générées sont généralement trop brutes pour un usage large dans une base de code. Elles exposent des détails de transport que chaque appelant doit alors réapprendre.
Un wrapper fin vous offre un seul endroit pour maintenir une politique cohérente :
- attach default headers and request IDs
- normaliser les formes d'erreurs
- exposer la pagination sous forme d'itérateur ou de méthode helper
- support per-request auth overrides for multi-tenant cases
- conserver les types de requête et de réponse générés plutôt que de les réécrire à la main
Par exemple, l’application code devrait appeler client.orders.listAll() ou client.orders.list({ cursor }), plutôt que d’assembler manuellement des chaînes de requête et de parser les métadonnées de pagination à chaque appel.
Les clients de style SDK ont du sens quand API est un produit
Les API publiques et les services de plateforme partagés ont besoin de plus que de simples fonctions d’endpoint générées. Les consommateurs attendent une cohérence de nommage, des erreurs prévisibles et des détails de transport masqués derrière des méthodes qui correspondent au domaine.
Une bonne ergonomie côté client ressemble généralement à ceci :
client.orders.list()retourne une page typée ou un itérateur asynchroneclient.files.stream()gère le streaming sans exposer la configuration fetch de bas niveau à chaque appel- l’authentification peut être définie globalement et surchargée par requête
- les appelants reçoivent des objets d’erreur typés et stables au lieu de payloads jetés ad hoc
Cela augmente les coûts de maintenance. Cela empêche aussi chaque équipe consommatrice de reconstruire les mêmes règles de frontière avec de légères variations, ce qui est la cause de la dérive des contrats.
Un client entièrement typé n'est pas l'objectif final. L'objectif final est un client dont les types correspondent toujours à la réalité après l'évolution de API, car la génération part du contrat public, la validation au runtime protège la frontière et le mapping des DTO empêche les changements internes de fuir vers l'extérieur.
Gestion des erreurs, tests et observabilité vraiment utiles
La plupart des exemples TypeScript API sont trop sereins. Les requêtes réussissent, le JSON correspond à l’interface, et les échecs deviennent throw new Error("something went wrong"). En production, ce n’est jamais aussi poli.
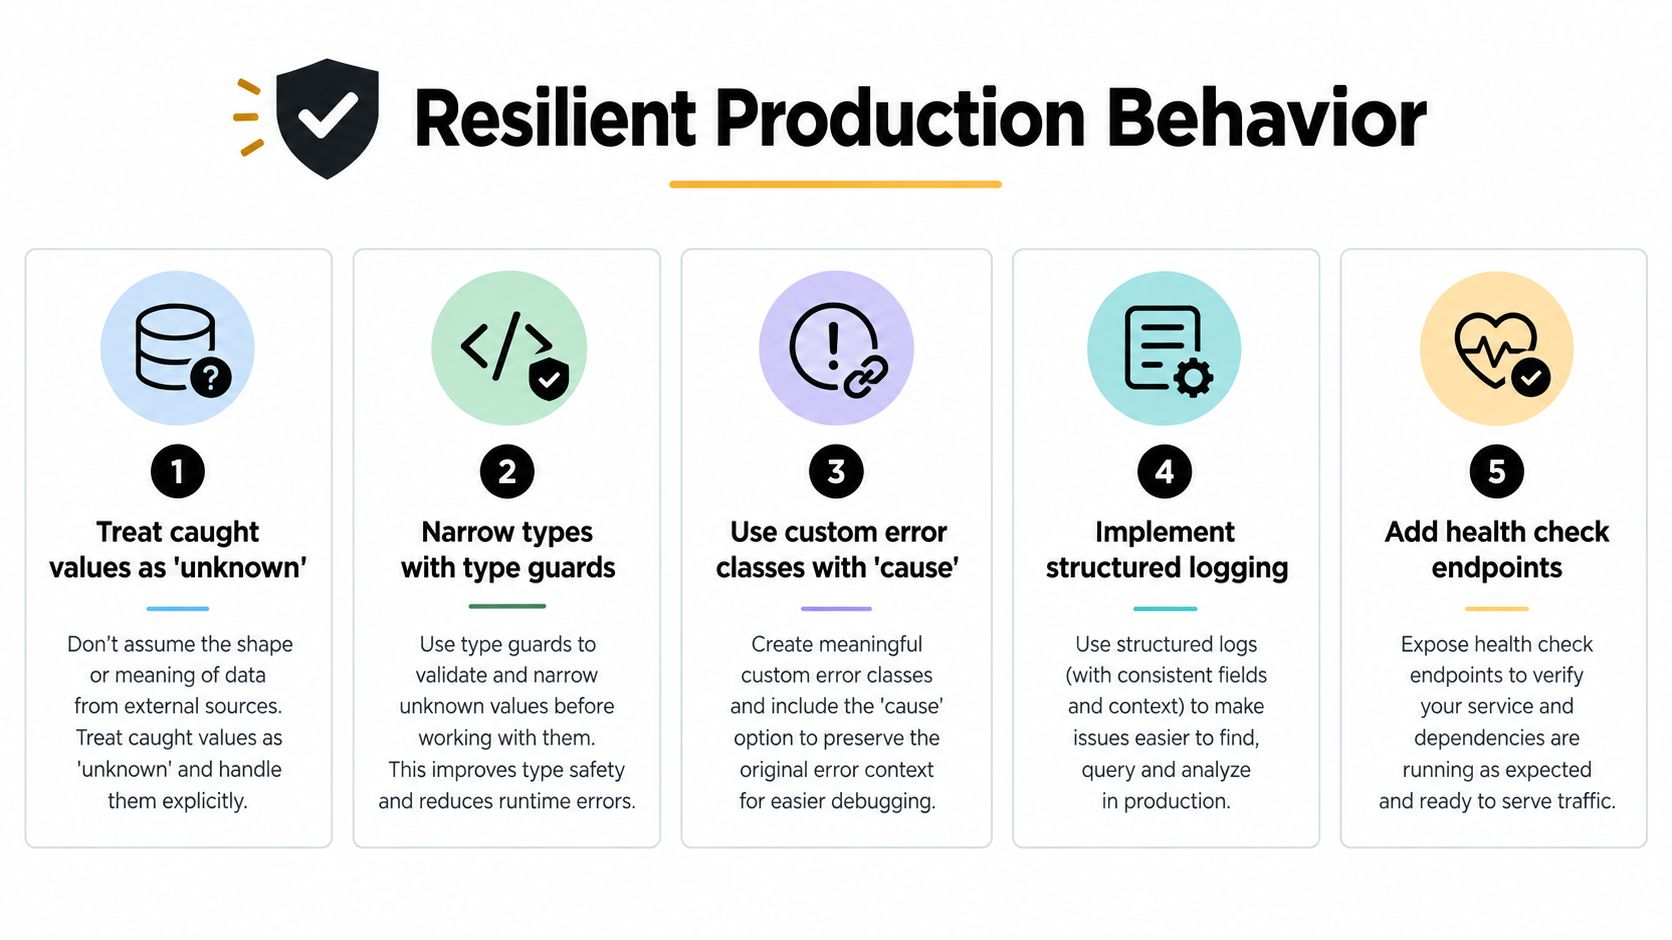
La première correction est mécanique. En TypeScript, les valeurs capturées doivent être traitées comme unknown, puis affinées avant de lire message, stack, ou les propriétés de la réponse. Les conseils d'experts recommandent également des classes d'erreur personnalisées, en conservant l'échec d'origine avec cause, la validation aux frontières, la normalisation des throws non-Error et l’ajout du contexte de requête pour l’observabilité (Gestion des erreurs en TypeScript).
Affinez les erreurs avant de les traiter
Les blocs catch non sécurisés sont encore courants :
try {
  await client.orders.create(input)
} catch (error) {
  logger.error(error.message)
}
Cela suppose trop de choses. error pourrait ne pas être un Error du tout.
Un pattern plus sûr :
try {
  await client.orders.create(input)
} catch (error: unknown) {
  if (error instanceof Error) {
    logger.error({ message: error.message, stack: error.stack })
    throw new OrderSyncError("Order sync failed", { cause: error })
  }

  logger.error({ error })
  throw new OrderSyncError("Order sync failed", { cause: new Error("Non-Error thrown") })
}
Cela semble un peu plus lourd. Mais cela résiste bien mieux en cas d'erreurs provenant de SDK tiers, d'un échec de parsing JSON ou d'exceptions inattendues.
Ne réessayez que si l'erreur est transitoire
La deuxième amélioration majeure est la classification des erreurs. Les directives pour les opérations TypeScript SDK et API convergent vers une règle simple : réessayez sur les échecs transitoires (erreurs réseau, réponses HTTP 429 et 503), validez tôt, préservez le contexte de l'erreur et ne réessayez pas sur les erreurs de règles métier. Ces mêmes recommandations préconisent aussi Promise.all pour un travail parallèl’en fail-fast et Promise.allSettled quand un succès partiel est acceptable (Modèles de gestion des erreurs SDK).
J’aime les regrouper en trois catégories :
- Erreurs de validation la requête était incorrecte avant même de quitter votre processus.
- Erreurs transitoires may succeed on retry with backoff.
- Erreurs permanentes reflètent les règles métier, les permissions ou les ressources manquantes et doivent être affichés directement.
Cette classification permet une meilleure gestion des erreurs code qu’un simple helper « retry on failure ».
Règle de champ : Les retries relèvent de l'incertitude du transport, pas d'un désaccord métier.
L'observabilité doit expliquer les échecs, pas seulement les enregistrer
Des logs sans contexte ne sont pas de l'observabilité. Pour API en TypeScript, associez un ID de corrélation, le nom de la route, les métadonnées de la requête et une structure d'erreur normalisée partout où une requête franchit une frontière.
Une bonne base :
- IDs de corrélation lier une requête entrante aux appels en aval
- Logs structurés stocker des champs, pas des blocs de texte
- Logs de frontière capturer les échecs de parsing séparément des exceptions métier
- Alertes clés basées sur la classe d’erreur et la route, pas seulement sur le volume code
Si vos applications mobiles ou clientes consomment ces API, l'observabilité des mises à jour compte aussi. Une option pratique dans la couche release est Capgo, qui fournit des API typées pour déployer et suivre les live updates dans les environnements Capacitor et Electron. C'est utile lorsqu'une correction de contrat côté client nécessite un déploiement progressif contrôlé et une visibilité par version, plutôt qu'une nouvelle attente aveugle sur les stores. Pour les équipes qui resserrent la boucle de feedback complète, ce guide sur l'observabilité des applications s'intègre bien au logging côté serveur.
Testez le contrat, pas seulement l'implémentation
Les tests unitaires seuls ne détectent pas la dérive. Ajoutez des tests là où la dérive se produit.
- Tests de validation aux frontières : Alimentez les schémas avec des entrées malformées et vérifiez la forme de l’échec.
- Tests de contrat : Vérifiez que les réponses HTTP réelles correspondent au contrat publié.
- Assertions d'erreurs typées : Vérifier que les échecs transitoires et permanents sont correctement normalisés.
- Tests d'intégration client : Vérifiez que les clients générés ou wrappés parsent les vraies réponses.
Une suite de tests robuste pour les API typées ne se contente pas de valider les chemins code. Elle prouve que votre contrat est toujours fiable.
Déployer en production avec confiance et contrôle
La qualité d'une release vient d'une boucle reproductible. Pas d'exploits héroïques.
Un API fiable dans un pipeline TypeScript repose généralement sur quelques essentiels : vérification des schémas en CI, contrôle des types sur les artefacts générés, revue des diffs de contrat avant le merge, et un chemin de déploiement capable de ralentir ou de rollback si une population de clients n'est pas prête.
La boucle de release qui tient la route
J'aime garder la checklist de production assez courte pour que les équipes la suivent :
- Échec de la CI en cas de dérive du contrat : Si OpenAPI change, les types et les clients générés doivent être mis à jour dans la même modification.
- Versionnez les contrats partagés de façon délibérée : Les packages DTO publics exigent une discipline de release, pas des refontes improvisées.
- Déployez par canal ou par cohorte : N'exposez pas tous vos consommateurs en même temps à un breaking change d'intégration.
- Gardez le rollback simple : Revenir à la version précédente du contrat, du client ou du bundle web doit être une opération banale.
Pour les équipes qui font évoluer leur infrastructure et leurs workflows de déploiement simultanément, ce guide sur les migration cloud pour les développeurs est une référence de planification utile, car la fiabilité de API se dégrade souvent pendant les transitions de plateforme, pas seulement lors des changements de code.
Le contrôle compte autant que la justesse
La dernière habitude de production, c'est la visibilité par version. Vous devez savoir quel build client appelle quel contrat, quelles releases ont été adoptées avec succès et où les échecs se concentrent après le déploiement. C'est particulièrement important pour les consommateurs mobiles et distribués sur l'edge qui ne se mettent pas tous à jour immédiatement.
Si votre stack inclut Capacitor ou Electron, l'outillage live update peut réduire le délai entre la correction d'un bug de contrat et sa mise à disposition aux utilisateurs. L'essentiel n'est pas d'avoir des « mises à jour plus rapides » dans l'abstrait. C'est d'avoir déploiement progressif par canal, protection contre le rollback et observabilité par version so contract fixes stay controlled.
Les API typées restent saines quand le schéma, la validation à l'exécution, la génération de clients et les opérations de release se renforcent mutuellement. Qu'une seule couche manque et les autres compensent mal.
Capgo offre aux équipes qui livrent des apps Capacitor et Electron un moyen typé de déployer des correctifs de bundle web, de contrôler les canaux de déploiement et de suivre l'adoption et les échecs par version. Si vos correctifs de contrat API doivent aussi atteindre les clients rapidement sans attendre la revue des stores, rendez-vous sur Capgo.





