

你的 TypeScript API 在发布当天看起来可能很完美。路由编译通过,前端导入了共享类型,编辑器给了每个人那种通常意味着“可以安全上线”的清爽绿色感觉。
然后后端修改了一个响应字段,一个没人预料到的地方出现了可空值,或者某个移动端客户端仍在调用旧版的数据结构。大多数 TypeScript 中的 API 故障就发生在这里。不是语法问题,而是漂移。
目录
- 为什么类型化 API 在上线后会失效,以及如何预防
- 以正确的方式搭建你的 TypeScript API 项目
- 设计 DTO 并在边界处验证输入
- 生成和使用完全类型化的 API 客户端
- 真正有用的错误处理、测试与可观测性
- 自信且可控地发布到生产环境
为什么类型化 API 在上线后会失效,以及如何预防
类型化 API 通常在常规发布期间就会出错。一个团队重命名了响应字段,另一个团队为部分迁移添加了可空分支。旧版客户端继续发送之前的 payload,因为移动端更新滞后于 Web 端。在更新了本地类型的每个仓库中,TypeScript 仍然能编译通过。但生产环境中的契约已经失效。
这种故障有一个名字:契约漂移。
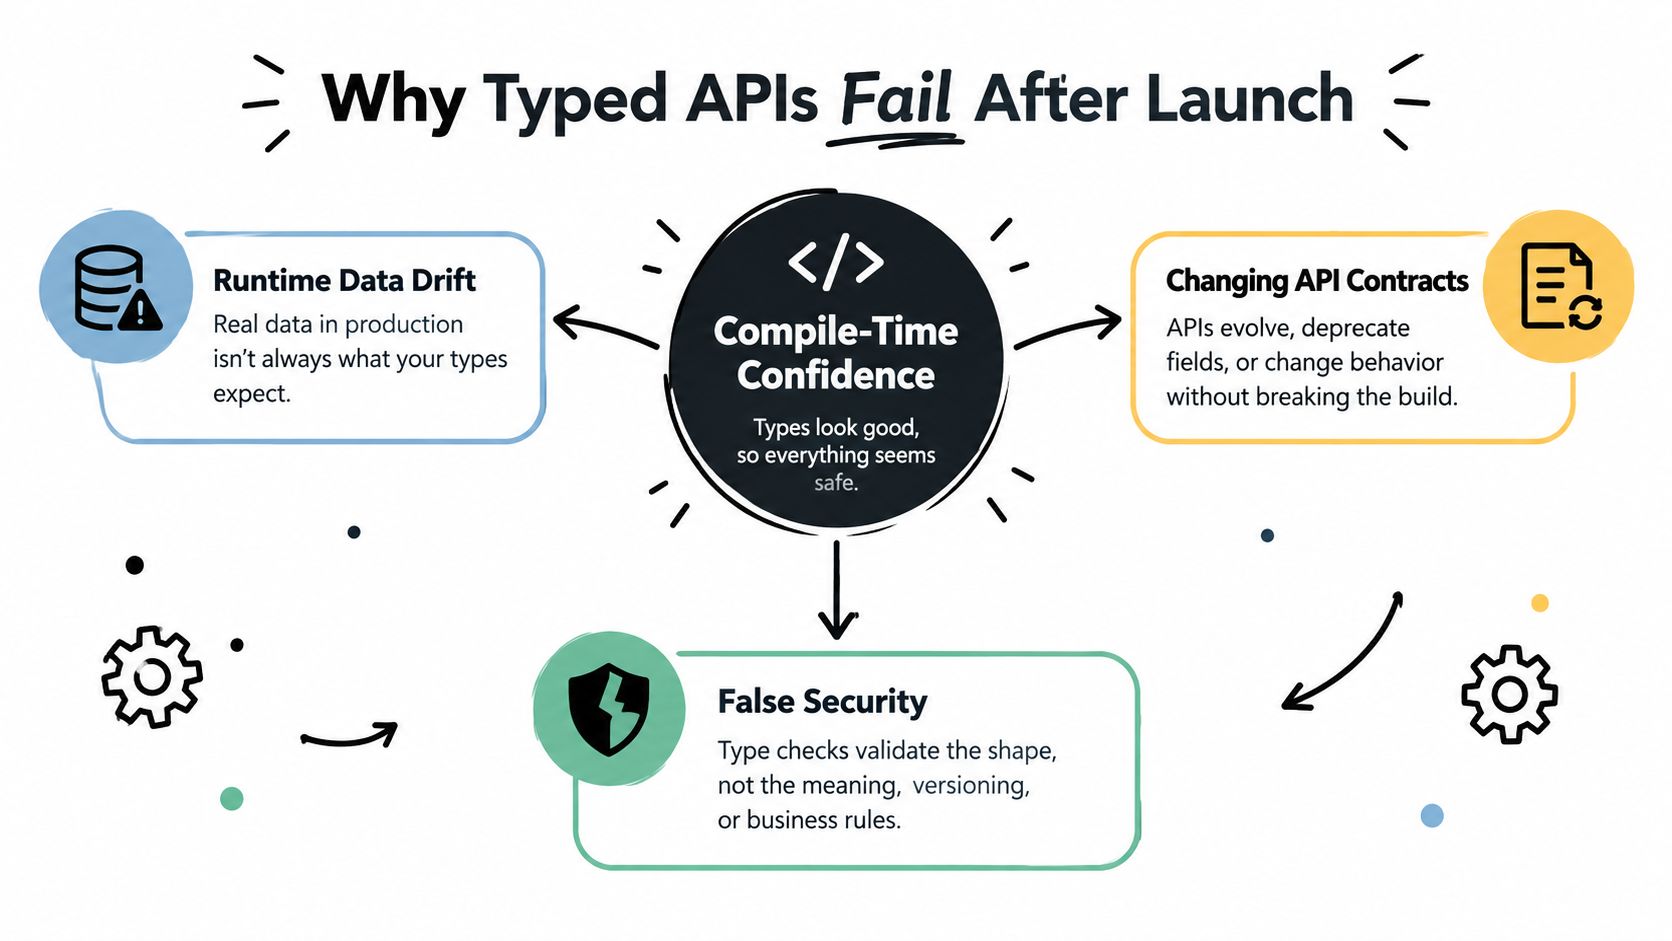
TypeScript 让 API 的开发体验更顺畅,但也让人更容易过度信任脆弱的契约。共享接口、路由泛型和类型化 fetch 封装在开发阶段很有帮助。但它们无法证明,在第二次或第十次发布后,网络传输的 JSON 仍然符合这些类型。
在生产环境中站得住脚的原则很简单。
如果未经验证的 JSON 能直接流入应用逻辑,那你的 TypeScript 类型描述的只是意图,而非现实。
解决之道与其说是巧妙的类型体操,不如说在于真相存放在哪里:
- 在边界处校验。 在 code 的其他部分接触它们之前,先解析请求体、参数、请求头,甚至下游服务的响应。
- 把 DTO 映射为领域模型。 让传输结构与业务对象保持分离,这样 API 的频繁变动就不会渗透到整个代码库。
- 从契约生成类型。 OpenAPI、JSON Schema 或 schema-first 框架能为客户端和服务端提供共享的单一事实来源。
- 把破坏性变更当作公开事件。 如果字段结构发生变化,要有意识地做版本控制,并像其他任何外部契约变更一样对外沟通。
DTO 映射是团队最常跳过的一环。一开始它显得多余。几个版本之后,它却成了防止你到处散播 string | null 以及遗留字段别名扩散到每个服务和前端页面的那一层。在边界处做一次小小的转换,比日后大范围重构成本更低。
类型化 API 也会失败,因为错误契约通常都是事后才补的。成功响应备受关注,失败响应却变成当天抛出的异常碰巧序列化成的样子。客户端随后基于这些从未被设计过的结构来构建重试逻辑、用户提示和监控。结果只是同一问题换了个形式:漂移。
版本管理同样需要这种纪律。团队很少因为一次大刀阔斧的重写而破坏客户端,而是因为一系列看似合理的局部变更累积成不兼容。一个清晰的 面向契约演进的 API 版本管理策略 让这些变更在影响调用方之前就可见。
目标不是到处都用 TypeScript,而是在上线后,当多次部署、多个客户端和真实生产数据开始冲击你第一天那套整齐的类型时,仍让契约保持真实。
以正确的方式搭建你的 TypeScript API 项目
一个类型化的 API 项目一开始通常看起来很整洁。六个月后,一个路由接受未校验的输入,另一个读取原始 process.env,第三个返回一个没有任何客户端针对它编写过的结构。脚手架很少会一下子崩掉,而是留出足够空间,让契约漂移混进日常功能开发。
从一个让契约难以被绕过的项目结构开始。
选择与团队结构相匹配的框架
对于 TypeScript 中的 API,首要的框架决策不在于语法,而在于契约纪律将落在何处。
- Express 适合希望抽象层最少且熟悉中间件模型的团队。它不干涉业务逻辑,这在每个路由各自定义验证、错误结构和响应约定之前很有用。
- Fastify 是中小型后端团队的强力默认选择。其插件系统简洁,并将 schema 工作推向路由层,有助于保持运行时行为与类型一致。
- Nest 适用于拥有众多贡献者、共享模块和明确所有权边界的大型代码库。代价是繁琐的仪式,如果服务本身很小,这种代价是实实在在的。
我通常避免购买团队用不到的框架。一个使用 Fastify、验证库和生成契约类型的小型服务,往往比在顶部叠加不一致约定的更重技术栈更能经受重构。
使用能守住边界的文件夹结构
文件夹名称不如 import 压力重要。如果路由能直接访问数据库模型,或服务层直接把 ORM 实体返回给客户端,脚手架就已经在纵容架构漂移了。
能在生产环境中站得住的结构,通常会把传输层关注点与应用层关注点分开:
src/routes仅用于 HTTP 接线src/schemas用于请求和响应 schemasrc/dto用于传输类型和 code 映射src/services用于用例和编排src/domain用于应比单个端点更持久的业务模型src/clients用于下游集成src/errors用于共享错误类型和类型收窄辅助函数src/config用于启动时的配置解析
那 src/dto 一层并非无用功。它让 API 有个地方吸收外部变化,而不会把这些变化泄漏进领域逻辑,也不会通过无关端点再漏出去。
配置也值得同样对待。在启动时解析一次环境变量,遇到无效值就快速失败,并把类型化的配置对象导出给应用的其他部分。那些一直 process.env 在处理器内部读取的团队,通常最终会出现 TypeScript 帮不上忙的分支繁多的运行时行为。这篇关于 环境配置 的指南,如果你需要标准化这种模式,会是不错的参考。
在添加新功能前先收紧编译器
生产环境的 API 应该让编写不安全的 code 变得很麻烦。
有用的默认值包括:
strict已启用useUnknownInCatchVariables已启用noUncheckedIndexedAccess如果团队能应对额外的规范要求,就启用- 除非 Node、测试、bundling 和工具链都能以相同方式解析,否则不要使用路径别名
- 分离
build,typecheck,并在 CI 中运行 lint 脚本
宽松的规则 tsconfig 会让偏差在不知不觉中累积。而严格的规则会在不一致变成生产行为之前,把它们变成可见的工作。
Lint 规则也有帮助,尤其是针对 any、floating promises 以及从公共契约模块中意外导出的规则。这些都不能替代运行时验证,但能减少契约错误可能隐藏的位置。
还有一个早期的脚手架选择很重要。决定你的 OpenAPI 规范从哪里来,并将该决策保持在路由层附近。有些团队从 code-first 模式生成。其他团队则先从规范生成服务器存根和类型。两种方法都可行。失败的做法是将规范视为次要产物,在首次发布后无人检查。
在初始脚手架之后,比较类型化契约在纯请求-响应服务之外的行为会有所帮助。 Streamkap Flink TypeScript 指南 对于处理流或事件密集型系统的团队很有用,在这些系统中,契约漂移会出现在更长的 pipeline 中,而不仅仅是在 HTTP 处理器中。
设计 DTO 并在边界处验证输入
类型化的 API 通常在第一天看起来是正确的。六个月后,bug 出现在边界处。移动客户端仍然发送旧字段。合作伙伴省略了前端假设始终存在的属性。重构在公共响应中暴露了内部 ORM 列。TypeScript 在代码库内部完成了它的工作。契约仍然漂移了。
这就是 DTO 设计的重要性所在。它不是为了美化请求体,而是为了确保首次发布后,公开类型依然保持准确可靠。
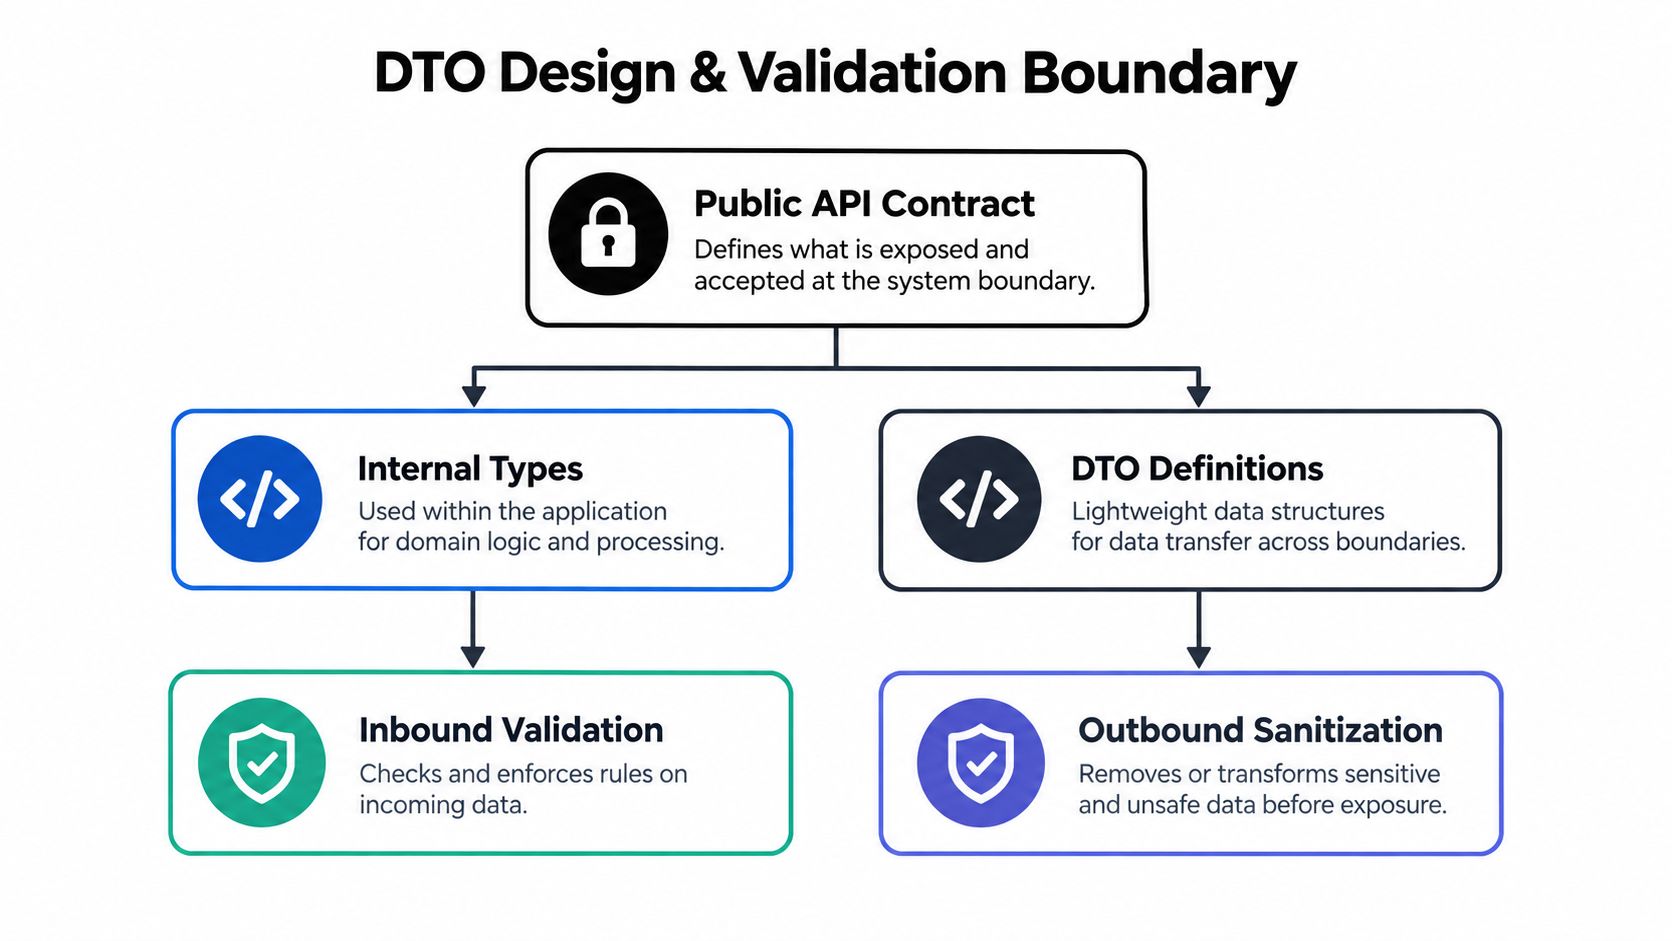
公共契约与内部模型不应相同
一套 DTO 描述了传输层的数据结构。而 领域模型 描述了应用执行核心业务所需的逻辑。将这两者混为一谈,初期虽能少写几行代码,后期却会引入高昂的耦合成本。
如果你的路由接收到这样的数据:
type CreateOrderRequestDto = {
  customerId: string
  items: Array<{ sku: string; quantity: number }>
  note?: string | null
}
你的服务层仍应接受更窄、更干净的结构,例如一个 OrderDraft ,其中包含规范化字符串、经过验证的数量,并在单一位置应用默认值。
边界层通常需要以下步骤:
- 解析传入的 payload
- 验证结构及字段级约束
- 将 DTO 映射为领域对象
- 在领域对象上执行业务逻辑
- 将结果映射到响应 DTO
- 在发送前校验出站响应
第六步经常被跳过。而它恰恰能捕获私有字段、泄漏到稳定响应里的可空值,以及重构时意外引入的 schema 变更。
在业务逻辑处理数据前进行校验
编译时类型无法校验来自网络的 JSON。它们也无法防止其他服务返回一个仍然满足类型定义的结构 unknown 并在运行时打破你的假设。
为了让 API 在 TypeScript 中生效,Zod 是常见选择,因为它在运行时解析,并为 code 的其余部分推断类型。Valibot、io-ts 等库也可以。比起用哪个库,更重要的是遵守规则:不可信数据必须先解析,再交给其他任何逻辑使用。
一个经得起重构的模式是这样的:
- 入站 Schema 拒绝格式错误的请求数据
- 依赖项 Schema 验证来自第三方 API 和内部服务的响应
- 出站 Schema 验证你的 API 即将发布的响应
这个中间层正是许多类型化 API 在上线后失效的地方。团队往往只验证请求,却跳过了对下游响应的验证,随后就会疑惑为什么供应商的一个字段重命名会导致生产事故。
我实际采用的规则是:原始 JSON 止步于路由层。
映射 code 并非浪费。正是在这里,漂移会变得可见。
团队常常抵触 DTO 映射,因为它看起来重复。但我在生产环境中看到的恰恰相反。一层薄薄的映射层,正是让契约变更变得清晰、可审查且局部化的地方。
例如:
- transport 允许
note?: string | null - 领域模型可能存储
note: string配合""作为默认值 - 响应 DTO 可能会省略
note当其为空时完全省略
这是面向三个不同受众的三种不同真相。将它们视为一个共享接口会掩盖差异,直到客户端出错。
Webhook 让这一点更加清晰,因为消费者可能会保留你的 payload 结构数年。如果你的团队正在解决该问题,这个 Webhook payload 设计示例 的文章也值得一读。
只有数据源明确时,共享类型才有用
将后端接口复制到前端是一种延迟的漂移。共享包可以提供帮助,但仅适用于有意公开的 type。
在大型代码库中更稳健的设置如下:
- 将公共请求和响应 schema 与持久化模型分开定义
- 从这些公共 schema 生成 OpenAPI,或先从 OpenAPI 生成服务端类型
- 让生成的契约类型靠近 handler 和 client
- 保持领域类型和 ORM 模型为内部使用
- 当兼容性重要时,有意识地版本化公共 DTO
这种分离也与 Azure SDK 团队的 TypeScript 设计指南保持一致,该指南强调稳定的公共接口,并将内部实现细节排除在契约之外。
可维护的边界看起来刻意平淡无奇
好的版本没那么“聪明”。
之前,前端信任 fetch().json() 如同真理一般,后端直接返回 ORM 对象,一个共享接口试图表示每一层。之后,每个边界都解析数据,DTO 保持精简,领域模型保持内部,生成的类型覆盖公共契约,映射 code 使变更显式化。
它增加了仪式感。同时,它也为你在调用方发现问题之前审查漂移提供了一个集中点。
生成和使用完全类型化的 API 客户端
类型化客户端在发布日往往看起来已经完美无缺。三个月后,一个端点开始返回可空字段,另一个添加了游标分页,而移动应用却固定了旧版本的契约。TypeScript 类型依然能编译通过,但调用方依然会出错。
这正是客户端层的职责所在。它应在首次发布后保持已发布契约的真实性,而不仅仅是让编辑器的自动补全看起来不错。
选择你的类型化客户端策略
客户端形态应与 API 的实际复杂度相匹配,而不是团队偏好。
| 方案 | 最佳适用场景 | 权衡 |
|---|---|---|
| 手写 fetch 封装 | 小型应用、非标准认证流程、快速迭代 | 上手快,但时间一长,各调用点容易碎片化 |
| OpenAPI code 生成 | schema 稳定、简单直接的 REST API | 基础扎实。但自定义认证、流式传输或特殊分页需要额外处理 |
| SDK 风格的类型化客户端 | 多团队平台、公共 API、长期集成的系统 | 维护成本最高。当 API 本身是产品时,能带来最佳的用户体验 |
手写客户端适用于小型接口
自定义 fetch 当 API 仅用于内部、接口范围较小,或者传输行为比 schema 生成更重要时,使用 wrapper 是合理的选择。我在管理工具和早期阶段的服务中仍会采用这种方式。
这种模式的失败点在于漂移(drift)。一个团队在 wrapper 中添加了重试规则,另一个团队绕过了它,第三个团队将响应类型复制到前端并放宽为 any ,在第一次不匹配之后。最终你会得到“类型化”的调用,但它们不再代表服务器实际返回的内容。
在满足以下条件时,使用手写客户端:
- API 很小且属于内部实现
- 契约变更频繁,重新生成 code 反而成了噪音
- 自定义传输行为占据了主要工作量
- 你愿意在客户端保留运行时解析,而不仅仅是 TypeScript 类型注解
最后一点很关键。 response.json() 运行时返回未知数据,即使函数签名并非如此。
OpenAPI 生成是务实的默认选择
对于稳定的 REST API,生成类型能在维护成本与安全性之间取得最佳平衡。它们省去大量重复的类型编写,并让契约变更在 pull request 中可见。
能经受重构的模式很简单。从公共契约生成,保持生成层精简,并在调用方需要更好易用性时加一个小包装器。 OpenAPI TypeScript 生成工作流 很好地契合该模型。
一种实用的拆分方式如下:
- 生成的 code 负责请求和响应结构
- 轻量的 SDK 包装器负责鉴权注入、重试和分页辅助工具
- 运行时校验仍发生在服务端边界,以及任何不可信输入重新进入系统的地方
- DTO 映射保持显式,避免内部模型变更泄漏到客户端契约中
这种混合方案让生成的 code 保持普通,这是好事。普通的 code 更容易重新生成、审查和替换。
在应用 code 使用它们之前,先封装生成的客户端
生成的函数通常太原始,不适合在整个代码库中广泛使用。它们会暴露传输细节,每个调用方都得重新学一遍。
一层薄封装让你能在一个地方保持策略一致:
- 附加默认请求头和请求 ID
- 统一错误结构
- 把分页暴露为迭代器或辅助方法
- 支持多租户场景下按请求覆盖鉴权
- 保留生成的请求和响应类型,而不是手动重写它们
例如,应用 code 应该调用 client.orders.listAll() 或 client.orders.list({ cursor }),而不是在每个调用点手动拼接查询字符串并解析分页元数据。
当 API 是一款产品时,采用 SDK 风格的客户端是合理的
公共 API 和共享平台服务需要的不仅仅是生成的端点函数。使用者期望命名一致、错误可预测,并且传输细节被隐藏在符合领域的方法背后。
良好的客户端体验通常如下:
client.orders.list()返回类型化的页面或异步迭代器client.files.stream()处理流式传输,而不将底层 fetch 配置泄露到每次调用中- 认证可全局设置,并支持按请求覆盖
- 调用者收到稳定的类型化错误对象,而非临时抛出的负载
这会增加维护成本。它还阻止每个使用团队以略有不同的方式重建相同的边界规则,而这正是契约漂移蔓延的方式。
完全类型化的客户端并非终点。真正的终点是:即使 API 不断演进,客户端的类型依然与现实保持一致。因为生成基于公开契约,运行时校验保护了边界,而 DTO 映射防止了内部变更向外泄露。
错误处理、测试与真正有用的可观测性
大多数 TypeScript API 示例都过于理想化。请求总是成功,JSON 完美匹配接口,失败情况则变成了 throw new Error("something went wrong")。生产环境可不会这么客气。
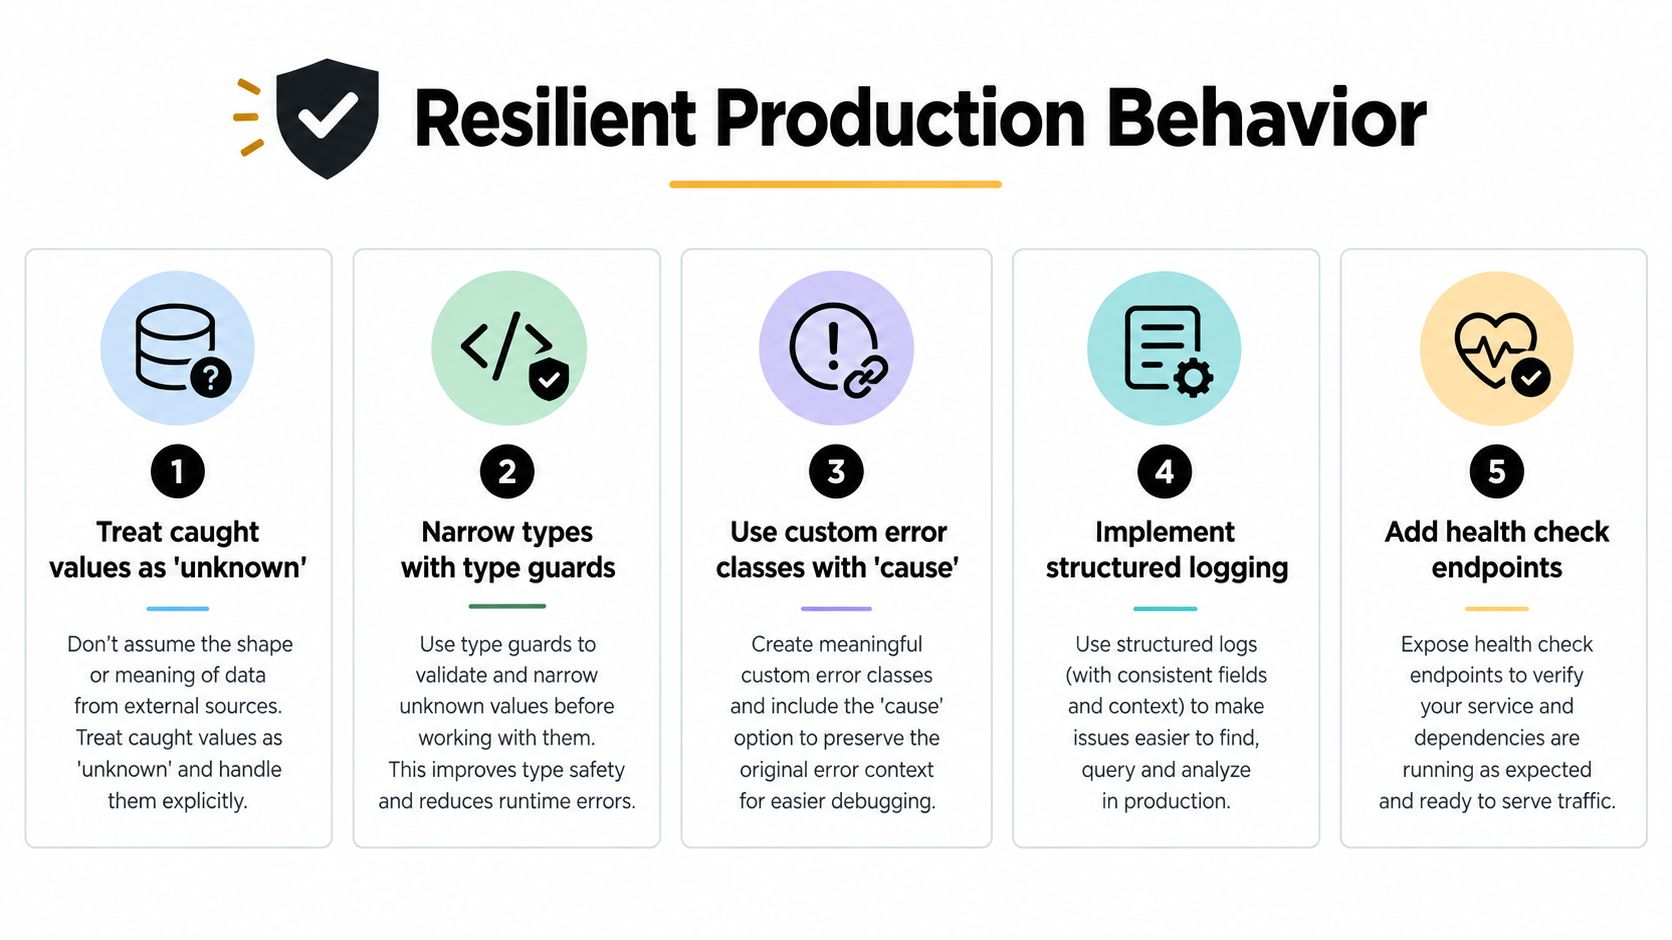
第一步修复是机械性的。在 TypeScript 中, 捕获到的值应被视为 unknown,然后在读取 message, stack或响应属性之前进行类型收窄。专家建议还包括使用自定义错误类,通过 cause保留原始失败信息,在边界处进行校验,规范化非 Error 类型的抛出,并附加请求上下文以增强可观测性(TypeScript 错误处理指南).
在处理错误前先进行类型收窄
不安全的 catch 块仍然很常见:
try {
  await client.orders.create(input)
} catch (error) {
  logger.error(error.message)
}
这个假设过于武断。 error 可能并不是一个 Error 。
更安全的模式:
try {
  await client.orders.create(input)
} catch (error: unknown) {
  if (error instanceof Error) {
    logger.error({ message: error.message, stack: error.stack })
    throw new OrderSyncError("Order sync failed", { cause: error })
  }

  logger.error({ error })
  throw new OrderSyncError("Order sync failed", { cause: new Error("Non-Error thrown") })
}
这看起来稍显繁琐。但当故障来自第三方 SDK、JSON 解析失败或意外抛出时,它的表现要稳健得多。
仅在错误是暂时性时重试
第二个重大改进是错误分类。关于 TypeScript SDK 和 API 操作的指南都趋向于一条清晰的规则: 重试暂时性故障(如网络错误或 HTTP 429 和 503 响应),尽早验证,保留错误上下文,并避免对业务规则失败进行重试。同样的指南还建议 Promise.all 用于快速失败的并行工作,以及 Promise.allSettled 当部分成功可接受时(SDK 错误处理模式).
我喜欢分三类:
- 验证错误 指请求在离开你的进程之前就是错误的。
- 暂时性错误 通过退避重试可能会成功。
- 永久性错误 反映业务规则、权限或资源缺失,应直接暴露。
这种分类能带来比通用“失败时重试”辅助函数更好的 code。
字段规则: 重试应针对传输层的不确定性,而非领域逻辑的分歧。
可观测性应解释故障,而不仅仅是记录它们
没有上下文的日志不算可观测性。对于 TypeScript 中的 API,在请求跨越任何边界时,都应附加关联 ID、路由名称、请求元数据和规范化的错误结构。
一个有用的基线:
- 关联 ID 把一次入站请求与下游调用关联起来
- 结构化日志 存储字段,而非大段文本
- 边界日志 将解析失败与业务异常分开捕获
- 告警 基于错误类型和路由设置告警,而不仅仅是 code 状态码
如果你的移动或客户端应用消费这些 API,可观测性同样重要。在发布层的一个实用选项是 Capgo,它提供类型化 API,用于在 Capacitor 和 Electron 环境中发布和跟踪 Live Update。当客户端契约修复需要受控发布和按版本可见性,而不是再次盲目等待应用商店审核时,这非常有用。对于希望收紧完整反馈循环的团队,这篇关于 App 可观测性 的指南与服务器端日志记录搭配使用效果很好。
测试契约,而不仅仅是实现
仅靠单元测试无法捕捉漂移。请在漂移发生的地方添加测试。
- 边界验证测试: 向 schema 输入格式错误的数据,并断言失败形状。
- 契约测试: 确认实际 HTTP 响应与已发布的契约匹配。
- 类型化错误断言: 验证瞬时故障和永久故障能否正确归一化。
- 客户端集成测试: 确保生成或包装后的客户端能解析真实响应。
一套针对类型化 API 的强大测试套件,不只是验证 code 路径,更是在证明你的契约仍然如实反映现实。
自信且可控地发布到生产环境
发布质量来自可重复的闭环,而不是靠英雄主义。
在 TypeScript pipeline 中,一个可靠的 API 通常包含几个关键要素:CI 中的 schema 检查、生成产物的类型检查、合并前的 contract diff 审查,以及在客户端群体尚未准备好时能够放慢或回滚的部署路径。
稳健的发布闭环
我喜欢把生产检查清单控制得足够短,让团队真的会照着做:
- 契约漂移时让 CI 失败: 如果 OpenAPI 发生变化,生成的类型和客户端必须在同一次变更中更新。
- 有意识地共享版本化契约: 公共 DTO 包需要严格的发布纪律,而非随意的重构。
- 按渠道或用户群逐步推出: 不要一次性向所有用户推送破坏性的集成变更。
- 让回滚保持简单: 回滚契约、客户端或 web bundle 的过程应当简单无感。
对于同时迁移基础设施和部署流程的团队,这份 开发者云迁移指南 是实用的规划参考,因为 API 的可靠性往往在平台过渡期间下降,而不仅仅是在 code 变更时。
控制力与正确性同等重要
最终的生产习惯是按版本进行可视化。你需要知道哪个客户端 build 调用了哪个契约,哪些 release 成功采纳,以及 rollout 后故障集中在哪里。对于并非立即更新的移动端和边缘分发消费者,这一点尤为重要。
如果你的技术栈包含 Capacitor 或 Electron,live update 工具可以缩短修复契约 bug 到用户收到修复之间的延迟。关键不在于抽象的“更快更新”,而在于拥有 基于 channel 的发布、回滚保护以及版本级可观测性 从而让 contract 修复保持可控。
只有当 schema、运行时校验、客户端生成和发布操作相互强化时,Typed API 才能保持健康。少了一层,其他层就会被迫糟糕地兜底。
Capgo 让发布 Capacitor 和 Electron 应用的团队能以类型化方式交付 web bundle 修复、控制 rollout channel,并按版本监控采用率和失败情况。如果你的 API contract 修复也需要快速触达客户端、无需等待应用商店审核,请访问 Capgo.





