

Il tuo API in TypeScript probabilmente sembrava solido il giorno del rilascio. Le route compilavano, il frontend importava i tipi condivisi e l'editor dava a tutti quella sensazione di verde pulito che di solito significa “pronto per la produzione”.
Poi il backend ha cambiato un campo della risposta, è comparso un valore nullable dove nessuno se lo aspettava, oppure un client mobile continuava a chiamare una struttura di payload più vecchia. È lì che la maggior parte API in TypeScript del lavoro si rompe. Non nella sintassi. Nel drift.
Indice dei contenuti
- Perché le API tipizzate falliscono dopo il lancio e come prevenirlo
- Come strutturare correttamente il tuo progetto API in TypeScript
- Progettare i DTO e validare l'input al confine
- Generare e consumare un client API completamente tipizzato
- Error Handling, Testing e Observability che aiutano davvero
- Pubblicare in produzione con sicurezza e controllo
Perché le API tipizzate falliscono dopo il lancio e come prevenirlo
Una API tipizzata di solito si rompe durante un normale rilascio. Un team rinomina un campo della risposta. Un altro aggiunge un ramo nullable per una migrazione parziale. Un client più vecchio continua a inviare il payload precedente perché gli aggiornamenti mobile sono in ritardo rispetto al web. TypeScript compila ancora in ogni repo che ha aggiornato i propri tipi locali. Il contratto in produzione è già falso.
Questa rottura ha un nome: contract drift.
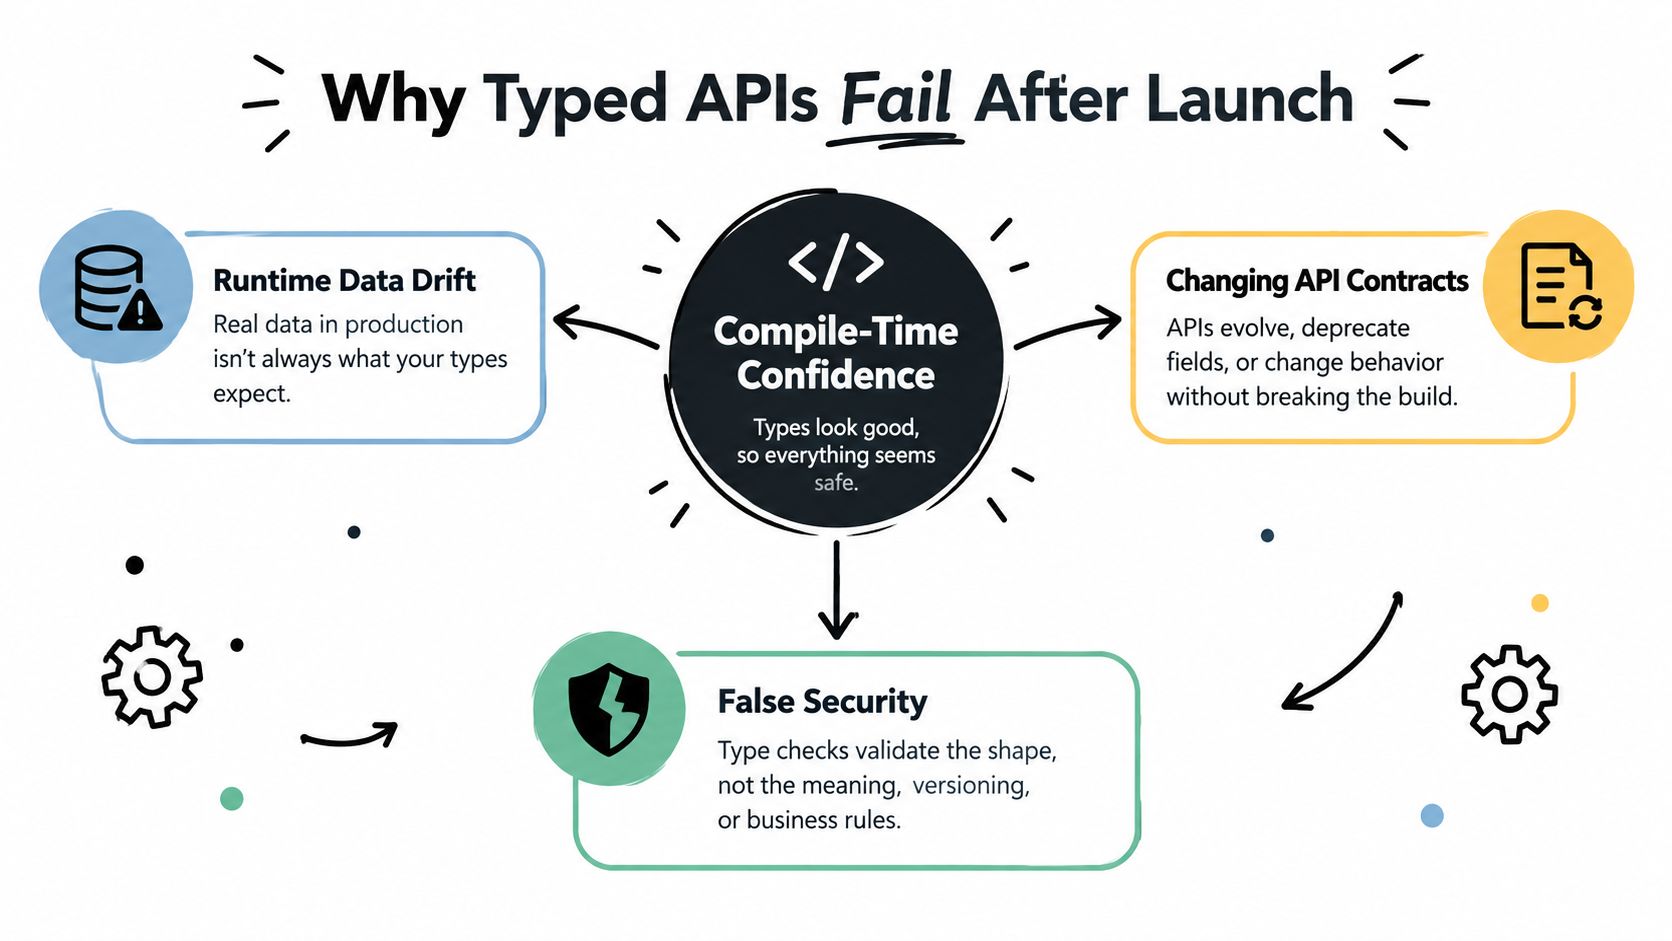
TypeScript ha reso il lavoro su API più piacevole, ma ha anche reso più facile fidarsi ciecamente di contratti deboli. Interfacce condivise, route generics e un wrapper tipizzato fetch aiutano durante lo sviluppo. Non dimostrano che il JSON che attraversa la rete corrisponda ancora a quei tipi dopo il secondo o il decimo rilascio.
La regola che regge in produzione è semplice.
Se un JSON non validato può finire direttamente nella logica applicativa, i tuoi tipi TypeScript descrivono l'intento, non la realtà.
La soluzione non sta tanto in acrobazie con i tipi, quanto in dove risiede la verità:
- Valida al confine. Analizza body, parametri, header e persino le risposte dei servizi a valle prima che il resto di code le tocchi.
- Mappa i DTO sui modelli di dominio. Tieni le strutture di trasporto separate dagli oggetti di business, così che i cambiamenti di API non si propaghino in tutto il codebase.
- Genera i tipi da un contratto. OpenAPI, JSON Schema o un framework schema-first danno a client e server un'unica fonte di verità condivisa.
- Tratta i breaking change come eventi pubblici. Se un campo cambia struttura, versionalo in modo esplicito e comunicalo come qualsiasi altra modifica a un contratto esterno.
Il mapping dei DTO è l'aspetto che i team saltano più spesso. All'inizio sembra ridondante. Dopo qualche release, diventa lo strato che ti salva dal diffondere string | null e alias di campi legacy in ogni servizio e schermata frontend. Un piccolo passaggio di traduzione al confine costa meno di un refactor esteso più avanti.
Le API tipizzate falliscono anche perché i contratti di errore sono spesso un ripensamento. I payload di successo ricevono attenzione. Quelli di fallimento diventano ciò che un'eccezione lanciata serializza in quel giorno. I client costruiscono logica di retry, messaggi per l'utente e monitoraggio su forme mai progettate. Il risultato è lo stesso problema in una forma diversa. Deriva.
Il versioning merita la stessa disciplina. I team raramente rompono i client con un singolo riscrittura drammatica. Li rompono con una serie di modifiche locali ragionevoli che sommate portano a incompatibilità. Un chiaro API strategia di versioning per contratti in evoluzione rende quelle modifiche visibili prima che raggiungano i consumatori.
L'obiettivo non è avere TypeScript ovunque. L'obiettivo è mantenere il contratto affidabile dopo il lancio, quando più deploy, più client e dati reali di produzione iniziano a mettere alla prova i tipi puliti che avevi il primo giorno.
Come strutturare correttamente il tuo progetto API in TypeScript
Un API tipizzato di solito sembra pulito il primo giorno. Sei mesi dopo, una rotta accetta input non controllati, un'altra legge dati grezzi process.env, e una terza restituisce una struttura per cui nessun client è stato programmato. Lo scaffolding raramente si rompe tutto in una volta. Crea abbastanza spazio perché il drift del contratto si insinui nel normale sviluppo delle feature.
Inizia con una struttura di progetto che renda difficile aggirare il contratto.
Scegli il framework adatto al tuo team
Per un API in TypeScript, la prima decisione sul framework riguarda meno la sintassi e più dove risiederà la disciplina del contratto.
- Express è adatto ai team che vogliono un'astrazione minima e conoscono già il modello middleware. Resta fuori dai piedi, il che è utile finché ogni rotta non inizia a inventarsi validazione, formato degli errori e convenzioni di risposta.
- Fastify è un'ottima scelta predefinita per team backend piccoli e medi. Il suo sistema di plugin è pulito e avvicina il lavoro sugli schemi al livello delle rotte, aiutando a mantenere il comportamento a runtime allineato ai tipi.
- Nest funziona bene per codebase più grandi con molti contributor, moduli condivisi e confini di ownership espliciti. Il costo è la cerimonia, e quel costo è reale se il servizio stesso è piccolo.
Di solito evito di comprare più framework di quanto il team userà. Un piccolo servizio con Fastify, una libreria di validazione e tipi di contratto generati spesso sopravvive meglio ai refactoring rispetto a uno stack più pesante con convenzioni incoerenti stratificate sopra.
Usa una struttura di cartelle che protegga i confini
I nomi delle cartelle contano meno della pressione degli import. Se le route possono raggiungere i modelli del database, o i servizi possono restituire entità ORM direttamente ai client, lo scaffold sta già invitando alla deriva.
Un layout che regge in produzione di solito separa le preoccupazioni di trasporto da quelle applicative:
src/routessolo per il wiring HTTPsrc/schemasper gli schemi di richiesta e rispostasrc/dtoper i tipi di trasporto e il mapping codesrc/servicesper i casi d'uso e l'orchestrazionesrc/domainper i modelli di business che devono sopravvivere a qualsiasi singolo endpointsrc/clientsper le integrazioni a vallesrc/errorsper tipi di errore condivisi e helper di narrowingsrc/configper l'analisi della configurazione al momento dell'avvio
Quello src/dto layer non è lavoro inutile. Dà a API un posto dove assorbire i cambiamenti esterni senza farli trapelare nella logica di dominio o farli uscire attraverso endpoint non correlati.
La configurazione merita lo stesso trattamento. Analizza le variabili d'ambiente una sola volta all'avvio, fallisci rapidamente sui valori non validi ed esporta un oggetto di configurazione tipizzato al resto dell'app. I team che continuano a leggere process.env dentro i handler finiscono di solito con un comportamento runtime ramificato che TypeScript non può correggere. Questa guida su la configurazione dell'ambiente è un buon riferimento se devi standardizzare quel pattern.
Rafforza il compilatore prima di aggiungere funzionalità
Un API in produzione dovrebbe rendere fastidioso scrivere code non sicuri.
I valori predefiniti utili includono:
strictabilitatouseUnknownInCatchVariablesabilitatonoUncheckedIndexedAccessabilitato se il team può gestire la disciplina aggiuntiva- Nessun alias di percorso a meno che Node, test, bundling e tooling non li risolvano tutti allo stesso modo
- Separa
build,typecheck, e gli script di lint in CI
Un tsconfig debole lascia che il drift si accumuli inosservato. Uno stretto trasforma i mismatch in lavoro visibile prima che diventino comportamento in produzione.
Le regole di linting aiutano anche, soprattutto quelle contro any, le promesse fluttuanti e gli export accidentali dai moduli del contratto pubblico. Nessuna di queste cose sostituisce la validazione a runtime, ma riduce i punti in cui gli errori di contratto possono nascondersi.
Un'altra scelta di scaffolding conta fin da subito. Decidi da dove provenga la tua specifica OpenAPI e mantieni quella decisione vicina al layer delle route. Alcuni team la generano da schemi code-first. Altri generano stub del server e tipi dalla specifica per primi. Entrambi gli approcci possono funzionare. Ciò che fallisce è trattare la specifica come un artefatto secondario che nessuno controlla dopo il primo rilascio.
Dopo lo scaffolding iniziale, è utile confrontare come si comportano i contratti tipizzati al di fuori dei servizi request-response puri. La guida Streamkap Flink TypeScript è utile per i team che lavorano con stream o sistemi ad alta densità di eventi, dove il drift dei contratti emerge in pipeline più lunghe, non solo negli handler HTTP.
Progettare i DTO e validare l'input al confine
Un API tipizzato di solito sembra corretto il primo giorno. Sei mesi dopo, i bug emergono al confine. Un client mobile invia ancora un campo vecchio. Un partner omette una proprietà che il tuo frontend dava per scontata. Un refactor espone una colonna ORM interna in una risposta pubblica. TypeScript ha fatto il suo lavoro all'interno del codebase. Il contratto è comunque deragliato.
Ecco perché la progettazione dei DTO conta. Non si tratta di rendere ordinati i corpi delle richieste. Si tratta di mantenere onesti i tipi pubblici dopo il primo rilascio.
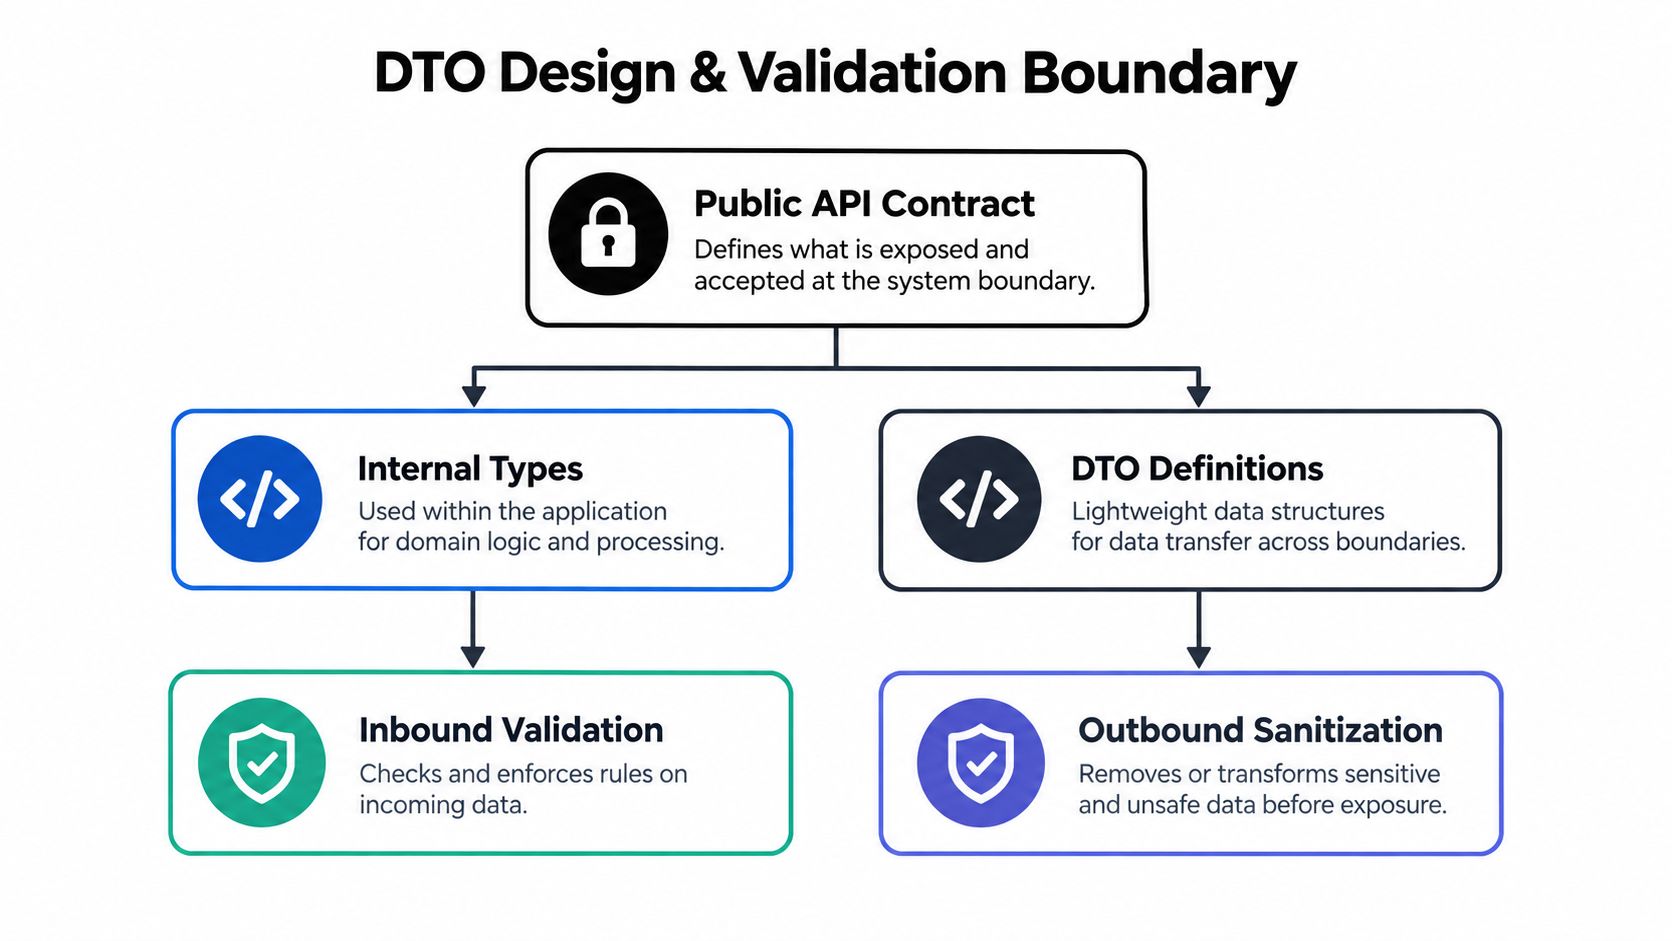
I contratti pubblici e i modelli interni non dovrebbero coincidere
Un DTO descrive ciò che attraversa la rete. Un modello di dominio descrive ciò che l'applicazione deve fare per svolgere il lavoro reale. Unire queste responsabilità fa risparmiare poche righe all'inizio, ma crea un accoppiamento costoso in seguito.
Se la tua route riceve questo:
type CreateOrderRequestDto = {
  customerId: string
  items: Array<{ sku: string; quantity: number }>
  note?: string | null
}
il tuo layer di servizio dovrebbe comunque accettare qualcosa di più stretto e pulito, come un OrderDraft con stringhe normalizzate, quantità validate e valori predefiniti applicati in un unico punto.
Il confine di solito richiede questi passaggi:
- Parsa il payload in ingresso
- Valida la forma e i vincoli a livello di campo
- Mappa il DTO a un oggetto di dominio
- Esegui la logica di business sull'oggetto di dominio
- Mappa il risultato a un DTO di risposta
- Valida la risposta in uscita prima di inviarla
Il passo sei viene spesso saltato. È anche quello che cattura i campi privati, i valori nullable che sono trapelati in una risposta stabile e i cambiamenti accidentali dello schema durante i refactoring.
Valida prima che la logica di business tocchi i dati
I tipi a compile-time non validano il JSON dalla rete. Non ti proteggono nemmeno da un altro servizio che restituisce una forma che soddisfa ancora unknown e rompe le tue assunzioni a runtime.
Per il lavoro con API in TypeScript, Zod è una scelta comune perché fa il parsing a runtime e inferisce i tipi per il resto del code. Valibot, io-ts e librerie simili possono funzionare altrettanto bene. La libreria conta meno della regola. I dati non fidati vengono analizzati prima che qualsiasi altra cosa li utilizzi.
Un pattern che resiste ai refactoring è questo:
- Schemi in ingresso rifiutano i dati di richiesta malformati
- Schemi delle dipendenze validano le risposte da API di terze parti e servizi interni
- Schemi in uscita verifica la risposta che API sta per pubblicare
È proprio in questo livello intermedio che molte API tipizzate falliscono dopo il lancio. I team validano le richieste, saltano la validazione sulle risposte a valle e poi si chiedono perché un semplice cambio di nome di un campo da parte di un vendor si trasformi in un incidente di produzione.
Ecco la regola pratica che uso. Il JSON grezzo si ferma al livello delle route.
Mappare code non è uno spreco. È lì che la deriva diventa visibile
I team spesso resistono al mapping dei DTO perché sembra ripetitivo. In produzione ho visto l'opposto. Un sottile livello di mapping è il luogo in cui i cambiamenti di contratto diventano evidenti, revisionabili e localizzati.
Per esempio:
- il trasporto consente
note?: string | null - il modello di dominio può memorizzare
note: stringcon""come valore predefinito - il DTO di risposta può omettere
notecompletamente quando è vuoto
Sono tre verità diverse per tre pubblici diversi. Trattarle come un'interfaccia condivisa nasconde le differenze finché un client non si rompe.
Un webhook rende tutto ancora più chiaro, perché i consumer potrebbero mantenere la struttura del payload per anni. Se il tuo team sta affrontando questo problema, questo esempio di design del payload webhook è un compagno utile.
I tipi condivisi aiutano solo quando la source of truth è esplicita
Copiare le interfacce del backend nel frontend è drift con un ritardo temporale. I pacchetti condivisi possono aiutare, ma solo per tipi intenzionalmente pubblici.
Un setup che regge meglio in codebase più grandi è questo:
- definire gli schemi pubblici di richiesta e risposta separatamente dai modelli di persistenza
- generare OpenAPI da quegli schemi pubblici, o generare i tipi del server da OpenAPI prima
- tenere i tipi di contratto generati vicini a handler e client
- tenere i tipi di dominio e i modelli ORM interni
- versiona i DTO pubblici deliberatamente quando la compatibilità conta
Questa separazione è anche coerente con le linee guida di progettazione TypeScript del team Azure SDK, che sottolineano superfici pubbliche stabili e l'esclusione dei dettagli di implementazione interna dal contratto.
Un confine mantenibile sembra noioso apposta
La buona versione è meno ingegnosa.
Prima, il frontend si fida di fetch().json() come se fosse verità, il backend restituisce direttamente oggetti ORM e un'unica interfaccia condivisa cerca di rappresentare ogni layer. Dopo, ogni confine analizza i dati, i DTO restano stretti, i modelli di dominio restano interni, i tipi generati coprono il contratto pubblico e il mapping code rende i cambiamenti espliciti.
Aggiunge cerimonie. Ma ti dà anche un unico punto per rivedere le deviazioni prima che i chiamanti le trovino per te.
Generare e consumare un client API completamente tipizzato
Un client tipizzato spesso sembra finito il giorno del rilascio. Tre mesi dopo, un endpoint inizia a restituire un campo nullable, un altro aggiunge la paginazione a cursore e un'app mobile fissa una versione più vecchia del contratto. I tipi TypeScript compilano ancora. I chiamanti si rompono comunque.
Questo è il lavoro del layer client. Dovrebbe mantenere il contratto pubblicato veritiero dopo il primo rilascio, non solo far sembrare bella l'autocompletazione dell'editor.
Scegliere la strategia del client tipizzato
La forma del client deve riflettere la complessità reale dell'API, non le preferenze del team.
| Approccio | Ideale per | Compromesso |
|---|---|---|
| Wrapper fetch scritto a mano | App piccole, flussi di auth insoliti, iterazione rapida | Partenza veloce. Rischio di frammentazione tra i callsite nel tempo |
| Generazione code da OpenAPI | API REST semplici con schemi stabili | Base solida. Serve aiuto per auth custom, streaming o paginazione insolita |
| Client tipizzato in stile SDK | Piattaforme multi-team, API pubbliche, integrazioni a lungo termine | Costo di manutenzione più alto. La migliore esperienza utente quando API è un prodotto |
I client hand-rolled funzionano per superfici piccole
Un fetch wrapper custom è una scelta ragionevole quando API è interno, la superficie è piccola o il comportamento di trasporto conta più della generazione dello schema. Uso ancora questo approccio per tool di amministrazione e servizi in fase iniziale.
La modalità di fallimento è il drift. Un team aggiunge una regola di retry nel wrapper. Un altro la bypassa. Un terzo copia un tipo di risposta nel frontend e lo estende a any dopo il primo mismatch. Ti ritrovi con chiamate "tipizzate" che non rappresentano più ciò che restituisce il server.
Usa un client scritto a mano quando valgono queste condizioni:
- la API è piccola e interna
- il contratto cambia così spesso che rigenerare code diventa solo rumore
- il comportamento di trasporto custom domina il lavoro
- sei disposto a mantenere il parsing a runtime nel client, non solo le annotazioni TypeScript
Quest'ultimo punto conta. response.json() restituisce dati unknown a runtime, anche se la firma della funzione dice il contrario.
La generazione OpenAPI è il default pratico
Per API REST stabili, i tipi generati offrono il miglior rapporto tra manutenzione e sicurezza. Eliminano gran parte della scrittura duplicata di tipi e rendono visibili i cambiamenti al contratto nelle pull request.
Il pattern che resiste ai refactor è semplice. Genera dal contratto pubblico, mantieni sottile lo strato generato e aggiungi un piccolo wrapper dove i consumatori hanno bisogno di un'ergonomia migliore. Il Workflow di generazione TypeScript da OpenAPI si adatta bene a quel modello.
Una suddivisione utile è la seguente:
- il code generato gestisce le forme di richiesta e risposta
- un sottile wrapper SDK gestisce l'iniezione dell'auth, i retry e i helper per la paginazione
- la validazione a runtime avviene comunque al confine del server e ovunque l'input non fidato rientri nel sistema
- il mapping dei DTO resta esplicito, così i cambiamenti del modello interno non finiscono nel contratto del client
Questo approccio ibrido mantiene noioso il code generato, il che è un bene. Un code noioso è più facile da rigenerare, rivedere e sostituire.
Wrappa i client generati prima che il code dell'applicazione li usi
Le funzioni generate sono di solito troppo grezze per un uso ampio in un codebase. Espongono dettagli di trasporto che ogni caller deve poi riimparare.
Un wrapper sottile ti dà un unico punto in cui mantenere coerente la policy:
- aggiungi header predefiniti e request ID
- normalizza la forma degli errori
- esponi la paginazione come iterator o metodo helper
- supporta override dell'auth per singola richiesta nei casi multi-tenant
- preserva i tipi generati di request e response invece di riscriverli a mano
Ad esempio, il code dell'applicazione dovrebbe chiamare client.orders.listAll() oppure client.orders.list({ cursor }), senza assemblare manualmente le query string e analizzare i metadati di paginazione in ogni punto di chiamata.
I client in stile SDK hanno senso quando l'API è un prodotto
Le API pubbliche e i servizi di piattaforma condivisi richiedono più delle semplici funzioni generate per gli endpoint. I consumatori si aspettano coerenza nella denominazione, errori prevedibili e dettagli di trasporto nascosti dietro metodi che riflettono il dominio.
Una buona ergonomia del client di solito è così:
client.orders.list()ritorna una pagina tipizzata o un iteratore asincronoclient.files.stream()gestisce lo streaming senza esporre la configurazione low-level di fetch in ogni chiamata- l'auth può essere impostata globalmente e sovrascritta per singola richiesta
- chi chiama riceve oggetti errore tipizzati e stabili invece di payload lanciati ad hoc
Questo aumenta i costi di manutenzione. Inoltre, impedisce a ogni team di riscrivere le stesse regole di confine in modo leggermente diverso, evitando così la diffusione del contract drift.
Un client completamente tipizzato non è il traguardo. Il traguardo è un client i cui tipi corrispondono ancora alla realtà dopo l'evoluzione di API, perché la generazione parte dal contratto pubblico, la validazione a runtime protegge il confine e il mapping dei DTO impedisce che i cambiamenti interni trapelino all'esterno.
Error Handling, Testing e Observability che aiutano davvero
La maggior parte degli esempi di API in TypeScript sono troppo tranquilli. Le richieste hanno successo, il JSON corrisponde all'interfaccia e i fallimenti diventano throw new Error("something went wrong"). In produzione non va mai così bene.
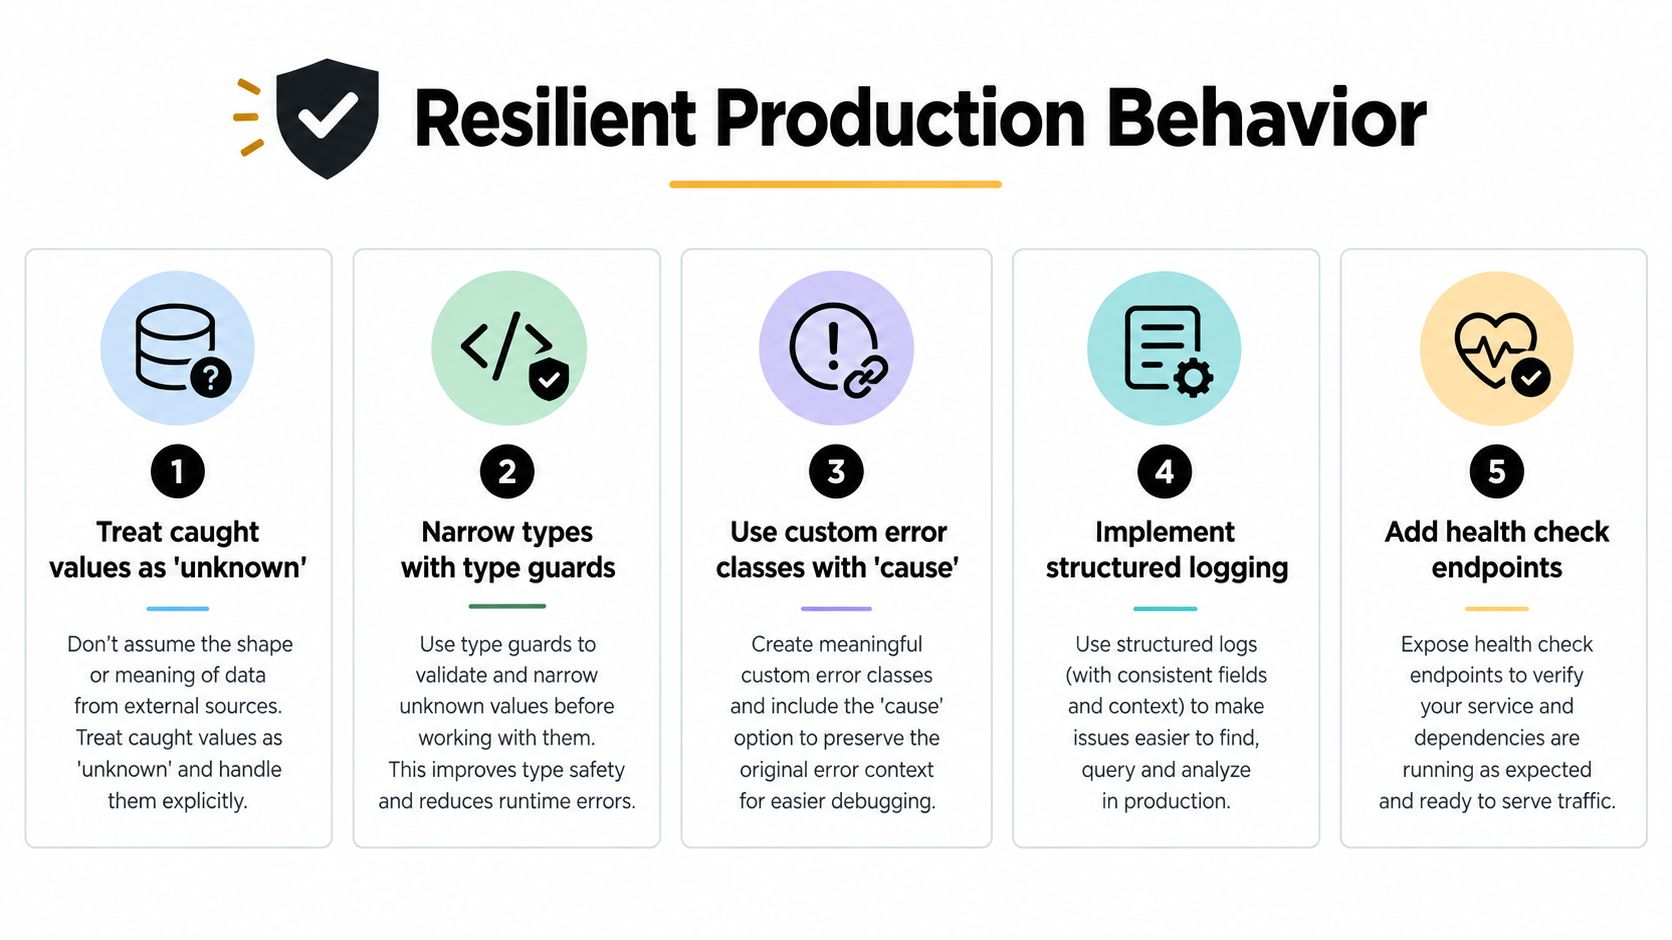
La prima soluzione è meccanica. In TypeScript, i valori catturati dovrebbero essere trattati come unknown, per poi essere ristretti prima di leggere message, stack, o le proprietà della risposta. Le best practice consigliano anche classi di errore custom, preservando il fallimento originale con cause, validando ai confini, normalizzando i throw non-Error e allegando il contesto della richiesta per l'osservabilità (Gestione degli errori in TypeScript).
Riduci gli errori prima di gestirli
I blocchi catch non sicuri sono ancora comuni:
try {
  await client.orders.create(input)
} catch (error) {
  logger.error(error.message)
}
È un'assunzione troppo ampia. error potrebbe non essere un Error affatto.
Un pattern più sicuro:
try {
  await client.orders.create(input)
} catch (error: unknown) {
  if (error instanceof Error) {
    logger.error({ message: error.message, stack: error.stack })
    throw new OrderSyncError("Order sync failed", { cause: error })
  }

  logger.error({ error })
  throw new OrderSyncError("Order sync failed", { cause: new Error("Non-Error thrown") })
}
Sembra leggermente più pesante. Ma regge molto meglio quando i fallimenti provengono da SDK di terze parti, parsing JSON fallito o throw inaspettati.
Riprova solo se l'errore è transitorio
Il secondo grande miglioramento è la classificazione degli errori. Le linee guida per le operazioni TypeScript SDK e API convergono su una regola chiara: riprova i fallimenti transitori come errori di rete o risposte HTTP 429 e 503, valida in anticipo, conserva il contesto dell'errore ed evita i retry per i fallimenti delle regole di business. Le stesse linee guida raccomandano anche Promise.all per il lavoro parallelo fail-fast e Promise.allSettled quando il successo parziale è accettabile (pattern di gestione degli errori SDK).
Mi piacciono tre categorie:
- Errori di validazione significano che la richiesta era errata prima ancora di lasciare il tuo processo.
- Errori transitori possono riuscire al retry con backoff.
- Errori permanenti riflettono regole di business, permessi o risorse mancanti e devono essere mostrati direttamente.
Questa classificazione guida un code migliore rispetto a un generico helper “retry on failure”.
Regola pratica: I retry appartengono all'incertezza del trasporto, non al disaccordo di dominio.
L'osservabilità deve spiegare i fallimenti, non solo registrarli
Log senza contesto non sono osservabilità. Per API in TypeScript, allega un correlation ID, il nome della route, i metadati della richiesta e una forma di errore normalizzata ovunque una richiesta attraversi un confine.
Una baseline utile:
- Correlation ID collegano una richiesta in ingresso alle chiamate a valle
- Log strutturati archivia campi, non blocchi di testo
- Log di confine registra i fallimenti di parsing separatamente dalle eccezioni di business
- Alerting basato su classe di errore e route, non solo sul volume di status code
Se le tue applicazioni mobili o client consumano queste API, anche l'aggiornamento dell'osservabilità è importante. Un'opzione pratica nel layer di rilascio è Capgo, che fornisce API tipizzate per spedire e tracciare live update in ambienti Capacitor ed Electron. È utile quando una correzione del contratto lato client richiede un rollout controllato e visibilità per versione, invece di un'altra attesa cieca dell'app store. Per i team che stringono il loop di feedback completo, questa guida su osservabilità delle app si integra bene con il logging lato server.
Testa il contratto, non solo l'implementazione
I soli unit test non cattureranno la deriva. Aggiungi test dove la deriva avviene.
- Test di validazione dei confini: Alimenta input malformati negli schemi e verifica la forma del fallimento.
- Test di contratto: Conferma che le risposte HTTP effettive corrispondano al contratto pubblicato.
- Assert di errori tipizzati: Verifica che i fallimenti transitori e permanenti vengano normalizzati correttamente.
- Test di integrazione client: Assicurati che i client generati o avvolti analizzino le risposte reali.
Una suite di test robusta per API tipizzate non dimostra solo i percorsi code. Dimostra che il tuo contratto sta ancora dicendo la verità.
Pubblicare in produzione con fiducia e controllo
La qualità del rilascio nasce da un ciclo ripetibile. Non da eroismi.
Una pipeline TypeScript affidabile per API di solito ha alcuni elementi essenziali: controlli di schema in CI, type check sugli artefatti generati, revisione del diff dei contratti prima del merge e un percorso di deployment che può rallentare o fare rollback quando la popolazione di client non è pronta.
Il ciclo di release che regge
Preferisco tenere la checklist di produzione abbastanza breve da essere seguita dai team:
- Fai fallire la CI sul drift dei contratti: Se OpenAPI cambia, i tipi e i client generati devono aggiornarsi nella stessa modifica.
- Versiona i contratti condivisi con criterio: I pacchetti DTO pubblici richiedono disciplina di release, non refactoring improvvisati.
- Rilascia per canale o coorte: Non esporre tutti i consumer a un breaking change dell'integrazione in una volta sola.
- Mantieni il rollback semplice: Fare rollback di contratto, client o web bundle dovrebbe essere noioso a livello operativo.
Per i team che spostano infrastruttura e workflow di deployment allo stesso tempo, questa guida a migrazione cloud per sviluppatori è un riferimento utile per la pianificazione, perché l'affidabilità di API spesso cala durante le transizioni di piattaforma, non solo durante i cambiamenti di code.
Il controllo conta quanto la correttezza
L'abitudine finale in produzione è la visibilità per versione. Devi sapere quale build del client sta chiamando quale contratto, quali release sono state adottate con successo e dove si concentrano i fallimenti dopo il rollout. Questo è particolarmente importante per i consumer mobile e edge-distributed che non si aggiornano tutti immediatamente.
Se il tuo stack include Capacitor o Electron, il tooling di live update può ridurre il ritardo tra la correzione di un bug nel contratto e la consegna della fix agli utenti. La parte importante non è "aggiornamenti più veloci" in astratto. È avere rollout basato su canali, protezione dal rollback e osservabilità a livello di versione so contract fixes stay controlled.
Le API tipizzate restano sane quando schema, validazione runtime, generazione client e operazioni di release si rafforzano a vicenda. Se ne manca uno, gli altri finiscono per compensare male.
Capgo offre ai team che pubblicano app Capacitor ed Electron un modo tipizzato per consegnare fix dei web bundle, controllare i canali di rollout e monitorare adozione e fallimenti per versione. Se le tue correzioni di contratto API devono anche raggiungere i client rapidamente senza aspettare la revisione dello store, visita Capgo.





