
Um 2 Uhr morgens sendet ein mobiler Lead einen Remote-Fix, nachdem ein Capacitor-Rückgang die Kasse auf Android unterbrochen hat. Bis zum Morgen stapeln sich die Support-Tickets, aber niemand kann bestätigen, welche installierten Versionen den JavaScript-Paket erhalten haben, welche Cohorts den gebrochenen Weg ausgeführt haben oder ob eine stille Wiederholung die Fehlfunktion verdeckt.
Dass diese Situation die Zweckmäßigkeit von app-Verhaltens-Trackingerflicht, ist nicht nur ein Wachstumsdashboard oder ein Datenschutzdebatt. Für Teams, die Capacitor- und Electron-Anwendungen in fragmentierten Geräteflotten bereitstellen, ist das Tracking ein Ingenieursystem zur Rekonstruktion von Verhalten, zur Validierung von Releases, zur Detektion von Rückschritten und zur Beweisführung, dass die Sammlung kontrolliert bleibt. Die Implementierungsdetails zählen, von Ereignisschemata und dauerhaften Warteschlangen bis hin zu Sampling-Regeln, regionalen Speicherung und Notfallwiederherstellung.
Inhaltsübersicht
- Warum App-Verhaltens-Tracking in 2026 wichtig ist
- Was App-Verhaltens-Tracking tatsächlich bedeutet
- Im Vergleich der Haupt-Tracking-Ansätze
- Architektur und Ereignisschemata für mobile und Desktop-Anwendungen
- Abtastung und Leistungstransaktionen
- Datenschutz und Compliance als Gestaltungsbeschränkung
- Metriken, Dashboards und Warnungen, die wirklich helfen
- Best Practices und ein Notfallwiederherstellungscheckliste
Weshalb App-Verhaltensüberwachung in 2026 wichtig ist
Ein Fehlerbericht könnte Ihnen sagen, dass der Checkout fehlgeschlagen ist. Er wird Ihnen jedoch nicht sagen, ob der Fehler von einem veralteten Web-Bundle, einer nativen Plugin-Grenze, einem bestimmten Renderer-Prozess oder einem Wiederholungsloop stammte, der schließlich erfolgreich war. Ohne Verhaltenskontext muss das Team die Support-Tickets, die Release-Protokolle und die Teile der Server-Evidenz manuell korrelieren.
Die erste nützliche Frage nach einer OTA-Veröffentlichung ist oft einfach: Erhielten und ausführten die beabsichtigten Benutzer die Aktualisierung? Um diese Frage zu beantworten, benötigt man mehr als eine Versionsnummer. Man benötigt die installierte native Shell, die aktive JavaScript-Bundle, den Update-Kanal, das Startergebnis, die Geräteplattform und bedeutende Geschäftsereignisse im betroffenen Fluss. Ein erfolgreicher Download beweist nicht, dass die Aktivierung erfolgreich war, und eine aktiviertes Bundle beweist nicht, dass der Benutzer die reparierte Seite erreicht hat.
Praktische Regel: Track release state and user outcome as separate event families. Combining them into one “update success” event makes rollback analysis unreliable.
Capacitor App-Beobachtung passt sich in die Produktionspraxis an. Ein nützlicher Pipeline verbindet die Release-Operationen mit der Laufzeitverhalten, so dass ein Ingenieur von 'Checkout-Berichte erhöht' zu einem begrenzten Query mit App-Version, Bundle-Version, Plattform, Kanal und Ereignissequenz übergehen kann.
Die Privatsphäreseinschränkung ist unzertrennlich von diesem Design. Apples App-Tracking-Transparenz-Framework, das 2021 eingeführt wurde, änderte die Kreuz-App-Tracking von implizitem Opt-out zu explizitem Opt-in.Ein 2025 durchgeführter Analyse fand heraus, dass der Anteil von Apple-Nutzern, der von Werbetreibenden in den Vereinigten Staaten verfolgt werden kann, von 72,63% vor ATT bis 17,9% danach17,9 % danach fiel , ein Rückgang von (9to5Mac-Analyse der ATT-Update.Das ändert zwar nicht die Produkttelemetrie von Capgo, aber es beeinflusst die Identifizierungsstrategie, den Zustand der Zustimmung und die Grenzen der Attribution als architektonische Entscheidungen.
Was App-Verhaltens-Tracking tatsächlich bedeutet
What App-Verhaltens-Tracking tatsächlich bedeutet Treat App-Verhaltens-Tracking wie ein . It captures what the application did, in which order, and under what conditions, so you can reconstruct a session after the fact instead of guessing from a crash stack.
Die Beschriftung umfasst mehrere Systeme, die unterschiedliche Fragen beantworten.
Event-Tracking registriert einzelne Fakten
Ein Ereignis ist ein benannter, strukturierter Vorgang wie checkout_started, payment_submitted, screen_viewed, oder bundle_activated. Ein gut konzipiertes Ereignis enthält Kontext, einschließlich der App-Version, der Plattform, der Sitzungs-ID und des relevanten Feature-Zustands. Es sollte etwas beschreiben, das passiert ist, und nicht ein gesamtes Objekt aus dem Speicher wiederherstellen.
Event-Tracking ist hervorragend für Funnels, Release-Verifizierung und operative Abfragen geeignet. Es verpasst jedoch visuelle Ambiguität. Wenn ein Benutzer auf einen Kontrollpunkt klickt, der aussehen mag, als sei er aktiv, aber keine Handler hat, kann ein Ereignis die vorherige Bildschirmansicht anzeigen, ohne die Benutzeroberflächenschwierigkeit zu erklären.
Session Replay bewahrt Interaktionskontext
Session Replay erfasst eine visuelle und Interaktionsströmung, oft durch DOM- oder Ansichtsbaum-Snapshots, Gesten und Navigationszustand. Es kann verdecktes Text, verwirrendes Fokusverhalten oder wiederholte Tasten aufdecken, die strukturierte Ereignisse nie darstellen.
Der Gegensatz ist die Exposition. Die Replay-Daten können sensitiveren Kontext enthalten als ein sorgfältig konzipiertes Ereignis, insbesondere wenn freier Text, Kontenansichten oder Zahlungsflüsse nicht richtig maskiert werden. Es hängt auch von einer zuverlässigen Aufzeichnung und Darstellung ab, daher sollte es nicht der einzige Aufzeichnung eines Geschäftskritischen Ereignisses sein.
Analytik wandelt Ereignisse in Entscheidungen um
Analytik-Systeme aggregieren Ereignisse in Funnels, Cohorts, Pfade und Retentions-Ansichten. Sie beantworten Fragen wie, wo Benutzer einen Workflow verlassen oder ob eine Release die Adoption von Features ändert.
Analytik ist eine nachträgliche Interpretation, nicht eine Instrumentierung. Wenn sich die Ereignisnamen zwischen Mobilgeräten und Desktops verschieben, kann das Dashboard möglicherweise noch laden, während es inkompatible Definitionen vergleicht.
Error- und Telemetrie-Tracking erklärt die Zuverlässigkeit
Error-Tracking fängt Crashes, Ausnahmen, Logs, Netzwerkfehler und Leistungsprofile ein. Es beantwortet, ob die Anwendung überlebt hat und wie lange Operationen gedauert haben.
Telemetrie ist oft zu grob, um die Absicht zu erklären. Ein langsamer API-Spannweite ist bedeutender, wenn sie mit einer Benutzeraktion wie „Versuchte Kasse“ verbunden werden kann, aber diese Verbindung sollte stabile Korrelationsfelder verwenden und nicht persönliche Daten in jede Logzeile kopieren.
Vergleicht man die Haupt-Tracking-Ansätze
Die richtige Wahl hängt von der Frage, der akzeptablen Exposition und der von der Mannschaft zu tragenden operativen Komplexität ab. Der Kostenunterschied ist sehr groß, je nach Anbieter, Aufbewahrungsrichtlinie, Payload-Größe und Abfragemodell, daher wäre eine feste Preise pro Million Ereignisse ohne eine definierte Infrastruktur und Kontext des Anbieters irreführend.
Tracking-Ansätze im Überblick
| Ansatz | Datenshape | Latenz | Kosten (pro 1M) | Exposition der Privatsphäre | Best For |
|---|---|---|---|---|---|
| Ereignisverfolgung | Gespeicherte Aufzeichnungen mit benannten Aktionen und Kontext | Häufig in Echtzeit, aber auch verzögert, je nach Batching | Variabel, abhängig von der Payload-Größe, der Eingabe, dem Speicher und der Abfrage-Größe | Moderat, wenn Identifikatoren oder Eigenschaften übermäßig sind | Röhren, Release-Aufnahmen, Feature-Verwendung, Workflow-Verifizierung |
| Sitzungswiedergabe | Visuelle Frames, Screenshot, Gesten und Interaktionsmetadata | Häufig verzögert durch Upload und Verarbeitung | Häufig höherer Betriebs- und Speicherbedarf, da Payloads reichhaltiger sind | Hoch, insbesondere wenn Text, Formulare oder Account-Ansichten nicht maskiert sind | Reproduktion von Benutzerinterface-Reibung und mehrdeutigen Interaktionsfehlern |
| Analytik | Zusammengefasste Kanäle, Kohorten, Wege und Aufrechterhaltungsergebnisse | Abhängig von Lager oder Anbieterverarbeitung | Abfrage- und Speicherkosten können wachsen, wenn Rohereignisse neben Aggregaten aufbewahrt werden | Erbt Aussetzung von Quellereignissen und Identitätsjoins | Produktentscheidungen und longitudinale Verhaltensanalyse |
| Fehler- und Telemetriedaten | Stack-Spuren, Protokolle, Spuren, Zeiträume und Gerätestand | Häufig schnell für Vorfälle, unterliegt Warteschlange und Netzwerkverfügbarkeit | Oft niedriger pro Datensatz, aber hocheffige Protokolle können teuer werden | Moderat, insbesondere, wenn Protokolle Anforderungsdaten oder Benutzereingaben enthalten | Unfalldiagnose, Leistungsanalyse und Pipeline-Gesundheit |
Die häufigste Fehlhandlung besteht darin, alle vier Systeme mit überlappenden Schemata und ohne Eigentumsrechte zu aktivieren. Produktanalysen rufen eine Aktion purchase_completed, die Fehlerpipeline sendet payment_success, und die Wiedergabe-Tool schließt die Beendigung aus einer Bildschirmübergang ab. Die Dashboards stimmen nicht überein, Ingenieure verbringen Zeit damit, Definitionen zu klären, und niemand kann bestimmen, welches Ereignis autoritativ ist.
Legen Sie Eigentumsrechte vor dem Hinzufügen eines Tools fest. Das Produkt sollte die Geschäftssemantik besitzen, der Ingenieur sollte die Liefergarantien und die Schemavalidierung besitzen, und die Datenschutzprüfer sollten in der Lage sein, jede Felder von der Erfassung bis zur Löschung zu verfolgen. Für Teams, die eine explizite benutzerdefinierte Ereignissebene in einer Capacitor-Anwendung benötigen Capgo-Anleitung für die benutzerdefinierte Ereignisverfolgung ist eine Implementierungsreferenz und kein Ersatz für die Entscheidung, was jedes Ereignis bedeutet.
Architektur und Ereignisschemata für mobile und Desktop-Anwendungen
Ein Produktionspipeline hat vier unterschiedliche Stadien: Instrumentierung, dauerhafte Pufferung, Transport und Ingestion. Durch die klare Abgrenzung dieser Grenzen wird ein vorübergehender Netzwerkfehler zu einem Anwendungsfehler.
In einer Capacitor-Anwendung sollte die Anwendung code eine kleine SDK-Hüllfunktion aufrufen, anstatt eine API-Funktion des Anbieters direkt. Die Hüllfunktion fügt gemeinsame Enveloppe-Felder wie session_id, app_version, platform, und Zustimmungszustand. Das hält Aufrufergebnisse konsistent und gibt dem Team einen Ort, um Felder zu löschen, die Probewerte zu ändern oder einen gebrochenen Tracker zu deaktivieren.
Die Warteschlange sollte persistent und append-only sein. Ein in-Memory-Array verschwindet bei einem Crash oder einem Prozesskill genau dann, wenn diagnostische Beweise am wertvollsten sind. Speichere Ereignisse auf dem Disk, markiere Uploadversuche separat und stelle die Servereingabe idempotent durch einen stabilen event_idTransport kann bei der Wiederaufnahme der App, bei einem kontrollierten Interval oder wenn die Warteschlange eine Größenbegrenzung erreicht, mit exponentieller Verzögerung nach Fehlern abgeschlossen werden.
Ein praktischer Ereignisrahmen
| Typ | context | erforderlich | Zweck |
|---|---|---|---|
event_id |
context | Yes | Wiederholungen während der Eingabe reduziert |
event_type |
context | Ja | Routen und validiert das Ereignis |
occurred_at |
Zeitstempel | Ja | Zeitpunkt des Ereignisses auf der Clientseite |
session_id |
Zeichenkette | Ja | Gruppieren Sie Ereignisse in einer Benutzersitzung ohne eine persönliche Identifikationsnummer zu erfordern |
app_version |
Zeichenkette | Ja | Identifiziert die installierte Anwendungsversion |
bundle_version |
Zeichenkette | Optional | Identifiziert die aktive JavaScript- oder Web-Bundle |
platform |
Zeichenkette | Ja | Unterscheidet iOS, Android, macOS, Windows oder ein anderes Laufzeitumfeld |
consent_state |
Zeichenkette | Ja | Wendet Sammlungspolitik vor dem Puffern und Upload an |
properties |
Objekt | Optional | Hält spezifische, validierte Felder für Ereignisse |
network_state |
Zeichenkette | Optional | Fügt Kontext für die Lieferung und die Offline-Analyse hinzu |
Eine Checkout-Ereignis kann enthalten cart_item_count und payment_provider, aber keine E-Mail-Adresse oder unfilterte Formulardaten. Der Server sollte unbekannte Felder ablehnen oder sie in die Quarantäne leiten. Die stille Akzeptanz von Schema-Drift führt zu Dashboards, die gesund aussehen, aber an Bedeutung verlieren.
Elektron führt ein weiteres Grenzgebiet ein. Benutzeraktionen finden normalerweise im Renderer-Prozess statt, während Systemzustand, Update-Status, Dateisystemzugriff und Netzwerkkoordination oft im Hauptprozess liegen. Verwenden Sie einen schmalen, validierten IPC-Vertrag anstatt beliebige Renderer-Payloads über die Grenze zu lassen.
{
  "event_id": "evt_opaque_123",
  "event_type": "checkout_submitted",
  "occurred_at": "2026-09-18T02:14:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "bundle_version": "2026.09.18.2",
  "platform": "android",
  "consent_state": "functional",
  "properties": {
    "cart_item_count": 2,
    "payment_provider": "provider_a"
  },
  "network_state": "online"
}
Ein Elektron-Renderer-Ereignis kann Prozesskontext hinzufügen, ohne Benutzerinhalte zu offenbaren:
{
  "event_id": "evt_opaque_789",
  "event_type": "window_action",
  "occurred_at": "2026-09-18T02:20:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "platform": "windows",
  "consent_state": "essential",
  "window_id": "window_opaque_12",
  "renderer_process_id": "renderer_opaque_34",
  "properties": {
    "action": "settings_opened"
  }
}
Capacitor-Plugin-Grenzen verdienen explizite Tests. Ein Webview-Ereignis benötigt möglicherweise eine Brücke zu nativen code für sichere Speicherung, Gerätestand oder native Lifecycle-Signale. Die Capgo-Anwendungsinfrastruktur-Leitfaden bietet relevante architektonischen Kontext, aber die dauerhafte Regel ist die lokale Eigentümerschaft: Fassen Sie UI-Intention im Renderer oder Webview, fassen Sie native Lifecycle-Zustand an der nativen Grenze und korrelieren Sie sie durch den gemeinsamen Umschlag.
Sampling und Leistungstransaktionen
Sampling ist eine Leistungsentscheidung, bevor es eine Entscheidung der Datenwissenschaft wird. Jedes Ereignis, das Sie fallen lassen, kann die Serialisierung arbeiten, die Warteschlangen schreiben, die Batterie, die Netzwerkübertragung und die Speicherung sparen. Jedes Ereignis, das Sie fallen lassen, kann auch Beweise von einem Vorfall entfernen.
Für eine realistische Mobilpipeline können serialisierte JSON-Ereignisse sein 1 bis 4 KB, Intervalle zur Flushung können sich von 5 bis 60 Sekunden, und ein typischer Sitzung kann Dutzende von Aktionen erzeugen. Diese Zahlen stammen aus der Implementierungsanweisung und nicht von einem universellen Benchmark, also messen Sie die Größe der Payloads und das Flushverhalten auf den Geräten, auf denen Ihre Benutzer arbeiten.
Wählen Sie eine Abtastung nach Signalwert
Fangen Sie wichtige Geschäftsevents mit voller Genauigkeit ein. Login, Absendung des Checkout, Aktivierung des Pakets, Zahlungsergebnis, Crash und Änderungen der Zustimmung sind schwierig zu rekonstruieren und sollten für die operative Wahrheit verfügbar bleiben.
Hochvolumige Signale wie Render-Frames, Scroll-Bewegungen, umfangreiche Protokolle und Pointer-Bewegungen sind anders. Eine Abtastung auf Client-Seite ist geeignet, wenn das Gerät nicht in der Lage ist, alle Vorkommnisse zu serialisieren und in einer Warteschlange zu platzieren. Ein kleiner Spielraum für die Telemetrie der Benutzeroberfläche kann nützlich sein, während Fehler und Crashes vollständig erfasst bleiben sollten.
Die Abtastung auf Server-Seite funktioniert besser, wenn Sie das Rohmaterial vorübergehend aufbewahren möchten, aber die Abfragekosten reduzieren möchten. Verwenden Sie einen deterministischen Hash von session_id oder einem genehmigten transparenten Benutzer-Identifikator, damit eine Sitzung konsistent entweder eingeschlossen oder ausgeschlossen bleibt, wenn es um verwandte Abfragen geht. Zufällige Probenahme pro Ereignis zerstört die Sequenzintegrität.
Das Abtasten der Abtastentscheidung selbst. Speichern Sie die Versionsnummer der Regel, den Ergebnis der Aufnahme und die Begründung, und überprüfen Sie, ob der Batteriezustand, die Plattform, die Region oder der Zustand der Zustimmung einen unbeabsichtigten Blindpunkt schafft. Die adaptive Abtastung kann die Sammlung von geringem Wert unter thermischer oder Batteriedruck reduzieren, aber sie darf die Erfassung von Fehlern oder Zustimmungsübergängen nie reduzieren.
Datenschutz und Compliance als Entwurfskonstrukt
Der Datenschutz gehört in den Pipeline-Diagramm, nicht in eine Startliste. Die erste architektonische Frage ist, ob der SDK überhaupt eine Ereignis erstellen oder ein Ereignis in einem Buffer speichern darf. Wenn eine Zustimmung erforderlich ist, muss der SDK die Schleuse anwenden, bevor die Daten auf den Festplatte geschrieben werden, nicht nachdem eine Warteschlange bereits den Payload aufgenommen hat.
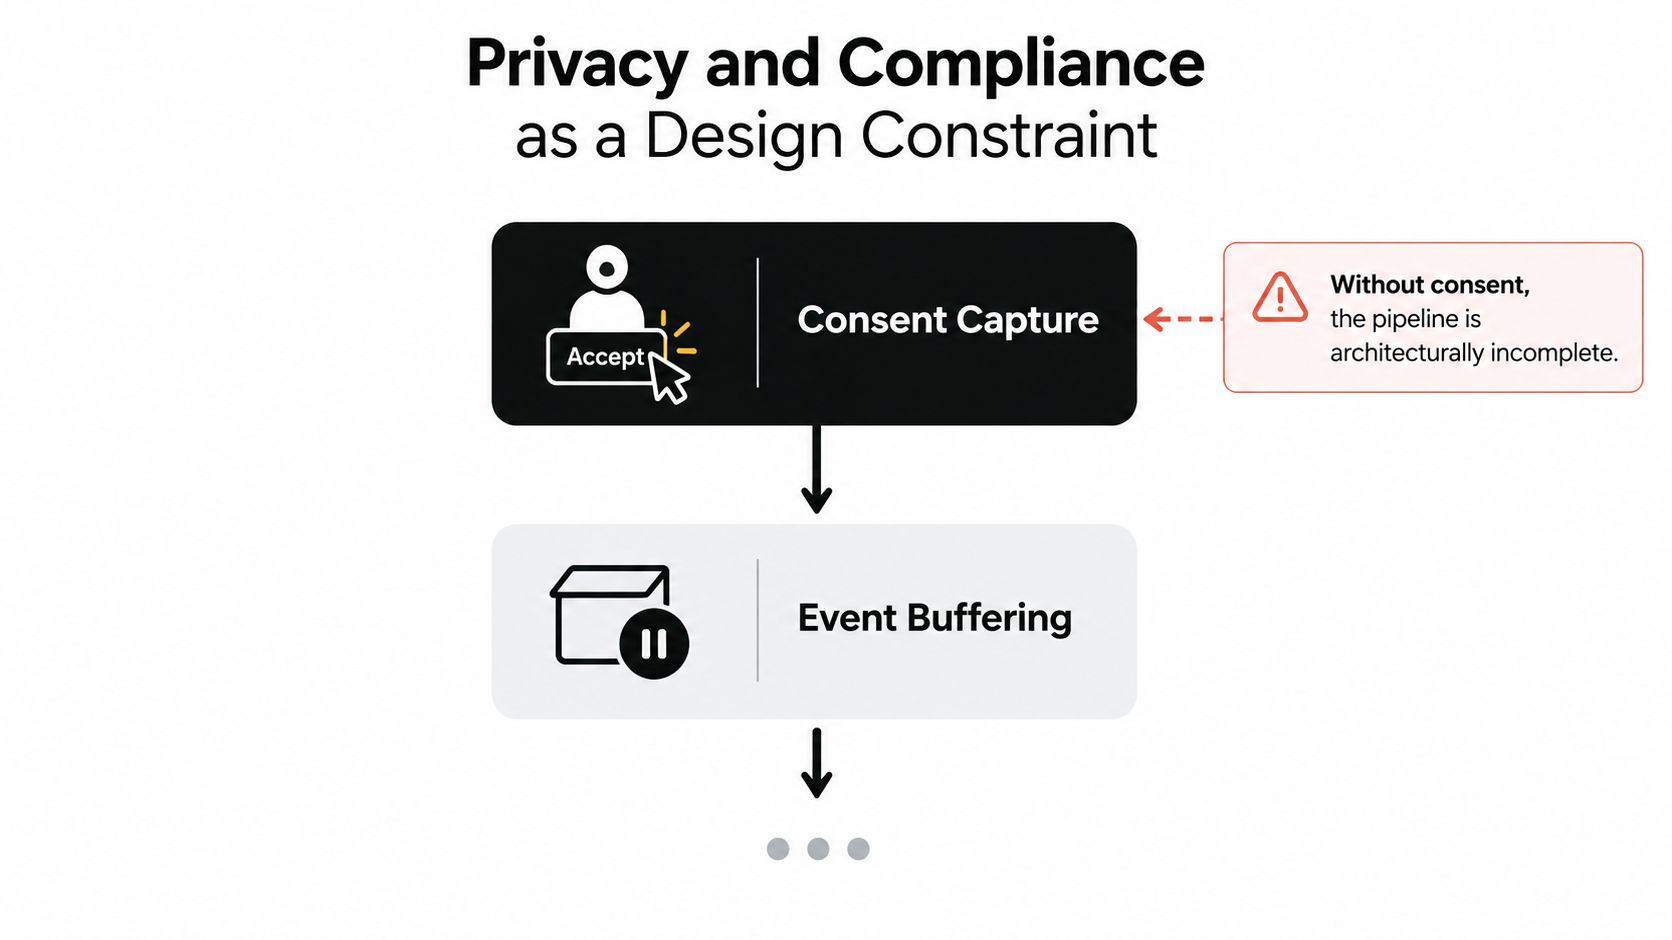
Verwenden Sie separate Sammlungskategorien für die notwendige Zuverlässigkeitsüberwachung, die funktionalen Produktanalysen und die optionalen Marketing-Signale. Jede Kategorie benötigt eine klare Richtlinie, einen SDK Switch und eine serverseitige Überprüfung. Diese Vorgehensweise macht es auch einfacher, Audits durchzuführen, da die Rezensenten die Entscheidung vom Zustimmungs-UI bis zum Buffer, Transport, Speicherung und Löschung nachvollziehen können.
Setzen Sie Kontrollen an mehreren Grenzen
- Bei der Ausstrahlung: Email-Adressen, Telefonnummern, Zahlungsdaten und unbeschränkte freie Texte sollten vor dem Eintritt in die Warteschlange abgelehnt werden.
- Bei der Identitätsbildung: Verwenden Sie transparente Identifikatoren und rotieren oder beschränken Sie sie entsprechend dem Datenschutzmodell des Produkts. Behandeln Sie ein Geräte-Identifikator nicht als unschädlich, nur weil es kein Name ist.
- At Ingestion: Überprüfen Sie die Feldtypen, die zulässigen Werte, den Zustand der Zustimmung und die regionale Routenmetadata. Die Servervalidierung ist ein Schutz in der Tiefe, kein Grund, sorglos auf dem Client Daten zu sammeln.
- At Speicherung: Halten Sie die Rohdaten für eine begrenzte Betriebszeit auf, behalten Sie Aggregatwerte nur für längere Zeit auf, wenn dies gerechtfertigt ist, und wenden Sie die strengste Aufbewahrungsregel auf die Sitzungswiedergabe an, da visuelle Aufzeichnungen eine größere Exposition darstellen.
- At Löschung: Stellen Sie sicher, dass Löschanfragen durch heißes Speicher, kaltes Speicher, abgeleitete Tabellen, Caches und Wiedergabe-Systeme propagieren. Ein verschwindender Dashboard beweist nicht, dass die zugrunde liegende Aufzeichnung entfernt wurde.
Regionale Routen sind auch ein Systemkonzept. Bestimmen Sie die anwendbare Region aus einer stabilen, dokumentierten Signalisierung, senden Sie dann das Ereignis an eine Ingestion-Endpunkt und ein Speicherort, der durch die erforderliche Richtlinie geregelt wird. Teams, die die umgebende Website und die Zustimmungsverpflichtungen überprüfen, können diese Leitfaden von Coto & Waddington zu Website-Privatsphäre als praktisches rechtliches Ressourcen verwenden, während sie noch spezifische Beratung für ihr Produkt und ihre Gerichtsbarkeiten einholen.
Plattformregeln unterstreichen die Notwendigkeit dieser Trennung. Die Industrieberichterstattung platziert die globale ATT-Opt-in um 27% bis 38% In einer 2026-Benchmark, mit den Vereinigten Staaten umher 31%, Japan umher 38%, Deutschland umher 24%, und das Vereinigte Königreich umher 26% (Branchenübersicht zum Apple-Tracking-Verhalten). Androids Privacy Sandbox Attribution Reporting ähnelt sich der Werbemaßnahme in Richtung aggregierter Berichterstattung anstatt Kreuzpartei-Identifikatoren, wie in diesem mobilen Analytics- und Datenschutzanalyse beschrieben. Für Implementierungsteams, Capacitor Leitfaden zur DSGVO-Konformität ist nur dann nützlich, wenn er in umsetzbare SDK und Ingestionsverhalten übersetzt wird.
Metriken, Dashboards und Warnungen, die wirklich helfen
Eine Trackingpipeline verdient ihren Platz, wenn sie einen Ingenieur- oder Produktentscheid ändert. Beginnen Sie mit drei Ansichten, Adoption, Qualität und Pipelinegesundheit, und geben Sie jedem Publikum dann einen Dashboard, der seine eigenen Fragen beantwortet, ohne die zugrunde liegenden Ereignisse neu zu definieren.
Adoptionsmetriken umfassen wöchentlich aktiven Gebrauch, Paketadoption durch Kanal, Feature-Eintritt und Funnell-Abgeschlossenheit. Qualitätsmetriken umfassen Crash-freie Sitzungen, fehlgeschlagene Anfragen, Checkout-Fehler und Client-Seitige Latenz. Pipeline-Metriken Einschließen Sie die Warteschlangentiefe, den Upload-Erfolg, die Eingabezeit, die Schemaablehnung, die Entscheidungen zum Einwilligungsschalter und die regionalen Routenfehler.
Metriken, Signale und Warnmuster
| Metrik-Kategorie | Beispiel-Metrik | Gesunde Schwellenwert | Warnmuster |
|---|---|---|---|
| Zuweisung | Aktive Benutzer auf der beabsichtigten Bundle-Version | Definiert durch den Release-Eigner und den Rollout-Plan | Warnung, wenn die Einführung über die geplante Beobachtungszeit hinausgeht |
| Qualität | Ratenzahl der fehlerfreien Sitzungen | Beispielweise oben 99,5% über 30 Minuten, ein im Betriebsanweisung festgelegter Schwellenwert | Seite, die dem mobilen Besitzer mit Plattform, App-Version und Release-Kanal zugeordnet ist |
| Pipeline | Umsatzstufenkonvertierung | Im Vergleich mit der genehmigten Basislinie für die gleiche Kohorte | Warnung aufgrund einer nachhaltigen, kohorte-spezifischen Abweichung anstatt einer einzelnen lauten Intervall |
| Pipeline | P95 Client-Eingabeverzögerung | Definiert in der Dienstleistungsziel für den Eingabe-Weg | Warnen Sie den Daten- oder Plattformbesitzer, wenn das Ziel kontinuierlich verletzt wird |
| Datenqualität | Schema-Ablehnungsrate | Nahe Null für veröffentlichte Ereignisversionen | Öffnen Sie ein Vorfall, wenn ein neues Ereignistyp oder eine Anwendungsversion eine plötzliche Ablehnungsmuster verursacht |
Der 99,5% Crash-freie Sitzung-Beispiel und die P95-Verzögerung-Framing kommen aus den Betriebsanforderungen in diesem Brief, nicht aus einem universellen Standard. Ihre Mannschaft sollte den Besitzer, Bewertungszeitraum, Basislinie und Runbook neben jedem Alarm aufzeichnen. Ein Schwellenwert ohne Antwortpfad ist eine Dekoration für das Dashboard.
Die Ingenieur-Dashboards sollten die Release-Version, Plattform, Warteschlangenzustand, Transportfehler, Eingabe-Verzögerung und Schema-Fehler anzeigen. Die Produkt-Dashboards sollten die Adoption, Konversion, Pfade und Retention anzeigen. Beide Ansichten sollten die gleichen Ereignisverträge verwenden. Der Capacitor Leistungsmessung-Leitfaden bietet eine fokussierte Referenz für die Verbindung von Laufzeit-Signalen zur Betriebsüberwachung.
Best Practices und ein Incident Recovery Checklist
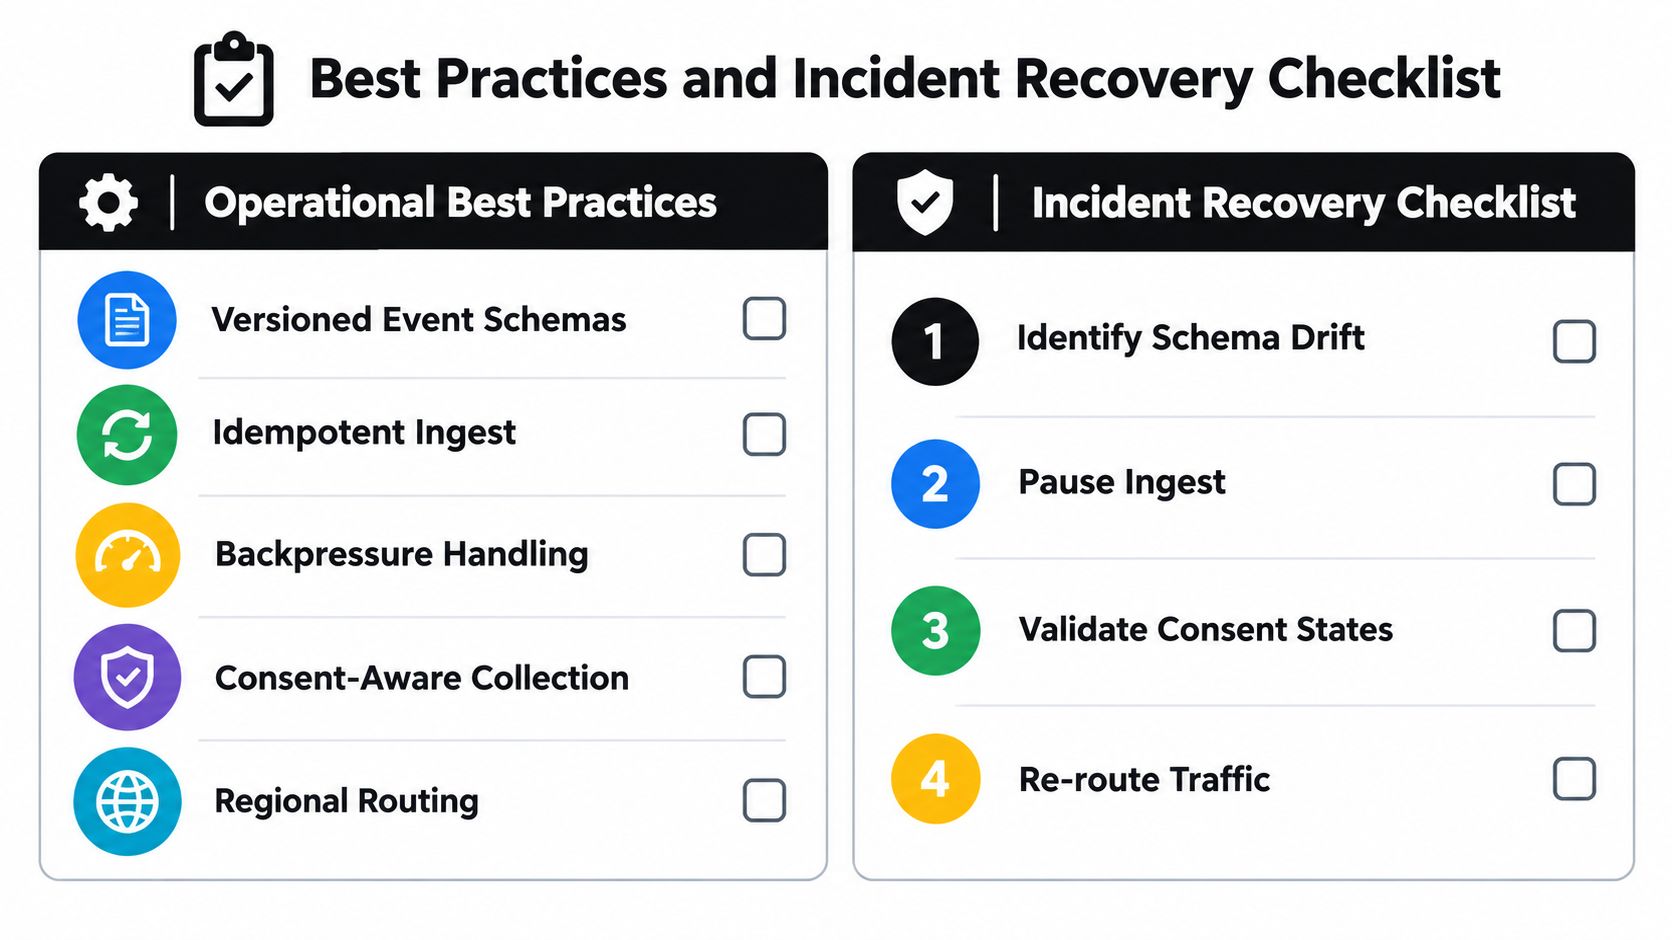
Ein zuverlässiges Tracking-System besteht hauptsächlich aus langweiligen Sicherheitsvorkehrungen. Versionieren Sie jeden Ereignisvertrag, machen Sie die Eingabe idempotent, behandeln Sie den Rückdruck explizit, erzwingen Sie die Zustimmung vor dem Puffern und routen Sie die Daten entsprechend der Richtlinie. Diese Kontrollen sind wichtiger als das Hinzufügen eines weiteren Dashboard, da sie bestimmen, ob die Daten während einer Veröffentlichung oder eines Ausfalls vertrauenswürdig bleiben.
Betriebscheckliste
- Versionierte Schemas: Veröffentlichen Sie Ereignisverträge mit erforderlichen Feldern, zulässigen Eigenschaften, Besitzern und Kompatibilitätsregeln.
- Idempotente Eingabe: Deduplizieren Sie durch
event_id, insbesondere wenn Kunden nach Zeitüberschreitungen oder Prozessneustarts wiederholen. - Rückdruck-Handling: Capgo-Warteschlangengroßzügigkeit, Priorität für Crashs und Geschäftskritische Aktionen erhalten und Drop-Entscheidungen als Telemetrie ausgeben.
- Einwilligungsbasierte Sammlung: Apply consent before persistence and re-evaluate queued events when consent changes.
- Regionale Routenplanung: Frühzeitig die Region lösen, deterministisch routen und das Verhalten der Speicherung und Löschung in jeder unterstützten Standortregion testen.
Handbuch zur Wiederherstellung von Vorfällen
- Detektieren und klassifizieren. Vergleichen Sie den Signalwert über App-Version, Bundle-Version, Plattform, Kanal und Zustand der Einwilligung. Ein plötzlicher Wechsel, der sich auf eine Bundle beschränkt, kann ein Schemaschieben oder einen gebrochenen SDK-Release anzeigen, während ein breiter Wechsel auf reale Verhaltensweisen oder eine Änderung der Richtlinie hinweist.
- Priorisieren Sie die Pipeline. Überprüfen Sie die Tiefe der Clientwarteschlange, die Uploadfehler, die Eingangsverzögerung, die abgelehnten Felder und die Duplikatrate. Beenden oder isolieren Sie das betroffene Ereignistyp, wenn fehlerhafte Payloads die nachfolgenden Systeme verunreinigen.
- Verwenden Sie Sicherheitsmaßnahmen. Deaktivieren Sie den fehlerhaften Tracker über einen ferngesteuerten Feature-Flag, wenn möglich, oder rollen Sie die Tracking-Bundle zurück, ohne die unabhängigen Produkte code zu ändern. Löschungen vor der Aufbewahrung der relevanten Warteschlange und Server-Records unter der genehmigten Aufbewahrungsrichtlinie sind nicht zulässig.
- Überprüfen Sie den Datenschutzstatus. Bestätigen Sie, dass Entscheidungen über den Einwilligungszustand, regionale Routen, die Löschung und die Entfernung von Pfaden wie geplant funktionieren. Ein Tracking-Vorfall kann ein Datenschutzvorfall sein, auch wenn das Produktfeature selbst funktioniert.
- Wiederherstellen und lernen. Replay nur validierte, dedupizierte Ereignisse aus den dauerhaften Puffern. Schreiben Sie eine schuldlose Postmortalanalyse, die den Auslöser, den Detektionsfehler, das betroffene Schema, die Wiederherstellungsaktion und die konkreten Pipeline- oder Teständerungen aufzeichnet.
Die App-Verhaltensüberwachung funktioniert, wenn sich die aufgerufenen Ingenieure auf das Ereignisvertrag verlassen können, die Produktteams die gleichen Fakten interpretieren können und die Datenschutzprüfer alle Felder durch das System verfolgen können. Wenn Sie Capacitor oder Electron-Apps bereitstellen und eine kontrollierte JavaScript-Bundlelieferung mit Release-Aufnahme, -Fehler, -Geräteprotokollen, -Kanalzielung und -Rücksetzungssichtbarkeit benötigen, besuchen Sie Capgo Um zu bewerten, wie sich das Live-Update-Plattform Ihres Unternehmens neben Ihrem Tracking-Pipeline einfügen lässt, beginnen Sie damit, eine kritische Release-Workflows zu kartieren, dann verbinden Sie seinen Update-Zustand, seinen Ausführungsverlauf und seinen Wiederherstellungsverlauf, bevor Sie die Abdeckung erweitern.



