
Al mediodía, un líder móvil envía una corrección por aire después de que una Capacitor regresión rompe el pago en Android. Por la mañana, las solicitudes de soporte están acumulándose, pero nadie puede confirmar qué versiones instaladas recibieron el paquete de JavaScript, qué cohortes ejecutaron el camino roto, o si un intento silencioso está ocultando el fracaso. El director de tecnología quiere datos de adopción, el líder de privacidad quiere un DPIA, y el ingeniero en llamada quiere saber si el rollback alcanzó a los usuarios.
Esa situación expone el propósito de Seguimiento de comportamiento de la aplicación. No es solo una consola de crecimiento o un debate de privacidad. Para los equipos que envían aplicaciones Capacitor y Electron a flotas de dispositivos fragmentadas, el seguimiento es un sistema de ingeniería para reconstruir el comportamiento, validar las liberaciones, detectar regresiones y demostrar que la recopilación sigue controlada. Los detalles de implementación importan, desde esquemas de eventos y colas duraderas hasta reglas de muestreo, almacenamiento regional y recuperación de incidentes.
Contenido de la Tabla
- Why App Behavior Tracking Matters in 2026
- What App Behavior Tracking Actually Means
- Comparando las principales enfoques de seguimiento
- Arquitectura y esquemas de eventos para aplicaciones móviles y de escritorio
- Ampliación y rendimiento: un equilibrio
- Privacidad y cumplimiento como restricción de diseño
- Métricas, tableros de control y alertas que realmente ayudan
- Prácticas recomendadas y un checklist de recuperación de incidentes
Why App Behavior Tracking Matters in 2026
Un informe de falla puede decirte que el pago falló. Normalmente no te dirá si la falla provino de un paquete de web caducado, una frontera de plugin nativo, un proceso de renderizador particular o un bucle de reintento que finalmente tuvo éxito. Sin contexto de comportamiento, el equipo debe correlacionar boletines de soporte, registros de lanzamiento y evidencia de servidor parcial a mano.
La primera pregunta útil después de un lanzamiento OTA es a menudo simple: ¿Recibieron y ejecutaron los usuarios destinatarios la actualización? Responderla requiere más que una cadena de versión. Necesitas la caja de comando nativa instalada, el paquete de JavaScript activo, el canal de actualización, el resultado de lanzamiento, la plataforma del dispositivo y eventos comerciales significativos alrededor del flujo afectado. Un descarga exitosa no prueba una activación exitosa, y un paquete activado no prueba que un usuario llegó a la pantalla reparada.
Regla práctica: Registra el estado de lanzamiento y el resultado del usuario como familias de eventos separadas. Combinarlas en un evento de éxito de actualización hace que el análisis de rollback sea poco confiable.
Capacitor observabilidad de la aplicación se ajusta a la práctica de producción. Una pipeline útil conecta las operaciones de lanzamiento con el comportamiento en tiempo de ejecución, por lo que un ingeniero puede pasar de 'los informes de pago aumentaron' a una consulta limitada que involucre la versión de la aplicación, la versión del paquete, la plataforma, el canal y la secuencia de eventos.
La restricción de privacidad es inseparable de ese diseño. El marco de trabajo de transparencia de seguimiento de aplicaciones de Apple, introducido en 2021, cambió el seguimiento entre aplicaciones de opt-out implícito a opt-in explícito.. Un análisis de 2025 encontró que la participación de usuarios de Apple rastreables por anunciantes en los Estados Unidos cayó de 72,63% antes de ATT a 17,9% después de eso, una caída de 54,73 puntos porcentuales (El análisis de 9to5Mac de la actualización de ATTEse cambio no elimina la telemetría de productos de primera parte, pero sí hace que la estrategia de identificadores, el estado de consentimiento y los límites de atribución sean decisiones arquitectónicas.
What App Behavior Tracking Actually Means
Treat app behavior tracking like a grabador de datos de vuelo para software. Captura qué hizo la aplicación, en qué orden y bajo qué condiciones, para que pueda reconstruir una sesión después de hecho en lugar de adivinar de una pila de errores.
El título cubre varios sistemas que responden a diferentes preguntas.
Registro de eventos registra hechos discretos
Un evento es una ocurrencia estructurada y nombrada, como checkout_started, payment_submitted, screen_viewed, o bundle_activated. Un evento bien diseñado lleva contexto, incluyendo la versión de la aplicación, la plataforma, el identificador de sesión y el estado relevante de la característica. Debe describir algo que ha ocurrido, no reproducir un objeto completo desde la memoria.
El seguimiento de eventos es excelente para flujos de trabajo, verificación de lanzamientos y consultas operativas. Falta la ambigüedad visual. Si un usuario hace clic en un control que parece habilitado pero no tiene un manejador, un evento puede mostrar la vista de pantalla anterior sin explicar el problema de la interfaz.
Reproducción de sesión preserva el contexto de interacción
La reproducción de sesión captura un flujo visual e interactivo, a menudo a través de instantáneas de DOM o árboles de vistas, gestos y estado de navegación. Puede revelar texto recortado, comportamiento de foco confuso o pulsaciones repetidas que los eventos estructurados nunca representan.
El equilibrio es la exposición. Los datos de reproducción pueden contener más contexto sensible que un evento cuidadosamente diseñado, especialmente cuando el texto libre, las pantallas de cuenta o los flujos de pago no están ocultos correctamente. También depende de la captura y la representación confiables, por lo que no debe ser el único registro de una acción crítica para el negocio.
Las métricas convierten eventos en decisiones
Los sistemas de métricas agrupan eventos en flujos de trabajo, cohortes, rutas y vistas de retención. Responden a preguntas como dónde los usuarios abandonan un flujo de trabajo o si un lanzamiento cambia la adopción de características.
Análisis es la interpretación downstream, no la instrumentación. Si los nombres de eventos varían entre móviles y escritorios, el panel de control puede seguir cargando al comparar definiciones incompatibles.
El seguimiento de errores y telemetría explica la confiabilidad
Seguimiento de errores captura fallas, excepciones, registros, fallos de red y huellas de rendimiento. Responde si la aplicación sobrevivió y cuánto tiempo tardaron las operaciones.
La telemetría es a menudo demasiado brusca para explicar la intención. Un período lento API importa más cuando se puede conectar a una acción de usuario como “intentó realizar un pago”, pero esa conexión debe utilizar campos de correlación estable en lugar de copiar datos personales en cada línea de registro.
Comparar las aproximaciones de seguimiento principales
La elección correcta depende de la pregunta, la exposición aceptable y la cantidad de complejidad operativa que el equipo puede asumir. El costo varía ampliamente según el proveedor, la política de retención, el tamaño del paquete y el modelo de consulta, por lo que un precio fijo por millón de eventos sería engañoso sin un contexto de infraestructura y proveedor definido.
Aproximaciones de seguimiento a la vista
| Aproximación | Forma de datos | Latencia | Costo (por 1M) | Exposición de privacidad | Mejor para |
|---|---|---|---|---|---|
| Seguimiento de eventos | Registros estructurados con acciones y contexto nombrados | Generalmente en tiempo real o con retraso, dependiendo de la agrupación | Variable, impulsado por el tamaño del paquete, ingesta, almacenamiento y volumen de consulta | Moderado si los identificadores o propiedades son excesivos | Flujos, adopción de lanzamientos, uso de características, verificación de flujo de trabajo |
| Reproducción de sesión | Marcos visuales, instantáneas, gestos y metadatos de interacción | A menudo retrasado por la carga y el procesamiento | Generalmente mayor carga operativa y de almacenamiento porque los paquetes son más ricos | Alto, especialmente cuando el texto, formularios o vistas de cuenta no están ocultos | Reproducing UI friction and ambiguous interaction failures |
| Análisis | Flujos agrupados, cohortes, rutas y salidas de retención | Depende del procesamiento de almacén o proveedor | Los costos de consulta y almacenamiento pueden aumentar cuando se retienen eventos brutos junto con agregados. | Hereda exposición de los eventos de origen y uniones de identidad | Análisis de decisiones de producto y comportamiento longitudinal |
| Seguimiento de errores y telemetría | Rastros de pila, registros, spans, tiempos y estado de dispositivo | Comúnmente rápido para incidentes, sujeto a cola y disponibilidad de red | A menudo más barato por registro, pero los logs de alta volumen pueden volverse costosos | Moderado, especialmente cuando los registros incluyen datos de solicitud o entrada del usuario | Diagnóstico de fallas, análisis de rendimiento y salud de la canalización |
El error más común es habilitar todos los cuatro sistemas con esquemas superpuestos y sin propiedad. Las llamadas de análisis de productos a una acción purchase_completed, la canalización de errores emite payment_success, y la herramienta de reproducción infiere la finalización desde una transición de pantalla. Los tableros de control no están de acuerdo, los ingenieros pasan tiempo reconciliando definiciones, y nadie puede afirmar cuál evento es autoritario.
Definir la propiedad antes de agregar una herramienta. El producto debería tener la propiedad de los semánticos comerciales, el ingeniería debería tener la propiedad de las garantías de entrega y la validación de schema, y los revisores de privacidad deberían poder rastrear cada campo desde la captura hasta la eliminación. Para los equipos que necesitan una capa de eventos personalizados explícitos en una aplicación Capacitor Capgo’s custom event tracking plugin guide No es una sustitución para decidir qué significa cada evento.
Arquitectura y Esquemas de Eventos para Aplicaciones Móviles y de Escritorio
Una canalización de producción tiene cuatro etapas distintas: instrumentación, almacenamiento de búfer duradero, transporte y ingestaEvitando que una falla de red temporal se convierta en una falla de la aplicación.
En una aplicación Capacitor, la aplicación code debería llamar a un pequeño wrapper SDK en lugar de un proveedor API directamente. El wrapper agrega campos comunes de envoltura como session_id, app_version, platformy el estado de consentimiento. Eso mantiene consistentes los sitios de llamada y da a la equipo un lugar para redactar campos, cambiar la muestra o deshabilitar un rastreador roto.
La cola debe ser persistente y de solo apoyo. Un array en memoria desaparece durante un crash o un kill de proceso, exactamente cuando la evidencia diagnóstica es más valiosa. Almacena eventos en disco, marca los intentos de carga separadamente y haz que la ingesta del servidor sea idempotente a través de un stable event_idEl transporte puede flush en la aplicación al reanudarse, a intervalos controlados, o cuando la cola alcance un límite de tamaño, con retraso exponencial después de fallas.
Un envoltorio de evento práctico
| Tipo | Type | Obligatorio | Propósito |
|---|---|---|---|
event_id |
String | Cadena | Elimina duplicados de intentos durante la ingesta |
event_type |
String | Sí | Rutas y valida el evento |
occurred_at |
Fecha de marcaje | Sí | Registra el tiempo de eventos del lado del cliente |
session_id |
String | Sí | Grupos eventos en una sesión de usuario sin requerir un identificador personal |
app_version |
String | Sí | Identifica la versión de la aplicación instalada |
bundle_version |
String | Opcional | Identifica el paquete de JavaScript o web activo |
platform |
String | Sí | Distingue iOS, Android, macOS, Windows o otro entorno de ejecución |
consent_state |
String | Sí | Distingue iOS, Android, macOS, Windows o otro entorno de ejecución |
properties |
Object | Opcional | Almacena campos específicos de eventos, validados |
network_state |
String | Opcional | Agrega contexto para la entrega y el análisis en línea |
Un evento de pago puede contener cart_item_count y payment_provider, pero no una dirección de correo electrónico o texto de formulario no filtrado. El servidor debe rechazar campos desconocidos o enviarlos a la cuarentena. La aceptación silenciosa de la deriva del esquema crea tableros que parecen saludables mientras pierden significado.
Electron introduce otra frontera. Las acciones del usuario suelen ocurrir en el proceso del renderizador, mientras que el estado del sistema, el estado de actualización, el acceso al sistema de archivos y la coordinación de red a menudo pertenecen al proceso principal. Utilice un contrato de IPC estrecho y validado en lugar de permitir que los payloads del renderizador arbitrarios crucen la frontera.
{
  "event_id": "evt_opaque_123",
  "event_type": "checkout_submitted",
  "occurred_at": "2026-09-18T02:14:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "bundle_version": "2026.09.18.2",
  "platform": "android",
  "consent_state": "functional",
  "properties": {
    "cart_item_count": 2,
    "payment_provider": "provider_a"
  },
  "network_state": "online"
}
Un evento de renderizado de Electron puede agregar contexto de proceso sin exponer contenido de usuario:
{
  "event_id": "evt_opaque_789",
  "event_type": "window_action",
  "occurred_at": "2026-09-18T02:20:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "platform": "windows",
  "consent_state": "essential",
  "window_id": "window_opaque_12",
  "renderer_process_id": "renderer_opaque_34",
  "properties": {
    "action": "settings_opened"
  }
}
Las fronteras del plugin Capacitor merecen pruebas explícitas. Un evento de webview puede necesitar una conexión a code nativo para almacenamiento seguro, estado de dispositivo o señales de ciclo de vida nativas. El La guía de infraestructura del app Capgo proporciona contexto arquitectónico relevante, pero la regla duradera es la propiedad local: captura la intención de la interfaz de usuario en el renderizador o webview, captura el estado de ciclo de vida nativo en la frontera nativa y correlaciona ambos a través del envoltorio compartido.
Muestras y Compromisos de Rendimiento
La muestra es una decisión de rendimiento antes de convertirse en una decisión de ciencia de datos. Cada evento que descartes puede ahorrar trabajo de serialización, escrituras en la cola, batería, transferencia de red y almacenamiento. Cada evento que descartes también puede eliminar evidencia de un incidente.
For una pila móvil realista, los eventos JSON serializados pueden ser 1 a 4 KB, los intervalos de descarga pueden variar desde 5 a 60 segundos, y una sesión típica puede generar docenas de acciones. Estas cifras provienen del informe de implementación, no de un benchmark universal, por lo que mida los tamaños de carga y el comportamiento de descarga en los dispositivos que utilizan sus usuarios.
Elige la muestra por valor de señal
Captura eventos críticos comerciales con fidelidad completa. El inicio de sesión, la presentación de la caja de pago, la activación del paquete, el resultado del pago, el error y los cambios de consentimiento son difíciles de reconstruir más tarde y deben permanecer disponibles para la verdad operativa.
Señales de alta volumen como frames de renderizado, movimiento de desplazamiento, registros verbosos y movimiento del puntero son diferentes. La muestra del lado del cliente es apropiada cuando el dispositivo no puede permitirse serializar y encolar cada ocurrencia. Una pequeña muestra de margen para la telemetría de la interfaz puede ser útil, mientras que los errores y los errores deben permanecer completamente capturados.
Funciona mejor el muestreo en servidor cuando deseas preservar evidencia bruta temporalmente pero reducir el costo de la consulta. Utiliza un hash determinístico de session_id o un identificador de usuario opaco aprobado para que una sesión permanezca consistentemente incluida o excluida en consultas relacionadas. La muestra aleatoria por evento destruye la integridad de la secuencia.
Configurar la decisión de muestreo en sí misma. Almacene la versión de la regla, el resultado de inclusión y la razón, y luego compruebe si el estado de la batería, la plataforma, la región o el estado de consentimiento crea un punto ciego no intencional. La muestreo adaptativo puede reducir la recopilación de baja valor bajo presión térmica o de batería, pero nunca debe reducir la captura de fallas o transiciones de consentimiento.
Privacidad y Cumplimiento como Restricción de Diseño
La privacidad pertenece al diagrama de la canalización, no a una lista de verificación de lanzamiento. La primera pregunta arquitectónica es si el SDK está permitido para crear o almacenar un evento en absoluto. Si se requiere consentimiento, el SDK debe aplicar la puerta antes de escribir en disco, no después de que una cola haya retenido ya el payload.
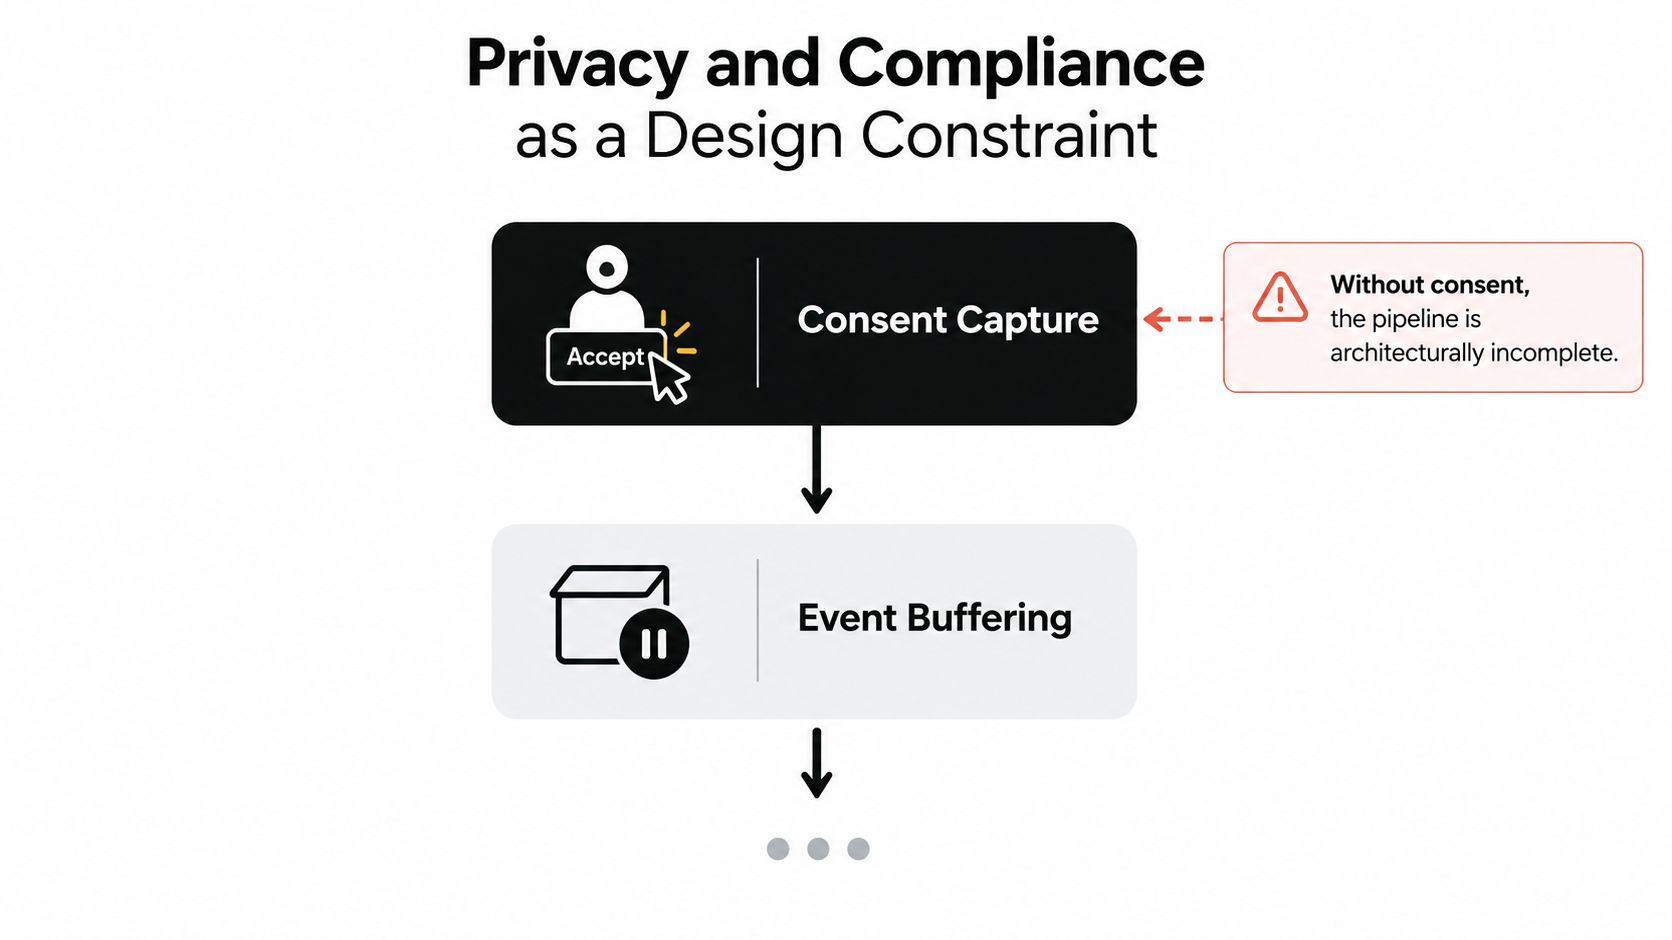
Utilice categorías de recopilación separadas para la telemetría de confiabilidad esencial, la análisis de productos funcionales y las señales de marketing opcionales. Cada categoría necesita una política clara, un interruptor SDK y un control de verificación en el lado del servidor. Esta aproximación también hace que las auditorías sean más fáciles porque los revisores pueden seguir la decisión desde la interfaz de usuario de consentimiento hasta el buffer, el transporte, el almacenamiento y la eliminación.
Coloque controles en múltiples fronteras
- En la emisión: Rechace direcciones de correo electrónico, números de teléfono, detalles de pago y texto libre sin límite antes de que un evento ingrese a la cola.
- En la creación de identidad: Prefer identificadores opacos y rotarlos o limitarlos según el modelo de privacidad del producto. No trate un identificador de dispositivo como inofensivo porque no es un nombre.
- Atención a la ingesta: Validar tipos de campos, valores permitidos, estado de consentimiento y metadatos de enrutamiento regional. La validación en el servidor es una defensa en profundidad, no una autorización para recopilar con descuido en el cliente.
- En almacenamiento: Mantenga eventos brutos durante una ventana operativa limitada, retenga agregados durante más tiempo solo cuando esté justificado y aplique la regla de retención más estricta a la reproducción de sesión porque los registros visuales llevan una mayor exposición.
- Atención a la eliminación: Haga que las solicitudes de eliminación se propaguen a través de almacenamiento caliente, almacenamiento frío, tablas derivadas, cachés y sistemas de reproducción. Un dashboard desapareciendo no prueba que el registro subyacente se eliminó.
El enrutamiento regional también es una preocupación de sistemas. Determine la región aplicable a partir de un señal estable y documentada, luego envíe el evento a un punto de ingesta y ubicación de almacenamiento gobernados por la política requerida. Los equipos que revisan el sitio web y las obligaciones de consentimiento pueden utilizar este Guía de privacidad de sitios web de Coto & Waddington como una fuente legal práctica, mientras aún obtienen asesoramiento específico para su producto y jurisdicciones.
La plataforma establece reglas que refuerzan la necesidad de esta separación. Los informes de la industria colocan la opción de ATT global alrededor 27% a 38% In un informe de 2026, con Estados Unidos alrededor de 31%, Japón alrededor de 38%, Alemania alrededor de 24%, y el Reino Unido alrededor de 26% (industry summary of Apple tracking behavior) El Sandbox de privacidad de Android para la atribución de publicidad se mueve hacia un informe agregado en lugar de identificadores de partido cruzado, como se describe en este análisis de móviles y privacidad. Para los equipos de implementación, Capacitor GDPR compliance guidance es útil solo cuando se traduce a una configuración SDK y se implementa el comportamiento de ingesta.
Las métricas, tableros de control y alertas que realmente ayudan
Un pipeline de seguimiento gana su lugar cuando cambia una decisión de ingeniería o de producto. Comience con tres vistas: adopción, calidad y salud del pipeline, luego dé a cada audiencia un tablero que responda a sus propias preguntas sin redefinir los eventos subyacentes.
Las métricas de adopción incluyen el uso activo semanal, la adopción de paquetes por canal, la entrada de características y la finalización de la funa. Indicadores de calidad sesiones sin errores, solicitudes fallidas, errores de pago y latencia en el lado del cliente. Indicadores de pipeline incluyen profundidad de cola, éxito de carga, latencia de ingesta, rechazo de esquema, decisiones de consentimiento y errores de enrutamiento regional.
Indicadores, señales y patrones de alerta
| Categoría de indicador | Ejemplo de indicador | Límite de umbral saludable | Patrón de alerta |
|---|---|---|---|
| Adopción | Usuarios activos en la versión del paquete prevista | Definido por el propietario de la versión y el plan de lanzamiento | Alerta cuando la adopción se estanca más allá de la ventana de observación planificada |
| Calidad | Tasa de sesión libre de errores | Por ejemplo, arriba 99,5% durante 30 minutos, un umbral especificado en el informe de operaciones | Página del propietario del móvil con plataforma, versión de la aplicación y canal de lanzamiento adjuntos |
| Funnel | Conversión del paso de pago | Comparado con el umbral aprobado para la misma cohorte | Alerta sobre una desviación sostenida y específica de cohorte en lugar de un intervalo ruidoso. |
| Pipeline | Latencia de ingesta del cliente P95 | Definido en el objetivo del servicio para el camino de ingesta | Notificar al propietario de datos o plataforma cuando el objetivo se incumple de manera continua |
| Calidad de datos | Tasa de rechazo de esquema | Casi cero para versiones de eventos liberadas | Abrir un incidente cuando un nuevo tipo de evento o versión de aplicación cause un patrón de rechazo repentino |
El Ejemplo de sesión sin crash del 99,5% y la definición de latencia P95 provienen de los requisitos operativos en este resumen, no de un estándar universal. Su equipo debe registrar el propietario, la ventana de evaluación, el umbral y el runbook junto a cada alerta. Un umbral sin un camino de respuesta es decoración de tablero.
Los tableros de ingeniería deben mostrar la versión de lanzamiento, la plataforma, el estado de cola, los errores de transporte, la latencia de ingesta y los fallos de esquema. Los tableros de producto deben mostrar la adopción, la conversión, los caminos y la retención. Ambas vistas deben utilizar los mismos contratos de eventos. El Guía de monitoreo de rendimiento Capacitor Proporciona una referencia enfocada para conectar señales de tiempo de ejecución a monitoreo operativo.
Prácticas recomendadas y un checklist de recuperación de incidentes
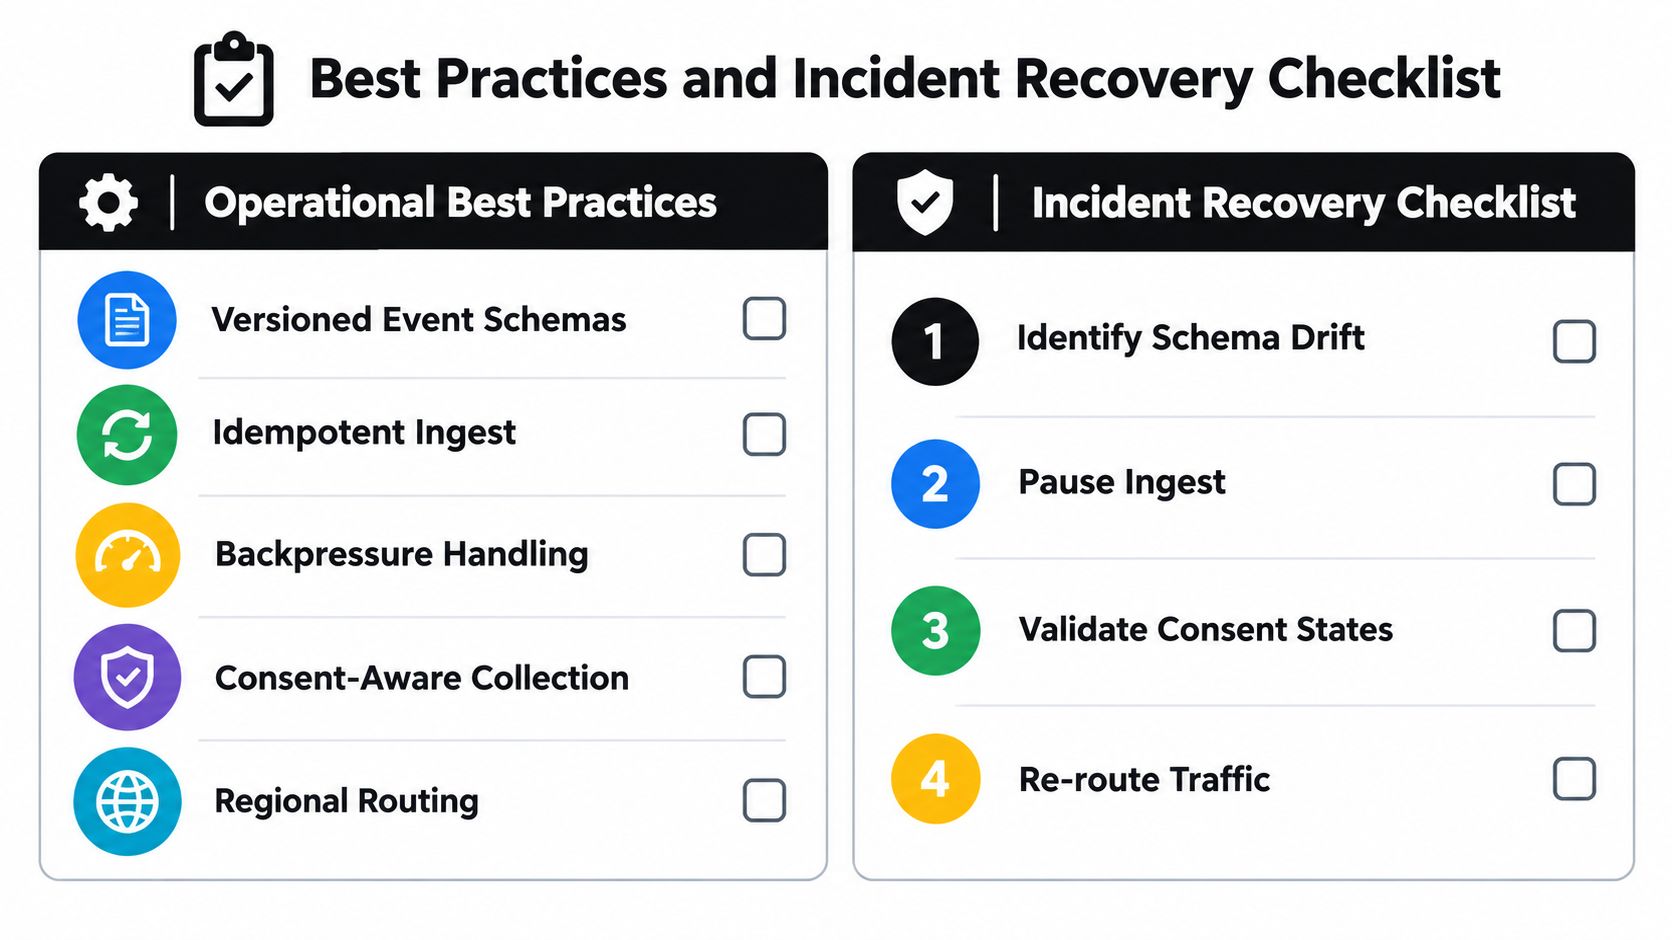
Un sistema de seguimiento confiable se compone principalmente de medidas de seguridad aburridas. Versione cada contrato de evento, haga la ingesta idópeta, maneje la presión de fondo explícitamente, imponga el consentimiento antes de la bufferización y rutee los datos según la política. Estos controles importan más que agregar otro tablero porque determinan si los datos permanecen confiables durante una liberación o un corte.
Lista de verificación operativa
- Esquemas versionados: Publicar contratos de eventos con campos requeridos, propiedades permitidas, propietarios y reglas de compatibilidad.
- Ingesta idópeta: Deduplicar por
event_id, especially when clients retry after timeouts or process restarts. - Gestión de presión de fondo: Crecimiento de la cola de Cap, preservar prioridad para errores y acciones críticas comerciales, y exponer decisiones de descarte como telemetría.
- Recolección consciente: Aplicar consentimiento antes de la persistencia y reevaluar eventos programados cuando cambie el consentimiento.
- Ruteo regional: Resolver la región temprano, rutar de manera determinista y probar el comportamiento de almacenamiento y eliminación en cada ubicación soportada.
Plan de recuperación de incidentes
- Detectar y clasificar. Comparar el señal en función de la versión de la aplicación, la versión del paquete, la plataforma, el canal y el estado de consentimiento. Un cambio repentino aislado a un paquete puede indicar un desplazamiento de esquema o una versión rota de SDK, mientras que un cambio amplio puede reflejar un comportamiento real o una actualización de política.
- Triar la canalización. Verificar la profundidad de la cola del cliente, las fallas de carga, la latencia de ingesta, los campos rechazados y las tasas de duplicados. Pausar o aislar el tipo de evento afectado si los payloads malformados están contaminando los sistemas downstream.
- Mitigar de manera segura. Deshabilitar el rastreador fallido mediante una bandera de características remota cuando sea posible, o retroceder el paquete de seguimiento sin cambiar productos relacionados code. No elimine evidencia antes de preservar la cola relevante y los registros del servidor bajo la política de retención aprobada.
- Validar el estado de privacidad. Verifique que las decisiones de consentimiento, la ruta regional, la supresión y las rutas de eliminación sigan comportándose como diseñadas. Un incidente de seguimiento puede ser un incidente de privacidad incluso cuando la característica del producto funcione correctamente.
- Recuperar y aprender. Reproducir solo eventos validados y deduplicados desde buffers duraderos. Escribe un postmortem sin culpas que registre el disparador, la brecha de detección, el esquema afectado, la acción de recuperación y los cambios concretos en la canalización o las pruebas.
El seguimiento del comportamiento de la aplicación funciona cuando los ingenieros en llamada de emergencia pueden confiar en el contrato de eventos, los equipos de producto pueden interpretar los mismos hechos y los revisores de privacidad pueden seguir cada campo a través del sistema. Si envías aplicaciones Capacitor o Electron y necesitas entrega de paquetes de JavaScript controlada con adopción de lanzamiento, fracaso, registros de dispositivo, targeting de canal y visibilidad de rollback, visita Capgo Para evaluar cómo su plataforma de actualización en vivo puede ajustarse a su pipeline de seguimiento. Comienza por mapear un flujo de trabajo de lanzamiento crítico, luego conecta su estado de actualización, el resultado de tiempo de ejecución y el camino de recuperación antes de ampliar la cobertura.



