
À 2 heures du matin, un lead mobile envoie un correctif par voie aérienne après qu'une Capacitor regression a cassé le processus de paiement sur Android. Le lendemain matin, les tickets de support s'accumulent, mais personne ne peut confirmer les versions installées qui ont reçu le bundle JavaScript, les cohortes qui ont exécuté la voie brisée, ou si une tentative silencieuse cache la failure. Le CTO veut des données d'adoption, le responsable de la protection des données veut un DPIA, et l'ingénieur en charge veut savoir si le rollback a atteint les utilisateurs.
Cette situation met en évidence l'objectif du suivi du comportement d'application. Il ne s'agit pas seulement d'un tableau de bord de croissance ou d'un débat sur la protection des données. Pour les équipes qui délivrent des applications Capacitor et Electron dans des flottes de dispositifs fragmentées, le suivi est un système d'ingénierie pour reconstruire le comportement, valider les mises à jour, détecter les régressions et prouver que la collecte reste contrôlée. Les détails d'implémentation comptent, des schémas d'événements et des files d'attente durables aux règles de sampling, au stockage régional et à la récupération d'incident.
Table des matières
- Why App Behavior Tracking Matters in 2026
- Quel Sens Réel de Suivi du Comportement des Applications
- Comparaison des principaux approches de suivi
- Architecture et schémas d'événements pour les applications mobiles et de bureau
- Échantillonnage et compromis de performance
- La confidentialité et la conformité comme contrainte de conception
- Indicateurs, Tableaux de bord et Alertes Qui Vraiment Aident
- Meilleures pratiques et un plan de récupération d'incident
Why App Behavior Tracking Matters in 2026
Un rapport de panne peut vous dire que la mise en paiement a échoué. Il ne vous dira généralement pas si l'échec venait d'un bundle web obsolète, d'une limite de plugin natif, d'un processus de rendu particulier ou d'un boucle de réessai qui a finalement réussi. Sans contexte comportemental, l'équipe doit corriger les tickets de support, les journaux de publication et les preuves partielles du serveur à la main.
La première question utile après une mise à jour OTA est souvent simple : les utilisateurs ciblés ont-ils reçu et exécuté la mise à jour ? Pour y répondre, il faut plus qu'une chaîne de version. Vous avez besoin de la coquille native installée, du bundle JavaScript actif, du canal d'actualisation, du résultat de lancement, de la plateforme de périphérique et d'événements commerciaux significatifs autour de la trajectoire affectée. Un téléchargement réussi ne prouve pas une activation réussie, et un bundle activé ne prouve pas que l'utilisateur a atteint l'écran réparé.
Règle pratique : Suivez l'état de la mise à jour et le résultat de l'utilisateur comme des familles d'événements distinctes. La combinaison de ces deux en un seul événement « succès de mise à jour » rend l'analyse de rollback peu fiable.
Capacitor observabilité de l'application s'insère dans la pratique de production. Une pipeline utile relie les opérations de publication avec le comportement en temps de cours, afin que l'ingénieur puisse passer de « les rapports de paiement augmentent » à une requête bornée impliquant la version de l'application, la version du bundle, la plateforme, le canal et la séquence d'événements.
La contrainte de confidentialité est indissociable de ce design. Le framework d'App Tracking Transparency d'Apple, introduit en 2021, a changé le suivi d'applications croisées de l'opt-out implicite à l'opt-in explicite.. Une analyse de 2025 a constaté que la part des utilisateurs d'Apple suivables par les annonceurs aux États-Unis est passée de 72,63 % avant ATT à 17,9 % après, une baisse de 54,73 points de pourcentage (l'analyse de 9to5Mac de l'update ATT). Cette modification n'élimine pas la telemétrie de produits tiers, mais elle rend les stratégies d'identifiant, l'état de consentement et les limites d'attribution des décisions architecturales
What le suivi réel de la piste d'application signifie
Tirez le suivi de la piste d'application comme un enregistreur de données de vol pour le logiciel. Il capture ce que l'application a fait, dans quel ordre, et sous quelles conditions, afin que vous puissiez reconstruire une session après le fait au lieu de deviner à partir d'un tas de crash
Le label couvre plusieurs systèmes qui répondent à des questions différentes
Suivi des événements enregistre des faits discrets
Un événement est une occurrence nommée et structurée, comme checkout_started, payment_submitted, screen_viewed, ou bundle_activated. Un événement bien conçu transporte du contexte, y compris la version de l'application, le système d'exploitation, l'identifiant de session et l'état pertinent des fonctionnalités. Il devrait décrire quelque chose qui s'est produit, et non reproduire un objet entier à partir de la mémoire.
Le suivi des événements est excellent pour les pipelines, la vérification des mises à jour et les requêtes opérationnelles. Il manque l'ambiguïté visuelle. Si un utilisateur appuie sur un contrôle qui ressemble à être activé mais n'a pas de gestionnaire, un événement peut montrer la vue de l'écran précédent sans expliquer le problème d'interface.
La retranscription de session conserve le contexte d'interaction
La retranscription de session capte un flux visuel et d'interaction, souvent à travers des captures de l'arborescence DOM ou des vues, des gestes et l'état de navigation. Elle peut révéler du texte coupé, un comportement de focus confus ou des appuis répétés qui ne sont jamais représentés par des événements structurés.
Le compromis est l'exposition. Les données de retranscription peuvent contenir plus de contexte sensible qu'un événement soigneusement conçu, surtout lorsqu'un texte libre, des écrans de compte ou des flux de paiement ne sont pas masqués correctement. Cela dépend également de la capture et de la mise en page fiables, donc cela ne devrait pas être le seul enregistrement d'une action critique pour les affaires.
Les analyses transforme les événements en décisions
Les systèmes d'analyse agrègent les événements en pipelines, en cohortes, en chemins et en vues de rétention. Ils répondent à des questions telles que où les utilisateurs abandonnent un flux de travail ou si une mise à jour change l'adoption des fonctionnalités.
L'analytique est une interprétation postérieure, pas d'instrumentation. Si les noms d'événement varient entre mobile et bureau, le tableau de bord peut toujours s'afficher en comparant des définitions incompatibles.
Suivi des erreurs et des données de télémétrie explique la fiabilité
Suivi des erreurs capte les plantages, les exceptions, les journaux, les échecs de réseau et les traces de performances. Il répond à la question de savoir si l'application a survécu et combien de temps ont duré les opérations.
La télémétrie est souvent trop brutale pour expliquer l'intention. Une durée de API span lente compte plus lorsque cela peut être connecté à une action utilisateur comme « tentative de paiement », mais cette connexion devrait utiliser des champs de corrélation stables plutôt que de copier les données personnelles dans chaque ligne de journal.
Comparer les approches de suivi principales
La bonne choix dépend de la question, de l'exposition acceptable et de la complexité opérationnelle que l'équipe peut gérer. Le coût varie considérablement en fonction du fournisseur, de la politique de conservation, de la taille du payload et du modèle de requête, donc un prix fixe par million d'événements serait trompeur sans un contexte d'infrastructure et de fournisseur défini.
Approches de suivi à vue d'œil
| Approche | Forme de données | Latence | Cout (par 1M) | Exposition à la vie privée | Meilleur pour |
|---|---|---|---|---|---|
| Suivi d'événements | Enregistrements structurés avec des actions nommées et un contexte | Généralement en temps réel avec un retard, en fonction de la batchification | Variable, motivée par la taille du payload, l'ingestion, le stockage et le volume de requêtes | Modéré si les identifiants ou les propriétés sont excessifs | Fonnelles, adoption de version, utilisation de fonctionnalité, vérification de flux de travail |
| Replay de session | Cadres visuels, captures d'écran, gestes et métadonnées d'interaction | Souvent retardés par l'envoi et le traitement | Généralement plus lourd en termes d'opérations et de stockage car les payloads sont plus riches | Surtout lorsque les vues de texte, de formulaires ou de comptes ne sont pas masquées. | Répéter les perturbations d'interface utilisateur et les échecs d'interaction ambigu |
| Analytiques | Flux agrégés, cohortes, chemins et sorties de rétention | Dépend des traitements de la boutique ou du fournisseur | Les coûts de requête et de stockage peuvent augmenter lorsque les événements bruts sont conservés aux côtés des agrégats | Hérite de l'exposition des événements source et des jointures d'identité | Décisions de produits et analyse de comportement longitudinale |
| Suivi des erreurs et de la télémétrie | Traces de pile, journaux, spans, temps et état de l'appareil | Communément rapide pour les incidents, soumis à la file d'attente et à la disponibilité du réseau | Souvent moins élevé par enregistrement, mais les journaux à haut volume peuvent devenir coûteux | Modéré, surtout lorsque les journaux incluent des données de requête ou des entrées utilisateur. | Analyse de performances, diagnostic de crash et santé de pipeline |
La plus grande erreur est d'activer les quatre systèmes avec des schémas superposés et sans propriété. Les appels d'analytique de produit déclenchent une action purchase_completed, l'erreur émet la chaîne de pipeline payment_success, et l'outil de replay infère la fin d'une transition d'écran. Les tableaux de bord s'accordent pas, les ingénieurs passent du temps à réconcilier les définitions, et personne ne peut déclarer quel événement est autoritaire.
Définir la propriété avant d'ajouter un outil. Le produit devrait posséder les sémantiques commerciales, l'ingénierie devrait posséder les garanties de livraison et la validation de schéma, et les réviseurs de confidentialité devraient pouvoir suivre chaque champ de la capture à la suppression. Pour les équipes qui ont besoin d'une couche d'événement personnalisée explicite dans une application Capacitor Le guide du plugin de suivi d'événement personnalisé de Capgo n'est qu'une référence d'implémentation, pas un substitut pour décider de la signification de chaque événement.
Architecture et schémas d'événement pour les applications mobiles et de bureau
Une chaîne de traitement de production a quatre étapes distinctes : l'instrumentation, le tamponnage durable, le transport et l'ingestion. Garder ces limites claires empêche une panne réseau temporaire de devenir une panne d'application.
Dans une application Capacitor, l'application code devrait appeler un petit wrapper SDK plutôt qu'un fournisseur API directement. Le wrapper ajoute des champs d'enveloppe courants comme session_id, app_version, platformCela maintient les sites d'appel cohérents et donne à l'équipe un seul endroit pour masquer des champs, modifier l'échantillonnage ou désactiver un suivi de tracker endommagé.
La file d'attente doit être persistante et append-only. Un tableau en mémoire disparaît lors d'une panne ou d'une interruption de processus, exactement lorsque les preuves de diagnostic sont les plus précieuses. Stockez les événements sur le disque, marquez les tentatives d'envoi séparément et faites de l'ingestion par le serveur idempotent à l'aide d'un stable event_idLe transport peut être vidé à la reprise de l'application, à intervalles contrôlés, ou lorsque la file d'attente atteint une limite de taille, avec un recul exponentiel après les échecs.
Un enveloppe d'événement pratique
| Champ | Type | Obligatoire | Objectif |
|---|---|---|---|
event_id |
Chaîne | Oui | Déduplique les retentives pendant l'ingestion |
event_type |
Chaîne | Oui | Traite et valide l'événement |
occurred_at |
Marqueur de temps | Oui | Enregistre le temps de l'événement côté client |
session_id |
String | Oui | Regroupe les événements dans une session utilisateur sans nécessité d'identifiant personnel |
app_version |
String | Oui | Identifie la version de l'application installée |
bundle_version |
String | Facultatif | Identifie le bundle JavaScript ou web actif |
platform |
Chaîne | Oui | Discrimine iOS, Android, macOS, Windows ou un autre runtime |
consent_state |
Chaîne | Oui | Distingue iOS, Android, macOS, Windows ou un autre runtime |
properties |
Object | Facultatif | Enregistre des champs spécifiques à l'événement, validés |
network_state |
Chaîne | Facultatif | Ajoute le contexte pour la livraison et l'analyse hors ligne |
Un événement de paiement peut contenir cart_item_count et payment_provider, mais pas une adresse e-mail ou un texte de formulaire non filtré. Le serveur doit rejeter les champs inconnus ou les diriger vers la quarantaine. L'acceptation silencieuse de la dérive du schéma crée des tableaux de bord qui semblent sains tout en perdant de la signification.
Electron introduit une autre limite. Les actions de l'utilisateur se produisent normalement dans le processus de rendu, tandis que l'état du système, l'état d'actualisation, l'accès au système de fichiers et la coordination de réseau appartiennent souvent au processus principal. Utilisez un contrat IPC étroitement validé au lieu de permettre des payloads de rendu arbitraires de traverser la limite.
{
  "event_id": "evt_opaque_123",
  "event_type": "checkout_submitted",
  "occurred_at": "2026-09-18T02:14:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "bundle_version": "2026.09.18.2",
  "platform": "android",
  "consent_state": "functional",
  "properties": {
    "cart_item_count": 2,
    "payment_provider": "provider_a"
  },
  "network_state": "online"
}
Un événement de rendu Electron peut ajouter un contexte de processus sans exposer du contenu utilisateur :
{
  "event_id": "evt_opaque_789",
  "event_type": "window_action",
  "occurred_at": "2026-09-18T02:20:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "platform": "windows",
  "consent_state": "essential",
  "window_id": "window_opaque_12",
  "renderer_process_id": "renderer_opaque_34",
  "properties": {
    "action": "settings_opened"
  }
}
Capacitor les limites du plugin méritent des tests explicites. Un événement de webview peut nécessiter un pontage vers un code natif pour un stockage sécurisé, un état de périphérique ou des signaux de cycle de vie natifs. Le Capgo guide de l'infrastructure de l'application fournit un contexte architectural pertinent, mais la règle durable est la propriété locale : captez l'intention de l'interface utilisateur dans le rendu ou le webview, captez l'état de cycle de vie natif à la limite native, et corrèlez-les à travers l'enveloppe partagée.
Échantillonnage et Compromis de Performance
Sampling is a performance decision before it becomes a data science decision. Every event you drop can save serialization work, queue writes, battery, network transfer, and storage. Every event you drop can also remove evidence from an incident.
For un pipeline mobile réaliste, les événements JSON sérialisés peuvent être de 1 à 4 Koles intervalles de vidange peuvent varier de 5 à 60 secondeset une session typique peut générer des dizaines d'actions. Ces chiffres proviennent du document de cadrage, et non d'un benchmark universel, mesurez donc les tailles de charge et le comportement de vidange sur les appareils utilisés par vos utilisateurs.
Sélectionnez un échantillonnage par valeur de signal
Capturer les événements critiques pour l'entreprise à pleine fidélité. La connexion, la soumission du panier, l'activation du panier, le résultat du paiement, la panne et les modifications de consentement sont difficiles à reconstruire ultérieurement et devraient rester disponibles pour la vérité opérationnelle.
Les signaux à haute fréquence comme les cadres de rendu, les mouvements de la souris, les journaux verbeux et les mouvements du pointeur sont différents. Un échantillonnage côté client est approprié lorsque l'appareil ne peut pas se permettre de sérialiser et de mettre en file d'attente chaque occurrence. Un petit échantillon de tête pour la telemétrie de l'interface peut être utile, tandis que les erreurs et les panne devraient rester capturés à pleine fidélité.
L'échantillonnage côté serveur fonctionne mieux lorsque vous souhaitez conserver des preuves brutes temporairement mais réduire les coûts de requête. Utilisez une hache déterministe de session_id ou un identifiant utilisateur opaque approuvé pour que la session reste consistemment incluse ou exclue dans les requêtes liées. Un échantillonnage aléatoire par événement détruit l'intégrité de la séquence.
Configurez la prise de décision d'échantillonnage elle-même. Enregistrez la version de la règle, le résultat d'inclusion et la raison, puis vérifiez si l'état de la batterie, le système d'exploitation, la région ou l'état de consentement créent un point aveugle non intentionnel. L'échantillonnage adaptatif peut réduire la collecte de faible valeur sous pression thermique ou de batterie, mais il ne doit jamais réduire la capture de pannes ou de transitions de consentement.
La confidentialité et la conformité comme contrainte de conception
La confidentialité doit figurer dans le diagramme de pipeline, et non dans une liste de vérification de lancement. La première question architecturale est de savoir si le SDK est autorisé à créer ou à stocker un événement du tout. Si le consentement est requis, le SDK doit appliquer la porte avant d'écrire sur le disque, et non après que la file d'attente ait déjà retenu le payload.
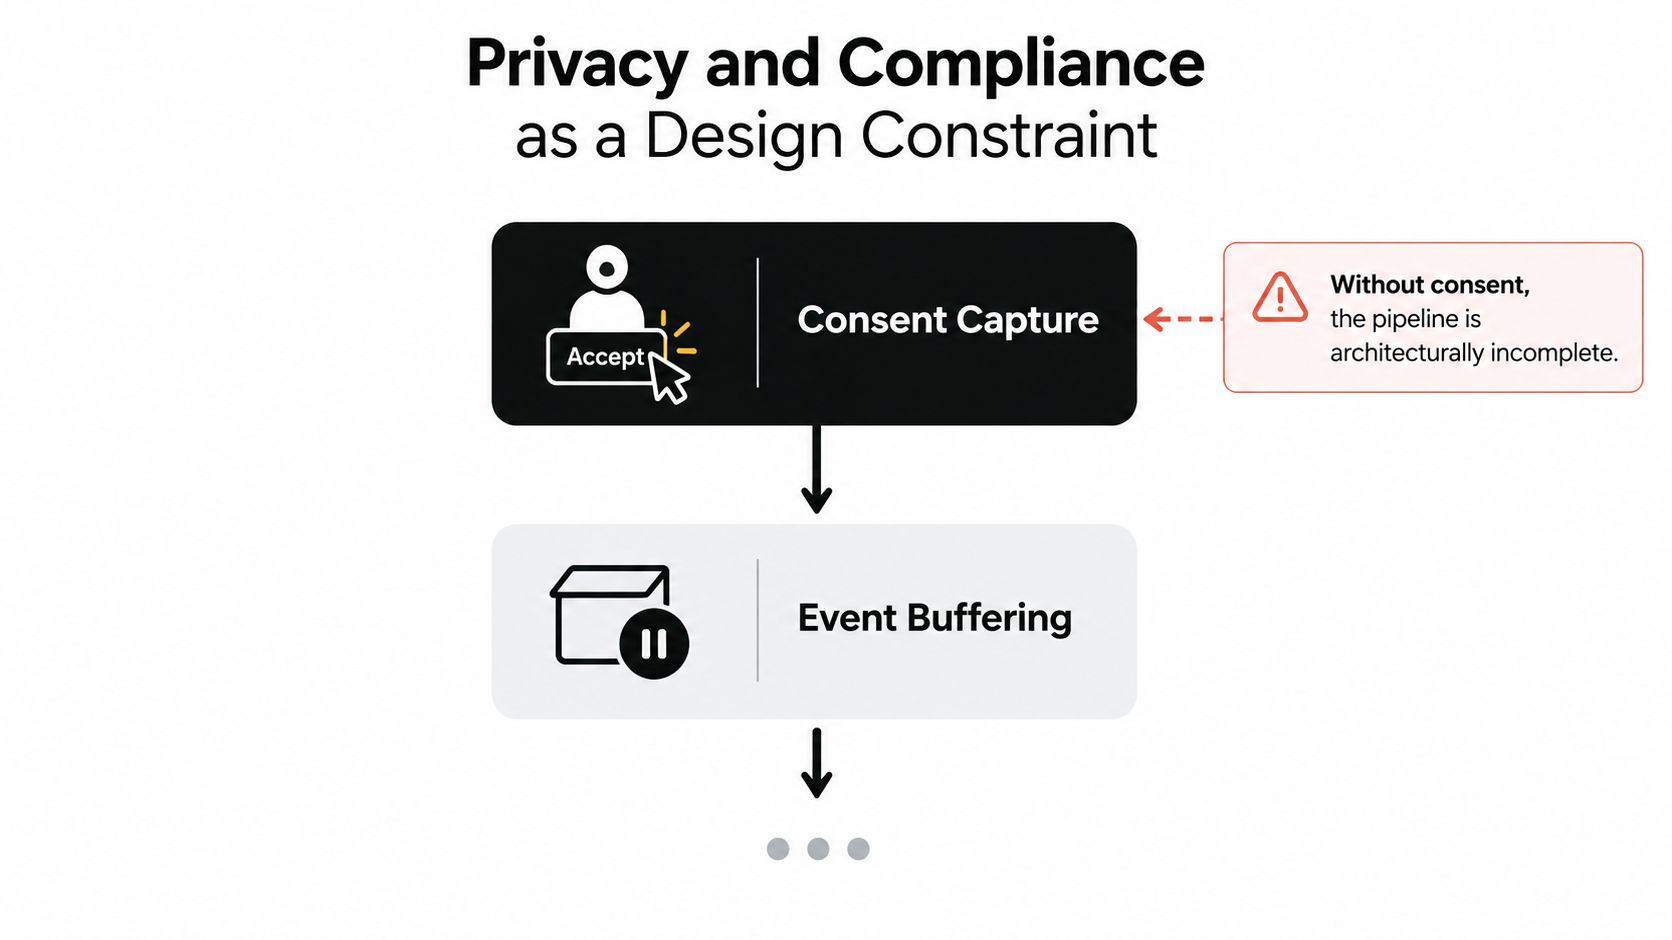
Utilisez des catégories de collecte séparées pour la fiabilité de l'essentiel, les analyses de produit fonctionnelles et les signaux de marketing optionnels. Chaque catégorie nécessite une politique claire, un interrupteur SDK et une vérification de mise en œuvre côté serveur. Cette approche rend également les audits plus faciles car les réviseurs peuvent suivre la décision de l'interface utilisateur de consentement à la buffer, au transport, au stockage et à la suppression.
Placez des contrôles à plusieurs frontières
- À l'émission : Rejetez les adresses e-mail, les numéros de téléphone, les détails de paiement et les textes libres non bornés avant que l'événement n'entre dans la file d'attente.
- À la création d'identité : Préférez les identifiants opaques et les faites tourner ou les restreignez en fonction du modèle de confidentialité du produit. N'oubliez pas que les identifiants de dispositif ne sont pas innocents parce qu'ils ne sont pas des noms.
- Atteindre l'ingestion : Validez les types de champs, les valeurs autorisées, l'état de consentement et les métadonnées de routage régional. La validation côté serveur est une défense en profondeur, pas une permission de collecter sans soin sur le client.
- Au stockage : Conservez les événements bruts pendant une fenêtre opérationnelle limitée, conservez les agrégats plus longtemps que nécessaire et appliquez la règle de conservation la plus stricte aux sessions de relecture car les enregistrements visuels comportent une exposition plus grande.
- Atteindre la suppression : Assurez-vous que les demandes de suppression se propagent à travers le stockage chaud, le stockage froid, les tables dérivées, les caches et les systèmes de relecture. Un tableau qui disparaît ne prouve pas que le registre sous-jacent a été supprimé.
La routage régional est également une préoccupation de système. Déterminez la région applicable à partir d'un signal stable et documenté, puis envoyez l'événement à un point d'entrée d'ingestion et à un emplacement de stockage soumis à la politique requise. Les équipes examinant le site web et les obligations de consentement peuvent utiliser ce guide de Coto & Waddington sur la confidentialité du site web Guide de confidentialité du site web de Coto & Waddington en tant que ressource juridique pratique, tout en obtenant des conseils spécifiques à leur produit et à leurs juridictions.
La plateforme impose des règles qui renforcent la nécessité de cette séparation. Les rapports de l'industrie situent l'opt-in global ATT autour 27% à 38% en un benchmark de 2026, avec les États-Unis autour de 31%, le Japon autour de 38%, l'Allemagne autour de 24%, et le Royaume-Uni autour de 26% (résumé de l'industrie de la traçabilité Apple). La boîte à outils de confidentialité de l'Android, Sandbox Attribution Reporting, déplace également la mesure publicitaire vers un rapport agrégé plutôt qu'avec des identifiants de parti, comme décrit dans cette analyse mobile et de confidentialité. Pour les équipes d'implémentation, Capacitor GDPR compliance guidance est utile uniquement lorsqu'il est traduit en SDK applicables et en comportement d'ingestion.
Indicateurs, Tableaux de bord et Alertes qui Vraiment Aident
A tracking pipeline earns its place when it changes an engineering or product decision. Start with three views, adoption, quality, and pipeline health, then give each audience a dashboard that answers its own questions without redefining the underlying events.
Métriques d'adoption Suivi de l'utilisation active hebdomadaire, adoption du bundle par canal, entrée de fonctionnalité et complétion du canal. Mesures de qualité sessions sans crash, requêtes échouées, erreurs de paiement, et latence côté client. Mesures de pipeline include queue depth, upload success, ingestion latency, schema rejection, consent-gate decisions, and regional routing failures.
Mesures, signaux et modèles d'alerte
| Catégorie de mesure | Exemple de mesure | Seuil de santé | Modèle d'alerte |
|---|---|---|---|
| Adoption | Utilisateurs actifs sur la version de bundle prévue | Défini par le propriétaire de la version et le plan de déploiement | Alerte lorsque l'adoption s'arrête au-delà de la fenêtre d'observation planifiée |
| Qualité | Taux de session sans crash | Par exemple, ci-dessus 99,5 % sur 30 minutesune limite spécifiée dans le document d'opération | Suivi de l'activité de l'application avec plateforme, version de l'application et canal de mise à jour associés |
| Funnel | Conversion de l'étape de paiement | Comparé à la base de référence approuvée pour le même groupe | Alerte sur une déviation soutenue et spécifique au groupe plutôt qu'une intervalle bruyant |
| Pipeline | Latence d'ingestion du client P95 | Définit dans l'objectif du service pour le chemin d'ingestion | Notifier le propriétaire des données ou de la plateforme lorsque l'objectif est constamment enfreint |
| Qualité des données | Taux de rejet de schéma | Presque zéro pour les versions d'événement publiées | Ouvrir un incident lorsque le type d'événement ou la version de l'application provoque un modèle de rejet soudain |
Le 99,5% d'exemple de session sans crash Les tableaux de bord d'ingénierie devraient afficher la version de publication, le plateau, l'état de la file d'attente, les erreurs de transport, la latence d'ingestion et les échecs de schéma. Les tableaux de bord de produits devraient afficher l'adoption, la conversion, les chemins et la rétention. Les deux vues devraient utiliser les mêmes contrats d'événement. Le
Engineering dashboards should show release version, platform, queue state, transport errors, ingestion latency, and schema failures. Product dashboards should show adoption, conversion, paths, and retention. Both views should use the same event contracts. The Guide de suivi de la performance de Capacitor propose une référence ciblée pour relier les signaux de runtime à la surveillance opérationnelle.
Meilleures Pratiques et un Plan de récupération d'incident
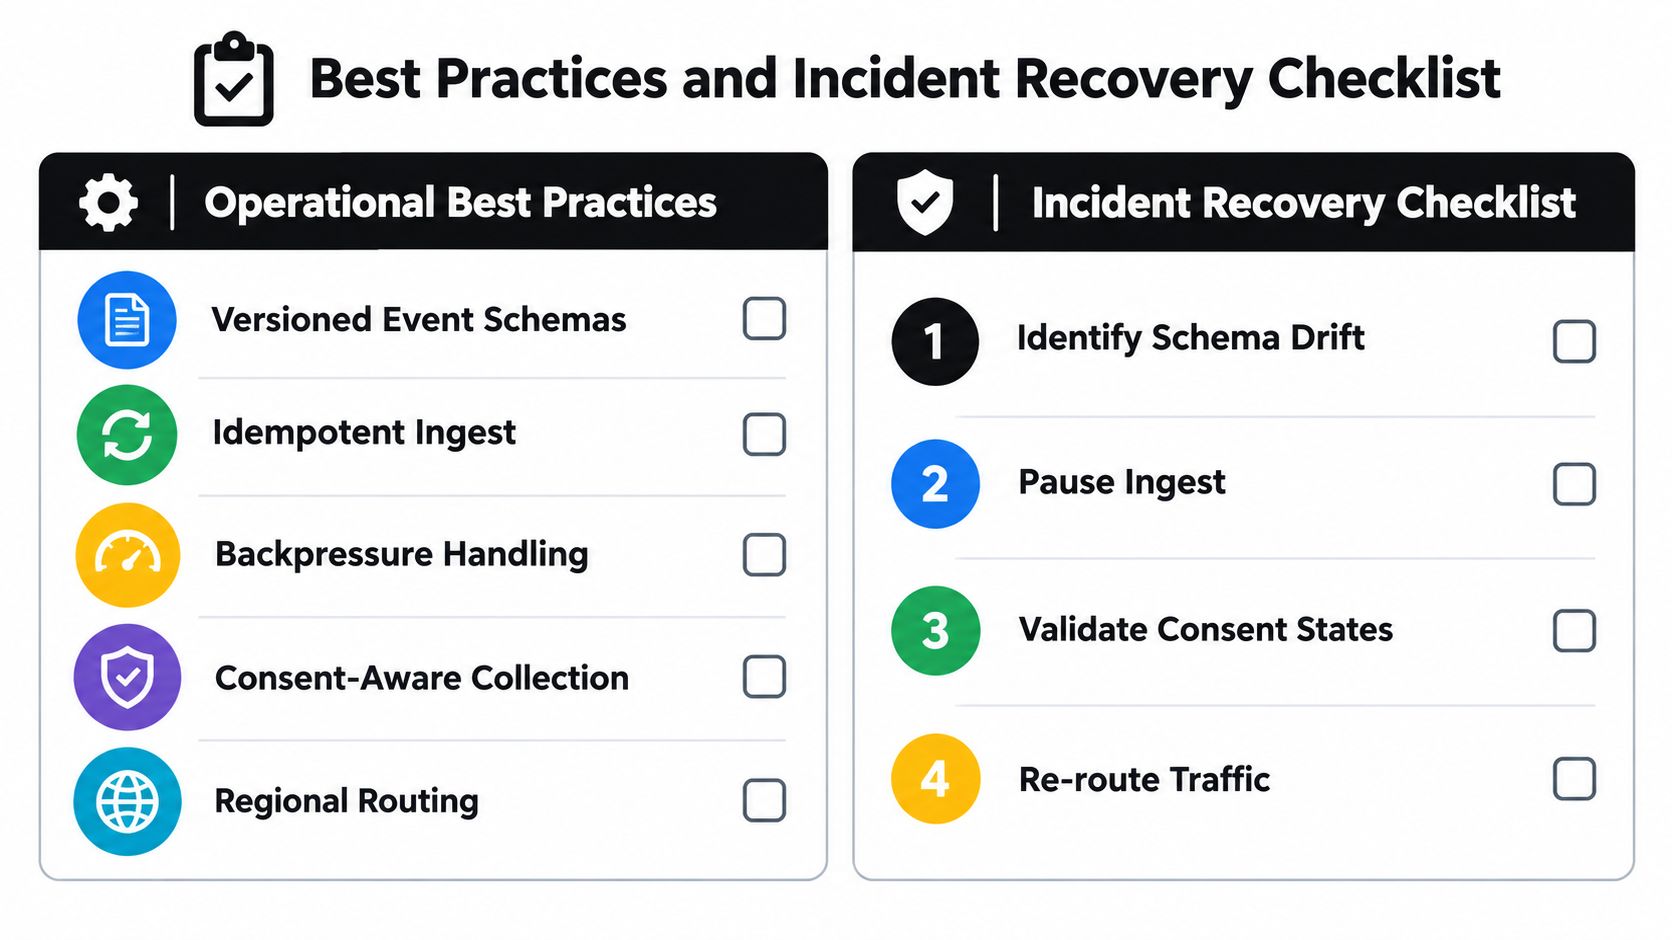
Un système de suivi fiable est principalement composé de mesures de sécurité ennuyeuses. Versionnez chaque contrat d'événement, faites l'ingestion idempotente, gérez la pression arrière explicitement, exigez le consentement avant le tamponnage, et dirigez les données en fonction de la politique. Ces contrôles comptent plus que d'ajouter un autre tableau de bord car ils déterminent si les données restent fiables pendant une mise à jour ou une panne.
Plan de vérification opérationnelle
- Schémas versionnés : Publiez les contrats d'événements avec les champs requis, les propriétés autorisées, les propriétaires et les règles de compatibilité.
- Ingénierie idempotente : Dédoublonnez par
event_id, surtout lorsque les clients réessayent après des temps d'attente ou des redémarrages du processus. - Gestion de la pression arrière : Croissance de la file d'attente, maintenir la priorité pour les plantages et les actions critiques, et exposer les décisions de décharge en tant que télémétrie.
- Collecte consciente : Appliquez le consentement avant la persistance et réévaluez les événements en attente lors d'un changement de consentement.
- Navigation régionale : Résolvez la région tôt, routez de manière déterministe et testez le comportement de stockage et de suppression dans chaque emplacement pris en charge.
Plan de récupération d'incident
- Détectez et classez. Comparez le signal en fonction de la version de l'application, de la version du paquet, de la plateforme, du canal et de l'état de consentement. Un changement soudain isolé à un seul paquet peut indiquer un dérive de schéma ou une mise à jour de version SDK brisée, tandis qu'un changement large peut refléter un comportement réel ou une mise à jour de politique.
- Triez la file d'attente. Vérifiez la profondeur de la file d'attente du client, les échecs d'envoi, la latence d'ingestion, les champs rejetés et les taux de doublons. Mettez en pause ou mettez en quarantaine le type d'événement affecté si des payloads malformés polluent les systèmes aval.
- Mitigez en toute sécurité. Désactivez le suivi échoué à l'aide d'un drapeau de fonctionnalité contrôlé à distance lorsque possible, ou annulez le paquet de suivi sans modifier les produits code non liés. N'effacez pas les preuves avant de conserver la file d'attente pertinente et les enregistrements serveur conformément à la politique de conservation approuvée.
- Vérifiez l'état de confidentialité. Confirmez que les décisions de consentement, la routage régional, la rature et les chemins de suppression fonctionnent toujours comme conçus. Un incident de suivi peut être un incident de confidentialité même lorsque la fonctionnalité du produit fonctionne bien.
- Reprenez et apprenez. Rejouez uniquement les événements validés et dédupliqués à partir de tampons durables. Écrivez un post-mortem sans reproche qui enregistre le déclencheur, la lacune de détection, le schéma affecté, l'action de récupération et les changements de pipeline ou de test concrets.
Lorsque les ingénieurs en charge peuvent faire confiance au contrat d'événement, les équipes de produit peuvent interpréter les mêmes faits et les réviseurs de confidentialité peuvent suivre chaque champ à travers le système. Si vous envoyez des applications Capacitor ou Electron et avez besoin d'une livraison contrôlée de bundles JavaScript avec l'adoption de la mise à jour, la défaillance, les journaux de dispositif, la ciblage de canal et la visibilité de la mise à l'arrière-plan, visitez Capgo pour évaluer comment sa plateforme de mise à jour en temps réel peut s'adapter à votre pipeline de suivi. Commencez par cartographier un workflow de mise à jour critique, puis connectez son état de mise à jour, son issue de runtime et son chemin de récupération avant d'élargir la couverture.



