
A mezzanotte, un leader mobile invia un fix via aria dopo che una regressione Capacitor ha rotto il checkout su Android. Al mattino, le richieste di supporto si accumulano, ma nessuno può confermare quali versioni installate hanno ricevuto il pacchetto JavaScript, quali cohort hanno eseguito la rotta rotta o se un tentativo silenzioso sta nascondendo il fallimento.
Quella situazione esporrebbe lo scopo del tracciamento del comportamento delle app. Non è solo un dashboard di crescita o un dibattito sulla privacy. Per gli squadre che distribuiscono Capacitor e le app Electron in flotte di dispositivi frammentate, il tracciamento è un sistema di ingegneria per ricostruire il comportamento, validare le rilasci, rilevare le regressioni e dimostrare che la raccolta rimane controllata.
Elenco dei contenuti
- Why App Behavior Tracking Matters in 2026
- What App Behavior Tracking Actually Means
- Confrontare le principali strategie di tracciamento
- Architettura e schemi degli eventi per applicazioni mobili e desktop
- Campionamento e compromessi di prestazioni
- La privacy e la conformità come vincolo di progettazione
- Metriche, Pannelli di Controllo e Avvisi che Funzionano Effettivamente
- Pratiche Consigliate e un Checklist di Recupero da Incidenti
Why App Behavior Tracking Matters in 2026
Un rapporto di crash potrebbe dirti che il checkout è fallito. Di solito non ti dirà se il fallimento è venuto da un bundle web obsoleto, da una barriera di plugin nativo, da un processo di rendering particolare o da un ciclo di retry che alla fine è riuscito.
La prima domanda utile dopo un rilascio OTA è spesso semplice: La prima domanda utile dopo un rilascio OTA è spesso semplice: Answering it requires more than a version string. You need the installed native shell, active JavaScript bundle, update channel, launch result, device platform, and meaningful business events around the affected flow. A successful download doesn’t prove a successful activation, and an activated bundle doesn’t prove that a user reached the repaired screen.
Regola pratica: Un download riuscito non prova un'attivazione riuscita, e un bundle attivato non prova che l'utente abbia raggiunto la schermata riparata.
Capacitor osservabilità dell'app si integra nella pratica di produzione. Una utile pipeline collega le operazioni di rilascio con il comportamento in esecuzione, quindi un ingegnere può passare da “le relazioni di controllo aumentano” a una query limitata che coinvolge la versione dell'app, la versione del pacchetto, la piattaforma, il canale e la sequenza degli eventi.
La restrizione sulla privacy è inseparabile da quel design. Il framework di trasparenza dell'app di Apple, introdotto nel 2021, ha cambiato il tracking cross-app da implicito opt-out a explicit opt-in.. Un'analisi del 2025 ha trovato che la quota degli utenti Apple tracciabili dagli annunciatori negli Stati Uniti è scesa da 72,63% prima dell'ATT a 17,9% dopouna riduzione di 54,73 punti percentuali (l'analisi di 9to5Mac dell'aggiornamento ATTQuella modifica non elimina la telemetria dei prodotti di prima parte, ma rende strategie di identificazione, stato di consenso e confini di attribuzione decisioni architettoniche.
What App Behavior Tracking Actually Means
Treat app behavior tracking like a registrazione dei dati di volo per softwareRaccoglie cosa l'applicazione ha fatto, in che ordine e con quali condizioni, in modo da poter ricostruire una sessione dopo il fatto al posto di indovinare da un stack di crash.
La label copre diversi sistemi che rispondono a domande diverse.
La tracciatura degli eventi registra fatti discreti
Un evento è una occorrenza nominata e strutturata, come checkout_started, payment_submitted, screen_viewedo bundle_activated. Un evento ben progettato porta contesto, incluso la versione dell'app, la piattaforma, l'identificatore della sessione e lo stato delle feature pertinenti. Dovrebbe descrivere qualcosa che è accaduto, non riprodurre un oggetto intero dalla memoria.
La tracciatura degli eventi è eccellente per i flussi, la verifica delle rilasci e le query operative. Manca l'ambiguità visiva. Se un utente clicca su un controllo che sembra abilitato ma non ha un gestore, un evento può mostrare la schermata precedente senza spiegare il problema dell'interfaccia.
Session replay preserves interaction context
La riproduzione della sessione cattura un flusso visivo e di interazione, spesso attraverso snapshot del DOM o della vista, gesti e stato di navigazione. Può rivelare testo tagliato, comportamento di focus confuso o tap ripetuti che gli eventi strutturati non rappresentano mai.
La contrapposizione è l'esposizione. I dati di riproduzione possono contenere più contesto sensibile di un evento ben progettato, specialmente quando il testo libero, le schermate degli account o le flussi di pagamento non sono mascherati correttamente. Dipende anche dalla cattura e dalla rendering affidabili, quindi non dovrebbe essere l'unico registro di un'azione critica per l'azienda.
Analytics trasforma gli eventi in decisioni
Le sistemi di analisi aggregano gli eventi in flussi, cohort, percorsi e viste di retention. Rispondono a domande come dove gli utenti abbandonano un workflow o se un rilascio modifica l'adozione di una feature.
La analisi è l'interpretazione downstream, non l'instrumentazione. Se i nomi degli eventi si spostano tra mobile e desktop, il dashboard potrebbe ancora caricare mentre confronta definizioni incompatibili.
Rilevamento errori e telemetria spiega affidabilità
Raccolta errori rileva crash, eccezioni, log, fallimenti di rete e tracce di prestazioni. Risponde se l'applicazione sia sopravvissuta e quanto tempo abbiano impiegato le operazioni.
La telemetria è spesso troppo grossolana per spiegare l'intento. Una span lenta API conta più quando può essere collegata a un'azione dell'utente come “tentativo di checkout”, ma quella connessione dovrebbe utilizzare campi di correlazione stabili piuttosto che copiare i dati personali in ogni riga di log.
Confrontare le Approcci di Tracciamento Principali
La scelta giusta dipende dalla domanda, dall'esposizione accettabile e da quanto complessità operativa il team può gestire. Il costo varia ampiamente a seconda del fornitore, della politica di retention, del peso del payload e del modello di query, quindi un prezzo fisso per milioni di eventi sarebbe ingannevole senza un contesto di infrastruttura e fornitore definito.
Approcci di Tracciamento alla vista
| Approccio | Forma dei dati | Latenza | Costo (per 1M) | Esposizione della privacy | Migliore per |
|---|---|---|---|---|---|
| Tracciamento degli eventi | Record strutturati con azioni denominate e contesto | Solitamente vicino a tempo reale o ritardato, a seconda della batch | Variabile, guidata da dimensione del payload, ingestione, archiviazione e volume di query | Moderato se gli identificatori o le proprietà sono eccessivi | Canali, adozione di rilascio, utilizzo di feature, verifica del workflow |
| Riproduzione della sessione | Frame visivi, snapshot, gesti e metadati di interazione | Spesso ritardato da caricamento e elaborazione | Solitamente maggiore onere operativo e di archiviazione a causa di payload più ricchi | Alto, soprattutto quando testi, formulari o viste account non sono mascherati | Riproducendo la resistenza dell'interfaccia e gli insuccessi di interazione ambigui |
| Analitica | Canali aggregati, cohorti, percorsi e output di mantenimento | Dipende dal trattamento del magazzino o del fornitore | I costi di query e archiviazione possono crescere quando gli eventi crudi sono conservati insieme agli aggregati | Ereditano l'esposizione dagli eventi di origine e dalle unioni di identità | Decisioni di prodotto e analisi del comportamento a lungo termine |
| Tracciamento degli errori e delle telemetrie | Tracce di stack, log, span, tempi e stato dispositivo | Comunemente veloci per gli incidenti, soggetti a coda e disponibilità di rete | Spesso più basso per registro, ma i log ad alto volume possono diventare costosi | Moderare, soprattutto quando i log includono dati di richiesta o input dell'utente | Diagnosi di crash, analisi di prestazioni e salute della pipeline |
Il errore più comune è abilitare tutti e quattro i sistemi con schemi sovrapposti e nessuna proprietà. Le analisi di prodotto chiamano un'azione purchase_completedl'errore della pipeline emette payment_successe lo strumento di riproduzione inferisce la completamento da una transizione di schermo. I dashboard discordano, gli ingegneri passano del tempo a riconciliare le definizioni, e nessuno può affermare quale evento è autoritativo
Definisci la proprietà prima di aggiungere uno strumento. Il prodotto dovrebbe possedere la semantica commerciale, l'ingegneria dovrebbe possedere le garanzie di consegna e la validazione dello schema, e i revisori di privacy dovrebbero poter tracciare ogni campo da cattura a cancellazione. Per le squadre che hanno bisogno di un layer di eventi personalizzati esplicito in un'applicazione Capacitor Capgo’s custom event tracking plugin guide è un riferimento di implementazione, non un sostituto per decidere cosa significa ogni evento
Architettura e schemi di eventi per applicazioni mobili e desktop
Una pipeline di produzione ha quattro fasi distinte: instrumentazione, buffering duraturo, trasporto e ingestioneTenere chiare queste frontiere impedisce un'interruzione di rete temporanea di diventare un fallimento dell'applicazione
In un'app Capacitor, l'applicazione code dovrebbe chiamare un piccolo wrapper SDK anziché un vendor API direttamente. session_id, app_version, platformEsegue chiamate coerenti e mantiene lo stato di consenso. Ciò consente alla squadra di redigere campi, modificare la campionatura o disabilitare un tracker rotto in un solo posto.
La coda dovrebbe essere persistente e append-only. Un array in memoria scompare durante un crash o un kill del processo, proprio quando l'evidenza diagnostica è più preziosa. Archivia gli eventi su disco, segna gli tentativi di upload separatamente e rendi l'ingestione del server idempotente attraverso un __CAPGO_KEEP_4__ stabile. event_id. Il trasporto può svuotare l'applicazione di ripresa, a un intervallo controllato o quando la coda raggiunge un limite di dimensione, con backoff esponenziale dopo gli errori.
Un envelope di evento pratico
| Campo | Tipo | context | Purpose |
|---|---|---|---|
event_id |
Richiesto | Scopo | Deduplicates retries during ingestion |
event_type |
String | Sì | Riconosce e valida l'evento |
occurred_at |
Timestamp | Sì | Registra l'ora dell'evento sul lato del client |
session_id |
String | Sì | Gruppa gli eventi in una sessione utente senza richiedere un identificatore personale |
app_version |
String | Sì | Identifica la versione di rilascio dell'applicazione installata |
bundle_version |
String | Facoltativo | Identifica il bundle JavaScript o web attivo |
platform |
String | Sì | Distingue iOS, Android, macOS, Windows o un altro runtime |
consent_state |
String | Sì | Applica la politica di raccolta prima del buffering e dell'upload |
properties |
Oggetto | Facoltativo | Raccoglie campi specifici e validati per evento |
network_state |
String | Facoltativo | Aggiunge contesto per la consegna e l'analisi offline |
Un evento di checkout potrebbe contenere cart_item_count e payment_provider, ma non un indirizzo email o un testo di form non filtrato. Il server dovrebbe rifiutare i campi sconosciuti o inviarli in quarantena. L'accettazione silenziosa della deriva dello schema crea dashboard che sembrano sane mentre perdono significato.
Electron introduce un altro confine. Le azioni degli utenti si verificano normalmente nel processo renderer, mentre lo stato del sistema, lo stato di aggiornamento, l'accesso al file system e la coordinazione della rete spesso appartengono al processo principale. Utilizzare un contratto IPC ristretto e validato al posto di consentire ai payload renderer arbitrari di attraversare il confine.
{
  "event_id": "evt_opaque_123",
  "event_type": "checkout_submitted",
  "occurred_at": "2026-09-18T02:14:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "bundle_version": "2026.09.18.2",
  "platform": "android",
  "consent_state": "functional",
  "properties": {
    "cart_item_count": 2,
    "payment_provider": "provider_a"
  },
  "network_state": "online"
}
Un evento renderer di Electron può aggiungere contesto di processo senza esporre il contenuto dell'utente:
{
  "event_id": "evt_opaque_789",
  "event_type": "window_action",
  "occurred_at": "2026-09-18T02:20:00Z",
  "session_id": "sess_opaque_456",
  "app_version": "4.8.1",
  "platform": "windows",
  "consent_state": "essential",
  "window_id": "window_opaque_12",
  "renderer_process_id": "renderer_opaque_34",
  "properties": {
    "action": "settings_opened"
  }
}
Capacitor i confini dei plugin meritano test espliciti. Un evento webview potrebbe richiedere un ponte per il code nativo per il storage sicuro, lo stato dispositivo o i segnali di ciclo di vita nativi. Il Capgo guida dell'infrastruttura dell'app fornisce contesto architettonico rilevante, ma la regola duratura è la proprietà locale: cattura l'intento dell'interfaccia utente nel renderer o webview, cattura lo stato di ciclo di vita nativo al confine nativo e correlarli attraverso l'enveloppe condivisa.
Compromessi di campionamento e prestazioni
La raccolta di dati è una decisione di prestazioni prima che diventi una decisione di scienza dei dati. Ogni evento che si abbandona può risparmiare lavoro di serializzazione, scrittura in coda, batteria, trasferimento di rete e archiviazione. Ogni evento che si abbandona può anche eliminare la prova di un incidente.
Per una pipeline mobile realistica, gli eventi JSON serializzati possono essere da 1 a 4 KB, gli intervalli di pulizia possono variare da da 5 a 60 secondi, e una sessione tipica può generare decine di azioni. Queste cifre provengono dalla nota di implementazione, non da un benchmark universale, quindi misura le dimensioni dei payload e il comportamento di pulizia sui dispositivi utilizzati dai tuoi utenti.
Scegliere campionamento per valore di segnale
Cattura gli eventi critici per l'azienda con fedeltà completa. L'accesso, la sottoscrizione del checkout, l'attivazione del pacchetto, il risultato del pagamento, il crash e i cambiamenti di consenso sono difficili da ricostruire in seguito e dovrebbero rimanere disponibili per la verità operativa.
I segnali di alta intensità come le righe di rendering, il movimento del cursore, i log verbosi e il movimento del puntatore sono diversi. La raccolta di dati client-side è appropriata quando il dispositivo non può permettersi di serializzare e mettere in coda ogni occorrenza. Un piccolo campione di test per la telemetria UI può essere utile, mentre gli errori e i crash dovrebbero rimanere completamente catturati.
Server-side sampling funziona meglio quando desideri preservare la prova originale temporaneamente ma ridurre il costo della query. Utilizza un hash deterministico di session_id Ogni sessione rimane coerentemente inclusa o esclusa attraverso tutte le query correlate. La campionamento casuale per evento distrugge l'integrità della sequenza.
Strumentare la decisione di campionamento stessa. Memorizza la versione della regola, il risultato di inclusione e la ragione, quindi controlla se lo stato della batteria, la piattaforma, la regione o lo stato di consenso creano un punto cieco non voluto. Il campionamento adattivo può ridurre la raccolta di basso valore sotto pressione termica o di batteria, ma non deve mai ridurre la cattura di fallimenti o transizioni di consenso.
La privacy e la conformità come vincolo di progettazione
La privacy appartiene al diagramma del flusso, non a un elenco di controllo di lancio. La prima domanda architettonica è se il SDK è autorizzato a creare o a memorizzare un evento in alcun modo. Se è richiesta la consenso, il SDK deve applicare la porta di controllo prima di scrivere su disco, non dopo che una coda ha già trattenuto il payload.
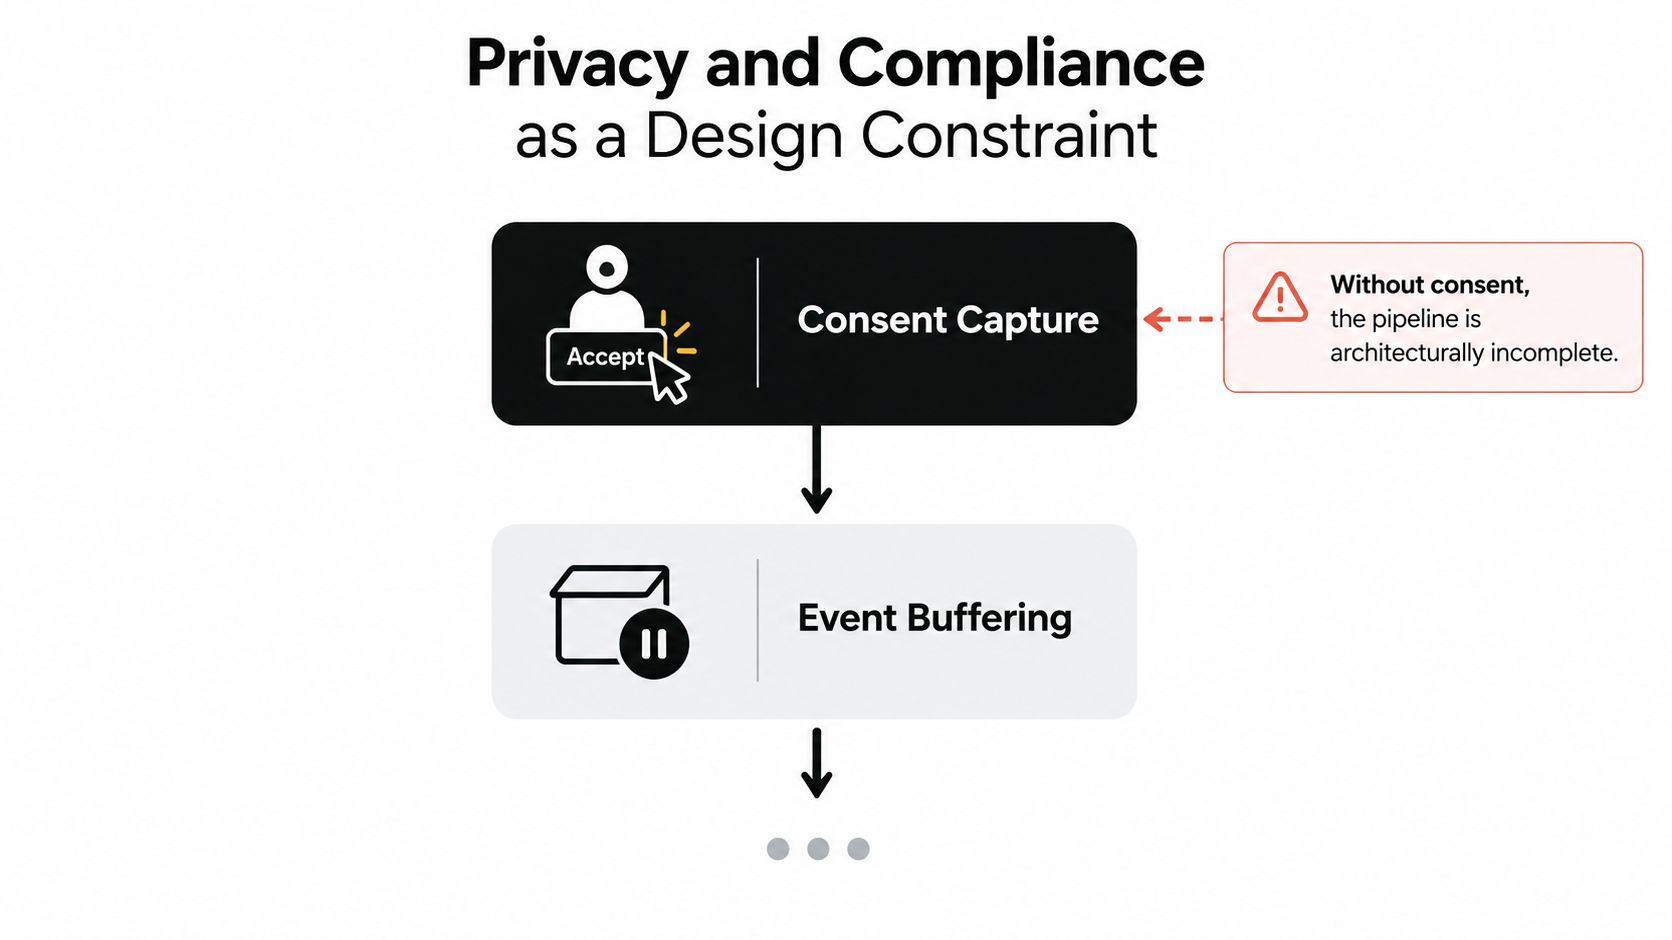
Usa categorie di raccolta separate per la telemetria di affidabilità essenziale, l'analitica del prodotto funzionale e i segnali di marketing facoltativi. Ogni categoria ha bisogno di una chiara politica, di un interruttore SDK e di un controllo di esecuzione server-side. Questo approccio rende anche le verifiche più facili perché i revisori possono seguire la decisione dalla UI di consenso al buffer, al trasporto, allo storage e alla cancellazione.
Colloca i controlli a più frontiere
- Al momento dell'emissione: Rifiuta indirizzi email, numeri di telefono, dettagli di pagamento e testo libero non vincolato prima che un evento entri nella coda.
- Al momento della creazione dell'identità: Prefer identificatori opachi e ruotarli o limitarli in base al modello di privacy del prodotto. Non considerare un identificatore di dispositivo inoffensivo solo perché non è un nome.
- At ingestione: Verificare i tipi di campo, i valori consentiti, lo stato di consenso e i metadati di routing regionale. La validazione del server è una difesa in profondità, non un permesso per raccogliere dati in modo negligente sul client.
- At archiviazione: Conservare gli eventi raw per un periodo di tempo operativo limitato, mantenere gli aggregati per un periodo più lungo solo quando giustificato e applicare la regola di conservazione più rigorosa al replay delle sessioni perché i registri visivi comportano una maggiore esposizione.
- At cancellazione: Far propagare le richieste di cancellazione attraverso il storage caldo, il storage freddo, le tabelle derivate, i cache e i sistemi di replay. Un dashboard che scompare non dimostra che il record sottostante è stato cancellato.
La routing regionale è anche una preoccupazione di sistema. Determinare la regione applicabile da un segnale stabile e documentato, quindi inviare l'evento a un endpoint di ingestione e a un luogo di archiviazione governato dalla politica richiesta. Le squadre che stanno esaminando il sito web e le obbligazioni di consenso circostanti possono utilizzare questo Guida alla privacy del sito di Coto & Waddington come una risorsa legale pratica, mentre ottengono ancora consigli specifici per il loro prodotto e giurisdizioni.
Il regolamento del platform rafforza la necessità di questa separazione. La segnalazione dell'industria colloca l'opt-in globale ATT intorno 27% a 38% In un benchmark del 2026, con gli Stati Uniti circa 31%, il Giappone circa 38%, la Germania circa 24%, e il Regno Unito circa 26% (industry summary of Apple tracking behavior). Il Sandbox di Privacy di Android per la Rilevazione di Attribuzione si sposta verso la rilevazione aggregata anziché gli identificatori di partito, come descritto in questa analisi di analytics mobili e privacy. Per i team di implementazione, Capacitor GDPR compliance guidance è utile solo quando tradotto in comportamenti di ingestione forzati SDK.
Metriche, Pannelli di Controllo e Avvisi che Funzionano Effettivamente
A tracking pipeline earns its place when it changes an engineering or product decision. Start with three views, adoption, quality, and pipeline health, then give each audience a dashboard that answers its own questions without redefining the underlying events.
Metriche di adozione includere l'utilizzo settimanale, l'adozione del pacchetto per canale, l'ingresso delle funzionalità e la completamento del canale. Metriche di qualità Includono sessioni senza crash, richieste fallite, errori di checkout e latenza client-side. Metriche di pipeline Rilevamento profilo applicazione: profondità coda inclusa, successo upload, ritardo ingestione, rifiuto schema, decisioni consenso, e fallimenti routing regionale.
Metriche, segnali e modelli di allarme
| Categoria di metrica | Esempio di metrica | Livello di soglia di salute | Modello di allarme |
|---|---|---|---|
| Adozione | Utenti attivi sulla versione del pacchetto destinata | Definito dal proprietario di rilascio e dal piano di distribuzione | Avviso quando l'adozione si ferma oltre la finestra di osservazione pianificata |
| Qualità | Tasso di sessione senza crash | Ad esempio, sopra 99,5% su 30 minutiuna soglia specificata nel verbale operativo | Page the mobile owner with platform, app version, and release channel attached |
| Funnel | Conversione del passaggio di checkout | Confrontato con il baseline approvato per la stessa cohort | Avviso su una deviazione sostenuta, specifica della cohort, piuttosto che su un intervallo rumoroso |
| Pipeline | P95 latenza di ingestione del client | Definito nell'obiettivo del servizio per la via di ingestione | Informare il proprietario dei dati o della piattaforma quando l'obiettivo viene violato continuamente |
| Qualità dei dati | Tasso di rifiuto dello schema | Pressoché zero per le versioni di evento rilasciate | Aprire un incidente quando un nuovo tipo di evento o una versione di app causa un modello di rifiuto improvviso |
Il Esempio di sessione crash-free al 99,5% E il framing della latenza P95 proviene dalle esigenze operative in questo breve, non da un standard universale. Il vostro team dovrebbe registrare il proprietario, la finestra di valutazione, il punto di riferimento e il runbook accanto a ogni allarme. Una soglia senza un percorso di risposta è decorazione della dashboard.
I dashboard di ingegneria dovrebbero mostrare la versione di rilascio, la piattaforma, lo stato della coda, gli errori di trasporto, la latenza di ingestione e gli errori di schema. I dashboard dei prodotti dovrebbero mostrare l'adozione, la conversione, le vie e la retention. Entrambe le viste dovrebbero utilizzare gli stessi contratti di evento. Il Guida di monitoraggio delle prestazioni Capacitor offre una riferimento focalizzato per connettere segnali di runtime a monitoraggio operativo.
Buone Pratiche e un Checklist di Recupero da Incidenti
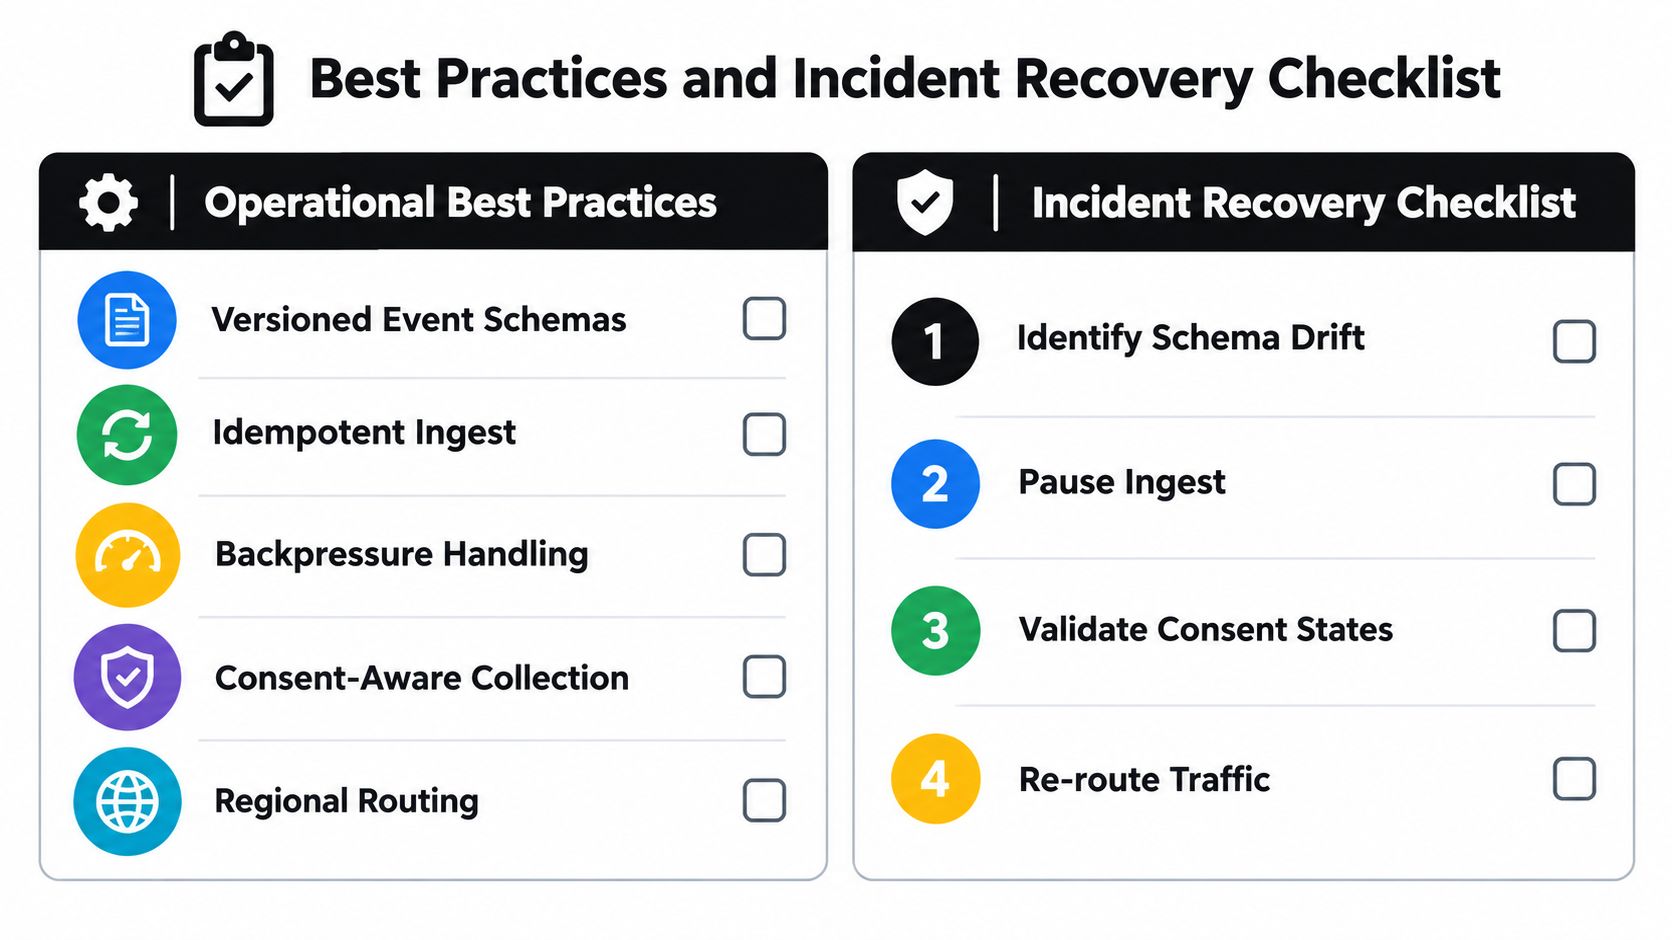
Un sistema di tracciamento affidabile è per lo più composto da misure di sicurezza noiose. Versiona ogni contratto di evento, rendi l'ingestione idempotente, gestisci la pressione di ritorno esplicitamente, imponi il consenso prima di memorizzare, e invia i dati in base a una politica. Questi controlli contano più che aggiungere un'altra dashboard perché determinano se i dati rimangono affidabili durante una rilascio o un'interruzione.
Elenco di controllo operativo.
- Schemi versionati: Pubblica contratti di evento con campi richiesti, proprietà consentite, proprietari e regole di compatibilità.
- Ingestione idempotente: Deduplica per
event_id, soprattutto quando i clienti ripetono dopo timeout o riavvio del processo. - Gestione della pressione di ritorno: Limita la crescita della coda, preserva la priorità per crash e azioni critiche per l'azienda, e esponi le decisioni di scarto come telemetria.
- Raccolta consapevole: Applica il consenso prima della persistenza e rievalua gli eventi in coda quando cambia il consenso.
- Routing regionale: Risolve la regione in anticipo, determina la rotta in modo deterministico e testa il comportamento di archiviazione e cancellazione in ogni posizione supportata.
Manuale di ripristino degli incidenti
- Detect e classifica. Confronta il segnale all'interno della versione dell'app, della versione del pacchetto, della piattaforma, del canale e dello stato di consenso. Un cambiamento improvviso isolato a un pacchetto può indicare una deriva dello schema o una versione rotta di SDK, mentre un cambiamento ampio può riflettere il comportamento reale o un aggiornamento della politica.
- Priorità del flusso di lavoro. Controlla la profondità della coda del client, gli errori di caricamento, la latenza di ingestione, i campi rifiutati e le tariffe di duplicazione. Sospendi o quarantena il tipo di evento interessato se i payload danneggiati stanno inquinando i sistemi downstream.
- Mitiga in modo sicuro. Disabilita il tracker fallito tramite un flag di funzionalità remoto quando possibile, o annulla il pacchetto di tracking senza modificare il prodotto correlato code. Non cancellare le prove prima di preservare la coda e i record del server in base alla politica di conservazione approvata.
- Valida lo stato di privacy. Confermare che le decisioni di consenso, la routing regionale, la redazione e le vie di cancellazione continuano a comportarsi come progettate. Un incidente di tracciamento può essere un incidente di privacy anche quando il prodotto funziona correttamente.
- Riprendere e imparare. Riprodurre solo eventi validati e deduplicati da buffer duraturi. Scrivere un post-mortem senza colpe che registri il trigger, la lacuna di detezione, lo schema colpito, l'azione di recupero e le modifiche concrete della pipeline o dei test.
L'analisi del comportamento dell'app funziona quando gli ingegneri in on-call possono fidarsi del contratto degli eventi, i team di prodotto possono interpretare gli stessi fatti e i revisori di privacy possono seguire ogni campo attraverso il sistema. Se si distribuisce Capacitor o app Electron e si hanno bisogno di una consegna di bundle JavaScript controllata con adozione di rilascio, fallimento, registri di dispositivo, targeting di canale e visibilità di rollback, visitare Capgo per valutare come il suo piattaforma di aggiornamento in tempo reale può adattarsi al suo flusso di tracciamento. Iniziare mappando un workflow di rilascio critico, poi collegare lo stato di aggiornamento, l'esito di runtime e la via di recupero prima di espandere la copertura.





