
Der beliebteste Ratschlag zu App-State-Management ist auch der am wenigsten hilfreiche: Wähle einen globalen Store und packe alles hinein. Dieser Ansatz behandelt API-Responses, Modal-Sichtbarkeit, ungespeicherte Formulareingaben, Authentifizierung und Navigationsfilter so, als hätten sie denselben Lifecycle. Das haben sie nicht. Eine Capacitor- oder Electron-App läuft über einen Web-Layer und eine native oder Desktop-Runtime, deshalb muss State danach getrennt werden, woher er kommt, wie lange er lebt, wem er gehört und was passiert, wenn das Netzwerk oder der Prozess verschwindet.
State Management ist essenziell geworden, weil mobile Runtimes volatil sind. Apps können nach Orientierungswechseln oder bei Speichermangel zerstört und neu erstellt werden, und Android bietet Instance-State-Restoration und Lifecycle-Callbacks wie onSaveInstanceState() aus diesem Grund, dokumentiert in einem UC-Riverside-Studie zu zuverlässigem State-Management in mobilen Apps. Dieselbe Studie untersuchte 966 Apps und 4.808 Aktivitäten, und stellte fest, dass 452 Apps (46,8 %) mindestens eine Aktivität mit nicht-leerem State enthielten, während und 1.896 Aktivitäten hatten insgesamt einen nicht-leeren State. State ist keine optionale Abstraktion, die man erst hinzufügt, wenn die UI läuft. Er ist Teil des Runtime-Contracts.
Inhaltsverzeichnis
- Das Global-Store-Modell neu denken
- Architekturmuster für Cross-Platform-Apps
- Persistenz und Offline-First-Synchronisation
- Performance-Tuning und Teststrategien
- Plattformspezifische Anleitung für Capacitor und Electron
- Migration zu einer modernen Hybrid-Architektur
- Best Practices und häufige Fehler vermeiden
Das Global-Store-Modell neu denken
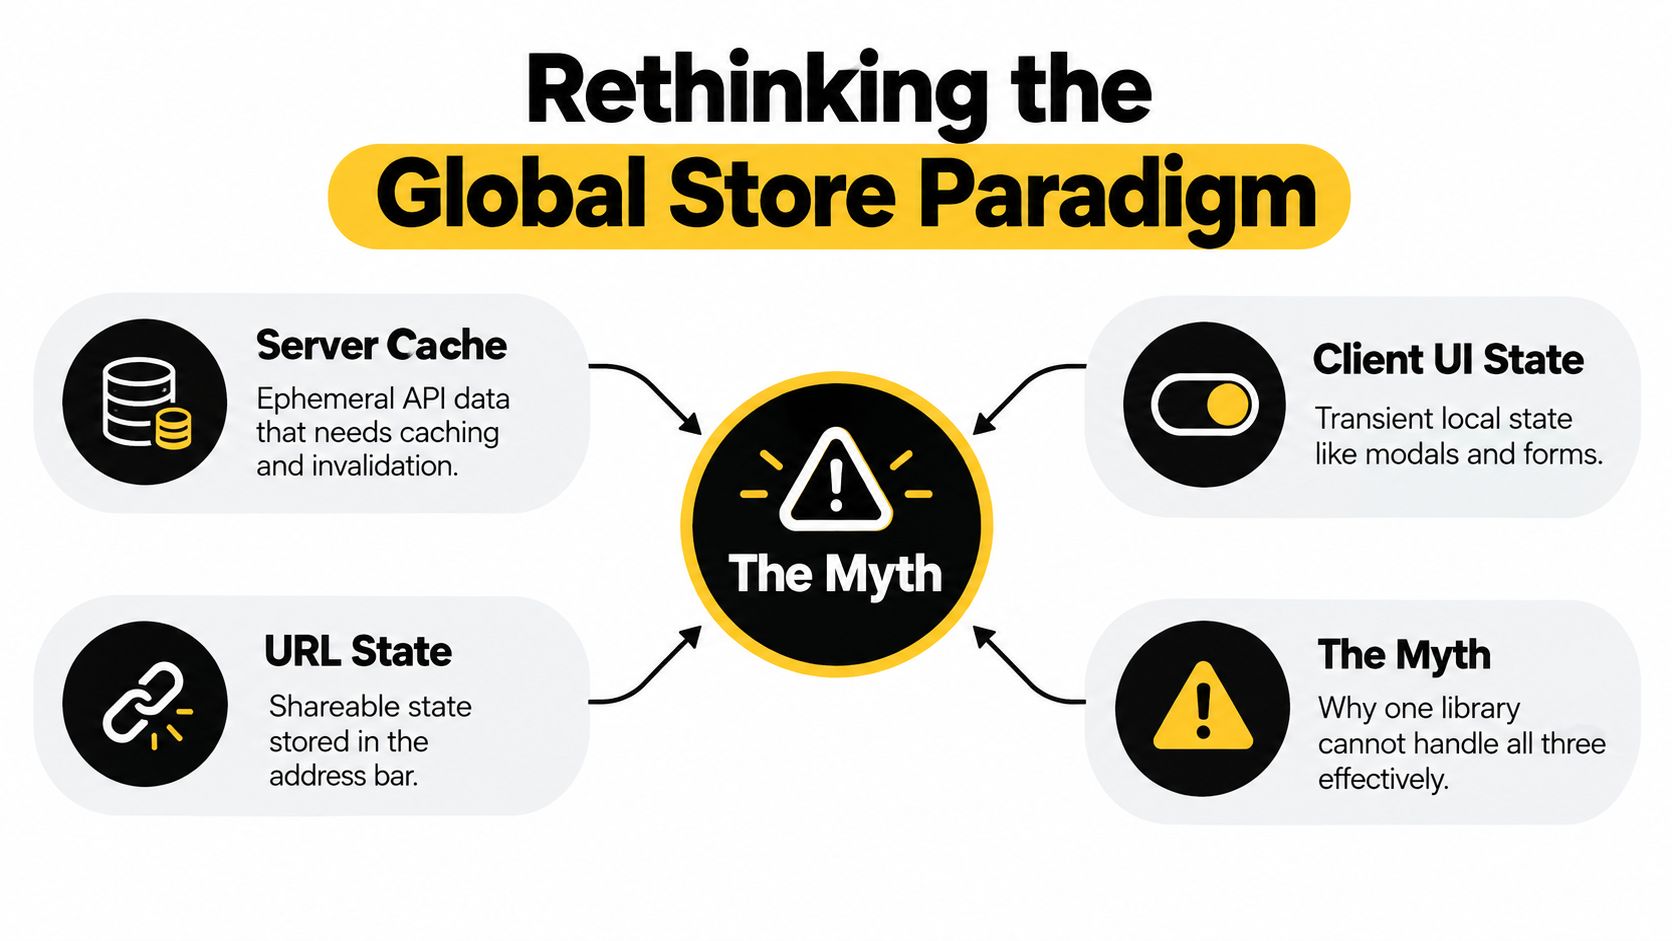
Redux versus Context versus MobX ist der falsche Ausgangspunkt. Ein Store kann Updates koordinieren, aber nicht bestimmen, ob ein Wert zum Server, zum aktuellen Screen, zu einem Form-Workflow oder zur Adressleiste gehört. Alle Werte in einem globalen Container zu speichern, führt zu duplizierten API-Caches, veralteten URL-Parametern und Subscriptions, die das Rerendern unverwandter Screens auslösen.
Ein robustes Design weist jedem Wert einen Owner und eine Recovery-Policy zu:
- Server-State gehört zur Data-Fetching- und Caching-Schicht. API-Antworten, Ladezustand, Fehler, Freshness, Invalidation und Retries beschreiben alle eine Remote-Ressource. Da der Server die autoritative Quelle bleibt, sollte der Client keine zweite permanente Quelle der Wahrheit pflegen.
- Client- oder UI-State bleibt in der Nähe des Components oder Features, das ihn besitzt. Modal-Sichtbarkeit, ausgewählte Tabs, aufgefaltete Zeilen, Theme-Einstellungen und temporäre Interaktions-Flags benötigen in der Regel keine app-weite Persistenz.
- Form-State folgt einem eigenen Workflow. Entwurfseingaben, Validierungsmeldungen, Dirty-Status und Submission-Fortschritt müssen eventuell eine Navigation innerhalb eines Formulars überleben, sollten aber nicht automatisch zu geteiltem Business-State werden.
- URL-State gehört zum Router. Suchbegriffe, Filter, Sortierungen, ausgewählte Datensätze und die Pagination in der Adressleiste lassen sich als Lesezeichen speichern, teilen, wiederherstellen und inspizieren, ohne sie in einen anderen Store zu kopieren.
Warum ein einziger Store zu Architektur-Ballast führt
Der 2024er detaillierte Review zum Application State Management untersucht das State Management in Web- und Mobile-Apps. Die Betrachtung spiegelt einen praktischen Wandel von verstreuten UI-Variablen hin zu einer expliziten, Lifecycle-bewussten Architektur wider. Androids Weg von Instance-State-Bundles hin zu ViewModel und SavedStateHandle geht in dieselbe Richtung, bedeutet aber nicht, dass jeder Wert in einen gemeinsamen Container gehört.
Ein globaler Store hat dennoch eine klare Rolle. Session-Identität, Berechtigungen, App-Einstellungen, Connectivity-Policies und eng definierte Cross-Feature-Workflows können gemeinsame Ownership erfordern. Probleme entstehen, wenn dieser Store zum Sammelbecken für Werte wird, die einen passenderen Owner haben.
Praktische Regel: Wenn ein Wert vom Server, aus der URL oder aus der aktuellen Komponente rekonstruiert werden kann, sollte er nicht in den globalen State wandern, es sei denn, ein bestimmter Workflow verlangt es.
Diese Abgrenzung unterstützt auch eigenständig verantwortete Module. Teams, die ein Produkt in deploybare Bereiche aufteilen, können die Ownership-Prinzipien anwenden, die in Micro-Frontend-Architektur, anstatt einen einzigen Dependency-Graph für die gesamte Anwendung aufzubauen. In einer Capacitor- oder Electron-Codebase funktioniert ein Hybridmodell besser: Remote-Daten nutzen Cache- und Synchronisationsregeln, UI-Werte bleiben lokal, und dauerhafter Workflow-State wird explizit persistiert. Diese Trennung begrenzt konkurrierende Schreibzugriffe und macht Recovery nach Reloads, suspendierten Prozessen oder Offline-Phasen leichter nachvollziehbar.
Architekturmuster für Cross-Platform-Apps
Sobald ein State einen Besitzer hat, wird die Auswahl der Implementierung deutlich eingeschränkter. Die meisten clientseitigen States folgen einem dieser drei Muster: lokaler Component-State, für eine kleiner Shared Store, oder Event-getriebene Kommunikation zwischen isolierten Modulen. Keines davon ist universell überlegen. Die falsche Wahl zeigt sich meist dann, wenn ein Team ein Muster wählt, bevor Update-Frequenz, Ownership und Recovery-Anforderungen definiert wurden.
| Muster | Komplexität | Speicherbedarf | Bester Anwendungsfall |
|---|---|---|---|
| Lokaler Komponenten-Status | Niedrig | Niedrig | Bildschirm-spezifische Toggles, Entwürfe, Disclosure-Panels, temporäre Auswahl |
| Zentralisierter, schlanker Store | Mittel | Mittel | Gemeinsame Sitzungspräferenzen, Theme, aktiver Workspace, UI-Koordination über Features hinweg |
| Event-Bus-Architektur | Mittel bis hoch | Variabel | Lose gekoppelte Module, Plugin-Benachrichtigungen, Native-Bridge-Events, isolierte Feature-Grenzen |
Lokaler State sollte der Standard sein
Ein komponentenlokaler Wert hat einen kurzen Dependency-Pfad. Wenn sich ein Modal öffnet, eine Zeile aufgeklappt wird oder sich ein Formularfeld ändert, kann das zuständige Feature aktualisieren, ohne die gesamte App zu benachrichtigen. Das reduziert unbeabsichtigte Kopplung und macht Unit-Tests unkomplizierter. Zudem begrenzt es den gehaltenen Speicher, wenn mobile Screens pausiert werden oder Desktop-Fenster über lange Sessions offen bleiben.
Lokaler State wird unhandlich, wenn mehrere weit auseinanderliegende Features denselben Wert brauchen oder ein Workflow Routengrenzen überschreitet. Dann ist es meist besser, den State in einen Feature-Store zu heben, statt ihn in einem globalen App-Singleton abzulegen. Ein kleiner Store wie Zustand oder Pinia kann fokussierte Selectors und explizite Actions bereitstellen, ohne dass jede Komponente auf jede Änderung subscriben muss.
Der Trade-off ist Disziplin. Lightweight-Stores sind schnell angelegt, sodass Teams am Ende viele überlappende Stores und unklare Zuständigkeiten haben. Benenne den Owner, definiere Mutations-Methoden und vermeide es, ein veränderbares Objekt offenzulegen, das jede Komponente einfach überschreiben kann.
Events sind nützlich, aber keine Datenbank
Ein Event Bus eignet sich gut für Benachrichtigungen wie „Der native Share wurde abgeschlossen“, „Das Fenster ist aktiv“ oder „Eine Hintergrundaufgabe hat neue Daten erhalten“. Er hilft Plugins und Modulen, miteinander zu kommunizieren, ohne sich gegenseitig zu importieren. Als alleinige Aufzeichnung des Business-State funktioniert er schlecht, da Events flüchtig sind. Ein Subscriber, der suspendiert, entladen oder spät registriert wurde, kann die Nachricht verpassen.
Nutze Events, um anzukündigen, dass etwas passiert ist, und lass das empfangende Modul dann seinen autoritativen Store oder seine Data Layer abfragen. Halte Event-Namen eng und Payloads versioniert, wo native und Web code sich unabhängig voneinander entwickeln können.
Für einen breiteren architektonischen Kontext Einblicke in die mobile App-Entwicklung von Bridge Global sind nützlich, wenn man geteilte code gegen plattformspezifisches Verhalten abwägt. Dasselbe Prinzip gilt für den App-State: Teile Domänenregeln, wo sie stabil sind, isoliere aber Lifecycle-Adapter und native Integrationspunkte. Ein praktisches Mobile-App-Architektur sollte diese Grenzen in der Ordnerstruktur und im Abhängigkeitsgraphen sichtbar machen.
Persistenz und Offline-First-Synchronisation
Ein In-Memory-Store ist kein dauerhafter State. Das Betriebssystem kann einen mobilen Prozess suspendieren oder beenden, ein Desktop-Nutzer kann ein Fenster schließen, und das Netzwerk kann verschwinden, während eine Mutation in Bearbeitung ist. Offline-first-Design beginnt damit, zu entscheiden, was der Nutzer wiederherstellen können muss, und wählt dann Speicher- und Synchronisationsregeln entsprechend.
Einen robusten Write-Path aufbauen
Ein zuverlässiger Workflow trennt das unmittelbare Nutzererlebnis von der Remote-Bestätigung:
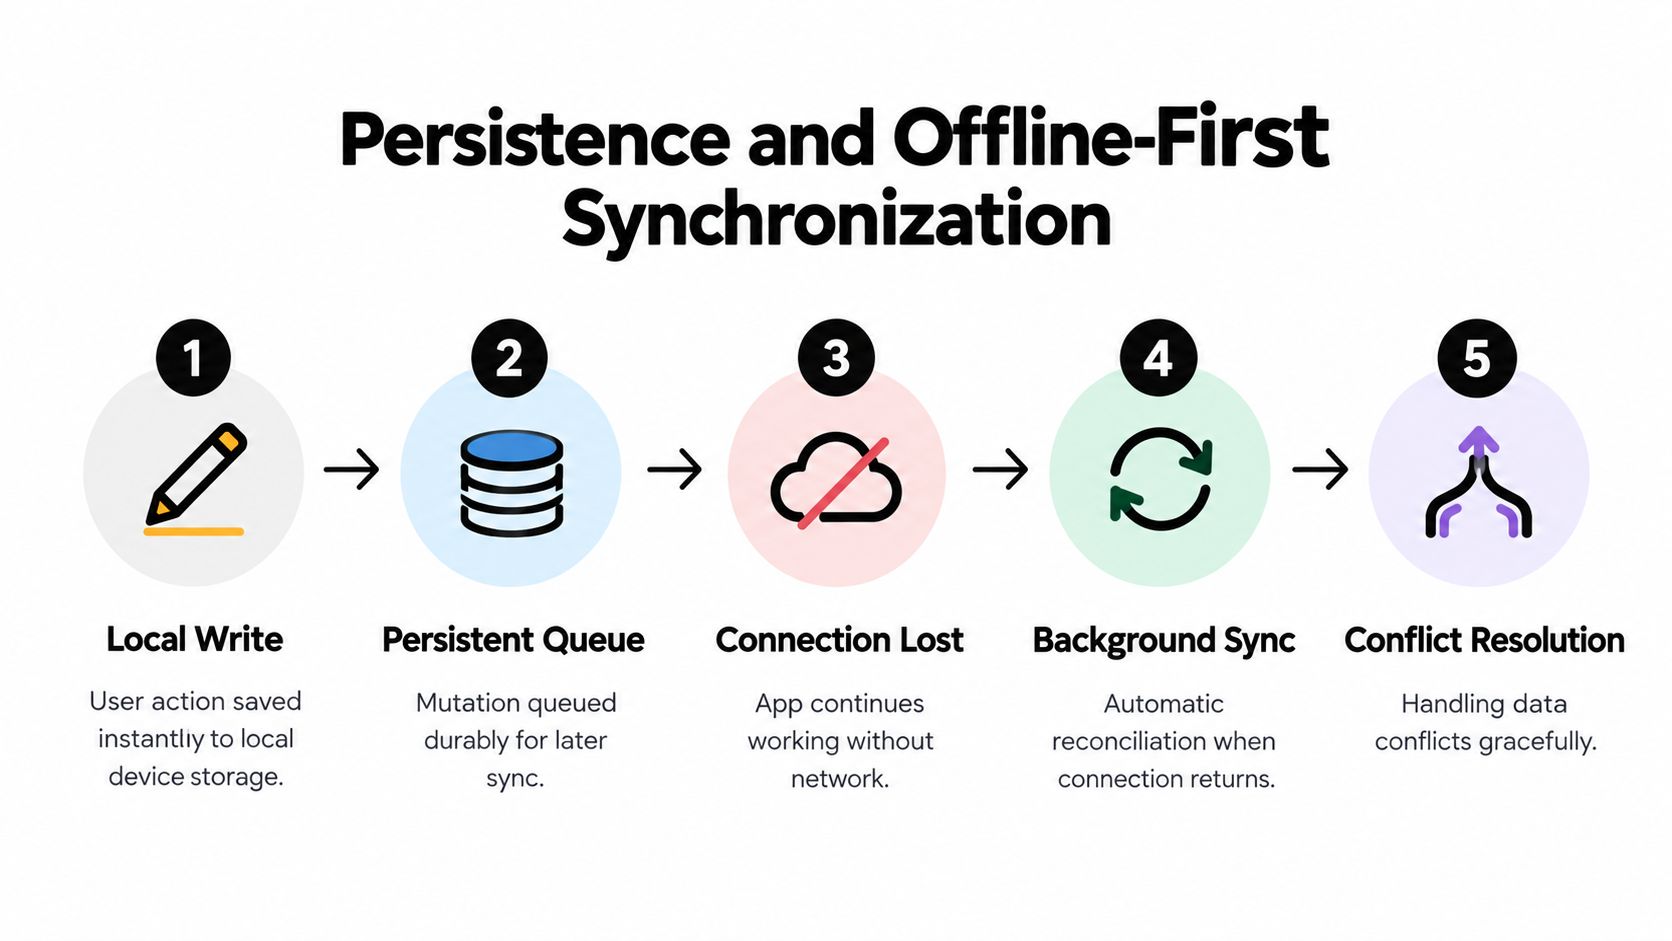
- Zuerst lokal schreiben. Schreibe die Nutzeraktion in eine lokale Datenbank oder einen persistenten Document Store, damit die UI reagiert, ohne auf das Netzwerk zu warten.
- Mutation in die Queue stellen. Speichere die Operation mit Entity-ID, Operationstyp, Payload, Erstellungskontext und Retry-Status. Eine nur im Arbeitsspeicher gehaltene Queue geht mit dem Prozess verloren.
- Ehrlichen Status anzeigen. Unterscheide zwischen lokal gespeichert, Synchronisierung ausstehend, synchronisiert und fehlgeschlagen. Nutzer müssen wissen, ob eine Änderung auf dem Gerät dauerhaft gespeichert oder remote bestätigt ist.
- Synchronisieren, wenn die Bedingungen es zulassen. Reconnect-Listener, App-Foreground-Events und geplante Background-Tasks können Retries auslösen. Der Sync-Worker sollte idempotent sein, da unterbrochene Requests erneut gesendet werden können.
- Konflikte gezielt lösen. Die Serverantwort muss bestimmen, ob die lokale Operation akzeptiert, abgelehnt oder gemergt wurde oder ob sie vom Nutzer geprüft werden muss.
SQLite ist eine praktische Wahl für relationale Datensätze und transaktionale Queues in native gestützten Apps. IndexedDB eignet sich für browserorientierten Speicher und Electron-Renderer code, sofern das Team Schema-Upgrades und Transaktionsgrenzen sorgfältig handhabt. Halte die Serialisierung explizit. Persistiere Domain-Daten und Recovery-Metadaten, keine Component-Instanzen, Closures oder Referenzen auf native Objekte.
Conflict-Policy ist eine Produktentscheidung
Last-write-wins ist einfach, kann aber legitime Änderungen verwerfen. Field-Level-Merging funktioniert, wenn sich unabhängige Felder sicher kombinieren lassen. Domänenspezifische Regeln sind sicherer für Lagerbestand, Freigaben, Finanzdaten oder klinische Workflows, bei denen ein automatischer Merge die Bedeutung verändern könnte. Manche Konflikte sollten die Synchronisation blockieren und den Nutzer entscheiden lassen.
Die Sync-Schicht sollte außerdem trennen zwischen Read-Reconciliation von Mutation-Replay. Das erneute Abrufen von Serverdaten beweist nicht, dass eine eingereihte Mutation erfolgreich war, und das Replay einer Mutation garantiert nicht, dass der resultierende Datensatz noch der aktuellen Repräsentation auf dem Server entspricht. Speichere Server-Versionen oder gleichwertige Validatoren, gib strukturierte Konfliktantworten zurück und behalte genug Queue-Historie, um Fehler erklären zu können.
Für den benutzerseitigen Teil dieses Designs: das Erstellen eines Offline-Screens in Vue, Angular oder React bietet einen wichtigen UI-Aspekt: Der Offline-Modus sollte ein sichtbarer App-Zustand sein, keine in der Konsole versteckte Ausnahme.
Das folgende Video kann die Implementierungsarbeit rund um Offline-Verhalten und Synchronisation ergänzen:
Performance-Tuning und Teststrategien
Performanceprobleme bei State entstehen selten durch einen einzelnen langsamen Reducer. Sie treten auf, wenn breite Subscriptions dazu führen, dass nicht verwandte Komponenten gerendert werden, abgeleitete Werte unnötig neu berechnet werden, große Objektgraphen referenziert bleiben oder Synchronisationsarbeit auf dem UI-Thread ausgeführt wird. Messen Sie die Update-Propagation, statt zu raten, welche Bibliothek am schnellsten ist.
Ein Benchmark aus dem Jahr 2026 mit einem Dashboard mit 100 verbundenen Komponenten und 10.000 Iterationen maß MobX bei 0,3 ms für einfache Änderungen, 0,4 ms für verschachtelte Änderungen und 0,6 ms für abgeleitete Änderungen, während Redux Toolkit 0,8 ms, 1,2 ms und 1,5 ms in den entsprechenden Tests erzielte. Derselbe Benchmark erfasste 2,8 MB für Zustand und 4,2 MB für Redux Toolkit in seinem Speichervergleich. Dies sind benchmark-spezifische Beobachtungen, keine universellen Produktionsgarantien, aber sie verdeutlichen, warum Subscriptions-Granularität und Update-Strategie wichtig sind. Siehe die vergleichende React State Management Benchmark für den Testkontext.
Die Update-Grenze optimieren
Beginne mit Selectors. Eine Komponente sollte den kleinsten sinnvollen Ausschnitt abonnieren, nicht das gesamte Session-Objekt oder die API Response. Memoize abgeleitete Daten, wenn die Berechnung aufwendig ist, aber memoize nicht reflexartig jeden primitiven Wert. Memoization verursacht außerdem zusätzlichen Aufwand für Retention und Vergleiche, also führe vorher und nachher ein Profiling durch.
Virtualisiere lange Listen, normalisiere Datensätze, wenn Updates einzelne Entitäten betreffen, und vermeide es, ein großes Root-Objekt wegen einer kleinen Feldänderung zu ersetzen. In Electron solltest du den Renderer-Speicher über lange Sessions im Blick behalten, da Fenster viel länger aktiv bleiben können als ein mobiler Screen. Vermeide in Capacitor synchrone Persistenz bei einer Eingabespitze. Debounce Entwürfe oder speichere aussagekräftige Checkpoints und stelle sicher, dass ein Crash keine Daten verlieren kann, die das Produkt zu behalten verspricht.
Eine mit Springer verknüpfte Studie ergab, dass die Änderung des State-Management-Ansatzes die Programmausführungszeit im Durchschnitt um 17 % über alle Testszenarien hinweg senkte, was die Annahme stützt, dass weniger unnötige Synchronisation und Recomputation deutliche Laufzeitgewinne bringen können. Das Ergebnis findet sich in der Studie zur Performance von State-Management in Web-Apps, und sie sollte nicht als garantierte Verbesserung für jeden Stack gelten.
Transitions testen, nicht nur Werte
Ein State-Test, der isLoading nach einem erfolgreichen Request prüft, übersieht die gefährlichen Pfade. Teste die Sequenz:
- Hydration: Persistierte Daten werden geladen, ungültige Datensätze abgelehnt und Standardwerte füllen nur fehlende Felder.
- Interruption: Eine Anfrage wird abgebrochen oder die App geht während einer Mutation in den Hintergrund.
- Replay: Gepufferte Operationen werden sicher wiederholt und erzeugen keine doppelten Server-Effekte.
- Konflikt: Der Server lehnt eine veraltete Version ab und die UI bietet eine wiederherstellbare Lösung an.
- Isolation: Ein lokales UI-Update führt nicht dazu, dass unbeteiligte Features gerendert oder verändert werden.
Mocke Server-State-Adapter an der Netzwerk-Grenze und nutze Integrationstests für komplette Workflows. Füge Instrumentierung in Entwicklung und CI hinzu, um unerwartete Subscriber-Zahlen, unbegrenzte Queues und State-Übergänge nach dem Unmount einer Feature zu erkennen. Die wertvollste Test-Fixture ist oft eine realistische Lifecycle-Sequenz, nicht eine weitere isolierte Reducer-Assertion. Nutze App-Performance-Optimierungsleitfaden wenn man diese Messwerte in einen wiederholbaren Release-Check verwandelt.
Plattformspezifische Anleitung für Capacitor und Electron
Eine Web-App kann davon ausgehen, dass ihr JavaScript-Prozess länger verfügbar bleibt als bei einer mobilen App. Capacitor und Electron heben diese Annahme auf unterschiedliche Weise auf. Capacitor bettet die Web-Schicht in einen mobilen Lifecycle ein, der von iOS oder Android verwaltet wird, während Electron einen Chromium-Renderer an ein Desktop-Prozessmodell anbindet, in dem Fenster unabhängig voneinander erscheinen und verschwinden können.
Capacitor benötigt Lifecycle-aware Hydration
Betrachte Backgrounding als Chance für einen Checkpoint, nicht als Beweis dafür, dass der Prozess fortgesetzt wird. Bei einem App-State-Wechsel flusht du kritische ausstehende Mutationen, hältst den aktuellen Sync-Cursor fest und gibst Ressourcen frei, die nicht aktiv bleiben sollten. Beim Wechsel in den Foreground rehydrierst du, was verloren ging, prüfst die Authentifizierung, aktualisierst veraltete Serverdaten und startest Subscriptions erst, wenn der lokale Store bereit ist.
Der JavaScript-Store sollte die Interna nativer Plugins nicht direkt besitzen. Kamera-Sessions, biometrische Prompts, Push-Registrierungen, Dateisystem-Handles und Hintergrundtasks unterliegen jeweils plattformspezifischen Lifecycle-Regeln. Kapsle sie in Adapter, die native Callbacks in Domain-Events oder -Commands übersetzen. So kann der Store Zustände wie unavailable, requesting, active, failed oder completed abbilden, ohne ein natives Objekt zu halten, das nach einer Suspension ungültig wird.
Die Webview-Grenze macht Serialisierung ebenfalls wichtig. Übertrage über die Capacitor-Brücke nur einfache Daten, validiere Plugin-Antworten und versioniere Nachrichten, falls ein live update dazu führen kann, dass verschiedene Web-Bundles mit installierten nativen code interagieren. Wie Capacitor Web und native code verbindet erklärt die Grenze, die diesen Adapter-Ansatz notwendig macht.
Electron benötigt Process Ownership
Der Main-Prozess von Electron sollte privilegierte Operationen und dauerhafte Koordination besitzen, während Renderer den view-spezifischen State verwalten. Verwende typisierte IPC-Commands für Aktionen wie das Lesen sicherer Einstellungen, das Schreiben von Dateien oder die Koordination von Fenstern. Gib nicht jedem Renderer breiten Dateisystem-Zugriff und behandle ein an ein Fenster gesendetes Event nicht als dauerhaften Anwendungs-Record.
Multi-Window-Anwendungen brauchen ein explizites Synchronisationsmodell. Der Main-Prozess kann verbindliche Updates verteilen, während jeder Renderer seinen lokalen UI-State hält. Bearbeiten zwei Fenster denselben Datensatz, braucht die App Versionsprüfungen oder eine Konfliktstrategie – nicht nur ein Broadcast-Event. Ein geschlossenes Fenster muss seinen State beim erneuten Öffnen rekonstruieren können; deshalb müssen der Main-Prozess oder die Persistenzschicht die Quelle für wiederherstellbare Daten bleiben.
Capacitor und Electron können Domain-Modelle, API-Clients, Queue-Formate und Reducer teilen. Sie müssen aber nicht zwingend dieselben Lifecycle-code nutzen. Die stärkste Cross-Platform-Architektur hat ein gemeinsames State-Vokabular und plattformspezifische Durability-, Bridge- und Recovery-Adapter.
Migration zu einer modernen Hybrid-Architektur
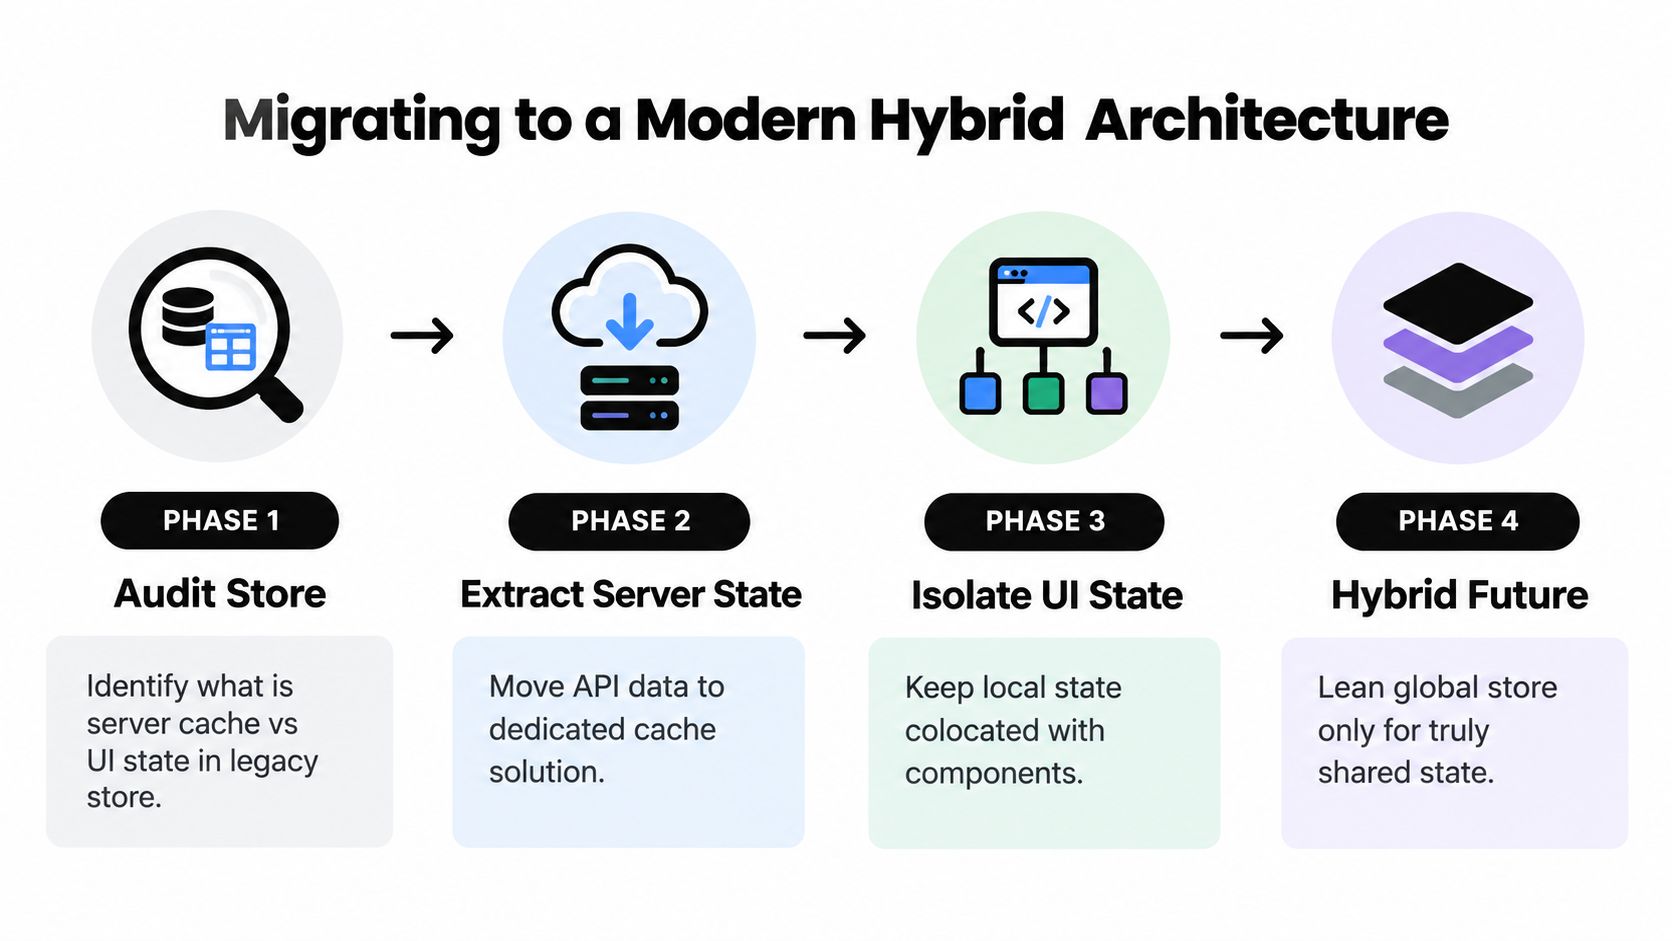
Ein Legacy-Global-Store braucht selten einen Rewrite. Er braucht eine Bestandsaufnahme und eine Abfolge sicherer Extraktionen. Migration funktioniert am besten, wenn jedes Feature eine State-Klasse nach der anderen verschieben kann, während der alte Store für unberührte Screens verfügbar bleibt.
Zuerst die Verantwortung, dann die Technologie
Erstelle einen State-Katalog für den bestehenden Store. Dokumentiere für jedes Feld die Quelle, die Consumer, Mutationspfade, Persistenzanforderungen und das Recovery-Verhalten. Markiere, ob es serverbasiert, routenbasiert, formulargebunden, feature-lokal oder geteilt ist. Diese Übung zeigt oft, dass der globale Store mehrere unabhängige Systeme hinter einem einzigen API verbirgt.
Migriere zuerst den Server-State. Ersetze manuell gespiegelte API Felder durch einen dedizierten Fetching- und Caching-Layer, der Request-Status, Invalidation, Retries und Revalidation verwaltet. Halte die Selectors vorübergehend kompatibel, damit bestehende Screens migrieren können, ohne alle Aufrufstellen gleichzeitig ändern zu müssen. Lösche die duplizierte Server-Kopie erst, wenn die neue Quelle die Integrationstests bestanden hat.
Gib als Nächstes den URL-State an den Router zurück. Suchfilter und ausgewählte Ressourcen sollten durch Route-Parameter oder Query-State auch nach Reloads oder beim Teilen erhalten bleiben. Entferne Synchronisationseffekte, die URL-Werte in einen Store und Store-Werte zurück in die URL kopieren. Solche Loops verursachen Race Conditions und machen den Browser-Verlauf unzuverlässig.
Feature-State schrittweise extrahieren
Verschiebe Modal-State, Wizard-Fortschritt und lokale Auswahl in die nächstgelegene Feature-Boundary. Wenn mehrere Komponenten den Wert benötigen, nutze einen Feature-Store mit einer engen Schnittstelle. Behalte den restlichen globalen Store für Cross-Cutting Concerns wie Session-Policy, Theme, Permissions oder explizit geteilte Workflows vor.
Nutze während der Transition einen Compatibility-Layer. Er kann aus der neuen Quelle lesen und dabei die alte Selector-Form nach außen beibehalten, sodass Features hinter Flags migriert werden können. Veröffentliche jede Extraktion unabhängig, überwache Fehlerpfade und das Hydration-Verhalten und behalte einen Rollback-Pfad, bis sich das neue Ownership-Modell als stabil erweist.
Für Capacitor- und Electron-Teams kann Capgo signierte JavaScript-, CSS-, Konfigurations- und Asset-Bundles über gezielte Channels ausliefern – mit Rollout-Steuerung, Versionshistorie, Device-Logs, Adoptions- und Failure-Metriken sowie automatischem Rollback-Schutz. So lässt sich ein State-Management-Refactor inkrementell ausliefern, während native Änderungen weiterhin dem jeweiligen Plattform-Release-Prozess folgen. Der operative Vorteil ist die Kontrolle über die Migration – kein Grund, Tests oder Kompatibilitätsplanung zu überspringen.
Best Practices und häufige Fehler vermeiden
Die State-Architektur scheitert, wenn Review-Fragen vage bleiben. Nutze diese Checks in Design-Reviews und Pull Requests:
- Benenne den Owner in code: Frage: „Welches Modul kann diesen Wert ändern, und was API tut, um diese Grenze durchzusetzen?“ Lehne einen Store ab, der nur deshalb hinzugefügt wurde, weil zwei Komponenten aktuell dasselbe Feld brauchen.
- Definiere den Recovery-Contract: Dokumentiere für jeden persistierten Wert, ob Reload, App-Neustart, Logout und Account-Wechsel ihn erhalten oder löschen. Ein Rechnungsentwurf kann einen Neustart überstehen, während ein ausgewählter Workspace eine Revalidierung erfordern kann.
- Mache die Synchronisation beobachtbar: Logge Request-IDs, Versionen, Retry-Counts und Konfliktergebnisse. Richte einen Alert für wiederholte Retries oder Konflikte ein, bevor Nutzer fehlende Updates melden.
- Prüfe die Commands, nicht die Objektstruktur: Eine Mutation sollte ihren fachlichen Zweck benennen, Inputs validieren und einen auditfreundlichen Action-Namen bieten. Direkte Writes, die diese Checks umgehen, gehören in Review-Diskussionen.
- Teste feindliche Sequenzen: Teste Hydration-Race-Conditions bei der Navigation, abgebrochene Writes mit anschließendem Retry, doppelte Zustellung, Offline-Edits aus zwei Fenstern und Logouts während eines Pending-Requests.
- Prüfe den Löschpfad: Eine Migration ist unvollständig, wenn ein alter Selector, Persistence-Adapter oder Event-Listener noch in den alten Store schreibt. Füge einen Test hinzu, der fehlschlägt, wenn beide Quellen dasselbe Feld updaten.
Eine praktische PR-Frage ist: „Was passiert, wenn dieser Prozess nach dem Write-Start, aber vor der Bestätigung verschwindet?“ Die Antwort sollte persistente Daten, Retry-Verantwortung, Deduplizierung und den für User sichtbaren Fehlerzustand benennen.
Capgo hilft CapacitorJS- und Electron-Teams, JavaScript-, CSS-, Config- und Asset-Updates über gezielte Channels auszurollen – mit signierten Bundles, Rollout-Kontrollen, Device-Logs und Rollback-Schutz. Nutze Capgo um Refactors am State-Management und Recovery-Fixes inkrementell auszuliefern und diese anschließend mit Lifecycle- und Sync-Tests zu validieren.





