
Il consiglio più comune su gestione dello stato dell'app è anche il meno utile: scegliere uno store globale e metterci tutto. Questo approccio tratta le risposte di API, la visibilità dei modal, gli input non salvati dei form, l'autenticazione e i filtri di navigazione come se avessero lo stesso ciclo di vita. Non è così. Un'app Capacitor o Electron gira attraverso un layer web e un runtime nativo o desktop, quindi lo stato va separato in base a da dove viene, per quanto tempo deve vivere, chi lo possiede e cosa succede quando la rete o il processo scompaiono.
Lo state management è diventato fondamentale perché i runtime mobile sono volatili. Le app possono essere distrutte e ricreate dopo cambi di orientamento o condizioni di memoria insufficiente, e Android offre il ripristino dell'instance-state e callback di lifecycle come onSaveInstanceState() per questo motivo, come documentato in una Studio UC Riverside sulla gestione affidabile dello stato delle app mobili. Lo stesso studio ha esaminato 966 app e 4.808 attività, scoprendo che 452 app, ovvero il 46,8%, contenevano almeno un'activity con stato non vuoto, mentre 1.896 activity avevano uno stato non vuoto nel complesso. Lo stato non è un'astrazione opzionale da aggiungere dopo che l'UI funziona. Fa parte del contratto di runtime.
Indice dei contenuti
- Ripensare il modello dello store globale
- Pattern architetturali per app cross-platform
- Persistenza e sincronizzazione offline-first
- Strategie di tuning e test delle prestazioni
- Guida specifica per piattaforma per Capacitor ed Electron
- Migrare verso un'architettura ibrida moderna
- Best practice ed errori comuni da evitare
Ripensare il modello di store globale
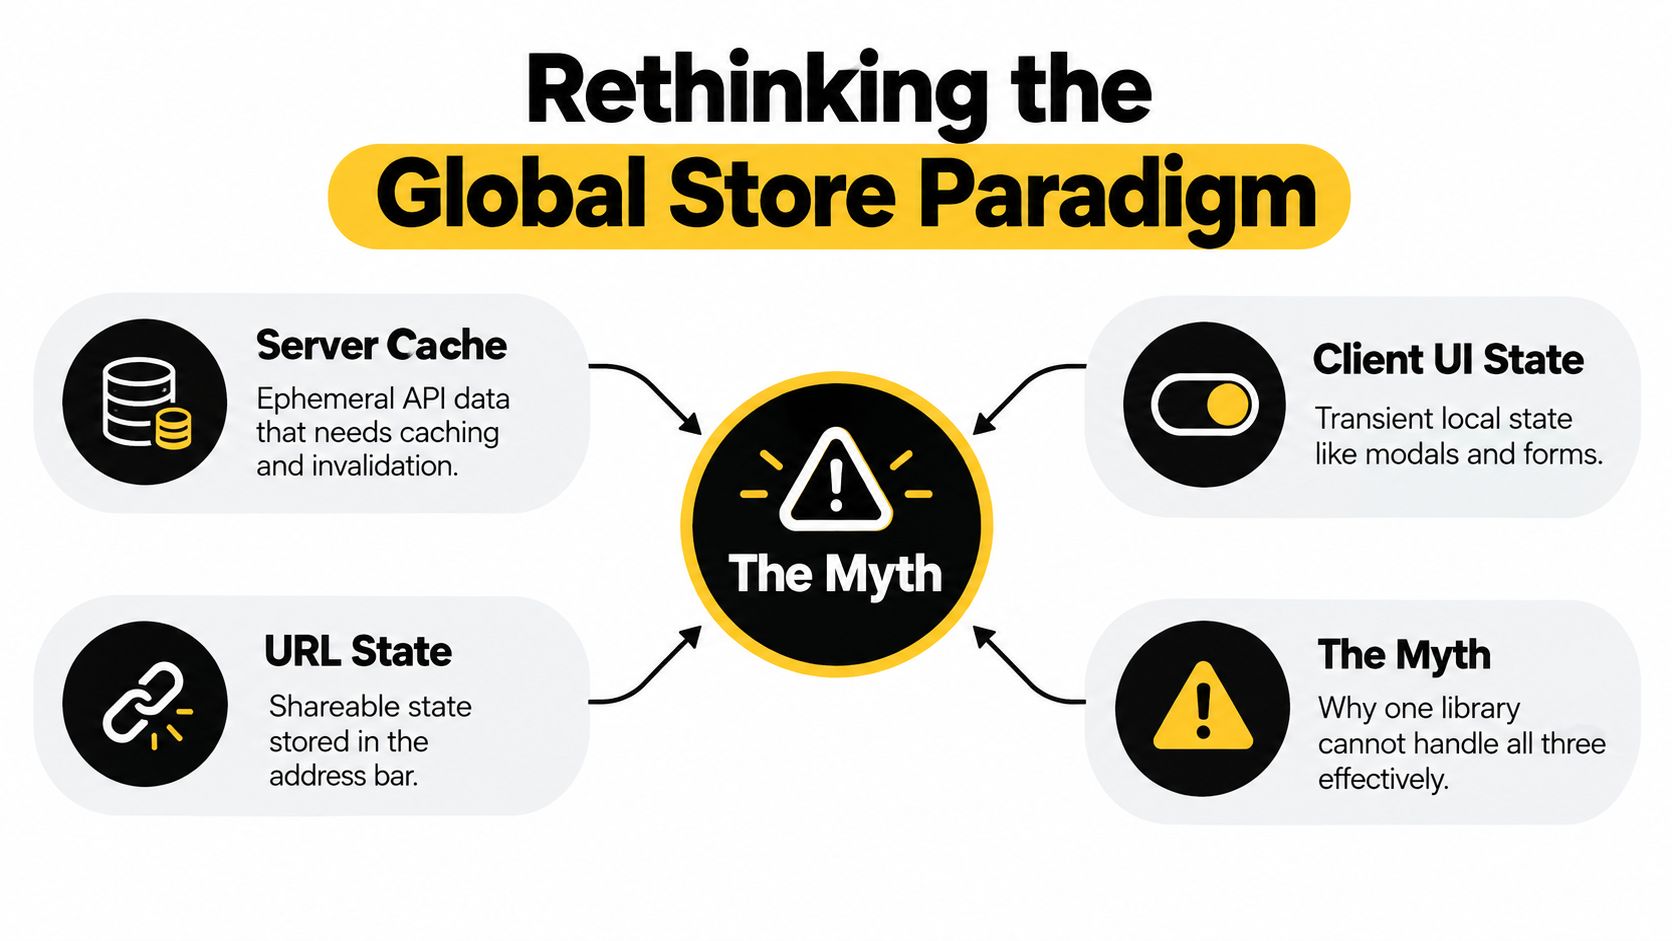
Redux contro Context contro MobX è il punto di partenza sbagliato. Uno store può coordinare gli aggiornamenti, ma non può determinare se un valore appartiene al server, allo schermo corrente, a un flusso di lavoro del form o alla barra degli indirizzi. Mettere ogni valore in un unico contenitore globale crea cache API duplicate, parametri URL obsoleti e sottoscrizioni che fanno ri-renderizzare schermate non correlate.
Un design durevole assegna a ogni valore un proprietario e una policy di recupero:
- Stato del server appartiene al layer di fetch e caching dei dati. Le risposte API, lo stato di caricamento, gli errori, la freschezza, l'invalidazione e i retry descrivono tutti una risorsa remota. Il server rimane autorevole, quindi il client non dovrebbe mantenere una seconda fonte di verità permanente.
- Stato client o UI resta vicino al componente o alla feature che lo possiede. La visibilità dei modali, le tab selezionate, le righe espanse, le preferenze di tema e i flag di interazione temporanei di solito non richiedono persistenza a livello di applicazione.
- Stato del form segue un workflow separato. Input della bozza, messaggi di validazione, stato dirty e avanzamento dell'invio possono dover sopravvivere alla navigazione all'interno di un form, ma non devono diventare automaticamente stato business condiviso.
- Stato URL appartiene al router. Termini di ricerca, filtri, criteri di ordinamento, record selezionati e paginazione nella barra degli indirizzi possono essere salvati nei segnalibri, condivisi, ripristinati e ispezionati senza copiarli in un altro store.
Perché un unico store crea attrito architettonico
Il 2024 dell'Application State Management esamina la gestione dello stato nelle applicazioni web e mobile. La sua copertura riflette un passaggio pratico da variabili UI sparse verso un'architettura esplicita e consapevole del ciclo di vita. L'evoluzione di Android dai bundle di instance state a ViewModel e SavedStateHandle segue la stessa direzione, ma non significa che ogni valore debba stare in un unico container condiviso.
Uno store globale ha comunque un ruolo definito. Identità di sessione, permessi, preferenze a livello di app, policy di connettività e workflow cross-feature ben delimitati possono richiedere una ownership condivisa. I problemi iniziano quando quello store diventa un contenitore di tutto per valori che avrebbero un owner più adatto.
Regola pratica: Se un valore può essere ricostruito dal server, dall'URL o dal componente corrente, tienilo fuori dallo stato globale, a meno che un workflow specifico non richieda diversamente.
Questo confine supporta anche moduli gestiti indipendentemente. I team che suddividono un prodotto in aree distribuibili possono applicare i principi di ownership utilizzati in architettura micro-frontend, invece di costruire un unico grafo di dipendenze per l'intera applicazione. In un codebase Capacitor o Electron, un modello ibrido funziona meglio: i dati remoti usano cache e regole di sincronizzazione, i valori della UI rimangono locali e lo stato durevole dei workflow riceve una persistenza esplicita. Questa separazione limita gli scrittori concorrenti e rende più semplice ragionare sul recupero dopo reload, processi sospesi o periodi offline.
Pattern architetturali per app cross-platform
Una volta definito il proprietario dello stato, le opzioni di implementazione si restringono. La maggior parte dello stato client rientra in uno di questi tre pattern: stato locale del componente, un piccolo store condiviso, o comunicazione event-driven tra moduli isolati. Nessuno è universalmente superiore. La scelta sbagliata di solito emerge quando un team seleziona un pattern prima di aver identificato frequenza di aggiornamento, ownership e requisiti di recovery.
| Pattern | Complessità | Impronta di memoria | Caso d'uso ideale |
|---|---|---|---|
| Stato locale dei componenti | Basso | Basso | Toggle specifici per schermata, bozze, pannelli espandibili, selezione temporanea |
| Store centralizzato leggero | Moderato | Moderato | Preferenze di sessione condivise, tema, workspace attivo, coordinamento UI tra feature |
| Architettura event bus | Da medio ad alto | Variabile | Moduli a basso accoppiamento, notifiche dei plugin, eventi del bridge nativo, confini di funzionalità isolati |
Lo stato locale dovrebbe essere il default
Un valore locale al componente ha un percorso di dipendenza breve. Quando si apre un modale, si espande una riga o cambia un campo del form, la funzionalità proprietaria può aggiornarsi senza notificare l'intera applicazione. Questo riduce l'accoppiamento accidentale e rende i test unitari diretti. Limita anche la memoria trattenuta quando le schermate mobili sono sospese o le finestre desktop restano aperte per sessioni lunghe.
Lo stato locale diventa scomodo quando più funzionalità distanti hanno bisogno dello stesso valore o quando un flusso di lavoro attraversa i confini delle rotte. In questi casi, sollevare lo stato in uno store di funzionalità è di solito meglio che metterlo in un singleton a livello di applicazione. Uno store piccolo come Zustand o Pinia può esporre selettori focalizzati e azioni esplicite senza richiedere a ogni componente di sottoscrivere ogni modifica.
Il compromesso è la disciplina. Gli store leggeri sono facili da creare, quindi i team possono finire con molti store sovrapposti e proprietà non chiare. Nominare il proprietario, definire i metodi di mutazione ed evitare di esporre un oggetto mutabile che qualsiasi componente possa riscrivere.
Gli eventi sono utili, ma non sono un database
Un event bus funziona bene per notifiche come “la condivisione nativa è completata”, “la finestra è diventata attiva” o “un task in background ha ricevuto nuovi dati”. Aiuta i plugin e i moduli a comunicare senza importarsi a vicenda. Funziona male come unico registro dello stato di business perché gli eventi sono transitori. Un subscriber sospeso, scaricato o registrato in ritardo potrebbe perdere il messaggio.
Usa gli eventi per annunciare che qualcosa è successo, poi lascia che il modulo ricevente interroghi il suo store o layer dati autoritativo. Mantieni i nomi degli eventi specifici e i payload versionati dove il code nativo e web possono evolvere separatamente.
Per un contesto architettonico più ampio, gli spunti sullo sviluppo di app mobili di Bridge Global sono utili quando si bilancia il code condiviso con il comportamento specifico della piattaforma. Lo stesso confine si applica allo stato dell'app: condividi le regole di dominio dove sono stabili, ma isola gli adattatori di ciclo di vita e i punti di integrazione nativa. Un pratico architettura delle applicazioni mobile dovrebbe rendere visibili quei confini nella struttura delle cartelle e nel grafo delle dipendenze.
Persistenza e sincronizzazione Offline-First
Uno store in memoria non è uno stato durevole. Il sistema operativo può sospendere o terminare un processo mobile, un utente desktop può chiudere una finestra e la rete può scomparire mentre una mutazione è in corso. Il design offline-first inizia decidendo cosa l'utente deve poter recuperare, poi scegliendo le regole di storage e sincronizzazione attorno a quel requisito.
Costruire un percorso di scrittura durevole
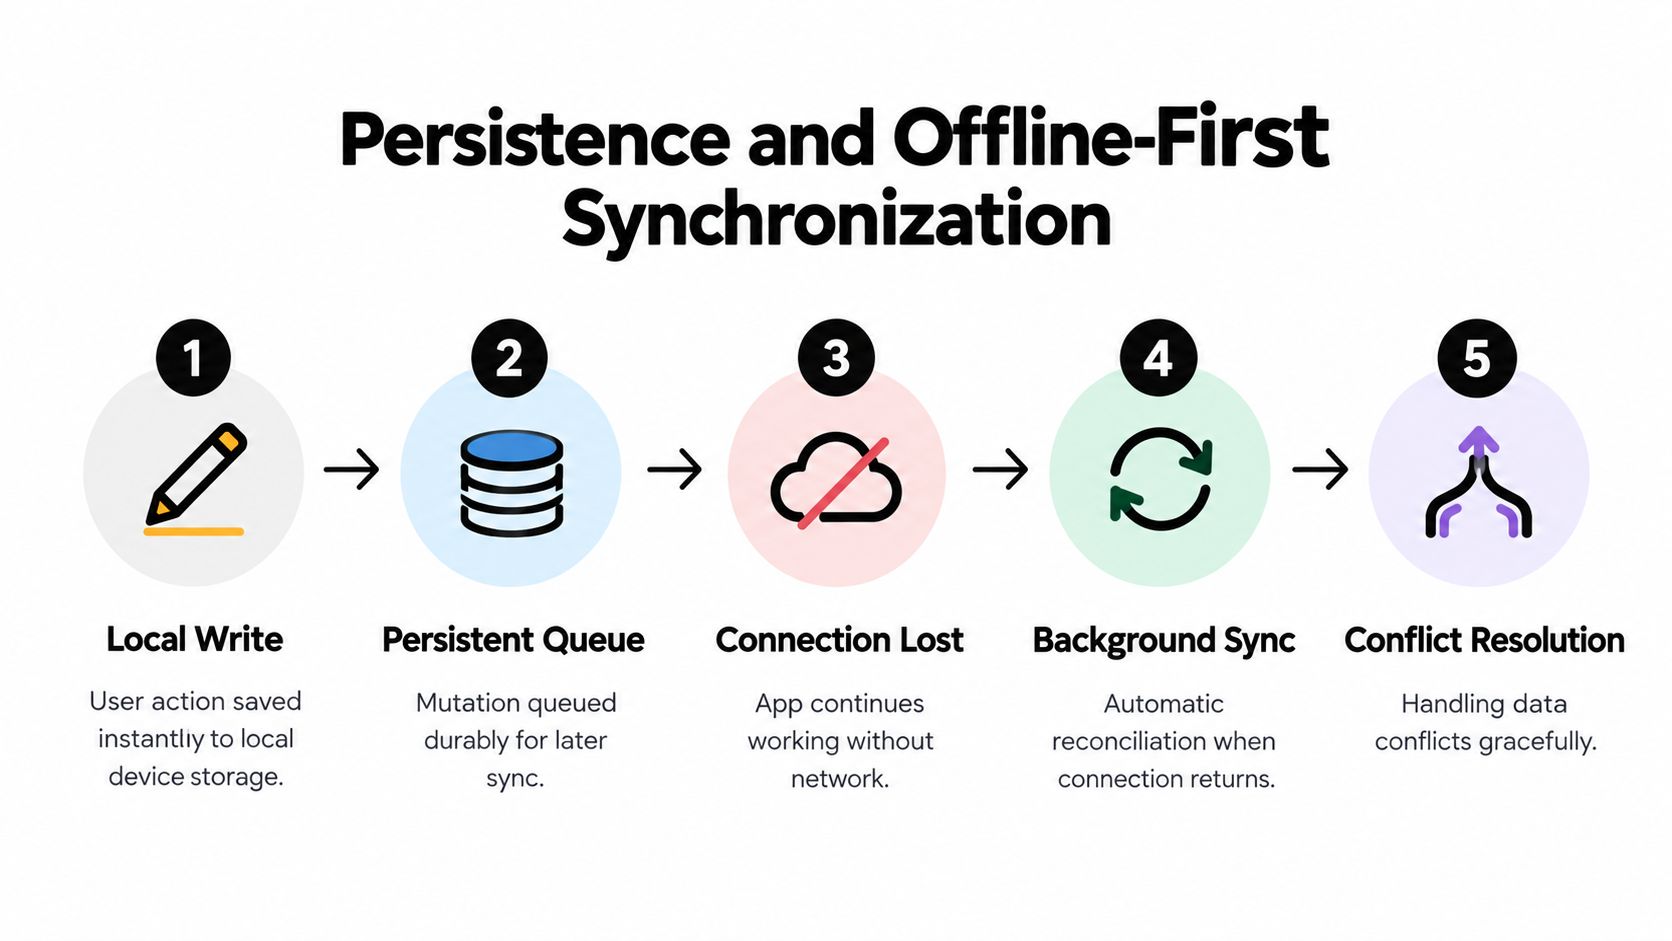
Un flusso affidabile separa l'esperienza utente immediata dalla conferma remota:
- Scrivi prima in locale. Applica l'azione dell'utente a un database locale o a un document store durevole, in modo che l'interfaccia risponda senza attendere la rete.
- Metti la mutazione in coda. Salva un'operazione con il suo identificatore di entità, il tipo di operazione, il payload, il contesto di creazione e lo stato di retry. Una coda mantenuta solo in memoria scompare con il processo.
- Mostra uno stato veritiero. Distingui tra salvato localmente, in attesa di sincronizzazione, sincronizzato e fallito. Gli utenti devono sapere se una modifica è persistente sul dispositivo o confermata in remoto.
- Sincronizza quando le condizioni lo consentono. Listener di riconnessione, eventi di foreground dell'app e attività in background pianificate possono attivare i retry. Il worker di sincronizzazione deve essere idempotente, perché le richieste interrotte potrebbero essere inviate di nuovo.
- Risolvi i conflitti in modo consapevole. La risposta del server deve stabilire se l'operazione locale è stata accettata, rifiutata, unita o richiede la revisione dell'utente.
SQLite è una scelta pratica per record relazionali e code transazionali in applicazioni con supporto nativo. IndexedDB può adattarsi allo storage orientato al browser e ai renderer Electron code, a patto che il team gestisca con cura gli upgrade dello schema e i confini delle transazioni. Mantieni esplicita la serializzazione. Persisti i dati di dominio e i metadati di recupero, non le istanze dei componenti, le closure o i riferimenti a oggetti nativi.
La policy di conflitto è una decisione di prodotto
Il modello Last-write-wins è semplice, ma può scartare modifiche legittime. Il merging a livello di campo funziona quando i campi indipendenti possono essere combinati in sicurezza. Le regole specifiche del dominio sono più sicure per inventari, approvazioni, record finanziari o workflow clinici, dove un merge automatico potrebbe alterarne il significato. Alcuni conflitti dovrebbero bloccare la sincronizzazione e chiedere all'utente di scegliere.
Il layer di sincronizzazione dovrebbe anche separare la riconciliazione in lettura da il replay delle mutazioni. Il refetch dei dati dal server non prova che una mutazione in coda sia andata a buon fine, e il replay di una mutazione non garantisce che il record risultante corrisponda ancora alla rappresentazione attuale sul server. Registra le versioni del server o validatori equivalenti, restituisci risposte di conflitto strutturate e mantieni una cronologia della coda sufficiente a spiegare i fallimenti.
Per la parte dell'interfaccia utente di questo design, creare una schermata offline in Vue, Angular o React mette in luce un aspetto importante dell'interfaccia: la modalità offline deve essere uno stato visibile dell'applicazione, non un'eccezione nascosta in console.
Il seguente video può integrare il lavoro di implementazione relativo al comportamento offline e alla sincronizzazione:
Strategie di tuning e test delle prestazioni
I problemi di performance dello stato raramente iniziano con un singolo reducer lento. Emergono quando ampie sottoscrizioni causano il rendering di componenti non correlati, i valori derivati vengono ricalcolati inutilmente, i grandi grafi di oggetti restano referenziati o il lavoro di sincronizzazione viene eseguito sul thread UI. Misura la propagazione degli aggiornamenti invece di indovinare quale libreria sia la più veloce.
Un benchmark del 2026 utilizzando un dashboard con 100 componenti connessi e 10.000 iterazioni ha misurato MobX a 0,3 ms per modifiche semplici, 0,4 ms per modifiche annidate e 0,6 ms per modifiche derivate, mentre Redux Toolkit ha misurato 0,8 ms, 1,2 ms e 1,5 ms nei test corrispondenti. Lo stesso benchmark ha registrato 2,8 MB per Zustand e 4,2 MB per Redux Toolkit nel confronto della memoria. Queste sono osservazioni specifiche del benchmark, non garanzie universali di produzione, ma illustrano perché la granularità delle sottoscrizioni e la strategia di aggiornamento contano. Vedi il benchmark comparativo di state management per React per il contesto di test.
Regola il confine dell'update
Inizia dai selettori. Un componente dovrebbe sottoscrivere la slice minima significativa, non l'intero oggetto di sessione o la risposta API. Mantieni memoizzati i dati derivati quando il calcolo è costoso, ma non memoizzare ogni valore primitivo per riflesso. La memoizzazione aggiunge anche lavoro di retention e confronto, quindi esegui il profiling prima e dopo.
Virtualizza le liste lunghe, normalizza i record quando gli aggiornamenti riguardano singole entità ed evita di sostituire un grande oggetto radice per la modifica di un singolo campo. In Electron, monitora la memoria del renderer durante le sessioni lunghe, poiché le finestre possono rimanere attive molto più a lungo di uno schermo mobile. In Capacitor, evita la persistenza sincrona durante una raffica di input. Usa il debounce per le bozze o persisti checkpoint significativi, assicurandoti che un crash non possa far perdere i dati che il prodotto promette di conservare.
Uno studio collegato a Springer ha scoperto che cambiare l'approccio di state management ha ridotto il tempo di esecuzione del programma in media del 17% negli scenari di test, a supporto dell'idea che ridurre la sincronizzazione e il ricalcolo non necessari possa produrre guadagni concreti a runtime. Il risultato appare nello studio sulle prestazioni della gestione dello stato delle applicazioni web, e non dovrebbe essere considerato un miglioramento garantito per ogni stack.
Testa le transizioni, non solo i valori
Un test dello stato che verifica isLoading dopo una richiesta riuscita trascura i percorsi pericolosi. Testa la sequenza:
- Hydration: i dati persistiti vengono caricati, i record non validi vengono rifiutati e i valori predefiniti riempiono solo i campi mancanti.
- Interruzione: una richiesta viene annullata o l'app passa in background durante una mutazione.
- Replay: le operazioni in coda vengono riprovate in sicurezza senza duplicare gli effetti sul server.
- Conflitto: il server rifiuta una versione obsoleta e l'UI espone una risoluzione recuperabile.
- Isolamento: un aggiornamento locale dell'UI non causa il rendering o la mutazione di funzionalità non correlate.
Mock degli adattatori dello stato del server al confine di rete, quindi usa test di integrazione per flussi completi. Aggiungi strumenti di misurazione in sviluppo e CI per rilevare conteggi di subscriber inaspettati, code illimitate e transizioni di stato che si verificano dopo che una funzionalità è stata smontata. Il fixture di test più prezioso è spesso una sequenza di ciclo di vita realistica, non un'altra asserzione isolata del reducer. Usa guida all'ottimizzazione delle prestazioni dell'app quando si trasformano quelle misurazioni in un controllo di rilascio ripetibile.
Guida specifica per piattaforma per Capacitor ed Electron
Un'applicazione web può assumere che il suo processo JavaScript rimanga disponibile più a lungo rispetto a un'app mobile. Capacitor ed Electron rimuovono questa assunzione in modi diversi. Capacitor inserisce il layer web all'interno di un ciclo di vita mobile gestito da iOS o Android, mentre Electron mantiene un renderer Chromium connesso a un modello di processo desktop con finestre che possono apparire e scomparire indipendentemente.
Capacitor richiede un'idratazione lifecycle-aware
Tratta il backgrounding come un'opportunità di checkpoint, non come prova che il processo riprenderà. Al cambio di stato dell'app, scarica le mutazioni critiche pendenti, registra il cursore di sincronizzazione attuale e rilascia le risorse che non dovrebbero rimanere attive. In foreground, ripristina ciò che è andato perso, verifica l'autenticazione, aggiorna i dati server obsoleti e riavvia le sottoscrizioni solo dopo che lo store locale è pronto.
Lo store JavaScript non dovrebbe possedere direttamente gli interni dei plugin nativi. Le sessioni della fotocamera, i prompt biometrici, la registrazione push, i handle del filesystem e i task in background hanno ciascuno regole di ciclo di vita specifiche della piattaforma. Incapsulali in adapter che traducono i callback nativi in eventi o comandi di dominio. Lo store può quindi rappresentare stati come non disponibile, in richiesta, attivo, fallito o completato, senza trattenere un oggetto nativo che diventa invalido dopo la sospensione.
Il confine del webview rende importante anche la serializzazione. Passa dati semplici attraverso il bridge Capacitor, valida le risposte dei plugin e versiona i messaggi quando un live update potrebbe lasciare diversi web bundle che interagiscono con i code nativi installati. Come Capacitor collega il web e i code nativi spiega il confine che rende necessario questo approccio con gli adapter.
Electron richiede l'ownership dei processi
Il main process di Electron dovrebbe possedere le operazioni privilegiate e il coordinamento durevole, mentre i renderer possiedono lo stato specifico della vista. Usa comandi IPC tipizzati per azioni come la lettura delle impostazioni sicure, la scrittura di file o il coordinamento delle finestre. Non esporre un accesso ampio al filesystem a ogni renderer e non trattare un evento inviato a una finestra come un record durevole dell'applicazione.
Le applicazioni multi-window richiedono un modello di sincronizzazione esplicito. Il processo principale può distribuire aggiornamenti autorevoli, mentre ogni renderer mantiene lo stato di presentazione locale. Se due finestre modificano lo stesso record, l'applicazione deve avere controlli di versione o una policy di conflitto, non un semplice evento di broadcast. Una finestra chiusa deve poter ricostruire lo stato quando viene riaperta, quindi il processo principale o il layer di persistenza deve restare la fonte dei dati recuperabili.
Capacitor ed Electron possono condividere i modelli di dominio, i client API, i formati delle code e i reducer. Non devono necessariamente condividere i code del ciclo di vita. L'architettura cross-platform più solida prevede un vocabolario di stato comune e adapter specifici per piattaforma per durabilità, bridge e ripristino.
Migrare verso un'architettura ibrida moderna
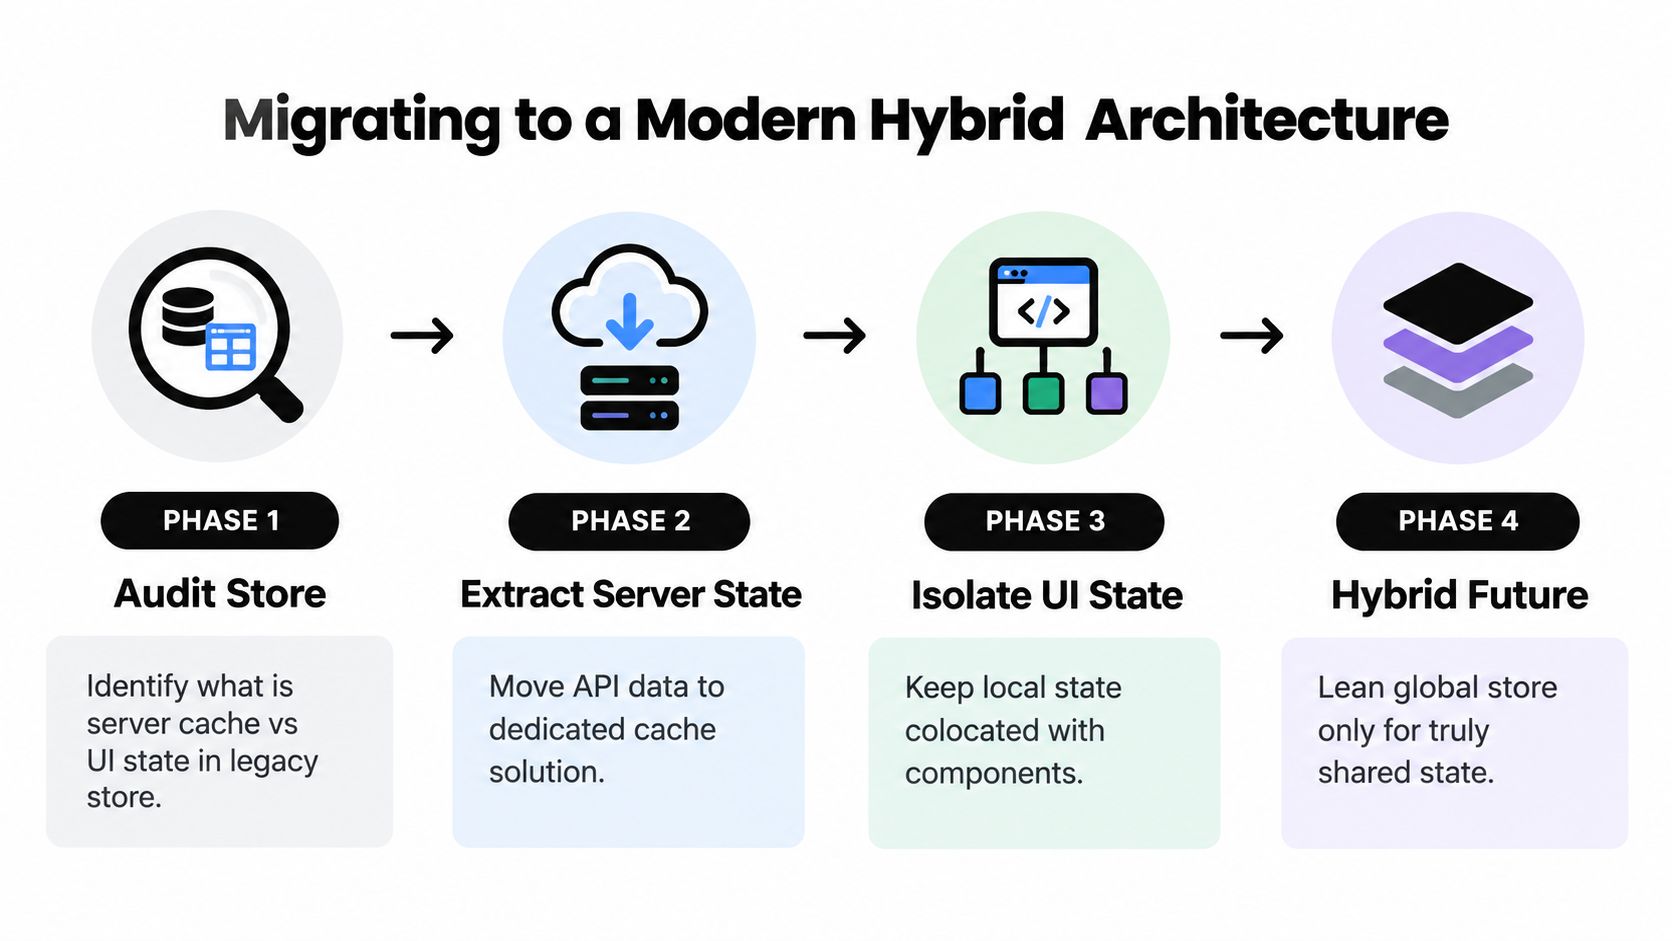
Raramente uno store globale legacy ha bisogno di una riscrittura. Serve invece un inventario e una sequenza di estrazioni sicure. La migrazione funziona meglio quando ogni feature può spostare una classe di stato alla volta, mantenendo il vecchio store disponibile per le schermate non ancora migrate.
Parti dall'ownership, non dalla tecnologia
Crea un catalogo dello stato per lo store esistente. Per ogni campo, registra la sua origine, i consumer, i percorsi di mutazione, i requisiti di persistenza e il comportamento di recupero. Indica se è derivato dal server, dalla route, posseduto da un form, locale alla feature o condiviso. Questo esercizio spesso rivela che lo store globale contiene diversi sistemi non correlati nascosti dietro un unico API.
Sposta prima lo stato del server. Sostituisci i campi API replicati manualmente con un layer dedicato di fetching e caching che gestisca lo stato delle richieste, l'invalidazione, i retry e la riconvalida. Mantieni i selector temporaneamente compatibili in modo che gli screen esistenti possano migrare senza modificare ogni call site in una volta sola. Elimina la copia duplicata del server solo dopo che la nuova fonte ha superato i test di integrazione.
Successivamente, restituisci lo stato dell'URL al router. I filtri di ricerca e le risorse selezionate dovrebbero sopravvivere a reload e condivisioni tramite parametri di route o query state. Rimuovi gli effetti di sincronizzazione che copiano i valori dell'URL in uno store e poi i valori dello store di nuovo nell'URL. Questi loop creano race condition e rendono la cronologia del browser più difficile da fidarsi.
Estrai lo stato delle feature incrementalmente
Sposta lo stato dei modali, i progressi dei wizard e le selezioni locali nel confine di feature più vicino. Se più componenti hanno bisogno del valore, usa uno store di feature con un'interfaccia stretta. Riserva lo store globale rimanente per preoccupazioni trasversali come la policy di sessione, il tema, i permessi o un workflow esplicitamente condiviso.
Usa un layer di compatibilità durante la transizione. Può leggere dalla nuova sorgente mantenendo la vecchia struttura dei selettori, permettendo di migrare le feature tramite flag. Rilascia ogni estrazione in modo indipendente, monitora i percorsi di errore e il comportamento di hydration, e mantieni una via di rollback finché il nuovo modello di ownership non sarà stabile.
Per i team Capacitor ed Electron, Capgo può distribuire bundle firmati di JavaScript, CSS, configurazioni e asset tramite canali mirati, con controlli di rollout, cronologia delle versioni, log dei dispositivi, metriche di adozione e fallimento e protezione automatica dal rollback. Questo permette di rilasciare un refactor dello state management in modo incrementale, mentre le modifiche native seguono il processo di rilascio della piattaforma pertinente. Il vantaggio operativo è il controllo sulla migrazione, non un motivo per saltare test o pianificazione della compatibilità.
Best practice ed errori comuni da evitare
L'architettura dello stato fallisce quando i requisiti rimangono vaghi. Usa questi controlli durante le design review e le pull request:
- Indica l'owner in code: Chiedi: “Quale modulo può cambiare questo valore e cosa in API fa rispettare quel confine?” Rifiuta uno store aggiunto solo perché due componenti hanno attualmente bisogno dello stesso campo.
- Definisci il contratto di recovery: Per ogni valore persistito, documenta se reload, riavvio dell'app, logout e cambio account lo preservano o lo cancellano. Una bozza di fattura può sopravvivere a un riavvio, mentre un workspace selezionato potrebbe richiedere una rivalidazione.
- Rendi la sincronizzazione osservabile: Registra i request ID, le versioni, i tentativi di retry e l'esito dei conflitti. Imposta un alert per retry ripetuti o conflitti prima che gli utenti segnalino la mancanza di update.
- Controlla i comandi, non la struttura dell'oggetto: Una mutazione deve dichiarare l'intento di business, validare gli input ed esporre un nome dell'azione adatto all'audit. Le scritture dirette che bypassano questi controlli vanno affrontate in review.
- Testa sequenze ostili: Esegui test per l'hydration in race con la navigazione, una scrittura interrotta seguita da un retry, consegne duplicate, modifiche offline da due finestre e logout durante una richiesta in sospeso.
- Verifica il percorso di rimozione: Una migrazione è incompleta se un vecchio selettore, un adapter di persistenza o un event listener scrive ancora nello store precedente. Aggiungi un test che fallisca se entrambe le fonti possono aggiornare lo stesso campo.
Una domanda pratica da farsi in PR è: “Cosa succede se questo processo scompare dopo l'inizio della scrittura ma prima dell'acknowledgement?”. La risposta deve indicare quali dati sono durevoli, chi gestisce il retry, la deduplicazione e lo stato di errore visibile all'utente.
Capgo aiuta i team CapacitorJS ed Electron a distribuire aggiornamenti di JavaScript, CSS, configurazioni e asset tramite canali mirati, con bundle firmati, controlli di rollout, log a livello di device e protezione dal rollback. Usa Capgo per rilasciare refactoring dello state management e fix di recovery in modo incrementale, validandoli poi con test di lifecycle e sincronizzazione.





