
Le conseil le plus répandu sur la gestion d’état d’application est aussi le moins utile : choisir un store global et y mettre tout. Cette approche traite les réponses API, la visibilité des modales, les saisies de formulaire non enregistrées, l’authentification et les filtres de navigation comme s’ils avaient le même cycle de vie. Ce n’est pas le cas. Une application Capacitor ou Electron s’exécute à la fois sur une couche web et un runtime natif ou desktop, il faut donc séparer l’état selon sa source, sa durée de vie, son propriétaire et ce qui se passe quand le réseau ou le processus disparaît.
La gestion d’état est devenue fondamentale car les runtimes mobiles sont volatils. Les applications peuvent être détruites puis recréées après un changement d’orientation ou une condition de mémoire faible, et Android fournit la restauration de l’état d’instance et des callbacks de cycle de vie tels que onSaveInstanceState() pour cette raison, comme documenté dans un Étude UC Riverside sur la gestion fiable de l'état des apps mobiles. Cette même étude a examiné 966 applications et 4 808 activités, révélant que 452 applications, soit 46,8 %, contenaient au moins une activité avec un état non vide, tandis que 1 896 activités avait un état global non vide. L'état n'est pas une abstraction optionnelle que l'on ajoute une fois l'UI fonctionnelle. Il fait partie intégrante du contrat d'exécution.
Table des matières
- Repenser le modèle de store global
- Patterns d'architecture pour les apps multiplateformes
- Persistance et synchronisation offline-first
- Optimisation des performances et stratégies de test
- Conseils par plateforme pour Capacitor et Electron
- Migrer vers une architecture hybride moderne
- Bonnes pratiques et erreurs courantes à éviter
Repenser le modèle de store global
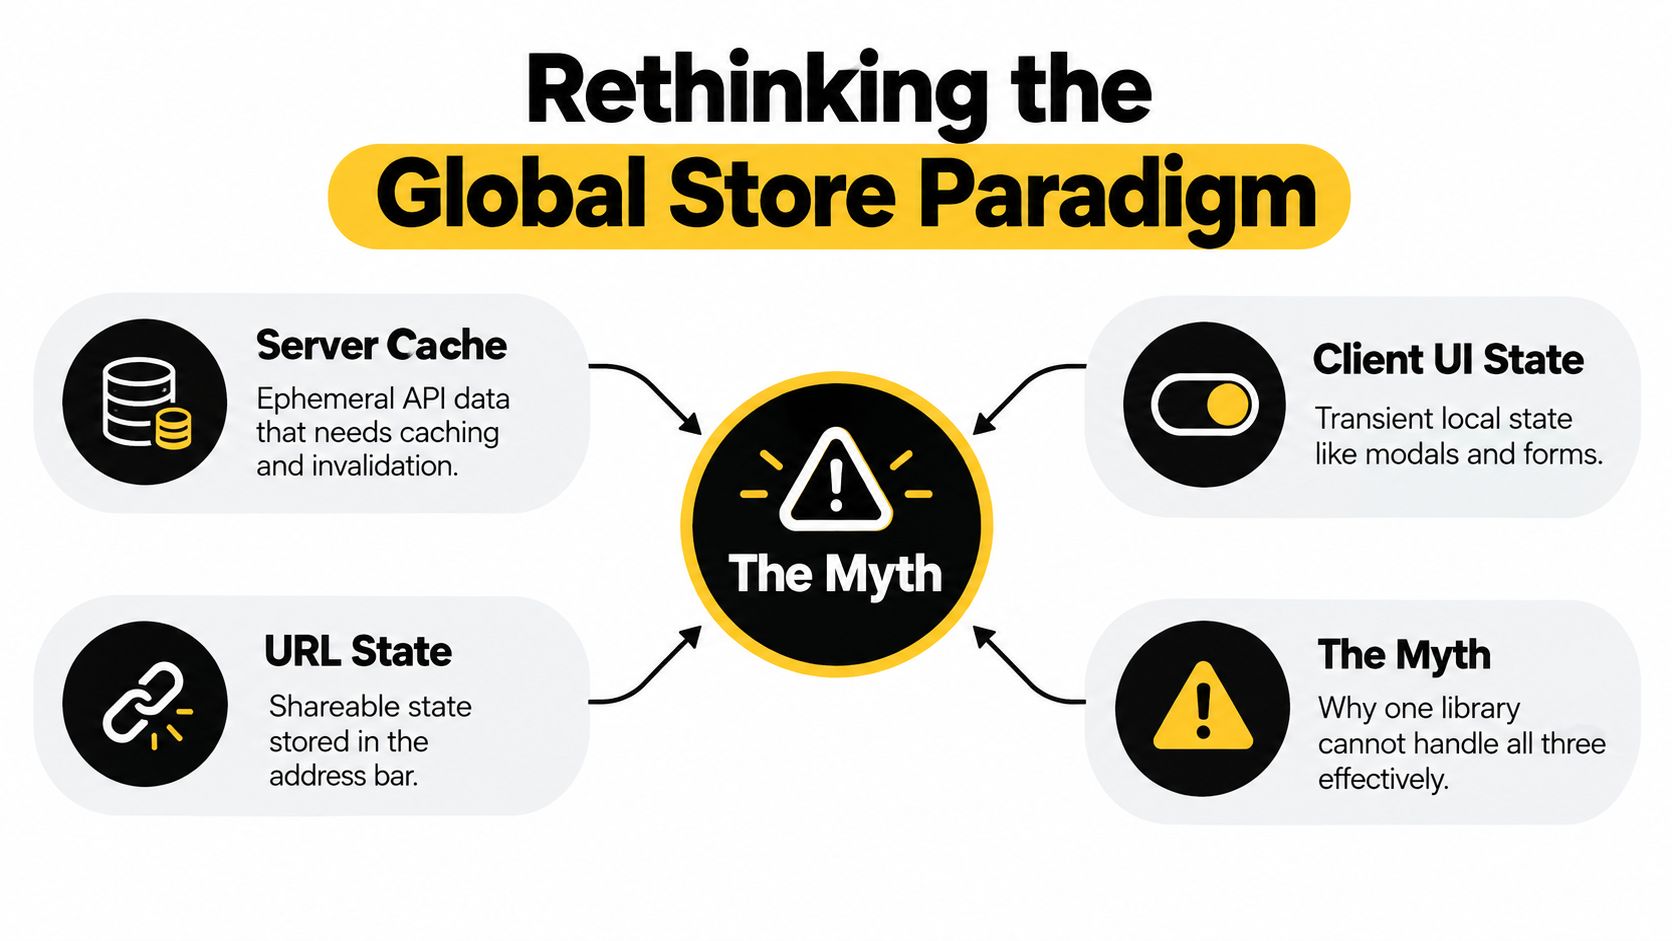
Comparer Redux, Context et MobX est un mauvais point de départ. Un store peut coordonner les mises à jour, mais il ne peut pas déterminer si une valeur appartient au serveur, à l'écran actuel, à un flux de formulaire ou à la barre d'adresse. Tout mettre dans un seul conteneur global crée des caches API dupliqués, des paramètres d'URL obsolètes et des abonnements qui forcent le rerender d'écrans sans rapport.
Une conception durable attribue à chaque valeur un propriétaire et une politique de récupération :
- État serveur appartient à la couche de récupération et de mise en cache des données. Les réponses API, le statut de chargement, les erreurs, la fraîcheur, l'invalidation et les retries décrivent une ressource distante. Le serveur fait autorité, le client ne doit donc pas maintenir une seconde source de vérité permanente.
- État client ou UI reste proche du composant ou de la fonctionnalité qui le possède. La visibilité des modales, les onglets sélectionnés, les lignes dépliées, les préférences de thème et les flags d'interaction temporaires ne nécessitent généralement aucune persistance à l'échelle de l'application.
- État de formulaire suit un workflow distinct. La saisie en brouillon, les messages de validation, l'état « modifié » et la progression de la soumission doivent parfois survivre à la navigation dans un formulaire, mais ils ne doivent pas devenir automatiquement un état métier partagé.
- État de l'URL appartient au routeur. Les termes de recherche, les filtres, les choix de tri, les enregistrements sélectionnés et la pagination dans la barre d'adresse peuvent être mis en favori, partagés, restaurés et inspectés sans avoir à les copier dans un autre store.
Pourquoi un seul store crée de la friction architecturale
L’année 2024 de la gestion de l'état des applications examine la gestion de l'état dans les applications web et mobiles. Son périmètre reflète un changement pratique, passant de variables UI dispersées vers une architecture explicite et consciente du cycle de vie. L'évolution d'Android, des bundles d'état d'instance vers ViewModel et SavedStateHandle, suit la même direction, mais cela ne signifie pas que chaque valeur doit se trouver dans un conteneur partagé unique.
Un store global conserve un rôle défini. L’identité de session, les permissions, les préférences au niveau de l’app, la politique de connectivité et les workflows inter-fonctionnalités soigneusement délimités peuvent nécessiter une propriété partagée. Les problèmes commencent lorsque ce store devient un dépotoir pour des valeurs ayant un propriétaire plus approprié.
Règle pratique : Si une valeur peut être reconstruite depuis le serveur, l’URL ou le composant actuel, gardez-la hors de l’état global, sauf si un workflow spécifique exige le contraire.
Cette limite soutient également les modules possédés de manière indépendante. Les équipes qui découpent un produit en zones déployables peuvent appliquer les principes de propriété utilisés dans architecture micro-frontend, plutôt que de construire un seul graphe de dépendances pour toute l'application. Dans une base de code Capacitor ou Electron, un modèle hybride fonctionne mieux : les données distantes passent par le cache et des règles de synchronisation, les valeurs d'UI restent locales, et l'état durable des workflows fait l'objet d'une persistance explicite. Cette séparation limite les écritures concurrentes et rend la reprise plus facile à appréhender après un rechargement, une suspension de processus ou une période hors ligne.
Patterns d'architecture pour les apps multiplateformes
Une fois que l'état a un propriétaire, le choix d'implémentation devient beaucoup plus restreint. La plupart de l'état côté client relève de l'un de ces trois patterns : état local de composant, un petit store partagé, ou communication événementielle entre modules isolés. Aucun n'est universellement supérieur. Le mauvais choix apparaît généralement lorsqu'une équipe choisit un pattern avant d'avoir identifié la fréquence de mise à jour, la propriété et les besoins de reprise.
| Modèle | Complexité | Empreinte mémoire | Meilleur cas d'usage |
|---|---|---|---|
| État local des composants | Faible | Faible | Bascules propres à l’écran, brouillons, panneaux de divulgation, sélection temporaire |
| Store centralisé léger | Modérée | Modérée | Préférences de session partagées, thème, espace de travail actif, coordination UI entre fonctionnalités |
| Architecture de bus d’événements | Modéré à élevé | Variable | Modules faiblement couplés, notifications de plugins, événements du pont natif, limites de fonctionnalités isolées |
L'état local doit être la règle par défaut
Une valeur locale à un composant a un chemin de dépendances court. Lorsqu'une modale s'ouvre, qu'une ligne se déplie ou qu'un champ de formulaire change, la fonctionnalité propriétaire peut se mettre à jour sans notifier toute l'application. Cela réduit le couplage accidentel et rend les tests unitaires directs. Cela limite également la mémoire retenue lorsque les écrans mobiles sont suspendus ou que les fenêtres desktop restent ouvertes pendant de longues sessions.
L'état local devient inconfortable lorsque plusieurs fonctionnalités distantes ont besoin de la même valeur ou lorsqu'un flux de travail traverse des limites de routes. Dans ces cas, hisser l'état vers un store de fonctionnalités est généralement préférable à son placement dans un singleton applicatif. Un petit store comme Zustand ou Pinia peut exposer des sélecteurs ciblés et des actions explicites sans exiger que chaque composant s'abonne à chaque changement.
Le compromis est la discipline. Les stores légers sont faciles à créer, si bien que les équipes peuvent finir avec de nombreux stores superposés et une propriété floue. Nommez le propriétaire, définissez les méthodes de mutation et évitez d'exposer un objet mutable que n'importe quel composant peut réécrire.
Les événements sont utiles, mais ce ne sont pas une base de données
Un event bus fonctionne bien pour les notifications telles que « le partage natif est terminé », « la fenêtre est devenue active » ou « une tâche de fond a reçu de nouvelles données ». Il permet aux plugins et aux modules de communiquer sans avoir à s'importer entre eux. En revanche, il est peu adapté comme seule source de vérité de l'état métier, car les événements sont éphémères. Un abonné suspendu, déchargé ou enregistré trop tard risque de manquer le message.
Utilisez les événements pour annoncer qu'une action a eu lieu, puis laissez le module récepteur interroger son store de référence ou sa couche de données. Gardez des noms d'événements précis et des payloads versionnés là où le code peut évoluer séparément côté natif et côté web.
Pour un contexte architectural plus large, les analyses de Bridge Global sur le développement d'applications mobiles sont utiles pour évaluer le compromis entre un code partagé et un comportement spécifique à la plateforme. La même limite s'applique à l'état de l'application : partagez les règles métier lorsqu'elles sont stables, mais isolez les adaptateurs de cycle de vie et les points d'intégration natifs. Une architecture d'application mobile devrait rendre ces limites visibles dans la structure des dossiers et le graphe de dépendances.
Persistance et synchronisation offline-first
Un store en mémoire n'est pas un état durable. Le système d'exploitation peut suspendre ou interrompre un processus mobile, un utilisateur de bureau peut fermer une fenêtre, et un réseau peut disparaître pendant qu'une mutation est en cours. La conception offline-first commence par décider de ce que l'utilisateur doit pouvoir récupérer, puis par choisir le stockage et les règles de synchronisation en fonction de ce besoin.
Construisez un chemin d'écriture durable
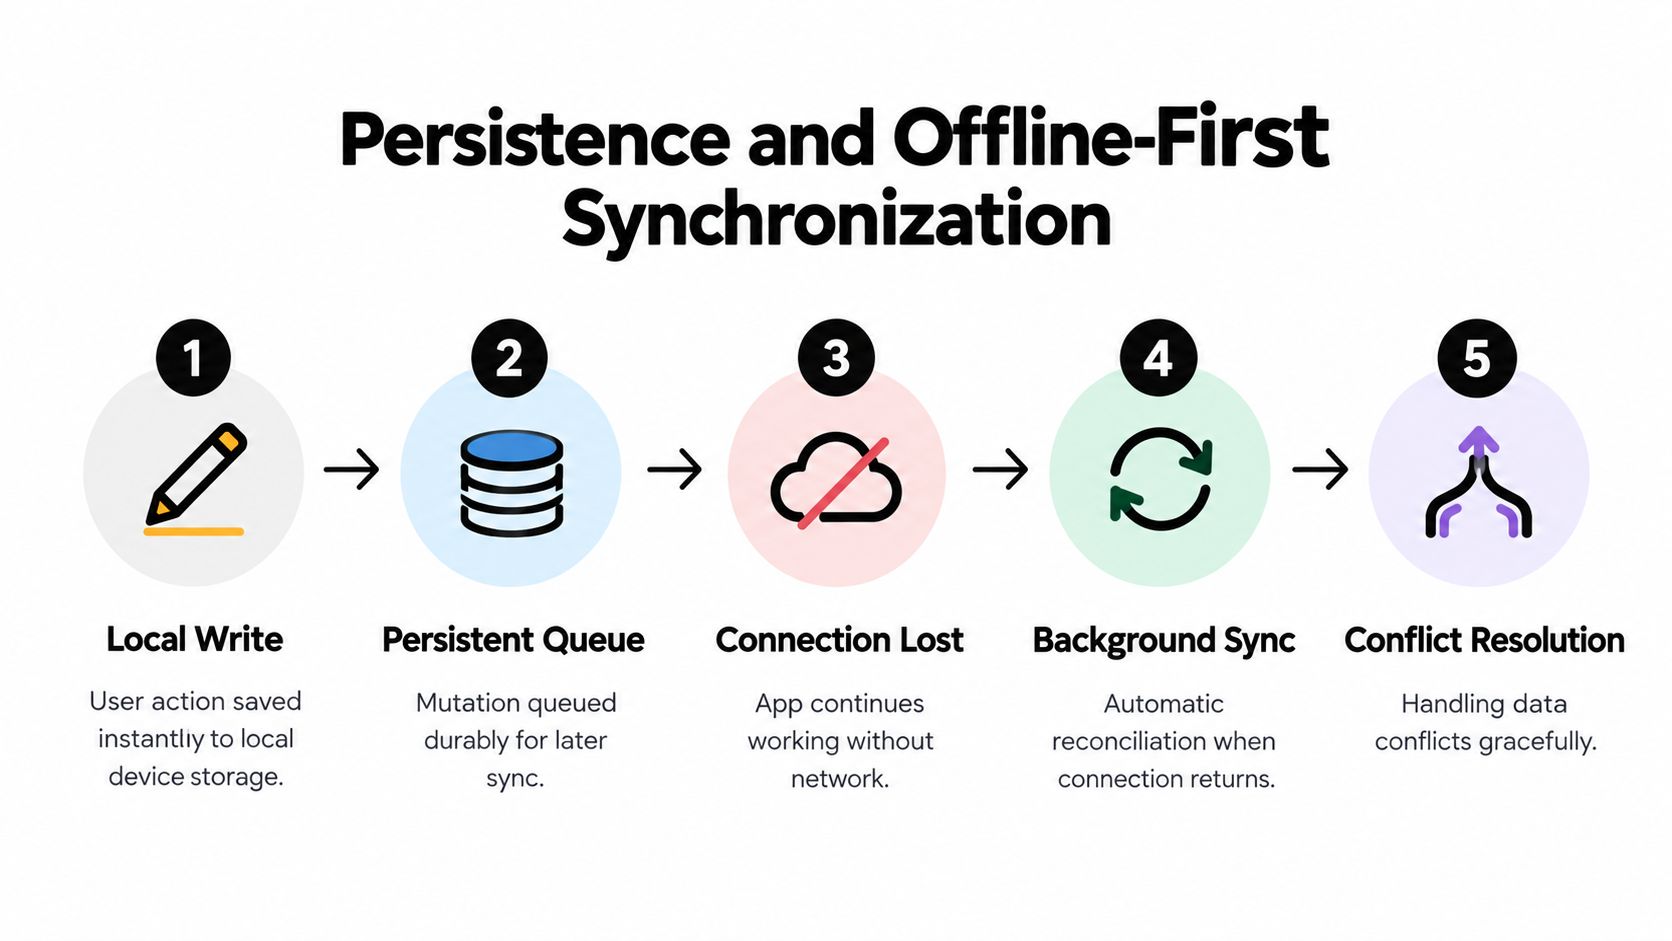
Un flux fiable sépare l’expérience utilisateur immédiate de l’accusé de réception distant :
- Écrire localement d’abord. Appliquer l’action de l’utilisateur à une base de données locale ou à un store de documents durable pour que l’interface réponde sans attendre le réseau.
- Mettre la mutation en file d’attente. Stocker une opération avec son identifiant d’entité, son type, sa charge utile, son contexte de création et son statut de nouvelle tentative. Une file d’attente maintenue uniquement en mémoire disparaît avec le processus.
- Afficher un statut honnête. Distinguer « enregistré localement », « en attente de synchronisation », « synchronisé » et « échec ». Les utilisateurs doivent savoir si un changement est durable sur l’appareil ou confirmé à distance.
- Synchroniser lorsque les conditions le permettent. Reconnect listeners, app foreground events, and scheduled background work can trigger retries. The sync worker should be idempotent because interrupted requests may be sent again.
- Résoudre les conflits de manière délibérée. La réponse du serveur doit déterminer si l’opération locale a été acceptée, rejetée, fusionnée ou nécessite une revue par l’utilisateur.
SQLite est un choix pratique pour les enregistrements relationnels et les files d’attente transactionnelles dans les applications adossées au natif. IndexedDB peut convenir au stockage orienté navigateur et aux renderers Electron code, à condition que l’équipe gère soigneusement les mises à niveau de schéma et les limites de transaction. Garder la sérialisation explicite. Persister les données de domaine et les métadonnées de récupération, pas les instances de composants, les closures ou les références à des objets natifs.
La politique de conflit est une décision produit
Last-write-wins est simple, mais il peut écarter des modifications légitimes. La fusion au niveau des champs fonctionne lorsque des champs indépendants peuvent être combinés sans risque. Des règles spécifiques au domaine sont plus sûres pour les stocks, les validations, les écritures financières ou les workflows cliniques, où une fusion automatique pourrait changer le sens. Certains conflits doivent bloquer la synchronisation et demander à l'utilisateur de choisir.
La couche de synchronisation doit également séparer la réconciliation des lectures depuis le rejeu des mutations. Récupérer à nouveau les données du serveur ne prouve pas qu'une mutation en file d'attente a réussi, et rejouer une mutation ne garantit pas que l'enregistrement résultant corresponde toujours à la représentation actuelle du serveur. Enregistrez les versions serveur ou des validateurs équivalents, renvoyez des réponses de conflit structurées et conservez suffisamment d'historique de la file d'attente pour expliquer les échecs.
Pour la partie de cette conception destinée à l'utilisateur, créer un écran hors ligne dans Vue, Angular ou React offre une interface utile : le mode hors ligne doit être un état visible de l’application, et non une exception cachée dans la console.
La vidéo suivante peut compléter le travail d'implémentation autour du comportement hors ligne et de la synchronisation :
Optimisation des performances et stratégies de test
Les problèmes de performance liés à l’état ne commencent presque jamais par un seul reducer lent. Ils apparaissent lorsque de larges abonnements forcent le rendu de composants non liés, que des valeurs dérivées sont recalculées inutilement, que de grands graphes d’objets restent référencés, ou que le travail de synchronisation s’exécute sur le thread UI. Mesurez la propagation des mises à jour plutôt que de deviner quelle bibliothèque est la plus rapide.
Un benchmark de 2026 utilisant un dashboard avec 100 composants connectés et 10 000 itérations a mesuré MobX à 0,3 ms pour les changements simples, 0,4 ms pour les changements imbriqués et 0,6 ms pour les changements dérivés, tandis que Redux Toolkit a mesuré 0,8 ms, 1,2 ms et 1,5 ms dans les tests correspondants. Le même benchmark a enregistré 2,8 Mo pour Zustand et 4,2 Mo pour Redux Toolkit dans sa comparaison de mémoire. Il s’agit d’observations propres aux benchmarks, non de garanties universelles en production, mais elles illustrent l’importance de la granularité des abonnements et de la stratégie de mise à jour. Voir benchmark comparatif de gestion d’état React pour le contexte de test.
Ajuster la limite de mise à jour
Commencez par les sélecteurs. Un composant doit s'abonner à la plus petite tranche de données pertinente, et non à l'objet de session complet ou à la réponse API. Gardez les données dérivées mémoïsées lorsque le calcul est coûteux, mais ne mémoïsez pas chaque primitive par réflexe. La mémoïsation ajoute aussi du travail de rétention et de comparaison, alors profilez avant et après.
Virtualisez les listes longues, normalisez les enregistrements lorsque les mises à jour ciblent des entités individuelles, et évitez de remplacer un objet racine volumineux pour un simple changement de champ. Dans Electron, surveillez la mémoire du renderer lors de sessions prolongées car les fenêtres peuvent rester actives bien plus longtemps qu'un écran mobile. Dans Capacitor, évitez la persistance synchrone lors d'un flux intense de saisies. Utilisez un debounce sur les brouillons ou persistez des points de contrôle significatifs, tout en garantissant qu'un crash ne puisse pas perdre les données que le produit s'engage à conserver.
Une étude liée à Springer a montré que changer d'approche de gestion d'état réduisait le temps d'exécution du programme de 17 % sur les scénarios de test, confirmant l'idée que réduire la synchronisation et le recalcul inutiles peut produire des gains concrets à l'exécution. Le résultat apparaît dans l' Étude de la performance de la gestion d'état des applications web, et ne doit pas être considéré comme une amélioration garantie pour chaque stack.
Testez les transitions, pas seulement les valeurs
Un test d'état qui vérifie isLoading après une requête réussie passe à côté des chemins dangereux. Testez la séquence :
- Hydratation : persisted data loads, invalid records are rejected, and defaults fill only missing fields.
- Interruption : une requête est annulée ou l'application passe en arrière-plan pendant une mutation.
- Rejeu : queued operations retry safely and don’t duplicate server effects.
- Conflit : le serveur rejette une version obsolète et l'UI propose une résolution récupérable.
- Isolation : une mise à jour de l'UI locale n'entraîne pas le rendu ou la mutation de fonctionnalités sans rapport.
Simulez des adaptateurs d'état serveur à la limite du réseau, puis utilisez des tests d'intégration pour les workflows complets. Ajoutez de l'instrumentation en développement et en CI pour détecter les nombres d'abonnés inattendus, les files d'attente non bornées et les transitions d'état survenant après le démontage d'une fonctionnalité. La fixture de test la plus précieuse est souvent une séquence de cycle de vie réaliste, plutôt qu'une énième assertion de reducer isolée. Utilisez Conseils d'optimisation des performances de l'app lorsqu'il s'agit de transformer ces mesures en un contrôle de release reproductible.
Conseils par plateforme pour Capacitor et Electron
Une application web peut partir du principe que son processus JavaScript reste disponible plus longtemps qu'une application mobile. Capacitor et Electron lèvent cette hypothèse, chacun à leur manière. Capacitor place la couche web dans un cycle de vie mobile géré par iOS ou Android, tandis qu'Electron garde un renderer Chromium connecté à un modèle de processus desktop, avec des fenêtres qui peuvent apparaître et disparaître indépendamment.
Capacitor nécessite une hydratation sensible au cycle de vie
Considérez le passage en arrière-plan comme une occasion de checkpoint, pas comme la preuve que le processus reprendra. Lors d'un changement d'état de l'app, videz les mutations critiques en attente, enregistrez le curseur de synchronisation actuel et libérez les ressources qui ne doivent pas rester actives. Au retour au premier plan, réhydratez ce qui a été perdu, vérifiez l'authentification, rafraîchissez les données serveur obsolètes et ne redémarrez les abonnements qu'une fois le store local prêt.
Le store JavaScript ne doit pas posséder directement les rouages internes des plugins natifs. Les sessions caméra, les prompts biométriques, l’enregistrement push, les handles de système de fichiers et les tâches en arrière-plan suivent chacun des règles de cycle de vie propres à la plateforme. Encapsulez-les dans des adaptateurs qui traduisent les callbacks natifs en événements ou commandes de domaine. Le store peut alors représenter des états tels que indisponible, en cours de demande, actif, en échec ou terminé, sans conserver d’objet natif qui devient invalide après suspension.
La frontière webview rend également la sérialisation essentielle. Transmettez des données simples via le pont Capacitor, validez les réponses des plugins et versionnez les messages lorsqu’un live update peut laisser différents bundles web interagir avec des code natifs installés. Comment Capacitor relie le web au code natif explique la frontière qui rend cette approche par adaptateurs nécessaire.
Electron nécessite la propriété du processus
Le processus principal d’Electron doit gérer les opérations privilégiées et la coordination durable, tandis que les renderers gèrent l’état spécifique à la vue. Utilisez des commandes IPC typées pour des actions telles que la lecture de paramètres sécurisés, l’écriture de fichiers ou la coordination des fenêtres. N’exposez pas un accès étendu au système de fichiers à chaque renderer, et ne considérez pas un événement envoyé à une fenêtre comme un enregistrement durable de l’application.
Les applications multi-fenêtres nécessitent un modèle de synchronisation explicite. Le processus principal peut distribuer les mises à jour faisant foi, tandis que chaque renderer maintient un état de présentation local. Si deux fenêtres modifient le même enregistrement, l'application doit utiliser des vérifications de version ou une politique de conflit, et non un simple événement de broadcast. Une fenêtre fermée doit pouvoir reconstruire son état à sa réouverture ; le processus principal ou la couche de persistance doit donc rester la source des données récupérables.
Capacitor et Electron peuvent partager des modèles de domaine, des clients API, des formats de file d'attente et des reducers. Ils ne doivent pas nécessairement partager les code de cycle de vie. L'architecture multiplateforme la plus robuste dispose d'un vocabulaire d'état commun et d'adaptateurs spécifiques à chaque plateforme pour la durabilité, le bridge et la récupération.
Migrer vers une architecture hybride moderne
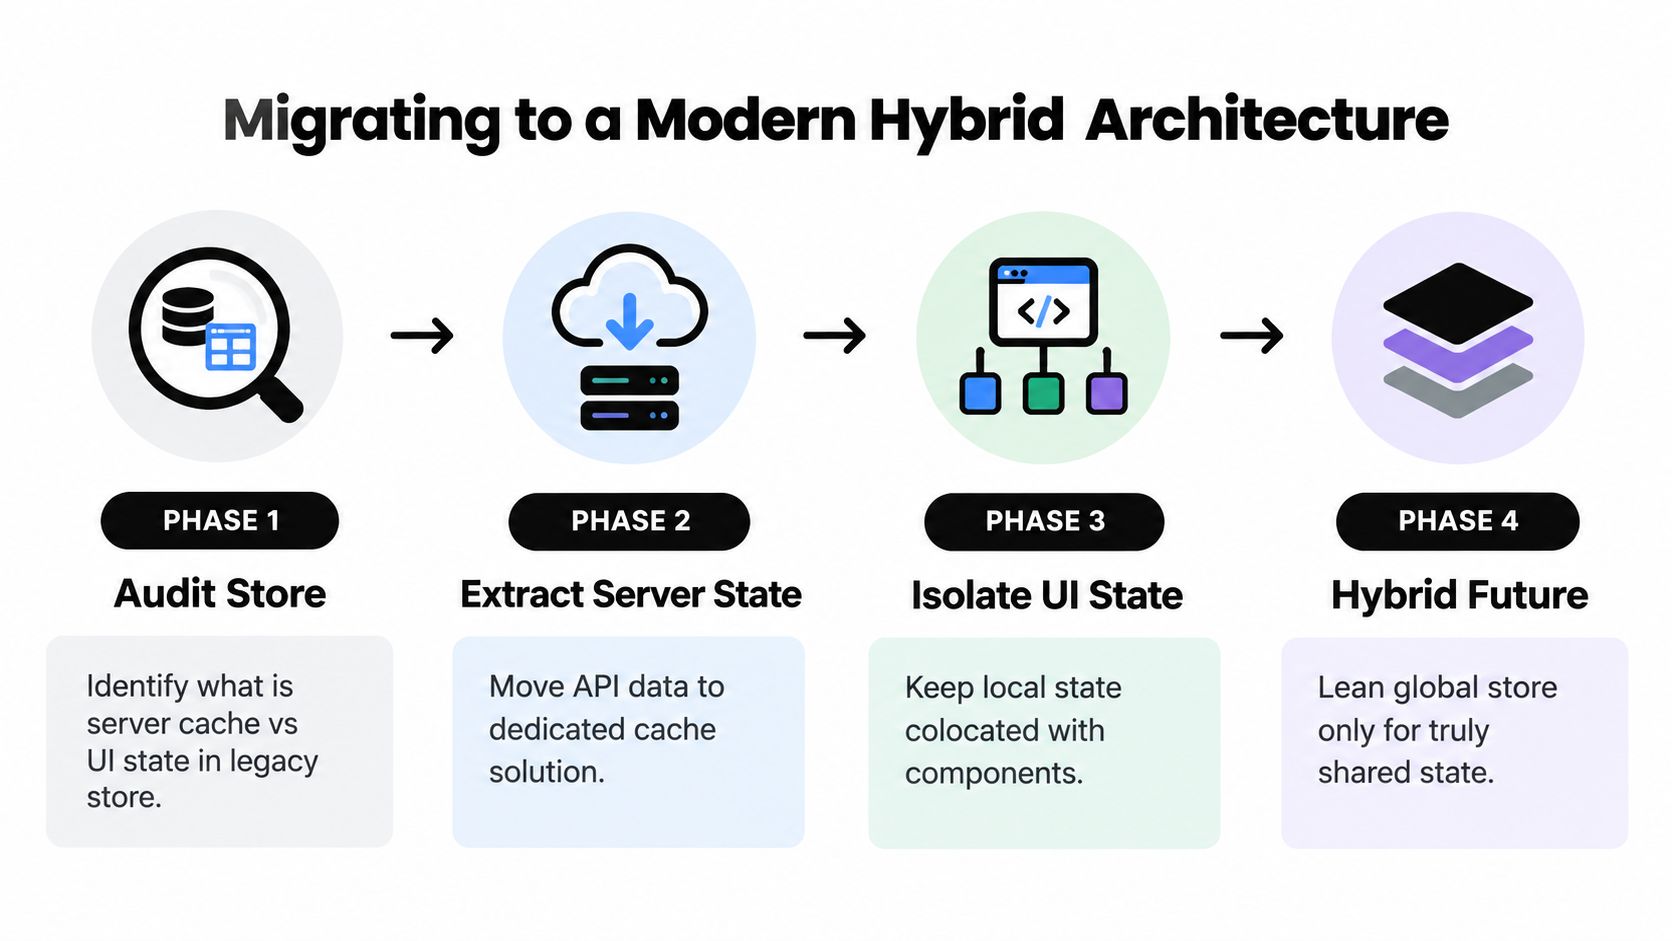
Un store global legacy nécessite rarement une réécriture complète. Il nécessite un inventaire et une séquence d'extractions sécurisées. La migration est plus efficace lorsque chaque fonctionnalité peut faire migrer une classe d'état à la fois, pendant que l'ancien store reste disponible pour les écrans non modifiés.
Commencez par la propriété, pas par la technologie
Créez un catalogue d'état pour le store existant. Pour chaque champ, enregistrez sa source, ses consommateurs, ses chemins de mutation, son besoin de persistance et son comportement de récupération. Indiquez s'il est dérivé du serveur, de la route, géré par un formulaire, local à une fonctionnalité ou partagé. Cet exercice révèle souvent que le store global contient plusieurs systèmes sans lien cachés derrière un seul API.
Commencez par déplacer l'état serveur. Remplacez les champs API répliqués manuellement par une couche dédiée au fetch et au cache qui gère le statut des requêtes, l'invalidation, les retries et la revalidation. Gardez les sélecteurs temporairement compatibles pour que les écrans existants puissent migrer sans modifier tous les points d'appel d'un coup. Ne supprimez la copie serveur dupliquée qu'une fois que la nouvelle source a passé les tests d'intégration.
Ensuite, rendez l'état de l'URL au routeur. Les filtres de recherche et les ressources sélectionnées doivent survivre aux rechargements et au partage via des paramètres de route ou l'état de la query. Supprimez les effets de synchronisation qui copient les valeurs de l'URL dans un store puis recopient les valeurs du store dans l'URL. Ces boucles créent des race conditions et rendent l'historique du navigateur moins fiable.
Extrayez progressivement l'état des fonctionnalités
Déplacez l'état des modales, la progression des wizards et la sélection locale vers la frontière de fonctionnalité la plus proche. Si plusieurs composants ont besoin de la valeur, utilisez un store de fonctionnalité avec une interface restreinte. Réservez le reste du store global aux problématiques transversales comme la politique de session, le thème, les permissions ou un workflow explicitement partagé.
Utilisez une couche de compatibilité pendant la transition. Elle peut lire depuis la nouvelle source tout en exposant l'ancienne forme de sélecteur, ce qui permet aux fonctionnalités de migrer derrière des flags. Publiez chaque extraction indépendamment, surveillez les chemins d'erreur et le comportement d'hydratation, et gardez une solution de rollback jusqu'à ce que le nouveau modèle de propriété soit stable.
Pour les équipes Capacitor et Electron, Capgo peut livrer des bundles JavaScript, CSS, de configuration et d'assets signés via des canaux ciblés, avec des contrôles de déploiement progressif, l'historique des versions, les logs des appareils, les métriques d'adoption et d'échec, et une protection automatique contre les rollbacks. Cela permet de déployer une refonte de la gestion d'état de façon incrémentale, tandis que les changements natifs suivent toujours le processus de release de la plateforme concernée. L'avantage opérationnel, c'est le contrôle de la migration, pas une raison de sauter les tests ou la planification de la compatibilité.
Bonnes pratiques et erreurs courantes à éviter
L'architecture d'état échoue quand les questions de revue restent vagues. Utilisez ces vérifications lors des revues de conception et des pull requests :
- Nommez le propriétaire dans code : Demandez : « Quel module peut modifier cette valeur, et quel API impose cette frontière ? » Refusez un store ajouté uniquement parce que deux composants ont besoin du même champ aujourd'hui.
- Définissez le contrat de récupération : Pour chaque valeur persistée, documentez si le rechargement, le redémarrage de l'app, la déconnexion et le changement de compte la conservent ou l'effacent. Un brouillon de facture peut survivre à un redémarrage, tandis qu'un espace de travail sélectionné peut nécessiter une revalidation.
- Rendez la synchronisation observable : Journalisez les IDs de requête, versions, tentatives et résultats de conflits. Configurez une alerte en cas d’échecs répétés avant que les utilisateurs ne signalent des mises à jour manquantes.
- Examinez les commandes, pas la forme des objets : Une mutation doit exprimer son intention métier, valider les entrées et exposer un nom d’action lisible pour l’audit. Les écritures directes qui contournent ces contrôles relèvent des discussions de revue.
- Testez les séquences hostiles : Exécutez des tests pour la course entre l’hydratation et la navigation, une écriture interrompue suivie d’un retry, une livraison en double, des modifications hors ligne depuis deux fenêtres, et une déconnexion pendant une requête en attente.
- Vérifiez le chemin de suppression : Une migration est incomplète si un ancien sélecteur, adaptateur de persistance ou écouteur d’événements écrit encore vers l’ancien store. Ajoutez un test qui échoue si les deux sources peuvent mettre à jour le même champ.
Une question pratique pour une PR est : « Que se passe-t-il si ce processus disparaît après le début de l’écriture mais avant l’accusé de réception ? » La réponse doit identifier les données durables, la propriété du retry, la déduplication et l’état d’échec visible par l’utilisateur.
Capgo aide les équipes CapacitorJS et Electron à déployer des mises à jour JavaScript, CSS, de configuration et d’actifs via des canaux ciblés, avec des bundles signés, des contrôles de déploiement progressif, des logs au niveau de l’appareil et une protection contre le rollback. Utilisez Capgo pour livrer progressivement les refactors de gestion d’état et les correctifs de récupération, puis les valider avec des tests de cycle de vie et de synchronisation.





