
El consejo más popular sobre gestión del estado de la app es también el menos útil: elige un único store global y pon todo en él. Ese enfoque trata las respuestas de API, la visibilidad de los modales, los inputs de formulario sin guardar, la autenticación y los filtros de navegación como si tuvieran el mismo ciclo de vida. No es así. Una app de Capacitor o Electron se ejecuta a través de una capa web y un runtime nativo o de escritorio, por lo que el estado debe separarse por de dónde proviene, cuánto debe durar, quién es el dueño y qué sucede cuando la red o el proceso desaparecen.
La gestión del estado se volvió fundamental porque los runtimes móviles son volátiles. Las apps pueden destruirse y recrearse tras cambios de orientación o condiciones de poca memoria, y Android ofrece restauración del estado de instancia y callbacks del ciclo de vida como onSaveInstanceState() por esa razón, tal como se documenta en un Estudio de UC Riverside sobre la gestión de estado fiable en apps móviles. El mismo estudio analizó 966 apps y 4.808 actividades, concluyendo que 452 apps (46,8%) tenían al menos una actividad con estado no vacío, mientras que 1.896 actividades tenía un estado global no vacío. El estado no es una abstracción opcional que añades cuando la UI ya funciona; es parte del contrato del runtime.
Tabla de contenidos
- Replanteando el modelo de store global
- Patrones arquitectónicos para apps multiplataforma
- Persistencia y sincronización offline-first
- Optimización del rendimiento y estrategias de testing
- Guía específica por plataforma para Capacitor y Electron
- Migración a una arquitectura híbrida moderna
- Mejores prácticas y errores comunes a evitar
Replanteando el modelo de store global
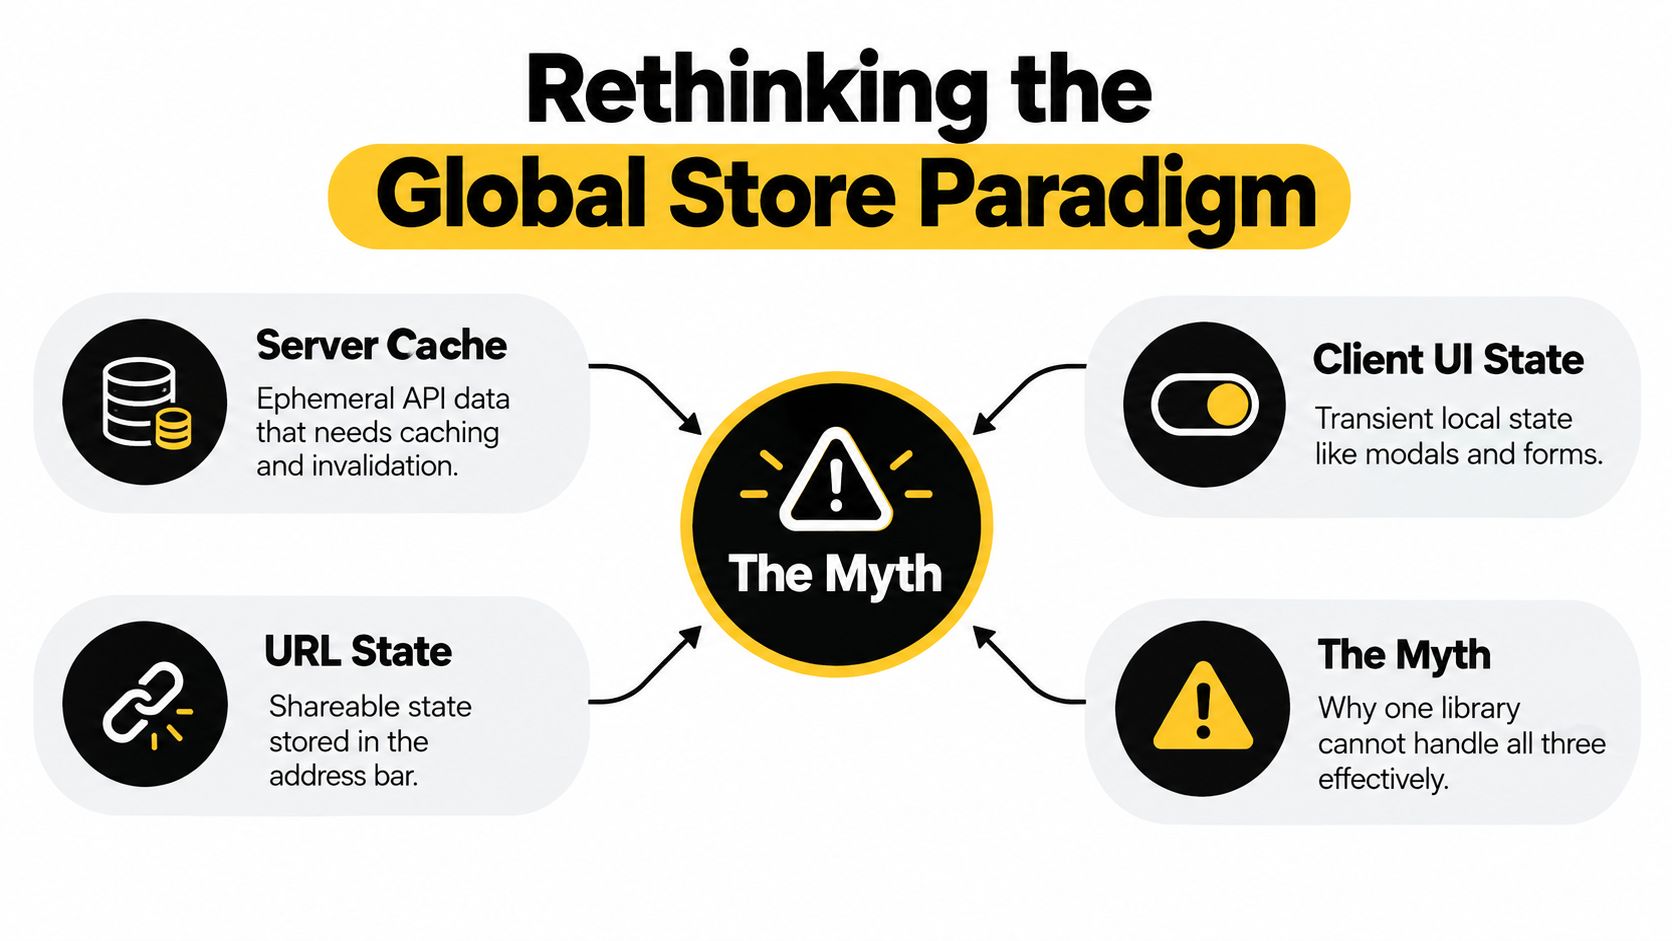
Comparar Redux vs Context vs MobX es un punto de partida erróneo. Un store puede coordinar actualizaciones, pero no puede determinar si un valor pertenece al servidor, a la pantalla actual, a un flujo de formulario o a la barra de direcciones. Meter cada valor en un único contenedor global crea cachés duplicadas de API, parámetros de URL obsoletos y suscripciones que provocan rerenders en pantallas no relacionadas.
Un diseño robusto asigna a cada valor un dueño y una política de recuperación:
- Estado del servidor pertenece a la capa de fetching y caching de datos. Las respuestas de API, el estado de carga, los errores, la frescura, la invalidación y los reintentos describen un recurso remoto. El servidor sigue siendo la autoridad, así que el cliente no debería mantener una segunda fuente de verdad permanente.
- Estado del cliente o de la UI se mantiene cerca del componente o de la feature que lo posee. La visibilidad de modales, las pestañas seleccionadas, las filas expandidas, las preferencias de tema y los flags temporales de interacción no suelen necesitar persistencia en toda la aplicación.
- Form state sigue un flujo de trabajo aparte. La entrada de borrador, los mensajes de validación, el estado dirty y el progreso de envío puede que necesiten sobrevivir a la navegación dentro de un formulario, pero no deberían convertirse automáticamente en estado de negocio compartido.
- Estado de la URL pertenece al router. Los términos de búsqueda, los filtros, las opciones de ordenación, los registros seleccionados y la paginación de la barra de direcciones se pueden guardar en marcadores, compartir, restaurar e inspeccionar sin copiarlos a otro store.
Por qué un único store genera fricción arquitectónica
El 2024 análisis detallado de la gestión del estado de aplicaciones examina la gestión de estado en aplicaciones web y móviles. Su cobertura refleja un cambio práctico: de variables de UI dispersas a una arquitectura explícita y consciente del ciclo de vida. La evolución de Android, de los bundles de estado de instancia a ViewModel y SavedStateHandle, va en la misma dirección, pero eso no significa que cada valor deba estar en un único contenedor compartido.
Un store global sigue teniendo un rol definido. La identidad de sesión, los permisos, las preferencias de la app, la política de conectividad y los flujos entre funcionalidades cuidadosamente acotados pueden requerir propiedad compartida. Los problemas empiezan cuando ese store se convierte en un cajón de sastre para valores que tienen un propietario más adecuado.
Regla práctica: Si un valor se puede reconstruir desde el servidor, la URL o el componente actual, mantenlo fuera del estado global salvo que un flujo de trabajo concreto requiera lo contrario.
Este límite también admite módulos con propiedad independiente. Los equipos que dividen un producto en áreas desplegables pueden aplicar los principios de propiedad usados en arquitectura de micro-frontends, en lugar de construir un único grafo de dependencias para toda la aplicación. En un codebase de Capacitor o Electron, un modelo híbrido funciona mejor: los datos remotos usan reglas de caché y sincronización, los valores de la UI permanecen locales y el estado duradero del workflow se persiste de forma explícita. Esa separación limita los escritores en competencia y hace más fácil razonar sobre la recuperación tras recargas, procesos suspendidos o periodos offline.
Patrones arquitectónicos para apps multiplataforma
Una vez que el estado tiene un dueño, la elección de implementación se acota mucho. La mayoría del estado del lado del cliente encaja en uno de estos tres patrones: estado local del componente, un store compartido pequeño, o comunicación basada en eventos entre módulos aislados. Ninguno es universalmente superior. La elección incorrecta suele darse cuando un equipo elige un patrón antes de identificar la frecuencia de actualización, la propiedad y los requisitos de recuperación.
| Patrón | Complejidad | Consumo de memoria | Caso de uso ideal |
|---|---|---|---|
| Estado local de componentes | Bajo | Bajo | Toggles específicos de pantalla, borradores, paneles desplegables y selección temporal |
| Store ligero centralizado | Moderado | Moderado | Preferencias de sesión compartidas, tema, workspace activo y coordinación de UI entre features |
| Arquitectura de event bus | Moderado a alto | Variable | Módulos desacoplados, notificaciones de plugins, eventos del bridge nativo, límites de features aislados |
El estado local debe ser la opción por defecto
Un valor local de un componente tiene una ruta de dependencia corta. Cuando se abre un modal, se expande una fila o cambia un campo de formulario, la feature propietaria puede actualizarse sin notificar a toda la aplicación. Esto reduce el acoplamiento accidental y hace que los tests unitarios sean directos. También limita la memoria retenida cuando se suspenden pantallas móviles o las ventanas de escritorio quedan abiertas durante sesiones largas.
El estado local se vuelve incómodo cuando varias features alejadas necesitan el mismo valor o cuando un workflow cruza límites de rutas. En esos casos, elevar el estado a un store de feature suele ser mejor que colocarlo en un singleton de toda la aplicación. Un store pequeño como Zustand o Pinia puede exponer selectores específicos y acciones explícitas sin que cada componente tenga que suscribirse a cada cambio.
La contrapartida es la disciplina. Los stores ligeros son fáciles de crear, así que los equipos pueden acabar con muchos stores solapados y responsabilidades poco claras. Nombra al responsable, define métodos de mutación y evita exponer un objeto mutable que cualquier componente pueda reescribir.
Los eventos son útiles, pero no son una base de datos
Un event bus funciona bien para notificaciones como “el share nativo terminó”, “la ventana se activó” o “una tarea en segundo plano recibió nuevos datos”. Ayuda a que plugins y módulos se comuniquen sin que tengan que importarse unos a otros. Funciona mal como único registro del estado de negocio porque los eventos son transitorios. Un suscriptor que se suspendió, se descargó de memoria o se registró tarde podría perder el mensaje.
Usa eventos para anunciar que algo sucedió y luego deja que el módulo receptor consulte su store autoritativo o capa de datos. Mantén los nombres de eventos acotados y los payloads versionados cuando el code nativo y web puedan evolucionar por separado.
Para un contexto arquitectónico más amplio, perspectivas sobre desarrollo de apps móviles de Bridge Global son útiles al comparar el code compartido frente al comportamiento específico de la plataforma. El mismo límite aplica al estado de la app: comparte las reglas de dominio donde sean estables, pero aísla los adaptadores de ciclo de vida y los puntos de integración nativa. Una arquitectura de aplicaciones móviles debería hacer que esos límites sean visibles en la estructura de carpetas y el grafo de dependencias.
Persistencia y sincronización offline-first
Un store en memoria no es un estado duradero. El sistema operativo puede suspender o terminar un proceso móvil, un usuario de escritorio puede cerrar una ventana y la red puede caerse mientras una mutación está en curso. El diseño offline-first empieza por decidir qué debe poder recuperar el usuario y luego elegir el almacenamiento y las reglas de sincronización en función de ese requisito.
Construye una ruta de escritura duradera
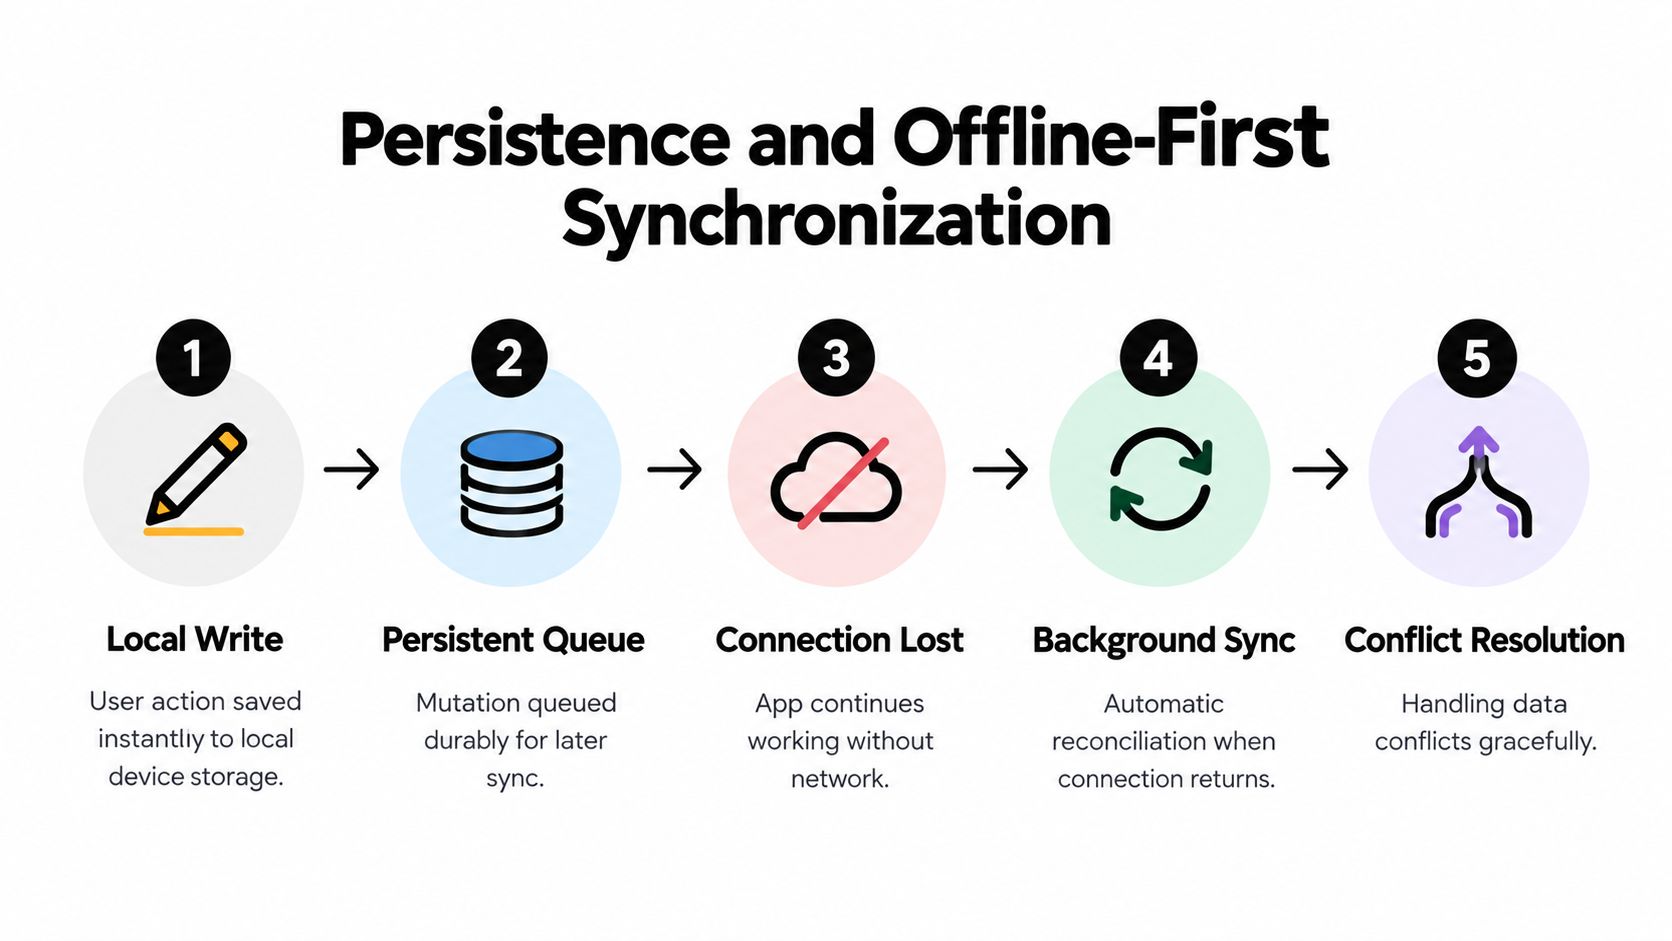
Un flujo fiable separa la experiencia de usuario inmediata del reconocimiento remoto:
- Escribe localmente primero. Aplica la acción del usuario a una base de datos local o un almacén de documentos duradero para que la interfaz responda sin esperar a la red.
- Encola la mutación. Almacena una operación con su identificador de entidad, tipo de operación, payload, contexto de creación y estado de reintento. Una cola mantenida solo en memoria desaparece con el proceso.
- Muestra un estado honesto. Distingue entre guardado localmente, pendiente de sincronización, sincronizado y fallido. Los usuarios necesitan saber si un cambio es duradero en el dispositivo o confirmado remotamente.
- Sincroniza cuando las condiciones lo permitan. Los listeners de reconexión, los eventos de primer plano de la app y el trabajo en segundo plano programado pueden desencadenar reintentos. El worker de sincronización debe ser idempotente, ya que las solicitudes interrumpidas pueden enviarse de nuevo.
- Resuelve los conflictos deliberadamente. La respuesta del servidor debe determinar si la operación local fue aceptada, rechazada, fusionada o requiere revisión del usuario.
SQLite es una opción práctica para registros relacionales y colas transaccionales en aplicaciones con soporte nativo. IndexedDB puede ser adecuado para almacenamiento orientado a navegador y renderers de Electron code, siempre que el equipo gestione cuidadosamente las actualizaciones de esquema y los límites de transacción. Mantén la serialización explícita. Persiste datos de dominio y metadatos de recuperación, no instancias de componentes, closures ni referencias a objetos nativos.
La política de conflictos es una decisión de producto
Last-write-wins es simple, pero puede descartar ediciones legítimas. La fusión a nivel de campo funciona cuando los campos independientes pueden combinarse de forma segura. Las reglas específicas del dominio son más seguras para inventario, aprobaciones, registros financieros o flujos clínicos, donde una fusión automática podría cambiar el significado. Algunos conflictos deberían bloquear la sincronización y pedirle al usuario que elija.
La capa de sincronización también debe separar la reconciliación de lecturas de los la reproducción de mutaciones. Volver a obtener datos del servidor no demuestra que una mutación en cola haya tenido éxito, y reproducir una mutación no garantiza que el registro resultante siga coincidiendo con la representación actual del servidor. Registra las versiones del servidor o validadores equivalentes, devuelve respuestas de conflicto estructuradas y conserva suficiente historial de cola para explicar los fallos.
Para la parte orientada al usuario de este diseño, crear una pantalla offline en Vue, Angular o React proporciona una preocupación de interfaz útil: el modo offline debe ser un estado de aplicación visible, no una excepción oculta en la consola.
El siguiente video puede complementar el trabajo de implementación sobre el comportamiento offline y la sincronización:
Optimización del rendimiento y estrategias de testing
Los problemas de rendimiento del estado rara vez empiezan con un solo reducer lento. Surgen cuando las suscripciones amplias hacen que se rendericen componentes no relacionados, los valores derivados se recalculan sin necesidad, se mantienen referencias a grafos de objetos grandes o el trabajo de sincronización se ejecuta en el hilo de la UI. Mide la propagación de las actualizaciones en vez de adivinar qué librería es más rápida.
Un benchmark de 2026 usando un dashboard con 100 componentes conectados y 10.000 iteraciones midió MobX en 0,3 ms para cambios simples, 0,4 ms para cambios anidados y 0,6 ms para cambios derivados, mientras que Redux Toolkit midió 0,8 ms, 1,2 ms y 1,5 ms en las pruebas correspondientes. El mismo benchmark registró 2,8 MB para Zustand y 4,2 MB para Redux Toolkit en su comparativa de memoria. Estas son observaciones específicas de este benchmark, no garantías universales en producción, pero ilustran por qué importan la granularidad de las suscripciones y la estrategia de actualización. Consulta el benchmark comparativo de gestión de estado en React para el contexto de prueba.
Ajusta el límite de actualización
Empieza con selectores. Un componente debe suscribirse a la porción más pequeña y significativa, no a todo el objeto de sesión ni a la respuesta de API. Mantén memoizados los datos derivados cuando el cálculo sea costoso, pero no memoices cada primitivo por inercia. La memoización también añade trabajo de retención y comparación, así que haz profiling antes y después.
Virtualiza listas largas, normaliza registros cuando las actualizaciones afecten a entidades individuales y evita reemplazar un objeto raíz grande por un cambio en un campo pequeño. En Electron, vigila la memoria del renderer en sesiones largas, ya que las ventanas pueden permanecer abiertas mucho más tiempo que una pantalla móvil. En Capacitor, evita la persistencia síncrona durante ráfagas de input. Aplica debounce a los borradores o persiste checkpoints significativos, y asegúrate de que un crash no pierda los datos que el producto promete retener.
Un estudio vinculado a Springer encontró que cambiar el enfoque de gestión de estado redujo el tiempo de ejecución del programa en un promedio de un 17% en los escenarios de prueba, lo que respalda la idea de que reducir la sincronización y el recálculo innecesarios puede aportar mejoras sustanciales en runtime. El resultado aparece en el estudio del rendimiento en la gestión del estado de aplicaciones web, y no debe tratarse como una mejora garantizada para todos los stacks.
Testea transiciones, no solo valores
Un test de estado que comprueba isLoading tras una petición exitosa deja fuera los paths peligrosos. Testea la secuencia:
- Hidratación: se cargan los datos persistidos, se rechazan los registros inválidos y los valores por defecto solo completan los campos faltantes.
- Interrupción: una petición se cancela o la app pasa a segundo plano durante una mutación.
- Repetir: las operaciones en cola se reintentan de forma segura sin duplicar efectos en el servidor.
- Conflicto: el servidor rechaza una versión desactualizada y la UI ofrece una resolución recuperable.
- Aislamiento: una actualización local de la UI no provoca que se rendericen o muten funcionalidades no relacionadas.
Usa adaptadores mock de estado del servidor en el límite de la red y luego usa tests de integración para flujos completos. Añade instrumentación en desarrollo y CI para detectar recuentos inesperados de suscriptores, colas sin límite y transiciones de estado tras el unmount de una feature. El fixture de test más valioso suele ser una secuencia realista del ciclo de vida, no otra aserción aislada de un reducer. Usa guía de optimización del rendimiento de apps al convertir esas mediciones en una comprobación de release repetible.
Guía específica por plataforma para Capacitor y Electron
Una aplicación web puede asumir que su proceso de JavaScript permanece disponible más tiempo que una app móvil. Capacitor y Electron eliminan esa premisa de formas distintas. Capacitor sitúa la capa web dentro de un ciclo de vida móvil gestionado por iOS o Android, mientras que Electron mantiene un renderer de Chromium conectado a un modelo de procesos de escritorio con ventanas que pueden aparecer y desaparecer de forma independiente.
Capacitor requiere hidratación sensible al ciclo de vida
Trata el backgrounding como una oportunidad para hacer un checkpoint, no como una garantía de que el proceso se reanudará. Ante un cambio de estado de la app, ejecuta el flush de las mutaciones críticas pendientes, registra el cursor de sincronización actual y libera los recursos que no deban seguir activos. Al volver al foreground, rehidrata lo perdido, verifica la autenticación, refresca los datos obsoletos del servidor y reinicia las suscripciones solo cuando el store local esté listo.
El store de JavaScript no debería ser dueño directo de los internals de los plugins nativos. Las sesiones de cámara, los prompts biométricos, el registro de push, los handles del filesystem y las tareas en background tienen sus propias reglas de ciclo de vida de la plataforma. Envuélvelos en adapters que traduzcan los callbacks nativos en eventos de dominio o comandos. Así, el store puede representar estados como unavailable, requesting, active, failed o completed sin retener un objeto nativo que se vuelva inválido tras una suspensión.
El límite de la webview también hace que la serialización sea clave. Pasa datos planos a través del bridge de Capacitor, valida las respuestas de los plugins y versiona los mensajes cuando un live update pueda dejar distintos web bundles interactuando con code nativos instalados. Cómo Capacitor conecta web y code nativos explica el límite que hace necesario este enfoque de adapters.
Electron requiere propiedad de procesos
El proceso principal de Electron debería ser dueño de las operaciones privilegiadas y la coordinación duradera, mientras que los renderers son dueños del estado específico de la vista. Usa comandos IPC tipados para acciones como leer ajustes seguros, escribir archivos o coordinar ventanas. No expongas acceso amplio al filesystem a cada renderer, ni trates un evento enviado a una ventana como un registro duradero de la aplicación.
Las aplicaciones multiventana necesitan un modelo de sincronización explícito. El proceso principal puede distribuir actualizaciones autoritativas, mientras que cada renderer mantiene su estado de presentación local. Si dos ventanas editan el mismo registro, la aplicación necesita verificaciones de versión o una política de conflictos, no solo un evento de broadcast. Una ventana cerrada debe poder reconstruir su estado al volver a abrirse, así que el proceso principal o la capa de persistencia debe seguir siendo la fuente de los datos recuperables.
Capacitor y Electron pueden compartir modelos de dominio, clientes API, formatos de cola y reducers. No necesariamente deberían compartir code de ciclo de vida. La arquitectura multiplataforma más sólida tiene un vocabulario de estado común y adaptadores de durabilidad, bridge y recuperación específicos de cada plataforma.
Migración a una arquitectura híbrida moderna
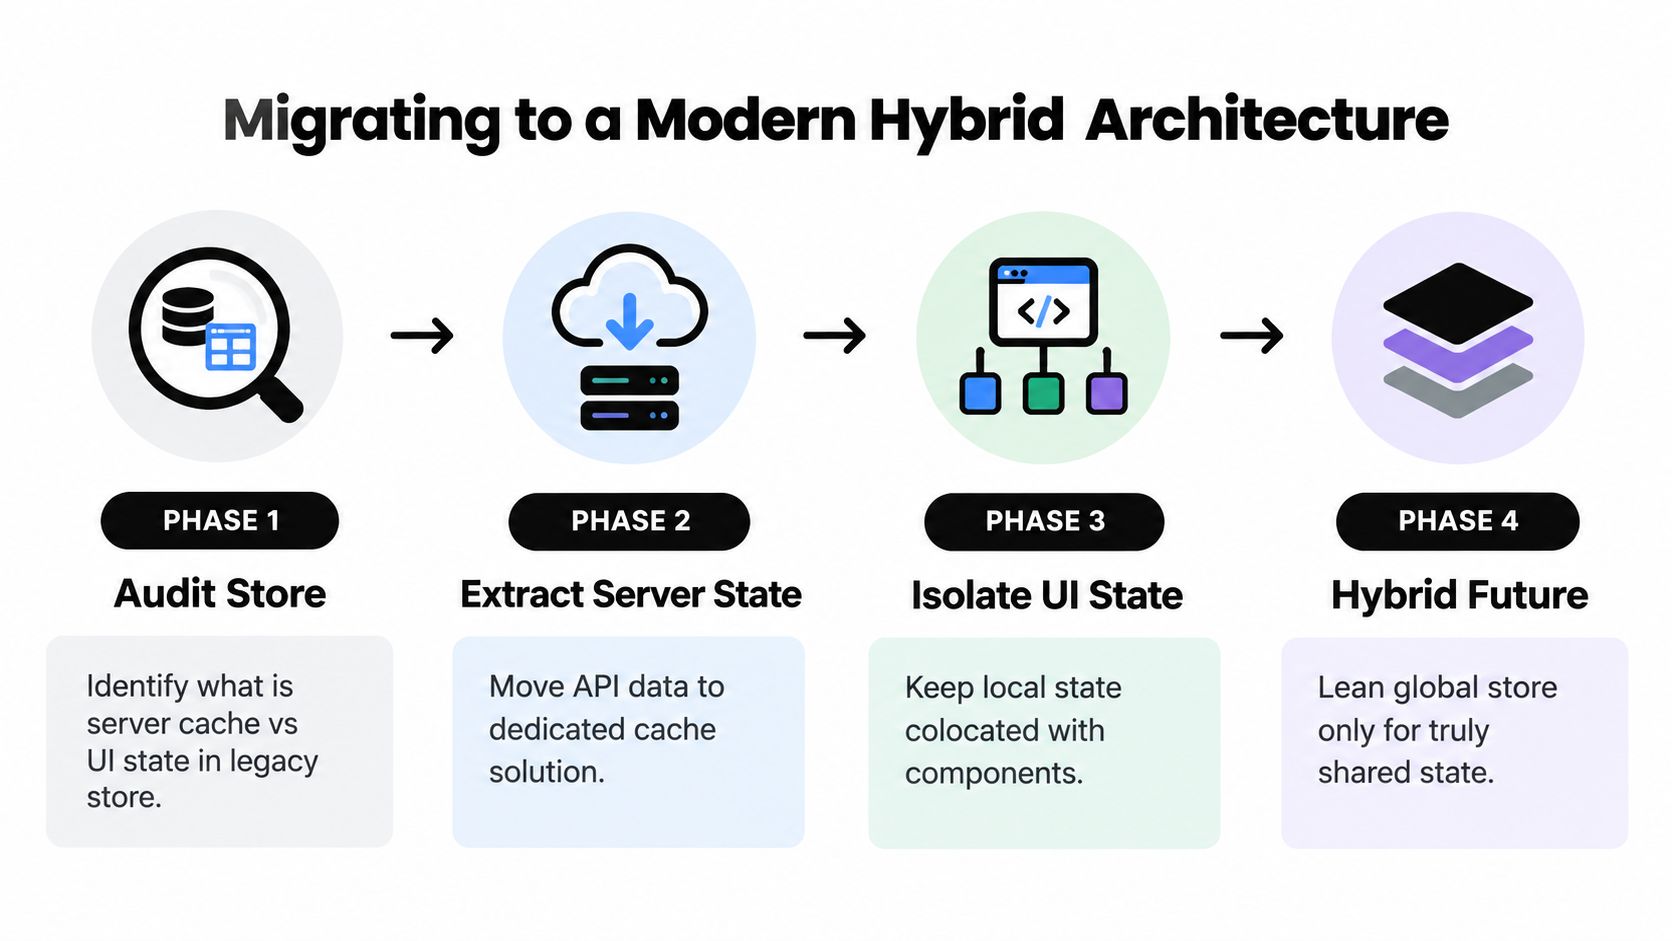
Rara vez un store global legacy necesita una reescritura. Necesita un inventario y una secuencia de extracciones seguras. La migración funciona mejor cuando cada funcionalidad puede mover una clase de estado a la vez, mientras el store antiguo sigue disponible para las pantallas sin tocar.
Empieza por el ownership, no por la tecnología
Crea un catálogo de estado para el store existente. Para cada campo, registra su origen, consumidores, rutas de mutación, requisito de persistencia y comportamiento de recuperación. Indica si es derivado del servidor, de la ruta, propio del formulario, local a la funcionalidad o compartido. Este ejercicio suele revelar que el store global contiene varios sistemas no relacionados ocultos detrás de un solo API.
Mueve primero el estado del servidor. Reemplaza los campos API replicados manualmente con una capa dedicada de fetching y caché que gestione el estado de la solicitud, la invalidación, los reintentos y la revalidación. Mantén los selectores temporalmente compatibles para que las pantallas existentes puedan migrar sin cambiar cada punto de llamada a la vez. Elimina la copia duplicada del servidor solo después de que la nueva fuente haya superado las pruebas de integración.
A continuación, devuelve el estado de la URL al router. Los filtros de búsqueda y los recursos seleccionados deben sobrevivir a recargas y al compartir mediante parámetros de ruta o estado de query. Elimina los efectos de sincronización que copian valores de la URL en el store y luego copian valores del store de vuelta a la URL. Esos bucles crean condiciones de carrera y hacen que el historial del navegador sea menos fiable.
Extrae incrementalmente el estado de las features
Mueve el estado de modales, el progreso de wizards y la selección local al límite de funcionalidad más cercano. Si varios componentes necesitan el valor, usa un feature store con una interfaz estrecha. Reserva el store global restante para aspectos transversales como la política de sesión, el tema, los permisos o un flujo de trabajo explícitamente compartido.
Usa una capa de compatibilidad durante la transición. Puede leer de la nueva fuente y a la vez exponer la forma del selector anterior, lo que permite migrar funcionalidades detrás de flags. Publica cada extracción por separado, monitorea las rutas de error y el comportamiento de hidratación, y mantén una ruta de rollback hasta que el nuevo modelo de propiedad demuestre ser estable.
Para equipos de Capacitor y Electron, Capgo puede entregar bundles firmados de JavaScript, CSS, configuración y assets a través de canales segmentados, con controles de rollout, historial de versiones, logs de dispositivos, métricas de adopción y fallos, y protección con rollback automático. Eso permite lanzar un refactor de gestión de estado de forma incremental, mientras que los cambios nativos siguen el proceso de release de la plataforma correspondiente. El beneficio operativo es el control sobre la migración, no una excusa para saltarse las pruebas o la planificación de compatibilidad.
Mejores prácticas y errores comunes a evitar
La arquitectura de estado falla cuando las preguntas de revisión son vagas. Usa estas comprobaciones en las revisiones de diseño y pull requests:
- Nombra al responsable en code: Pregunta: “¿Qué módulo puede cambiar este valor y qué API hace cumplir ese límite?” Rechaza un store añadido solo porque dos componentes necesitan actualmente el mismo campo.
- Define el contrato de recuperación: Para cada valor persistido, documenta si la recarga, el reinicio de la app, el logout y el cambio de cuenta lo conservan o lo borran. Un borrador de factura puede sobrevivir a un reinicio, mientras que un workspace seleccionado puede requerir revalidación.
- Haz que la sincronización sea observable: Registra IDs de solicitud, versiones, conteos de reintento y resultados de conflictos. Configura una alerta para fallos repetidos de reintento o conflicto antes de que los usuarios reporten actualizaciones faltantes.
- Revisa los comandos, no la forma del objeto: Una mutación debe declarar su intención de negocio, validar entradas y exponer un nombre de acción apto para auditoría. Las escrituras directas que omiten esas comprobaciones pertenecen a discusiones de revisión.
- Prueba secuencias hostiles: Ejecuta pruebas para hidratación compitiendo con navegación, una escritura interrumpida seguida de reintento, entrega duplicada, ediciones sin conexión desde dos ventanas y cierre de sesión durante una solicitud pendiente.
- Verifica la ruta de eliminación: Una migración está incompleta si un selector antiguo, un adaptador de persistencia o un listener de eventos aún escribe en el store anterior. Añade una prueba que falle cuando ambas fuentes puedan actualizar el mismo campo.
Una pregunta práctica para un PR es: “¿Qué pasa si este proceso desaparece después de que comienza la escritura pero antes del acuse de recibo?” La respuesta debe identificar datos duraderos, propiedad del reintento, deduplicación y el estado de fallo visible para el usuario.
Capgo ayuda a los equipos de CapacitorJS y Electron a publicar actualizaciones de JavaScript, CSS, configuración y assets a través de canales específicos, con bundles firmados, controles de despliegue, logs a nivel de dispositivo y protección contra rollback. Usa Capgo para entregar refactorizaciones de gestión de estado y correcciones de recuperación de forma incremental, y luego validarlas con pruebas de ciclo de vida y sincronización.





