
Mittwoch um 9:12 Uhr entdeckt dein Mobile-Team einen Checkout-Bug in der Produktion. Web kann ihn schnell patchen. iOS und Android nicht – zumindest nicht über den Store-Review. Der Support sammelt Tickets, das Produktmanagement will ein Status-Update und das Engineering versucht, drei Fragen gleichzeitig zu beantworten: Wie schnell können wir den Fix deployen, wie schnell erhalten die User ihn und wie schnell können wir beweisen, dass der Fix funktioniert hat?
Hier hört die Cloud-App-Performance auf, ein abstraktes Backend-Thema zu sein, und wird zum Release-Thema. Für Hybrid-Mobile-Teams, die JavaScript-Bundles, Configs, Copy oder Assets außerhalb des Stores ausliefern, bedeutet Performance nicht nur: „Ist das API schnell?“. Es geht darum, ob dein Delivery-Pfad ein Update veröffentlichen, routen, downloaden, validieren, anwenden, observe und bei Bedarf zurückrollen kann, während die Nutzer noch im Blast Radius sind.
Wenn du mit Capacitor, Ionic oder einem anderen Hybrid-Stack arbeitest, ändert das deine Sicht auf Performance-Optimierung. Ein hängender Manifest-Fetch, ein Edge-Cache, der ein altes Bundle ausliefert, oder ein Trace, der den Fehler eines Hotfixes nicht identifizieren kann – all das gehört zum selben System. Die App-Experience und der Release-Mechanismus sind untrennbar miteinander verbunden.
Inhaltsverzeichnis
- Das Mobile-Team, das keinen Fix ausliefern konnte
- Was Cloud-App-Performance wirklich bedeutet
- Die Anatomie der Latenz in Cloud-basierten Apps
- Edge-Netzwerke und CDN-Delivery für mobile Updates
- Wichtige Metriken jenseits der durchschnittlichen Antwortzeit
- Observability für Cloud-Apps ohne Data Swamp
- SLAs, Error Budgets und Channel-basierte Rollouts
- Cloud-App-Performance in die Praxis umsetzen
Das Mobile-Team, das keinen Fix ausliefern konnte
Ein Team, das ich in der Praxis oft sehe, sieht so aus: ein Mobile Lead, zwei App-Engineers, ein Backend-Engineer, ein Product Manager und der Support, der Screenshots von wütenden Usern weiterleitet. Der Bug ist simpel: Ein Pricing-Mismatch bricht den Checkout ab, sobald ein Feature Flag umgeschaltet wird. Der Fix ist ebenfalls simpel. Das Frustrierende ist das Deployment.
Der native Shell muss nicht geändert werden. Das JavaScript-Bundle schon. Verlässt sich das Team nur auf App Store Submissions, wartet es auf einen Prozess, den es nicht kontrollieren kann. Während dieser Wartezeit wird jede Kommunikation schwieriger. Der Support fragt, wer betroffen ist. Product fragt, wann die Fehlerquote sinkt. Engineering fragt, ob die User überhaupt den korrigierten code Pfad erreichen.
Verzögerungen entstehen nicht nur beim Coding
Betrachte dies zunächst als Flaschenhals bei Releases. Das stimmt teilweise. Aber das eigentliche Problem ist: die Performance durch Cloud-Delivery über den gesamten Update-Pfad hinweg.
Damit ein live update wirklich hilft, müssen mehrere Faktoren stimmen:
- Das Gerät muss den Update-Service erreichen: Wenn die Manifest-Anfrage langsam ist oder sporadisch fehlschlägt, bleiben Nutzer länger auf der fehlerhaften Version.
- Der Edge-Server muss die richtigen Dateien ausliefern: Wenn die Cache-Invalidierung verzögert ist, erhält ein Land den Fix, während ein anderes noch veraltete Assets lädt.
- The app must verify and apply safely: Signierte Bundles, Channel-Targeting und Rollback-Regeln sind genauso wichtig wie die reine Geschwindigkeit.
- Das Team muss die Adoption beobachten: Einen Fix zu deployen, ohne zu wissen, wer ihn erhalten hat, ist nur eine komplexere Form des Ratens.
Praktische Regel: Ein mobiler Hotfix ist erst dann wirklich „deployed“, wenn die betroffenen Geräte ihn heruntergeladen und angewendet haben.
Deshalb ist die Cloud-App-Performance für Live Updates so entscheidend. Du optimierst nicht nur die Server-Antwortzeit, sondern die Recovery-Zeit für echte Geräte in instabilen Netzwerken, verschiedenen Regionen und mit unterschiedlichen App-Versionen.
Eine bessere Frage als „Ist die App schnell?“
Wenn Teams nach einem Incident über Performance sprechen, fragen sie oft, ob sich die App langsam angefühlt hat. Die wichtigere Frage ist, ob das Delivery-System schnell genug war, um die User Experience zu verbessern, bevor sich der Incident ausbreitete.
Bei Hybrid-Apps ist der Release-Pfad Teil des Produkts. Wenn dein Team schnell ein korrigiertes Bundle veröffentlichen, einen Channel sicher ansteuern und die Adoption verlässlich verifizieren kann, wird Performance zu einem operativen Faktor. Das beeinflusst direkt die Support-Last, den Umsatzschutz und das Vertrauen des Produkts in das Engineering während eines Ausfalls.
Was Cloud-App-Performance wirklich bedeutet
Wenn Mobile-Teams von „Performance“ hören, denken sie meist an die Ladezeit. Das ist aber nur ein Teil davon. Cloud-App-Performance ist die Kombination aus vier zusammenwirkenden Qualitäten: Latenz, Durchsatz, Verfügbarkeit und Konsistenz.
Um das zu verdeutlichen, hilft ein Vergleich mit einem Laden.
Vier Eigenschaften, mit denen man wirklich arbeiten kann
Latenz ist das Warten an der Kasse. Du stellst eine Anfrage und zählst, wie lange es dauert, bis eine Antwort zurückkommt.
Durchsatz beschreibt, wie viele Kunden der Laden gleichzeitig reibungslos bedienen kann. Ein schneller Kassierer reicht nicht aus, wenn sich bei Lastspitzen sofort eine Schlange bildet.
Verfügbarkeit gibt an, ob der Laden überhaupt geöffnet ist. Eine Antwort, die nie ankommt, ist kein langsamer Erfolg, sondern eine fehlgeschlagene Interaktion.
Konsistenz gibt an, ob jede Kasse denselben Lagerbestand und dieselben Preise sieht. Wenn eine Kasse den Artikel als vorhanden meldet und eine andere nicht, erlebt der Kunde Verwirrung, nicht nur Verzögerung.
Ein historischer Benchmark hilft, den ersten und dritten Begriff einzuordnen. Eine CloudOps-Analyse ergab einen weltweiten Durchschnitt von 426,4 Millisekunden um einen HTTP-Request abzuschließen und eine Antwort zu erhalten, bei einer durchschnittlichen Verfügbarkeit von 97.69% according to Google Cloud Observability. Diese beiden Werte sind entscheidend, da Nutzer sowohl die Verzögerung als auch die Ausfallzeit spüren, selbst wenn der Dienst „größtenteils verfügbar“ ist.
Warum die Auslieferung von Mobile-Updates von allen vier abhängt
Bei Live Updates ist die Latenz die Zeit, um das Manifest und das Bundle abzurufen. Der Durchsatz bestimmt, ob der Dienst bei Lastspitzen stabil bleibt, wenn viele Geräte beim Start nach Updates suchen. Die Verfügbarkeit gibt an, ob Geräte den Update-Endpoint während eines Vorfalls überhaupt erreichen können. Die Konsistenz entscheidet, ob Geräte an verschiedenen Orten denselben Release-Channel und denselben Asset-Satz erhalten.
Die App-Architektur wird hier entscheidend. Wenn du die Abhängigkeiten zwischen der App code, Storage, CDN, Edge-Logik und Release-Channels planst, hilft ein praktischer Leitfaden zu Mobile App Infrastruktur dabei, die Delivery-Pipeline mit der User Experience zu verknüpfen.
Die häufigste Verwechslung
Teams werfen oft alle vier in einen Topf: „Updates sind zu langsam.“ Dabei handelt es sich um unterschiedliche Probleme mit unterschiedlichen Verantwortlichkeiten.
- Hohe Latenz: die Anfrage funktioniert, aber die User warten
- Geringer Durchsatz: Anfragen stauen sich bei Lastspitzen
- Schlechte Verfügbarkeit: der Service ist nicht erreichbar
- Schwache Konsistenz: User erhalten falsche Zustände oder veraltete Versionen
Wenn man diese vier Punkte früh trennt, wird die Incident-Analyse deutlich präziser. Man hört auf, über „das Netzwerk“ zu diskutieren, und identifiziert stattdessen genau den Layer, der ausgefallen ist.
Für Mobile-Teams ist diese Unterscheidung wichtig, da Update-Systeme mehrstufig sind. Ein Bundle kann klein, signiert und korrekt sein, erreicht die User aber trotzdem zu langsam, wenn eine dieser Qualitäten nachlässt.
Die Anatomie der Latenz in Cloud-basierten Apps
Die wahrgenommene Verzögerung durch den User ist selten eine einzelne Ursache. Es ist ein Stapel aus vielen kleinen Wartezeiten. Wenn eine Hybrid-App nach einem live update sucht, sieht der User DNS, TLS, Netzwerk-Latenz, Manifest-Generierung, Signatur-Validierung, File-Download, Disk-Write und JavaScript-Evaluation nicht als separate Events. Er spürt nur eine einzige Pause.
Deshalb sollte die Arbeit an der Latenz wie ein Budget.
Woher die Wartezeiten kommen
Die erste Ebene ist der Verbindungsaufbau. DNS-Resolution und der TLS-Handshake finden oft statt, bevor deine App-Logik überhaupt läuft. Dann folgt der Netzwerk-Roundtrip zum nächstgelegenen Delivery Point. Danach muss die Backend- oder Edge-Logik noch entscheiden, welches Manifest und welches Bundle dieses Gerät erhalten soll. Schließlich muss das Gerät das Downloaded-Paket entpacken und auswerten.
Nutze dies als Arbeitsmodell:
| Schicht | Typischer Bereich (ms) | Optimierungshebel |
|---|---|---|
| DNS- und TLS-Setup | 50 bis 150 | Connection Reuse, HTTP Keep-Alive, TLS Session Resumption |
| Netzwerk-RTT zum Delivery Point | 10 bis 80 | Regionale Platzierung, CDN-Routing, Edge-Cache-Hitrate |
| Origin- oder Edge-Processing | 20 bis 300 | Effiziente Manifest-Generierung, vorberechnete Metadaten, schnellere Storage-Lookups |
| Anwenden und Rendern auf dem Device | 100 bis 600 | Kleinere Bundles, vorgewärmte JS-Engine, weniger Startup-Aufwand |
Wenn Sie tiefer in den Netzwerk-Aspekt eintauchen möchten, ist diese Erklärung zu Netzwerklatenz bei der App-Auslieferung für Nicht-Netzwerk-Spezialisten in Mobile-Teams hilfreich.
Geografie hilft, aber nicht allein
Eine viel zitierte Studie zur Erreichbarkeit ergab, dass die Mehrheit der Weltbevölkerung könnte eine Cloud-Einrichtung innerhalb von 100 Millisekunden erreichen, was erklärt, warum die regionale Bereitstellung zum Kern der Performance-Strategie wurde, wie in dieser Diskussion zur Cloud-Erreichbarkeitzusammengefasst wird. Das ist ermutigend, bedeutet aber nicht, dass jeder Nutzer automatisch einen schnellen Update-Pfad erhält.
Eine andere Studie zeigt die Falle auf: Edge-Standorte können die Netzwerklatenz senken, aber begrenzte Ressourcen am Edge können Warteschlangenverzögerungen verursachen. Laut dieser Edge-vs.-Cloud-Latenzanalyse.
Was Mobile-Teams zuerst optimieren sollten
Beginnen Sie mit den Ebenen, die am einfachsten zu ändern sind, ohne die App neu zu schreiben:
- Cachen Sie das Manifest am Edge vorsichtig: Kurze TTLs und explizite Invalidierung sind meist sicherer, als darauf zu hoffen, dass die Propagation während eines Hotfixes perfekt funktioniert.
- Release-Metadaten vorab berechnen: Erstellen Sie kein komplexes Manifest bei jeder Anfrage, wenn Channel-, Versions- und Signaturdaten vorab vorbereitet werden können.
- Startup-Last in der App reduzieren: Ein Bundle, das zwar schnell lädt, aber zu lange zum Evaluieren braucht, fühlt sich trotzdem langsam an.
- Verbindungen nach Möglichkeit wiederverwenden: Wiederholte Setup-Kosten sorgen für spürbare Verzögerungen in instabilen mobilen Netzen.
Ein „schneller Bundle-Download“ garantiert noch kein schnelles Update. Den User interessiert nur, wann das neue code tatsächlich einsatzbereit ist.
Edge-Netzwerke und CDN-Delivery für mobile Updates
Eine einzelne Cloud-Region kann für interne Tools oder Apps in einem Land gut funktionieren. Schwierig wird es, wenn die Userbasis über Kontinente verteilt ist und Hotfixes schnell ankommen müssen. Bei der Auslieferung mobiler Updates entscheiden Edge- und CDN-Design darüber, wer das erste Byte schnell bekommt, wer veraltete Inhalte erhält und wer im ungünstigsten Moment auf den Origin zurückfällt.
Drei Delivery-Modelle, die Teams meist in Betracht ziehen
Das einfachste Modell ist zentralisierte Origin-Auslieferung. Geräte laden Manifests und Bundles aus einer einzigen Region. Das ist einfach zu betreiben, leicht nachzuvollziehen und anfangs oft gut genug.
Der nächste Schritt ist regionale Auslieferung. Man platziert Storage oder App-Logik in einigen großen Regionen und leitet User zur nächstgelegenen weiter. Das verkürzt die Transitstrecke für viele User und verteilt die Last besser.
Dann gibt es noch Edge-DeliveryStatische Bundles werden nah am Nutzer gecacht. Zudem kann leichtgewichtige Logik am Edge Manifests umschreiben, Channels routen oder Signature-Checks durchführen, bevor die Anfrage den Origin erreicht.
Hier ist ein praktischer Vergleich:
| Modell | Typische P50 First Byte | Aufwand für Cache-Invalidierung | Beste Eignung |
|---|---|---|---|
| Zentralisierte Cloud-Region | Höher für entfernte Nutzer | Niedrig | Geringer Footprint, seltene Releases |
| Regionale Deployments | Mittel | Mittel | Multi-Region-Apps mit klaren Nutzerclustern |
| Edge-Delivery via CDN und Edge-Logik | Minimal bei hoher Cache-Hit-Rate | Hoch | Globale Apps, häufige Updates, kritische Releases |
Für Teams, die die Mechanik verstehen wollen: Dieser Guide zu Edge-Netzwerken bei der App-Auslieferung liefert das richtige mentale Modell.
Was Teams oft unterschätzen
Cache-Invalidierung klingt nach einem gelösten Problem, bis ein kritischer Fix veröffentlicht wird. Dann liefert der Edge in einer Region das Manifest von gestern, in einer anderen das von heute, und der Support erhält Meldungen wie: „Der Fix funktioniert nur bei einigen Nutzern.“
Das ist keine theoretische Unannehmlichkeit. Das ist ein Problem der Release-Integrität.
Eine Studie über Edge-Platzierung ergab, dass das Verschieben von Compute näher zu den Nutzern die Access-Latency oft nur um etwa 6 % bis 30 % verbesserte, und stellte zudem fest, dass alternative Netzwerkpfade eine nominell lokale Route um bis zu 40 %übertreffen können. Das bedeutet, dass Routing-Qualität und Peering für das User Experience Tail genauso wichtig sein können wie die physische Nähe, laut dieser umfangreichen Edge-Performance-Studie.
Entscheidungsmatrix für Mobile-Teams
Nutzen Sie diese Kriterien bei der Wahl Ihres Update-Delivery-Tiers:
- Nutzerverteilung: Konzentrieren sich die Nutzer in einem Land, reicht eine zentrale oder regionale Auslieferung oft aus.
- Release-Frequenz: Teams mit hohen Release-Zyklen profitieren stärker von Edge Caching, müssen dafür aber eine striktere Cache-Disziplin pflegen.
- Hotfix-Kosten: Wenn ein veraltetes Bundle während eines Incidents teuer zu stehen kommt, plane explizite Invalidation und Rollbacks bereits im Vorfeld ein.
- Operationale Toleranz: Edge-Logik bietet mehr Power, erhöht aber auch das Risiko für Routing-Bugs, Signature-Mismatches und geo-spezifische Überraschungen.
Die richtige Antwort ist nicht „immer Edge nutzen“. Die richtige Antwort ist, die Delivery-Architektur auf die Geschwindigkeit und den Blast Radius deines Release-Prozesses abzustimmen.
Wichtige Metriken jenseits der durchschnittlichen Antwortzeit
Die durchschnittliche Antwortzeit ist nützlich für Dashboards, aber fast wertlos, um über User Pain zu diskutieren. Mobile Nutzer erleben nicht den Durchschnitt. Sie erleben ihre eigene Anfrage, auf ihrem Gerät, in ihrem Netzwerk, genau in dem Moment, in dem sie die App nach deinem Hotfix öffnen.
Deshalb sind Tail Metrics entscheidend.
Die drei Ansichten, die ich einem Product Manager zeigen würde
Beginne mit der Cold- und Warm-Start-Latenz bei P95 und P99. Der Cold Start zeigt, was passiert, wenn die App frisch startet und nach Updates sucht, ohne dass ein warmer State vorhanden ist. Der Warm Start zeigt, wie viel Reibung nach der ersten Initialisierung noch besteht.
Direkt darunter trackst du Apdex mit einem Schwellenwert, den dein Mobile-Team für sinnvoll hält. Ein Wert, der für Desktop-Websites fair wirkt, kann bei einem Hybrid-App-Startup völlig falsch sein.
Verfolge dann den Error Budget Burn. Das verschiebt den Fokus von „Gab es einen Alert?“ hin zu „Wie schnell verbrauchen wir den vereinbarten Spielraum für unsere Zuverlässigkeit?“
Hier ist eine kompakte Grafik, die du im Weekly Review teilen kannst:
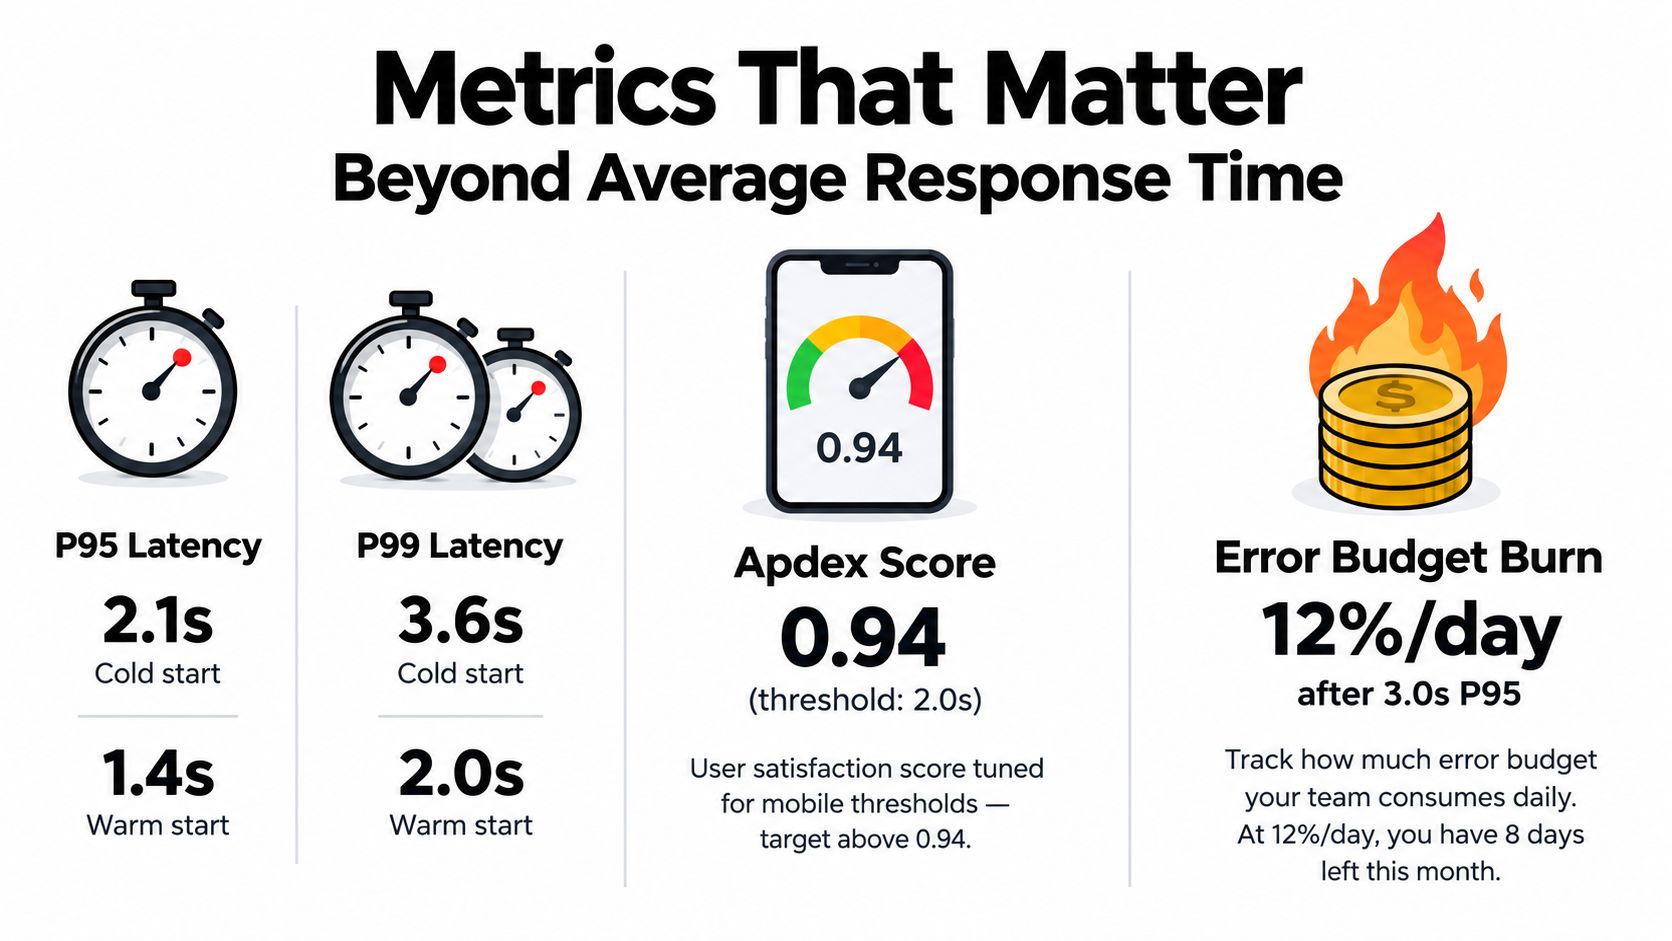
Metriken, die Performance mit Release-Ergebnissen verknüpfen
Ergänze eine delivery-spezifische Metrik, die Web-Teams oft nicht brauchen: Adoptionsrate nach Release-Channel. Wenn ein gefixtes Bundle veröffentlicht wurde, die betroffenen Geräte aber noch auf der alten Version sind, ist das gleichzeitig ein Performance- und ein Delivery-Problem.
Segmentiere deine Metriken nach:
- Geräteklasse: Ältere Smartphones machen Startup- und Evaluierungskosten oft zuerst sichtbar.
- Netzwerktyp: WLAN kann schlechtes Bundle-Design kaschieren, das mobile Daten sofort aufdecken.
- App-Version: Einige Fehler sind versionsspezifisch, besonders beim Bridge-Verhalten oder bei der Migrationslogik.
Dieses Video ist eine gute Ergänzung, wenn dein Team eine praktische Auffrischung braucht, wie man Performance-Telemetrie interpretiert, statt nur auf Durchschnittswerte zu starren:
Vorsicht beim Interpretieren von Rauschen
Nicht jede kleine Schwankung der Cloud-App-Performance ist relevant. Eine große Längsschnittstudie über 2.366 Benchmarks auf 789 AWS Kubernetes-Cluster ergab eine Gesamtvariabilität unter 3.7%, mit subtilen Effekten durch Tageszeit und Wochenende, laut dieser Studie zur Cloud-Performance-Variabilität. Das ist eine nützliche Erinnerung, nicht auf winzige Schwankungen überzureagieren und Tail-Regressionen trotzdem ernst zu nehmen.
Frag nicht, ob die Cloud-Performance zufällig ist. Frag lieber, wie das normale Messrauschen deines Systems aussieht, und alarmiere bei Änderungen, die darüber hinausgehen.
Observability für Cloud-Apps ohne Data Swamp
Viele Engineers nutzen Telemetrie, aber sie liefert oft nicht schnell genug Antworten für den On-Call-Einsatz. Bei hybriden Mobile-Updates ist die entscheidende Frage meist spezifisch: Warum blieb dieses Gerät beim alten Bundle, warum schlug das neue Update fehl oder warum wurde der Startup-Prozess nach einem Release langsamer?
Traces, Logs und Metriken sind notwendig, aber oft nicht ausreichend.
Den Stack um einen Release-Pfad herum aufbauen
Ein praktischer Observability-Stack für die Performance von Cloud-Apps sollte es ermöglichen, einen Update-Versuch vom Gerät bis zum Backend und wieder zurück lückenlos zu verfolgen.
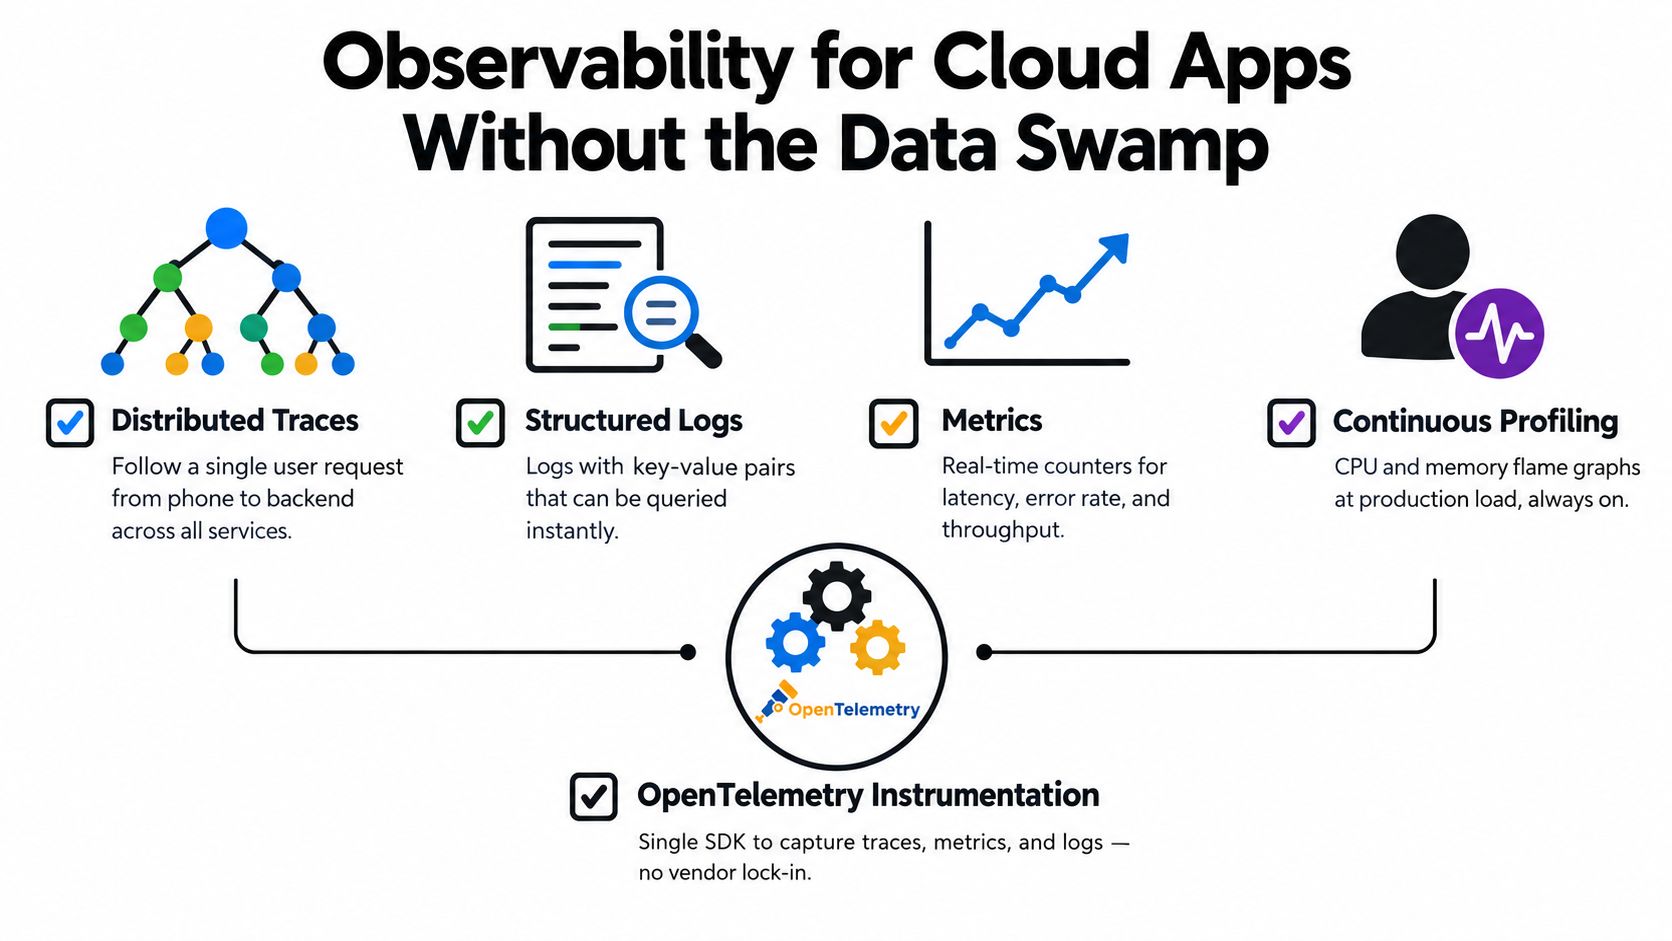
Instrumentiere die Mobile Bridge und den Update-Client mit OpenTelemetry Tags für App-Version, Release-Channel, Plattform und Update-Ergebnis. Strukturiere Logs so, dass du eine Update-ID oder eine Device-Session ohne Fuzzy-Suche abfragen kannst. Halte Metriken fokussiert auf Latenz, Error Rate, Adoption und Rollback-Events.
Für Teams, die diese Komponenten standardisieren, ist dieser Überblick über Application Observability für produktive Apps eine gute Referenz für die Implementierung.
Das fehlende vierte Signal
Einer der nützlichsten Ansätze in der modernen APM-Beratung ist die Erkenntnis, dass Traces, Metriken und Logs immer noch eine Diagnoselücke hinterlassen. Continuous Profiling wird zunehmend als das vierte Signal betrachtet, da es genau zeigt, welche Funktion CPU, Speicher oder Lock-Zeiten verbraucht, wie in diesem Leitfaden zu Application Performance Monitoring und Profiling beschrieben wird.
Das ist in live update Workflows entscheidend. Ein Trace zeigt vielleicht, dass „apply update“ zu lange gedauert hat. Profiling kann zeigen, ob der Flaschenhals die Bundle-Dekompression, das JSON-Parsing, die Bridge-Initialisierung oder ein Lock in einem Startup-Pfad war.
Sorgen Sie für Lesbarkeit um 2 Uhr morgens.
Nutzen Sie eine kleine, fokussierte Auswahl an Views:
- Release Channel Dashboard: Adoption, Failures, Rollback-Anzahl
- Update Transaction Trace: Manifest Fetch bis Bundle Evaluation
- Top Startup Regressions: Gruppiert nach App-Version und Plattform
- Profiling-Ansicht: hitzigste Funktionen beim Update-Apply und First Render
Wenn Ihr Team sein DevOps- und SRE-Betriebsmodell rund um diese Workflows verfeinert, ist es hilfreich, zu sehen, wie die Nexus IT Group DevOps umsetzt, da die Case Study Observability als Betriebspraxis und nicht nur als Tool-Anschaffung betrachtet.
Das beste Dashboard ist dasjenige, das ein On-Call-Engineer tatsächlich öffnet, versteht und darauf reagiert, noch bevor der Support die Incident-Zusammenfassung für ihn schreibt.
SLAs, Error Budgets und Channel-basierte Rollouts
SLA-Formulierungen klingen im Vertrag sauber, aber in der Produktion chaotisch. Mobile-Teams merken das meist erst bei einem schlechten Release. „High Availability“ klingt beruhigend, bis man entscheiden muss, ob man Updates weiter ausrollt, während Nutzer in einer Region das aktuelle Bundle nicht laden können.
Verfügbarkeitsziele in Release-Policies umwandeln
Nutzen Sie Verfügbarkeitsziele, um Rollout-Phasen zu definieren, nicht nur für Kundenversprechen.
| Verfügbarkeitsziel | Monatliches Downtime-Budget | Geeignete Rollout-Phase |
|---|---|---|
| 99% | Etwa 7 Stunden 18 Minuten | Interne und experimentelle Channels |
| 99.9% | Etwa 43 Minuten | Beta und gestaffelter Production-Rollout |
| 99.99% | Etwa 4 Minuten 23 Sekunden | Breiter Production-Rollout für geschäftskritische Pfade |
Diese Downtime-Budgets ergeben sich aus einfacher monatlicher Mathematik. In der Praxis schrumpfen sie zudem, sobald man die gesamte Delivery-Chain berücksichtigt. Dein Origin mag gesund sein, während DNS, Edge-Propagation oder eine fehlerhafte Channel-Regel verhindern, dass Geräte das gewünschte Release erhalten.
Wenn du ein konkretes Beispiel dafür brauchst, wie eine Update-Plattform dies operativ handhabt, schau dir das Capgo Service Level Agreement an und vergleiche es mit deinen eigenen Annahmen zu Incidents.
Error Budgets: Wo Produkt und Zuverlässigkeit aufeinandertreffen
Ein Error-Budget gibt dem Team eine Entscheidungsstruktur. Wenn die Burn-Rate niedrig ist, kannst du etwas Release-Risiko akzeptieren. Wenn die Burn-Rate nach einem Hotfix sprunghaft ansteigt, pausiere die Promotion in den nächsten Channel.
Eine solide Rollout-Ladder für Hybrid-Apps sieht meistens so aus:
- Intern: Ingenieure prüfen, ob Manifest, Signatur und Apply-Flow wie erwartet funktionieren
- Beta: Early Adopter und Tester finden Fehler auf Edge-Devices
- Staged Production: Zuerst erhält eine begrenzte Zielgruppe das Bundle
- Full Production: Das Update wird zum Standard-Channel-Target
Dasselbe Prinzip gilt für Feature Flags, Over-the-Air JavaScript Updates oder beides.
Rollback-Trigger festlegen, bevor sie gebraucht werden
Rollback-Regeln sollten explizit und langweilig sein. Improvisiere sie nicht während eines Incidents.
Nützliche Trigger sind:
- Die Adoption stagniert unerwartet: Geräte melden sich, wechseln aber nicht zum neuen Bundle
- Die Startup-Latenz verschlechtert sich bei Tail-Usern massiv: besonders bei älteren Geräten oder schwächeren Netzwerken
- Fehlgeschlagene Deployments häufen sich auf einer Plattform oder Version: oft ein Bridge- oder Packaging-Mismatch
- Real User Monitoring zeigt eine schlechtere Experience: Synthetische Checks übersehen oft mobile-spezifische Probleme
Kommuniziere Fehler in klarer Sprache. Sag, was fehlgeschlagen ist, wer betroffen war, welcher Channel pausiert wurde, welcher Rollback erfolgte und wann die nächste Entscheidung ansteht. Stakeholder brauchen keinen Telemetry-Dump. Sie brauchen operative Klarheit.
Cloud-App-Performance in die Praxis umsetzen
Der schnellste Weg, die Performance von Cloud-Apps zu verbessern, besteht darin, sie nicht länger als reines Infrastruktur-Prestigeobjekt zu betrachten. Nutzern ist die Cache-Hit-Ratio egal, solange sie das Erlebnis nicht spürbar verbessert. Das Produktmanagement interessiert die CPU am Origin nicht, solange sie nicht bestimmt, wie schnell ein Fix die betroffenen Geräte erreicht.
Wähle diese Woche eine einzige nutzerorientierte Metrik aus und setze sie um.
Eine einwöchige Challenge, die sich lohnt
Wähle eine Metrik mit klarem Impact auf die User. Gute Optionen sind die Time-to-Interactive nach einem Update-Check oder die Download-Zeit des Update-Bundles für die langsamsten Nutzer in einem Production-Channel.
Gehe dann in vier Schritten vor:
- Ermittle einen Baseline-Wert: Nutze Real User Monitoring statt nur synthetische Tests.
- Setze eine gezielte Änderung um: Verkleinere zum Beispiel die Bundle-Size, berechne Manifest-Outputs vor oder optimiere die Edge-Caching-Regeln.
- Release über einen Staged-Channel: Beobachte Adoption und Fehlerraten, bevor du den Rollout breit aufziehst.
- Messe dieselbe Metrik erneut: Wenn sich das Nutzererlebnis nicht verbessert hat, war die Optimierung kaum etwas wert.
Diese Checkliste zeigt die richtige Priorisierung für die meisten Mobile-Teams:
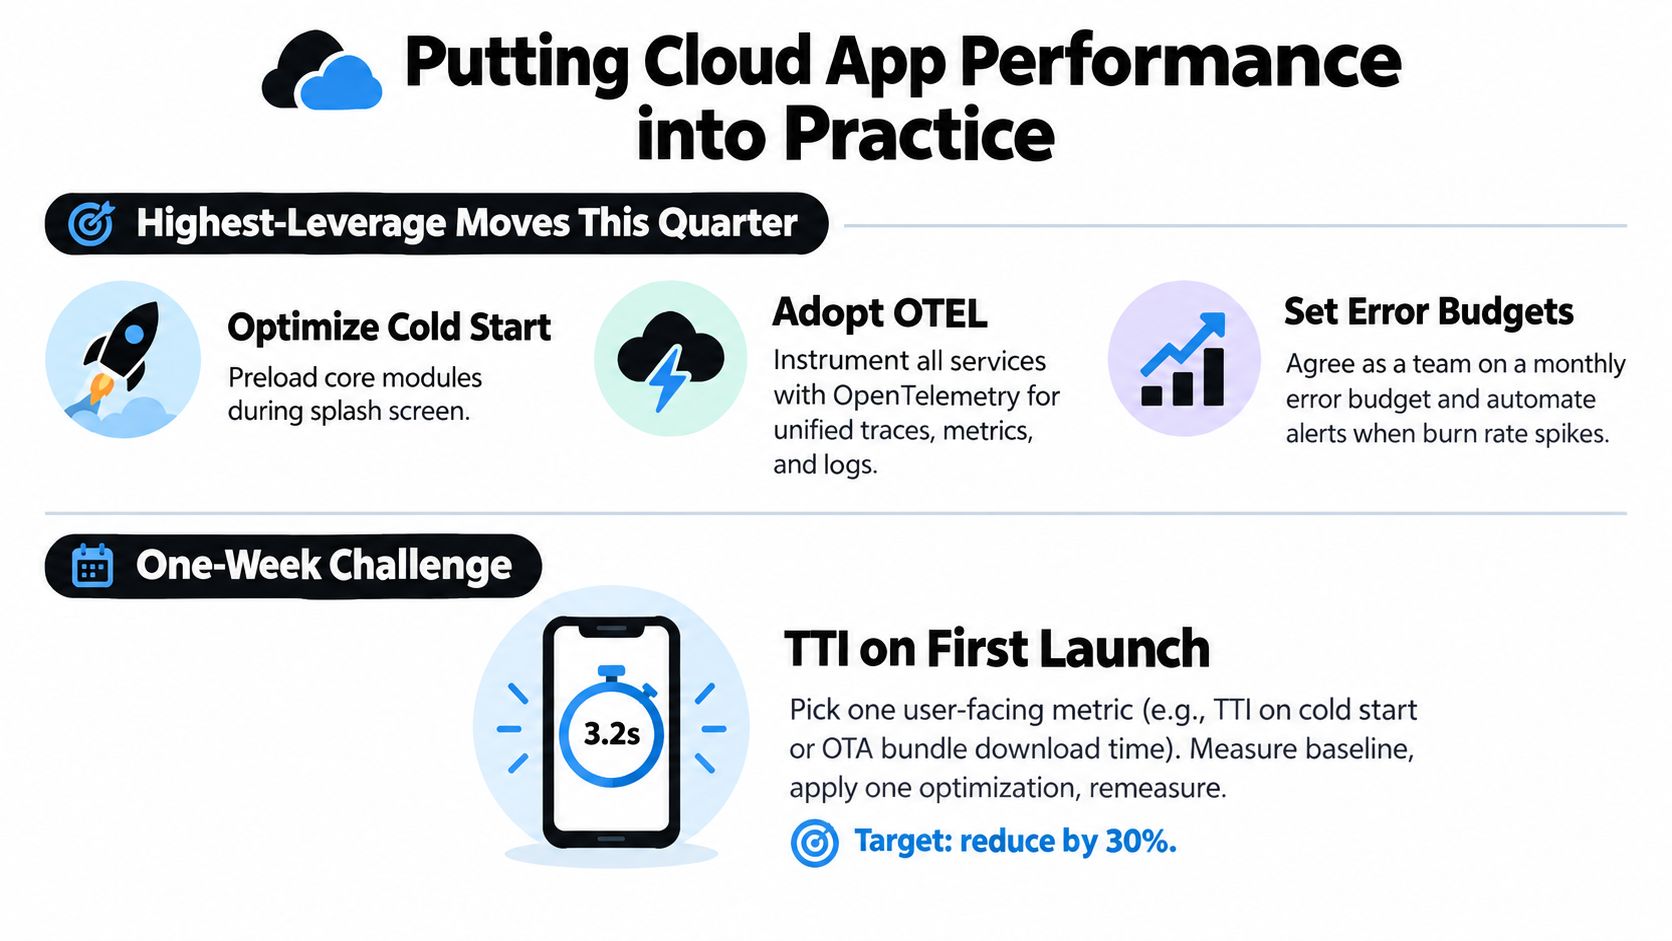
Meine Prioritäten für dieses Quartal
Beginnen Sie mit der Arbeit, die Incident-Pain am schnellsten reduziert:
- Edge-Cache-Verhalten validieren: Stellen Sie sicher, dass Manifest-Freshness und Bundle-Invalidierung sich so verhalten, wie Ihr Runbook annimmt.
- Bundle-Größe und Startup-Kosten prüfen: Delivery-Speed und Evaluation-Speed sind beide wichtig.
- P95-Dashboards für den Update-Flow erstellen: Bleiben Sie nicht bei Durchschnittswerten stehen.
- Error-Budget-Burn pro Channel tracken: Reliability und Release-Velocity sollten auf demselben Scoreboard stehen.
- Das Rollback-Runbook schreiben: Triggers, Verantwortliche und Kommunikationsschritte aufnehmen.
Wenn du ein konkretes Tool-Beispiel für diese Kategorie suchst, Capgo ist eine Option für Capacitor- und Electron-Teams, die signierte Live Updates, Channel-basierte Rollout-Steuerung, gerätespezifische Logs und Rollback-Support über ein globales Edge-Netzwerk benötigen. Der entscheidende Punkt ist nicht der Anbietername. Es geht darum, einen Workflow zu wählen, mit dem du Updates veröffentlichen, beobachten und rückgängig machen kannst, ohne auf die Store-Review zu warten – besonders wenn das Problem im webbasierten code liegt.
Disziplinierte Messung schlägt heroisches Engineering. Es ist besser, eine sichtbare Metrik in einer Woche zu verbessern, als ein Quartal damit zu verbringen, Backend-Zahlen zu optimieren, die das Nutzererlebnis nie beeinflussen.
Wenn dein Team Capacitor Apps ausliefert und mehr Kontrolle über live update-Delivery, Observability, Staged Rollouts und Rollback-Sicherheit möchte, Capgo ist genau für diesen Workflow gebaut. Damit kannst du signierte JavaScript-, CSS-, Config- und Asset-Updates außerhalb der Store-Review ausliefern und die Adoption sowie Fehler so genau tracken, dass Cloud-App-Performance operativ statt nur theoretisch wird.


