
Mercredi à 9h12, votre équipe mobile découvre un bug de paiement en production. Le web peut le corriger rapidement. iOS et Android non, du moins pas via la revue des stores. Le support commence à collecter les tickets, le produit veut un point d'avancement, et l'ingénierie tente de répondre à trois questions en même temps : à quelle vitesse peut-on livrer un correctif, à quelle vitesse les utilisateurs le recevront-ils, et à quelle vitesse peut-on prouver que le correctif a fonctionné ?
C'est là que la performance cloud cesse d'être un sujet backend abstrait pour devenir un sujet de release. Pour les équipes mobiles hybrides qui déploient des bundles JS, des configs, des textes ou des assets en dehors des stores, la performance ne se résume pas à « est-ce que API est rapide ? ». Il s'agit de savoir si votre pipeline de livraison peut publier, router, télécharger, valider, appliquer, observer et, si besoin, faire un rollback d'une mise à jour alors que des utilisateurs sont encore impactés.
Si vous travaillez sur Capacitor, Ionic ou une autre stack hybride, cela change votre vision de la performance. Un fetch de manifeste qui bloque, un cache edge qui renvoie un ancien bundle ou une trace incapable d'identifier où un hotfix a échoué font tous partie du même système. L'expérience de l'app et le mécanisme de release sont liés.
Table des matières
- L'équipe mobile qui n'arrivait pas à déployer de correctif
- Ce que signifie vraiment la performance d'une app cloud
- Anatomie de la latence des apps cloud
- Réseaux edge et diffusion CDN pour les mises à jour mobiles
- Les métriques qui comptent au-delà du temps de réponse moyen
- L'observabilité des applications cloud sans le data swamp
- SLA, budgets d'erreur et déploiements progressifs par canal
- Mettre en pratique la performance des applications cloud
L'équipe mobile qui n'arrivait pas à déployer de correctif
Une équipe que j'ai vue souvent en pratique ressemble à ceci : un lead mobile, deux ingénieurs app, un ingénieur backend, un product manager et le support qui transfère les captures d'écran d'utilisateurs en colère. Le bug est simple. Un écart de prix casse le checkout après l'activation d'un feature flag. Le correctif est tout aussi simple. Ce qui est frustrant, c'est la livraison.
Le shell natif n'a pas besoin de changer. Le bundle JavaScript, si. Si l'équipe se repose uniquement sur la publication sur les stores, elle dépend désormais d'un processus qu'elle ne maîtrise pas. Pendant cette attente, chaque échange se dégrade. Le support demande qui est affecté. Le produit demande quand l'exposition baisse. L'ingénierie demande si les utilisateurs atteignent même le chemin code corrigé.
Le délai ne vient pas seulement du code
Voyez d'abord cela comme un goulot d'étranglement de release. C'est en partie vrai. Mais le problème de fond est la performance via le cloud sur l'ensemble du parcours de mise à jour.
Pour qu’un live update soit utile, plusieurs éléments doivent être réunis :
- L'appareil doit joindre le service de mise à jour : Si la requête du manifeste est lente ou échoue par intermittence, les utilisateurs restent plus longtemps sur la version défectueuse.
- L'edge doit servir les bons fichiers : Si l'invalidation du cache est tardive, un pays peut recevoir le correctif tandis qu'un autre télécharge encore des assets obsolètes.
- The app must verify and apply safely: Les bundles signés, le ciblage par canal et les règles de rollback comptent autant que la vitesse brute.
- L'équipe doit observer l'adoption : Déployer un correctif sans savoir qui l'a reçu n'est qu'une forme plus complexe de devinette.
Règle pratique : Un hotfix mobile n'est réellement « déployé » que lorsque les appareils concernés l'ont effectivement téléchargé et appliqué.
C’est pourquoi la performance des applications cloud est cruciale pour les live updates. Vous n’optimisez pas seulement le temps de réponse du serveur. Vous optimisez le temps de récupération après incident sur des appareils réels, sur des réseaux hétérogènes, dans différentes zones géographiques, avec différentes versions de l’application.
Une meilleure question que « l'app est-elle rapide ? »
Lorsque les équipes parlent de performance après un incident, elles demandent souvent si l’application semblait lente. La question vraiment utile est de savoir si le système de livraison était assez rapide pour modifier l’expérience utilisateur avant que l’incident ne se propage.
Pour les applications hybrides, le processus de release fait partie du produit. Si votre équipe peut publier rapidement un bundle corrigé, cibler un canal en toute sécurité et vérifier l’adoption en toute confiance, la performance devient opérationnelle. Elle affecte directement la charge du support, la protection des revenus et la confiance que l’équipe produit accorde à l’ingénierie pendant une panne.
Ce que signifie vraiment la performance d'une app cloud
Lorsque les équipes mobiles entendent « performance », elles imaginent généralement le temps de chargement. Ce n’est qu’une partie de l’histoire. Performance des applications cloud est la combinaison de quatre qualités qui fonctionnent ensemble : latence, débit, disponibilité et cohérence.
Une bonne façon de l’expliquer est de passer par une analogie avec un commerce.
Quatre qualités que vous pouvez réellement analyser
Latence correspond à l'attente au comptoir. Vous demandez quelque chose et comptez le temps qu'il faut pour obtenir une réponse.
Débit correspond au nombre de clients que le magasin peut servir sans encombre simultanément. Un caissier rapide ne suffit pas si une file d'attente se forme dès que le trafic augmente.
Disponibilité est de savoir si la boutique est ouverte ou non. Une réponse qui n'arrive jamais n'est pas un succès lent. C'est une interaction échouée.
Cohérence est la question de savoir si chaque caisse voit le même niveau de stock et les mêmes prix. Si une caisse indique que l'article est disponible et une autre qu'il ne l'est pas, le client est désorienté, pas seulement ralenti.
Un benchmark historique aide à ancrer les premier et troisième termes. Une analyse CloudOps a relevé une moyenne mondiale de 426,4 millisecondes pour effectuer une requête HTTP et recevoir une réponse, avec une disponibilité moyenne de 97.69% according to Google Cloud Observability. Ces deux chiffres comptent, car les utilisateurs subissent autant le délai que l'indisponibilité, même quand le service est « globalement opérationnel ».
Pourquoi la livraison des mises à jour mobiles dépend des quatre
Pour les live updates, la latence est le temps nécessaire pour récupérer le manifeste et le bundle. Le débit (throughput) indique si le service tient encore la charge lors d'un pic, quand de nombreux appareils cherchent des mises à jour au lancement. La disponibilité, c'est la capacité des appareils à atteindre l'endpoint de mise à jour pendant un incident. La cohérence, c'est le fait que les appareils, où qu'ils soient, reçoivent bien le même canal de release et le même ensemble d'assets.
L'architecture de l'app entre alors en jeu. Si vous cartographiez les rouages entre code, le stockage, le CDN, la logique edge et les canaux de release, un guide pratique sur l'infrastructure d'app mobile permet de relier le pipeline de livraison à l'expérience utilisateur.
La confusion habituelle
Les équipes regroupent souvent les quatre en une seule plainte : « les mises à jour sont lentes ». Mais ce sont des défaillances différentes, avec des responsables différents.
- Latence élevée : the request works, but users wait
- Faible débit : les requêtes s'accumulent lors des pics
- Faible disponibilité : le service est inaccessible
- Cohérence fragile : les utilisateurs reçoivent un état incohérent ou des versions obsolètes
Si vous séparez ces quatre aspects dès le départ, l’analyse des incidents devient bien plus précise. Vous cessez de débattre sur « le réseau » et commencez à identifier la couche exacte qui a échoué.
Pour les équipes mobiles, cette distinction compte car les systèmes de mise à jour se déroulent en plusieurs étapes. Un bundle peut être petit, signé et correct, mais arriver trop lentement aux utilisateurs si l’une de ces qualités se dégrade.
Anatomie de la latence des apps cloud
Le délai perçu par l’utilisateur est rarement une seule chose. C’est une pile d’attentes courtes qui s’additionnent. Quand une app hybride vérifie une live update, l’utilisateur ne voit pas le DNS, le TLS, le trajet réseau, la génération du manifeste, la validation de signature, le téléchargement du fichier, l’écriture sur disque et l’évaluation JavaScript comme des événements distincts. Il ressent un seul temps d’attente.
C’est pourquoi le travail sur la latence doit être traité comme un budget.
D'où vient le temps d'attente
La première couche concerne l’établissement de la connexion. La résolution DNS et le handshake TLS ont souvent lieu avant l’exécution de la logique applicative. Vient ensuite l’aller-retour réseau vers le point de livraison le plus proche. Puis la logique backend ou edge doit encore déterminer quel manifest et quel bundle cet appareil doit recevoir. Enfin, l’appareil doit décompresser et évaluer ce qu’il a téléchargé.
Utilisez ceci comme modèle de travail :
| Couche | Plage typique (ms) | Levier d'optimisation |
|---|---|---|
| Configuration DNS et TLS | 50 à 150 | Réutilisation des connexions, HTTP keep-alive, reprise de session TLS |
| RTT réseau vers le point de livraison | 10 à 80 | Placement régional, routage CDN, taux de hit du cache edge |
| Traitement à l'origine ou à l'edge | 20 à 300 | Génération de manifestes légers, métadonnées précalculées, recherches de stockage plus rapides |
| Application et rendu côté appareil | 100 à 600 | Bundles plus petits, moteur JS préchauffé, moins de travail au démarrage |
Si vous voulez des bases sur la partie réseau en particulier, cet article sur la latence réseau dans la distribution des applications est utile pour les non-spécialistes réseau au sein des équipes mobiles.
La géographie aide, mais pas à elle seule
Une étude de connectivité largement citée a révélé que la majorité de la population mondiale pourrait accéder à une infrastructure cloud en moins de 100 millisecondes, ce qui explique pourquoi le déploiement régional est devenu central dans la stratégie de performance, comme résumé dans ce discussion sur la connectivité cloudC'est encourageant, mais cela ne signifie pas que chaque utilisateur bénéficie automatiquement d'un chemin de mise à jour rapide.
Une autre étude met clairement le piège en évidence. Les sites edge peuvent réduire la latence réseau, mais des ressources limitées à l'edge peuvent créer des délais de file d'attente, avec des cas où le cloud est globalement plus rapide, selon cette analyse de latence edge versus cloud.
Ce que les équipes mobiles optimisent d'abord
Commencez par les couches les plus faciles à modifier sans réécrire l'app :
- Mettez le manifeste en cache à l'edge avec prudence : Des TTL courts et une invalidation explicite sont généralement plus sûrs que d'espérer une propagation parfaite lors d'un hotfix.
- Précalculez les métadonnées de release : Ne générez pas un manifeste complexe à chaque requête si les données de canal, de version et de signature peuvent être préparées à l'avance.
- Réduisez le travail au démarrage de l'app : Un bundle qui se télécharge rapidement mais met trop de temps à être évalué donne toujours une impression de lenteur.
- Réutilisez les connexions dès que possible : Le coût d’une configuration répétée pèse visiblement sur les réseaux mobiles instables.
Un « téléchargement rapide du bundle » ne garantit pas une mise à jour rapide. L’utilisateur ne se soucie que du moment où la nouvelle code est réellement prête à s’exécuter.
Réseaux edge et diffusion CDN pour les mises à jour mobiles
Une seule région cloud peut suffire pour des outils internes ou des applications limitées à un pays. Cela devient plus difficile à justifier lorsque votre base d’utilisateurs est répartie sur plusieurs continents et que vous avez besoin de hotfixes déployés rapidement. Pour la livraison de mises à jour mobiles, la conception edge et CDN détermine qui reçoit le premier octet rapidement, qui reçoit du contenu obsolète et qui bascule sur l’origine au pire moment possible.
Trois modèles de déploiement couramment envisagés par les équipes
Le modèle le plus simple est la livraison centralisée depuis l’origine. Les appareils récupèrent les manifests et les bundles depuis une seule région. C’est simple à exploiter, facile à comprendre, et souvent suffisant au début.
L’étape suivante est diffusion régionale. Vous placez le stockage ou la logique applicative dans quelques grandes régions et redirigez les utilisateurs vers la plus proche. Cela réduit la distance de transit pour de nombreux utilisateurs et répartit mieux la charge.
Il y a ensuite diffusion à l'edge. Les bundles statiques sont mis en cache près des utilisateurs, et une logique légère à l'edge peut réécrire les manifests, router les canaux ou effectuer des vérifications de signature avant que la requête n'atteigne l'origine.
Voici une comparaison concrète :
| Modèle | P50 typique du premier octet | Effort d'invalidation du cache | Idéal pour |
|---|---|---|---|
| Région cloud centralisée | Plus élevé pour les utilisateurs éloignés | Faible | Faible empreinte, faible fréquence de release |
| Déploiements régionaux | Modérée | Moyen | Applications multi-région avec des clusters d'utilisateurs prévisibles |
| Livraison edge avec CDN et logique edge | Minimal quand le cache est efficace | Élevée | Applications mondiales, mises à jour fréquentes, releases critiques |
Pour les équipes qui évaluent les mécanismes, ce guide sur les réseaux edge dans la livraison d'apps offre le bon modèle mental.
Ce que les équipes sous-estiment
L'invalidation de cache semble être un problème résolu jusqu'à ce qu'un correctif critique soit déployé. L'edge sert alors le manifeste d'hier dans une zone géographique, et celui d'aujourd'hui dans une autre, et le support reçoit des rapports disant que « le correctif fonctionne pour certains utilisateurs ».
Ce n’est pas une gêne théorique. C’est un problème d’intégrité de la release.
Une thèse sur le placement edge a montré que rapprocher le calcul des utilisateurs n’améliorait souvent la latence d’accès que de environ 6 % à 30 %, et a également noté que des chemins réseau alternatifs peuvent surpasser une route théoriquement locale de jusqu'à 40 %, ce qui signifie que la qualité du routage et le peering peuvent compter autant que la proximité physique dans la queue de l’expérience utilisateur, selon ce thèse sur les performances edge à grande échelle.
Une matrice de décision pour les équipes mobiles
Utilisez ces critères pour choisir votre niveau de livraison des mises à jour :
- Répartition des utilisateurs : Si les utilisateurs sont concentrés dans un seul pays, une livraison centralisée ou régionale peut suffire.
- Fréquence des releases : Les équipes qui déploient souvent tirent davantage parti du cache edge, mais elles héritent aussi d’une discipline de cache plus stricte.
- Coût d’un hotfix : Si un bundle obsolète pendant un incident est coûteux, prévoyez une invalidation explicite et un rollback avant d’en avoir besoin.
- Tolérance opérationnelle : La logique edge apporte de la puissance, mais aussi plus de points de défaillance : bugs de routage, gestion des signatures non conformes et surprises géolocalisées.
La bonne réponse n’est pas « toujours utiliser l’edge », mais d’aligner l’architecture de livraison sur la vitesse et le rayon d’impact exigés par votre processus de release.
Les métriques qui comptent au-delà du temps de réponse moyen
Le temps de réponse moyen est utile pour les dashboards, mais presque inutile pour débattre de la douleur utilisateur. Les utilisateurs mobiles ne subissent pas la requête moyenne. Ils subissent la leur, sur leur appareil, sur leur réseau, au moment où ils ouvrent l’app après le déploiement d’un hotfix.
That’s why tail metrics matter more.
Les trois vues que je présenterais à un product manager
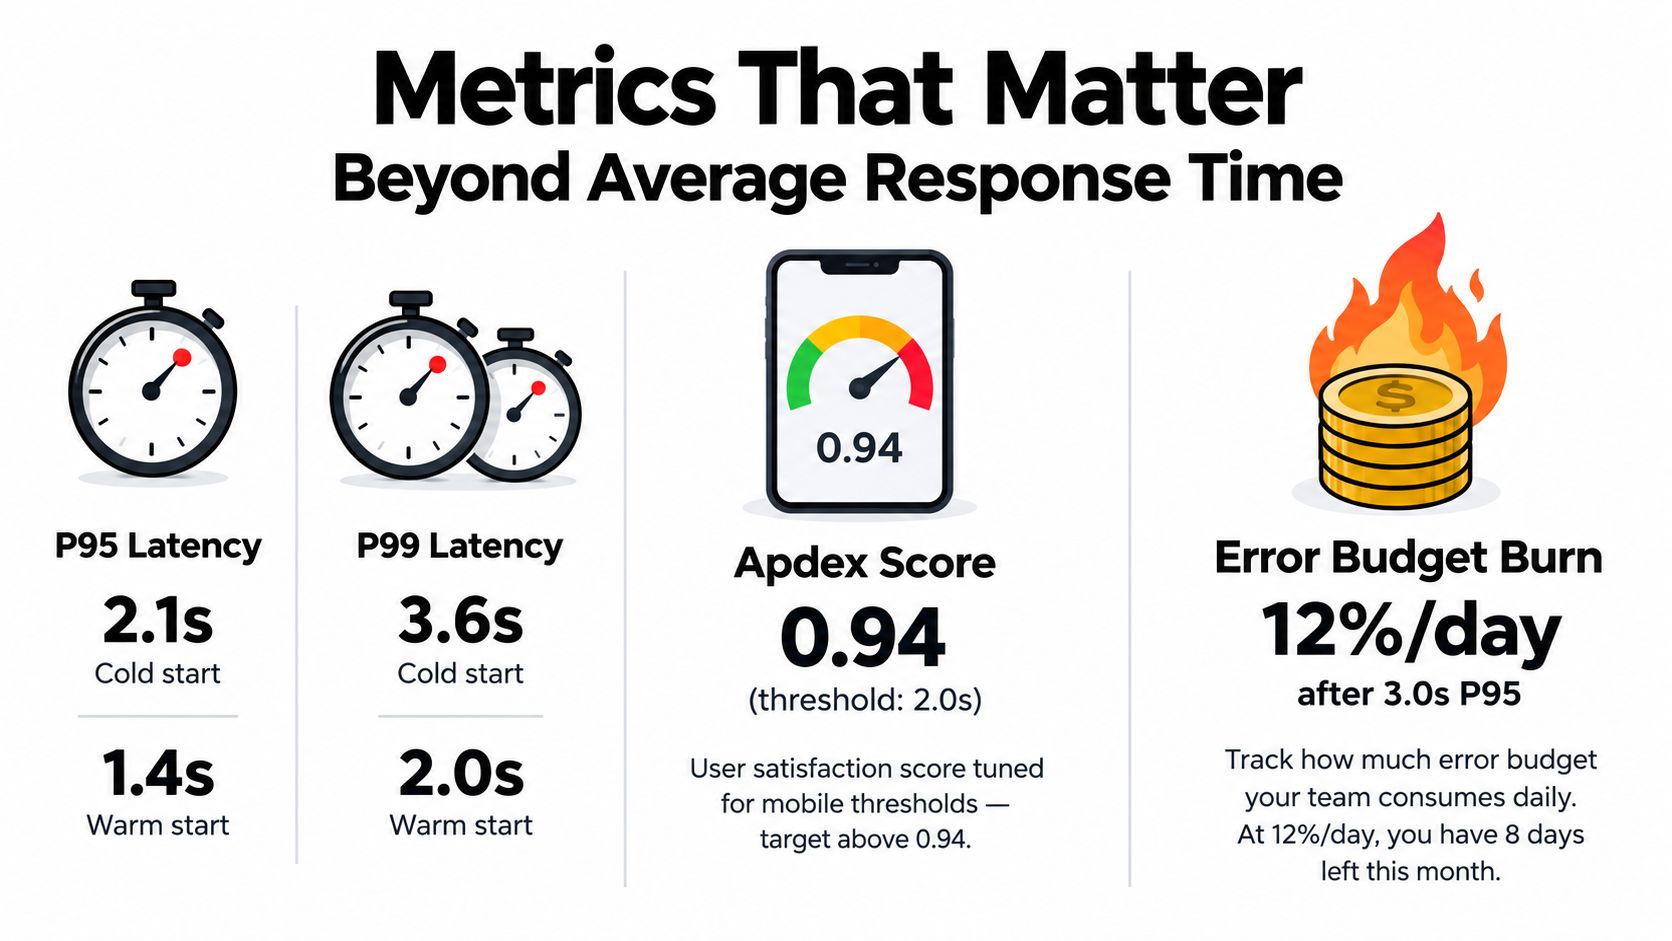
Commencez par la latence à froid et à chaud au P95 et P99. Le cold start indique ce qui se passe quand l'app se lance à froid et vérifie les mises à jour sans état préexistant pour l'aider. Le warm start indique la friction restante une fois que l'app a déjà effectué une partie du travail.
Juste en dessous, suivez Apdex avec un seuil auquel votre équipe mobile croit. Un seuil qui peut sembler juste pour le web desktop peut être erroné pour le parcours de démarrage d'une app hybride.
Ensuite, suivez l'error budget burn. Cela déplace la discussion de « une alerte a-t-elle été déclenchée ? » vers « à quelle vitesse consommons-nous la marge de fiabilité convenue ? »
Voici un visuel compact à partager en revue hebdomadaire :
Les métriques qui lient la performance aux résultats des releases
Ajoutez un indicatif de livraison spécifique dont les équipes web ont souvent peu besoin : taux d’adoption par canal de release. Si un bundle corrigé a été publié mais que les appareils concernés sont toujours sur la version précédente, c’est un problème de performance et de livraison à la fois.
Segmentez vos métriques par :
- Classe d’appareil : Les anciens mobiles révèlent souvent d’abord le coût de démarrage et d’évaluation.
- Type de réseau : Le Wi-Fi peut masquer un mauvais design de bundle que les données mobiles exposent immédiatement.
- Version de l’app : Certains échecs sont spécifiques à une version, notamment autour du comportement du bridge ou de la logique de migration.
Cette vidéo est un bon complément si votre équipe a besoin d’un rappel pratique sur l’interprétation des télémétries de performance plutôt que de se limiter aux moyennes :
Une mise en garde sur l'interprétation du bruit
Toutes les variations de performance d'une application cloud ne sont pas significatives. Une vaste étude longitudinale menée sur 2 366 benchmarks sur 789 clusters AWS Kubernetes a révélé une variabilité globale inférieure à 3.7%, avec de légers effets liés à l'heure de la journée et au week-end, selon ceci étude sur la variabilité des performances cloudC'est un bon rappel pour éviter de surréagir aux micro-fluctuations tout en restant vigilant face aux régressions de performance.
Ne vous demandez pas si la performance cloud est aléatoire. Demandez-vous plutôt à quoi ressemble le bruit de mesure normal de votre système, puis alertez sur les changements qui le dépassent.
L'observabilité des applications cloud sans le data swamp
Beaucoup d'ingénieurs disposent de télémétrie, mais elle ne permet souvent pas de répondre assez vite aux questions d'astreinte. Pour les mises à jour mobiles hybrides, la question utile est souvent spécifique : pourquoi cet appareil est-il resté sur l'ancien bundle, pourquoi le nouveau n'a-t-il pas pu s'appliquer, ou pourquoi le démarrage est-il devenu plus lent après une release ?
Les traces, les logs et les métriques sont nécessaires. Ils sont souvent insuffisants.
Construire la stack autour d'un seul chemin de release
Une stack d'observabilité pratique pour la performance des apps cloud doit vous permettre de suivre une tentative de mise à jour de l'appareil jusqu'au backend, et inversement.
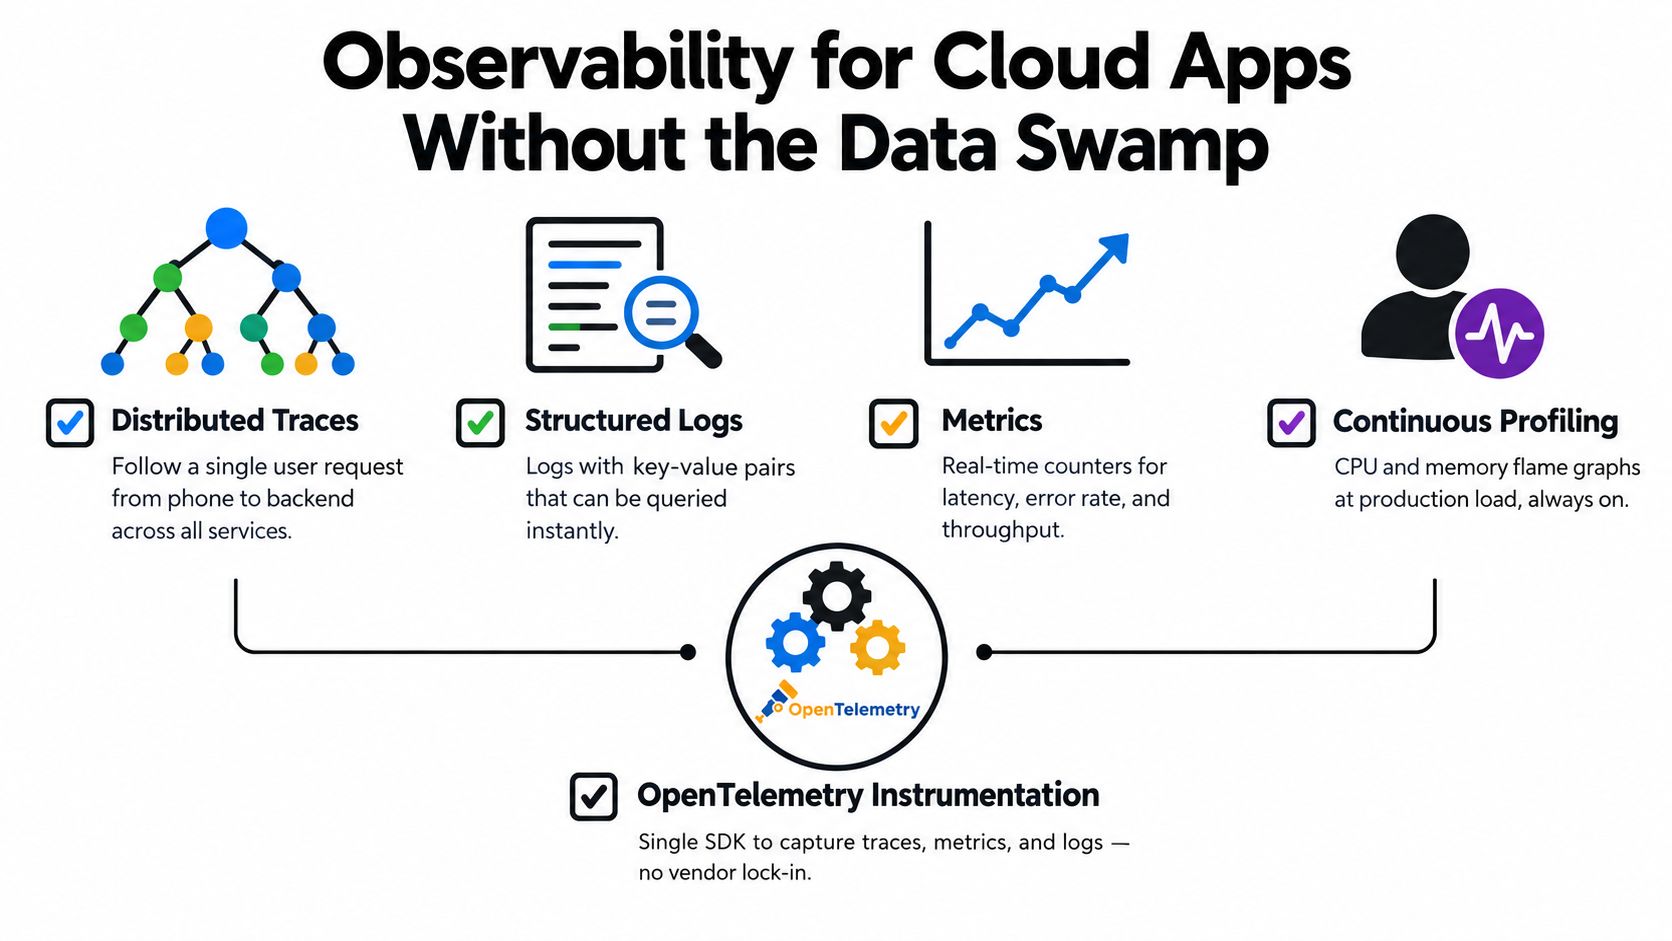
Instrumentez le bridge mobile et le client de mise à jour avec OpenTelemetry des tags pour la version de l'app, le canal de release, la plateforme et le résultat de la mise à jour. Structurez vos logs pour pouvoir requêter un ID de mise à jour ou une session d'appareil sans recherche textuelle floue. Concentrez vos métriques sur la latence, le taux d'erreur, l'adoption et les événements de rollback.
Pour les équipes qui standardisent ces éléments, cet aperçu de l'observabilité applicative pour les apps déployées est une excellente référence d'implémentation.
Le quatrième signal manquant
L'un des changements les plus utiles dans les recommandations APM modernes est l'idée que les traces, les métriques et les logs laissent encore une lacune dans le diagnostic. Le profiling continu est de plus en plus considéré comme le quatrième signal car il montre la fonction exacte qui consomme le CPU, la mémoire ou le temps de lock, comme décrit dans ce guide du monitoring et du profiling des performances applicatives.
Cela compte dans les workflows live update. Une trace peut montrer que « apply update » a pris trop de temps. Le profiling peut indiquer si le goulot d’étranglement venait de la décompression du bundle, du parsing JSON, de l’initialisation du bridge ou d’un verrou dans un chemin de démarrage.
Garder le système lisible à 2 h du matin
Utilisez un ensemble restreint et rigoureux de vues :
- Dashboard du canal de release : adoption, échecs, nombre de rollbacks
- Trace de la transaction de mise à jour : du fetch du manifeste à l'évaluation du bundle
- Principales régressions au démarrage : groupées par version de l’app et par plateforme
- Vue de profilage : fonctions chaudes à l’application de la mise à jour et au rendu
Si votre équipe affine son modèl’opérationnel DevOps et SRE global autour de ces workflows, il est utile de voir comment nexus IT group met en œuvre le DevOps car l’étude de cas présente l’observabilité comme une pratique opérationnelle, et non comme un simple achat d’outils.
Le meilleur dashboard est celui qu’un ingénieur de garde ouvre, comprend et exploite avant que le support rédige le résumé de l’incident à sa place.
SLA, budgets d'erreur et déploiements progressifs par canal
Le langage des SLA semble clair dans un contrat, mais devient flou en production. Les équipes mobiles découvrent généralement cela lors d’une mauvaise release. « Haute disponibilité » rassure, jusqu’au moment où il faut décider de continuer à déployer des mises à jour alors que les utilisateurs d’une région ne peuvent pas récupérer le bundle actuel.
Transformez vos objectifs de disponibilité en politique de release
Use availability targets to define rollout stages, not just customer promises.
| Objectif de disponibilité | Budget mensuel d’indisponibilité | Étape de déploiement appropriée |
|---|---|---|
| 99% | Environ 7 heures 18 minutes | Canaux internes et expérimentaux |
| 99.9% | Environ 43 minutes | Bêta et déploiement progressif en production |
| 99.99% | Environ 4 minutes 23 secondes | Production large pour les chemins critiques |
Ces budgets d’indisponibilité proviennent d’un simple calcul mensuel. Ils se réduisent aussi en pratique une fois que vous tenez compte de toute la chaîne de livraison. Votre origine peut être saine, mais le DNS, la propagation edge ou une règle de canal défaillante peuvent toujours empêcher les appareils de recevoir la release prévue.
Si vous avez besoin d’un exemple concret de la manière dont une plateforme de live update encadre cette opération, consultez Contrat de niveau de service Capgo et comparez-l’à vos propres hypothèses en cas d’incident.
Les budgets d'erreur sont le point de rencontre entre produit et fiabilité
Un budget d’erreur donne à l’équipe un cadre de décision. Si le burn rate est calme, vous pouvez accepter un peu de risque sur les releases. S’il s’emballe après un hotfix, mettez en pause la promotion vers le canal suivant.
A strong rollout ladder for hybrid apps usually looks like this:
- Interne : les ingénieurs valident que le manifest, la signature et le flux d'application se comportent comme prévu
- Bêta : testeurs et utilisateurs de confiance détectent les pannes d'appareils edge
- Production progressive : une audience limitée reçoit d'abord le bundle
- Production complète : la mise à jour devient la cible par défaut du canal
La même discipline vaut que vous utilisiez des feature flags, des live updates JavaScript, ou les deux.
Configurez vos déclencheurs de rollback avant d'en avoir besoin
Les règles de rollback doivent être explicites et sans surprise. N'improvisez pas pendant un incident.
Les déclencheurs utiles incluent :
- L'adoption stagne de manière inattendue : les appareils font un check-in mais ne passent pas au nouveau bundle
- Latence de démarrage en hausse pour les utilisateurs en queue : notamment sur les appareils anciens ou les réseaux faibles
- Les échecs d'application se concentrent sur une plateforme ou version : souvent une incompatibilité de bridge ou de packaging
- Le monitoring des utilisateurs réels montre une expérience dégradée : les checks synthétiques peuvent rater des problèmes mobiles
Communiquez sur les incidents en langage clair. Précisez ce qui a échoué, qui a été affecté, quel canal a été mis en pause, quel rollback a eu lieu et à quel moment se situe le prochain point de décision. Les parties prenantes n'ont pas besoin d'un dump de télémétrie. Elles ont besoin de clarté opérationnelle.
Mettre en pratique la performance des applications cloud
Le moyen le plus rapide d'améliorer les performances d'une app cloud est d'arrêter de la traiter comme un projet d'infrastructure de prestige. Les utilisateurs se fichent de votre taux de cache hit, sauf si cela change leur ressenti. Le produit se fiche du CPU de l'origin, sauf si cela change la vitesse à laquelle un correctif atteint les appareils affectés.
Choisissez une métrique côté utilisateur cette semaine et rendez-la concrète.
Un défi d'une semaine qui vaut le coup
Choisissez une métrique à l'impact utilisateur clair. De bonnes options : le temps jusqu'à l'interactivité au premier lancement après une vérification de mise à jour, ou le temps de téléchargement du bundle de mise à jour pour les utilisateurs les plus lents d'un canal de production.
Effectuez ensuite ces quatre étapes :
- Mesurez une base de référence : Use real user monitoring, not only synthetic checks.
- Appliquez un changement ciblé : Par exemple, réduisez la taille du bundle, précalculez le manifest ou affinez les règles de mise en cache edge.
- Déployez via un canal progressif : Surveillez l'adoption et les échecs avant un déploiement global.
- Mesurez à nouveau la même métrique : Si le résultat pour l'utilisateur n'a pas progressé, l'optimisation n'en valait pas la peine.
Cette checklist donne le bon ordre de priorité pour la plupart des équipes mobiles :
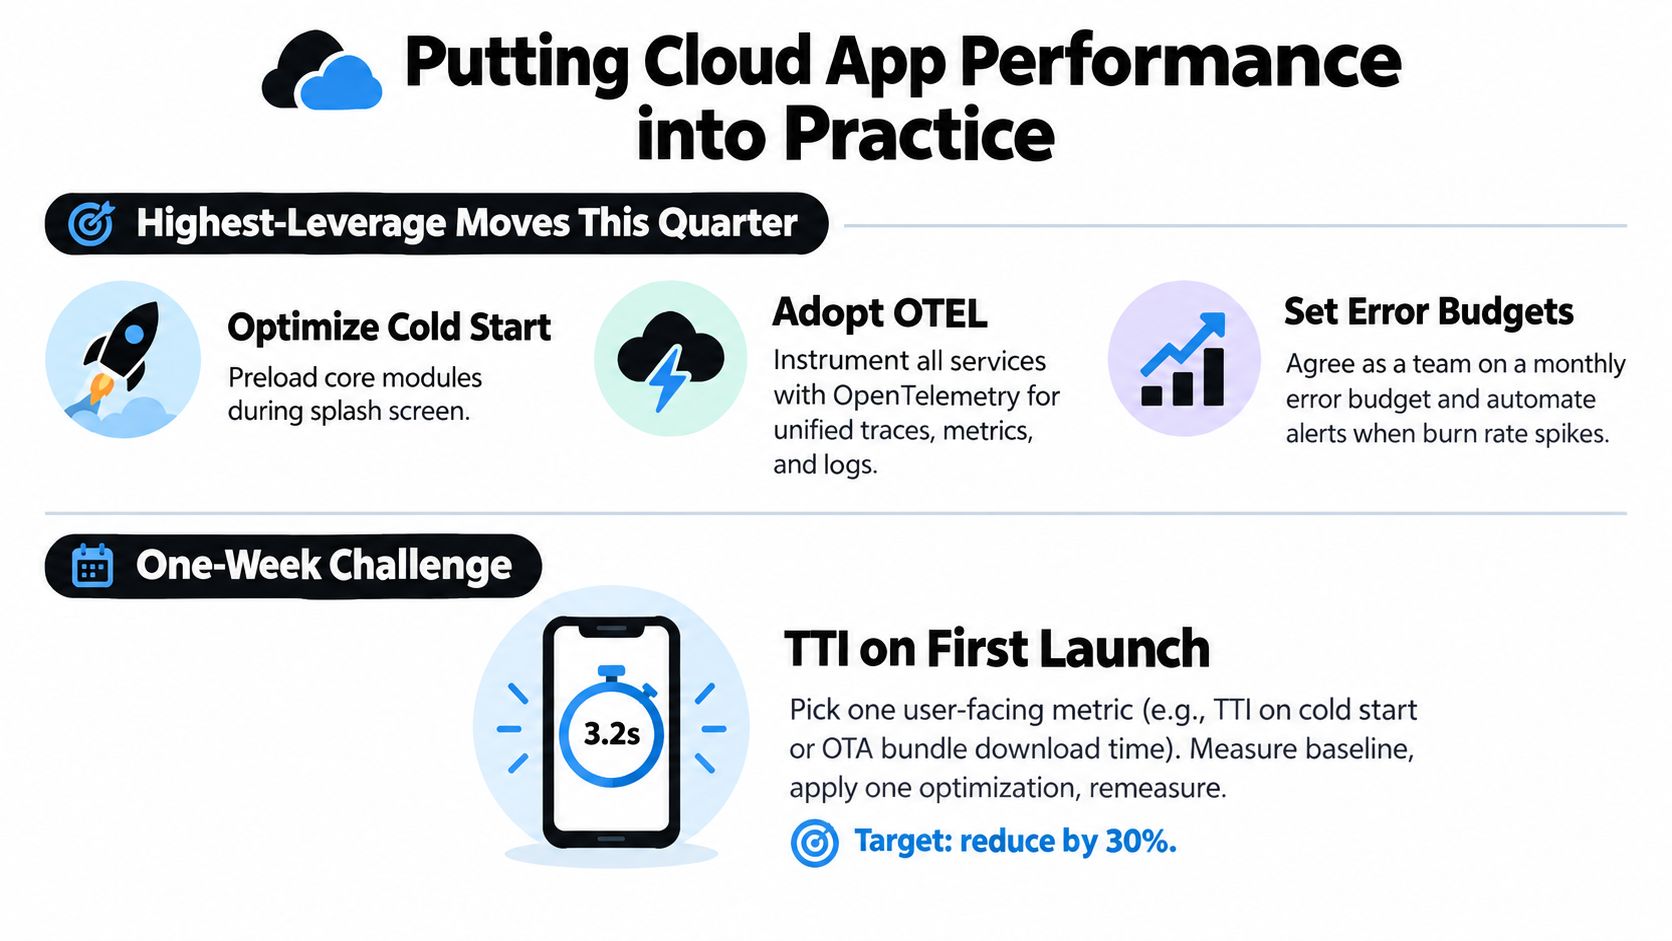
Ce que je prioriserais ce trimestre
Commencez par les actions qui réduisent le plus vite l'impact des incidents :
- Validez le comportement du cache edge : Vérifiez que la fraîcheur du manifeste et l'invalidation du bundle respectent les hypothèses de votre runbook.
- Auditez taille et coût de démarrage du bundle : La vitesse de livraison et celle d'évaluation comptent toutes deux.
- Créez des dashboards P95 pour les mises à jour : Ne vous contentez pas des moyennes.
- Track error budget burn by channel: Fiabilité et vélocité des releases doivent partager le même tableau de bord.
- Rédigez le runbook de rollback : Incluez déclencheurs, responsables et étapes de communication.
Si vous avez besoin d'un exemple concret d'outil dans cette catégorie, Capgo est une option pour les équipes Capacitor et Electron qui ont besoin de live updates signés, d'un contrôle du déploiement par canal, de logs par appareil et d'un rollback possible, le tout livré via un réseau edge mondial. L'essentiel n'est pas le nom du fournisseur. C'est de choisir un workflow qui vous permet de publier, d'observer et de revenir sur une mise à jour sans attendre la validation des stores quand le problème se situe dans le code livré via le web.
Une mesure disciplinée l'emporte sur l'ingénierie héroïque. Mieux vaut faire bouger une métrique visible en une semaine que passer un trimestre à peaufiner des chiffres backend qui ne changent jamais l'expérience utilisateur.
Si votre équipe déploie des applications Capacitor et souhaite un meilleur contrôle sur la livraison live update, l'observabilité, les déploiements progressifs et la sécurité des rollbacks, Capgo est conçu pour ce workflow. Il vous permet de livrer des mises à jour signées de JavaScript, CSS, config et assets en dehors de la validation des stores, puis de suivre l'adoption et les échecs d'assez près pour rendre la performance des apps cloud opérationnelle plutôt que théorique.


