
水曜日の午前9時12分、モバイルチームが本番環境でチェックアウトのバグを発見しました。Webならすぐに修正できます。しかしiOSとAndroidでは、少なくともストア審査を通す方法では不可能です。サポートは問い合わせチケットを集め始め、プロダクトは状況アップデートを求め、エンジニアリングは「修正をどれだけ早く出せるか」「ユーザーにどれだけ早く届くか」「修正が効いたことをどれだけ早く証明できるか」という3つの問いに同時に答えようとしています。
ここで、クラウドアプリのパフォーマンスは抽象的なバックエンドの話題ではなく、リリースの話題になります。ストア外でJavaScript bundle、設定、テキスト、アセットの更新を配信するハイブリッドモバイルチームにとって、パフォーマンスとは単に「API が速いか?」ではありません。ユーザーがまだ影響範囲にいる間に、配信経路が更新を公開、ルーティング、ダウンロード、検証、適用、観測し、必要ならロールバックできるかどうかです。
Capacitor、Ionic、その他のハイブリッドスタックで開発しているなら、パフォーマンス作業への考え方が変わります。マニフェストの取得が止まる、古いbundleを返すエッジキャッシュ、ホットフィックスの失敗箇所を特定できないトレースは、すべて同じシステムの一部です。アプリの体験とリリースの仕組みは密接に結びついています。
目次
- 修正をリリースできなかったモバイルチーム
- クラウドアプリのパフォーマンスの本当の意味
- クラウドバックエンドアプリのレイテンシ構造
- モバイルアップデート向けエッジネットワークとCDN配信
- 平均レスポンスタイム以上に重要な指標
- データスワンプに陥らないクラウドアプリのオブザーバビリティ
- SLA、エラーバジェット、チャネルベースのロールアウト
- クラウドアプリのパフォーマンスを実践に移す
修正をリリースできなかったモバイルチーム
実務で何度も見てきたチームの構成はこんな感じだ。モバイルリード1名、アプリエンジニア2名、バックエンドエンジニア1名、プロダクトマネージャー1名、そして怒ったユーザーからのスクリーンショットを転送してくるサポート。バグは単純だ。フィーチャーフラグが切り替わった後、価格の不整合でチェックアウトが壊れる。修正も単純だ。厄介なのはデリバリーだ。
ネイティブシェルは変更不要だ。JavaScriptバンドルを変える必要がある。チームがアプリストアへの提出だけに頼っているなら、今まさに自分たちの制御できないプロセスを待たされていることになる。その待ち時間中、すべての会話は悪化していく。サポートは誰が影響を受けているかを尋ねる。プロダクトはエクスポージャーがいつ下がるかを尋ねる。エンジニアリングはユーザーが修正された code パスに到達しているのかを尋ねる。
遅延はコーディングだけではない
まずリリースのボトルネックとして捉える。これは部分的に正しい。しかし、より根本的な問題は クラウド配信によるパフォーマンス 更新パス全体にわたって。
live update が機能するには、いくつかの条件が整う必要があります:
- デバイスが更新サービスに到達すること: マニフェストのリクエストが遅い、または断続的に失敗すると、ユーザーは壊れたバージョンのまま放置される時間が長くなります。
- エッジが正しいファイルを配信すること: キャッシュの無効化が遅れると、ある国では修正版が届くのに、別の国ではまだ古いアセットをダウンロードしている可能性があります。
- アプリが安全に検証して適用すること: 署名済みバンドル、チャネルターゲティング、ロールバックルールは、単なる速度と同じくらい重要です。
- チームが採用状況を監視すること: 誰が受け取ったか確認せずに修正をリリースするのは、より複雑な推測に過ぎません。
実践的なルール: モバイルのホットフィックスは、影響を受けたデバイスが実際にダウンロードして適用した時点で初めて「リリース」されたと言えます。
だからこそ、Live Updatesではクラウドアプリのパフォーマンスがこれほど重要になります。最適化しているのはサーバーの応答時間だけではありません。ネットワークが不安定な環境や地域、アプリバージョンが異なる実機でのインシデント復旧時間を最適化しているのです。
「アプリは速いか」よりも重要な問い
インシデント後にチームがパフォーマンスを語るとき、よく「アプリが遅く感じたか」を問題にします。より有用な問いは、「インシデントが広がる前にユーザー体験を変えられるほど、配信システムが速かったか」です。
ハイブリッドアプリでは、リリースパスもプロダクトの一部です。修正済みのbundleを迅速に公開し、チャネルを安全に対象指定し、導入状況を確信を持って確認できれば、パフォーマンスは運用の一部になります。これはサポート負荷、収益の保護、そして障害時にプロダクトがエンジニアリングをどれだけ信頼するかに直結します。
クラウドアプリのパフォーマンスの本当の意味
モバイルチームが「パフォーマンス」と聞くと、たいていは読み込み時間を思い浮かべます。それはほんの一部にすぎません。 クラウドアプリのパフォーマンス は、以下の4つの要素が組み合わさったものです: レイテンシ、スループット、可用性、一貫性.
これを理解するには、お店の例えを使うのが分かりやすいでしょう。
論理的に把握できる4つの要素
レイテンシ は、カウンターでの待ち時間です。何かを頼んで、返答が返ってくるまでの時間を数えます。
スループット は、その店が一度に何人の客をスムーズに扱えるかです。トラフィックが急増した瞬間に行列ができるなら、速いレジ1台では不十分です。
利用可否 は、そもそも店が開いているかどうかです。返答が永遠に届かないのは、遅い成功ではなく、失敗したやり取りです。
一貫性 は、すべてのレジが同じ在庫数と価格を見ているかどうかです。あるレジには商品があると言われ、別のレジにはないと言われると、客は遅延だけでなく混乱を体験します。
過去のベンチマークは、第1と第3の用語を根拠づけるのに役立ちます。あるCloudOpsの分析では、世界平均が 426.4ミリ秒 HTTPリクエストを完了し、レスポンスを受信するまでの時間。平均可用性は 97.69% これは、 Google Cloud Observability. サービスが「ほぼ稼働している」状態でも、ユーザーは遅延とダウンタイムの両方を実感するため、この2つの数値は重要です。
モバイルアップデート配信が4つすべてに依存する理由
Live Updateでは、レイテンシはマニフェストとbundleを取得するまでの時間です。スループットは、アプリ起動時に大量のデバイスがアップデートを確認するような急増時でも、サービスが正常に動作するかどうかを指します。可用性は、障害発生時にデバイスがアップデートのエンドポイントにそもそも到達できるかどうかです。一貫性は、異なる場所にいるデバイスが、意図した同じリリースチャネルとアセットセットを受け取れるかどうかを意味します。
アプリのアーキテクチャが重要になってきます。アプリの code、ストレージ、CDN、エッジロジック、リリースチャネル間の構成要素を整理するなら、 モバイルアプリのインフラストラクチャ に関する実践的な入門ガイドが、配信パイプラインとユーザー体験をつなぐのに役立ちます。
よくある混同
チームは「アップデートが遅い」という一つの不満に、これら4つをまとめてしまいがちです。しかし、これらは原因も担当者も異なる、別々の問題です。
- 高レイテンシ: リクエストは通るが、ユーザーは待たされる
- 低スループット: バースト時にリクエストが滞留する
- 可用性の低下: サービスに到達できない
- 整合性の弱さ: ユーザーが不整合な状態や古いバージョンを受け取る
これら4つを早期に分離すれば、インシデントレビューがはるかに明確になります。「ネットワークの問題」で揉めるのをやめ、失敗した正確なレイヤーを特定できるようになります。
モバイルチームにとって、この区別は重要です。更新システムは多段階のシステムであり、bundleが小さく、署名済みで正しくても、これらの品質のいずれかが低下すれば、ユーザーに届くのが遅くなる可能性があります。
クラウドバックエンドアプリにおけるレイテンシの構造
ユーザーが感じる遅延は、単一の要因であることは稀です。それは積み重なる小さな待ち時間のスタックです。ハイブリッドアプリがlive updateを確認する際、ユーザーはDNS、TLS、ネットワーク伝送、マニフェスト生成、署名検証、ファイルダウンロード、ディスク書き込み、JavaScript評価を個別のイベントとして認識しません。彼らが感じるのは、一つの停止です。
そのため、レイテンシ対策は~のように扱うべきです 予算.
待ち時間の発生箇所
最初のレイヤーは接続のセットアップです。DNS解決とTLSハンドシェイクは、アプリケーションロジックの実行前に発生することがよくあります。次に、最寄りの配信ポイントへのネットワーク往復(RTT)が発生します。その後、バックエンドまたはエッジロジックが、このデバイスにどのマニフェストとバンドルを配信するかを決定する必要があります。最後に、デバイスはダウンロードしたデータを展開して評価する必要があります。
これを作業モデルとして使用してください:
| レイヤー | 典型的な範囲 (ms) | 最適化のレバー |
|---|---|---|
| DNSとTLSのセットアップ | 50〜150 | 接続の再利用、HTTP keep-alive、TLSセッション再開 |
| 配信ポイントまでのネットワークRTT | 10〜80 | リージョナル配置、CDNルーティング、エッジキャッシュヒット率 |
| オリジンまたはエッジ処理 | 20〜300 | 軽量なマニフェスト生成、事前計算されたメタデータ、高速なストレージ参照 |
| デバイス側の適用とレンダリング | 100〜600 | 小さいバンドル、事前ウォームアップされたJSエンジン、少ない起動処理 |
ネットワーク部分に特化した基礎知識が必要な場合は、この解説が アプリケーション配信におけるネットワーク遅延 についてで、モバイルチームの非ネットワーク担当者にも役立ちます。
地理的条件は有効ですが、それだけでは不十分です
広く引用される到達可能性調査では、 世界人口の大半が100ミリ秒以内にクラウド施設にアクセスできる。これが、この クラウド到達性の議論にまとめられているように、パフォーマンス戦略において地域デプロイが中心になった理由を説明しています。これは朗報ですが、すべてのユーザーが自動的に高速な更新パスを得られるわけではありません。
別の研究がこの罠を明確に示しています。エッジサイトはネットワーク遅延を削減できますが、エッジのリソース制約によりキューイング遅延が発生し、結果としてクラウド全体の方が速くなるケースがある、とこの エッジとクラウドのレイテンシ分析.
モバイルチームが最初に調整すべきこと
アプリを書き直さずに変更しやすいレイヤーから始めましょう:
- マニフェストをエッジで慎重にキャッシュする: ホットフィックス中にプロパゲーションが完璧に動作することを期待するよりも、短いTTLと明示的な無効化の方が通常は安全です。
- リリースメタデータを事前計算する: チャネル、バージョン、署名データが事前に準備できる場合、リクエストごとに複雑なマニフェストを構築しないでください。
- アプリの起動処理を削減する: ダウンロードは速くても評価に時間がかかるバンドルは、依然として遅く感じられます。
- 可能な限り接続を再利用する: セットアップの繰り返しコストは、不安定なモバイルネットワークで目に見える遅延を生みます。
「バンドルのダウンロードが速い」からといって、アップデートが速いとは限りません。ユーザーが気にするのは、新しい code が実際に実行できる状態になったときだけです。
モバイルアップデート向けエッジネットワークとCDN配信
単一のクラウドリージョンは、社内ツールや単一の国向けアプリには十分機能します。しかし、ユーザーが複数の大陸に分散し、ホットフィックスを素早く届ける必要があると、その構成を正当化するのは難しくなります。モバイルアップデート配信では、エッジとCDNの設計が、誰がファーストバイトを速く受け取れるか、誰が古いコンテンツを受け取るか、そして誰がよりによって最悪のタイミングでオリジンにフォールバックするかを決めます。
チームがよく検討する3つのデリバリーモデル
最もシンプルなモデルは 集中型オリジン配信です。デバイスは単一のリージョンからマニフェストとバンドルを取得します。運用がシンプルで挙動を理解しやすく、初期段階では多くの場合これで十分です。
次のステップは リージョン配信です。主要な数カ所のリージョンにストレージやアプリケーションロジックを配置し、ユーザーを最も近いリージョンへルーティングします。これにより、多くのユーザーの通信距離が短縮され、負荷分散も改善します。
さらに、 エッジ配信。静的バンドルはユーザーの近くでキャッシュされ、エッジの軽量ロジックにより、リクエストがオリジンに到達する前にマニフェストの書き換え、チャネルのルーティング、署名関連のチェックなどが実行できます。
実用的な比較を以下に示します:
| モデル | 典型的なP50ファーストバイト | キャッシュ無効化の労力 | 最適な用途 |
|---|---|---|---|
| 集中型クラウドリージョン | 遠方のユーザーでは高くなる | 低 | フットプリントが小さく、リリース頻度が低い |
| リージョナルデプロイ | 中程度 | 中 | ユーザーが地域ごとに集まるマルチリージョンアプリ |
| CDNとエッジロジックによるエッジ配信 | キャッシュヒット率が良好な場合、最も低い | 高 | グローバルアプリ、頻繁な更新、インシデントに敏感なリリース |
仕組みを評価しているチーム向けに、このガイドでは アプリ配信におけるエッジネットワーク 正しいメンタルモデルを与えてくれます。
チームが見落としがちな要素
キャッシュの無効化は解決済み問題のように聞こえますが、重要な修正がリリースされると状況が変わります。エッジではある地域では昨日のmanifest、別の地域では今日のmanifestが配信され、「修正は一部のユーザーには効いている」というサポート報告が殺到します。
これは単なる理論上の話ではありません。リリースの整合性に関わる問題です。
エッジ配置に関する論文によると、コンピューティングをユーザーに近づけても、アクセスレイテンシの改善はわずか 約6%〜30%にとどまることが分かっており、また、代替ネットワークパスが名目上のローカルルートより 最大40%つまり、ユーザー体験のテールでは、物理的な近さと同じくらいルーティング品質やピアリングが重要になり得ると、この 大規模なエッジパフォーマンス論文は指摘しています。.
モバイルチーム向けの意思決定マトリックス
アップデート配信のティアを選ぶ際は、次の基準を使ってください:
- ユーザー分布: ユーザーが1つの国に集中している場合は、集中型またはリージョン配信で十分な場合があります。
- リリース頻度: 頻繁にリリースするチームはエッジキャッシュの恩恵を大きく受けますが、より厳格なキャッシュ規律も引き継ぐことになります。
- Hotfixのコスト: インシデント中に古いbundleが深刻な影響を与える場合、必要になる前に明示的な無効化とロールバックを構築しておきましょう。
- 運用上の許容度: エッジロジックは強力ですが、ルーティングのバグ、署名不一致の処理、地域固有の予期せぬ問題が発生する箇所も増えます。
正解は「常にエッジを使う」ことではありません。リリースプロセスが要求するスピードと影響範囲に合わせて配信アーキテクチャを選ぶことです。
平均レスポンスタイム以上に重要な指標
平均応答時間はダッシュボードには有用ですが、ユーザーの苦痛を議論する際にはほとんど役に立ちません。モバイルユーザーは平均的なリクエストを体験するのではなく、Hotfixをプッシュした直後にアプリを開いた瞬間、自分のデバイス、自分のネットワーク上で、自分のリクエストを体験します。
だからこそ、テールメトリクスがより重要になるのです。
プロダクトマネージャーに見せたい3つの視点
まず、コールドスタートとウォームスタートのレイテンシを P95 と P99から始めましょう。コールドスタートは、アプリが新規に起動し、ウォーム状態なしで更新を確認する際の挙動を示します。ウォームスタートは、アプリがすでに一部処理を行った後に残る摩擦の大きさを示します。
その直下で、 Apdex を、モバイルチームが妥当と判断するしきい値で追跡します。デスクトップWebでは妥当に感じられるしきい値でも、ハイブリッドアプリの起動パスでは誤りになる可能性があります。
次に、 エラーバジェット燃焼率を追跡します。これにより、議論は「アラートが発火したか?」から「合意した信頼性の余裕をどの速さで消費しているか?」へと移ります。
週次レビューで共有する価値のあるコンパクトなビジュアルです:
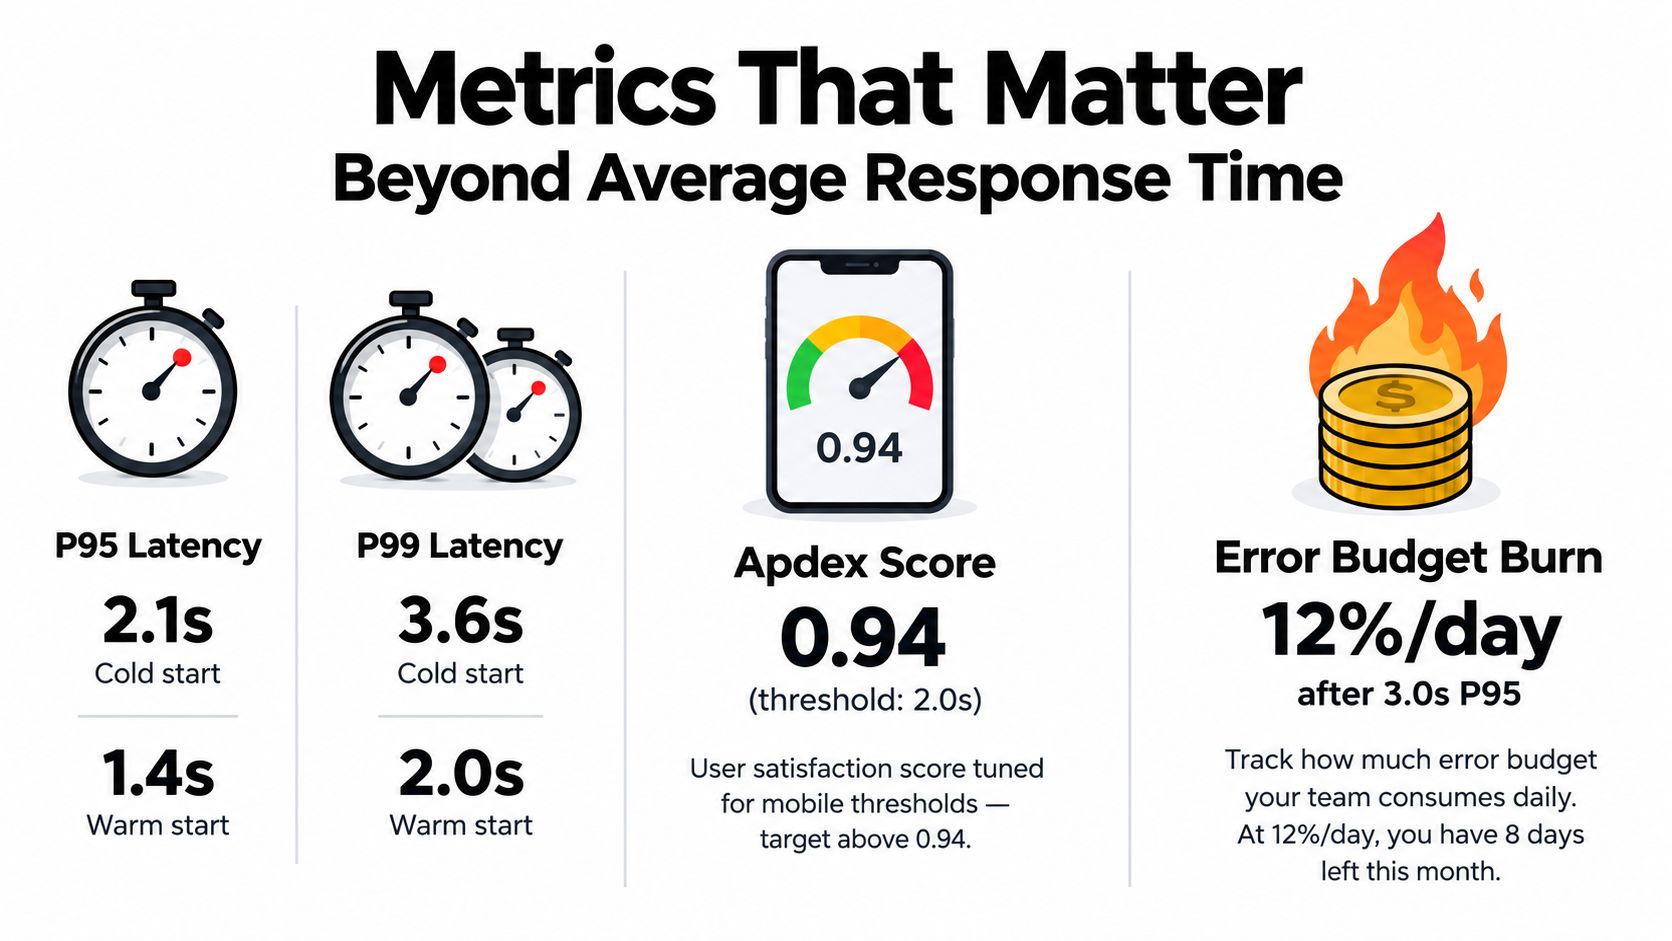
パフォーマンスとリリース結果を紐付ける指標
Webチームには不要なことが多い、配信特有の指標を1つ追加しましょう: adoption rate(適用率) リリースチャネル別に。修正したbundleを公開したのに、対象デバイスがまだ旧バージョンのままなら、それはパフォーマンスと配信の両方の問題です。
指標は次の軸でセグメント化しましょう:
- デバイスクラス: 古い端末では、起動やbundle評価のコストが真っ先に表面化しがちです。
- ネットワーク種別: Wi-Fiでは隠れてしまうbundle設計の悪さも、モバイルデータ通信では即座に露呈します。
- アプリバージョン: バージョン固有の失敗もあり、特にブリッジの挙動やマイグレーションロジック周りで発生します。
平均値を眺めるのではなく、パフォーマンステレメトリをどう解釈するか実践的に復習したいチームには、この動画がおすすめです:
ノイズを読む際の注意点
クラウドアプリのパフォーマンスにおける小さな変動が、すべて意味を持つわけではありません。大規模な縦断研究では、 2,366件のベンチマーク で 789個のAWS Kubernetesクラスター 全体的な変動は次を下回っており、 3.7%時間帯や週末によるわずかな影響は見られるものの、この クラウドパフォーマンス変動調査によれば、小さな変動に過剰反応せず、テールのリグレッションには真剣に受け止めるべきだという有用なリマインダーです。
クラウドのパフォーマンスがランダムかどうかを問うのではなく、自分のシステムで通常の測定ノイズがどのようなものかを見極め、それを超える変化にアラートを出すべきです。
データスワンプに陥らないクラウドアプリのオブザーバビリティ
多くのエンジニアはテレメトリを持っていますが、オンコール時の問いにすぐ答えられるとは限りません。ハイブリッドモバイルアップデートでは、有用な問いはたいてい具体的です。「なぜこのデバイスは古いbundleのままなのか」「なぜ新しいbundleの適用に失敗したのか」「リリース後に起動が遅くなったのはなぜか」などです。
トレース、ログ、メトリクスは必要です。しかし、それだけでは足りないことがよくあります。
1つのリリースパスを中心にスタックを構築
クラウドアプリのパフォーマンス監視スタックは、1回の更新試行をデバイスからバックエンドへ、そして戻ってくるまで追跡できるようにすべきです。
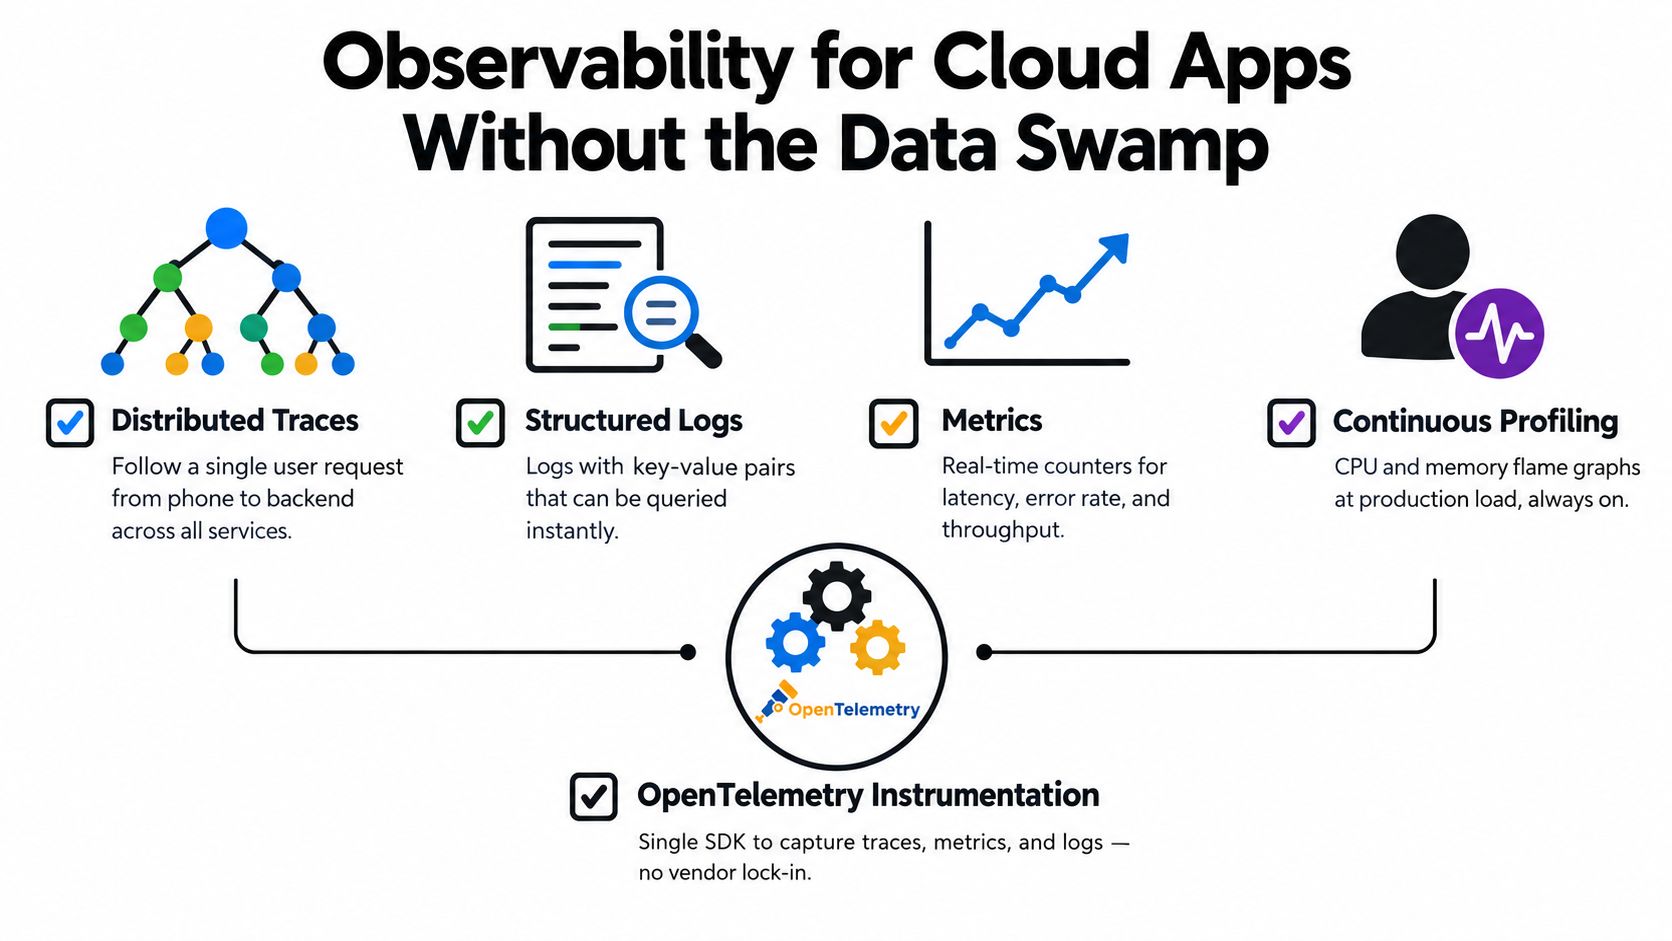
モバイルブリッジと更新クライアントに OpenTelemetry を埋め込み、アプリバージョン、リリースチャネル、プラットフォーム、更新結果のタグを付与します。ログは構造化し、あいまいなテキスト検索なしで1つの更新IDやデバイスセッションをクエリできるようにします。メトリクスはレイテンシ、エラー率、採用率、ロールバックイベントに焦点を当てます。
これらの要素を標準化しているチームには、 リリース済みアプリのアプリケーション可観測性 の概要が実装の参考になります。
欠けている4つ目のシグナル
モダンなAPMガイダンスにおける最も有用な変化の一つは、トレース、メトリクス、ログだけでは診断のギャップが残るという考え方です。CPU、メモリ、ロック時間を消費している正確な関数を示すため、継続的プロファイリングは第4のシグナルとしてますます重視されています。これはこの アプリケーションパフォーマンス監視とプロファイリングのガイド.
これはlive updateのワークフローにおいて重要です。トレースは「apply update」が長すぎたことを示すかもしれません。プロファイリングにより、ボトルネックがバンドルの展開、JSONの解析、ブリッジの初期化、あるいは起動パス内のロックのいずれかであるかが分かります。
深夜2時でも状況が把握できるシステムを
小さく、規律のあるビューのセットを使用します:
- リリースチャネルダッシュボード: 採用率、失敗数、ロールバック数
- 更新トランザクショントレース: マニフェットの取得からバンドルの評価まで
- トップの起動リグレッション: アプリバージョンとプラットフォーム別にグループ化
- プロファイリングビュー: Live Update の適用と初回レンダリング中の最も負荷の高い関数
これらのワークフローを中心に、より広範な DevOps や SRE の運用モデルを洗練させているチームには、 nexus IT group が DevOps をどのように提供しているかを見るのが役立ちます なぜなら、このケーススタディは可観測性を単なるツール購入ではなく、運用プラクティスとして位置づけているからです。
最高のダッシュボードとは、オンコールエンジニアが実際に開き、理解し、サポートがインシデントサマリーを書く前に行動を起こせるものです。
SLA、エラーバジェット、チャネルベースのロールアウト
SLA の表現は契約書上はきれいに聞こえますが、本番環境では厄介です。モバイルチームは、問題のあるリリース時にそのことをよく発見します。「高可用性」という言葉は安心感を与えますが、ある地域でユーザーが現在の bundle を取得できない状況で、更新を配信し続けるべきかどうかを判断しなければならなくなるまでです。
可用性目標をリリースポリシーに変える
可用性目標を顧客への約束だけでなく、ロールアウト段階の定義に使用します。
| 可用性目標 | 月間ダウンタイム予算 | 適切なロールアウト段階 |
|---|---|---|
| 99% | 約7時間18分 | 内部および実験チャネル |
| 99.9% | 約43分 | ベータおよび段階的な本番ロールアウト |
| 99.99% | 約4分23秒 | ビジネスクリティカルパスの本番環境への広範な展開 |
これらのダウンタイム予算は、単純な月次計算から導き出されます。また、デリバリーチェーン全体を考慮すると、実際にはさらに縮小します。オリジンが健全であっても、DNS、エッジ伝播、または不適切なチャネルルールにより、デバイスが意図されたリリースを取得できない場合があります。
更新プラットフォームがどのようにこの問題を運用面で捉えているか、具体的な例が必要であれば、 Capgo のサービスレベル契約 を確認し、ご自身のインシデント前提と比較してください。
エラーバジェットは、プロダクトと信頼性がようやく交わる場所
エラーバジェットはチームに権限構造を与えます。燃焼が穏やかであれば、ある程度のリリースリスクを許容できます。ホットフィックス後に燃焼が急増した場合は、次のチャネルへのプロモーションを一時停止してください。
ハイブリッドアプリ向けの堅牢なロールアウトラダーは、通常次のようになります。
- 内部: エンジニアがマニフェスト、署名、および適用フローが期待通りに動作することを確認します
- ベータ: フレンドリーユーザーやテスターがエッジデバイスの失敗を捕捉します
- 段階的プロダクション: 限られたオーディエンスが最初にバンドルを受信します
- 完全プロダクション: アップデートがデフォルトチャネルのターゲットになります
フィーチャーフラグ、オーバーザエアJavaScriptアップデート、またはその両方を使用する場合でも、同じ規律が適用されます。
必要になる前にロールバックのトリガーを設定しよう
ロールバックのルールは明確で、退屈なほど単純であるべきです。インシデント中に即興で決めないでください。
有用なトリガーには以下が含まれます:
- 採用が予期せず停滞した場合: デバイスはチェックインしているが、新しいbundleに移行していない
- テール側のユーザーで起動レイテンシが急激に悪化している: 特に古いデバイスや低速なネットワーク環境
- 適用失敗が特定のプラットフォームやバージョンに集中している: 多くの場合、bridgeやパッケージングの不一致が原因
- リアルユーザーモニタリング(RUM)でユーザー体験の劣化が確認されている: synthetic checksではモバイル特有の課題を見逃す可能性がある
障害は平易な言葉で伝えましょう。何が失敗し、誰が影響を受け、どのチャネルを停止し、どのロールバックが発生し、次の判断ポイントがいつなのかを伝えます。ステークホルダーに必要なのはテレメトリのダンプではなく、運用の明確さです。
クラウドアプリのパフォーマンスを実践に移す
クラウドアプリのパフォーマンスを改善する最短ルートは、インフラの自己満足プロジェクトにしないことです。ユーザーは、体感が変わらない限りキャッシュヒット率など気にしません。プロダクトも、修正が影響を受けるデバイスに届く速さが変わらない限り、オリジンCPUなど気にしません。
今週は、ユーザーに直結するメトリクスを1つ選び、実際に形にしましょう。
取り組む価値のある1週間のチャレンジ
ユーザーへの影響が明確な指標を選びましょう。良い候補は、アップデート確認後の初回起動でインタラクティブになるまでの時間や、本番チャンネルで最も遅いユーザーのアップデートbundleのダウンロード時間です。
次に、4つのことを行います:
- ベースラインを測定する: synthetic checksだけでなく、real user monitoring(RUM)も活用してください。
- 的を絞った変更を1つ行う: 例えば、bundleサイズを削減する、manifest出力を事前計算する、エッジキャッシュルールを厳格化するなどです。
- ステージングチャンネル経由で配信する: 全体ロールアウト前に、採用状況と失敗を監視します。
- 同じ指標を再測定する: ユーザーに見える結果が改善していなければ、その最適化にはあまり価値がなかったということです。
このチェックリストは、ほとんどのモバイルチームにとって適切な優先順位を示しています:
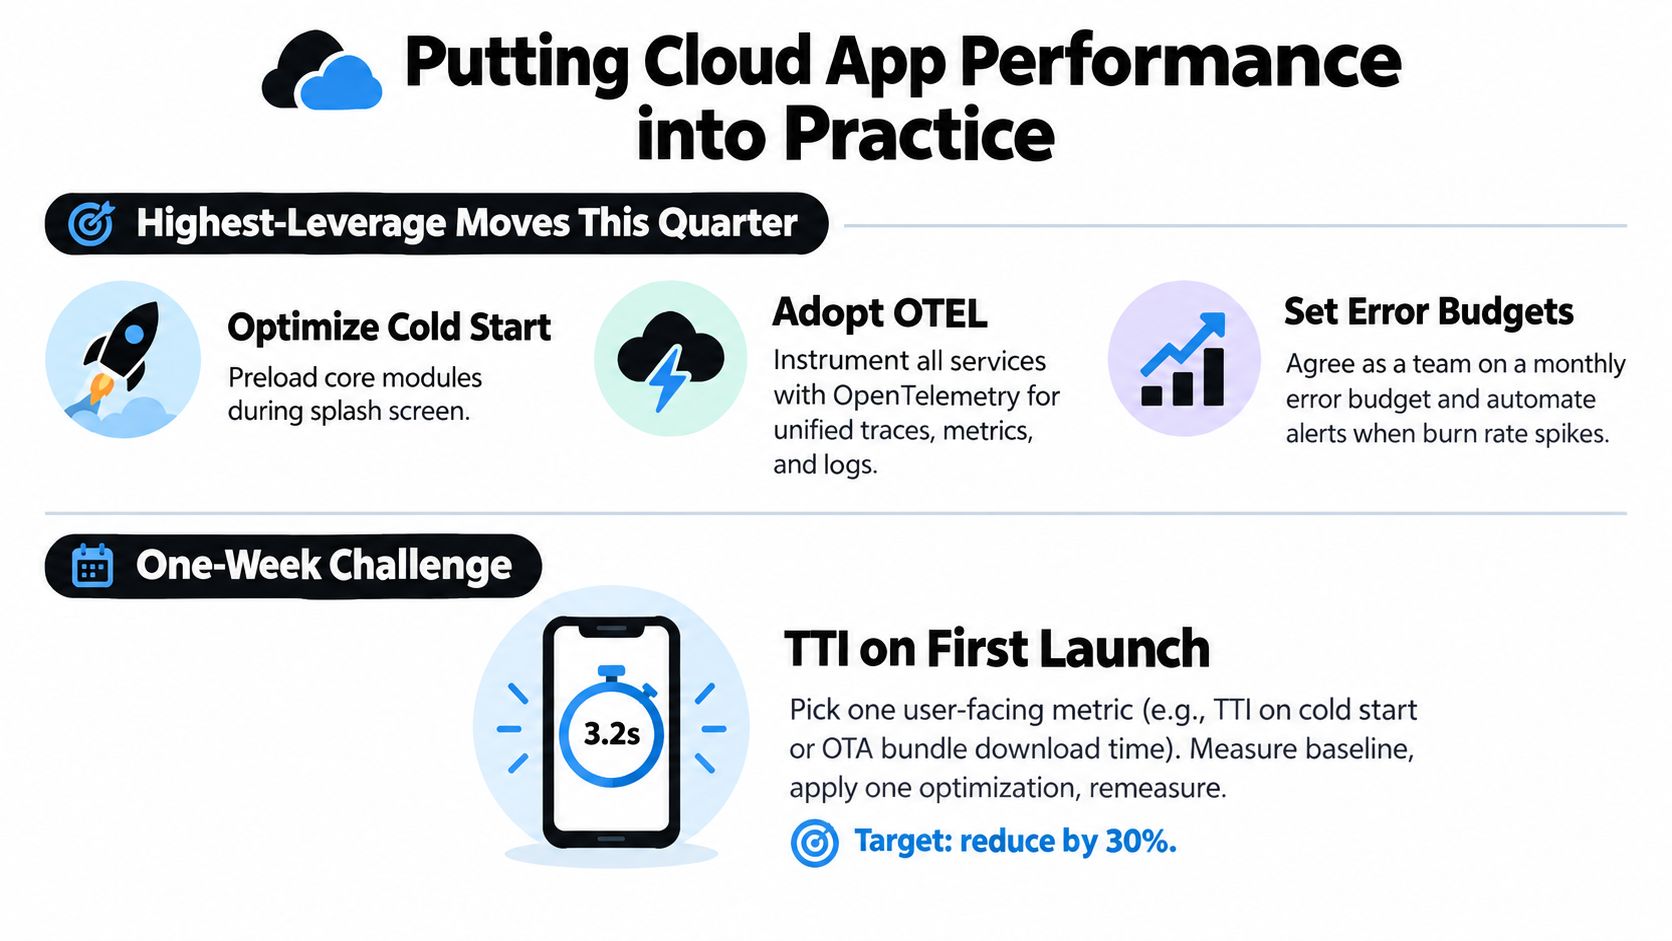
今四半期に優先すべきこと
インシデントの負担を最も早く軽減できる作業から始めましょう:
- エッジキャッシュの動作を検証します: マニフェストの鮮度とバンドルの無効化が、ランブックの想定通りに動作することを確認します。
- バンドルサイズと起動コストを監査します: 配信速度と評価速度、どちらも重要です。
- 更新フローのP95ダッシュボードを構築します: 平均値だけに留まらせないでください。
- チャネル別のエラーバジェット消費を追跡します: 信頼性とリリース速度は、同じスコアボードで評価すべきです。
- ロールバックのランブックを作成してください: トリガー、責任者、コミュニケーション手順を含めてください。
このカテゴリで実際のツール例が必要なら、 Capgo グローバルなエッジネットワーク経由で提供される署名付き Live Update、チャンネルベースのロールアウト制御、デバイスごとのログ、ロールバック対応を必要とする Capacitor や Electron チームにとって、選択肢の一つです。重要なのはベンダー名ではありません。問題がウェブ経由で配信される code にあるなら、ストア審査を待たずにアップデートを公開し、観測し、ロールバックできるワークフローを選ぶことです。
規律ある計測は、英雄的なエンジニアリングに勝ります。1週間で目に見える指標を1つ動かす方が、ユーザー体験を変えないバックエンドの数値を四半期かけて磨き上げるより価値があります。
チームが Capacitor アプリをリリースしていて、live update の配信、オブザーバビリティ、段階的ロールアウト、ロールバックの安全性をもっと厳密にコントロールしたいなら、 Capgo そのワークフロー向けに作られています。ストア審査を経ずに、署名済みの JavaScript、CSS、設定、アセットの更新を配信でき、導入状況と失敗を十分に追跡できるので、クラウドアプリのパフォーマンスを理論上の話ではなく、運用できるものにします。


