
Un miércoles a las 9:12 a. m., tu equipo móvil descubre un bug de checkout en producción. Web puede parchearlo rápidamente. iOS y Android no, al menos no a través de la revisión de la tienda. Soporte empieza a recopilar tickets, producto pide una actualización de estado e ingeniería intenta responder tres preguntas distintas a la vez: ¿qué tan rápido podemos lanzar una corrección, qué tan rápido la recibirán los usuarios y qué tan rápido podemos demostrar que la corrección funcionó?
Es ahí donde el rendimiento de las apps en la nube deja de ser un tema abstracto de backend y se convierte en un tema de releases. Para los equipos de móviles híbridos que publican bundles de JavaScript, configs, textos y actualizaciones de assets fuera de las tiendas, el rendimiento no es solo «¿es rápido el API?». Es si tu ruta de entrega puede publicar, enrutar, descargar, validar, aplicar, observar y, si es necesario, revertir una actualización mientras los usuarios siguen en el radio de impacto.
Si trabajas con Capacitor, Ionic u otro stack híbrido, esto cambia cómo piensas en el trabajo de rendimiento. Un fetch de manifiesto que se atasca, una caché de edge sirviendo un bundle antiguo o un trace que no puede identificar dónde falló un hotfix, todo se convierte en parte del mismo sistema. La experiencia de la app y el mecanismo de release están entrelazados.
Tabla de contenidos
- El equipo móvil que no pudo lanzar un fix
- Qué significa realmente el rendimiento de una Cloud App
- Anatomía de la latencia en apps con backend en la nube
- Redes edge y entrega por CDN para actualizaciones móviles
- Métricas que importan más allá del tiempo de respuesta medio
- Observabilidad para apps en la nube sin un pantano de datos
- SLAs, Error Budgets y Rollouts basados en canales
- Cómo llevar Cloud App Performance a la práctica
El equipo móvil que no pudo lanzar un fix
He visto este equipo muchas veces en la práctica: un mobile lead, dos ingenieros de apps, un ingeniero de backend, un product manager y soporte reenviando capturas de usuarios enfadados. El bug es simple. Un desajuste de precios rompe el checkout al activarse un feature flag. La solución también es simple. Lo frustrante es la entrega.
El shell nativo no necesita cambiar. El bundle de JavaScript sí. Si el equipo solo depende del envío a la App Store, ahora espera un proceso que no controla. Mientras esperan, cada conversación empeora. Soporte pregunta quiénes están afectados. Producto pregunta cuándo baja la exposición. Ingeniería pregunta si los usuarios llegan siquiera a la ruta code corregida.
El retraso no está solo en el código
Primero, plantéalo como un cuello de botella en el release. Es en parte cierto. Pero el problema de fondo es rendimiento desde la nube en toda la ruta de actualización.
Para que un live update sea útil, varias cosas deben salir bien:
- El dispositivo debe alcanzar el servicio de actualización: Si la solicitud del manifest es lenta o falla de forma intermitente, los usuarios permanecen más tiempo en la versión defectuosa.
- El edge debe servir los archivos correctos: Si la invalidación de la caché se retrasa, un país puede recibir la corrección mientras otro sigue descargando assets obsoletos.
- La app debe verificar y aplicar de forma segura: Los bundles firmados, el targeting de canales y las reglas de rollback importan tanto como la velocidad bruta.
- El equipo debe observar la adopción: Publicar una corrección sin saber quién la recibió es solo una forma más compleja de adivinar.
Regla práctica: Un hotfix móvil solo se considera «publicado» cuando los dispositivos afectados realmente lo han descargado y aplicado.
Por eso el rendimiento de las apps en la nube es tan importante para las actualizaciones en vivo. No solo optimizas el tiempo de respuesta del servidor. Optimizas el tiempo de recuperación ante incidentes en dispositivos reales, en redes irregulares, en distintas geografías y con diferentes versiones de la app.
Una pregunta mejor que «¿es rápida la app?»
Cuando los equipos hablan del rendimiento tras un incidente, suelen preguntar si la app se sentía lenta. La pregunta más útil es si el sistema de entrega fue lo suficientemente rápido para cambiar la experiencia de usuario antes de que el incidente se extendiera.
Para las apps híbridas, la ruta de publicación es parte del producto. Si tu equipo puede publicar un bundle corregido rápidamente, apuntar a un canal de forma segura y verificar la adopción con confianza, el rendimiento se vuelve operativo. Afecta directamente la carga de soporte, la protección de ingresos y la confianza que el producto tiene en ingeniería durante una interrupción.
Qué significa realmente el rendimiento de una Cloud App
Cuando los equipos móviles escuchan «rendimiento», suelen imaginar el tiempo de carga. Eso es solo una parte. Rendimiento de aplicaciones en la nube es la combinación de cuatro cualidades que trabajan juntas: latencia, throughput, disponibilidad y consistencia.
Una buena forma de explicarlo es usar la analogía de una tienda.
Cuatro cualidades que puedes analizar de verdad
Latencia es la espera en el mostrador. Pides algo y mides cuánto tarda en llegar la respuesta.
Rendimiento es cuántos clientes puede atender la tienda sin problemas a la vez. Un cajero rápido no basta si se forma una cola en cuanto se dispara el tráfico.
Disponibilidad es si la tienda está abierta o no. Una respuesta que nunca llega no es un éxito lento; es una interacción fallida.
Consistencia es si cada caja ve el mismo nivel de stock y los mismos precios. Si una caja dice que el artículo existe y otra que no, el cliente siente confusión, no solo retraso.
Un benchmark histórico ayuda a contextualizar el primer y tercer término. Un análisis de CloudOps reportó un promedio mundial de 426,4 milisegundos para completar una petición HTTP y recibir una respuesta, con una disponibilidad promedio de 97.69% according to Google Cloud Observability. Esas dos cifras importan porque los usuarios perciben tanto el retardo como el tiempo de inactividad, incluso cuando el servicio está “casi siempre disponible”.
Por qué la entrega de actualizaciones móviles depende de las cuatro
En las actualizaciones en vivo, la latencia es el tiempo para obtener el manifiesto y el bundle. El throughput indica si el servicio sigue funcionando bajo un pico cuando muchos dispositivos buscan actualizaciones al inicio. La disponibilidad es si los dispositivos pueden alcanzar el endpoint de actualización durante un incidente. La consistencia es si los dispositivos en diferentes ubicaciones reciben el mismo canal de lanzamiento y conjunto de assets previsto.
La arquitectura de la app empieza a importar. Si estás mapeando las piezas móviles entre la app code, el almacenamiento, el CDN, la lógica de edge y los canales de lanzamiento, una guía práctica sobre infraestructura de apps móviles ayuda a conectar el pipeline de entrega con la experiencia de usuario.
La confusión habitual
Los equipos suelen agrupar los cuatro en una sola queja: “las actualizaciones son lentas”. Pero son fallos distintos con responsables distintos.
- Alta latencia: la solicitud funciona, pero los usuarios esperan
- Throughput bajo: las solicitudes se acumulan durante picos
- Baja disponibilidad: el servicio no es accesible
- Consistencia débil: los usuarios reciben estados inconsistentes o versiones obsoletas
Si separas esos cuatro desde el inicio, la revisión de incidentes se vuelve mucho más precisa. Dejas de discutir sobre “la red” y empiezas a identificar la capa exacta que falló.
Para los equipos móviles, esa distinción importa porque los sistemas de actualización tienen múltiples pasos. Un bundle puede ser pequeño, estar firmado y ser correcto, y aun así llegar a los usuarios demasiado lento si alguna de esas cualidades se degrada.
Anatomía de la latencia en apps con backend en la nube
El retraso percibido por el usuario rara vez es una sola cosa. Es una acumulación de pequeñas esperas que se suman. Cuando una app híbrida comprueba una live update, el usuario no percibe DNS, TLS, tránsito por la red, generación del manifiesto, validación de firma, descarga del archivo, escritura en disco y evaluación de JavaScript como eventos separados. Percibe una única pausa.
Por eso el trabajo de latencia debe tratarse como un presupuesto.
De dónde viene el tiempo de espera
La primera capa es la configuración de la conexión. La resolución de DNS y el handshake TLS suelen ocurrir antes de que se ejecute la lógica de tu aplicación. Luego viene el viaje de red al punto de entrega más cercano. Después, la lógica del backend o del edge aún debe decidir qué manifest y qué bundle debe recibir este dispositivo. Finalmente, el dispositivo tiene que descomprimir y evaluar lo que descargó.
Usa este modelo de referencia:
| Capa | Rango típico (ms) | Palanca de optimización |
|---|---|---|
| Configuración de DNS y TLS | 50 a 150 | Reutilización de conexiones, HTTP keep-alive, reanudación de sesión TLS |
| RTT de red al punto de entrega | 10 a 80 | Ubicación regional, enrutamiento CDN, tasa de aciertos de caché edge |
| Procesamiento en origen o edge | 20 a 300 | Generación de manifiestos ligera, metadatos precalculados, búsquedas de almacenamiento más rápidas |
| Aplicación y renderizado en el dispositivo | 100 a 600 | Bundles más pequeños, motor JS precalentado, menos trabajo de inicio |
Si quieres una base sólida sobre la parte de red específicamente, esta explicación sobre latencia de red en la entrega de aplicaciones es útil para especialistas no de red en equipos móviles.
La geografía ayuda, pero no por sí sola
Un estudio de accesibilidad ampliamente citado encontró que la mayoría de la población mundial podría acceder a una instalación en la nube en 100 milisegundos, lo que ayuda a explicar por qué el despliegue regional se volvió central en la estrategia de rendimiento, como se resume en esta discusión sobre la accesibilidad de la nube. Eso es alentador, pero no significa que cada usuario reciba automáticamente una ruta de actualización rápida.
Otro estudio deja clara la trampa. Los sitios en el edge pueden reducir la latencia de red, pero los recursos limitados en el edge pueden crear retrasos de cola, provocando casos en los que la nube es más rápida en general, según este análisis de latencia edge vs cloud.
Qué deben optimizar primero los equipos móviles
Empieza por las capas más fáciles de cambiar sin reescribir la app:
- Cachea el manifest en el edge con cuidado: Los TTL cortos y la invalidación explícita suelen ser más seguros que esperar que la propagación funcione perfectamente durante un hotfix.
- Precalcula los metadatos de la release: No generes un manifest complejo en cada request si los datos de channel, version y signature pueden prepararse de antemano.
- Reduce la carga de inicio en la app: Un bundle que se descarga rápido pero tarda demasiado en evaluarse sigue sintiéndose lento.
- Reutiliza conexiones siempre que sea posible: El coste de la configuración repetida frena visiblemente en redes móviles inestables.
Una “descarga de bundle rápida” no garantiza una actualización rápida. Al usuario solo le importa cuándo el nuevo code está realmente listo para ejecutarse.
Redes edge y entrega por CDN para actualizaciones móviles
Una sola región cloud puede funcionar bien para herramientas internas o apps de un solo país. Pero cuesta más justificarlo cuando tu base de usuarios está repartida por varios continentes y necesitas que los hotfixes lleguen rápido. En la entrega de actualizaciones móviles, el diseño de edge y CDN determina quién recibe rápido el primer byte, quién recibe contenido obsoleto y quién recurre al origen justo en el peor momento.
Tres modelos de entrega que los equipos suelen considerar
El modelo más simple es entrega desde un origen centralizado. Los dispositivos descargan manifiestos y bundles desde una sola región. Es sencillo de operar, fácil de entender y suele ser suficiente al principio.
El siguiente paso es entrega regional. Colocas el almacenamiento o la lógica de la app en algunas regiones principales y diriges a los usuarios a la más cercana. Esto reduce la distancia de tránsito para muchos usuarios y distribuye mejor la carga.
Luego está la entrega en el edge. Los bundles estáticos se cachean cerca de los usuarios, y la lógica ligera en el edge puede reescribir manifiestos, enrutar canales o realizar validaciones de firmas antes de que la petición llegue al origen.
Aquí tienes una comparativa práctica:
| Modelo | P50 típico del primer byte | Esfuerzo de invalidación de caché | Mejor para |
|---|---|---|---|
| Región de nube centralizada | Mayor para usuarios lejanos | Bajo | Huella pequeña, lanzamientos poco frecuentes |
| Despliegues regionales | Moderado | Medio | Apps multirregión con clusters de usuarios predecibles |
| Entrega en el edge con CDN y lógica de edge | Mínima cuando los cache hits son saludables | Alta | Apps globales, updates frecuentes, releases sensibles a incidentes |
Para equipos que evalúan la mecánica, esta guía sobre redes edge en la entrega de apps ofrece el modelo mental adecuado.
Lo que los equipos suelen subestimar
La invalidación de caché parece un problema resuelto hasta que se publica un fix crítico. Entonces el edge sirve el manifest de ayer en una región y el de hoy en otra, y soporte recibe reportes de que “el fix funciona para algunos usuarios”.
No es una molestia teórica. Es un problema de integridad de la release.
Una tesis sobre el despliegue en el edge encontró que acercar la computación a los usuarios solo mejoraba la latencia de acceso en entre un 6% y un 30%, y también señaló que las rutas de red alternativas pueden superar a una ruta localmente nominal en hasta un 40%, lo que significa que la calidad del enrutamiento y el peering pueden importar tanto como la proximidad física en la cola de la experiencia de usuario, según esta tesis a gran escala sobre rendimiento en el edge.
Una matriz de decisión para equipos móviles
Usa estos criterios al elegir tu nivel de entrega de actualizaciones:
- Distribución de usuarios: Si los usuarios se concentran en un solo país, la entrega centralizada o regional puede ser suficiente.
- Frecuencia de lanzamientos: Los equipos que publican con frecuencia se benefician más del edge caching, pero también heredan una disciplina de caché más estricta.
- Coste de los hotfixes: Si un bundle obsoleto durante un incidente es costoso, diseña para invalidación y rollback explícitos antes de necesitarlo.
- Tolerancia operativa: La lógica en el edge añade potencia, pero también más puntos para errores de enrutamiento, manejo de discrepancias de firma y sorpresas geoespecíficas.
La respuesta correcta no es «usar siempre el edge». La respuesta correcta es adaptar la arquitectura de entrega a la velocidad y el alcance del impacto que exige tu proceso de lanzamiento.
Métricas que importan más allá del tiempo de respuesta medio
El tiempo de respuesta medio es útil para dashboards y casi inútil para discutir el dolor del usuario. Los usuarios móviles no experimentan la solicitud media. Experimentan su solicitud, en su dispositivo, en su red, en el momento en que abrieron la app después de que publicaste un hotfix.
Por eso las métricas de cola importan más.
Las tres vistas que pondría delante de un product manager
Empieza con la latencia de arranque en frío y en caliente en P95 y P99. El arranque en frío te dice qué pasa cuando la app se lanza desde cero y busca actualizaciones sin estado cálido que la ayude. El arranque en caliente te indica cuánto fricción queda una vez que la app ya ha hecho algo de trabajo.
Justo debajo, rastrea Apdex con un umbral en el que tu equipo móvil confíe. Un umbral que puede parecer justo para web de escritorio puede ser incorrecto para la ruta de arranque de una app híbrida.
Luego rastrea el consumo del presupuesto de errores. Esto cambia la conversación de «¿se disparó una alerta?» a «¿qué tan rápido estamos consumiendo el margen de fiabilidad que acordamos gastar?»
Aquí tienes un visual compacto que vale la pena compartir en la revisión semanal:
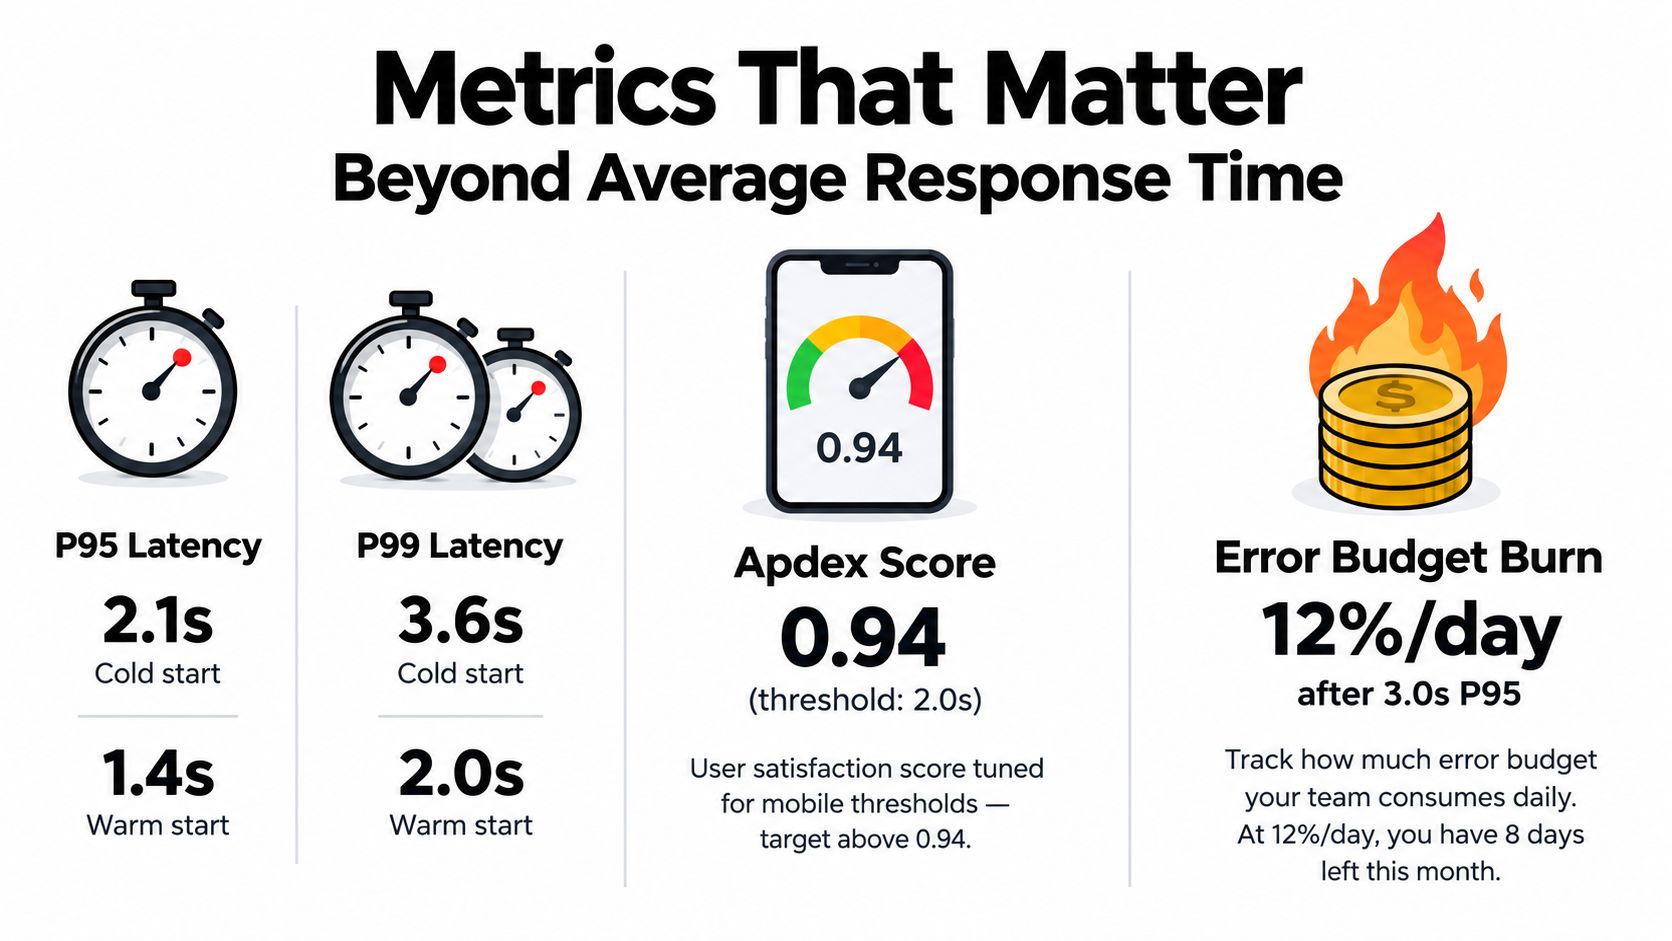
Métricas que conectan el rendimiento con los resultados de la liberación
Añade una métrica específica de entrega que los equipos web suelen no necesitar: tasa de adopción por canal de liberación. Si se publicó un bundle corregido pero los dispositivos afectados siguen en la versión anterior, es un problema de rendimiento y de entrega a la vez.
Segmenta tus métricas por:
- Clase de dispositivo: Los teléfonos antiguos suelen revelar primero los costes de arranque y evaluación.
- Tipo de red: Wi-Fi puede ocultar un mal diseño de bundle que los datos móviles exponen de inmediato.
- Versión de la app: Algunos fallos son específicos de la versión, especialmente en el comportamiento del bridge o la lógica de migración.
Este video es un buen complemento si tu equipo necesita un repaso práctico sobre cómo interpretar la telemetría de rendimiento en lugar de fijarse en promedios:
Una advertencia sobre el ruido en las lecturas
No todo pequeño movimiento en el rendimiento de apps en la nube es significativo. Un gran estudio longitudinal a través 2.366 benchmarks en 789 clústeres de AWS Kubernetes encontró una variabilidad general inferior a 3.7%, con sutiles efectos según la hora del día y el fin de semana, según este estudio sobre variabilidad de rendimiento en la nube. Es un recordatorio útil para no sobreaccionar ante pequeñas variaciones, pero sí tomar en serio las regresiones en la cola.
No preguntes si el rendimiento en la nube es aleatorio. Pregunta cómo se ve el ruido de medición normal en tu sistema y alerta ante cambios que lo superen.
Observabilidad para apps en la nube sin el pantano de datos
Muchos ingenieros tienen telemetría, pero a menudo no puede responder a la pregunta del on-call lo suficientemente rápido. Para actualizaciones híbridas móviles, la pregunta útil suele ser específica: ¿por qué este dispositivo se quedó en el bundle antiguo, por qué el nuevo no se aplicó, o por qué el arranque se volvió más lento tras un release?
Traces, logs y métricas son necesarios. A menudo no son suficientes.
Construye tu stack basado en una única ruta de lanzamiento
Un stack de observabilidad práctico para el rendimiento de apps en la nube debe permitirte rastrear un intento de update desde el dispositivo al backend y viceversa.
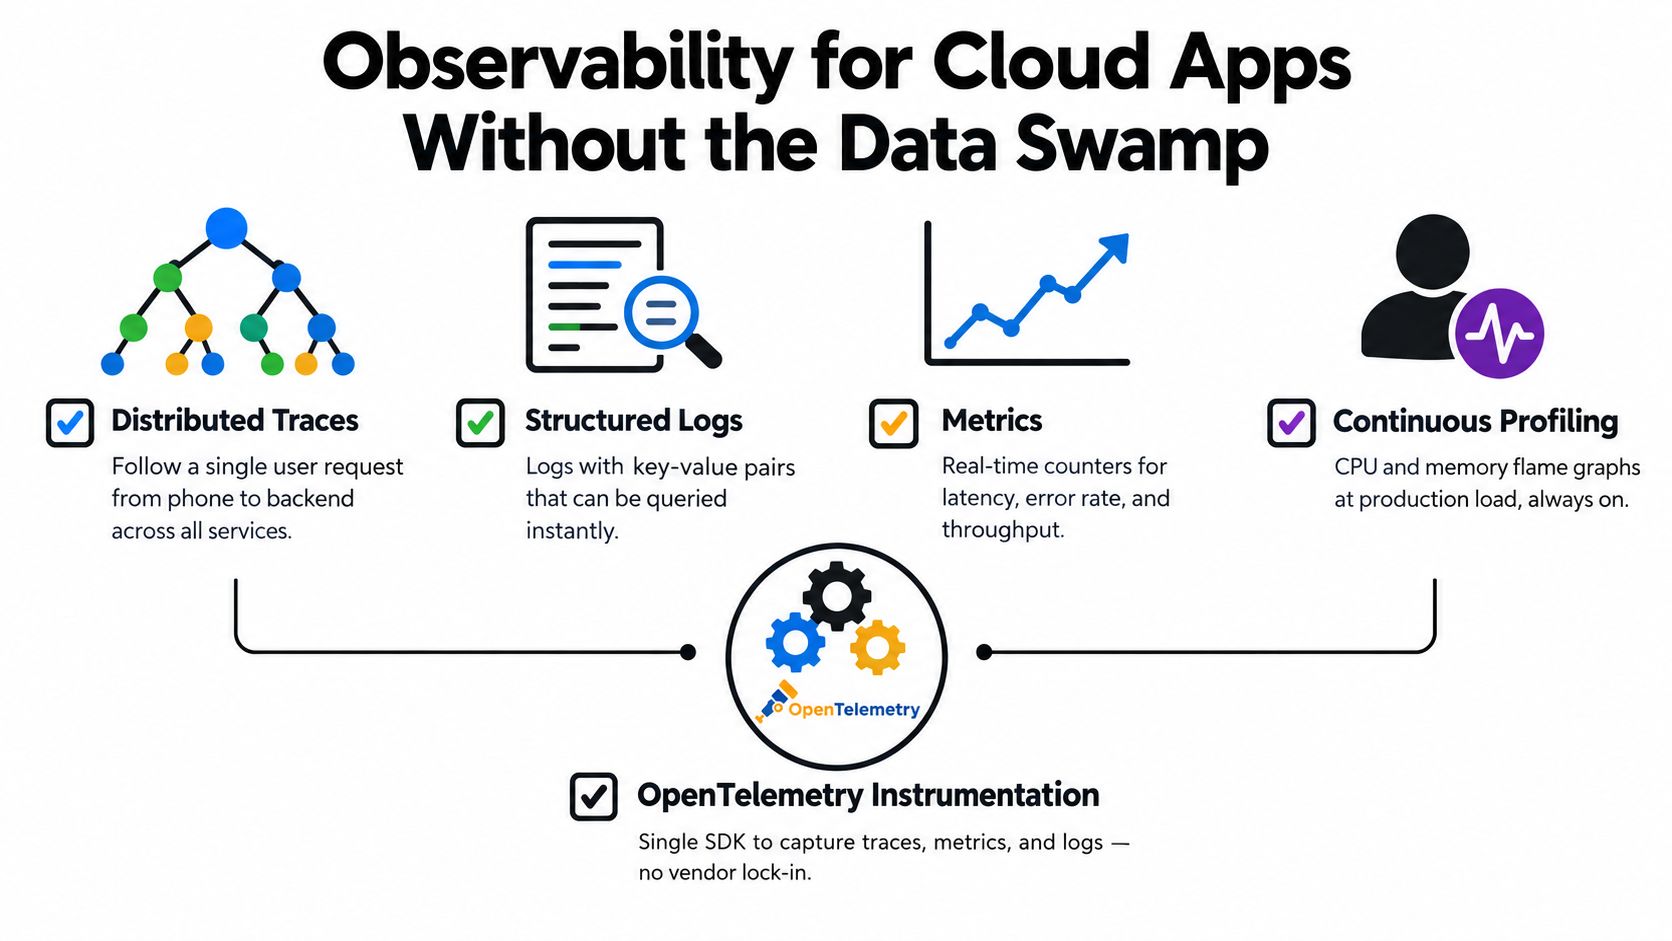
Instrumenta el bridge móvil y el cliente de update con OpenTelemetry tags para la versión de la app, el canal de release, la plataforma y el resultado del update. Estructura los logs para poder consultar un ID de update o una sesión de dispositivo sin búsquedas de texto difusas. Mantén las métricas centradas en latencia, tasa de error, adopción y eventos de rollback.
Para equipos que estandarizan estos componentes, este resumen de observabilidad de aplicaciones para apps ya publicadas es una buena referencia de implementación.
La cuarta señal que falta
Uno de los cambios más útiles en las guías modernas de APM es la idea de que los traces, métricas y logs todavía dejan un vacío de diagnóstico. El continuous profiling se considera cada vez más la cuarta señal porque muestra la función exacta que consume CPU, memoria o tiempo de lock, como se describe en esta guía de application performance monitoring y profiling.
Eso importa en los workflows de live update. Un trace podría mostrar que “apply update” tardó demasiado. El profiling puede revelar si el cuello de botella fue la descompresión del bundle, el parsing de JSON, la inicialización del bridge o un lock en una ruta de inicio.
Mantén el sistema legible a las 2 a.m.
Usa un conjunto pequeño y disciplinado de vistas:
- Dashboard del release channel: adopción, fallos, número de rollbacks
- Trace de la transacción de update: del fetch del manifest a evaluación del bundle
- Principales regresiones de startup: agrupadas por versión de app y plataforma
- Vista de profiling: funciones más pesadas en update apply y primer render
Si tu equipo está refinando su modelo operativo más amplio de DevOps y SRE en torno a estos workflows, es útil mira cómo nexus IT group implementa DevOps porque el caso de estudio plantea la observabilidad como una práctica operativa en lugar de una simple compra de herramientas.
El mejor dashboard es el que un ingeniero de guardia realmente abre, entiende y usa para actuar antes de que soporte redacte el resumen del incidente.
SLAs, Error Budgets y Rollouts basados en canales
El lenguaje de los SLA suena impecable en un contrato, pero es un caos en producción. Los equipos móviles suelen descubrirlo durante un release fallido. La “alta disponibilidad” suena tranquilizadora hasta que tienes que decidir si seguir publicando updates mientras los usuarios de una región no pueden obtener el bundle actual.
Convierte los objetivos de disponibilidad en políticas de release
Usa objetivos de disponibilidad para definir las etapas de rollout, no solo promesas al cliente.
| Objetivo de disponibilidad | Presupuesto mensual de downtime | Etapa de rollout adecuada |
|---|---|---|
| 99% | Aproximadamente 7 horas 18 minutos | Canales internos y experimentales |
| 99.9% | Unos 43 minutos | Beta y despliegue gradual en producción |
| 99.99% | Unos 4 minutos 23 segundos | Producción amplia para rutas críticas del negocio |
Esos presupuestos de tiempo de inactividad surgen de cálculos mensuales simples. En la práctica, también se reducen al considerar toda la cadena de entrega. Tu origen puede estar sano, pero el DNS, la propagación en el edge o una regla de canal errónea pueden impedir que los dispositivos reciban la versión prevista.
Si necesitas un ejemplo concreto de cómo una plataforma de actualizaciones plantea esto a nivel operativo, revisa el acuerdo de nivel de servicio de Capgo y compáralo con tus propios supuestos de incidentes.
Los presupuestos de error son donde producto y fiabilidad por fin se encuentran
Un error budget le da al equipo un marco para decidir. Si el consumo es bajo, puedes aceptar cierto riesgo en el release. Si el consumo se dispara tras un hotfix, pausa la promoción al siguiente canal.
Una escalera de rollout sólida para apps híbridas suele verse así:
- Interno: los ingenieros validan que el manifiesto, la firma y el flujo de aplicación funcionen como se espera
- Beta: usuarios y testers de confianza detectan fallos en dispositivos atípicos
- Producción escalonada: una audiencia limitada recibe el bundle primero
- Producción completa: la actualización se convierte en el canal objetivo predeterminado
La misma disciplina se aplica si usas feature flags, actualizaciones JavaScript over-the-air o ambas.
Configura los triggers de rollback antes de necesitarlos
Las reglas de rollback deben ser explícitas y aburridas. No las improvises durante un incidente.
Los triggers útiles incluyen:
- La adopción se estanca de forma inesperada: los dispositivos se reportan pero no pasan al nuevo bundle
- La latencia de inicio empeora drásticamente en los usuarios del tail: especialmente en dispositivos antiguos o redes lentas
- Los fallos al aplicar se concentran en una plataforma o versión: suele ser un desajuste en el bridge o el empaquetado
- El monitoreo de usuarios reales muestra una experiencia degradada: synthetic checks can miss mobile-specific pain
Comunica los incidentes con lenguaje claro. Di qué falló, a quién afectó, qué canal se pausó, qué rollback se hizo y cuándo es el próximo punto de decisión. Los stakeholders no necesitan un volcado de telemetría. Necesitan claridad operativa.
Cómo llevar Cloud App Performance a la práctica
La forma más rápida de mejorar el cloud app performance es dejar de tratarlo como un proyecto de infraestructura para lucirse. A los usuarios no les importa tu cache hit ratio si no cambia su experiencia. Al equipo de producto no le importa la CPU del origin si no cambia la rapidez con la que un fix llega a los dispositivos afectados.
Elige una métrica orientada al usuario esta semana y hazla real.
Un reto de una semana que vale la pena
Elige una métrica con impacto claro en el usuario. Buenas opciones son el tiempo hasta la interactividad en el primer lanzamiento tras una comprobación de actualización, o el tiempo de descarga del bundle de actualización para los usuarios más lentos de un canal de producción.
Luego, sigue estos cuatro pasos:
- Mide una línea base: Usa monitorización de usuarios reales, no solo checks sintéticos.
- Realiza un cambio específico: Por ejemplo, reduce el tamaño del bundle, precalcula el manifest o ajusta las reglas de edge caching.
- Despliega mediante un canal escalonado: Observa la adopción y los fallos antes del rollout masivo.
- Vuelve a medir la misma métrica: Si el resultado visible para el usuario no mejoró, la optimización no valió la pena.
Este checklist recoge el orden de prioridad correcto para la mayoría de los equipos móviles:
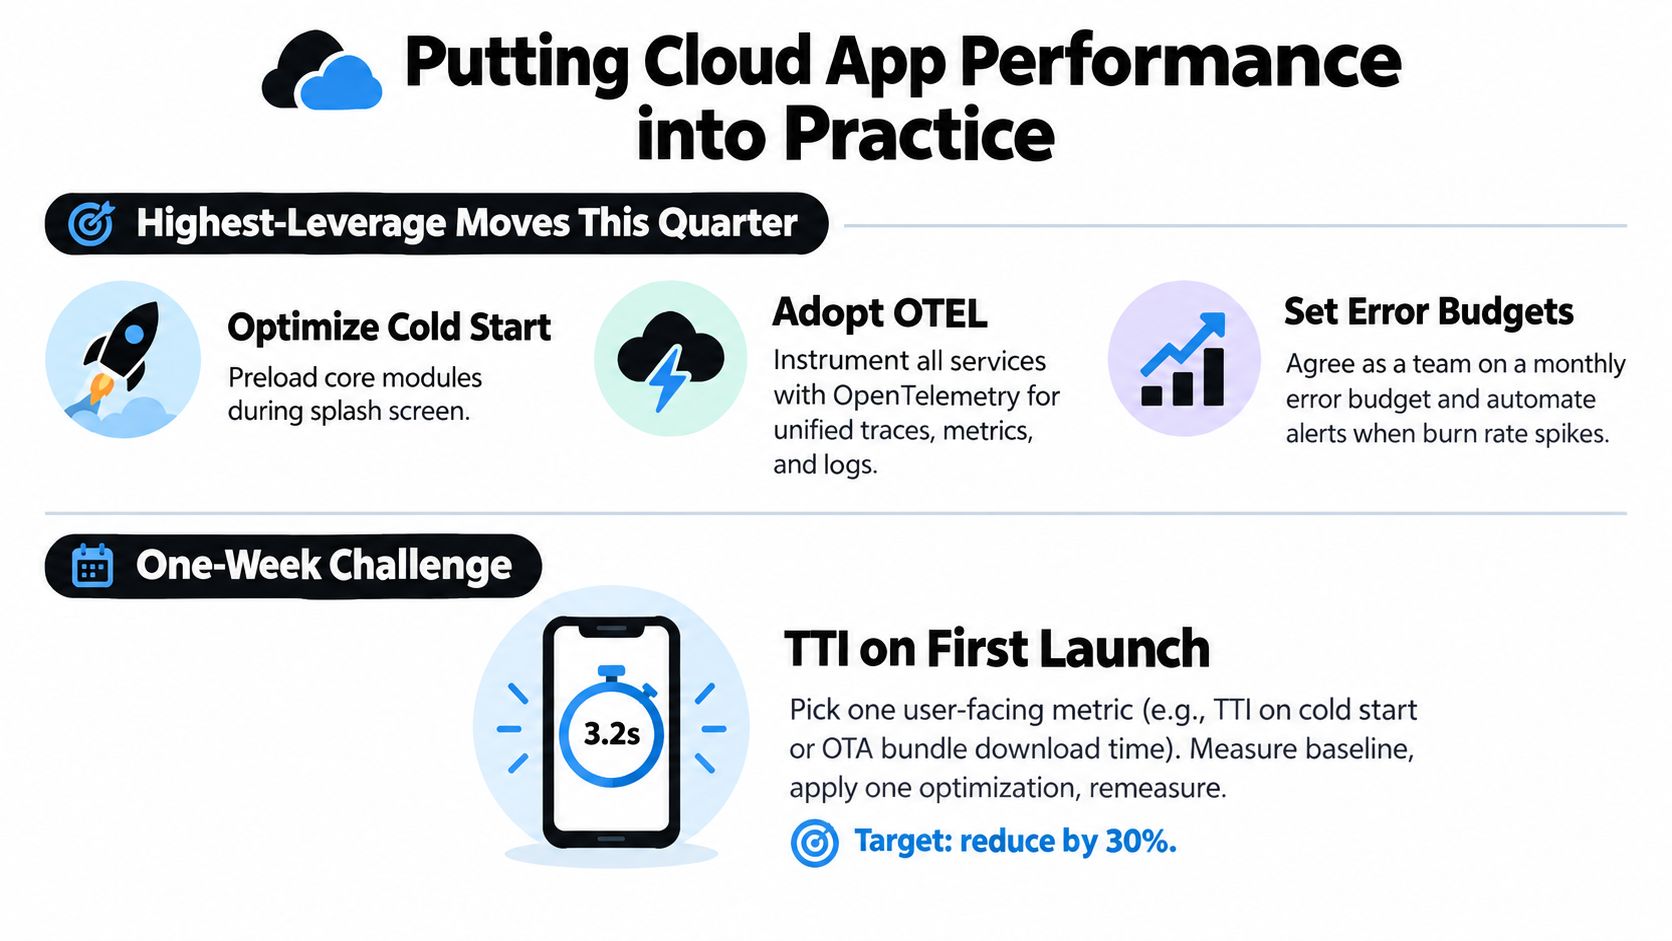
Qué priorizaría este trimestre
Empieza por lo que reduzca más rápido el impacto de los incidentes:
- Valida el comportamiento del edge cache: Asegúrate de que la frescura del manifest y la invalidación del bundle funcionen según tu runbook.
- Audita el tamaño del bundle y coste de startup: Tanto la velocidad de entrega como la de evaluación son clave.
- Crea dashboards de P95 para el flujo de updates: No te quedes solo en los promedios.
- Monitoriza el error budget burn por canal: La fiabilidad y la velocidad de release deben compartir el mismo scoreboard.
- Escribe el runbook de rollback: Incluye triggers, responsables y pasos de comunicación.
Si necesitas un ejemplo real de herramienta en esta categoría, Capgo es una opción para equipos de Capacitor y Electron que necesitan actualizaciones en vivo firmadas, control de despliegue por canales, logs por dispositivo y soporte de rollback, todo entregado a través de una red edge global. La parte importante no es el nombre del proveedor. Es elegir un flujo de trabajo donde puedas publicar, observar y revertir una actualización sin esperar a la revisión de la tienda cuando el problema está en el code servido desde la web.
La medición disciplinada supera a la ingeniería heroica. Es mejor mover una métrica visible en una semana que pasar un trimestre puliendo cifras de backend que nunca cambian lo que experimentan los usuarios.
Si tu equipo publica apps de Capacitor y quiere un control más estricto sobre la entrega de live update, la observabilidad, los despliegues escalonados y la seguridad del rollback, Capgo está diseñado para ese flujo de trabajo. Te permite entregar actualizaciones firmadas de JavaScript, CSS, configuración y assets fuera de la revisión de la tienda, y luego rastrear la adopción y los fallos con suficiente detalle para que el rendimiento de la app en la nube sea operativo en lugar de teórico.


