
Rabu pukul 09.12 pagi, tim mobile Anda menemukan bug checkout di production. Web bisa memperbaikinya dengan cepat. iOS dan Android tidak bisa, setidaknya tidak melalui review store. Support mulai mengumpulkan tiket, product meminta update status, dan engineering berusaha menjawab tiga pertanyaan berbeda sekaligus: seberapa cepat kita bisa ship perbaikan, seberapa cepat pengguna menerimanya, dan seberapa cepat kita bisa membuktikan bahwa perbaikannya berhasil?
Di situlah performa aplikasi cloud berhenti menjadi topik backend abstrak dan berubah menjadi topik rilis. Bagi tim mobile hybrid yang mengirim bundle JavaScript, config, copy, dan pembaruan aset di luar store, performa bukan sekadar “apakah API cepat?” Melainkan apakah jalur distribusi Anda bisa mempublikasikan, merutekan, mengunduh, memvalidasi, menerapkan, mengamati, dan jika perlu, melakukan rollback pembaruan saat pengguna masih berada dalam radius dampak.
Jika Anda bekerja dengan Capacitor, Ionic, atau stack hybrid lainnya, ini mengubah cara Anda berpikir tentang pekerjaan performa. Manifest fetch yang macet, edge cache yang menyajikan bundle lama, atau trace yang tidak bisa mengidentifikasi di mana hotfix gagal, semuanya menjadi bagian dari sistem yang sama. Pengalaman aplikasi dan mekanisme rilis saling terhubung.
Table of Contents
- Tim Mobile yang Gagal Merilis Perbaikan
- Apa Sebenarnya Arti Performa Cloud App
- Anatomi Latensi pada Aplikasi Berbasis Cloud
- Edge Networks dan Pengiriman CDN untuk Update Mobile
- Metrik yang Penting Selain Rata-rata Waktu Respons
- Observability untuk Aplikasi Cloud Tanpa Data Swamp
- SLA, Error Budget, dan Rollout Berbasis Channel
- Menerapkan Cloud App Performance secara Praktis
Tim Mobile yang Gagal Merilis Perbaikan
Tim yang sering saya temui di lapangan seperti ini: satu mobile lead, dua app engineer, satu backend engineer, satu product manager, dan tim support yang meneruskan screenshot dari user yang marah. Bug-nya sederhana. Ketidakcocokan harga membuat checkout gagal setelah feature flag diaktifkan. Perbaikannya juga sederhana. Yang membuat frustrasi adalah delivery-nya.
Native shell tidak perlu diubah. JavaScript bundle-nya yang perlu diubah. Jika tim hanya mengandalkan submission ke app store, mereka kini menunggu proses yang tidak bisa mereka kontrol. Selama menunggu, setiap percakapan makin buruk. Support bertanya siapa yang terdampak. Product bertanya kapan exposure menurun. Engineering bertanya apakah user benar-benar sampai ke path code yang sudah diperbaiki.
Penundaan bukan hanya soal coding
Pertama, pandang ini sebagai bottleneck rilis. Itu sebagian benar. Namun masalah yang lebih dalam adalah performa berbasis cloud di seluruh jalur update.
Agar live update bisa membantu, beberapa hal harus berjalan dengan benar:
- Perangkat harus dapat menjangkau layanan update: Jika permintaan manifest lambat atau gagal secara intermiten, pengguna akan tetap berada di versi yang rusak lebih lama.
- Edge harus menyajikan file yang tepat: Jika invalidasi cache tertunda, satu negara mungkin sudah mendapatkan perbaikan sementara negara lain masih mengunduh aset yang usang.
- The app must verify and apply safely: Bundle bertanda tangan, penargetan channel, dan aturan rollback sama pentingnya dengan kecepatan semata.
- Tim harus memantau adopsi: Merilis perbaikan tanpa melihat siapa yang menerimanya hanyalah bentuk menebak yang lebih rumit.
Aturan praktis: Hotfix mobile baru dianggap “dirilis” setelah perangkat terdampak benar-benar mengunduh dan menerapkannya.
Itulah mengapa performa cloud app sangat krusial untuk live update. Anda tidak hanya mengoptimalkan waktu respons server, tetapi juga waktu pemulihan insiden untuk perangkat nyata di jaringan yang tidak stabil, di berbagai wilayah, dengan versi app yang berbeda-beda.
Pertanyaan yang lebih tepat: apakah aplikasinya cepat
Saat tim membahas performa pasca-insiden, mereka sering bertanya apakah app terasa lambat. Pertanyaan yang lebih berguna adalah apakah sistem pengiriman cukup cepat untuk mengubah user experience sebelum insiden itu meluas.
Untuk hybrid app, jalur rilis adalah bagian dari produk. Jika tim Anda bisa mempublikasikan bundle perbaikan dengan cepat, menargetkan channel dengan aman, dan memverifikasi adopsi dengan yakin, performa menjadi soal operasional. Ini langsung berdampak pada beban support, perlindungan revenue, dan seberapa besar kepercayaan product ke engineering saat terjadi outage.
Apa Sebenarnya Arti Performa Cloud App
Saat tim mobile mendengar “performance”, mereka biasanya membayangkan load time. Padahal itu hanya salah satu bagiannya. Performa cloud app adalah kombinasi dari empat kualitas yang bekerja bersama: latency, throughput, availability, dan consistency.
Cara yang baik untuk menjelaskan ini adalah lewat analogi toko.
Empat kualitas yang benar-benar bisa Anda analisis
Latensi adalah waktu tunggu di kasir. Anda memesan sesuatu dan menghitung berapa lama waktu yang dibutuhkan untuk mendapatkan jawaban.
Throughput adalah berapa banyak pelanggan yang bisa dilayani dengan baik sekaligus. Satu kasir cepat tidak cukup jika antrean langsung terbentuk saat lalu lintas melonjak.
Ketersediaan adalah apakah tokonya buka atau tidak. Respons yang tidak pernah tiba bukanlah keberhasilan yang lambat. Itu adalah interaksi yang gagal.
Konsistensi adalah apakah setiap kasir melihat tingkat stok dan harga yang sama. Jika satu kasir mengatakan item ada dan yang lain mengatakan tidak, pelanggan mengalami kebingungan, bukan sekadar penundaan.
Benchmark historis membantu memetakan istilah pertama dan ketiga. Analisis CloudOps melaporkan rata-rata global sebesar 426,4 milidetik untuk menyelesaikan permintaan HTTP dan menerima respons, dengan ketersediaan rata-rata 97.69% according to Google Cloud Observability. Kedua angka ini penting karena pengguna merasakan baik penundaan maupun downtime, bahkan ketika layanan “sebagian besar aktif.”
Mengapa pengiriman update mobile bergantung pada keempatnya
Untuk Live Update, latensi adalah waktu untuk mengambil manifest dan bundle. Throughput adalah apakah layanan masih berfungsi saat lonjakan banyak perangkat memeriksa pembaruan saat peluncuran. Ketersediaan adalah apakah perangkat dapat mencapai endpoint pembaruan selama insiden. Konsistensi adalah apakah perangkat di lokasi berbeda mendapatkan channel rilis dan set aset yang sama.
Arsitektur aplikasi mulai menjadi penting. Jika Anda memetakan komponen antara aplikasi code, penyimpanan, CDN, logika edge, dan channel rilis, panduan praktis tentang infrastruktur aplikasi mobile membantu menghubungkan pipeline pengiriman dengan pengalaman pengguna.
Kebingungan yang umum
Tim sering mengeluhkan keempatnya sekaligus: “pembaruan lambat.” Tapi itu kegagalan yang berbeda dengan pemilik yang berbeda.
- Latensi tinggi: permintaan berhasil, tetapi pengguna menunggu
- Throughput rendah: permintaan menumpuk saat lonjakan
- Ketersediaan buruk: layanan tidak dapat dijangkau
- Konsistensi lemah: user menerima state yang tidak sinkron atau versi usang
Jika Anda memisahkan keempat hal tersebut sejak awal, review insiden akan jauh lebih tajam. Anda tidak lagi berdebat soal "jaringan" dan mulai mengidentifikasi layer mana yang sebenarnya gagal.
Bagi tim mobile, perbedaan ini sangat penting karena sistem update adalah sistem multi-step. Sebuah bundle bisa saja kecil, sudah di-sign, dan benar, namun tetap sampai ke user terlalu lambat jika salah satu kualitas tersebut menurun.
Anatomi Latensi pada Aplikasi Berbasis Cloud
Delay yang dirasakan user jarang sekali disebabkan oleh satu hal saja. Ini adalah tumpukan waktu tunggu kecil yang terakumulasi. Saat hybrid app mengecek live update, user tidak melihat DNS, TLS, perjalanan jaringan, manifest generation, signature validation, file download, disk write, dan JavaScript evaluation sebagai kejadian terpisah. Mereka hanya merasakan satu jeda.
Itulah mengapa penanganan latensi harus diperlakukan seperti sebuah budget.
Dari mana waktu tunggu berasal
Layer pertama adalah setup koneksi. DNS resolution dan TLS handshake sering kali terjadi sebelum logika aplikasi Anda berjalan. Kemudian ada network round trip ke delivery point terdekat. Setelah itu, backend atau edge logic masih harus memutuskan manifest dan bundle mana yang harus diterima perangkat ini. Terakhir, perangkat harus unpack dan mengevaluasi apa yang telah di-download.
Gunakan ini sebagai model kerja:
| Lapisan | Rentang Tipikal (ms) | Faktor Optimasi |
|---|---|---|
| Konfigurasi DNS dan TLS | 50 hingga 150 | Penggunaan ulang koneksi, HTTP keep-alive, TLS session resumption |
| RTT jaringan ke titik pengiriman | 10 hingga 80 | Penempatan regional, routing CDN, hit rate cache edge |
| Pemrosesan origin atau edge | 20 hingga 300 | Pembuatan manifest ringkas, metadata yang sudah dihitung, lookup storage lebih cepat |
| Apply dan render di sisi perangkat | 100 hingga 600 | Bundle lebih kecil, JS engine yang sudah siap, beban startup lebih ringan |
Jika Anda ingin mendalami bagian jaringan secara spesifik, penjelasan tentang latensi jaringan dalam pengiriman aplikasi ini berguna bagi non-spesialis jaringan di tim mobile.
Geografi membantu, tapi tidak berdiri sendiri
Sebuah studi jangkauan yang banyak dikutip menemukan bahwa mayoritas populasi dunia dapat mengakses fasilitas cloud dalam waktu 100 milidetik, yang membantu menjelaskan mengapa deployment regional menjadi inti strategi performa, seperti dirangkum dalam diskusi jangkauan cloud ini. Itu menggembirakan, tapi bukan berarti setiap user otomatis mendapat jalur update yang cepat.
Studi lain memperjelas jebakan ini. Situs edge bisa mengurangi latensi jaringan, tetapi resource yang terbatas di edge dapat menimbulkan queueing delay, sehingga dalam beberapa kasus cloud justru lebih cepat secara keseluruhan, menurut analisis latensi edge versus cloud.
Apa yang harus di-tuning tim mobile lebih dulu
Mulailah dengan layer yang paling mudah diubah tanpa harus menulis ulang app:
- Lakukan caching manifest di edge dengan hati-hati: TTL yang pendek dan invalidasi eksplisit biasanya lebih aman daripada berharap propagasi berjalan sempurna selama hotfix.
- Precompute metadata rilis: Jangan build manifest yang kompleks di setiap request jika data channel, version, dan signature bisa disiapkan sebelumnya.
- Kurangi pekerjaan saat startup aplikasi: Bundle yang diunduh cepat tapi butuh waktu lama untuk dievaluasi tetap terasa lambat.
- Gunakan ulang koneksi jika memungkinkan: Biaya setup berulang menambah hambatan yang terasa di jaringan mobile yang tidak stabil.
“Unduhan bundle yang cepat” tidak menjamin update yang cepat. Pengguna hanya peduli kapan code baru benar-benar siap dijalankan.
Edge Networks dan Pengiriman CDN untuk Update Mobile
Satu region cloud bisa bekerja dengan baik untuk tool internal atau aplikasi satu negara. Namun ini makin sulit dipertahankan saat basis pengguna tersebar di berbagai benua dan Anda perlu hotfix yang cepat sampai. Untuk pengiriman update mobile, desain edge dan CDN menentukan siapa yang menerima byte pertama dengan cepat, siapa yang mendapatkan konten usang, dan siapa yang fallback ke origin tepat di saat yang salah.
Tiga model pengiriman yang biasa dipertimbangkan tim
Model paling sederhana adalah pengiriman origin terpusat. Perangkat mengambil manifest dan bundle dari satu region. Ini mudah dioperasikan, mudah dipahami, dan sering kali sudah cukup di awal.
Langkah selanjutnya adalah pengiriman regional. Anda menempatkan penyimpanan atau logika aplikasi di beberapa wilayah utama dan mengarahkan pengguna ke wilayah terdekat. Ini mengurangi jarak transit bagi banyak pengguna dan mendistribusikan beban dengan lebih baik.
Then there’s pengiriman edge. Bundle statis di-cache di dekat pengguna, dan logika ringan di edge dapat menulis ulang manifest, merutekan channel, atau melakukan pemeriksaan terkait tanda tangan sebelum permintaan mencapai origin.
Berikut perbandingan praktisnya:
| Model | P50 First Byte Tipikal | Usaha Invalidation Cache | Paling Cocok |
|---|---|---|---|
| Wilayah cloud terpusat | Lebih tinggi untuk pengguna jauh | Rendah | Footprint kecil, frekuensi rilis rendah |
| Deployment regional | Menengah | Menengah | Aplikasi multi-region dengan klaster pengguna yang dapat diprediksi |
| Pengiriman edge dengan CDN dan logika edge | Terendah saat cache hit sehat | Tinggi | Aplikasi global, pembaruan sering, rilis yang sensitif terhadap insiden |
Untuk tim yang mengevaluasi mekanismenya, panduan ini membahas jaringan edge dalam pengiriman aplikasi memberikan model mental yang tepat.
Bagian yang sering diremehkan tim
Cache invalidation terdengar seperti masalah yang sudah terpecahkan sampai ada fix kritis yang dirilis. Lalu edge menyajikan manifest kemarin di satu wilayah, manifest hari ini di wilayah lain, dan support menerima laporan bahwa “fix-nya hanya berfungsi untuk sebagian pengguna.”
Itu bukan sekadar gangguan teoretis. Itu masalah integritas rilis.
Sebuah tesis tentang penempatan edge menemukan bahwa memindahkan compute lebih dekat ke pengguna sering kali hanya meningkatkan akses latensi sebesar sekitar 6% hingga 30%, dan juga mencatat bahwa jalur jaringan alternatif bisa melampaui rute yang secara nominal lebih lokal sebesar hingga 40%, yang berarti kualitas routing dan peering bisa sama pentingnya dengan kedekatan fisik pada bagian akhir pengalaman pengguna, menurut ini tesis performa edge berskala besar ini.
Matriks keputusan untuk tim mobile
Gunakan kriteria ini saat memilih tier pengiriman update Anda:
- Distribusi pengguna: Jika pengguna terkonsentrasi di satu negara, pengiriman terpusat atau regional mungkin sudah cukup.
- Frekuensi rilis: Tim yang sering merilis lebih diuntungkan oleh edge caching, tetapi juga mewarisi disiplin cache yang lebih ketat.
- Biaya hotfix: Jika bundle usang selama insiden menimbulkan biaya besar, siapkan invalidasi dan rollback eksplisit sebelum Anda membutuhkannya.
- Toleransi operasional: Logika edge menambah kekuatan, tetapi juga lebih banyak titik rawan bug routing, penanganan signature mismatch, dan kejutan spesifik geo.
Jawaban yang tepat bukan “selalu gunakan edge.” Jawabannya adalah menyesuaikan arsitektur pengiriman dengan kecepatan dan blast radius yang dibutuhkan proses rilis Anda.
Metrik yang Penting Selain Rata-rata Waktu Respons
Waktu respons rata-rata berguna untuk dashboard, tetapi hampir tidak berguna saat membahas masalah yang dialami pengguna. Pengguna mobile tidak merasakan request rata-rata. Mereka merasakan request-nya sendiri, di perangkatnya, di jaringannya, saat membuka aplikasi setelah Anda merilis hotfix.
Itulah sebabnya tail metrics lebih penting.
Tiga tampilan yang akan saya tunjukkan ke PM
Mulai dengan latensi cold start dan warm start di P95 dan P99. Cold start menunjukkan apa yang terjadi saat aplikasi diluncurkan dari awal dan memeriksa update tanpa state warm yang membantu. Warm start menunjukkan seberapa banyak friksi yang tersisa setelah aplikasi sudah melakukan beberapa pekerjaan.
Di bawahnya, lacak Apdex dengan threshold yang diyakini tim mobile Anda. Threshold yang mungkin terasa wajar untuk web desktop bisa salah untuk jalur startup aplikasi hybrid.
Kemudian lacak pembakaran error budget. Ini menggeser percakapan dari “apakah alert terpicu?” menjadi “seberapa cepat kami menghabiskan ruang reliabilitas yang kami sepakati untuk dipakai?”
Berikut visual ringkas yang layak dibagikan di review mingguan:
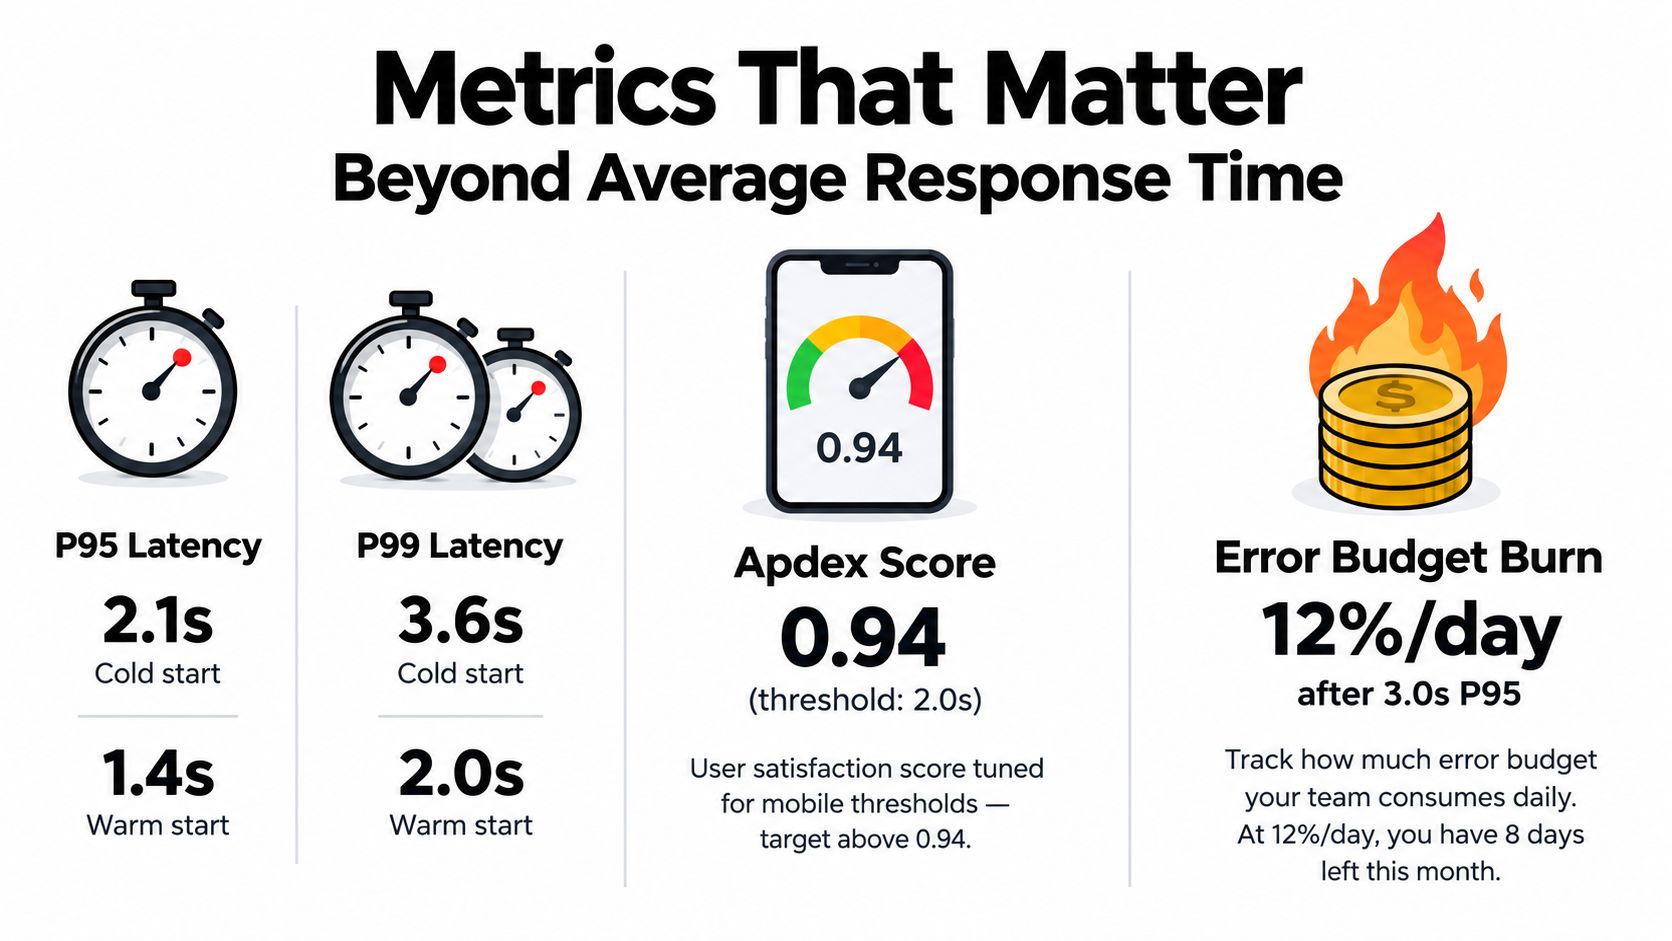
Metrik yang menghubungkan performa dengan hasil rilis
Tambahkan satu metrik spesifik pengiriman yang sering tidak dibutuhkan tim web: tingkat adopsi per release channel. Jika bundle yang sudah dipublikasikan belum diadopsi oleh perangkat yang terdampak (masih di versi sebelumnya), itu adalah masalah performa sekaligus pengiriman.
Segmentasikan metrik Anda berdasarkan:
- Kelas perangkat: Ponsel lama sering kali pertama kali mengungkapkan biaya startup dan evaluasi.
- Jenis jaringan: Wi-Fi bisa menyembunyikan desain bundle buruk yang langsung terlihat saat pakai data seluler.
- Versi aplikasi: Beberapa kegagalan bersifat spesifik versi, terutama terkait perilaku bridge atau logika migrasi.
Video ini cocok sebagai pendamping jika tim Anda perlu pengingat praktis tentang cara menafsirkan telemetri performa, bukan sekadar menatap angka rata-rata:
Satu peringatan tentang membaca noise
Tidak semua perubahan kecil pada performa cloud app itu berarti. Sebuah studi longitudinal besar pada 2.366 benchmark aktif 789 cluster AWS Kubernetes menemukan variabilitas keseluruhan di bawah 3.7%, dengan efek halus terkait waktu dalam sehari dan akhir pekan, menurut studi variabilitas performa cloud ini. Ini pengingat agar tidak bereaksi berlebihan terhadap fluktuasi kecil, namun tetap serius menangani tail regression.
Jangan tanya apakah performa cloud itu acak. Cari tahu seperti apa noise pengukuran normal pada sistem Anda, lalu buat alert jika ada perubahan yang melampauinya.
Observability untuk Aplikasi Cloud Tanpa Data Swamp
Banyak engineer punya telemetry, tapi sering kali tidak bisa menjawab pertanyaan on-call dengan cepat. Untuk hybrid mobile updates, pertanyaannya biasanya spesifik: kenapa device ini masih pakai bundle lama, kenapa bundle baru gagal diterapkan, atau kenapa startup jadi lebih lambat setelah rilis?
Traces, logs, dan metrics itu perlu. Tapi sering kali tidak cukup.
Bangun stack di sekitar satu jalur rilis
Stack observabilitas yang praktis untuk performa aplikasi cloud harus memungkinkan Anda mengikuti satu percobaan update dari perangkat ke backend dan kembali lagi.
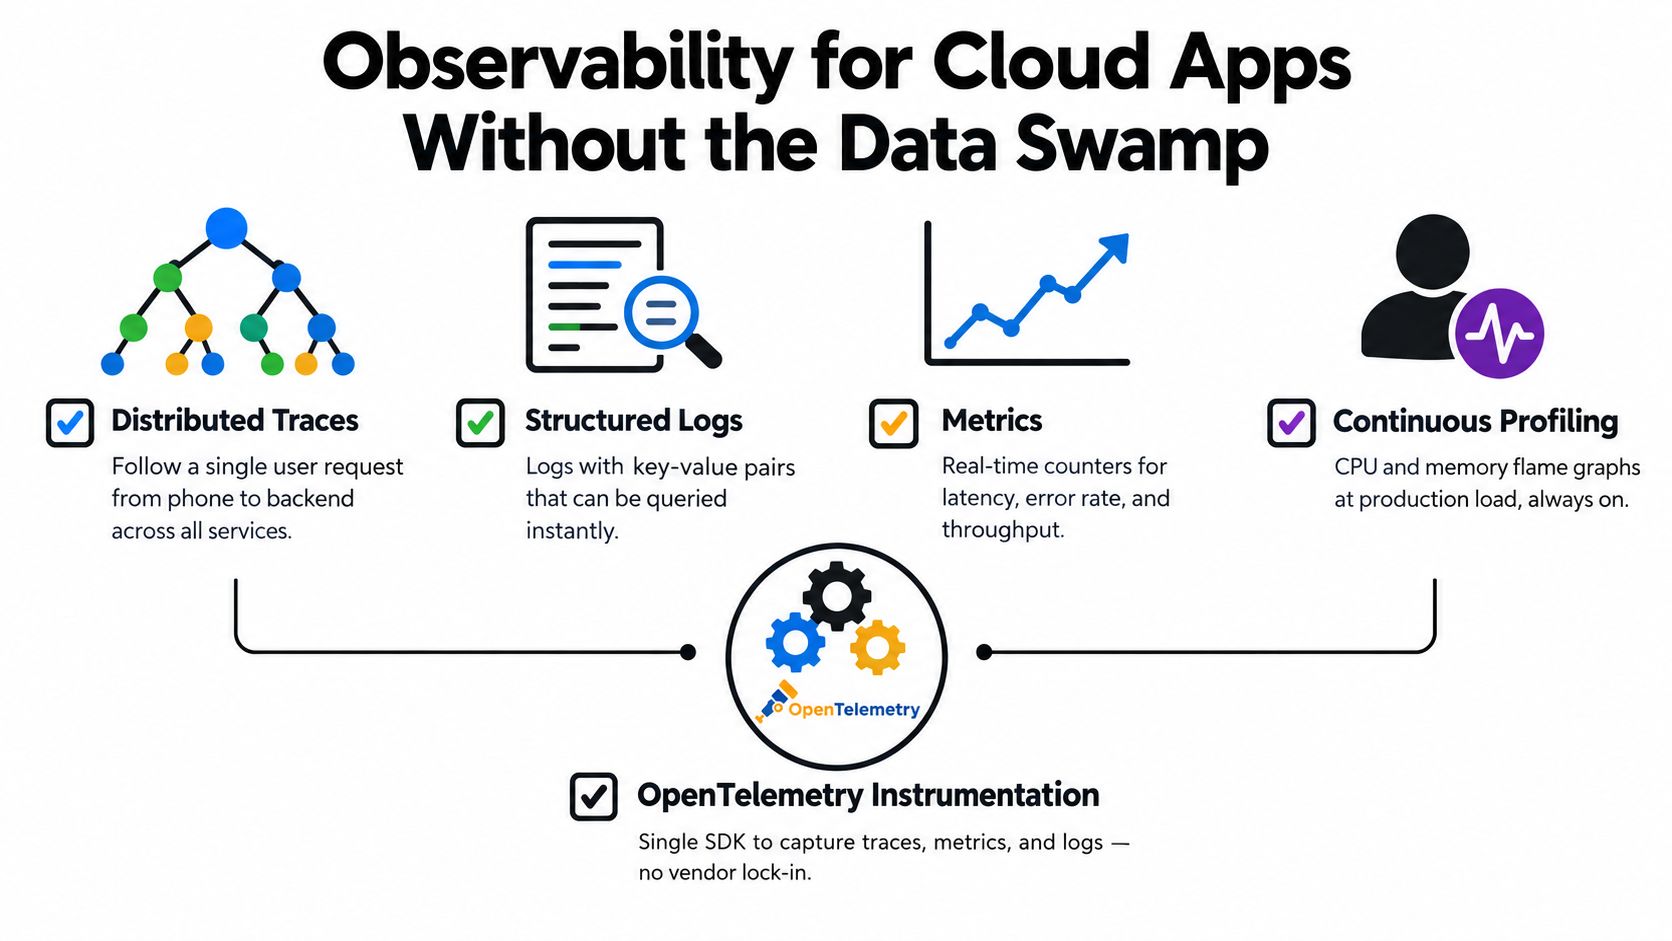
Beri instrumentasi mobile bridge dan update client dengan OpenTelemetry tag untuk versi aplikasi, release channel, platform, dan hasil update. Strukturkan logs agar Anda bisa query satu update ID atau satu sesi perangkat tanpa fuzzy text search. Fokuskan metrik pada latency, error rate, adoption, dan event rollback.
Bagi tim yang menstandarkan komponen ini, ringkasan tentang observabilitas aplikasi untuk app yang sudah rilis adalah referensi implementasi yang baik.
Sinyal keempat yang hilang
Salah satu perubahan paling berguna dalam panduan APM modern adalah gagasan bahwa traces, metrik, dan logs masih menyisakan celah diagnosis. Continuous profiling kini semakin dianggap sebagai sinyal keempat karena menunjukkan fungsi persis yang mengonsumsi CPU, memori, atau lock time, seperti dijelaskan dalam panduan application performance monitoring dan profiling ini.
Hal ini penting dalam workflow live update. Sebuah trace mungkin menunjukkan bahwa “apply update” memakan waktu terlalu lama. Profiling dapat menunjukkan apakah bottleneck terjadi pada dekompresi bundle, parsing JSON, inisialisasi bridge, atau lock pada startup path.
Pastikan sistem tetap mudah dibaca jam 2 pagi
Gunakan set tampilan yang ringkas dan disiplin:
- Dashboard release channel: adopsi, kegagalan, jumlah rollback
- Trace transaksi update: dari fetch manifest hingga evaluasi bundle
- Regresi startup teratas: dikelompokkan berdasarkan versi app dan platform
- Tampilan profiling: fungsi paling berat saat update apply dan first render
Jika tim Anda sedang menyempurnakan model operasi DevOps dan SRE yang lebih luas seputar workflow ini, akan berguna untuk lihat bagaimana nexus IT group menerapkan devops karena studi kasus ini membingkai observability sebagai praktik operasional, bukan sekadar pembelian alat.
Dashboard terbaik adalah yang benar-benar dibuka, dipahami, dan ditindaklanjuti oleh engineer on-call sebelum tim support menulis ringkasan insiden untuk mereka.
SLA, Error Budget, dan Rollout Berbasis Channel
Bahasa SLA terdengar rapi di kontrak, tapi berantakan di produksi. Tim mobile biasanya menyadarinya saat rilis bermasalah. “High availability” terasa menenangkan sampai Anda harus memutuskan apakah tetap mengirim update sementara pengguna di satu wilayah tidak bisa mengambil bundle terbaru.
Ubah target ketersediaan menjadi kebijakan rilis
Gunakan target ketersediaan untuk mendefinisikan tahap rollout, bukan hanya janji kepada pelanggan.
| Target Ketersediaan | Anggaran Downtime Bulanan | Tahap Rollout yang Sesuai |
|---|---|---|
| 99% | Sekitar 7 jam 18 menit | Channel internal dan eksperimental |
| 99.9% | Sekitar 43 menit | Beta dan rollout produksi bertahap |
| 99.99% | Sekitar 4 menit 23 detik | Produksi luas untuk jalur bisnis kritis |
Anggaran downtime tersebut berasal dari perhitungan bulanan sederhana. Namun, dalam praktiknya, angka ini menyusut setelah memperhitungkan seluruh rantai pengiriman. Origin Anda mungkin sehat, tetapi masalah DNS, propagasi edge, atau aturan channel yang salah tetap bisa mencegah perangkat menerima rilis yang dimaksud.
Jika Anda membutuhkan contoh konkret tentang bagaimana platform update membingkai hal ini secara operasional, tinjau service level agreement Capgo dan bandingkan dengan asumsi insiden Anda sendiri.
Error budget adalah tempat produk dan reliabilitas akhirnya bertemu
Error budget memberikan struktur izin bagi tim. Jika burn rate stabil, Anda bisa menerima sedikit risiko rilis. Jika burn rate melonjak setelah hotfix, tunda promosi ke channel berikutnya.
Ladder rollout yang kuat untuk aplikasi hybrid biasanya terlihat seperti ini:
- Internal: insinyur memvalidasi bahwa manifest, signature, dan alur apply berperilaku sesuai harapan
- Beta: pengguna dan tester yang ramah menangkap kegagalan pada perangkat edge
- Produksi bertahap: audiens terbatas menerima bundle terlebih dahulu
- Produksi penuh: update menjadi target channel default
Disiplin yang sama berlaku baik Anda menggunakan feature flags, pembaruan JavaScript over-the-air, atau keduanya.
Atur trigger rollback sebelum dibutuhkan
Aturan rollback harus eksplisit dan membosankan. Jangan mengimprovisasi saat insiden.
Pemicu yang berguna meliputi:
- Adopsi terhenti secara tak terduga: perangkat melakukan check-in tetapi tidak beralih ke bundle baru
- Latensi startup memburuk drastis pada pengguna tail: terutama perangkat lama atau jaringan lemah
- Gagal apply terkonsentrasi di satu platform atau versi: often a bridge or packaging mismatch
- Pemantauan pengguna nyata menunjukkan pengalaman menurun: cek sintetis bisa melewatkan masalah spesifik mobile
Komunikasikan pelanggaran dalam bahasa sederhana. Sebutkan apa yang gagal, siapa yang terdampak, channel mana yang dijeda, rollback apa yang terjadi, dan kapan titik keputusan berikutnya. Stakeholder tidak butuh dump telemetri. Mereka butuh kejelasan operasional.
Menerapkan Cloud App Performance secara Praktis
Cara tercepat untuk meningkatkan performa cloud app adalah berhenti memperlakukannya sebagai proyek infrastruktur demi gengsi. Pengguna tidak peduli dengan cache hit ratio Anda kecuali itu mengubah apa yang mereka rasakan. Tim produk tidak peduli dengan CPU origin kecuali itu mengubah seberapa cepat perbaikan mencapai perangkat yang terdampak.
Pilih satu metrik yang terlihat oleh pengguna minggu ini dan buatlah nyata.
Tantangan satu minggu yang layak dicoba
Pilih metrik dengan dampak pengguna yang jelas. Opsi yang baik termasuk waktu hingga interaktif saat peluncuran pertama setelah update check, atau waktu download update bundle untuk pengguna paling lambat di production channel.
Lalu lakukan empat hal ini:
- Ukur baseline: Gunakan real user monitoring, bukan hanya synthetic checks.
- Lakukan satu perubahan yang ditargetkan: Misalnya, perkecil ukuran bundle, precompute manifest output, atau perketat aturan edge caching.
- Ship melalui staged channel: Pantau adopsi dan kegagalan sebelum rollout luas.
- Ukur ulang metrik yang sama: Jika hasil yang terlihat oleh pengguna tidak membaik, optimasi tersebut tidak terlalu bernilai.
Checklist ini menangkap urutan prioritas yang tepat untuk sebagian besar tim mobile:
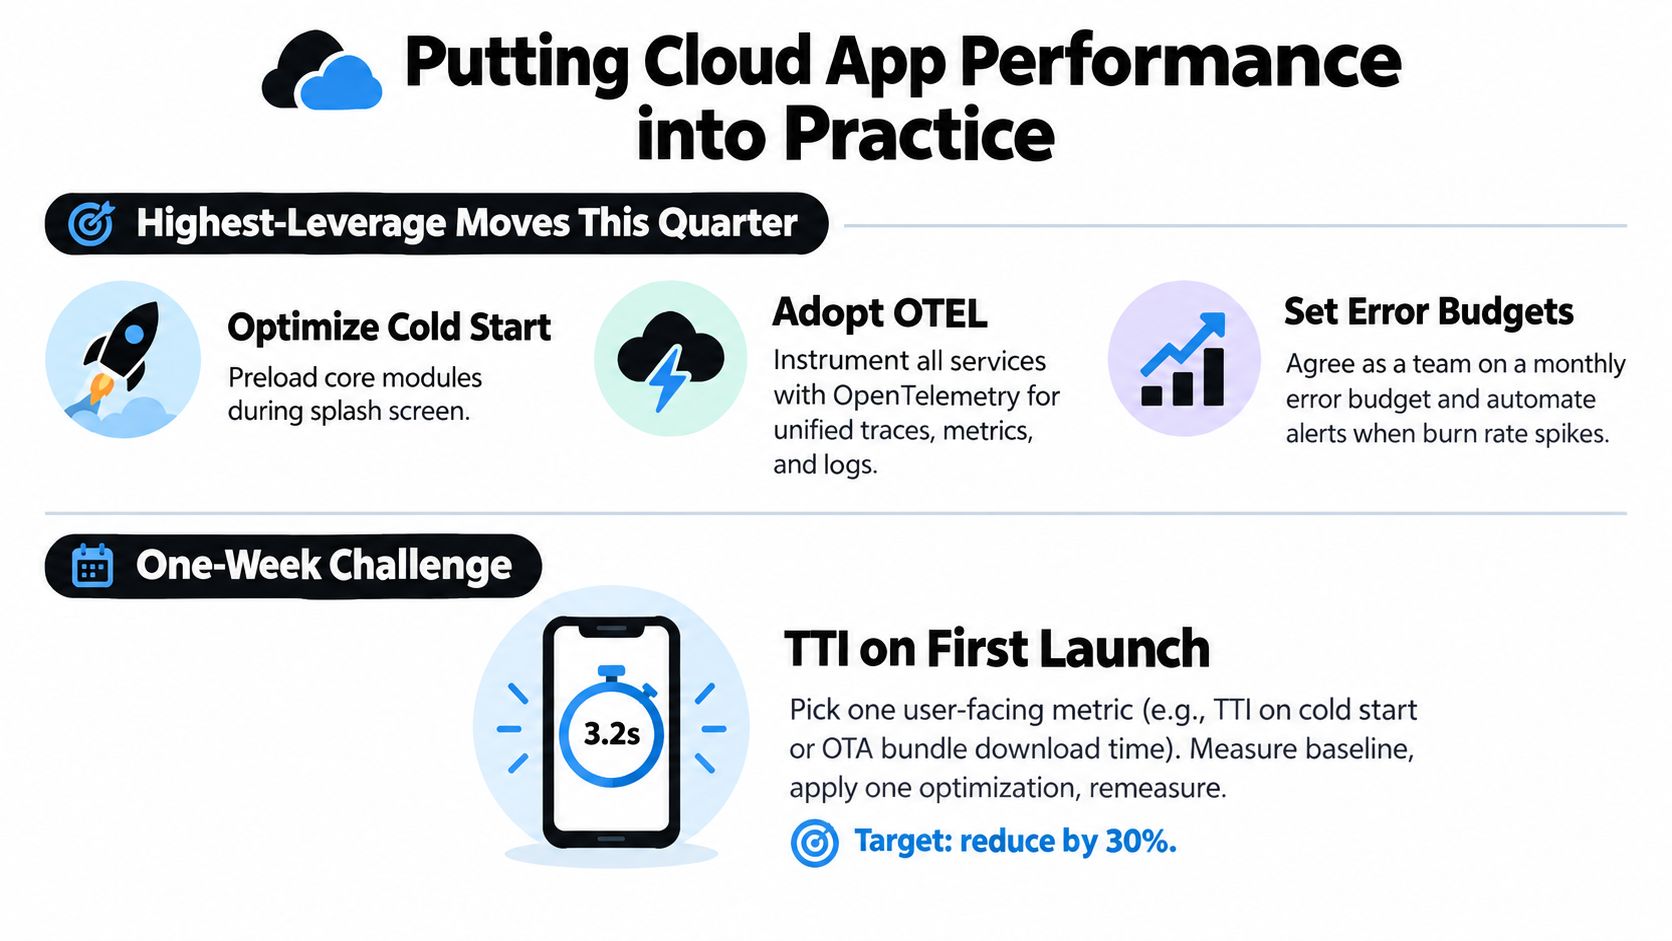
Apa yang akan saya prioritaskan kuartal ini
Mulai dari pekerjaan yang paling cepat mengurangi dampak insiden:
- Validasi perilaku edge cache: Pastikan kesegaran manifest dan invalidasi bundle berjalan sesuai asumsi runbook Anda.
- Audit ukuran bundle dan biaya startup: Kecepatan delivery dan kecepatan evaluasi sama-sama penting.
- Buat dashboard P95 untuk alur update: Jangan hanya terpaku pada angka rata-rata.
- Pantau error budget burn per channel: Reliability dan kecepatan rilis harus berada dalam satu scoreboard yang sama.
- Tulis runbook rollback: Sertakan trigger, owner, dan langkah-langkah komunikasi.
Jika Anda butuh contoh tool nyata di kategori ini, Capgo adalah salah satu opsi untuk tim Capacitor dan Electron yang membutuhkan live update bertanda tangan, kontrol rollout berbasis channel, log per-perangkat, dan dukungan rollback yang dikirimkan melalui jaringan edge global. Bagian pentingnya bukan nama vendor-nya. Melainkan memilih alur kerja di mana Anda bisa mempublikasikan, mengamati, dan membatalkan update tanpa menunggu review store ketika masalahnya ada di code yang dikirimkan via web.
Pengukuran yang disiplin lebih baik daripada rekayasa heroik. Lebih baik menggeser satu metrik yang terlihat dalam seminggu daripada menghabiskan satu kuartal untuk memoles angka backend yang tidak pernah mengubah pengalaman pengguna.
Jika tim Anda merilis aplikasi Capacitor dan ingin kontrol yang lebih ketat atas pengiriman live update, observabilitas, rollout bertahap, dan keamanan rollback, Capgo dibangun untuk alur kerja tersebut. Ia memungkinkan Anda mengirimkan update JavaScript, CSS, konfigurasi, dan aset yang ditandatangani di luar review store, lalu melacak adopsi dan kegagalan dengan cukup dekat untuk membuat performa aplikasi cloud menjadi operasional, bukan sekadar teoretis.


