
수요일 오전 9시 12분, 모바일 팀은 프로덕션에서 체크아웃 버그를 발견했습니다. 웹은 빠르게 패치를 적용할 수 있지만, iOS와 Android는 최소한 스토어 리뷰를 통해 패치를 적용할 수 없습니다. 지원 팀은 티켓을 수집하고, 제품은 상태 업데이트를 원하고, 엔지니어는 한 번에 세 가지 다른 질문에 답하려고 합니다: 패치를 얼마나 빨리 배포할 수 있나요, 사용자가 패치를 얼마나 빨리 받을 수 있나요, 패치가 성공적으로 작동했는지 얼마나 빨리 증명할 수 있나요?
클라우드 앱 성능이 추상적인 백엔드 주제에서 배포 주제로 변하는 곳입니다. 자바스크립트 번들을 포함한 구성, 복사본, 자산 업데이트 외 스토어를 통해 배포하는 모바일 팀에게 성능은 단순히 'API'이 빠른가요? 아니면 배포 경로가 업데이트를 사용자들이 여전히 영향을 받는 범위 내에서 발행, 라우팅, 다운로드, 유효성 검사, 적용, 관찰, 필요할 때 롤백할 수 있는지에 대한 문제인가요?
Capacitor에서 작업하는 팀, 이온IC, 또는 다른 하이브리드 스택에서 작업하는 팀에게는 성능 작업에 대한 생각이 달라집니다. 매니페스트를 가져올 때 멈추는 것, 에지 캐시가 이전 버전의 번들을 제공하는 것, 트레이스에서 핫픽스가 실패한 곳을 식별할 수 없는 것 모두가 같은 시스템의 일부가 됩니다. 앱 경험과 배포 메커니즘은 서로 연결되어 있습니다.
목차
- 성능이 느린 앱이 문제가 아니에요
- 클라우드 앱 성능이 실제로 무엇을 의미하는지
- 클라우드 백업 앱의 지연 시간 구조
- 모바일 업데이트에 대한 Edge 네트워크 및 CDN 전달
- 평균 응답 시간 이외의 성능에 대한 중요 메트릭
- 클라우드 앱 성능을 위한 관찰성
- SLA, 오류 예산, 채널 기반 롤아웃
- 클라우드 앱 성능을 실천하는 방법
배송을 못하는 모바일 팀
이 팀은 실무에서 여러 번 보았습니다. 모바일 리드 1명, 앱 엔지니어 2명, 백엔드 엔지니어 1명, 제품 매니저 1명, 그리고 화가 된 사용자로부터 스크린샷을 전달하는 지원 팀이 있습니다. 버그는 간단합니다. 가격 불일치로 체크아웃이 중단되며, 기능 플래그가 전환되면 체크아웃이 중단됩니다. 해결 방법도 간단합니다. 그러나 문제는 배포입니다.
자바스크립트 번들을 변경할 필요가 없습니다. native shell도 변경할 필요가 없습니다. 앱 스토어 제출에만 의존하는 팀은 이제 기다리는 프로세스에 의존하게 됩니다. 그 기다림 동안 모든 대화가 악화됩니다. 지원 팀은 영향을 받은 사용자에 대해 물어보고 제품 팀은 노출이 떨어질 때까지 기다립니다. 엔지니어 팀은 사용자가 고쳐진 code 경로에 도달하는지 여부를 물어봅니다.
배포 지연은 코드 작성만의 문제가 아닙니다.
첫 번째 프레임을 배포 지연으로 프레임으로 보세요. 그 부분은 사실입니다. 그러나 더 깊은 문제는 전체 업데이트 경로에서 cloud-delivered performance 여러 가지 조건이 맞아야 __CAPGO_KEEP_0__가 도움이 됩니다.
For a live update to help, several things must go right:
- 만약 매니페스트 요청이 느려지거나 중간 중간 실패하면 사용자는 더 오래 동안 깨진 버전을 사용하게 됩니다. 엣지 서버가 올바른 파일을 제공해야 합니다.
- 에지에서 올바른 파일을 제공해야 합니다. 앱이 안전하게 검증하고 적용해야 합니다.
- native_build_builder_credit_first 속성 파일, 채널 목표, 롤백 규칙은 raw 속도만큼 중요합니다.
- 팀은 수용을 관찰해야합니다. 수정 사항을 배포하지 않고 받은 사람을 보지 못하는 것은 단순히 복잡한 추측일 뿐입니다.
실용적인 규칙: 모바일 핫픽스는 실제로 다운로드 및 적용된 장치가 있는 경우에만 '배포'됩니다.
이것이 클라우드 앱 성능이 라이브 업데이트에서如此 중요하기 때문입니다. 서버 응답 시간만 최적화하는 것이 아니라, 실제 장치에서 불균형 네트워크를 통해, 다른 지역에서, 다른 앱 버전을 실행하는 동안, 장애 발생 시 사용자 경험을 변경할 수 있는지 여부를 최적화합니다.
앱이 느려졌는지 여부보다 더 좋은 질문은 앱이 느려졌는지 여부입니다.
팀이 성능에 대해 이야기할 때, 일반적으로 성능에 대해 이야기할 때, 앱이 느려졌는지 여부를 묻는 경우가 많습니다. 그러나 실제로 더 유용한 질문은 사용자 경험을 변경하기 전에 장애가 확산되기 전에 배달 시스템이 충분히 빠른지 여부입니다.
하이브리드 앱의 경우, 배포 경로는 제품의 일부입니다. 팀이 수정된 패키지를 빠르게 배포할 수 있고, 안전한 채널을 목표로 하며, 신뢰할 수 있는 수용을 확인할 수 있다면, 성능은 운영에 영향을 미칩니다. 이는 직접적으로 지원 부하, 수익 보호, 그리고 장애 발생 시 엔지니어링에 대한 제품의 신뢰도에 영향을 미칩니다.
클라우드 앱 성능이 무엇을 의미하는지
모바일 팀이 '성능'을 들으면, 일반적으로 로드 타임을 떠올립니다. 그러나 이것은 그것만입니다. 클라우드 앱 성능 는 네 가지 품질이 함께 작동하는 조합입니다: 지연 시간, 처리량, 가용성 및 일관성.
이것을 가르치는 좋은 방법은 상점 analogy를 빌리기이다.
실질적으로 논리할 수 있는 네 가지 품질
지연 시간 카운터에서 기다리는 시간입니다. 어떤 것을 요청하고 응답이 돌아오기까지 얼마나 오랜 시간이 걸리는지 계산합니다.
처리량 상점이 한 번에 한 번씩 깨끗하게 고객을 처리할 수 있는 고객 수입니다. 한 번에 빠른 카운터만 있으면, 고객이 증가할 때 줄이 바로 형성된다면 충분하지 않습니다.
가용성 상점이 열려 있는지 여부입니다. 응답이 절대 돌아오지 않으면, 그것은 느린 성공이 아닙니다. 그것은 실패한 상호 작용입니다.
일관성 모든 레지스터가 동일한 재고 수준과 가격을 볼 수 있는지 여부입니다. 하나의 레지스터가 아이템이 존재한다고 말하고 다른 하나가 없다고 말하면 고객은 지연뿐만 아니라 혼란을 겪습니다.
역사적인 벤치마크는 첫 번째와 세 번째 용어를 기반으로합니다. CloudOps 분석은 전 세계 평균으로 HTTP 요청과 응답을 완료하는 데 426.4 밀리초 를 소요하고 평균 가용성을 97.69% 에 따라 구글 클라우드 관측성에서 보고했습니다. 두 개의 숫자는 사용자가 서비스가 “주로 작동”하는 동안 느끼는 지연과 중단을 모두 느끼기 때문입니다.
왜 모바일 업데이트 전송은 네 가지 모두에 의존하는가
실시간 업데이트에는 지연 시간이 매니페스트와 번들을 가져올 때이고, 처리량은 서비스가 업데이트를 확인하는 많은 장치가 시작할 때 여전히 작동하는지 여부입니다. 가용성은 장치가 업데이트를 확인할 수 있는지 여부입니다. 일시 중단 시 업데이트를 확인할 수 있는지 여부입니다. 일관성은 장치가 다른 장소에서 동일한 릴리스 채널과 자산 집합을 받는지 여부입니다.
앱 아키텍처가 중요해집니다. 앱 code, 저장소, CDN, 에지 로직, 및 릴리스 채널 사이의 움직이는 부분을 매핑하는 경우 모바일 앱 인프라 에 대한 실용적인 개론은
서비스 전달 pipe line을 사용자 경험과 연결하는 데 도움이 됩니다.
팀들은 종종 네 가지를 하나의 불만으로 묶습니다: “업데이트가 느립니다.” 그러나 그들은 다른 실패와 다른 소유주입니다.
- 고주파: 요청이 작동하지만 사용자가 기다립니다
- 저속도: 요청이 폭발적인 증가로 쌓입니다
- 불가용성: 서비스가 접근할 수 없습니다
- 강한 일관성: 사용자가 일치하지 않는 상태 또는陈舊 버전을 받습니다
만약에 그 네 가지를 일찍 분리한다면, 사고 검토가 훨씬 더 선명해집니다. ‘네트워크’에 대해 논쟁하는 것을 중단하고 정확한 레이어가 실패한 것을 식별합니다.
모바일 팀에게는 그 distinction이 중요합니다. 업데이트 시스템은 다단계 시스템입니다. 하나의 품질이 저하되면 작은, 서명된, 정확한 배달이 사용자에게도 너무 늦게 도달할 수 있습니다.
클라우드 백업 앱의 지연성 해부
사용자 경험 지연은 거의 항상 단일 요소가 아닙니다. 여러 작은 대기 시간이 쌓여서 지연 시간이 됩니다. 하이브리드 앱이 live update을 확인할 때 사용자는 DNS, TLS, 네트워크 전송, 매니페스트 생성, 서명 검증, 파일 다운로드, 디스크 쓰기 및 자바스크립트 평가와 같은 별도의 이벤트를 볼 수 없습니다. 그들은 하나의 일시정지로만 느끼게 됩니다.
그것이 왜 중요하다는 건 예산.
대기 시간이 어디서 오는가
첫 번째 층은 연결 설정입니다. DNS 해석과 TLS 핸드셰이크는 일반적으로 애플리케이션 로직이 실행되기 전에 발생합니다. 그 다음 네AREST 배포 지점으로의 네트워크 라운드 트립이 발생합니다. 그 다음 백엔드 또는 에지 로직이 이 장치가 받을 매니페스트와 번들을 결정해야 합니다. 마지막으로 장치는 다운로드한 것을 압축하고 평가해야 합니다.
이것을 작업 모델로 사용하세요:
| 층 | 일반적인 범위 (ms) | 최적화 레버 |
|---|---|---|
| DNS 및 TLS 설정 | 50에서 150 | 연결 재사용, HTTP 유지, TLS 세션 재개 |
| 네트워크 RTT에서 전달점까지 | 10에서 80 | 지역 배치, CDN 라우팅, 에지 캐시 히트율 |
| 원본 또는 에지 처리 | 20에서 300 | Lean 매니페스트 생성, 미리 계산된 메타데이터, 더 빠른 저장소 조회 |
| 장치側 적용 및 렌더링 | 100에서 600 | 더 작은 번들, 미리 가열된 JS 엔진, 시작 작업이 덜함 |
네트워크 부분에 대한 근거를 원한다면, 애플리케이션 전달에서 네트워크 지연 시간에 대한 이 설명서가 비네트워크 전문가인 모바일 팀원들에게 유용합니다. 네트워크 지연 시간에 대한 설명서 네트워크 지연 시간에 대한 설명서
지리적 위치가 도움이 되지만, 단독으로는 충분하지 않습니다.
많은 사람들이 인용하는 접근성 연구에서 발견한 바와 같이 세계 인구의 대부분이 100 밀리초 이내에 클라우드 인프라에 접근할 수 있다는 사실이 있습니다.이것이 클라우드 접근성에 대한 논의를 요약한 이유입니다. 이것이 ENCOURAGING 하지만, 사용자가 자동으로 빠른 업데이트 경로를 얻는다는 것은 아니다.다른 연구는 이 트랩을 명확하게 보여줍니다.
엣지 사이트는 네트워크 지연을 줄일 수 있지만, 엣지에서 제약된 자원은 큐잉 지연을 발생시켜 클라우드가 더 빠른 경우가 발생할 수 있습니다. 이것이 엣지와 클라우드 지연 분석에 대한 내용입니다..
모바일 팀이 먼저 조정해야 하는 것은 무엇인가요?
앱을 다시 작성하지 않고도 가장 쉽게 변경할 수 있는 layer부터 시작하세요:
- 엣지에서 캐시를 신중하게 관리하세요: 짧은 TTL과 명시적 인 유효 기간은 보통 완벽한 핫픽스 전파가 발생하는 것을 기대하지 않고도 안전합니다.
- 릴리즈 메타데이터 미리 계산 요청마다 복잡한 매니페스트를 빌드하지 말고, 채널, 버전, 서명 데이터를 미리 준비할 수 있다면 미리 준비해두면 좋다.
- 앱의 시작 시간을 줄이기: 빠르게 다운로드하는 번들을 평가하는 데 너무 오랜 시간이 걸리면 느린 것처럼 느껴질 수 있다.
- 가능한 경우 연결을 재사용: 반복적인 설정 비용은 불안정한 모바일 네트워크에서 눈에 띄는 저항을 유발한다.
빠른 번들 다운로드가 빠른 업데이트를 보장하지 않는다. 사용자는 새로운 code이 실제로 실행 준비가 될 때까지 기다린다.
에지 네트워크 및 모바일 업데이트 CDN 전송
내부 도구나 한 국가 앱에 한정된 경우 단일 클라우드 지역이 잘 작동할 수 있다. 그러나 사용자 기반이 대륙을跨하는 경우 빠른 핫픽스를 필요로 할 때는 더 어려운 상황이 된다. 모바일 업데이트 전송을위한 에지 및 CDN 디자인은 빠르게 첫 바이트를 받을 사람, 스테일 콘텐츠를 받을 사람, 정확한 순간에 오리진으로 돌아가는 사람을 결정한다.
팀이 일반적으로 고려하는 3가지 전송 모델
가장 단순한 모델은 중앙 원본 전송장치들은 하나의 지역에서 매니페스트와 번들을 가져옵니다. 운영이 간단하고, 이해하기 쉬우며, 초기 단계에서는 충분합니다.
다음 단계는 지역 배포장치들은 하나의 지역에서 매니페스트와 번들을 가져옵니다. 운영이 간단하고, 이해하기 쉬우며, 초기 단계에서는 충분합니다.
사용자는 가장 가까운 지역으로 라우팅되며, 많은 사용자의 전송 거리를 줄이고 부하를 더 잘 분산시킵니다. 그 다음에는에지 배포
정적 번들은 사용자 근처에 캐시되며, 에지에서 가벼운 논리에서는 매니페스트를 다시 작성하거나 채널을 라우팅하거나 서명 관련된 검사를 수행하기 전에 요청이 원본에 도달하기 전에 수행됩니다.
| Model | 모델 | 일반적인 P50 첫 번째 바이트 | 캐시 무효화 노력 |
|---|---|---|---|
| 중앙 집중식 클라우드 지역 | 거리 있는 사용자에게 더 높은 성능 | 낮음 | 작은 footprint, 낮은 릴리즈 빈도 |
| 지역 배포 | 보통 | 중간 | 예측 가능한 사용자 클러스터가 있는 다중 지역 앱 |
| CDN 및 에지 로직과 함께 에지 전달 | 캐시 히트가 건강할 때 가장 낮은 | 높음 | 글로벌 앱, 빈번한 업데이트, 사고敏감 릴리즈 |
팀이 edge 네트워크 평가를 위해 이 안내서를 참조하세요. 앱 전달에서 edge 네트워크 정확한 정신 모델을 제공합니다.
팀이 과소 평가하는 부분
캐시 무효화는 중요한 수정이 배포될 때까지 해결된 문제처럼 들리지만, 그 후 edge 서버는 한 지역에서昨日の 매니페스트를, 다른 지역에서는 오늘의 매니페스트를 제공하고, 지원 팀은 "해당 수정이 일부 사용자에게 작동한다"고 보고합니다.
그것은 릴리스完整성 문제입니다.
edge 위치에 대한 학문적 연구에서, 사용자와 더 가까운 위치로 컴퓨팅을 이동하면 액세스 지연 시간이 약 6%에서 30%까지 개선될 수 있습니다. 또한, 대안 네트워크 경로가 물리적으로 가까운 경로보다 최대 40%까지 성능을 개선할 수 있습니다.이것은 라우팅 품질과 피어링이 사용자 경험의 꼬리 부분에서 물리적 근접성과 같은 중요성을 가질 수 있음을 나타냅니다. 대규모 edge 성능 학문이것은 라우팅 품질과 피어링이 사용자 경험의 꼬리 부분에서 물리적 근접성과 같은 중요성을 가질 수 있음을 나타냅니다. 대규모 edge 성능 학문.
모바일 팀의 결정 매트릭스
업데이트 전송 계층을 선택할 때 사용하는 기준
- 사용자 분포: 사용자가 한 국가에 집중되어 있다면 중앙화 또는 지역화된 전송이 충분할 수 있습니다.
- 릴리스 빈도: 자주 릴리스하는 팀은 에지 캐싱의 이점을 더 많이 누릴 수 있지만 더 엄격한 캐시 규칙도 물려받습니다.
- 고정비 비용: 사용자에게 오래된 패키지가 사고 시 비용이 발생하는 경우 명시적 무효화 및 롤백을 위해 빌드하세요.
- 운영 용인도: 에지 로직은 힘을 더 주지만 라우팅 버그, 서명 일치 처리, 및 지역화된驚愕도 더 많은 장소에 있습니다.
정답은 '항상 에지'가 아닙니다. 정답은 릴리스 프로세스의 속도와 폭파 반경에 맞춰 전송 아키텍처를 맞춰야 합니다.
평균 응답 시간 이외의 중요한 지표
평균 응답 시간은 대시보드에 유용하지만 사용자 불편을 논하기 위해선 거의 쓸모가 없습니다. 모바일 사용자는 평균 요청을 경험하지 않습니다. 그들은 자신의 요청, 장치, 네트워크, 앱을 열었을 때의 순간에 요청을 경험합니다. 앱에 핫픽스를 푸시한 후에.
그것이 왜 헤드라인 지표가 더 중요하다는 것을 의미합니다.
제품 매니저에게 보여줄 세 가지 뷰입니다.
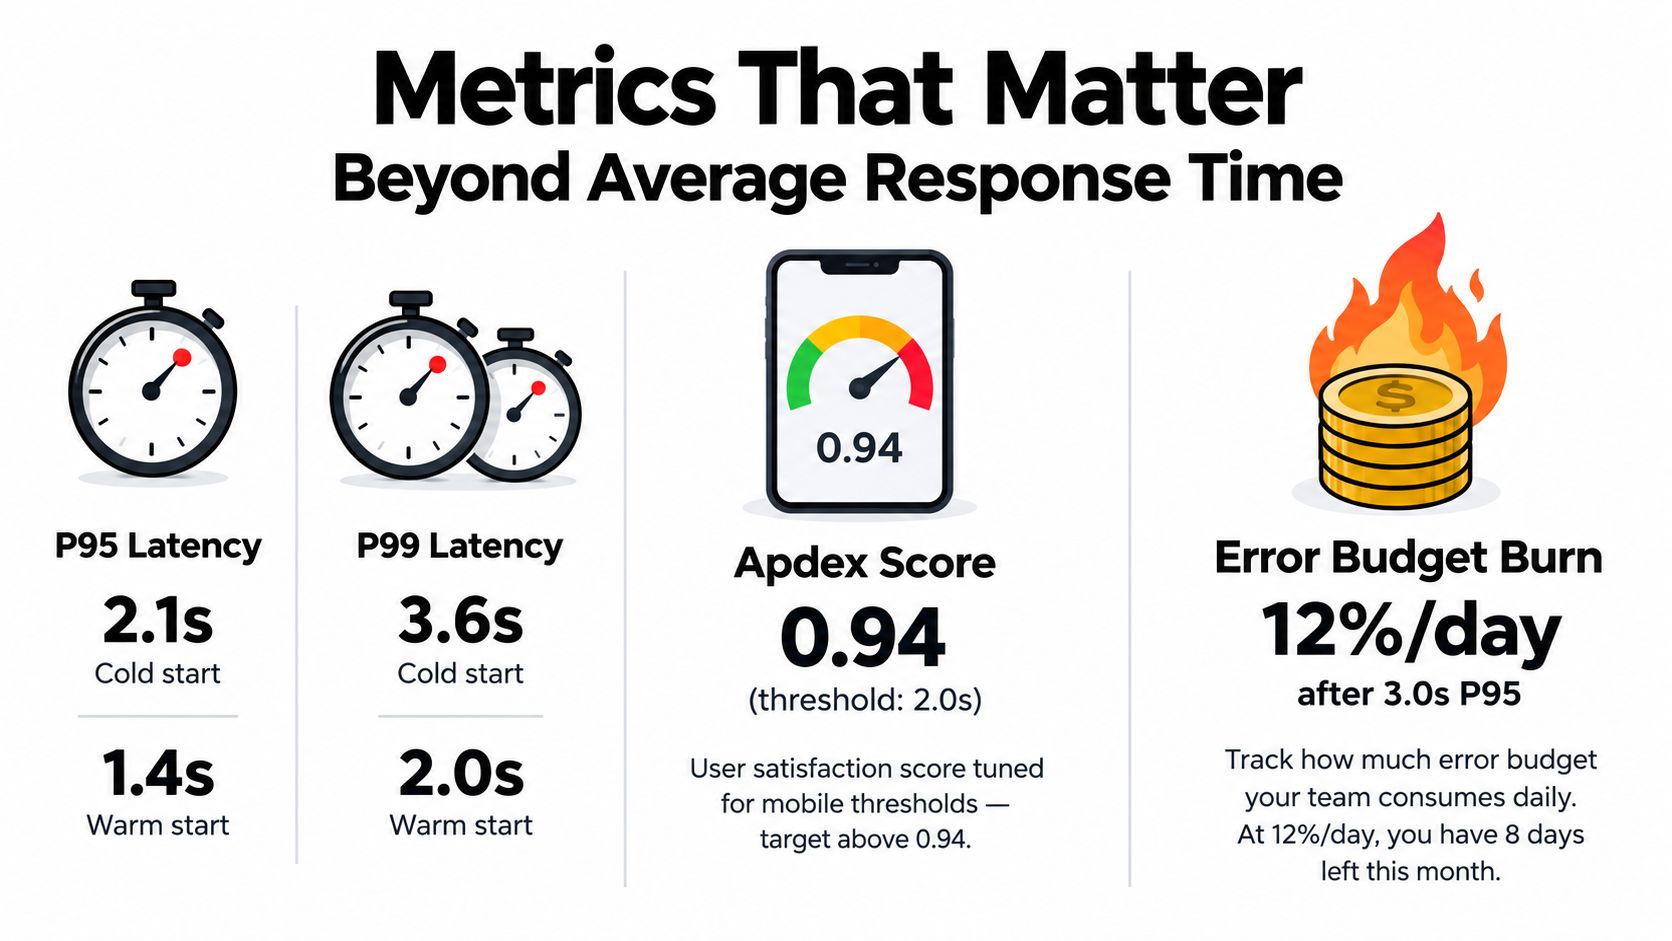
cold와 warm start 지연 시간을 시작으로 하여 P95 및 P99. cold start는 앱이 새로 시작되었을 때 업데이트를 확인하기 위해 어떤 일이 발생하는지 알려줍니다. warm start는 앱이 이미 어떤 작업을 수행한 후에도 남아있는 마찰을 알려줍니다.
그것 바로 아래에 Apdex 을 추적하세요. 모바일 팀이 믿는 임계값과 함께. 데스크톱 웹에서 공평한 임계값이 모바일 앱 시작 경로에 대해 잘못된 경우가 있을 수 있습니다.
그 다음에 오류 예산 소진. 이 대화는 “경보가 발생했는가?” 에서 “우리가 사용할 수 있는 신뢰성 공간을 얼마나 빨리 소진하는가?” 로 바뀌었다.
주간 리뷰에서 공유할 가치 있는 간결한 시각화:
성능과 릴리스 결과를 연결하는 지표
배포에 특화된 지표를 추가하십시오. 웹 팀이 종종 필요하지 않은 지표입니다: 배포 채널별로 릴리스 채널에 따라, 고정된 패키지가 배포되었지만 이전 버전의 장치에 아직 영향을 미치고 있다면, 성능과 배포 문제가 동시에 발생합니다.
지표를 구분하십시오:
- 장치 종류: 오래된 휴대폰은 시작 및 평가 비용을 먼저 드러내는 경우가 많습니다.
- 네트워크 종류: Wi-Fi는 모바일 데이터가 즉시 노출하는 나쁜 배포 설계를 숨길 수 있습니다.
- 앱 버전: 버전별로 특정한 오류가 발생할 수 있으며, 특히 브리지 동작이나 마이그레이션 로직과 관련된 오류입니다.
이 비디오는 팀이 성능 모니터링을 평균치만 보는 대신 해석하는 데 실무적인 리프레셔로 사용할 수 있습니다.
주의할 점은 모든 작은 클라우드 앱 성능의 움직임이 의미가 있는 것은 아닙니다.
2,366 개의 벤치마크를 통해 789 개의 AWS Kubernetes 클러스터에서 on 이며, 시간대와 주말 효과에 의한 미묘한 변동이 발생한다고 합니다. 이 연구는 클라우드 성능의 변동성을 조사한 연구입니다. 3.7%App version: cloud performance variability studyCloud 애플리케이션 성능
Cloud 성능이 랜덤한지 물어보지 마세요. 시스템의 정상 측정 오류를 알아내고, 그 이상의 변화를 경고하세요.
Cloud 애플리케이션 관찰성
많은 엔지니어들이 모니터링을 가지고 있지만, 그것은 일반적으로 빠르게 호출할 수 있는 질문을 대답하지 못합니다. 하이브리드 모바일 업데이트 경우 유용한 질문은 일반적으로 특정적입니다: 이 기기는 왜 이전 버전을 유지했으며, 새로운 버전이 적용되지 않았는지, 또는 시작이 느려졌는지.
트레이스, 로그, 및 메트릭은 필수적입니다. 그러나 종종 충분하지 않습니다.
업데이트 경로 하나를 중심으로 스택을 구축하세요
Cloud 애플리케이션 성능을 관찰하는 데 필요한 스택은 기기에서 백엔드까지의 한 업데이트 시도부터 다시 시작할 수 있어야 합니다.
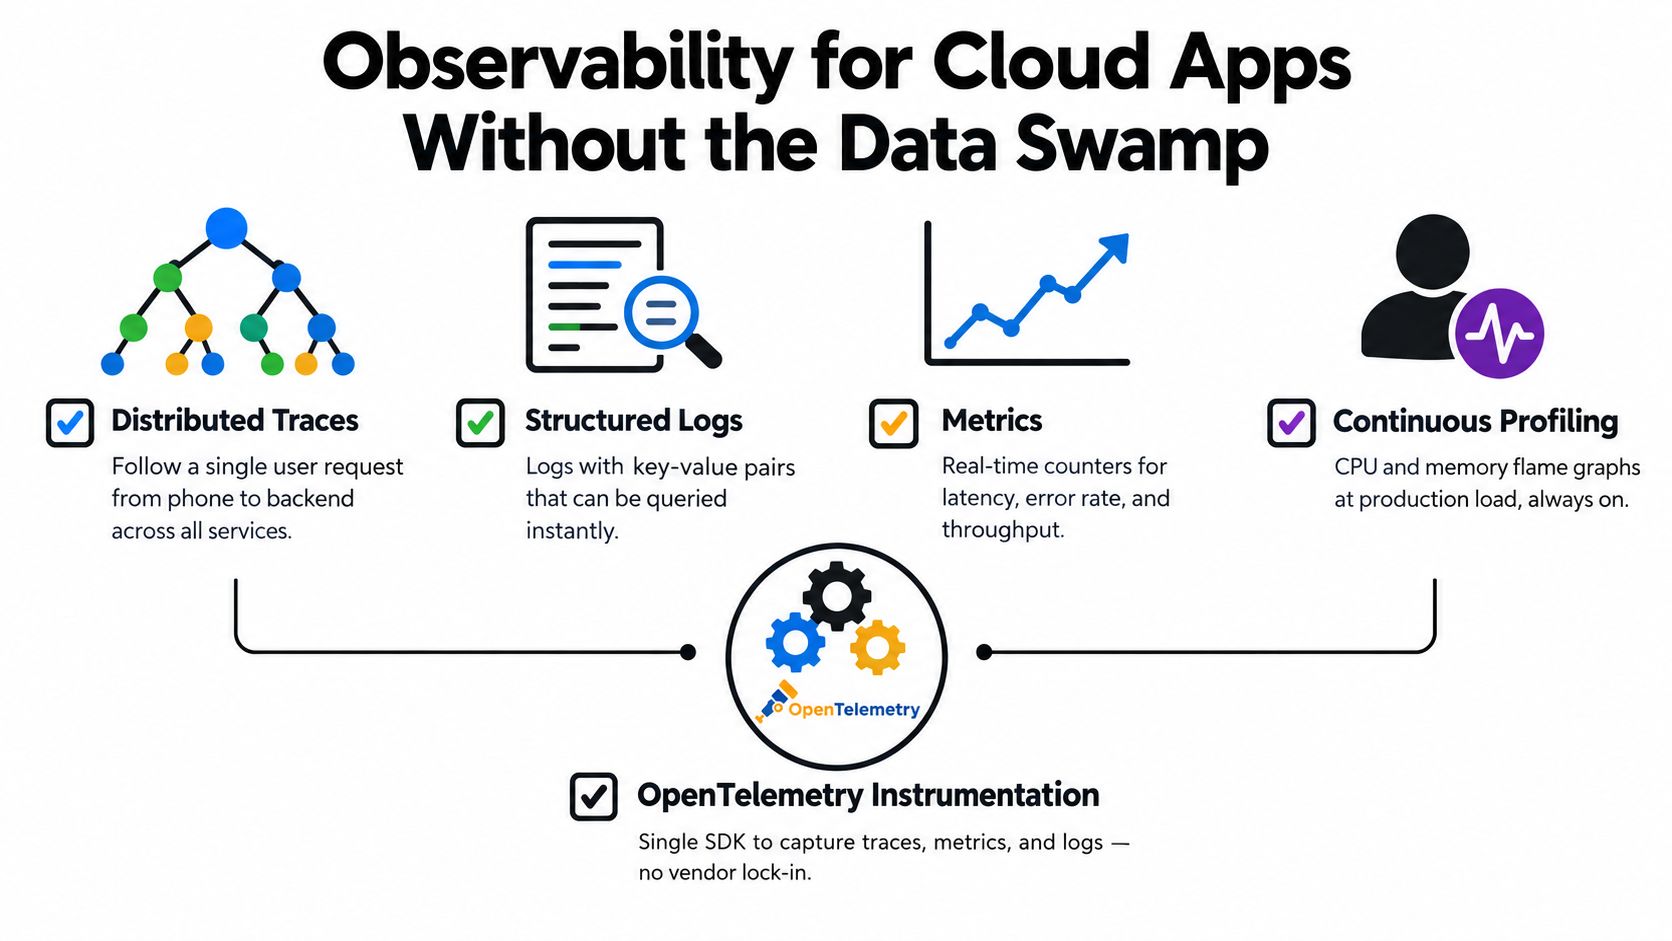
모바일 브리지 및 업데이트 클라이언트를 OpenTelemetry로 구현하세요 OpenTelemetry 앱 버전, 릴리스 채널, 플랫폼, 및 업데이트 결과에 대한 태그를 추가하세요. 로그를 구조화하여 한 업데이트 ID 또는 한 기기 세션을 쿼리할 수 있도록 하세요. 지연 시간, 오류율,採用률, 및 롤백 이벤트에 대한 메트릭을 집중하세요.
이러한 구성 요소를 표준화하는 팀에게는 애플리케이션 관찰성 제공 은 shipped 앱에 대한 좋은 구현 참고 자료입니다.
네 번째 신호
modern APM 지침에서 가장 유용한 shift 중 하나는 trace, metrics, logs가 여전히 진단 gap을 남기고 있다는 것입니다. Continuous profiling은 점점 더 네 번째 신호로 다루어지고 있습니다. 이는 guide to application performance monitoring and profiling에서 설명한 CPU, 메모리, lock 시간을 정확하게 소비하는 함수를 보여줍니다. 응용 프로그램 성능 모니터링 및 프로파일링 가이드.
That matters in live update workflows. A trace might show that “apply update” took too long. Profiling can show whether the bottleneck was bundle decompression, JSON parsing, bridge initialization, or a lock in a startup path.
작은, discipline된 views의 작은 집합을 사용하세요:
릴리스 채널 대시보드:
- 수용, 실패, 롤백 횟수 업데이트 트랜잭션 트레이스:
- 매니페스트 가져오기부터 번들 평가까지 이것은 애플리케이션 성능 모니터링 및 프로파일링에 대한 안내서의 일부입니다.
- 시작업 성능 하락: 버전 및 플랫폼에 따라 그룹화
- 프로파일링 뷰: 업데이트 적용 및 첫 렌더링 시 가장 뜨거운 함수
팀이 이러한 워크플로우를 기반으로 더 광범위한 DevOps 및 SRE 운영 모델을 개선하고 있다면, nexus IT 그룹이 제공하는 개발 운영 사례를 참조하는 것이 유용합니다. 사례 연구는 관찰성 운영을 단순한 도구 구매로만 보는 것보다 운영 관행으로 프레임합니다. 최고의 대시보드는 실제로 지원팀이 작성한 인시던트 요약을 읽기 전에 호출 엔지니어가 열고 이해하고 행동하는 대시보드입니다.
SLA, 오류 지출, 채널 기반 롤아웃
SLAs, 오류 예산, 채널 기반 배포
가용성 목표를 릴리스 정책으로 변환
가용성 목표를 고객 약속으로만 정의하는 것보다 롤아웃 단계로 정의하세요.
가용성 목표를 릴리스 정책으로 변환
| 운영 목표 | 월간 중단 예산 | 적합한 배포 단계 |
|---|---|---|
| 99% | 약 7시간 18분 | 내부 및 실험적 채널 |
| 99.9% | 약 43분 | 베타 및 스테이징된 프로덕션 배포 |
| 99.99% | 약 4분 23초 | 기업 비즈니스 경로에 대한 광범위한 프로덕션 |
이 중단 예산은 단순한 월별 계산에서 나옵니다. 실제로는 전달 chain 전체를 고려할 때 실질적으로 줄어듭니다. 원본은 건강한 상태일 수 있지만 DNS, 에지 전파, 또는 나쁜 채널 규칙이 장치가 의도한 릴리스를 받을 수 있도록 방해하는 경우 여전히 장치가 의도한 릴리스를 받을 수 없습니다.
업데이트 플랫폼이 이 작업을 운영적으로 프레임하는 구체적인 예시가 필요하다면, 릴리스 전달에 대한 uptime 보증을 검토하세요. 업타임 보장(uptime guarantee)으로 릴리즈 전달(delivery) 그것을 자신의 사고 가정과 비교하세요.
오류 예산은 제품과 신뢰성이 만나는 곳입니다.
오류 예산은 팀에 권한 구조를 제공합니다. 만약 burn이 평온하다면, 일부 릴리스 위험을 수용할 수 있습니다. 만약 burn이 핫픽스 이후에 급격히 증가한다면, 다음 채널로의 프로모션을 중단하세요.
하이브리드 앱의 강력한 롤아웃 계단은 다음과 같이 보입니다:
- 내부: 엔지니어들이 매니페스트, 서명, 적용 흐름이 예상대로 동작하는지 확인합니다.
- 베타: 친절한 사용자 및 테스터들이 에지 장치 오류를 잡습니다.
- 스테이지드 프로덕션: 한정된 관중이 패키지를 먼저 받습니다.
- 풀 프로덕션: 업데이트가 기본 채널 목표로 설정됩니다.
동일한 규칙이 사용자들이 기능 플래그, 오버-더-에어 자바스크립트 업데이트, 또는 두 가지 모두를 사용하는 경우에도 적용됩니다.
롤백 트리거를 설정하기 전에 필요로 할 때까지
롤백 규칙은 명확하고 지루해야 합니다. 사고 중에는 그들을 임의로 만들지 마세요.
유용한 트리거에는 다음과 같은 것들이 포함됩니다:
- 적용이 예상치 못하게 중단됩니다: 장치들은 새로운 버전으로 이동하지 않습니다.
- 시작 시간 지연이 급격하게 나빠집니다: 특히 오래된 장치 또는 약한 네트워크에서
- 적용 오류가 하나의 플랫폼 또는 버전에서 집중됩니다: 주로 브리지 또는 패키징 불일치로 인해
- 실 사용자 모니터링에서 경험의 저하가 나타납니다: 합성 체크는 모바일 특정한 고통을 놓치게 됩니다.
plain language로 실패를 설명하십시오. 실패한 것이 무엇인지, 영향을 받은 사람들, 중단된 채널, 롤백이 무엇인지, 다음 결정 지점은 언제인지 설명하십시오. 이해관계자는 수집된 데이터를 필요로 하지 않습니다. 그들은 운영에 대한 명확한 정보가 필요합니다.
Cloud App Performance를 실천하는 방법
클라우드 앱 성능을 개선하는 가장 빠른 방법은 그것을 인프라의 자랑거리가 아닌 실질적인 문제로 다루는 것입니다. 사용자는 캐시 히트 비율이 변경되지 않는 한 그것에 관심이 없습니다. 제품도 원본 CPU에 관심이 없으며, 그것이 영향을 받은 장치로 수정이 빨리 도달하는지에만 관심이 있습니다.
이번 주에 사용자에게 영향을 미치는 한 가지 지표를 선택하고 그것을 현실화하십시오.
1주일 동안 수행할 도전
사용자에게 영향을 미치는 지표를 선택하십시오. 좋은 옵션은 업데이트를 확인한 후 인터랙티브로 변환되는 첫 번째 런치 시간 또는 업데이트 패키지 다운로드 시간입니다. 가장 느린 사용자들에 대한 프로덕션 채널에서.
그런 다음 네 가지 일을 하십시오:
- 기준점을 측정하십시오: 실제 사용자 모니터링을 사용하십시오. 단순한 합성 검사만 사용하지 마십시오.
- 하나의 목표를 설정하십시오: 예를 들어, 패키지 크기를 줄이십시오. 매니페스트 출력을 미리 계산하십시오. 에지 캐싱 규칙을 강화하십시오.
- 스테이지 채널을 통해 배포하십시오: 배포 전 사용자 실패율과 성공률을 모니터링하세요.
- 같은 지표를 다시 측정하세요. 사용자에게 보이는 결과가 개선되지 않았다면, 최적화는 그만한 가치가 없었습니다.
이 체크리스트는 대부분의 모바일 팀이 우선순위를 정하는 데 도움이 됩니다:
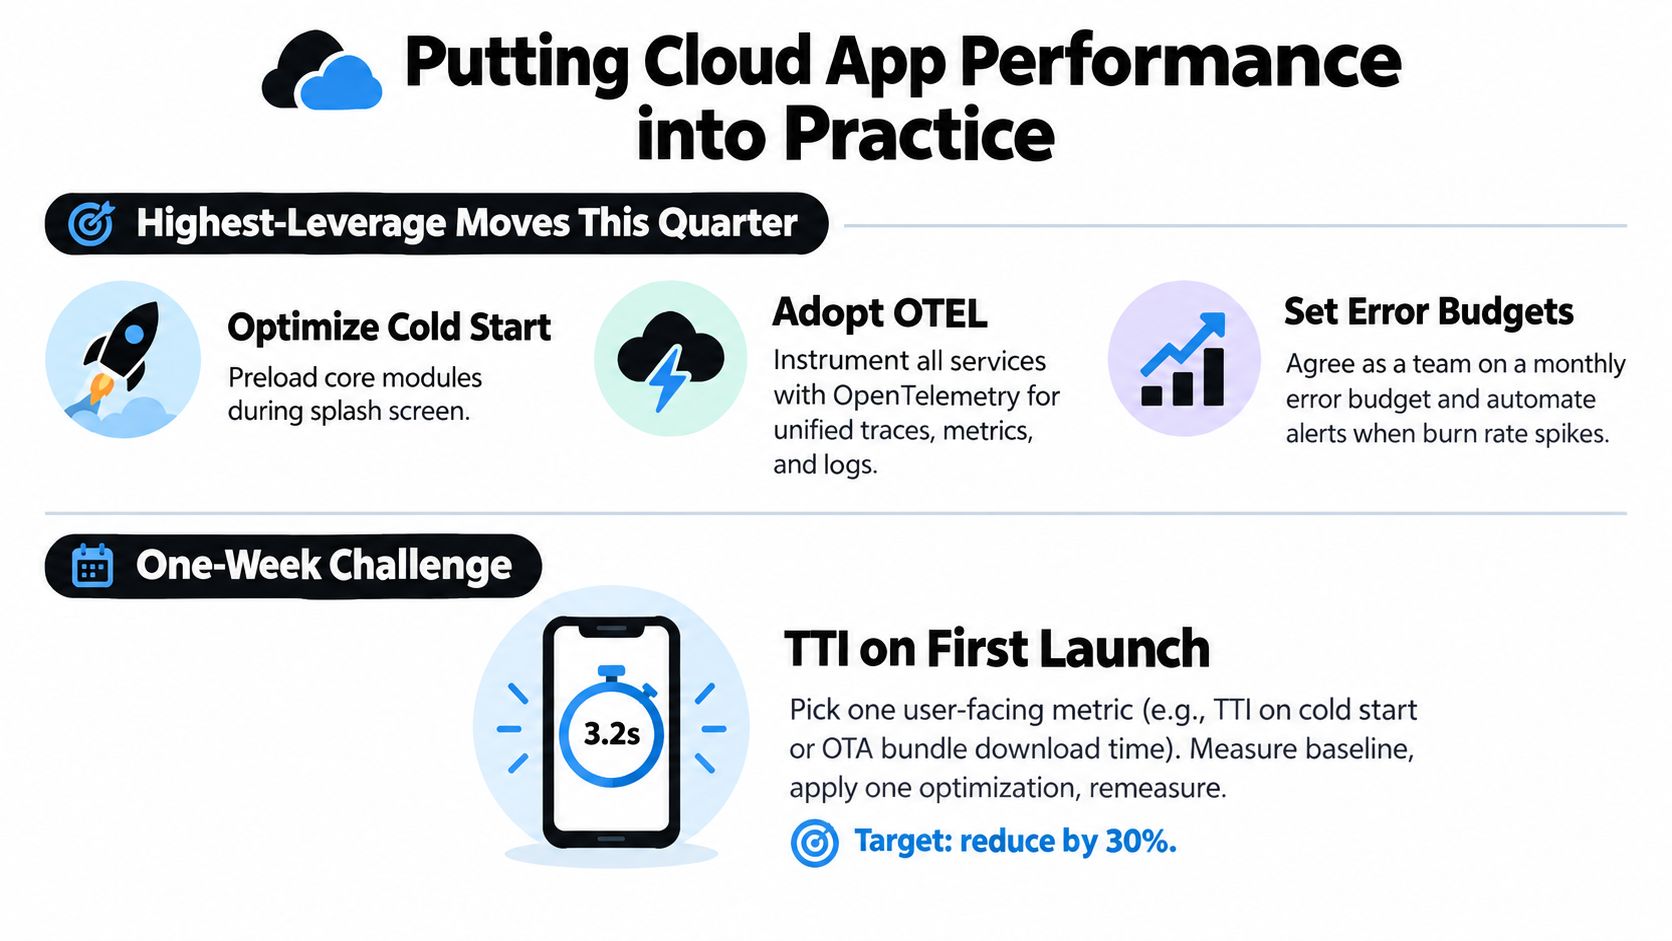
이번 분기에 우선순위를 정할 것들
먼저 가장 빠르게 사용자 불편을 줄이는 작업부터 시작하세요.
- 엣지 캐시 동작을 검증하세요. 매니페스트의 최신성을 유지하고 번들의 무효화를 제대로 동작하는지 확인하세요.
- 번들의 크기와 시작 시간을 감사하세요. 배포 속도와 평가 속도가 모두 중요합니다.
- 업데이트 흐름을 위한 P95 대시보드를 구축하세요. 평균을 넘지 마세요.
- 에러 비용 소비를 채널별로 추적하세요: 신뢰성과 릴리즈 속도는 동일한 점수판을 공유해야 합니다.
- 롤백 계획서를 작성하세요: 트리거, 책임자, 통신 단계를 포함하세요.
이 카테고리에서 실제 도구 예시가 필요하다면 Capgo Electron 팀과 같은 Capacitor 및 Electron 팀이 서명된 라이브 업데이트, 채널 기반 롤아웃 제어, 장치별 로그, 롤백 지원을 전 세계 에지 네트워크를 통해 제공할 수 있도록 하는 옵션입니다. 중요한 것은 벤더 이름이 아니라, 사용자 경험에 영향을 미치는 문제가 웹으로 전달되는 code에 대한 업데이트를 발행, 관찰, 되돌리기 위해 스토어 리뷰를 기다리지 않고 workflow를 선택하는 것입니다.
hero적인 엔지니어링보다 제한된 측정법이 낫습니다. 사용자가 경험하는 것을 바꾸지 않는 백엔드 숫자를 한 달 동안 다듬는 것보다 한 주에 하나의 가시적인 지표를 움직이는 것이 낫습니다.
팀이 Capacitor 앱을 배포하고 live update 전달, 관찰성, 스테이지드 롤아웃, 롤백 안전성을 더 chặt하게 제어하고 싶다면 Capgo __CAPGO_KEEP_0__ 앱을 배포하고 __CAPGO_KEEP_1__ 전달, 관찰성, 스테이지드 롤아웃, 롤백 안전성을 더 chặt하게 제어하고 싶다면



