
Mercoledì alle 9:12, il tuo team mobile scopre un bug nel checkout in produzione. Il web può correggerlo in fretta. iOS e Android no, almeno non passando dalla revisione degli store. Il supporto inizia a raccogliere ticket, il product vuole un aggiornamento sullo stato e l'engineering cerca di rispondere a tre domande diverse insieme: quanto in fretta possiamo rilasciare una correzione, quanto in fretta la riceveranno gli utenti e quanto in fretta possiamo dimostrare che la correzione ha funzionato?
È qui che le prestazioni delle app cloud smettono di essere un tema astratto di backend e diventano un tema di release. Per i team mobile ibridi che pubblicano bundle JavaScript, config, copy e asset al di fuori degli store, la performance non è solo "il API è veloce?" È se il tuo percorso di delivery può pubblicare, instradare, scaricare, validare, applicare, osservare e, se necessario, fare rollback di un aggiornamento mentre gli utenti sono ancora nell'area di impatto.
Se lavori su Capacitor, Ionic o un altro stack ibrido, questo cambia il modo in cui pensi al lavoro sulle prestazioni. Un fetch del manifest che si blocca, una cache edge che serve un bundle vecchio o un trace che non riesce a identificare dove un hotfix è fallito diventano tutti parte dello stesso sistema. L'esperienza dell'app e il meccanismo di release sono legati tra loro.
Indice dei contenuti
- Il team mobile che non riusciva a rilasciare un fix
- Cosa significa davvero la performance delle cloud app
- L'anatomia della latenza nelle app con backend cloud
- Edge Networks e distribuzione CDN per gli aggiornamenti mobile
- Metriche che contano oltre il tempo medio di risposta
- Osservabilità per le app cloud senza il data swamp
- SLA, error budget e rollout basati sui channel
- Portare nella pratica le performance delle Cloud App
Il team mobile che non riusciva a rilasciare un fix
Un team che ho visto molte volte in pratica è così: un mobile lead, due app engineer, un backend engineer, un product manager e il supporto che inoltra screenshot di utenti arrabbiati. Il bug è semplice. Un mismatch di prezzo rompe il checkout dopo che un feature flag viene attivato. La fix è altrettanto semplice. La parte frustrante è la delivery.
La native shell non deve cambiare. Il JavaScript bundle sì. Se il team si affida solo al submission su app store, ora sta aspettando un processo che non può controllare. Durante quell'attesa, ogni conversazione peggiora. Il supporto chiede chi è colpito. Il product chiede quando l'esposizione cala. L'engineering chiede se gli utenti stanno nemmeno raggiungendo il percorso code corretto.
Il ritardo non è solo nel codice
Prima di tutto, inquadralo come un collo di bottiglia nel rilascio. È in parte vero. Ma il problema più profondo è prestazioni erogate dal cloud lungo tutto il percorso di aggiornamento.
Perché un live update sia utile, diverse cose devono andare bene:
- Il dispositivo deve raggiungere il servizio di aggiornamento: Se la richiesta del manifest è lenta o fallisce a intermittenza, gli utenti restano sulla versione difettosa più a lungo.
- L'edge deve servire i file giusti: Se l'invalidazione della cache è lenta, un paese potrebbe ricevere la fix mentre un altro scarica ancora asset obsoleti.
- L'app deve verificare e applicare in sicurezza: I bundle firmati, il targeting dei canali e le regole di rollback contano quanto la velocità pura.
- Il team deve monitorare l'adozione: Rilasciare una fix senza vedere chi l'ha ricevuta è solo un modo più complesso di tirare a indovinare.
Regola pratica: Un hotfix mobile viene “rilasciato” solo quando i dispositivi interessati l’hanno effettivamente scaricato e applicato.
Ecco perché le performance cloud contano così tanto per i live update. Non stai ottimizzando solo il tempo di risposta del server, ma anche il tempo di ripristino da un incidente su dispositivi reali, su reti instabili, in aree geografiche diverse e con versioni dell'app diverse.
Una domanda più pertinente di "l'app è veloce?"
Quando i team parlano di performance dopo un incidente, spesso si chiedono se l'app sembrasse lenta. La domanda più utile è se il sistema di delivery è stato abbastanza veloce da cambiare l'esperienza utente prima che l'incidente si diffondesse.
Per le app ibride, il percorso di rilascio fa parte del prodotto. Se il tuo team riesce a pubblicare rapidamente un bundle corretto, a targettare un channel in sicurezza e a verificare l'adozione con certezza, la performance diventa operativa. Impatta direttamente sul carico del supporto, sulla tutela dei ricavi e sulla fiducia che il prodotto ripone nell'engineering durante un outage.
Cosa significa davvero la performance delle cloud app
Quando i team mobile sentono parlare di "performance", di solito pensano ai tempi di caricamento. Ma è solo una parte del problema. La performance delle cloud app è la combinazione di quattro qualità che lavorano insieme: latenza, throughput, disponibilità e coerenza.
Un buon modo per spiegarlo è usare l'analogia del negozio.
Quattro qualità su cui puoi ragionare concretamente
Latenza è l'attesa al banco. Chiedi qualcosa e conti quanto tempo passa prima di ricevere una risposta.
Throughput indica quanti clienti il negozio può servire senza problemi contemporaneamente. Un unico cassiere veloce non basta se si forma una coda non appena il traffico aumenta.
Disponibilità indica se il negozio è aperto o meno. Una risposta che non arriva mai non è un successo lento. È un'interazione fallita.
Consistenza indica se ogni cassa vede lo stesso livello di stock e gli stessi prezzi. Se una cassa dice che l'articolo esiste e un'altra no, il cliente percepisce confusione, non solo ritardo.
Un benchmark storico aiuta a contestualizzare il primo e il terzo termine. Un'analisi CloudOps ha riportato una media mondiale di 426,4 millisecondi per completare una richiesta HTTP e ricevere una risposta, con una disponibilità media pari a 97.69% according to Google Cloud Observability. Questi due numeri contano perché gli utenti percepiscono sia il ritardo che il downtime, anche quando il servizio è “quasi sempre attivo”.
Why mobile update delivery depends on all four
Per le Live Update, la latenza è il tempo per recuperare il manifest e il bundle. Lo throughput indica se il servizio regge sotto un picco quando molti dispositivi controllano gli aggiornamenti all'avvio. La disponibilità è se i dispositivi possono raggiungere l'endpoint di aggiornamento durante un incidente. La consistenza è se i dispositivi in diverse posizioni ricevono lo stesso canale di rilascio e lo stesso set di asset.
L'architettura dell'app inizia a contare. Se stai mappando le parti mobili tra app code, storage, CDN, logica edge e canali di rilascio, una guida pratica su l'infrastruttura delle app mobili aiuta a collegare la pipeline di distribuzione all'esperienza utente.
La confusione comune
I team spesso raggruppano tutti e quattro in un unico lamento: “gli aggiornamenti sono lenti”. Ma si tratta di guasti diversi con responsabili diversi.
- Alta latenza: la richiesta funziona, ma gli utenti aspettano
- Basso throughput: le richieste si accumulano durante i picchi
- Disponibilità scarsa: il servizio non è raggiungibile
- Coerenza debole: gli utenti ricevono stati incoerenti o versioni obsolete
Se separi questi quattro aspetti fin dall'inizio, l'analisi degli incidenti diventa molto più precisa. Smetti di discutere di "la rete" e inizi a identificare lo strato esatto che ha fallito.
Per i team mobile, questa distinzione è importante perché i sistemi di aggiornamento sono sistemi multi-step. Un bundle può essere piccolo, firmato e corretto, ma raggiungere comunque gli utenti troppo lentamente se una di queste qualità peggiora.
L'anatomia della latenza nelle app supportate da cloud
Il ritardo percepito dall'utente raramente è una cosa sola. È una pila di piccole attese che si sommano. Quando un'app ibrida verifica un live update, l'utente non vede DNS, TLS, viaggio di rete, generazione del manifest, validazione della firma, download del file, scrittura su disco e valutazione JavaScript come eventi separati. Sente una sola pausa.
Ecco perché il lavoro sulla latenza dovrebbe essere trattato come un budget.
Da dove arriva il tempo di attesa
Il primo livello è la configurazione della connessione. La risoluzione DNS e il handshake TLS avvengono spesso prima che la logica della tua applicazione venga eseguita. Poi arriva il round trip di rete verso il punto di consegna più vicino. Dopo di che, la logica del backend o dell'edge deve ancora decidere quale manifest e quale bundle questo dispositivo dovrebbe ricevere. Infine, il dispositivo deve estrarre ed eseguire ciò che ha scaricato.
Usa questo come modello di lavoro:
| Livello | Range tipico (ms) | Leva di ottimizzazione |
|---|---|---|
| Configurazione DNS e TLS | 50 - 150 | Riutilizzo delle connessioni, HTTP keep-alive, ripresa della sessione TLS |
| RTT di rete verso il punto di consegna | 10 - 80 | Posizionamento regionale, routing CDN, edge cache hit rate |
| Elaborazione su origin o edge | 20 - 300 | Generazione manifest snella, metadati precalcolati, lookup storage più rapidi |
| Applicazione e rendering lato dispositivo | 100 a 600 | Bundle più piccoli, motore JS pre-riscaldato, meno lavoro all'avvio |
Se vuoi una base solida sulla parte di rete in particolare, questa spiegazione su la latenza di rete nella distribuzione delle applicazioni è utile per i membri dei team mobile non specializzati in rete.
La geografia aiuta, ma non basta da sola
Uno studio ampiamente citato sulla raggiungibilità ha scoperto che la maggior parte della popolazione mondiale potrebbe accedere a un'infrastruttura cloud entro 100 millisecondi, il che spiega perché il deployment regionale sia diventato centrale nella strategia di performance, come riassunto in questa discussione sulla raggiungibilità cloud. È incoraggiante, ma non significa che ogni utente ottenga automaticamente un percorso di aggiornamento veloce.
Un altro studio chiarisce la trappola. I siti edge possono ridurre la latenza di rete, ma le risorse limitate all'edge possono creare ritardi di coda, causando casi in cui il cloud è più veloce nel complesso, secondo questa analisi della latenza edge vs cloud.
Cosa dovrebbero ottimizzare prima i team mobile
Inizia dai layer più facili da modificare senza riscrivere l'app:
- Fai la cache del manifest all'edge con attenzione: TTL brevi e invalidazione esplicita sono generalmente più sicuri che sperare in una propagazione perfetta durante un hotfix.
- Pre-calcola i metadati del release: Non costruire un manifest complesso a ogni richiesta se i dati di channel, versione e firma possono essere preparati in anticipo.
- Riduci il lavoro di avvio nell'app: Un bundle che si scarica rapidamente ma impiega troppo tempo per essere valutato risulta comunque lento.
- Riutilizza le connessioni quando possibile: Il costo di setup ripetuto crea un rallentamento evidente sulle reti mobili instabili.
Un “download veloce del bundle” non garantisce un aggiornamento rapido. All’utente interessa solo quando il nuovo code è davvero pronto a girare.
Edge Networks e distribuzione CDN per gli aggiornamenti mobile
Una singola regione cloud può funzionare bene per tool interni o app locali. Diventa più difficile da giustificare quando gli utenti sono sparsi su più continenti e servono hotfix rapidi. Per la distribuzione degli aggiornamenti mobile, l’architettura edge e CDN determina chi riceve subito il primo byte, chi riceve contenuti obsoleti e chi finisce sull’origin nel momento peggiore.
Tre modelli di delivery che i team considerano
Il modello più semplice è la distribuzione da un origin centralizzato. I dispositivi scaricano manifest e bundle da un’unica regione. È semplice da gestire, facile da comprendere e spesso sufficiente nelle prime fasi.
Il passo successivo è la distribuzione regionale. Si posizionano storage o logica applicativa in alcune regioni principali, instradando gli utenti verso la più vicina. Questo riduce la distanza di transito per molti utenti e distribuisce meglio il carico.
Then there’s la distribuzione edge. I bundle statici vengono memorizzati in cache vicino agli utenti, e la logica leggera all'edge può riscrivere i manifest, instradare i canali o eseguire controlli relativi alle firme prima che la richiesta raggiunga l'origine.
Ecco un confronto pratico:
| Modello | P50 First Byte tipico | Sforzo di invalidazione cache | Ideale per |
|---|---|---|---|
| Regione cloud centralizzata | Più alto per utenti lontani | Basso | Impronta ridotta, frequenza di rilascio bassa |
| Deploy regionali | Moderato | Medio | App multi-regione con cluster di utenti prevedibili |
| Consegna edge con CDN e logica edge | Minima quando i cache hit sono sani | Alta | App globali, aggiornamenti frequenti, release sensibili agli incidenti |
Per i team che valutano le dinamiche, questa guida a le reti edge nella consegna delle app fornisce il modello mentale giusto.
L'aspetto che i team sottovalutano
L'invalidazione della cache sembra un problema risolto finché non viene rilasciata una correzione critica. Poi l'edge serve il manifest di ieri in una regione e quello di oggi in un'altra, e il supporto riceve segnalazioni che "la correzione funziona per alcuni utenti".
Non è un semplice fastidio teorico. È un problema di integrità del rilascio.
Una tesi sull'edge placement ha rilevato che spostare il calcolo più vicino agli utenti spesso migliorava la latenza di accesso solo del circa dal 6% al 30%, e ha anche osservato che percorsi di rete alternativi possono superare un percorso nominalmente locale fino al 40%, il che significa che la qualità del routing e del peering può contare quanto la vicinanza fisica nella coda dell'esperienza utente, secondo questa tesi su larga scala sulle performance edge.
Una matrice decisionale per i team mobile
Usa questi criteri per scegliere il tuo tier di distribuzione degli update:
- Distribuzione utenti: Se gli utenti sono concentrati in un solo paese, la distribuzione centralizzata o regionale potrebbe bastare.
- Frequenza dei rilasci: I team che rilasciano spesso traggono più vantaggio dalla cache edge, ma ereditano anche una disciplina di cache più rigorosa.
- Costo del hotfix: Se un bundle obsoleto durante un incidente è costoso, progetta per l'invalidazione esplicita e il rollback prima di averne bisogno.
- Tolleranza operativa: La logica edge aggiunge potenza, ma anche più punti in cui possono nascere bug di routing, problemi di mismatch delle firme e sorprese legate alla geolocalizzazione.
La risposta giusta non è “usare sempre l'edge”. La risposta giusta è allineare l'architettura di distribuzione alla velocità e al raggio d'azione che il tuo processo di rilascio richiede.
Metriche che contano oltre il tempo medio di risposta
Il tempo di risposta medio è utile per i dashboard e quasi inutile per discutere del dolore dell'utente. Gli utenti mobili non vivono la richiesta media. Vivono la loro richiesta, sul loro dispositivo, sulla loro rete, nel momento in cui hanno aperto l'app dopo che hai spinto un hotfix.
Ecco perché le metriche di coda sono più importanti.
Le tre viste che proporrei a un product manager
Inizia con la latenza di avvio a freddo e a caldo P95 e P99. Il cold start indica cosa succede quando l'app si avvia da zero e cerca aggiornamenti senza uno stato preesistente. Il warm start indica quanto attrito resta una volta che l'app ha già svolto parte del lavoro.
Subito sotto, monitora Apdex con una soglia in cui il tuo team mobile crede. Una soglia che può sembrare giusta per il web desktop può essere sbagliata per il percorso di avvio di una hybrid app.
Poi monitora l'error budget burn. Questo sposta la conversazione da “è scattato un alert?” a “quanto velocemente stiamo consumando il margine di affidabilità che abbiamo deciso di spendere?”
Ecco un visual compatto che vale la pena condividere nella review settimanale:
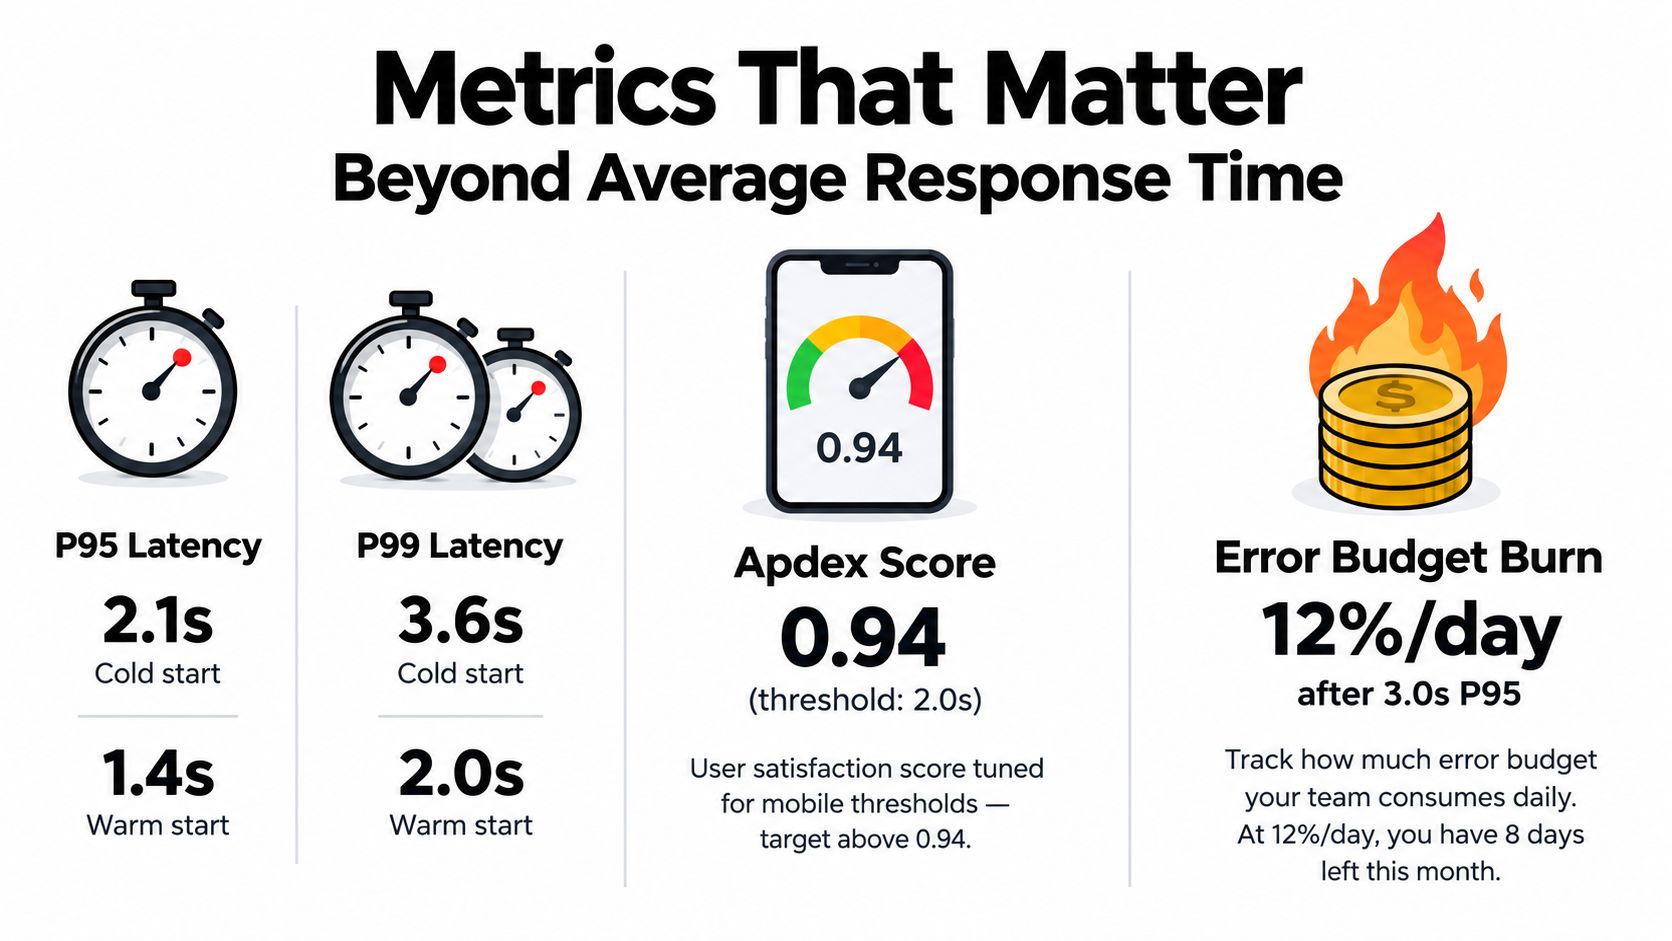
Metriche che collegano le performance agli esiti del rilascio
Aggiungi un metrica di delivery specifica che i team web spesso non necessitano: tasso di adozione per canale di rilascio. Se un bundle fisso è stato pubblicato ma i dispositivi interessati sono ancora sulla versione precedente, si tratta di un problema di performance e di distribuzione allo stesso tempo.
Segmenta le tue metriche per:
- Classe di dispositivo: I telefoni più vecchi spesso rivelano prima i costi di avvio e valutazione.
- Tipo di rete: Il Wi-Fi può nascondere un bundle mal progettato che i dati mobili espongono immediatamente.
- Versione dell'app: Some failures are version-specific, especially around bridge behavior or migration logic.
Questo video è un ottimo compagno se il tuo team ha bisogno di un ripasso pratico su come interpretare la telemetria delle prestazioni, invece di fissare le medie:
Un avvertimento su come leggere il rumore
Non ogni piccola variazione nelle prestazioni delle app cloud è significativa. Un ampio studio longitudinale su 2.366 benchmark su 789 cluster AWS Kubernetes ha trovato una variabilità complessiva inferiore a 3.7%, con sottili effetti legati all'ora del giorno e al fine settimana, secondo questo studio sulla variabilità delle prestazioni cloud. È un promemoria utile per evitare di reagire eccessivamente a piccole fluttuazioni, prendendo comunque sul serio le regressioni nella coda.
Non chiederti se le prestazioni cloud siano casuali. Chiediti come appare il rumore di misurazione normale per il tuo sistema, poi imposta alert per le variazioni che lo superano.
Osservabilità per le app cloud senza il data swamp
Molti ingegneri hanno la telemetria, ma spesso non riesce a rispondere abbastanza in fretta alla domanda tipica dell'on-call. Per gli aggiornamenti mobile ibridi, la domanda utile è di solito specifica: perché questo dispositivo è rimasto sul vecchio bundle, perché il nuovo non è stato applicato, o perché l'avvio è diventato più lento dopo un rilascio?
Tracce, log e metriche sono necessari. Spesso non sono sufficienti.
Costruisci lo stack attorno a un unico percorso di release
Uno stack di osservabilità pratico per le prestazioni delle app cloud dovrebbe permetterti di seguire un tentativo di aggiornamento dal dispositivo al backend e viceversa.
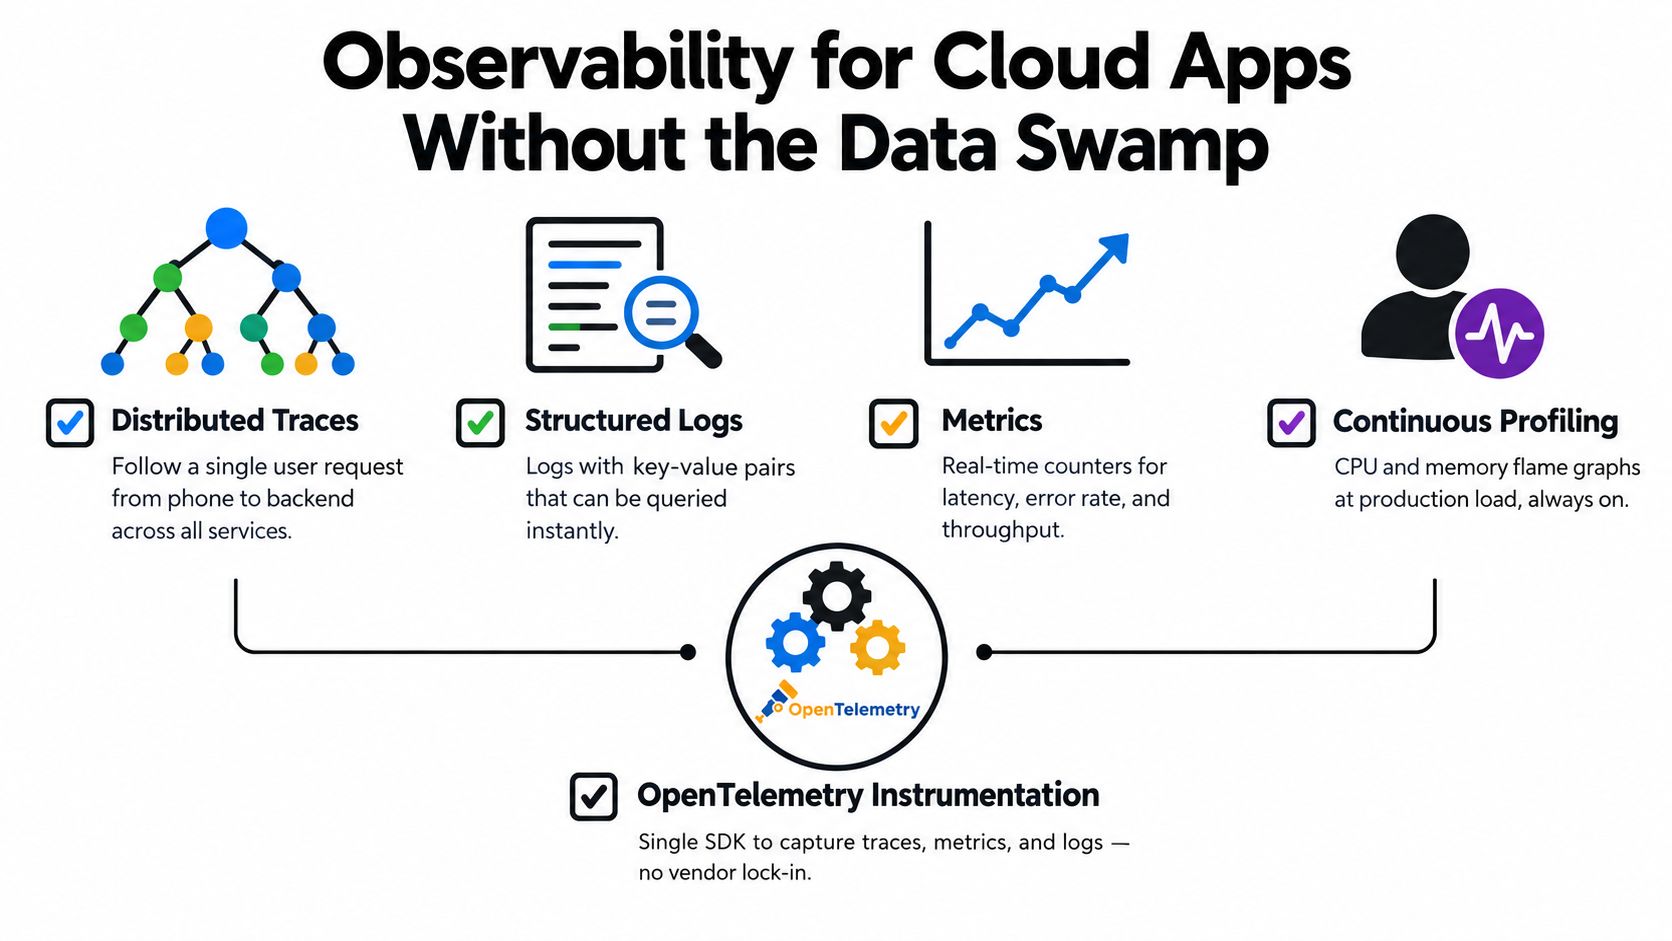
Strumentare il bridge mobile e il client di aggiornamento con OpenTelemetry tag per versione dell'app, canale di rilascio, piattaforma e risultato dell'aggiornamento. Strutturare i log in modo da poter interrogare un ID di aggiornamento o una sessione di dispositivo senza ricerche testuali approssimative. Mantenere le metriche focalizzate su latenza, tasso di errore, adozione ed eventi di rollback.
Per i team che stanno standardizzando questi elementi, questa panoramica su l'osservabilità delle applicazioni per app rilasciate è un buon riferimento per l'implementazione.
Il quarto segnale mancante
Uno dei cambiamenti più utili nelle linee guida moderne sull'APM è l'idea che tracce, metriche e log lascino ancora un vuoto diagnostico. Il profiling continuo è sempre più considerato il quarto segnale, perché mostra la funzione esatta che consuma CPU, memoria o tempo di lock, come descritto in questo guida al monitoraggio delle prestazioni e al profiling delle applicazioni.
Questo è importante nei flussi di lavoro di live update. Una traccia potrebbe mostrare che "apply update" ha richiesto troppo tempo. Il profiling può rivelare se il collo di bottiglia era la decompressione del bundle, il parsing JSON, l'inizializzazione del bridge o un lock in un percorso di avvio.
Mantieni il sistema leggibile alle 2 di notte
Usa un piccolo insieme disciplinato di viste:
- Dashboard del canale di rilascio: adozione, fallimenti, numero di rollback
- Traccia della transazione di aggiornamento: dal fetch del manifest alla valutazione del bundle
- Principali regressioni all'avvio: raggruppate per versione dell'app e piattaforma
- Vista di profiling: funzioni più critiche durante l'applicazione dell'aggiornamento e il primo render
Se il tuo team sta affinando il proprio modello operativo DevOps e SRE attorno a questi workflow, è utile vedere come nexus IT group eroga devops poiché lo studio di caso inquadra l'osservabilità come pratica operativa, non come semplice acquisto di tool.
Il dashboard migliore è quello che un ingegnere on-call apre davvero, capisce e su cui agisce prima che il supporto scriva il riepilogo dell'incidente per lui.
SLA, error budget e rollout basati sui channel
Il linguaggio degli SLA suona pulito in un contratto e disordinato in produzione. I team mobili di solito lo scoprono durante un rilascio problematico. "Alta disponibilità" sembra rassicurante finché non devi decidere se continuare a spedire aggiornamenti mentre gli utenti in una regione non riescono a recuperare il bundle corrente.
Trasforma gli obiettivi di disponibilità in policy di rilascio
Usa gli obiettivi di disponibilità per definire le fasi di rollout, non solo promesse ai clienti.
| Obiettivo di disponibilità | Budget mensile di downtime | Fase di rollout adatta |
|---|---|---|
| 99% | Circa 7 ore e 18 minuti | Canali interni e sperimentali |
| 99.9% | Circa 43 minuti | Rollout beta e produzione scaglionata |
| 99.99% | Circa 4 minuti e 23 secondi | Produzione estesa per i percorsi business-critical |
I budget di downtime derivano da semplici calcoli mensili. Nella pratica si riducono ulteriormente se consideri l'intera catena di distribuzione. Il tuo origin può essere sano, ma DNS, propagazione edge o una regola di canale errata impediscono comunque ai dispositivi di ricevere il rilascio previsto.
Se cerchi un esempio concreto di come una piattaforma di update gestisce questo aspetto operativo, consulta lo SLA del servizio Capgo e confrontalo con le tue ipotesi sugli incidenti.
Gli error budget sono il punto d'incontro tra prodotto e affidabilità
Un error budget dà al team una struttura decisionale. Se il burn rate è basso, puoi accettare qualche rischio nel rilascio. Se il burn aumenta dopo una hotfix, metti in pausa la promozione al canale successivo.
Una scala di rollout efficace per le app ibride di solito è questa:
- Interno: gli ingegneri verificano che manifest, firma e flusso di applicazione dell'aggiornamento funzionino come previsto
- Beta: utenti di fiducia e tester intercettano guasti sui dispositivi edge
- Produzione graduale: un pubblico limitato riceve prima il bundle
- Produzione completa: l'update diventa il target predefinito del canale
Lo stesso rigore si applica a feature flag, aggiornamenti JavaScript over-the-air o entrambi.
Configura i trigger di rollback prima che servano
Le regole di rollback devono essere esplicite e prevedibili. Non improvvisarle durante un incidente.
I trigger più utili includono:
- L'adozione si blocca inaspettatamente: i dispositivi fanno il check-in ma non passano al nuovo bundle
- La latenza di startup peggiora bruscamente per gli utenti tail: specialmente su dispositivi datati o reti più lente
- I fallimenti si concentrano su una singola piattaforma o versione: spesso è un mismatch nel bridge o nel packaging
- Il real user monitoring mostra un'esperienza degradata: i check sintetici possono ignorare i problemi specifici del mobile
Comunica le violazioni in modo semplice. Di' cos'è fallito, chi è stato colpito, quale canale è stato messo in pausa, quale rollback è stato fatto e quando sarà il prossimo punto decisionale. Gli stakeholder non hanno bisogno di un dump di telemetria. Hanno bisogno di chiarezza operativa.
Portare nella pratica le performance delle Cloud App
Il modo più veloce per migliorare le performance delle cloud app è smettere di considerarle un progetto di vanità infrastrutturale. Agli utenti non interessa il tuo cache hit ratio, a meno che non cambi quello che provano. Al Product non interessa la CPU dell'origin, a meno che non cambi la velocità con cui una fix arriva sui dispositivi colpiti.
Scegli una metrica user-facing questa settimana e rendila concreta.
Una sfida di una settimana che vale la pena tentare
Scegli una metrica con un impatto chiaro sull'utente. Ottime opzioni sono il tempo di interattività al primo avvio dopo un controllo aggiornamenti, o il tempo di download del bundle per gli utenti più lenti in un canale di produzione.
Poi, segui questi quattro passaggi:
- Misura una baseline: Usa il real user monitoring, non solo test sintetici.
- Applica un singolo cambiamento mirato: Ad esempio, riduci la dimensione del bundle, precomputa l'output del manifest o affina le regole di edge caching.
- Distribuisci tramite un canale di staging: Monitora l'adozione e i fallimenti prima del rollout globale.
- Rimisura la stessa metrica: Se il risultato percepito dall'utente non è migliorato, l'ottimizzazione non è servita a molto.
Questa checklist racchiude l'ordine di priorità corretto per la maggior parte dei team mobile:
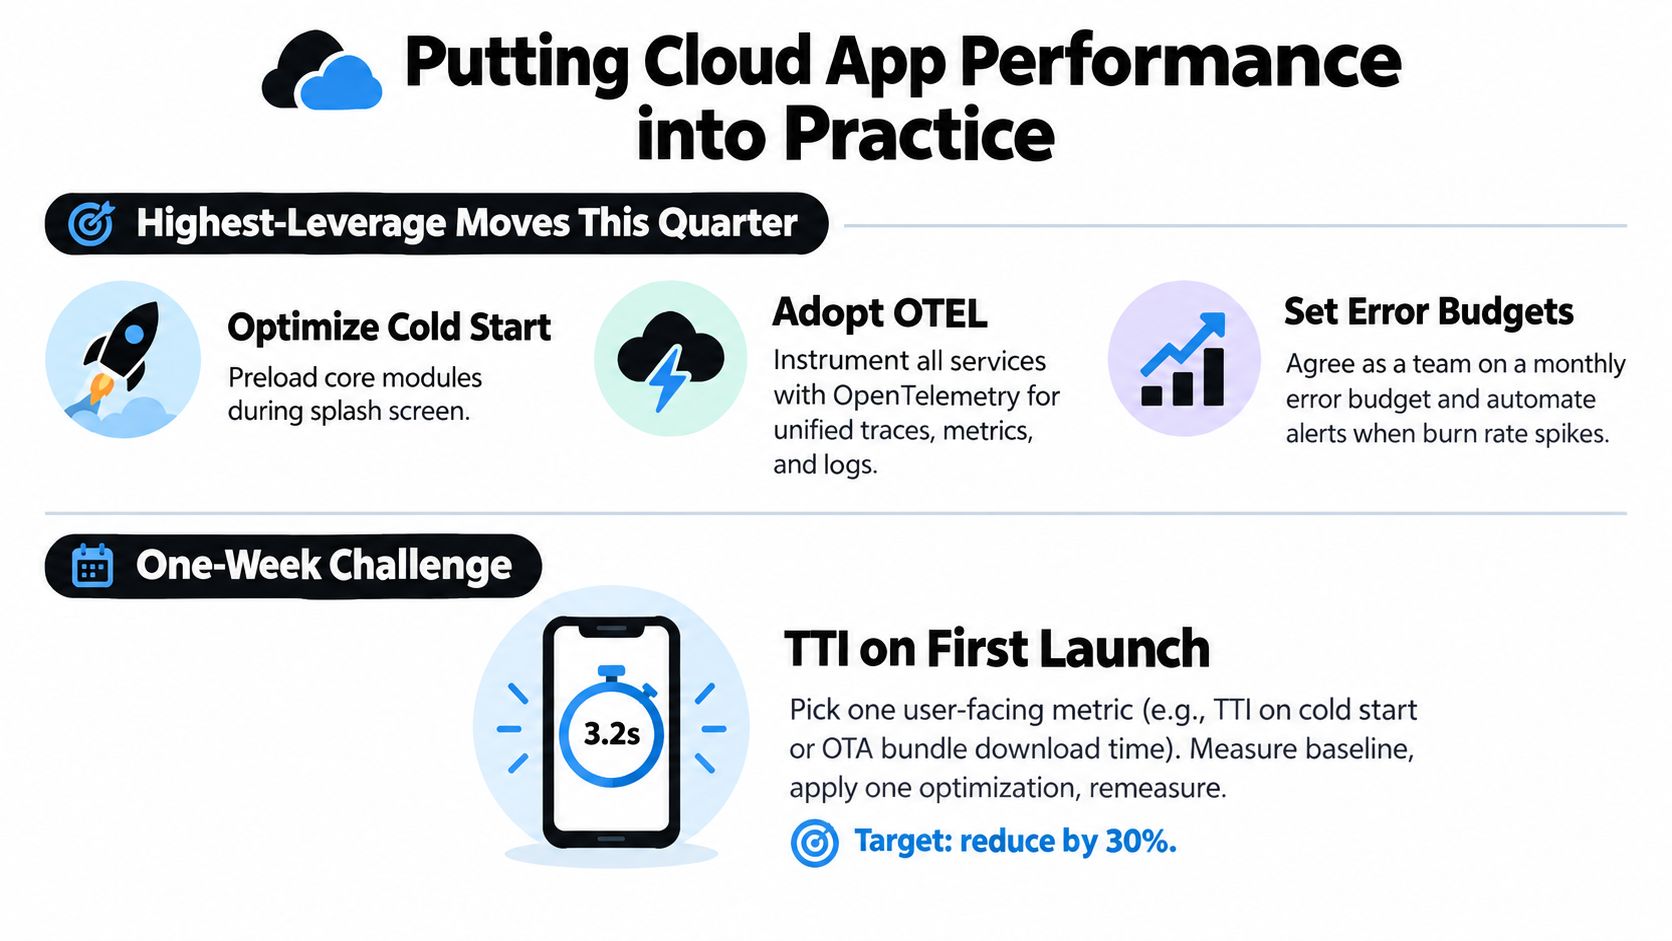
Le mie priorità per questo trimestre
Inizia dalle attività che riducono più rapidamente il dolore da incidenti:
- Valida il comportamento dell'edge cache: Assicurati che la freschezza del manifest e l'invalidazione del bundle seguano il tuo runbook.
- Audita dimensione del bundle e costo di startup: Contano sia la velocità di delivery sia quella di valutazione.
- Crea dashboard P95 per il flusso di update: Non fermarti alle medie.
- Monitora l'error budget burn per canale: Affidabilità e velocità di rilascio devono condividere lo stesso scoreboard.
- Scrivi il runbook di rollback: Includi trigger, responsabili e passaggi di comunicazione.
Se ti serve un esempio concreto di tool in questa categoria, Capgo è un'opzione per i team Capacitor ed Electron che necessitano di live update firmati, controllo del rollout basato su canali, log per dispositivo e supporto al rollback, distribuiti tramite una rete edge globale. La parte importante non è il nome del vendor. È scegliere un workflow in cui puoi pubblicare, osservare e annullare un update senza aspettare la revisione dello store quando il problema riguarda il code distribuito via web.
La misurazione disciplinata batte l'ingegneria eroica. È meglio migliorare una metrica visibile in una settimana che sprecare un trimestre a rifinire numeri di backend che non cambiano mai l'esperienza degli utenti.
Se il tuo team rilascia app Capacitor e desidera un controllo più stretto su distribuzione live update, osservabilità, rollout progressivi e sicurezza dei rollback, Capgo è progettato per questo workflow. Ti permette di distribuire aggiornamenti firmati di JavaScript, CSS, config e asset al di fuori della revisione dello store, per poi monitorare adozione e fallimenti con la precisione necessaria per rendere le prestazioni delle app cloud operative anziché teoriche.


