

Un rilascio va online, i primi utenti aprono l'app e il canale degli incidenti inizia a muoversi più velocemente di quanto chiunque riesca a leggere. I crash report aumentano, l'autenticazione fallisce per una parte dei clienti e il supporto chiede se il team può semplicemente “annullare” il deployment. Senza una policy di rollback già pronta, gli ingegneri sono costretti a decidere sotto pressione quale versione sia sicura, chi possa autorizzare il cambio e se il rollback di un livello possa romperne un altro.
Un rollback non è un pulsante magico per annullare. In un'applicazione ibrida, il web bundle, la native shell, lo schema del backend e i dati locali in cache possono avere cicli di rilascio diversi. Una policy concreta deve quindi controllare l'esposizione, conservare le evidenze e ripristinare un'esperienza utente compatibile, non limitarsi a ridistribuire un artifact più vecchio.
Indice dei contenuti
- Perché la protezione tramite rollback conta per i team mobile
- Capire le cause profonde dei fallimenti di deployment
- Componenti essenziali di una politica di rollback
- Strategie di rollback automatiche vs manuali
- Governance e requisiti di audit per i rollback
- Workflow di esecuzione rollback passo dopo passo
- Misurare l'efficacia del rollback e i tassi di errore
Perché la protezione tramite rollback conta per i team mobile
Il primo errore che i team commettono durante un incidente in produzione è considerare la velocità come l'unico obiettivo. Un rollback rapido di un artefatto errato può causare un secondo incidente, soprattutto quando un bundle JavaScript si aspetta funzionalità native che il binario installato non fornisce. L'obiettivo più sicuro è il ritorno più rapido e verificato a uno stato noto e funzionante.
Uno studio empirico fondamentale ha esaminato 345 release di produzione di una grande applicazione web e-commerce per circa 1,5 anni. Tra le 320 release con dati completi sull'esito, 248 release, ovvero il 77,5%, si sono concluse senza problemi, mentre 72 release, ovvero il 22,5%, sono state classificate come malriuscite perché hanno causato comportamenti anomali come crash, blocchi o prestazioni scarse subito dopo il deployment. I ricercatori hanno identificato 17 root cause ricorrenti in quattro macro categorie, il che dimostra perché la preparazione al rollback non può concentrarsi solo sui difetti del source-code. Lo studio sul rollback delle release offre ai team mobile una lezione operativa utile: il rischio di release è normale al punto da richiedere una risposta strutturata.
L'esposizione non equivale al ripristino
La distribuzione mobile rende ambiguo il termine “rollback”. Mettere in pausa un rollout graduale blocca ulteriore esposizione. Disabilitare un feature flag impedisce l'esecuzione di un percorso code. Revertire un web bundle live cambia ciò che scaricano i binari compatibili installati. Forzare un aggiornamento del binario chiede agli utenti di installare un nuovo pacchetto nativo, che può dipendere dalla revisione degli store, dall'adozione e dalla volontà dell'utente di aggiornare.
Un rollback dello store non può rimuovere un binario già installato su un dispositivo. Un fix d'emergenza può richiedere da 24 a 72 ore per raggiungere gli utenti interessati a causa dei ritardi di revisione e adozione, secondo le linee guida di mobile release engineering in questa guida al rollback per app ibride. Questo rende il rollback di un bundle live prezioso per difetti di JavaScript, CSS, testi, configurazione o asset, ma non rende reversibile la shell nativa.
Regola pratica: Definisci cosa intende il tuo team per rollback prima di un incidente. Fermare la distribuzione, revertire un bundle, disabilitare una feature e rilasciare un aggiornamento del binario sono azioni distinte con rischi diversi.
Una chiara strategia di disponibilità dovrebbe anche identificare quali user journey devono rimanere utilizzabili durante un incidente. Autenticazione, pagamenti, sincronizzazione dati e avvio dell'app meritano controlli specifici invece di essere nascosti dietro un'unica soglia di errore generica. I team che documentano queste distinzioni prima del rilascio possono ridurre l'incertezza quando arrivano i ticket di supporto, come guida alla disponibilità delle app mobile sottolinea anche.
Capire le cause profonde dei fallimenti di deployment
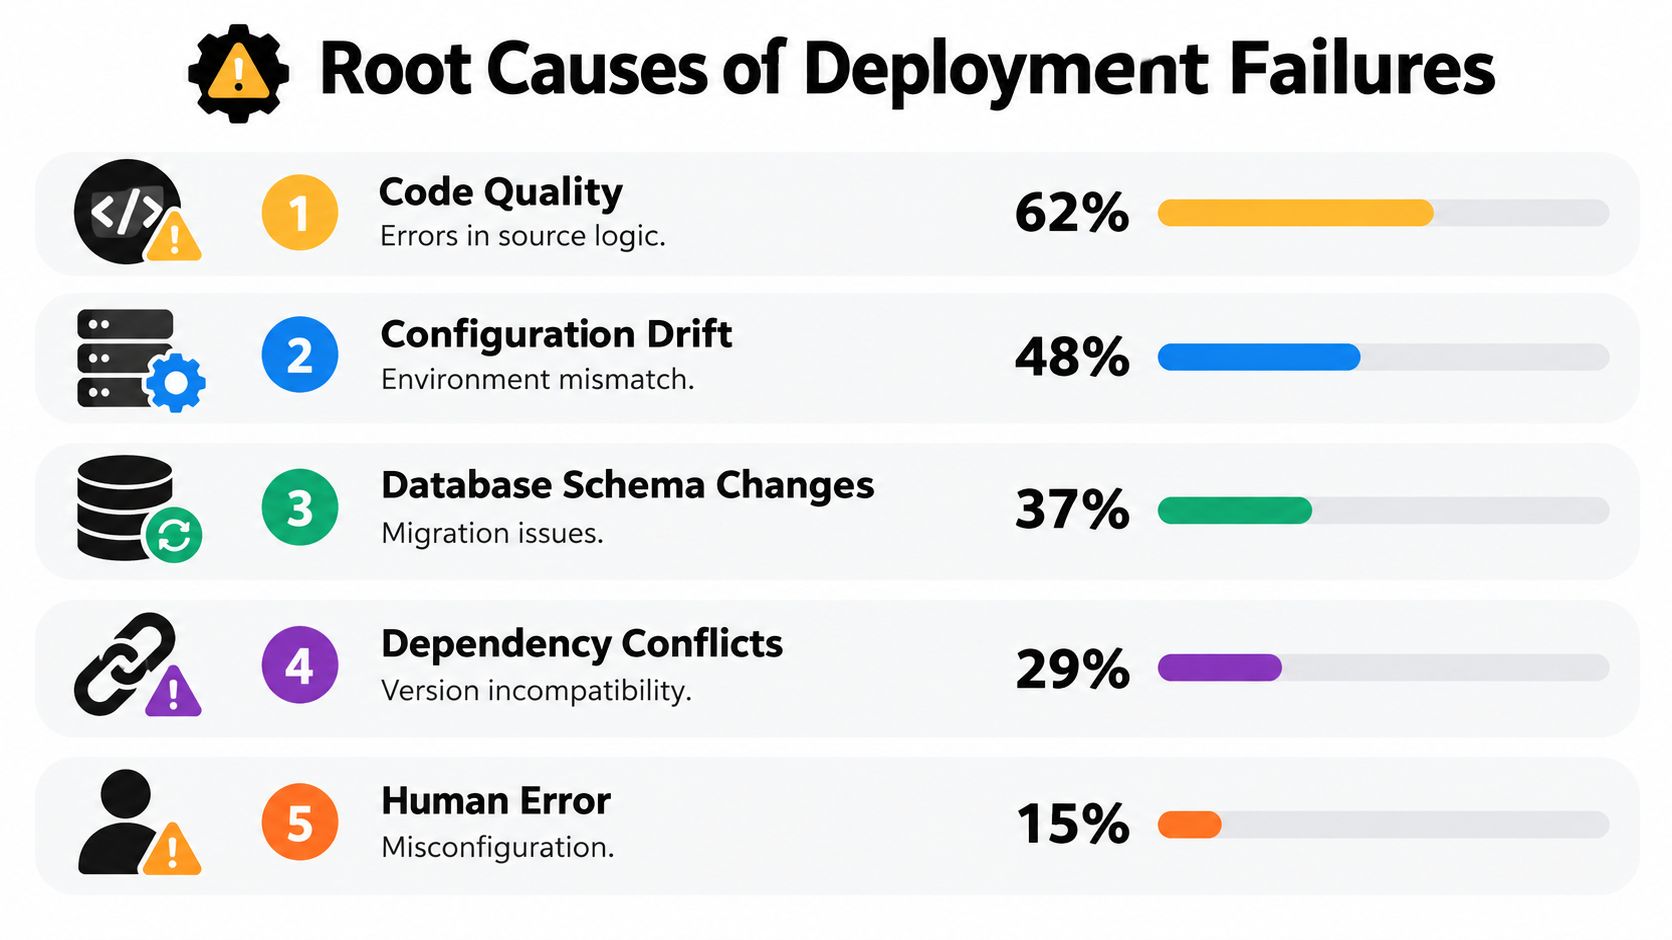
Una policy di rollback basata solo su "bad code" ignora i comuni scenari di errore in produzione. Uno studio empirico del 2022 su 152 incidenti gravi in produzione ha rilevato che i bug di code hanno causato 27.0% degli incidenti, guasti alle dipendenze, 16.4%, guasti dell'infrastruttura, 15.8%, errori di deployment, 13.2%e bug di configurazione 12.5%. La sua classificazione più ampia ha attribuito 40% degli incidenti a code o a bug di configurazione, mentre 60% riguardavano infrastruttura, deployment o dipendenze tra servizi. Lo studio sugli incidenti porta a una conclusione pratica: i trigger di rollback devono monitorare l'ambiente di delivery, non solo il binario dell'app o il web bundle live.
Progetta i trigger in base alle classi di errore
Un fallimento di una dipendenza può lasciare invariato il code dell'app mentre login, pagamenti o sincronizzazione smettono di funzionare. I problemi di infrastruttura possono causare avvii lenti o API non disponibili. Gli errori di deployment possono inviare l'artifact sbagliato al canale sbagliato, mentre i difetti di configurazione possono alterare il comportamento senza un nuovo commit del codice sorgente.
Le app ibride richiedono un'ulteriore distinzione. Un web bundle live può solitamente essere rimosso o sostituito senza cambiare la native shell installata. Un difetto di compatibilità nativa può richiedere un aggiornamento del binario, che non può essere annullato servendo un bundle precedente. Il trigger deve quindi identificare il layer che fallisce prima di scegliere la risposta.
Lo studio ha rilevato che il rollback è una delle strategie di mitigazione più diffuse. Gli incidenti legati alla configurazione sono stati particolarmente rivelatori: 47% mitigati tramite rollback, rispetto a 21% risolti con una vera correzione della configurazione, come riportato dallo stesso studio sugli incidenti. Ciò non rende il rollback automatico adatto a ogni incidente di configurazione. Dimostra che uno stato di release noto come valido può fornire un confine a breve termine più sicuro rispetto a modificare un valore live mentre gli utenti sono coinvolti.
Una matrice di trigger utile separa i sintomi dalle probabili cause:
| Segnale | Criticità probabile | Prima risposta |
|---|---|---|
| Errori all'avvio | Problemi di bundle, compatibilità nativa o inizializzazione | Blocca l'esposizione e valuta il rollback |
| Errori di autenticazione | Incompatibilità di configurazione, identity provider o API | Sospendi il rollout e verifica le dipendenze |
| Errori di pagamento | Contratto backend, comportamento client o configurazione feature | Richiedi approvazione manuale prima di cambiare l'esposizione |
| Corruzione dei dati | Incompatibilità di migrazione o persistenza | Proteggi i dati prima di fare rollback |
| Incidente di sicurezza | Artifact o percorso di distribuzione compromesso | Revoca l'esposizione, conserva le prove e segui le procedure di sicurezza |
La matrice non sostituisce le soglie. Definisce quali segnali possono attivare un'azione meccanica e quali richiedono un'indagine. I tassi di crash possono supportare una risposta automatica, mentre i fallimenti dei pagamenti o la corruzione sospetta richiedono in genere un owner esplicito.
L'analisi dei guasti deve coprire il targeting dei canali, le firme degli artifact, gli identificativi di build, i lockfile delle dipendenze, la compatibilità degli schemi, il comportamento della cache e il tempo di rilevamento. Negli ambienti fintech regolamentati, conserva la decisione, la versione dell'artifact, le prove osservate, l'approvatore e l'azione risultante in modo che il rollback possa essere ricostruito durante la revisione. I team che formalizzano questo lavoro possono usare tecniche di analisi dei guasti per incidenti di rilascio come riferimento pratico.
Componenti essenziali di una politica di rollback
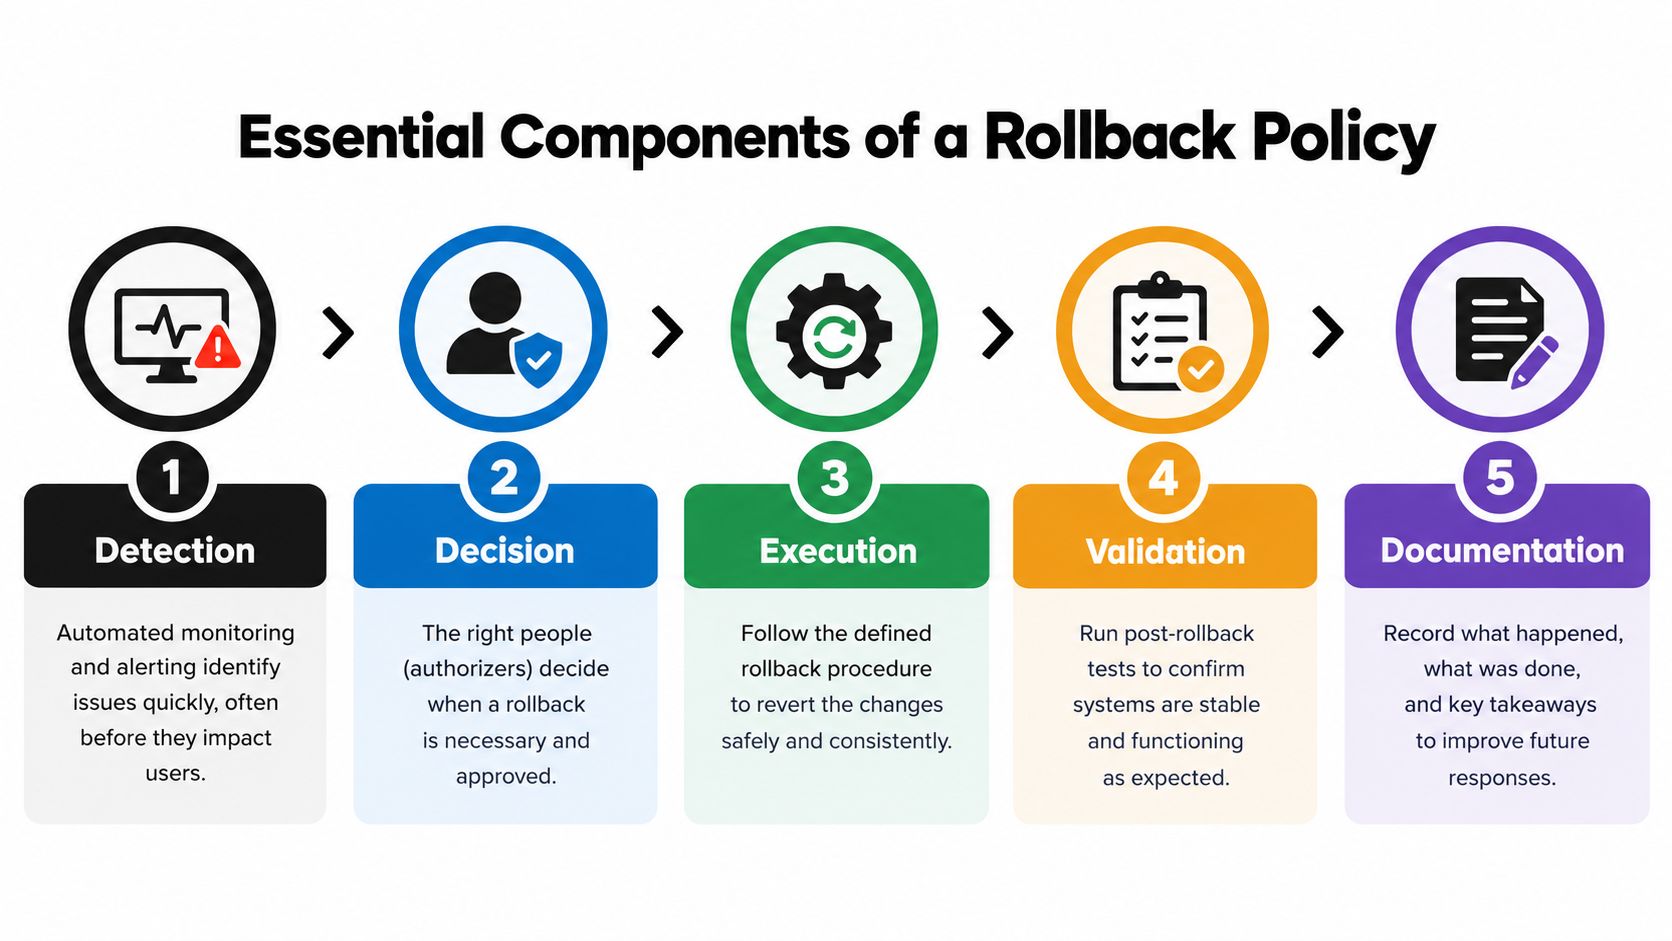
Una policy di rollback matura è un accordo operativo tra ingegneria, sicurezza, prodotto e supporto. Indica cosa può accadere automaticamente, cosa richiede approvazione, quali artefatti restano disponibili e quali evidenze devono sopravvivere all'incidente. Un singolo comando di redeploy non offre quel livello di controllo.
Rileva con segnali oggettivi
Strumenta ogni release con un build identifier, il commit sorgente, il channel, la cohort e il timestamp di deployment. Monitora il completamento dell'avvio, il comportamento in caso di crash, l'autenticazione, le chiamate API critiche e i workflow di business. Usa soglie commisurate al danno del failure, non una percentuale di errore generica applicata a ogni feature.
Decidi con autorità designata
Metti per iscritto chi può sospendere la delivery, chi può autorizzare un rollback e chi deve essere notificato. In caso di regressione all'avvio a basso rischio, un ingegnere on-call potrebbe dover avere l'autorità per interrompere subito l'esposizione. Un sospetto problema ai dati o alla sicurezza deve attivare l'incident command e conservare un registro chiaro delle approvazioni.
Esegui uno switch di versione immutabile
Conserva più versioni precedenti deployabili di software applicativo, configurazione, firmware e documentazione di supporto. NIST SP 800-53 raccomanda di conservare un numero di configurazioni baseline precedenti definito dall'organizzazione e richiede una pianificazione di contingenza per definire obiettivi di recovery, priorità di ripristino, responsabilità e risultati misurabili. Le sue linee guida su contingenza e configurazione supportano l'archiviazione di bundle immutabili e versionati, invece di affidarsi a una directory “previous” sovrascritta.
Per le app ibride, includi metadati di compatibilità, verifica crittografica dell'integrità e switch atomico dei canali. La retention deve considerare l'individuazione ritardata dei difetti e l'esposizione graduale, non solo l'ultimo rilascio. Un artefatto di rollback non autenticabile o che non corrisponde alla shell nativa non è una risorsa di recupero.
Valida i comportamenti critici per il business
Dopo lo switch, testa l'avvio dell'app, l'autenticazione, i pagamenti, la sincronizzazione, la gestione delle push e qualsiasi workflow legato ai dati locali. La validazione deve utilizzare i canali e le versioni dei client interessati, perché un test di staging andato a buon fine potrebbe non rappresentare uno stream di produzione specifico per il cliente.
Documenta il risultato
Registra trigger, decisione, operatore, identità dell'artefatto, popolazione interessata, timestamp, versione ripristinata e esito della validazione. Per i team che formalizzano i controlli operativi in ambienti sensibili, le best practice di change management per le cliniche forniscono un contesto utile su approvazioni, comunicazione e tracciabilità.
Un'esercitazione di rollback dovrebbe testare l'intera catena. NIST raccomanda di testare i piani di contingenza, incluso il recupero e la ricostruzione a uno stato noto. Il test deve verificare rilevamento, autorità, targeting, telemetria, comportamento delle sessioni utente, escalation e raccolta delle prove. I team possono anche rivedere Guida alla configurazione del rollback di Capacitor quando si traducono questi controlli in un workflow di live-update.
Strategie di rollback automatiche vs manuali
L'automazione è eccellente nel rispondere a un guasto evidente e misurabile. È invece scarsa nell'interpretare incidenti ambigui, dove un rollback del client potrebbe peggiorare un'incompatibilità del backend. La scelta giusta non è “automatizzato o manuale” per l'intero sistema, ma una divisione basata sul rischio tra azioni sicure da ripetere e azioni che richiedono giudizio.
Dove l'automazione ha senso
Il rollback automatico funziona bene quando il segnale è rapido, specifico e strettamente legato al nuovo artifact. Esempi includono un'app che non supera il callback di readiness all'avvio, un'eccezione critica di inizializzazione, un controllo di compatibilità non superato o una regressione netta in una cohort controllata. Il sistema può bloccare il rollout, ripristinare il bundle compatibile precedente e avvisare l'engineer on-call mentre l'impatto è contenuto.
L'automazione deve essere idempotente. Ripetere l'azione non deve creare una sequenza di cambiamenti di stato imprevedibili. Deve anche avere dei guardrail:
- Fissa il target: Ripristina un artifact firmato identificato da una versione immutabile, non la build che per caso è etichettata come “previous”.
- Limita lo scope: Applica l'azione al canale o alla cohort interessata, a meno che non emergano difetti più estesi.
- Conserva la traccia: Logga automaticamente il trigger, la soglia, la regola decisionale e la versione ripristinata.
- Testa il fallback: Conferma che il bundle precedente possa inizializzarsi con la shell nativa e il backend attualmente in uso.
Il rollback automatico può generare falsi positivi. Un'interruzione temporanea di una dipendenza potrebbe risolversi prima del completamento del rollback di un bundle, e un gap nella telemetria regionale potrebbe sembrare un errore del client. Un'azione automatizzata dovrebbe quindi, se possibile, sospendere prima l'esposizione e procedere al rollback solo quando il segnale è sufficientemente chiaro.
Dove devono decidere le persone
L'approvazione manuale è indicata per errori di pagamento, possibili corruzioni dei dati, problemi di sicurezza, modifiche irreversibili allo schema e incidenti che coinvolgono più generazioni di client. Un ingegnere deve stabilire se il bundle precedente può leggere in sicurezza i dati scritti dal nuovo, se il backend supporta ancora il vecchio contratto e se i canali specifici per cliente hanno dipendenze diverse.
L'intervento manuale è più lento e più variabile, ma questo attrito può evitare che un rollback tecnicamente pulito danneggi i record o rompa un servizio già migrato. La policy dovrebbe indicare chi approva e fornire un breve registro decisionale, senza lasciare l'ingegnere on-call a cercare in un documento di controllo degli accessi durante un'interruzione.
Mettere in pausa il rollout è spesso la mossa iniziale più sicura. Riduce l'esposizione alle nuove versioni mentre il team decide se il recupero corretto sia un rollback, la disattivazione di una feature o un fix in avanti.
Per i team che usano il rilascio graduale, distinguere tra l'arresto di un rollout progressivo e il rollback di una versione già attiva. Confronto tra pausa del rollout e rollback aiuta a inquadrare questa differenza. La policy dovrebbe rendere esplicita la distinzione sia negli strumenti sia nel linguaggio degli incidenti.
Governance e requisiti di audit per i rollback
In un ambiente regolamentato, "l'app funziona di nuovo" è solo una parte di un rollback riuscito. L'organizzazione deve anche dimostrare cosa è cambiato, chi ha approvato la risposta, quali clienti hanno ricevuto l'artefatto e se lo stato ripristinato ha mantenuto i controlli richiesti.
Un registro delle prove difendibile inizia con l'identità dell'artefatto. Conserva il digest del bundle firmato o del binario, il commit sorgente, i metadati di build, il canale di rilascio, la dichiarazione di compatibilità e l'approvazione della pubblicazione. Collega poi quell'artefatto ai dati sull'esposizione, incluse le popolazioni di dispositivi o tenant interessati, lo stato del rollout e il momento in cui il team ha sospeso o annullato la distribuzione.
Preserva la traccia delle decisioni
L'identità dell'operatore conta, ma anche il ragionamento. Conserva la telemetria che ha innescato l'evento, la valutazione delle soglie, la timeline dell'incidente, il timestamp dell'approvazione, l'azione eseguita, la versione ripristinata e i controlli post-rollback. Se il team ha scelto di non eseguire il rollback, conserva anche quella decisione e la relativa giustificazione.
I canali specifici per il cliente richiedono un trattamento separato. Un tenant fintech potrebbe ricevere una combinazione di configurazioni o funzionalità non presente nel flusso di produzione generale. Revertire il canale globale senza verificare il targeting dei tenant può creare comportamenti incoerenti, oscurare chi è stato colpito o lasciare un cliente su una versione non validata dal team di incident response.
Proteggi i dati e i workflow di compliance
Un rollback del client non può annullare una migrazione del database che ha già modificato lo stato di produzione. Prima di approvare un'inversione, verifica se il client più vecchio può leggere i record attuali, se le migrazioni sono reversibili e se i dati locali in cache contengono campi o formati sconosciuti al bundle precedente. Se la compatibilità non è garantita, la risposta corretta potrebbe essere disabilitare l'esposizione e rilasciare una correzione forward piuttosto che forzare un downgrade del client.
La responsabilità tecnica e quella di compliance devono incontrarsi qui. I record dei pagamenti, i dati dei pazienti, le decisioni di accesso, gli eventi di audit e la lineage dei dati necessitano di validazione dopo il recupero. Un rollback che ripristina la schermata ma perde la tracciabilità non è un recupero conforme.
Le linee guida sulla supply chain sottolineano anche l'importanza di gateway di aggiornamento controllati, canali approvati, deployment graduale, trigger di rollback e revoca rapida. L'advisory sulla supply chain di Sygnia offre un contesto rilevante per le organizzazioni che progettano controlli di accesso e prove per gli aggiornamenti software.
Workflow di esecuzione rollback passo dopo passo
Un rollback dovrebbe leggersi come un runbook, non come un'improvvisazione eroica. La sequenza seguente presuppone che il team possa separare il controllo dell'esposizione dal ripristino dell'artifact e identificare i limiti di compatibilità prima di modificare lo stato in produzione.
-
Dichiara l'incidente e blocca la nuova esposizione. Assegna un incident lead, registra l'identificativo del rilascio e metti in pausa il rollout o il canale interessato. Non permettere ad altri dispositivi di ricevere un artifact mentre il team sta ancora definendo l'ambito dell'incidente.
-
Conferma il segnale di errore. Confronta la coorte interessata con una coorte funzionante. Controlla l'avvio, l'autenticazione, le API critiche e il comportamento delle sessioni utente. Un picco di telemetria potrebbe indicare un problema di osservabilità piuttosto che un difetto del client.
-
Mappa il limite di compatibilità. Identifica la versione della native shell, il web bundle, il contratto backend, lo stato dello schema e il formato dei dati locali. Conferma che il rollback candidato possa avviarsi e funzionare con i servizi attualmente deployati.
-
Seleziona e autentica l'artifact target. Scegli una versione immutabile e firmata con un identificativo di build registrato. Non affidarti mai a una copia locale non verificata o a un'etichetta informale "ultimo rilascio".
-
Scegli l'azione di ripristino. Metti in pausa la distribuzione, disabilita una feature, ripristina il web bundle, forza uno stato di manutenzione o avvia un forward binary fix. Usa l'azione meno impattante che rimuova il comportamento non sicuro senza creare un mismatch di versioni.
-
Esegui entro l'ambito approvato. Applica prima la modifica al canale o alla popolazione di tenant interessati quando le evidenze supportano un ripristino mirato. Mantieni operatore, ora, motivo e artefatto visibili nel record dell'incidente.
-
Valida i flussi critici. Testa l'avvio, il login, i pagamenti, la sincronizzazione, le operazioni di lettura/scrittura dati e qualsiasi workflow che ha causato l'incidente. Testa su shell native e canali cliente rappresentativi, non solo sul dispositivo di un ingegnere.
-
Espandi o chiudi deliberatamente. Se la validazione va a buon fine, continua a monitorare e decidi se ripristinare una distribuzione più ampia. Se fallisce, interrompi l'espansione dell'esposizione e passa a un forward fix o a un rollback del servizio più profondo.
Un runbook utile descrive anche chi è responsabile di ogni passaggio. I team che sviluppano automazioni operative possono consultarlo Guida CIO ai workflow agentici per un contesto più ampio su azioni delegate, approvazioni ed esecuzione tracciabile, quindi adatta tali principi alle operazioni di rilascio.
Misurare l'efficacia del rollback e i tassi di errore
Contare solo i rollback fornisce un quadro fuorviante. Un team potrebbe registrare pochi rollback perché il rilevamento è debole, perché gli ingegneri tollerano rilasci degradati o perché ogni incidente diventa un'emergenza da risolvere con un forward fix. La misurazione dell'affidabilità deve collegare il deployment originario alla risoluzione e al tempo necessario per ripristinare il servizio agli utenti.
DORA definisce il change failure rate come la proporzione di deploy in produzione che richiedono un intervento immediato, come un rollback o un hotfix. Il calcolo è fallimenti di modifica divisi per il totale dei deploy, come documentato nelle linee guida DORA metrics. Registra l'identificativo del deploy, il commit o la build, il canale interessato, il trigger, il timestamp del rollback e l'ora di completamento del ripristino, in modo che la metrica rifletta il rilascio effettivo che ha causato il problema.
Misura l'impatto sugli utenti
Associa il change failure rate a misure che ne spieghino la gravità:
- Tempo di ripristino: Misura l'intervallo tra l'impatto confermato e il recupero validato.
- Raggio d'azione: Registra i canali, i tenant, i dispositivi e le versioni client interessati.
- Esposizione al momento del rilevamento: Registra quanto si era diffusa la release prima che il team la mettesse in pausa.
- Ricorrenza: Raggruppa gli incidenti per componente, dipendenza, area di configurazione e modalità di errore.
- Qualità della validazione: Registra quali flussi critici per il business sono stati ripristinati e quali sono rimasti compromessi.
Un basso tasso di rollback non è automaticamente un buon segno. Se il monitoraggio non rileva i fallimenti all'avvio o errori di pagamento specifici per singoli clienti, la dashboard può sembrare stabile mentre gli utenti subiscono il danno. Al contrario, frequenti rollback automatici possono indicare una protezione utile o rivelare soglie troppo sensibili.
Analizza le metriche dopo ogni incidente. Chiediti se il segnale è scattato abbastanza presto, se l'azione scelta era coerente con la classe di errore, se l'artifact di fallback era compatibile e se le prove erano sufficienti per una revisione di compliance. Metriche di aggiornamento in tempo reale per app Capacitor può aiutare i team a ragionare su adozione, fallimenti e visibilità per singolo dispositivo quando progettano quel feedback loop.
La policy più efficace trasforma il rollback da un pulsante di emergenza a un esperimento controllato. Ogni evento deve migliorare il targeting delle release, i controlli di compatibilità, la retention degli artifact, i percorsi di approvazione e la validazione del recovery. La velocità conta ancora, ma solo quando il team può dimostrare cosa è cambiato e perché gli utenti sono più sicuri dopo l'intervento.
Capgo permette ai team CapacitorJS ed Electron di pubblicare bundle firmati di JavaScript, CSS, configurazioni e asset su canali specifici, con cronologia delle versioni, osservabilità per singolo dispositivo e protezione automatica con rollback in caso di inizializzazione fallita. Visita Capgo per valutare un workflow di Live Update che separa il recupero del bundle dalla distribuzione del binario, offrendo al team una traccia di rilascio più chiara.





