

Una versión sale a producción, los primeros usuarios abren la app y el canal de incidentes empieza a moverse más rápido de lo que cualquiera puede leer. Los informes de fallos aumentan, la autenticación falla para un subconjunto de clientes y el equipo de soporte pregunta si pueden simplemente "deshacer" el despliegue. Sin una política de rollback preparada, los ingenieros se ven obligados a decidir bajo presión qué versión es segura, quién puede autorizar el cambio y si revertir una capa romperá otra.
Un rollback no es un botón mágico de deshacer. En una aplicación híbrida, el web bundle, el native shell, el esquema del backend y los datos locales en caché pueden tener ciclos de vida de release distintos. Por tanto, una política práctica debe controlar la exposición, preservar la evidencia y restaurar una experiencia de usuario compatible, no limitarse a volver a desplegar un artefacto antiguo.
Tabla de contenidos
- Por qué la protección contra rollback es clave para equipos móviles
- Entender las causas raíz de los fallos de despliegue
- Componentes esenciales de una política de rollback
- Estrategias de rollback: automatizadas vs. manuales
- Requisitos de gobernanza y auditoría para rollbacks
- Flujo de rollback paso a paso
- Medir efectividad y tasa de fallos de rollbacks
Por qué la protección contra rollback es clave para equipos móviles
El primer error de los equipos en una crisis de producción es priorizar solo la velocidad. Revertir rápido un artefacto incorrecto puede causar un segundo incidente, especialmente si un bundle de JavaScript espera una funcionalidad nativa que el binario instalado no ofrece. El objetivo más seguro es el retorno verificado más rápido a un estado válido conocido.
Un estudio empírico fundamental analizó 345 lanzamientos de producción en una gran aplicación web de e-commerce durante aproximadamente 1,5 años. Entre los 320 lanzamientos con datos completos de resultados, 248 releases, o el 77,5%, finalizaron sin problemas, mientras que 72 releases, o el 22,5%, se clasificaron como fallidos porque causaron comportamientos anómalos como crashes, cuelgues o bajo rendimiento poco después del despliegue. Los investigadores identificaron 17 causas raíz recurrentes en cuatro categorías generales, lo que demuestra que la preparación para un rollback no puede centrarse solo en defectos de source-code. El estudio de rollback de releases ofrece a los equipos móviles una lección operativa útil: el riesgo de los releases es lo bastante normal como para requerir una respuesta diseñada.
Exponer un fallo no es lo mismo que restaurar
La distribución móvil hace que el término “rollback” sea ambiguo. Pausar un despliegue gradual detiene la exposición adicional. Desactivar un feature flag evita que se ejecute una ruta code. Revertir un web bundle cambia lo que descargan los binarios instalados compatibles. Forzar una actualización de binario implica pedir a los usuarios que instalen un nuevo paquete nativo, lo que puede depender de la revisión de la tienda, la adopción y la disposición del usuario a actualizar.
Un rollback de tienda no puede eliminar un binario ya instalado en un dispositivo. Un forward fix de emergencia puede tardar de 24 a 72 horas en llegar a los usuarios afectados debido a los retrasos de revisión y adopción, según la guía de ingeniería de lanzamientos móviles en este blueprint de rollback para apps híbridasEso hace que el rollback de un bundle sea valioso para corregir defectos en JavaScript, CSS, textos, configuraciones o assets, pero no permite revertir el Native Build.
Regla práctica: Define qué significa rollback para tu equipo antes de que ocurra un incidente. Detener la entrega, revertir un bundle, desactivar una función y lanzar una actualización de binario son acciones distintas con riesgos diferentes.
Una estrategia de disponibilidad clara también debe identificar qué flujos de usuario deben seguir siendo utilizables durante un incidente. La autenticación, los pagos, la sincronización de datos y el arranque de la app merecen sus propias comprobaciones en lugar de ocultarse tras un umbral de error general. Los equipos que documentan estas distinciones antes del lanzamiento pueden reducir la incertidumbre cuando llegan los tickets de soporte, tal como guía de disponibilidad para apps móviles también lo enfatiza.
Entender las causas raíz de los fallos de despliegue
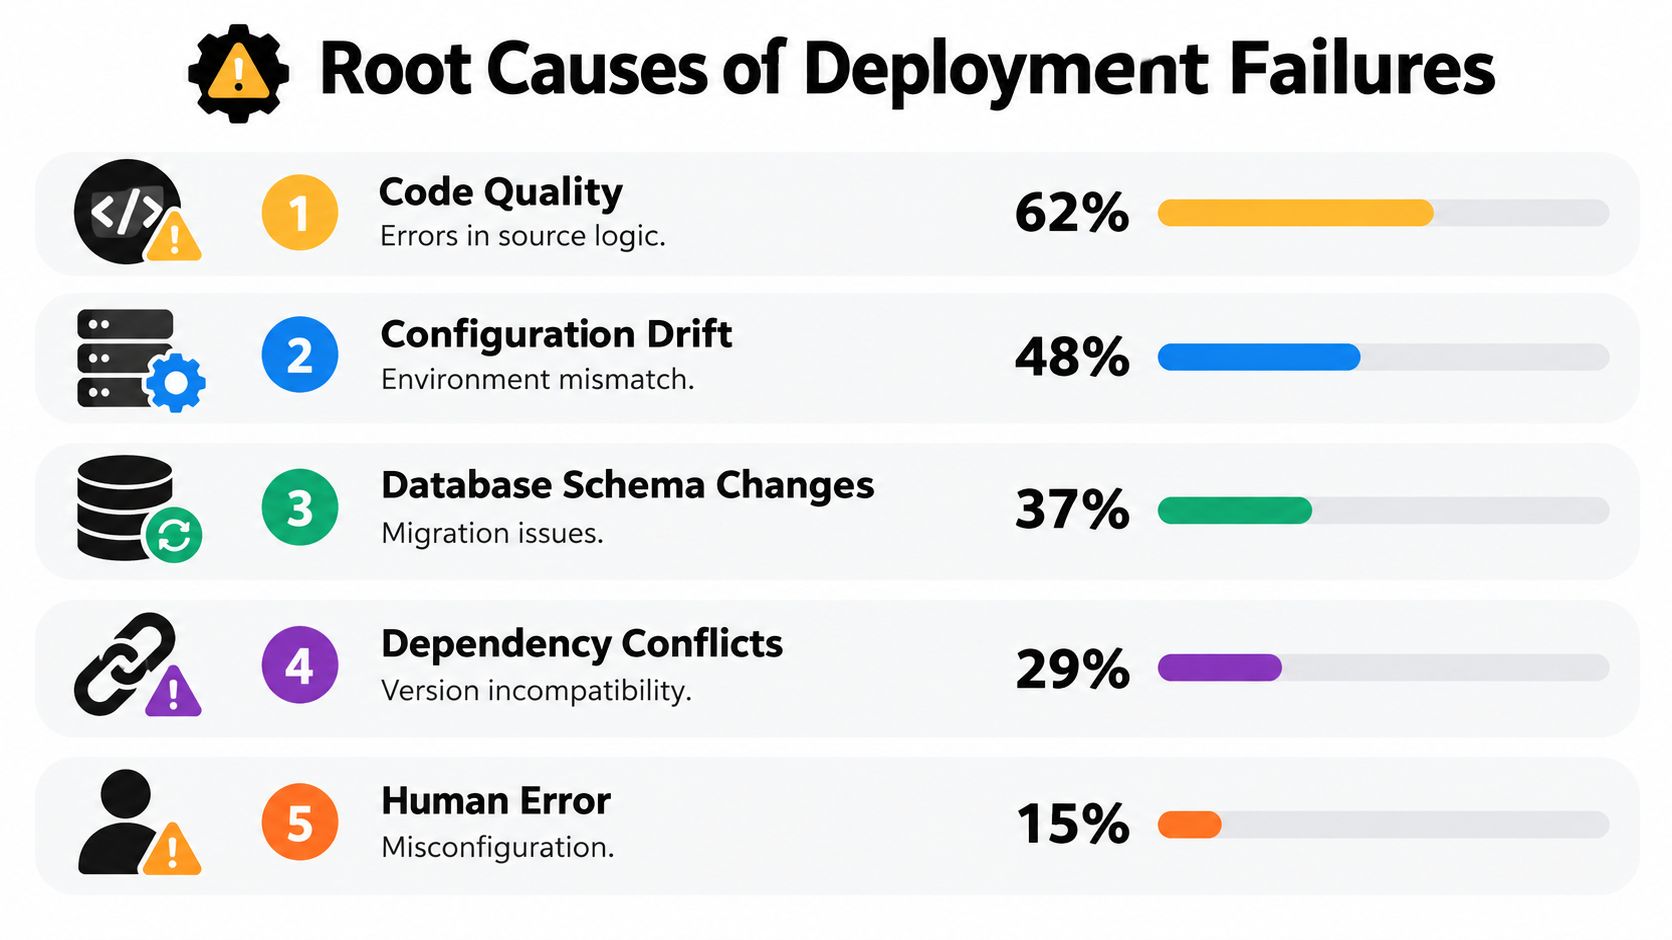
Una política de rollback basada solo en "mal code" ignora fallos comunes en producción. Un estudio empírico de 2022 sobre 152 incidentes de producción de alta severidad reveló que los bugs de code causaron 27.0% de los incidentes, fallos de dependencias, 16.4%fallos de infraestructura, 15.8%errores de despliegue, 13.2%y bugs de configuración 12.5%. Su agrupación más amplia atribuyó 40% de los incidentes a code o bugs de configuración, mientras que 60% involucraron infraestructura, despliegue o dependencias de servicios. El estudio de incidentes apoya una conclusión práctica: los triggers de rollback deben vigilar el entorno de entrega, no solo el binario de la aplicación o el bundle web en vivo.
Diseña disparadores según las clases de fallo
Un fallo de dependencia puede dejar code de la aplicación sin cambios, mientras que el inicio de sesión, los pagos o la sincronización dejan de funcionar. Los problemas de infraestructura pueden causar un arranque lento o APIs no disponibles. Los errores de despliegue pueden entregar el artefacto incorrecto al canal equivocado, mientras que los defectos de configuración pueden alterar el comportamiento sin un nuevo commit de código fuente.
Las apps híbridas requieren una distinción más. Un bundle web en vivo generalmente se puede retirar o reemplazar sin cambiar el shell nativo instalado. Un defecto de compatibilidad nativa puede requerir una actualización del binario, lo cual no se puede revertir entregando un bundle anterior. Por lo tanto, el disparador debe identificar la capa que falla antes de elegir una respuesta.
El estudio reveló que el rollback era una de las estrategias de mitigación más populares. Los incidentes relacionados con la configuración fueron especialmente reveladores: El 47% se mitigó mediante rollback, frente al 21% resuelto con una corrección real de la configuración, según informó el mismo estudio de incidentes. Eso no hace que el rollback automático sea adecuado para todos los incidentes de configuración. Demuestra que un estado de release validado puede ofrecer un límite a corto plazo más seguro que editar un valor en vivo mientras los usuarios se ven afectados.
Una matriz de triggers útil separa los síntomas de las causas probables:
| Señal | Posible problema | Primera respuesta |
|---|---|---|
| Fallos de inicio | Defecto en bundle, compatibilidad nativa o inicialización | Detener exposición y evaluar reversión |
| Errores de autenticación | Incompatibilidad de configuración, proveedor de identidad o API | Pausar rollout y verificar dependencias |
| Fallos de pago | Contrato de backend, comportamiento del cliente o configuración de feature | Requiere aprobación humana antes de cambiar la exposición |
| Corrupción de datos | Incompatibilidad de migración o persistencia | Protege los datos antes de revertir |
| Incidente de seguridad | Artefacto o ruta de entrega comprometidos | Revoca la exposición, preserva la evidencia y sigue los protocolos de seguridad |
La matriz no sustituye a los umbrales. Define qué señales pueden activar una acción mecánica y cuáles requieren investigación. Las tasas de crash pueden permitir una respuesta automática, mientras que los fallos de pago o la sospecha de corrupción suelen requerir un responsable explícito.
El análisis de fallos debe cubrir el targeting de canales, firmas de artefactos, identificadores de build, lockfiles de dependencias, compatibilidad de esquemas, comportamiento de caché y tiempo de detección. En entornos fintech regulados, preserva la decisión, la versión del artefacto, la evidencia observada, el aprobador y la acción resultante para que el rollback pueda reconstruirse durante la revisión. Los equipos que formalicen este proceso pueden usar técnicas de análisis de fallos para incidentes de release como referencia práctica.
Componentes esenciales de una política de rollback
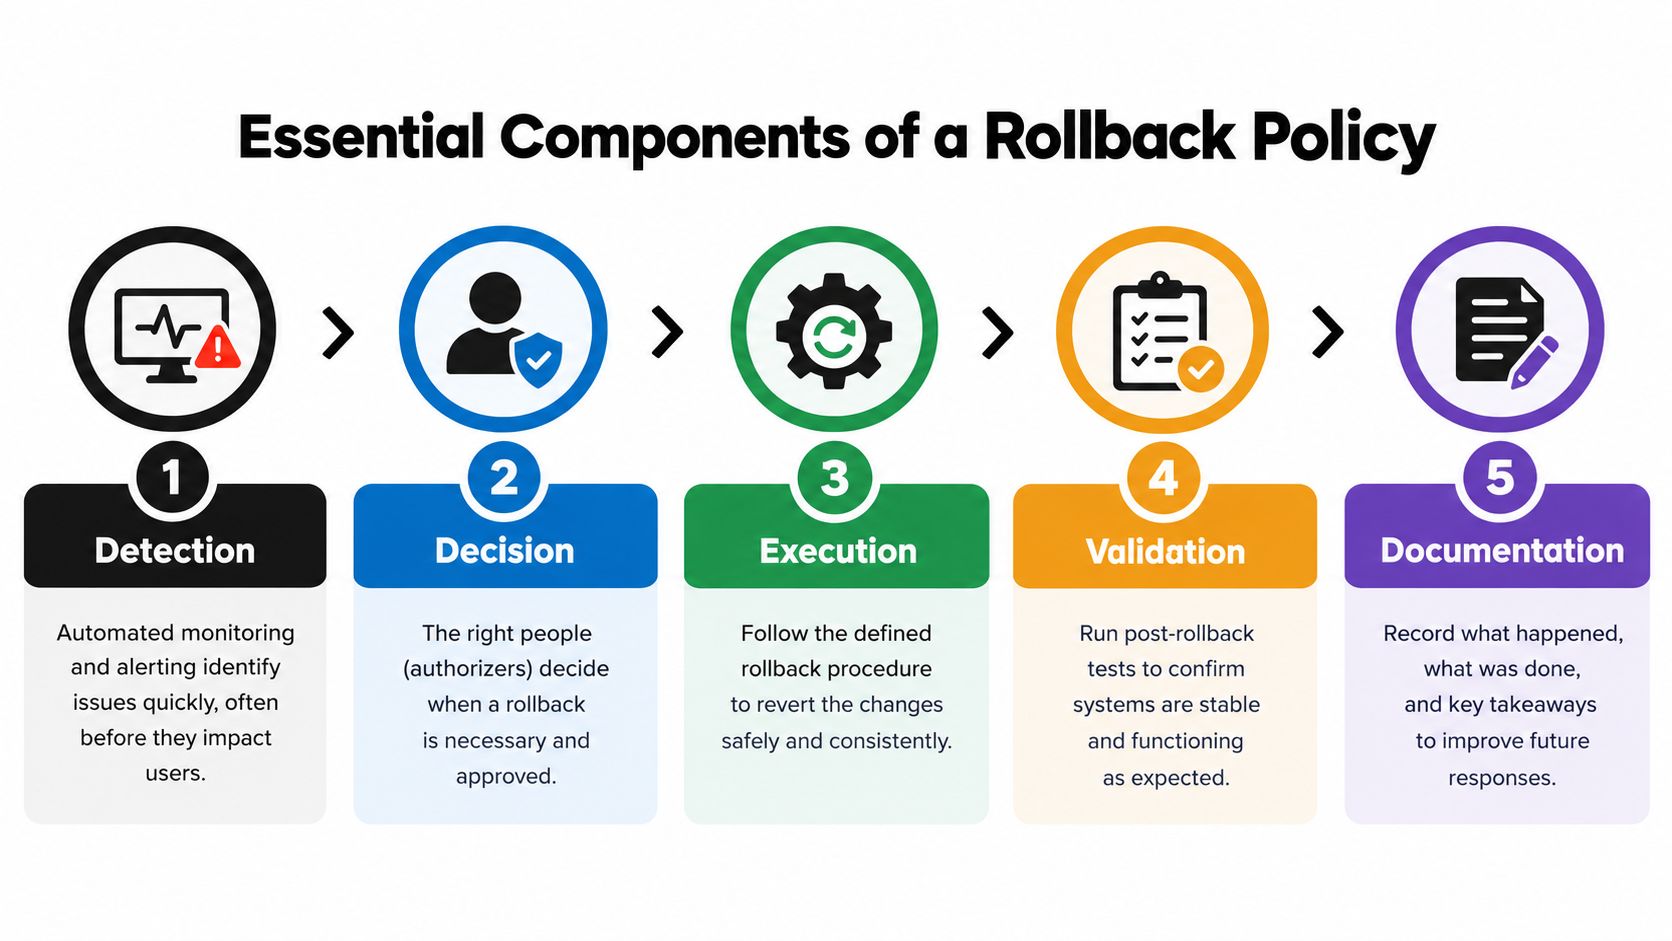
Una política de rollback madura es un acuerdo operativo entre ingeniería, seguridad, producto y soporte. Define qué puede ocurrir automáticamente, qué requiere aprobación, qué artefactos siguen disponibles y qué evidencia debe preservarse tras el incidente. Un simple comando de redeploy no ofrece ese control.
Detecta con señales objetivas
Instrumenta cada release con un identificador de build, el commit de origen, el canal, la cohorte y el timestamp de despliegue. Monitoriza la finalización del startup, el comportamiento ante crashes, la autenticación, las llamadas críticas a API y los flujos de negocio. Usa umbrales acordes al impacto del fallo, no un porcentaje de error genérico aplicado a cada feature.
Decide con autoridad definida
Deja por escrito quién puede pausar la entrega, quién puede autorizar un rollback y a quién hay que notificar. Durante una regresión de bajo riesgo en el startup, un ingeniero de guardia podría necesitar autoridad para detener la exposición de inmediato. Un posible problema de datos o seguridad debe activar el incident command y conservar un registro de aprobación claro.
Ejecuta un switch de versión inmutable
Mantén varias versiones desplegables anteriores del software de aplicación, la configuración, el firmware y la documentación de soporte. NIST SP 800-53 recomienda retener un número de configuraciones base anteriores definido por la organización y exige planificación de contingencia para definir objetivos de recuperación, prioridades de restauración, responsabilidades y resultados medibles. Su guía de contingencia y configuración admite almacenar bundles inmutables y versionados en lugar de depender de un directorio "previous" sobrescrito.
Para apps híbridas, incluye metadatos de compatibilidad, verificación de integridad criptográfica y conmutación atómica de canal. La retención debe tener en cuenta el descubrimiento tardío de defectos y la exposición por etapas, no solo el último release. Un artefacto de rollback que no se pueda autenticar o no coincida con el shell nativo no es un activo de recuperación.
Valida el comportamiento crítico del negocio
Tras el cambio, prueba el arranque de la app, la autenticación, los pagos, la sincronización, la gestión de push y cualquier flujo ligado a datos locales. La validación debe usar los canales y las versiones de cliente afectados, ya que una prueba de staging correcta puede no representar un stream de producción específico de un cliente.
Documenta el resultado
Registra el trigger, la decisión, el operador, la identidad del artefacto, la población afectada, los timestamps, la versión restaurada y el resultado de la validación. Para equipos que formalizan controles operativos en entornos sensibles, mejores prácticas de gestión del cambio para clínicas proporcionan contexto útil sobre aprobaciones, comunicación y trazabilidad.
Un simulacro de rollback debe poner a prueba toda la cadena. NIST recomienda probar planes de contingencia, incluida la recuperación y la reconstitución a un estado conocido. La prueba debe verificar detección, autoridad, targeting, telemetría, comportamiento de las sesiones de usuario, escalado y recolección de evidencia. Los equipos también pueden revisar Capacitor guía de configuración de rollback al trasladar estos controles a un workflow de live updates.
Estrategias de rollback: automatizadas vs. manuales
La automatización es excelente para responder a un fallo obvio y medible. Es mala interpretando un incidente ambiguo en el que revertir el cliente podría empeorar una incompatibilidad con el backend. La elección correcta no es «automatizado o manual» en todo el sistema, sino una división basada en riesgos entre acciones que son seguras de repetir y acciones que requieren criterio.
Dónde se justifica la automatización
El rollback automático funciona bien cuando la señal es rápida, específica y está estrechamente ligada al nuevo artefacto. Ejemplos: una app que falla en su callback de readiness de arranque, una excepción crítica de inicialización, un fallo de compatibilidad o una regresión brusca en un cohorte controlado. El sistema puede detener el rollout, restaurar el bundle compatible anterior y alertar al ingeniero de guardia mientras se contiene el impacto.
La automatización debe ser idempotente. Repetir la acción no debe crear una secuencia de cambios de estado impredecibles. También necesita guardrails:
- Fija el objetivo: Restaura un artefacto firmado identificado por una versión inmutable, no el build que esté etiquetado como «anterior».
- Limita el alcance: Aplica la acción al canal o cohort afectado, a menos que haya evidencia de un defecto más amplio.
- Conserva el rastro: Registra automáticamente el trigger, el umbral, la regla de decisión y la versión restaurada.
- Prueba el fallback: Confirma que el bundle anterior puede inicializarse con el shell nativo y el backend que están actualmente en servicio.
El rollback automático puede generar falsos positivos. Una caída temporal de una dependencia podría recuperarse antes de que termine la reversión de un bundle, o un hueco en la telemetría regional podría parecer un fallo del cliente. Por ello, una acción automatizada debería pausar primero la exposición cuando sea posible y revertir solo cuando la señal sea lo bastante clara.
Dónde interviene la decisión humana
La aprobación manual es adecuada para fallos de pago, posible corrupción de datos, problemas de seguridad, cambios de esquema irreversibles e incidentes que afecten a múltiples generaciones de clientes. Un ingeniero debe determinar si el bundle anterior puede leer con seguridad los datos escritos por el nuevo, si el backend aún soporta el contrato anterior y si los canales específicos de cada cliente tienen dependencias distintas.
La acción manual es más lenta y variable, pero esa fricción puede evitar que un rollback técnicamente limpio dañe registros o rompa un servicio ya migrado. La política debe designar al aprobador y proporcionar un breve registro de la decisión, en lugar de dejar al ingeniero de guardia buscando en un documento de control de acceso durante una caída.
Pausar el rollout suele ser la medida inicial más segura. Reduce la nueva exposición mientras el equipo decide si lo correcto es revertir, desactivar la funcionalidad o aplicar un forward fix.
Para equipos que usan despliegue escalonado, distingue entre detener un rollout progresivo y revertir una versión que ya está activa. Comparativa entre pausar un rollout y hacer un rollback ayuda a enmarcar esa diferencia. La política debe hacer explícita la distinción tanto en las herramientas como en el lenguaje de los incidentes.
Requisitos de gobernanza y auditoría para rollbacks
En un entorno regulado, «la app vuelve a funcionar» es solo una parte de un rollback exitoso. La organización también debe demostrar qué cambió, quién aprobó la respuesta, qué clientes recibieron el artefacto y si el estado restaurado preservó los controles requeridos.
Un registro de evidencia defendible comienza con la identidad del artefacto. Almacena el digest del bundle o binario firmado, el commit de origen, los metadatos de build, el canal de release, la declaración de compatibilidad y la aprobación de publicación. Luego, vincula ese artefacto con los datos de exposición, incluidas las poblaciones de dispositivos o tenants afectados, el estado del rollout y el momento en que el equipo pausó o revirtió la entrega.
Preserva el historial de decisiones
La identidad del operador importa, pero también el razonamiento. Conserva la telemetría que desencadenó el incidente, la evaluación del umbral, la cronología del incidente, la marca de tiempo de aprobación, la acción tomada, la versión restaurada y las comprobaciones posteriores al rollback. Si el equipo decidió no hacer rollback, conserva también esa decisión y su justificación.
Los canales específicos de cliente requieren un tratamiento separado. Un tenant fintech puede recibir una combinación de configuración o funciones que no existe en el flujo de producción general. Revertir el canal global sin verificar el targeting de tenants puede crear comportamientos inconsistentes, ocultar a quién afectó o dejar a un cliente en una versión que el equipo de respuesta a incidentes no validó.
Protege tus datos y flujos de cumplimiento
Un rollback de cliente no puede revertir una migración de base de datos que ya ha cambiado el estado de producción. Antes de aprobar una reversión, verifica si el cliente anterior puede leer los registros actuales, si las migraciones son reversibles y si los datos locales en caché contienen campos o formatos desconocidos para el bundle anterior. Si la compatibilidad no está garantizada, la respuesta correcta puede ser desactivar la exposición y lanzar un forward fix en lugar de forzar un downgrade del cliente.
El ownership técnico y de cumplimiento debe confluir aquí. Los registros de pago, datos de pacientes, decisiones de acceso, eventos de auditoría y el linaje de datos deben validarse tras la recuperación. Un rollback que restaura la pantalla pero pierde trazabilidad no es una recuperación conforme.
Las guías de cadena de suministro también enfatizan gateways de actualización controlados, canales aprobados, despliegue por etapas, triggers de rollback y revocación rápida. El aviso de cadena de suministro de Sygnia ofrece contexto relevante para las organizaciones que diseñan controles de evidencia y acceso en torno a las actualizaciones de software.
Flujo de rollback paso a paso
Un rollback debe leerse como un runbook, no como una improvisación heroica. La secuencia siguiente asume que el equipo puede separar el control de exposición de la restauración del artefacto y puede identificar los límites de compatibilidad antes de cambiar el estado de producción.
-
Declarar el incidente y congelar la nueva exposición. Asignar un líder de incidente, registrar el identificador de la release y pausar el rollout o canal afectado. No permitir que dispositivos adicionales reciban un artefacto mientras el equipo aún está definiendo el alcance.
-
Confirmar la señal de fallo. Comparar la cohorte afectada con una cohorte de referencia. Revisar el arranque, la autenticación, las APIs críticas y el comportamiento de las sesiones de usuario. Un pico de telemetría por sí solo puede indicar un problema de observabilidad en lugar de un defecto del cliente.
-
Mapear el límite de compatibilidad. Identificar la versión del shell nativo, el web bundle, el contrato del backend, el estado del esquema y el formato de datos locales. Confirmar que el rollback candidato puede iniciar y operar contra los servicios actualmente desplegados.
-
Seleccionar y autenticar el artefacto objetivo. Elige una versión inmutable y firmada con un identificador de build registrado. No confíes en una copia local sin verificar ni en una etiqueta informal de “última release”.
-
Elige la acción de recuperación. Pausa la entrega, desactiva una función, revierte el web bundle, fuerza un estado de mantenimiento o inicia una corrección binaria hacia adelante. Usa la acción menos disruptiva que elimine el comportamiento inseguro sin crear un desajuste de versión.
-
Ejecuta dentro del alcance aprobado. Aplica primero el cambio al canal o a la población de tenants afectada cuando la evidencia respalde una recuperación dirigida. Mantén visibles el operador, la hora, el motivo y el artefacto en el registro del incidente.
-
Valida los flujos críticos. Prueba el arranque, el login, los pagos, la sincronización, las lecturas y escrituras de datos, y cualquier workflow que haya desencadenado el incidente. Prueba en shells nativos representativos y canales de clientes, no solo en el dispositivo de un ingeniero.
-
Expande o cierra deliberadamente. Si la validación tiene éxito, sigue monitoreando y decide si restaurar la entrega más amplia. Si falla, detén la expansión de la exposición y escala a una corrección hacia adelante o a un rollback de servicio más profundo.
Un runbook útil también describe quién es responsable de cada handoff. Los equipos que construyen automatización operativa pueden consultar esta guía para CIO sobre workflows agénticos para un contexto más amplio sobre acciones delegadas, aprobaciones y ejecución trazable, y luego adaptar esos principios a las operaciones de release.
Medir efectividad y tasa de fallos de rollbacks
Contar solo los rollbacks da una imagen engañosa. Un equipo puede reportar pocas reversas porque la detección es débil, porque los ingenieros toleran releases degradados o porque cada incidente se convierte en una corrección de emergencia. La medición de la confiabilidad debe conectar el despliegue original con la remediación y el tiempo necesario para restaurar a los usuarios.
DORA define tasa de fallo de cambios como la proporción de despliegues en producción que requieren una corrección inmediata, como un rollback o un hotfix. El cálculo es fallos de cambio divididos entre el total de despliegues, como se documenta en la guía de métricas DORA. Registra el identificador del despliegue, el commit o build, el canal afectado, el disparador, la marca de tiempo del rollback y la hora de finalización de la recuperación para que la métrica refleje el release real que causó el problema.
Mide el impacto en los usuarios
Combina la tasa de fallos de cambio con medidas que expliquen la gravedad:
- Tiempo de recuperación: Mide el intervalo desde el impacto confirmado hasta la recuperación validada.
- Radio de impacto: Registra los canales, tenants, dispositivos y versiones de cliente afectados.
- Exposición al detectar: Captura hasta dónde se había extendido la release antes de que el equipo la pausara.
- Recurrencia: Agrupa los incidentes por componente, dependencia, área de configuración y modo de fallo.
- Calidad de la validación: Registra qué flujos críticos de negocio pasaron tras la recuperación y cuáles seguían afectados.
Una tasa de rollback baja no es automáticamente saludable. Si el monitoreo no detecta fallos de arranque o errores de pago específicos de un cliente, el dashboard puede parecer estable mientras los usuarios sufren el daño. Por el contrario, los rollbacks automáticos frecuentes pueden indicar una protección útil o revelar umbrales demasiado sensibles.
Revisa las métricas tras cada incidente. Pregúntate si la señal se disparó con suficiente antelación, si la acción elegida correspondía a la clase de fallo, si el artefacto de fallback era compatible y si la evidencia bastaba para la revisión de cumplimiento. Métricas de actualización en tiempo real para apps de Capacitor puede ayudar a los equipos a reflexionar sobre la adopción, los fallos y la visibilidad por dispositivo al diseñar ese bucle de retroalimentación.
La política más sólida convierte el rollback de un botón de pánico en un experimento controlado. Cada evento debe mejorar el targeting de releases, las comprobaciones de compatibilidad, la retención de artefactos, las rutas de aprobación y la validación de recuperación. La velocidad sigue siendo importante, pero solo cuando el equipo puede demostrar qué cambió y por qué los usuarios están más seguros después.
Capgo permite a los equipos de CapacitorJS y Electron publicar bundles firmados de JavaScript, CSS, configuración y assets en canales específicos, con historial de versiones, observabilidad por dispositivo y protección contra rollback automático para inicializaciones fallidas. Visita Capgo para evaluar un flujo de live-update que separa la recuperación de bundles de la distribución binaria y da a tu equipo un historial de lanzamientos más claro.





