

リリースが本番に出て最初のユーザーがアプリを開くと、インシデントチャネルは誰も読み切れない速さで動き出す。クラッシュレポートが増え、一部の顧客で認証に失敗し、サポートからは「デプロイを元に戻せないのか」という声が上がる。あらかじめ用意されたロールバックポリシーがなければ、エンジニアはプレッシャーの中で、どのバージョンが安全か、誰が変更を承認できるのか、1つのレイヤーを戻すと別のレイヤーが壊れないのかを判断せざるを得ない。
ロールバックは魔法の元に戻すボタンではありません。ハイブリッドアプリケーションでは、Webバンドル、ネイティブシェル、バックエンドスキーマ、キャッシュされたローカルデータなど、それぞれ異なるリリースライフサイクルを持つ可能性があります。そのため、実用的なポリシーは、単に古いアーティファクトを再デプロイするだけでなく、影響範囲を制御し、証拠を保全し、互換性のあるユーザー体験を復元することを目指すべきです。
目次
- モバイルチームにとってロールバック保護が重要な理由
- デプロイ失敗の根本原因を理解する
- ロールバックポリシーの必須構成要素
- 自動ロールバック vs 手動ロールバックの戦略
- ロールバックのガバナンスと監査要件
- ロールバック実行のステップバイステップワークフロー
- ロールバックの有効性と失敗率の測定
モバイルチームにとってロールバック保護が重要な理由
本番障害の対応中にチームが最初に犯すミスは、スピードだけを目的にすることです。誤ったアーティファクトを素早くロールバックすると、二次インシデントを引き起こしかねません。特に JavaScript bundle が、インストール済みのバイナリにはないネイティブ機能を前提としている場合はそうです。より安全な目標は、 検証済みの正常な状態に最速で戻ることです.
基礎的な実証研究では、 345件の本番リリースを 大規模なeコマースWebアプリケーションにおいて、約 1.5年間にわたり調査しました。そのうち 320件のリリースの 完全な結果データに基づくと、 248件(77.5%)は問題なく完了しましたが、。一方、 72件(22.5%)は失敗と分類されました。 デプロイ直後にクラッシュやハング、パフォーマンス低下などの異常動作を引き起こしたためです。研究チームは、 17件の再発する根本原因を 4つの大きなカテゴリにまたがって特定しました。これは、ロールバックの準備がソース-codeの欠陥だけに集中できない理由を示しています。 このリリースロールバック調査は、 モバイルチームに有用な運用上の教訓を与えています。リリースリスクは日常的で、設計された対応が必要だということです。
リスクにさらされることと復旧は別物だ
モバイル配布では「ロールバック」の意味が曖昧になりがちです。段階的ロールアウトの一時停止は、さらなる影響範囲の拡大を防ぎます。機能フラグの無効化は、code パスの実行を阻止します。ライブ Web バンドルの巻き戻しは、互換性のあるインストール済みバイナリがダウンロードする内容を変更します。バイナリ更新の強制は、ユーザーに新しいネイティブパッケージのインストールを求めますが、ストアの審査、採用率、およびユーザーの更新意欲に依存する可能性があります。
ストアでのロールバックでは、デバイスにインストール済みのバイナリを削除できません。緊急のフォワードフィックスが 24〜72時間 かかる場合があり、これは審査や採用の遅延によるものです( このハイブリッドアプリのロールバックブループリントのモバイルリリースエンジニアリングガイドライン参照)。そのため、ライブバンドルのロールバックは JavaScript、CSS、コピー、設定、またはアセットの欠陥に対して価値がありますが、ネイティブシェルを可逆的にするものではありません。
実践的なルール: インシデントが発生する前に、チーム内で「ロールバック」が何を意味するかを定義しておきましょう。配信の停止、バンドルの巻き戻し、機能の無効化、バイナリ更新のリリースは、それぞれリスクが異なる別々のアクションです。
明確な可用性戦略では、インシデント発生時に利用可能でなければならないユーザーのジャーニーも特定すべきです。認証、決済、データ同期、アプリの起動は、一般的なエラー閾値に隠すのではなく、それぞれ個別にチェックする価値があります。リリース前にこれらの違いを文書化しておくことで、サポートチケットが殺到した際の不確実性を軽減できます。これは実用的な モバイルアプリの可用性に関するガイダンス でも強調されています。
デプロイ失敗の根本原因を理解する
「不良 code」を基準にしたロールバックポリシーでは、本番環境でよくある障害モードを見逃します。2022年の実証研究では、 152件の重大な本番インシデントを調べたところ、 code のバグがインシデントの 27.0% 原因となっており、依存関係の障害、 16.4%インフラ障害、 15.8%デプロイエラー、 13.2%、および設定バグが 12.5%確認されました。より広範な分類では、 40% インシデントを code または設定バグに帰属させる一方で、 60% インフラ、デプロイ、またはサービス依存関係が関与していました。 このインシデント調査では 実用的な結論を裏付けます。ロールバックのトリガーは、アプリケーションのバイナリやライブWeb bundleだけでなく、配信環境も監視する必要があります。
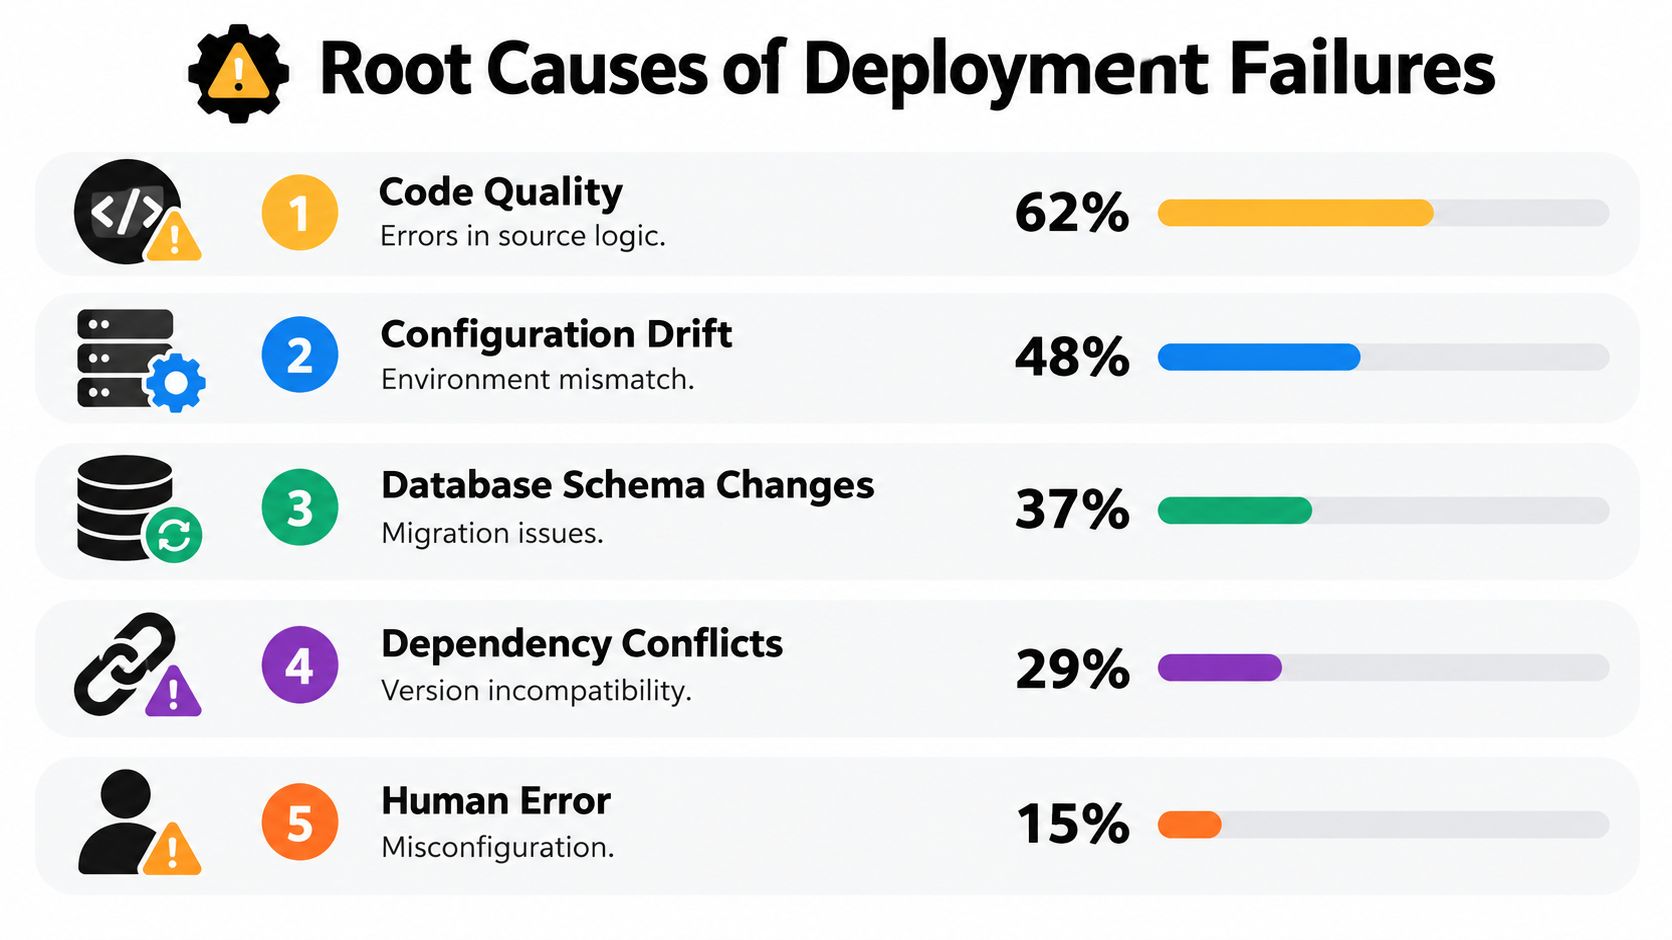
障害の種類に応じたトリガー設計
依存関係の失敗により、アプリケーションの code は変わらないまま、ログイン、決済、同期が機能しなくなることがあります。インフラの問題で起動が遅くなったり、APIが利用できなくなったりすることがあります。デプロイエラーは誤ったアーティファクトを誤ったチャネルに配信する可能性があり、設定の不備は新しいソースコミットなしに挙動を変えることがあります。
ハイブリッドアプリには、もう一つの区別が必要です。ライブWeb bundleは、インストール済みのネイティブシェルを変更せずに、通常は取り消しや差し替えが可能です。一方、ネイティブの互換性不具合はバイナリ更新が必要になる場合があり、古いbundleを配信しても元に戻せません。そのため、トリガーは対応を選ぶ前に、障害が起きているレイヤーを特定する必要があります。
調査では、ロールバックが最もよく使われる緩和策の一つであることが分かりました。設定関連のインシデントは特に示唆に富んでいます: 47% はロールバックで緩和これに対し、 21% は実際の設定修正で解決同じインシデント調査でも報告されています。これは自動ロールバックがすべての設定インシデントに適しているという意味ではありません。ユーザーが影響を受けている間に稼働中の値を編集するより、既知の正常なリリース状態に戻す方が、短期的には安全な境界になることを示しています。
症状と想定原因を切り分ける実用的なトリガーマトリックス:
| シグナル | 懸念される可能性 | 初回対応 |
|---|---|---|
| 起動失敗 | Bundle、ネイティブ互換性、または初期化の欠陥 | 公開を停止し、ロールバックを評価 |
| 認証エラー | 設定、ID プロバイダー、または API の非互換性 | ロールアウトを一時停止し、依存関係を検証 |
| 支払いの失敗 | バックエンドの契約、クライアントの動作、または機能設定 | 公開範囲を変更する前に人間の承認を要求 |
| データ破損 | マイグレーションまたは永続化の互換性問題 | ロールバック前にデータを保護する |
| セキュリティインシデント | アーティファクトまたは配信経路の侵害 | 露出を遮断し、証拠を保全して、セキュリティ手順に従う |
このマトリックスは閾値に代わるものではありません。どのシグナルが自動アクションをトリガーし、どれに調査が必要かを定義するものです。クラッシュ率は自動対応の根拠になり得ますが、決済失敗やデータ破損の疑いがある場合は通常、明確な担当者による判断が必要です。
障害分析には、チャネルターゲティング、アーティファクト署名、ビルド識別子、依存関係のロックファイル、スキーマ互換性、キャッシュの挙動、検知時間を含めるべきです。規制の厳しいフィンテック環境では、レビュー時にロールバックを再現できるよう、決定内容、アーティファクトのバージョン、確認された証拠、承認者、実行されたアクションを保存してください。この取り組みを明文化するチームは、以下を活用できます。 リリースインシデントの障害分析手法を 実用的なリファレンスとして。
ロールバックポリシーの必須構成要素
成熟したロールバックポリシーとは、エンジニアリング、セキュリティ、プロダクト、サポート間の運用上の合意です。何が自動で実行され、何に承認が必要か、どのアーティファクトが利用可能なままか、どの証拠をインシデント後も残す必要があるかを明確にします。単一の再デプロイコマンドだけでは、そのような制御は実現できません。
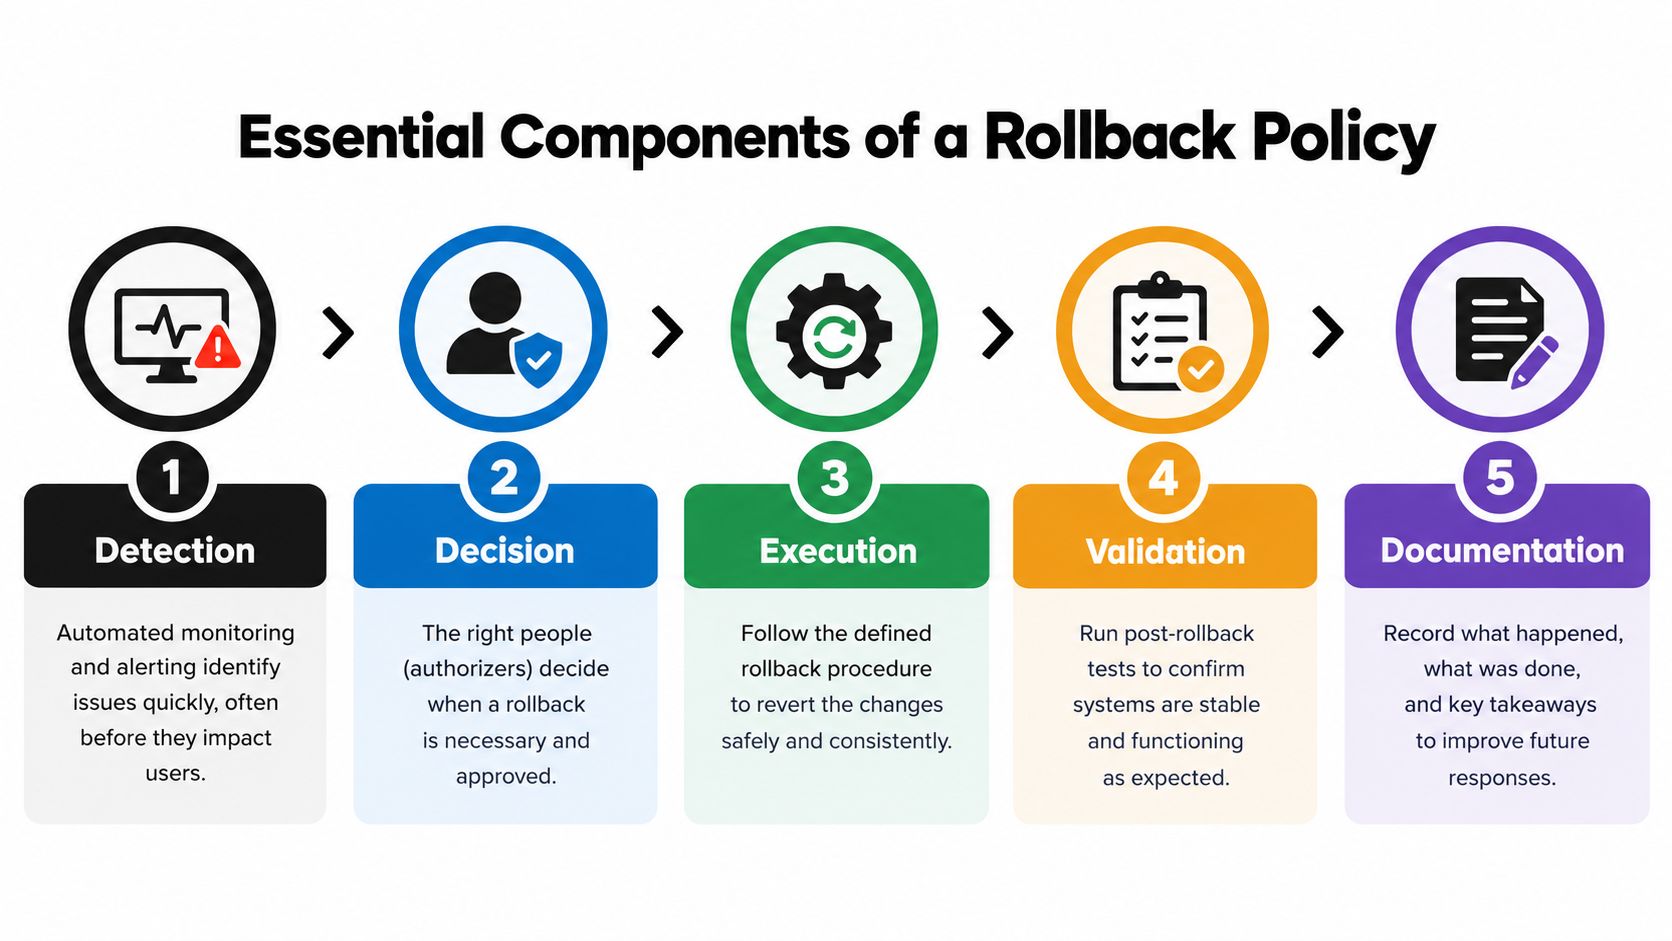
客観的シグナルで検知
ビルド識別子、ソースコミット、チャネル、コホート、デプロイメントタイムスタンプを付与して、すべてのリリースを計装します。起動完了、クラッシュ挙動、認証、重要な API 呼び出し、ビジネスワークフローを監視します。汎用的なエラー率ではなく、障害の深刻さに応じたしきい値を設定してください。
指名された権限者が判断
配信を一時停止できる者、ロールバックを承認できる者、通知が必要な者を文書化してください。低リスクの起動時リグレッションでは、オンコールエンジニアが即座に露出を停止する権限を必要とすることがあります。データまたはセキュリティの問題が疑われる場合は、インシデントコマンドを発動し、明確な承認記録を保持してください。
不変バージョンへの切り替えを実行
アプリケーションソフトウェア、設定、ファームウェア、および関連ドキュメントの、デプロイ可能な複数の以前のバージョンを保持します。NIST SP 800-53 は、組織が定義した数の以前のベースライン設定の保持を推奨し、復旧目標、復旧優先度、責任、測定可能な成果を定義するための緊急時計画を要求しています。その 緊急時計画および設定に関するガイダンス 「前バージョン」ディレクトリの上書きに頼るのではなく、不変でバージョン管理されたバンドルを保存することをサポートします。
ハイブリッドアプリでは、互換性メタデータ、暗号学的完全性検証、アトミックなチャネル切り替えを含めてください。保持期間は、直近のリリースだけでなく、欠陥の発見遅れや段階的公開も考慮に入れるべきです。認証できない、またはネイティブシェルと一致しないロールバック用アーティファクトは、リカバリ資産にはなりません。
ビジネスに不可欠な動作の検証
切り替え後は、アプリの起動、認証、決済、同期、プッシュ通知の処理、ローカルデータに関連するすべてのワークフローをテストしてください。検証には、影響を受けるチャネルとクライアントバージョンを使用する必要があります。ステージングで正常に動作しても、顧客固有の本番ストリームを代表するとは限らないためです。
結果の記録
トリガー、決定事項、担当者、アーティファクトの識別情報、影響を受けるユーザー層、タイムスタンプ、復元されたバージョン、検証結果を記録します。機密性の高い環境で運用管理を整備しているチームにとって、 クリニックにおける変更管理のベストプラクティス 承認、コミュニケーション、トレーサビリティに関する有用なコンテキストを提供します。
ロールバック演習では、チェーン全体を実際に動かすべきです。NISTは、既知の状態への復旧と再構成を含むコンティンジェンシープランのテストを推奨しています。テストでは、検知、権限、ターゲット指定、テレメトリ、ユーザーセッションの挙動、エスカレーション、証拠収集を検証すべきです。また、チームは以下を確認することもできます。 Capacitor のロールバック設定ガイド これらの管理策を Live Update のワークフローに落とし込む際。
自動ロールバック vs 手動ロールバックの戦略
自動化は、明確で測定可能な障害への対応に優れています。しかし、クライアントのロールバックがバックエンドの互換性問題を悪化させる可能性のある曖昧なインシデントの解釈には不向きです。システム全体で「自動化か手動か」を選ぶのではなく、安全に繰り返し実行できるアクションと、判断を要するアクションの間にリスクベースの分岐を設けることが重要です。
自動化が適している場面
シグナルが速く、具体的で、新しいアーティファクトと密接に関連している場合、自動ロールバックは有効に機能します。例としては、アプリの起動準備コールバックの失敗、重大な初期化例外、互換性チェックの失敗、または制御されたコホートにおける急激なリグレッションなどが挙げられます。システムはロールアウトを停止し、以前の互換性のあるbundleを復元し、影響が拡大する前にオンコールエンジニアにアラートを送信できます。
自動化はべき等であるべきです。アクションの繰り返し実行によって、予測不能な状態変化の連鎖が生じてはなりません。また、ガードレールが必要です:
- ターゲットを固定する: たまたま「previous」とラベル付けされたビルドではなく、不変のバージョンで識別される署名済みアーティファクトを復元します。
- スコープを限定する: より広範な欠陥を示す証拠がない限り、アクションは影響を受けたチャネルまたはコホートにのみ適用します。
- 証跡を残す: トリガー、しきい値、判断ルール、復元されたバージョンを自動的にログに記録します。
- フォールバックをテストする: 古いバンドルが、現在稼働中のネイティブシェルとバックエンドで初期化できることを確認します。
自動ロールバックは誤検知を招く可能性があります。一時的な依存先の障害がbundleの切り戻し完了前に復旧したり、リージョン単位のテレメトリ欠損がクライアント障害に見えたりするためです。そのため自動アクションは、可能ならまず露出を一時停止し、シグナルが十分に明確な場合にのみ切り戻すべきです。
人間による判断が必要な場面
決済失敗、データ破損の可能性、セキュリティ上の懸念、不可逆的なスキーマ変更、複数のクライアント世代が関わるインシデントには、手動承認が適切です。エンジニアは、古いbundleが新しいbundleが書き込んだデータを安全に読めるか、バックエンドが古いコントラクトを引き続きサポートしているか、顧客固有のチャネルで依存関係が異ならないかを判断する必要があります。
手動操作は遅く、ばらつきも大きくなりますが、その手間が、技術的には問題ないロールバックによるレコード破損や、移行済みサービスの破壊を防げます。ポリシーでは承認者を明記し、簡単な意思決定記録を残すべきです。障害時にオンコールエンジニアがアクセス制御ドキュメントを探し回る状態にしてはいけません。
ロールアウトの一時停止は、多くの場合、最も安全な初動です。切り戻し、機能の無効化、forward fix のどれが正しい復旧かをチームが判断する間、新たな露出を減らせます。
段階的配信を利用しているチームは、「段階的ロールアウトの停止」と「すでに有効なバージョンの切り戻し」を区別してください。 ロールアウトの一時停止とロールバックの比較 その違いを位置づけるのに役立ちます。ポリシーは、ツールとインシデント時の言葉遣いの両方で、その区別を明示すべきです。
ロールバックのガバナンスと監査要件
規制の厳しい環境では、「アプリが再び動作している」ことは、ロールバック成功のほんの一部に過ぎません。組織は、何が変更されたのか、誰が対応を承認したのか、どの顧客がアーティファクトを受け取ったのか、そして復元後の状態が必須の統制を維持しているかを示す必要があります。
根拠を示せるエビデンス記録は、アーティファクトの識別情報から始まります。署名済みbundleまたはバイナリのダイジェスト、ソースコミット、ビルドメタデータ、リリースチャネル、互換性宣言、公開承認を保存してください。次に、そのアーティファクトを、影響を受けたデバイスやテナントの母集団、ロールアウト状況、チームが配信を一時停止または巻き戻した時刻などのエクスポージャーデータに紐付けます。
意思決定の履歴を保存
オペレーターの識別情報だけでなく、その判断理由も重要です。トリガーとなったテレメトリ、閾値評価、インシデントのタイムライン、承認タイムスタンプ、実行したアクション、復元したバージョン、ロールバック後のチェックを保持してください。チームがロールバックしない選択をした場合も、その決定と根拠を保存してください。
顧客固有のチャネルには個別対応が必要です。フィンテックのテナントは、一般の本番ストリームにはない設定や機能の組み合わせを受け取る場合があります。テナントのターゲティングを確認せずにグローバルチャネルをロールバックすると、挙動が不整合になったり、誰が影響を受けたか分かりにくくなったり、インシデント対応チームが検証していないバージョンに特定の顧客が残ってしまう可能性があります。
データとコンプライアンスのワークフローを保護する
クライアントのロールバックでは、すでに本番状態を変更したデータベースマイグレーションを取り消すことはできません。ロールバックを承認する前に、旧クライアントが現在のレコードを読めるか、マイグレーションが可逆か、ローカルキャッシュに旧bundleが知らないフィールドや形式が含まれていないかを確認してください。互換性が保証されない場合は、クライアントのダウングレードを強制するのではなく、公開を停止してforward fixを配信するのが正しい対応となる場合があります。
ここでは技術とコンプライアンスの責任が交わらなければなりません。復旧後には、決済記録、患者データ、アクセス判定、監査イベント、データリネージの検証が必要です。画面を復旧してもトレーサビリティが失われるロールバックは、コンプライアンスを満たした復旧とは言えません。
サプライチェーンのガイダンスでは、管理された更新ゲートウェイ、承認済みチャネル、段階的デプロイ、ロールバックトリガー、迅速な失効(revocation)の重要性も強調されています。 Sygniaによるサプライチェーンアドバイザリは ソフトウェアアップデートに関するエビデンスとアクセス制御を設計する組織に、関連するコンテキストを提供します。
ロールバック実行のステップバイステップワークフロー
ロールバックは英雄的な即興ではなく、ランブックのように読めるべきです。以下の手順は、チームが露出制御と成果物の復元を分離でき、本番環境の状態を変更する前に互換性の境界を特定できることを前提としています。
-
インシデントを宣言し、新しい露出を凍結します。 インシデントリーダーを割り当て、リリース識別子を記録し、影響を受けたロールアウトまたはチャネルを一時停止します。スコープを確定するまで、追加のデバイスに成果物を配信させないでください。
-
失敗シグナルを確認します。 影響を受けたコホートと既知の正常なコホートを比較します。起動、認証、重要なAPI、ユーザーセッションの動作を確認してください。テレメトリーのスパイクだけでは、クライアントの欠陥ではなく観測可能性の問題を示している可能性があります。
-
互換性の境界をマッピングします。 ネイティブシェルバージョン、Webバンドル、バックエンド契約、スキーマ状態、ローカルデータ形式を特定します。候補のロールバックが、現在デプロイされているサービスに対して起動し、動作することを確認してください。
-
ターゲット成果物を選択し、認証します。 ビルド識別子が記録された、不変かつ署名済みのバージョンを選択してください。未検証のローカルコピーや非公式な「最終リリース」ラベルに頼らないでください。
-
リカバリーアクションを選択します。 配信の一時停止、機能の無効化、Webバンドルのロールバック、メンテナンス状態への強制移行、またはフォワードバイナリ修正の開始を行います。バージョン不一致を生み出さず、危険な動作を除去する最小限の侵襲的なアクションを使用してください。
-
承認されたスコープ内で実行します。 証拠がターゲット指定リカバリーを支持する場合、まず影響を受けるチャネルまたはテナントのユーザーに適用してください。オペレーター、時刻、理由、成果物をインシデント記録に表示可能に保ちます。
-
クリティカルなフローを検証します。 起動、ログイン、決済、同期、データの読み書き、およびインシデントを引き起こしたワークフローをテストします。エンジニアのデバイスだけでなく、代表的なネイティブシェルと顧客チャネルでテストしてください。
-
意図的に拡大または終了します。 検証に成功した場合、監視を継続し、より広範な配信を復元するかどうかを判断します。失敗した場合、露出の拡大を停止し、フォワード修正またはより深いサービスロールバックにエスカレーションしてください。
有用なランブックは、各ハンドオフの責任者も記述しています。運用自動化を構築するチームは、これを参照できます CIO向けエージェント型ワークフローガイド 委任されたアクション、承認、追跡可能な実行に関するより広い文脈を得た後、リリース運用にこれらの原則を適応させてください。
ロールバックの有効性と失敗率の測定
ロールバック回数だけを見ると誤った印象を与えます。チームがロールバックをほとんど報告しないのは、検知が弱いから、エンジニアが品質低下したリリースを許容しているから、またはすべてのインシデントが緊急のフォワードフィックスになっているからかもしれません。信頼性を測るには、起点となったデプロイと修正、ユーザー復旧までの時間を紐づける必要があります。
DORAは以下を定義しています 変更失敗率 ロールバックやホットフィックスなど、即時対応が必要な本番デプロイの割合です。計算式は、 変更失敗数 ÷ 総デプロイ数です。これは、 DORAメトリクスのガイドラインに記載されているとおりです。問題を引き起こした実際のリリースがメトリクスに反映されるよう、デプロイID、コミットまたはビルド、影響を受けたチャネル、トリガー、ロールバックのタイムスタンプ、復旧完了時刻を記録してください。
ユーザーへの影響を測定する
変更失敗率は、深刻度を説明する指標と組み合わせて評価します:
- 復旧までの時間: 影響が確認されてから、復旧が検証されるまでの間隔を測定します。
- 影響範囲: 影響を受けたチャネル、テナント、デバイス、クライアントバージョンを記録します。
- 検知時の影響規模: チームがリリースを一時停止する前に、どの範囲まで展開されていたかを記録します。
- 再発: コンポーネント、依存関係、設定領域、障害モードごとにインシデントをグループ化します。
- 検証の質: 復旧後にどのビジネスクリティカルなフローが正常に動作し、どのフローが依然として障害を抱えているかを記録します。
ロールバック率が低いからといって、必ずしも健全なわけではありません。監視が起動時の失敗や顧客固有の決済エラーを見逃している場合、ダッシュボードは安定して見えても、ユーザーは被害を被っている可能性があります。逆に、頻繁な自動ロールバックは有効な保護を示している場合もあれば、閾値が過敏すぎていることを示している場合もあります。
すべてのインシデント後にメトリクスをレビューしてください。シグナルは十分に早期に発火したか、選択したアクションが障害クラスに合致していたか、フォールバックの成果物が互換性を持っていたか、コンプライアンスレビューに十分な証拠があったかを問いましょう。 Capacitor アプリのリアルタイム更新メトリクス フィードバックループを設計する際に、チームが導入、障害、デバイス単位の可視性について考えるのを助けます。
最も強力なポリシーは、ロールバックをパニックボタンから制御された実験へと変えます。各イベントは、リリースのターゲティング、互換性チェック、アーティファクトの保持、承認パス、復旧検証を改善すべきです。スピードは依然として重要ですが、チームが何を変更したか、そしてその後ユーザーがより安全になったことを証明できる場合に限ります。
Capgo を使えば、CapacitorJS や Electron のチームは、署名済みの JavaScript、CSS、設定、アセットの bundle を対象の channel に公開できます。バージョン履歴、デバイスごとの observability、初期化失敗時の自動ロールバック保護も備えています。詳細は Capgo バイナリ配布から bundle のリカバリを切り離し、チームがリリースをより明確に追える live-update ワークフローをご確認ください。





