

Une release est déployée, les premiers utilisateurs ouvrent l'app, et le canal d'incident s'emballe plus vite qu'on ne peut le lire. Les rapports de crash se multiplient, l'authentification échoue pour une partie des clients, et le support demande si l'équipe peut « simplement annuler » le déploiement. Sans une politique de rollback préparée, les ingénieurs sont contraints de décider sous pression quelle version est sûre, qui peut autoriser le changement, et si revenir en arrière sur une couche ne va pas casser une autre.
Un rollback n'est pas un bouton « annuler » magique. Dans une application hybride, le bundle web, le shell natif, le schéma backend et les données locales en cache peuvent avoir des cycles de release différents. Une politique concrète doit donc maîtriser l'exposition, conserver les preuves et rétablir une expérience utilisateur compatible, plutôt que de simplement redéployer un ancien artefact.
Table des matières
- Pourquoi la protection par rollback compte pour les équipes mobiles
- Comprendre les causes profondes des échecs de déploiement
- Composants essentiels d'une politique de rollback
- Stratégies de rollback : automatisées ou manuelles
- Gouvernance et exigences d'audit pour les rollbacks
- Workflow d'exécution de rollback étape par étape
- Mesurer l'efficacité des rollbacks et les taux d'échec
Pourquoi la protection par rollback compte pour les équipes mobiles
La première erreur des équipes face à un incident en production est de considérer la vitesse comme l’unique objectif. Revenir rapidement sur le mauvais artefact peut provoquer un second incident, surtout si un bundle JS attend une fonctionnalité native que le binaire installé ne fournit pas. L’objectif le plus sûr est le retour le plus rapide vers un état connu bon.
Une étude empirique fondatrice a examiné 345 releases en production d’une grande application web e-commerce sur environ 1,5 ans. Parmi les 320 releases avec des données de résultat complètes, 248 releases, soit 77,5 %, se sont déroulées sans problème, tandis que 72 releases, soit 22,5 %, ont été classées comme ratées car ils ont provoqué des comportements anormaux tels que des crashs, des blocages ou des performances dégradées peu après le déploiement. Les chercheurs ont identifié 17 causes racines récurrentes réparties en quatre grandes catégories, ce qui montre pourquoi la préparation d'un rollback ne peut pas se limiter aux seuls défauts de code. L'étude sur le rollback des releases donne une leçon opérationnelle utile aux équipes mobiles : le risque lié aux releases est suffisamment courant pour nécessiter une réponse structurée.
L'exposition n'est pas la restauration
La distribution mobile rend le terme « rollback » ambigu. Mettre en pause un déploiement progressif stoppe l’exposition supplémentaire. Désactiver un feature flag empêche un chemin code de s’exécuter. Revenir en arrière sur un bundle web live modifie ce que téléchargent les binaires installés compatibles. Forcer une mise à jour binaire demande aux utilisateurs d’installer un nouveau package natif, ce qui peut dépendre de la revue du store, de l’adoption et de la volonté de l’utilisateur à mettre à jour.
Un rollback sur le store ne peut pas supprimer un binaire déjà installé sur un appareil. Une correction en avant d’urgence peut prendre 24 à 72 heures pour atteindre les utilisateurs concernés, en raison des délais de revue et d’adoption, conformément aux recommandations d’ingénierie des releases mobiles dans ce blueprint de rollback pour applications hybrides. Cela rend un rollback de bundle live utile pour les défauts de JavaScript, CSS, textes, configuration ou assets, mais il ne rend pas le shell natif réversible.
Règle pratique : Définissez ce que votre équipe entend par rollback avant qu'un incident ne survienne. Arrêter la livraison, revenir à un bundle précédent, désactiver une fonctionnalité ou déployer une mise à jour binaire sont des actions distinctes avec des risques différents.
Une stratégie de disponibilité claire doit également identifier les parcours utilisateurs qui doivent rester utilisables lors d'un incident. L'authentification, les paiements, la synchronisation des données et le démarrage de l'app méritent leurs propres contrôles plutôt que d'être masqués derrière un seul seuil d'erreur global. Les équipes qui documentent ces distinctions avant le jour de la release peuvent réduire l'incertitude quand les tickets de support arrivent, comme les conseils pratiques sur la disponibilité des applications mobiles le soulignent aussi.
Comprendre les causes profondes des échecs de déploiement
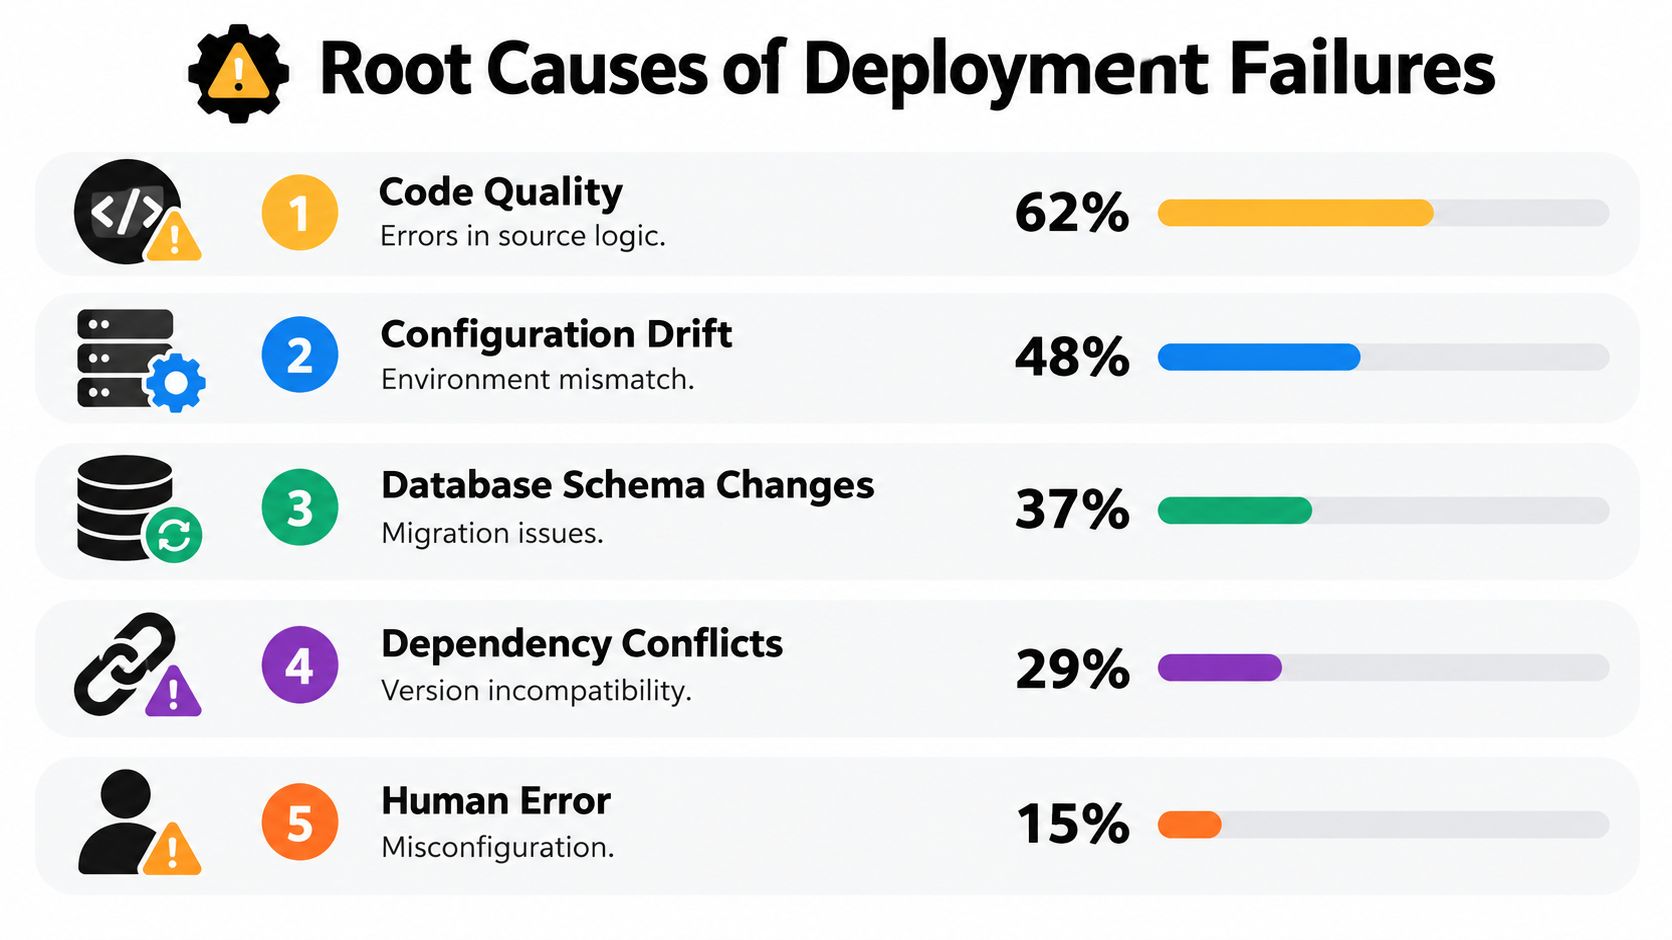
Une politique de rollback centrée sur les « mauvais code » ignore les modes de défaillance courants en production. Une étude empirique de 2022 152 incidents de production critiques a révélé que les bugs code ont causé 27.0% des incidents, des défaillances de dépendances 16.4%, des défaillances d'infrastructure 15.8%, des erreurs de déploiement 13.2% et des bugs de configuration 12.5%. Son regroupement plus large attribuait 40% d’incidents liés à code ou à des bugs de configuration, tandis 60% l’infrastructure, le déploiement ou les dépendances de service impliqués. L’étude des incidents étaye une conclusion pratique : les déclencheurs de rollback doivent surveiller l'environnement de livraison, et pas seulement le binaire de l'application ou le bundle web live.
Concevez des déclencheurs selon les types d'échec
Une défaillance de dépendance peut laisser le code de l'application inchangé alors que la connexion, les paiements ou la synchronisation cessent de fonctionner. Des problèmes d'infrastructure peuvent entraîner un démarrage lent ou des API indisponibles. Des erreurs de déploiement peuvent envoyer le mauvais artefact au mauvais canal, tandis que des défauts de configuration peuvent modifier le comportement sans nouveau commit source.
Les applications hybrides demandent une distinction de plus. Un bundle web live peut généralement être retiré ou remplacé sans modifier la coque native installée. Un défaut de compatibilité native peut nécessiter une mise à jour du binaire, impossible à annuler en servant un bundle plus ancien. Le déclencheur doit donc identifier la couche en échec avant de choisir une réponse.
L'étude montre que le rollback est l'une des stratégies de mitigation les plus populaires. Les incidents liés à la configuration sont particulièrement révélateurs : 47 % ont été atténués par un rollback, comparé à 21 % résolus par une véritable correction de la configuration, comme l'a rapporté la même étude d'incidents. Cela ne rend pas le rollback automatique adapté à chaque incident de configuration. Cela montre qu'un état de release connu comme fiable peut constituer une limite à court terme plus sûre que la modification d'une valeur en direct pendant que les utilisateurs sont impactés.
Une bonne matrice de déclencheurs permet de distinguer les symptômes des causes probables :
| Signal | Préoccupation probable | Première réponse |
|---|---|---|
| Échecs au démarrage | Défaut de bundle, de compatibilité native ou d’initialisation | Stopper l’exposition et évaluer le rollback |
| Erreurs d’authentification | Incompatibilité de configuration, de fournisseur d’identité ou de API | Pause rollout and verify dependencies |
| Échecs de paiement | Contrat backend, comportement client ou configuration de fonctionnalité | Exiger une validation humaine avant de modifier l'exposition |
| Corruption de données | Incompatibilité de migration ou de persistance | Protéger les données avant le rollback |
| Incident de sécurité | Artefact ou chemin de livraison compromis | Révoquer l'exposition, préserver les preuves et suivre les procédures de sécurité |
La matrice ne remplace pas les seuils. Elle définit quels signaux peuvent déclencher une action mécanique et lesquels nécessitent une investigation. Les taux de crash peuvent justifier une réponse automatique, tandis que les échecs de paiement ou une suspicion de corruption nécessitent généralement un responsable explicite.
L'analyse des échecs doit couvrir le ciblage du canal, les signatures d'artefacts, les identifiants de build, les lockfiles de dépendances, la compatibilité des schémas, le comportement du cache et le temps de détection. Dans les environnements fintech réglementés, conservez la décision, la version de l'artefact, les preuves observées, l'approbateur et l'action résultante afin que le rollback puisse être reconstruit lors de la revue. Les équipes qui formalisent ce travail peuvent utiliser techniques d'analyse d'échec pour les incidents de release comme référence pratique.
Composants essentiels d'une politique de rollback
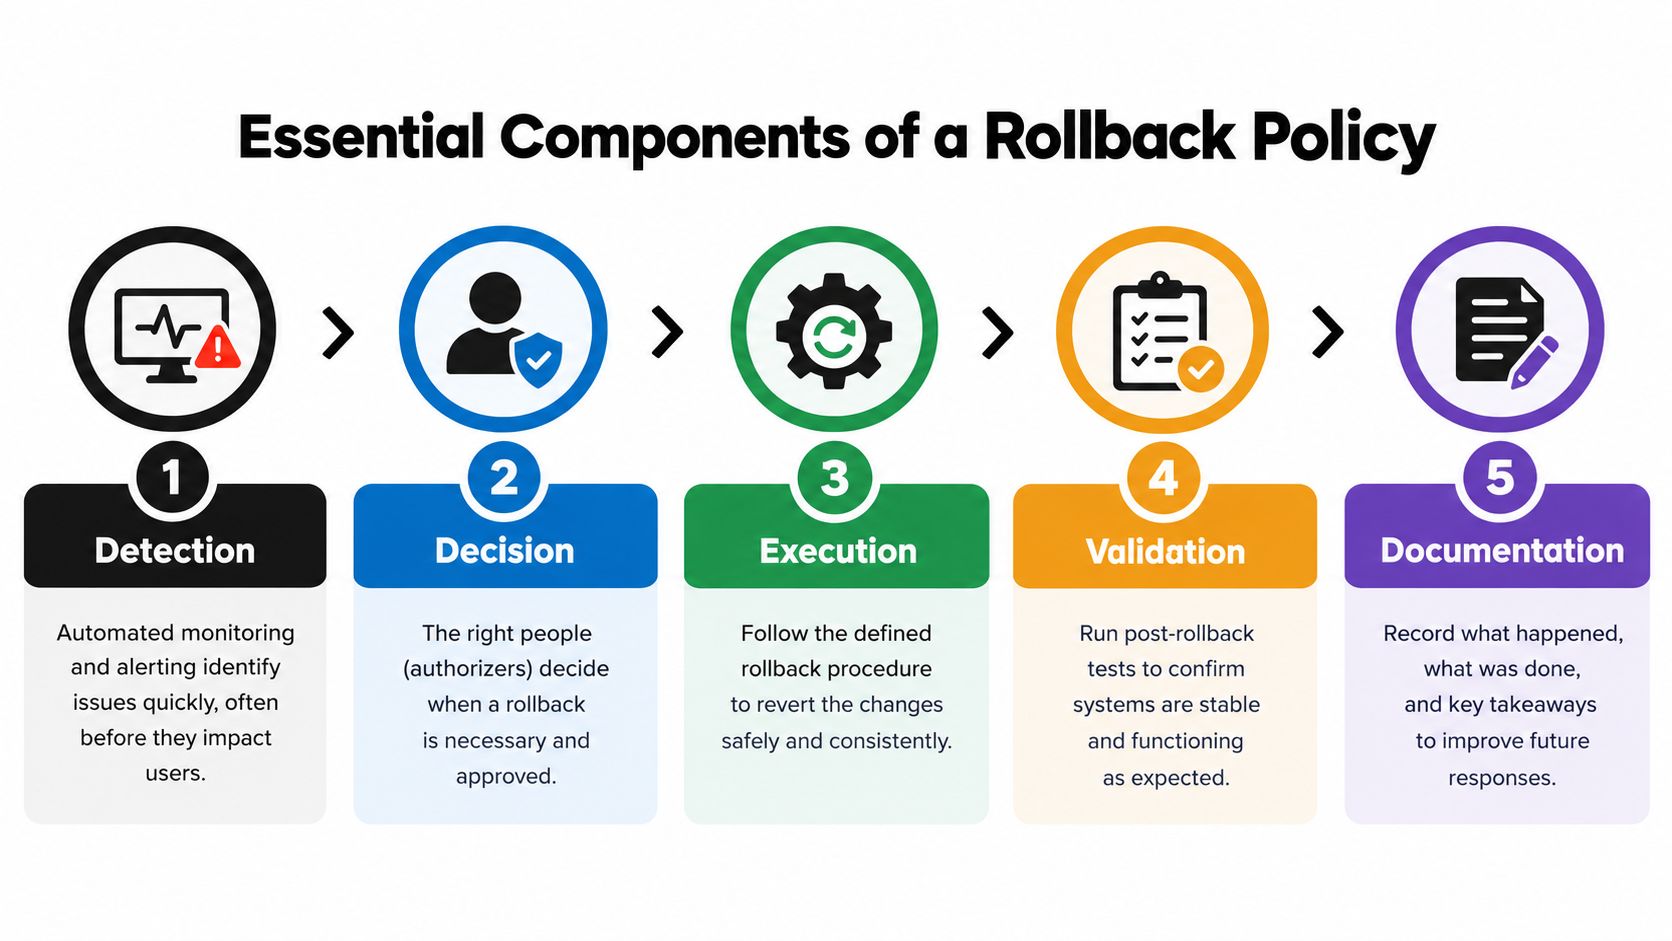
Une politique de rollback mature est un accord opérationnel entre l'ingénierie, la sécurité, le produit et le support. Elle définit ce qui peut se produire automatiquement, ce qui nécessite une approbation, quels artefacts restent disponibles et quelles preuves doivent être conservées après l'incident. Une simple commande de redéploiement ne suffit pas à garantir ce contrôle.
Détecter via des signaux objectifs
Instrumentez chaque release avec un identifiant de build, le commit source, le canal, la cohorte et l'horodatage du déploiement. Surveillez l'achèvement du démarrage, le comportement en cas de crash, l'authentification, les appels API critiques et les workflows métier. Utilisez des seuils adaptés à la gravité de la défaillance, et non un pourcentage d'erreur générique appliqué à toutes les fonctionnalités.
Décider avec une autorité nommée
Documentez qui peut mettre la livraison en pause, qui peut autoriser un rollback et qui doit être notifié. Lors d'une régression au démarrage à faible risque, un ingénieur d'astreinte peut avoir besoin de l'autorité pour arrêter immédiatement l'exposition. Une suspicion de problème de données ou de sécurité doit déclencher la gestion d'incident et conserver une trace claire des approbations.
Exécuter une bascule de version immuable
Conservez plusieurs versions déployables précédentes du logiciel applicatif, de la configuration, du firmware et de la documentation associée. Le NIST SP 800-53 recommande de conserver un nombre de configurations de référence défini par l'organisation et exige une planification de contingence pour définir les objectifs de récupération, les priorités de restauration, les responsabilités et les résultats mesurables. Ses directives de contingence et de configuration permet de stocker des bundles immuables et versionnés plutôt que de s'appuyer sur un répertoire « précédent » écrasé.
Pour les apps hybrides, incluez des métadonnées de compatibilité, une vérification d’intégrité cryptographique et un basculement atomique de canal. La conservation doit prendre en compte la découverte tardive de défauts et l’exposition progressive, pas seulement la dernière release. Un artefact de rollback impossible à authentifier ou qui ne correspond pas au shell natif n’est pas une ressource de récupération.
Valider les comportements critiques métier
Après le basculement, testez le démarrage de l’app, l’authentification, les paiements, la synchronisation, la gestion des notifications push et tout workflow lié aux données locales. La validation doit utiliser les canaux et les versions client concernés, car un test réussi en staging peut ne pas être représentatif d’un flux de production propre à un client.
Documenter le résultat
Enregistrez le déclencheur, la décision, l'opérateur, l'identité de l'artefact, la population affectée, les horodatages, la version restaurée et le résultat de la validation. Pour les équipes formalisant les contrôles opérationnels dans des environnements sensibles, meilleures pratiques de gestion du changement pour les cliniques fournir un contexte utile sur les approbations, la communication et la traçabilité.
Un exercice de rollback doit tester toute la chaîne. Le NIST recommande de tester les plans de contingence, y compris la récupération et la reconstitution vers un état connu. Le test doit vérifier la détection, l’autorité, le ciblage, la télémétrie, le comportement des sessions utilisateurs, l’escalade et la collecte de preuves. Les équipes peuvent aussi consulter Capacitor conseils de configuration du rollback lors de la transposition de ces contrôles dans un workflow de live update.
Stratégies de rollback : automatisées ou manuelles
L'automatisation est excellente pour réagir à une défaillance évidente et mesurable. Elle est en revanche mauvaise pour interpréter un incident ambigu où un rollback du client pourrait aggraver une incompatibilité backend. Le bon choix n'est pas « automatisé ou manuel » pour tout le système. C'est une répartition basée sur le risque entre les actions sûres à répéter et celles qui exigent du jugement.
Quand l'automatisation a sa place
Le rollback automatique fonctionne bien lorsque le signal est rapide, spécifique et étroitement lié au nouvel artefact. Cela inclut, par exemple, une application qui échoue à son callback de disponibilité au démarrage, une exception d'initialisation critique, un échec de contrôle de compatibilité ou une régression brutale sur une cohorte contrôlée. Le système peut alors stopper le déploiement progressif, restaurer le bundle compatible précédent et alerter l'ingénieur d'astreinte pendant que l'impact reste contenu.
L'automatisation doit être idempotente. Répéter l'action ne doit pas créer une séquence de changements d'état imprévisibles. Elle nécessite également des garde-fous :
- Verrouillez la cible : Restaurer un artefact signé identifié par une version immuable, et non le build qui se trouve étiqueté « précédent ».
- Limitez le périmètre : Appliquez l'action au canal ou à la cohorte affectée, sauf si les preuves indiquent un défaut plus large.
- Conservez la trace : Journalisez automatiquement le déclencheur, le seuil, la règle de décision et la version restaurée.
- Testez le repli : Confirmez que l'ancien bundle peut s'initialiser avec le shell natif et le backend actuellement en service.
Le rollback automatique peut produire des faux positifs. Une panne temporaire de dépendance peut se résorber avant qu'un rollback de bundle ne soit terminé, et un trou de télémétrie régional peut ressembler à une défaillance côté client. Une action automatisée doit donc d'abord suspendre l'exposition quand c'est possible, puis ne revenir en arrière que si le signal est suffisamment clair.
Quand une décision humaine s'impose
L'approbation manuelle convient pour les défaillances de paiement, une éventuelle corruption de données, les problèmes de sécurité, les modifications de schéma irréversibles et les incidents impliquant plusieurs générations de clients. Un ingénieur doit déterminer si l'ancien bundle peut lire sans risque les données écrites par le nouveau, si le backend prend toujours en charge l'ancien contrat, et si les canaux spécifiques à chaque client ont des dépendances différentes.
L'action manuelle est plus lente et plus variable, mais cette friction peut empêcher un rollback techniquement propre d'endommager des enregistrements ou de casser un service déjà migré. La politique doit nommer l'approbateur et fournir un court compte rendu de décision, plutôt que de laisser l'ingénieur d'astreinte chercher dans un document de contrôle d'accès pendant une panne.
Une pause du déploiement est souvent la mesure la plus sûre pour commencer. Elle réduit l'exposition supplémentaire pendant que l'équipe décide si le rollback, la désactivation d'une fonctionnalité ou un correctif direct est la bonne option de rétablissement.
Pour les équipes qui utilisent la livraison progressive, distinguez l'arrêt d'un déploiement progressif du rollback d'une version déjà active. Comparaison entre la pause d'un déploiement et le rollback aide à cadrer cette différence. La politique doit expliciter cette distinction, tant dans les outils que dans le vocabulaire des incidents.
Gouvernance et exigences d'audit pour les rollbacks
Dans un environnement réglementé, « l’application fonctionne à nouveau » ne représente qu’une partie d’un rollback réussi. L’organisation doit aussi démontrer ce qui a changé, qui a approuvé la réponse, quels clients ont reçu l’artefact et si l’état restauré a conservé les contrôles requis.
Un dossier de preuves solide commence par l’identité de l’artefact. Conservez le digest du bundle signé ou du binaire, le commit source, les métadonnées de build, le canal de release, la déclaration de compatibilité et l’approbation de publication. Reliez ensuite cet artefact aux données d’exposition, notamment les populations d’appareils ou de tenants affectées, l’état du déploiement progressif et l’heure à laquelle l’équipe a suspendu ou fait un rollback de la livraison.
Préserver la trace des décisions
L’identité de l’opérateur compte, mais le raisonnement aussi. Conservez la télémétrie déclenchante, l’évaluation du seuil, la chronologie de l’incident, l’horodatage de l’approbation, l’action effectuée, la version restaurée et les vérifications post-rollback. Si l’équipe a choisi de ne pas faire de rollback, conservez également cette décision et sa justification.
Les canaux spécifiques aux clients nécessitent un traitement distinct. Un tenant fintech peut recevoir une configuration ou une combinaison de fonctionnalités absente du flux de production général. Revenir à la version précédente sur le canal global sans vérifier le ciblage des tenants peut créer des comportements incohérents, masquer qui a été affecté ou laisser un client sur une version que l'équipe de réponse aux incidents n'a pas validée.
Protéger les données et les workflows de conformité
Un rollback côté client ne peut pas annuler une migration de base de données qui a déjà modifié l'état de production. Avant d'approuver un rollback, vérifiez si l'ancien client peut lire les enregistrements actuels, si les migrations sont réversibles et si les données locales en cache contiennent des champs ou des formats inconnus pour l'ancien bundle. Si la compatibilité n'est pas garantie, la bonne réponse peut être de désactiver l'exposition et de livrer un correctif (forward fix) plutôt que de forcer un downgrade côté client.
Les responsabilités techniques et de conformité doivent converger ici. Les enregistrements de paiement, les données patients, les décisions d'accès, les événements d'audit et la lignée des données doivent être validés après la récupération. Un rollback qui restaure l'écran mais perd la traçabilité n'est pas une récupération conforme.
Les directives de la supply chain mettent également l'accent sur des passerelles de mise à jour contrôlées, des canaux approuvés, le déploiement progressif, les déclencheurs de rollback et la révocation rapide. L'avis de Sygnia sur la supply chain offre un contexte pertinent aux organisations qui conçoivent des contrôles de preuve et d'accès autour des mises à jour logicielles.
Workflow d'exécution de rollback étape par étape
Un rollback doit se lire comme un runbook, pas comme une improvisation héroïque. La séquence ci-dessous suppose que l'équipe sait séparer le contrôle de l'exposition de la restauration de l'artefact et identifier les limites de compatibilité avant de modifier l'état de la production.
-
Déclarez l'incident et gélérez toute nouvelle exposition. Désignez un responsable d'incident, enregistrez l'identifiant de la release et mettez en pause le déploiement progressif ou le canal concerné. Ne laissez pas d'autres appareils recevoir un artefact pendant que l'équipe définit encore le périmètre.
-
Confirmez le signal d'erreur. Comparez la cohorte affectée à une cohorte saine. Vérifiez le démarrage, l'authentification, les API critiques et le comportement des sessions utilisateur. Un pic de télémétrie peut à lui seul indiquer un problème d'observabilité plutôt qu'un défaut client.
-
Définissez la limite de compatibilité. Identifiez la version du shell natif, le bundle web, le contrat backend, l'état du schéma et le format des données locales. Confirmez que le rollback envisagé peut démarrer et fonctionner avec les services actuellement déployés.
-
Sélectionnez et authentifiez l'artefact cible. Choisissez une version immuable et signée avec un identifiant de build enregistré. Ne vous fiez jamais à une copie locale non vérifiée ni à un label informel du type « dernière release ».
-
Choisissez l'action de récupération. Mettez la livraison en pause, désactivez une fonctionnalité, revenez au bundle web précédent, forcez un mode maintenance ou lancez un forward fix binaire. Utilisez l'action la moins impactante qui élimine le comportement risqué sans créer de décalage de version.
-
Exécutez dans le périmètre approuvé. Appliquez d'abord le changement au canal concerné ou à la population de tenants concernée lorsque les éléments justifient une récupération ciblée. Gardez l'opérateur, l'heure, la raison et l'artefact visibles dans le compte rendu d'incident.
-
Validez les flux critiques. Testez le démarrage, la connexion, les paiements, la synchronisation, les lectures et écritures de données, ainsi que tout workflow ayant déclenché l'incident. Testez sur des shells natifs représentatifs et des canaux clients, pas seulement sur l'appareil d'un ingénieur.
-
Élargissez ou clôturez délibérément. Si la validation réussit, continuez à surveiller et décidez si vous rétablissez une livraison plus large. En cas d'échec, cessez d'élargir l'exposition et escaladez vers un correctif en avant ou un rollback de service plus profond.
Un bon runbook décrit aussi qui est responsable de chaque transfert. Les équipes qui construisent de l’automatisation opérationnelle peuvent s’y référer Guide CIO sur les workflows agentiques pour un contexte plus large sur les actions déléguées, les approbations et l'exécution traçable, puis adapter ces principes aux opérations de release.
Mesurer l'efficacité des rollbacks et les taux d'échec
Compter uniquement les rollbacks donne une image trompeuse. Une équipe peut signaler peu de rollbacks parce que la détection est faible, parce que les ingénieurs tolèrent des releases dégradées, ou parce que chaque incident se transforme en correctif d'urgence. La mesure de la fiabilité doit relier le déploiement d'origine à la remédiation et au temps nécessaire pour rétablir le service pour les utilisateurs.
DORA définit le taux d'échec des changements en tant que proportion des déploiements en production nécessitant une correction immédiate, comme un rollback ou un hotfix. Le calcul est : nombre d'échecs divisé par le nombre total de déploiements, comme documenté dans le guide des métriques DORA. Enregistrez l'identifiant du déploiement, le commit ou le build, le canal affecté, le déclencheur, l'horodatage du rollback et le temps de rétablissement complet afin que la métrique reflète la release réelle ayant causé le problème.
Mesurez l'impact utilisateur
Associez le taux d'échec des changements à des mesures expliquant la sévérité :
- Temps de rétablissement : Mesurez l'intervalle entre l'impact confirmé et le rétablissement validé.
- Périmètre d'impact : Enregistrez les canaux, tenants, appareils et versions client affectés.
- Exposition au moment de la détection : Consignez la propagation de la release avant que l'équipe ne la mette en pause.
- Récurrence : Groupez les incidents par composant, dépendance, zone de configuration et mode de défaillance.
- Qualité de la validation : Notez quels flux critiques pour l'activité ont fonctionné après le rétablissement et lesquels sont restés dégradés.
Un faible taux de rollback n'est pas forcément un signe de santé. Si le monitoring rate les échecs au démarrage ou les erreurs de paiement propres à certains clients, le dashboard peut paraître stable alors que les utilisateurs subissent les dégâts. À l'inverse, des rollbacks automatiques fréquents peuvent indiquer une protection utile ou révéler des seuils trop sensibles.
Analysez les métriques après chaque incident. Demandez-vous si l'alerte s'est déclenchée assez tôt, si l'action choisie correspondait au type de défaillance, si l'artefact de fallback était compatible et si les preuves suffisaient pour une revue de conformité. Métriques de mise à jour en temps réel pour les apps Capacitor peut aider les équipes à réfléchir à l'adoption, aux échecs et à la visibilité par appareil quand elles conçoivent cette boucle de feedback.
La politique la plus robuste transforme le rollback d'un bouton de panique en une expérience contrôlée. Chaque événement doit améliorer le ciblage des releases, les vérifications de compatibilité, la rétention des artefacts, les parcours d'approbation et la validation du retour arrière. La vitesse reste importante, mais seulement si l'équipe peut prouver ce qu'elle a changé et en quoi les utilisateurs sont mieux protégés ensuite.
Capgo permet aux équipes CapacitorJS et Electron de publier des bundles signés (JavaScript, CSS, configuration et assets) vers des canaux ciblés, avec un historique des versions, une observabilité par appareil et une protection automatique contre le rollback en cas d'échec d'initialisation. Visitez Capgo pour évaluer un workflow de Live Update qui sépare la récupération du bundle de la distribution binaire et offre à votre équipe un historique de release plus clair.





