

Sebuah release sudah live, pengguna pertama membuka app, dan incident channel mulai bergerak lebih cepat dari yang bisa dibaca siapa pun. Laporan crash naik, autentikasi gagal untuk sebagian pelanggan, dan support bertanya apakah tim bisa “sekadar undo” deployment itu. Tanpa rollback policy yang sudah disiapkan, engineer terpaksa memutuskan di bawah tekanan: versi mana yang aman, siapa yang boleh memberi otorisasi perubahan, dan apakah revert di satu layer akan merusak layer lain.
Rollback bukan tombol undo ajaib. Dalam aplikasi hybrid, web bundle, native shell, backend schema, dan data lokal yang di-cache bisa punya lifecycle release yang berbeda. Karena itu, policy yang praktis harus mengendalikan exposure, menjaga evidence, dan memulihkan user experience yang kompatibel, bukan sekadar redeploy artifact lama.
Table of Contents
- Mengapa Proteksi Rollback Penting bagi Tim Mobile
- Memahami Akar Penyebab Kegagalan Deployment
- Komponen Penting dalam Kebijakan Rollback
- Strategi Rollback Otomatis vs Manual
- Persyaratan Tata Kelola dan Audit Rollback
- Workflow Eksekusi Rollback Langkah demi Langkah
- Mengukur Efektivitas Rollback dan Tingkat Kegagalan
Mengapa Proteksi Rollback Penting bagi Tim Mobile
Kesalahan pertama tim saat terjadi insiden produksi adalah menganggap kecepatan sebagai satu-satunya tujuan. Membalikkan artifact yang salah dengan cepat bisa memicu insiden kedua, terutama saat JavaScript bundle mengharapkan fungsionalitas native yang tidak disediakan binary yang terpasang. Target yang lebih aman adalah kembali terverifikasi secepat mungkin ke state yang diketahui baik.
Studi empiris mendasar meneliti 345 rilis produksi pada aplikasi web e-commerce besar selama sekitar 1,5 tahun. Di antara 320 rilis dengan data hasil lengkap, 248 rilis, atau 77,5%, selesai tanpa masalah, sementara 72 rilis, atau 22,5%, dikategorikan sebagai gagal karena menyebabkan perilaku abnormal seperti crash, hang, atau performa buruk sesaat setelah deployment. Peneliti mengidentifikasi 17 akar masalah yang berulang dalam empat kategori besar, yang menunjukkan mengapa persiapan rollback tidak bisa hanya fokus pada cacat source-code. Studi rollback rilis memberikan pelajaran operasional penting bagi tim mobile: risiko rilis adalah hal normal yang butuh respons terencana.
Exposure tidak sama dengan pemulihan
Distribusi mobile membuat istilah “rollback” menjadi ambigu. Menjeda staged rollout menghentikan eksposur tambahan. Menonaktifkan feature flag mencegah jalur code berjalan. Melakukan revert pada live web bundle mengubah apa yang diunduh oleh binary terinstal yang kompatibel. Memaksa update binary meminta pengguna menginstal paket native baru, yang mungkin bergantung pada review store, adopsi, dan kesediaan pengguna untuk update.
Rollback di store tidak bisa menghapus binary yang sudah terinstal di perangkat. Emergency forward fix mungkin butuh 24 hingga 72 jam untuk menjangkau pengguna yang terdampak karena keterlambatan review dan adopsi, sesuai panduan mobile release engineering dalam blueprint rollback hybrid app ini. Hal ini membuat rollback live bundle bernilai untuk defect JavaScript, CSS, copy, konfigurasi, atau asset, namun tidak membuat native shell bisa di-revert.
Aturan praktis: Definisikan apa yang dimaksud tim Anda dengan rollback sebelum terjadi insiden. Menghentikan delivery, revert bundle, menonaktifkan fitur, dan merilis binary update adalah tindakan terpisah dengan risiko berbeda.
Strategi ketersediaan yang jelas juga harus mengidentifikasi user journey mana yang harus tetap bisa digunakan saat insiden. Autentikasi, pembayaran, sinkronisasi data, dan startup app sebaiknya dicek sendiri, bukan disembunyikan di balik satu ambang error umum. Tim yang mendokumentasikan perbedaan ini sebelum hari rilis dapat mengurangi ketidakpastian saat support ticket masuk, sebagaimana panduan praktis ketersediaan mobile app juga menekankan.
Memahami Akar Penyebab Kegagalan Deployment
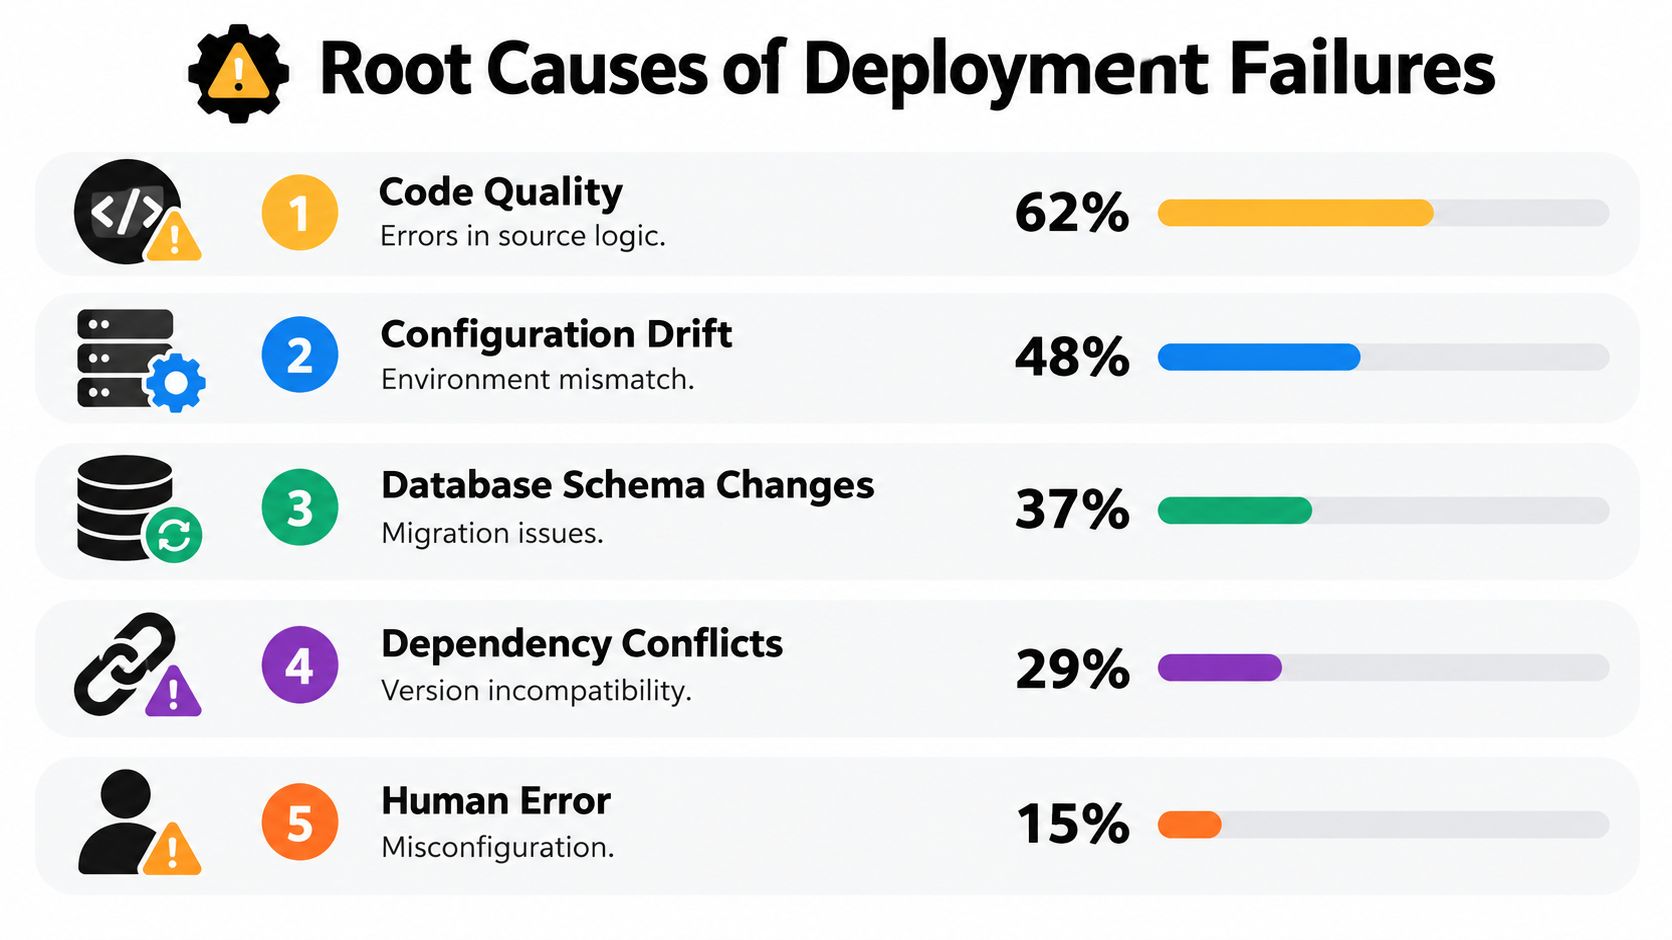
Kebijakan rollback yang berpusat pada “code yang buruk” melewatkan mode kegagalan produksi yang umum. Sebuah studi empiris tahun 2022 terhadap 152 insiden produksi dengan tingkat keparahan tinggi menemukan bahwa bug code menyebabkan 27.0% dari insiden, kegagalan dependensi 16.4%, kegagalan infrastruktur 15.8%, kesalahan deployment 13.2%, dan bug konfigurasi 12.5%. Pengelompokan yang lebih luas mengaitkan 40% dari insiden dengan code atau bug konfigurasi, sementara 60% melibatkan infrastruktur, deployment, atau dependensi layanan. Studi insiden tersebut mendukung kesimpulan praktis: trigger rollback harus memantau lingkungan delivery, bukan hanya binary aplikasi atau live web bundle.
Rancang trigger berdasarkan jenis kegagalan
Kegagalan dependensi bisa membuat code aplikasi tidak berubah, sementara login, pembayaran, atau sinkronisasi berhenti berfungsi. Masalah infrastruktur dapat menyebabkan startup lambat atau API tidak tersedia. Error deployment dapat mengirimkan artifact yang salah ke channel yang salah, sementara masalah konfigurasi dapat mengubah perilaku tanpa commit source baru.
Aplikasi hybrid butuh satu pembedaan lagi. Live web bundle biasanya bisa ditarik atau diganti tanpa mengubah native shell yang terinstal. Cacat kompatibilitas native mungkin memerlukan update binary, yang tidak bisa dibatalkan hanya dengan menyajikan bundle lama. Karena itu, trigger harus mengidentifikasi layer yang bermasalah sebelum menentukan respons.
Studi tersebut menemukan bahwa rollback adalah salah satu strategi mitigasi paling populer. Insiden terkait konfigurasi sangat mengungkap banyak hal: 47% dimitigasi melalui rollback, dibandingkan dengan 21% diselesaikan dengan perbaikan konfigurasi yang sebenarnya, sebagaimana dilaporkan studi insiden yang sama. Hal ini tidak membuat automatic rollback cocok untuk setiap insiden konfigurasi. Ini menunjukkan bahwa status rilis yang sudah terbukti aman bisa memberi batas jangka pendek yang lebih aman daripada mengubah nilai live saat pengguna terdampak.
Matriks trigger yang berguna memisahkan gejala dari kemungkinan penyebabnya:
| Sinyal | Kekhawatiran umum | Respons pertama |
|---|---|---|
| Kegagalan startup | Kecacatan pada bundle, kompatibilitas native, atau inisialisasi | Hentikan paparan dan evaluasi pembalikan |
| Kesalahan autentikasi | Konfigurasi, penyedia identitas, atau ketidakcocokan API | Jeda rollout dan verifikasi dependensi |
| Kegagalan pembayaran | Kontrak backend, perilaku client, atau konfigurasi fitur | Wajibkan persetujuan manusia sebelum mengubah exposure |
| Kerusakan data | Ketidakcocokan migrasi atau persistensi | Lindungi data sebelum melakukan revert |
| Insiden keamanan | Artifact atau jalur pengiriman yang terkompromi | Cabut akses yang terekspos, amankan bukti, dan ikuti prosedur keamanan |
Matriks ini bukan pengganti threshold. Matriks ini menentukan sinyal mana yang dapat memicu aksi otomatis dan mana yang butuh investigasi. Crash rate bisa mendukung respons otomatis, sementara kegagalan pembayaran atau dugaan kerusakan data biasanya butuh owner yang eksplisit.
Analisis kegagalan harus mencakup penargetan channel, signature artifact, build identifier, dependency lockfile, kompatibilitas skema, perilaku cache, dan waktu deteksi. Di lingkungan fintech yang teregulasi, simpan keputusan, versi artifact, bukti yang teramati, approver, dan tindakan yang diambil agar rollback dapat direkonstruksi saat review. Tim yang mulai memformalkan pekerjaan ini dapat menggunakan teknik analisis kegagalan untuk insiden rilis sebagai referensi praktis.
Komponen Penting dalam Kebijakan Rollback
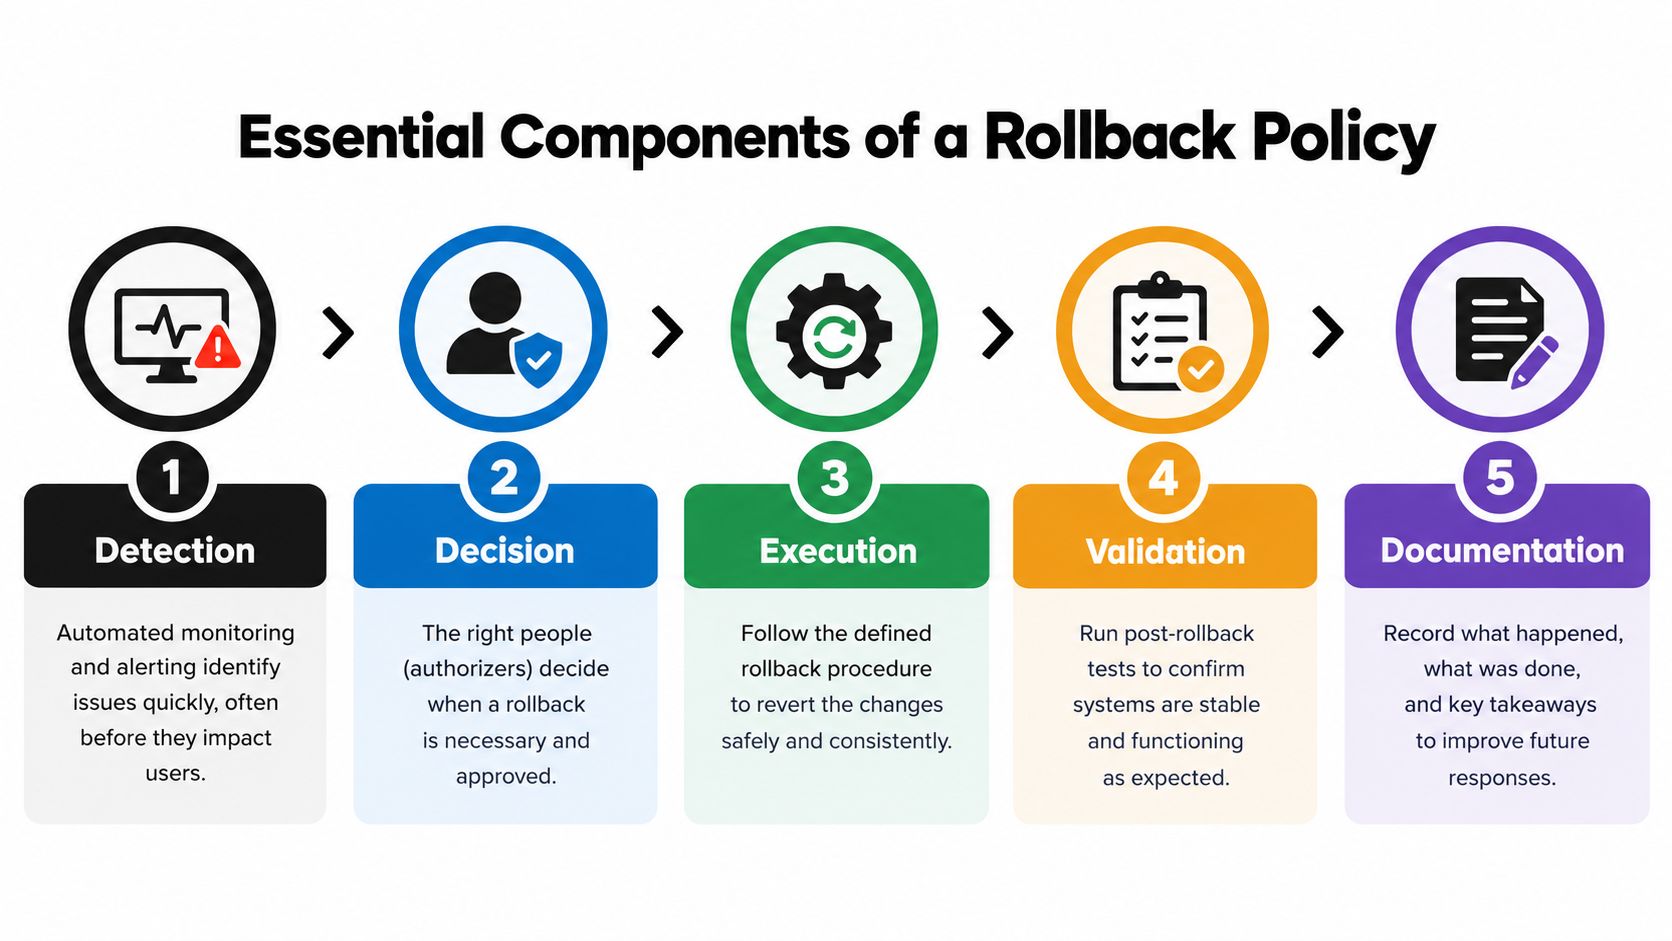
Kebijakan rollback yang matang adalah kesepakatan operasional antara tim engineering, security, product, dan support. Ini menjelaskan apa yang berjalan otomatis, apa yang butuh approval, artifact mana yang tetap tersedia, dan bukti apa yang harus bertahan setelah insiden. Perintah redeploy tunggal tidak memberikan kontrol tersebut.
Deteksi dengan sinyal objektif
Instrumen setiap rilis dengan build identifier, source commit, channel, cohort, dan timestamp deployment. Pantai startup completion, perilaku crash, autentikasi, panggilan API kritis, dan alur kerja bisnis. Gunakan ambang batas yang sesuai dengan tingkat kerusakan kegagalan, bukan persentase error generik yang diterapkan ke semua fitur.
Putuskan dengan otoritas yang ditunjuk
Tuliskan siapa yang bisa menjeda pengiriman, siapa yang bisa mengotorisasi rollback, dan siapa yang harus diberi tahu. Selama regresi startup berisiko rendah, engineer on-call mungkin perlu wewenang untuk menghentikan paparan segera. Dugaan masalah data atau keamanan harus mengaktifkan incident command dan mempertahankan catatan persetujuan yang jelas.
Eksekusi switch versi yang immutable
Simpan beberapa versi sebelumnya yang dapat di-deploy dari perangkat lunak aplikasi, konfigurasi, firmware, dan dokumentasi pendukung. NIST SP 800-53 merekomendasikan penyimpanan sejumlah konfigurasi baseline sebelumnya yang ditentukan organisasi, serta mewajibkan perencanaan kontinjensi untuk mendefinisikan tujuan pemulihan, prioritas restorasi, tanggung jawab, dan hasil yang terukur. Panduan kontinjensi dan konfigurasi mendukung penyimpanan bundle immutable dan berversi, alih-alih mengandalkan direktori “previous” yang ditimpa.
Untuk aplikasi hybrid, sertakan metadata kompatibilitas, verifikasi integritas kriptografis, dan peralihan channel secara atomik. Retensi harus memperhitungkan penemuan cacat yang tertunda dan paparan bertahap, bukan hanya rilis terakhir. Artefak rollback yang tidak dapat diautentikasi atau tidak cocok dengan native shell bukanlah aset pemulihan.
Validasi perilaku kritis untuk bisnis
Setelah peralihan, uji startup aplikasi, autentikasi, pembayaran, sinkronisasi, penanganan push, dan alur kerja apa pun yang terkait dengan data lokal. Validasi harus menggunakan channel dan versi klien yang terdampak, karena pengujian staging yang sehat mungkin tidak mewakili stream produksi yang spesifik pelanggan.
Dokumentasikan hasilnya
Catat pemicu, keputusan, operator, identitas artefak, populasi yang terdampak, timestamp, versi yang dipulihkan, dan hasil validasi. Untuk tim yang memformalkan kontrol operasional di lingkungan sensitif, praktik terbaik manajemen perubahan untuk klinik memberikan konteks yang berguna mengenai persetujuan, komunikasi, dan ketertelusuran.
Simulasi rollback harus menguji seluruh rantai. NIST merekomendasikan pengujian rencana kontinjensi, termasuk pemulihan dan rekonstruksi ke kondisi yang diketahui. Pengujian ini harus memverifikasi deteksi, otoritas, penargetan, telemetri, perilaku sesi pengguna, eskalasi, dan pengumpulan bukti. Tim juga dapat meninjau panduan konfigurasi rollback Capacitor saat menerjemahkan kontrol ini ke dalam alur kerja live-update.
Strategi Rollback Otomatis vs Manual
Automasi sangat baik dalam merespons kegagalan yang jelas dan terukur. Namun, automasi buruk dalam menafsirkan insiden ambigu ketika melakukan revert pada client justru dapat memperburuk inkompatibilitas backend. Pilihan yang tepat bukanlah “otomatis atau manual” untuk seluruh sistem, melainkan pembagian berbasis risiko antara tindakan yang aman diulang dan tindakan yang memerlukan pertimbangan.
Kapan otomatisasi layak dipakai
Rollback otomatis bekerja dengan baik jika sinyalnya cepat, spesifik, dan terkait erat dengan artifact baru. Contohnya termasuk aplikasi yang gagal pada startup readiness callback, exception inisialisasi yang kritis, kegagalan pengecekan kompatibilitas, atau regresi tajam pada cohort tertentu. Sistem dapat menghentikan rollout, mengembalikan bundle kompatibel sebelumnya, dan memberi peringatan kepada engineer on-call saat dampaknya masih terkendali.
Automasi harus bersifat idempotent. Mengulang tindakan tersebut tidak boleh menciptakan urutan perubahan state yang tidak terprediksi. Automasi juga membutuhkan guardrails:
- Pin target: Restore artifact bertanda tangan yang diidentifikasi oleh versi immutable, bukan build yang kebetulan berlabel “previous.”
- Batasi scope-nya: Terapkan tindakan hanya pada channel atau cohort yang terdampak, kecuali ada bukti adanya defect yang lebih luas.
- Pertahankan jejaknya: Catat trigger, threshold, aturan keputusan, dan versi yang di-restore secara otomatis.
- Test fallback-nya: Pastikan bundle versi lama dapat melakukan inisialisasi dengan native shell dan backend yang sedang berjalan saat ini.
Rollback otomatis bisa menghasilkan false positive. Gangguan dependensi sementara bisa pulih sebelum pembalikan bundle selesai, dan celah telemetri regional bisa terlihat seperti kegagalan klien. Karena itu, tindakan otomatis sebaiknya menjeda exposure dulu jika memungkinkan, lalu baru melakukan pembalikan saat sinyalnya cukup jelas.
Kapan manusia harus memutuskan
Persetujuan manual cocok untuk kegagalan pembayaran, potensi korupsi data, masalah keamanan, perubahan schema yang tidak dapat dibatalkan, dan insiden yang melibatkan beberapa generasi klien. Engineer perlu menentukan apakah bundle lama dapat membaca dengan aman data yang ditulis bundle baru, apakah backend masih mendukung kontrak lama, dan apakah channel khusus pelanggan punya dependensi berbeda.
Tindakan manual memang lebih lambat dan bervariasi, namun hambatan tersebut dapat mencegah rollback yang secara teknis bersih justru merusak record atau membuat service yang sudah dimigrasi rusak. Kebijakan harus menyebutkan approver dan menyediakan catatan keputusan singkat, bukan membuat engineer on-call harus mencari-cari dokumen access-control saat outage.
Menjeda rollout sering jadi langkah pertama paling aman. Ini mengurangi exposure baru sambil tim memutuskan apakah reversal, menonaktifkan fitur, atau forward fix adalah pemulihan yang tepat.
Untuk tim yang menggunakan staged delivery, bedakan antara menghentikan progressive rollout dan me-revert versi yang sudah aktif. Perbandingan antara menjeda rollout dan rollback membantu menjelaskan perbedaan itu. Kebijakan harus membuat pembedaan tersebut eksplisit, baik dalam tooling maupun bahasa insiden.
Persyaratan Tata Kelola dan Audit Rollback
Di lingkungan teregulasi, “aplikasi sudah berjalan normal kembali” hanyalah satu bagian dari rollback yang sukses. Organisasi juga harus menunjukkan apa yang berubah, siapa yang menyetujui respons, pelanggan mana yang menerima artifact, dan apakah state yang dipulihkan tetap mempertahankan kontrol yang diperlukan.
Catatan bukti yang dapat dipertahankan dimulai dari identitas artifact. Simpan bundle bertanda tangan atau digest biner, source commit, metadata build, release channel, deklarasi kompatibilitas, dan persetujuan publikasi. Lalu hubungkan artifact itu ke data eksposur, termasuk populasi perangkat atau tenant yang terdampak, status rollout, dan waktu saat tim menjeda atau membalikkan pengiriman.
Pertahankan jejak keputusan
Identitas operator penting, tetapi alasannya juga. Simpan telemetry pemicu, evaluasi threshold, timeline insiden, timestamp persetujuan, tindakan yang diambil, versi yang dipulihkan, dan pengecekan pasca-rollback. Jika tim memilih untuk tidak rollback, simpan keputusan itu beserta alasannya.
Channel khusus pelanggan butuh penanganan terpisah. Tenant fintech mungkin menerima kombinasi konfigurasi atau fitur yang tidak ada di stream produksi umum. Melakukan revert pada channel global tanpa mengecek targeting tenant dapat menyebabkan perilaku tidak konsisten, menyulitkan pelacakan siapa yang terdampak, atau membiarkan satu pelanggan tetap di versi yang belum divalidasi tim incident response.
Lindungi data dan workflow kepatuhan
Rollback client tidak bisa membatalkan migrasi database yang sudah mengubah state produksi. Sebelum menyetujui pembalikan, cek apakah client lama bisa membaca record saat ini, apakah migrasi bersifat reversible, dan apakah data lokal yang di-cache berisi field atau format yang tidak dikenal oleh bundle lama. Jika kompatibilitas tidak terjamin, langkah yang tepat mungkin adalah menonaktifkan exposure dan mengirimkan forward fix daripada memaksa downgrade client.
Kepemilikan teknis dan compliance harus bertemu di sini. Record pembayaran, data pasien, keputusan akses, audit event, dan data lineage perlu divalidasi setelah recovery. Rollback yang memulihkan layar tetapi menghilangkan traceability bukan recovery yang compliant.
Panduan rantai pasokan juga menekankan gateway update yang terkontrol, channel yang disetujui, deployment bertahap, pemicu rollback, dan pencabutan cepat. Advisory rantai pasokan dari Sygnia menyediakan konteks relevan bagi organisasi yang merancang kontrol bukti dan akses seputar pembaruan perangkat lunak.
Workflow Eksekusi Rollback Langkah demi Langkah
Rollback harus terbaca seperti runbook, bukan improvisasi heroik. Urutan di bawah ini mengasumsikan tim dapat memisahkan kontrol eksposur dari pemulihan artifact dan dapat mengidentifikasi batas kompatibilitas sebelum mengubah state produksi.
-
Deklarasikan insiden dan bekukan eksposur baru. Tunjuk pemimpin insiden, catat ID rilis, dan jeda rollout atau channel yang terdampak. Jangan biarkan perangkat lain menerima artifact sementara tim masih menetapkan cakupan.
-
Konfirmasi sinyal kegagalan. Bandingkan kohort terdampak dengan kohort yang terbukti baik. Periksa startup, autentikasi, API kritis, dan perilaku sesi pengguna. Lonjakan telemetri saja mungkin menunjukkan masalah observability, bukan cacat klien.
-
Petakan batas kompatibilitas. Identifikasi versi native shell, web bundle, kontrak backend, state skema, dan format data lokal. Pastikan kandidat rollback dapat dimulai dan beroperasi dengan layanan yang saat ini di-deploy.
-
Pilih dan autentikasi artifact target. Pilih versi immutable yang sudah ditandatangani dengan build identifier yang tercatat. Jangan pernah mengandalkan salinan lokal yang tidak terverifikasi atau label informal “last release”.
-
Pilih tindakan pemulihan. Jeda pengiriman, nonaktifkan fitur, revert web bundle, paksa status maintenance, atau mulai forward binary fix. Gunakan tindakan yang paling tidak mengganggu untuk menghilangkan perilaku tidak aman tanpa menimbulkan version mismatch.
-
Eksekusi sesuai cakupan yang disetujui. Terapkan perubahan ke channel atau populasi tenant yang terdampak terlebih dahulu jika bukti mendukung pemulihan terarah. Pastikan operator, waktu, alasan, dan artifact tetap terlihat di catatan insiden.
-
Validasi alur kritis. Uji startup, login, pembayaran, sinkronisasi, baca-tulis data, dan alur kerja apa pun yang memicu insiden. Uji pada native shell dan channel pelanggan yang representatif, bukan hanya di perangkat engineer.
-
Perluas atau tutup secara terencana. Jika validasi berhasil, terus pantau dan putuskan apakah akan memulihkan pengiriman yang lebih luas. Jika gagal, hentikan perluasan eksposur dan eskalasikan ke forward fix atau rollback layanan yang lebih dalam.
Runbook yang berguna juga menjelaskan siapa pemilik setiap handoff. Tim yang membangun otomatisasi operasional dapat merujuk ke ini Panduan CIO untuk agentic workflows untuk konteks yang lebih luas mengenai delegasi aksi, persetujuan, dan eksekusi yang terlacak, lalu adaptasikan prinsip-prinsip tersebut ke operasi rilis.
Mengukur Efektivitas Rollback dan Tingkat Kegagalan
Hanya menghitung rollback saja memberikan gambaran yang menyesatkan. Sebuah tim mungkin melaporkan sedikit pembalikan karena deteksi yang lemah, karena insinyur mentolerir rilis yang menurun, atau karena setiap insiden menjadi perbaikan darurat ke depan. Pengukuran keandalan harus menghubungkan deployment awal dengan remediasi dan waktu yang dibutuhkan untuk memulihkan pengguna.
DORA mendefinisikan tingkat kegagalan perubahan sebagai proporsi deployment produksi yang butuh perbaikan segera, seperti rollback atau hotfix. Perhitungannya adalah jumlah kegagalan perubahan dibagi total deployment, sebagaimana didokumentasikan dalam panduan metrik DORA. Catat ID deployment, commit atau build, channel yang terdampak, trigger, timestamp rollback, dan waktu selesainya pemulihan agar metrik mencerminkan rilis aktual yang menyebabkan masalah.
Ukur dampak ke pengguna
Pasangkan change failure rate dengan metrik yang menjelaskan tingkat keparahan:
- Waktu pemulihan: Ukur interval dari dampak yang terkonfirmasi hingga pemulihan yang tervalidasi.
- Radius dampak: Catat channel, tenant, device, dan versi client yang terdampak.
- Exposure saat deteksi: Pantau sejauh mana rilis telah tersebar sebelum tim menghentikannya.
- Pengulangan: Kelompokkan insiden berdasarkan komponen, dependensi, area konfigurasi, dan mode kegagalan.
- Kualitas validasi: Catat alur bisnis kritis mana yang berhasil setelah pemulihan dan mana yang masih terganggu.
Angka rollback yang rendah tidak selalu berarti sehat. Jika monitoring melewatkan kegagalan startup atau error pembayaran pada pengguna tertentu, dashboard bisa terlihat stabil padahal pengguna sedang terdampak. Sebaliknya, rollback otomatis yang sering bisa jadi tanda proteksi yang berguna, atau menunjukkan threshold yang terlalu sensitif.
Tinjau metrik setelah setiap insiden. Evaluasi apakah sinyal terpicu cukup dini, apakah tindakan yang diambil sesuai dengan jenis kegagalan, apakah artifact fallback kompatibel, dan apakah buktinya cukup untuk tinjauan kepatuhan. Metrik update real-time untuk aplikasi Capacitor dapat membantu tim memikirkan adopsi, kegagalan, dan visibilitas per-perangkat saat merancang feedback loop tersebut.
Kebijakan terkuat mengubah rollback dari tombol panik menjadi eksperimen terkendali. Setiap kejadian harus meningkatkan targeting rilis, pengecekan kompatibilitas, retensi artifact, jalur persetujuan, dan validasi pemulihan. Kecepatan tetap penting, tapi hanya jika tim bisa membuktikan apa yang berubah dan mengapa pengguna lebih aman setelahnya.
Capgo memungkinkan tim CapacitorJS dan Electron memublikasikan bundle JavaScript, CSS, konfigurasi, dan aset yang sudah ditandatangani ke channel tertentu, lengkap dengan riwayat versi, observabilitas per perangkat, dan proteksi rollback otomatis jika inisialisasi gagal. Kunjungi Capgo untuk mengevaluasi workflow live update yang memisahkan pemulihan bundle dari distribusi binary dan memberi tim Anda jejak rilis yang lebih jelas.





