
Um 16 Uhr erreicht ein Web-Layer-Update die Produktion. Innerhalb von Minuten steigen die Crash-Reports, Support-Tickets gehen ein und das Team stellt fest, dass das neue JavaScript-Bundle nur auf einem Teil der Geräte fehlschlägt. Auf ein Review im App Store oder bei Google Play zu warten, ist keine Option. Doch eine ältere Datei wiederherzustellen reicht nicht, wenn sich auch Konfiguration, APIs, Feature Flags oder gespeicherte Daten geändert haben. Ein brauchbares Beispiel für einen Rollback-Plan muss dem Betreiber sagen, was die Reaktion auslöst, welche Version wiederhergestellt werden soll, wie die Wiederherstellung überprüft wird und wann ein Revert von code den Vorfall sogar verschlimmern könnte.
Die folgenden sieben Playbooks verknüpfen Rollback-Aktionen mit bestimmten Fehlertypen in Capacitor und Electron-Apps, einschließlich Releases, die über Capgo Channels. Verwenden Sie sie als Runbook-Muster und ersetzen Sie die Beispiel-Trigger durch Baselines aus Ihrem eigenen Crash-, Business- und Datenintegritäts-Monitoring.
Inhaltsverzeichnis
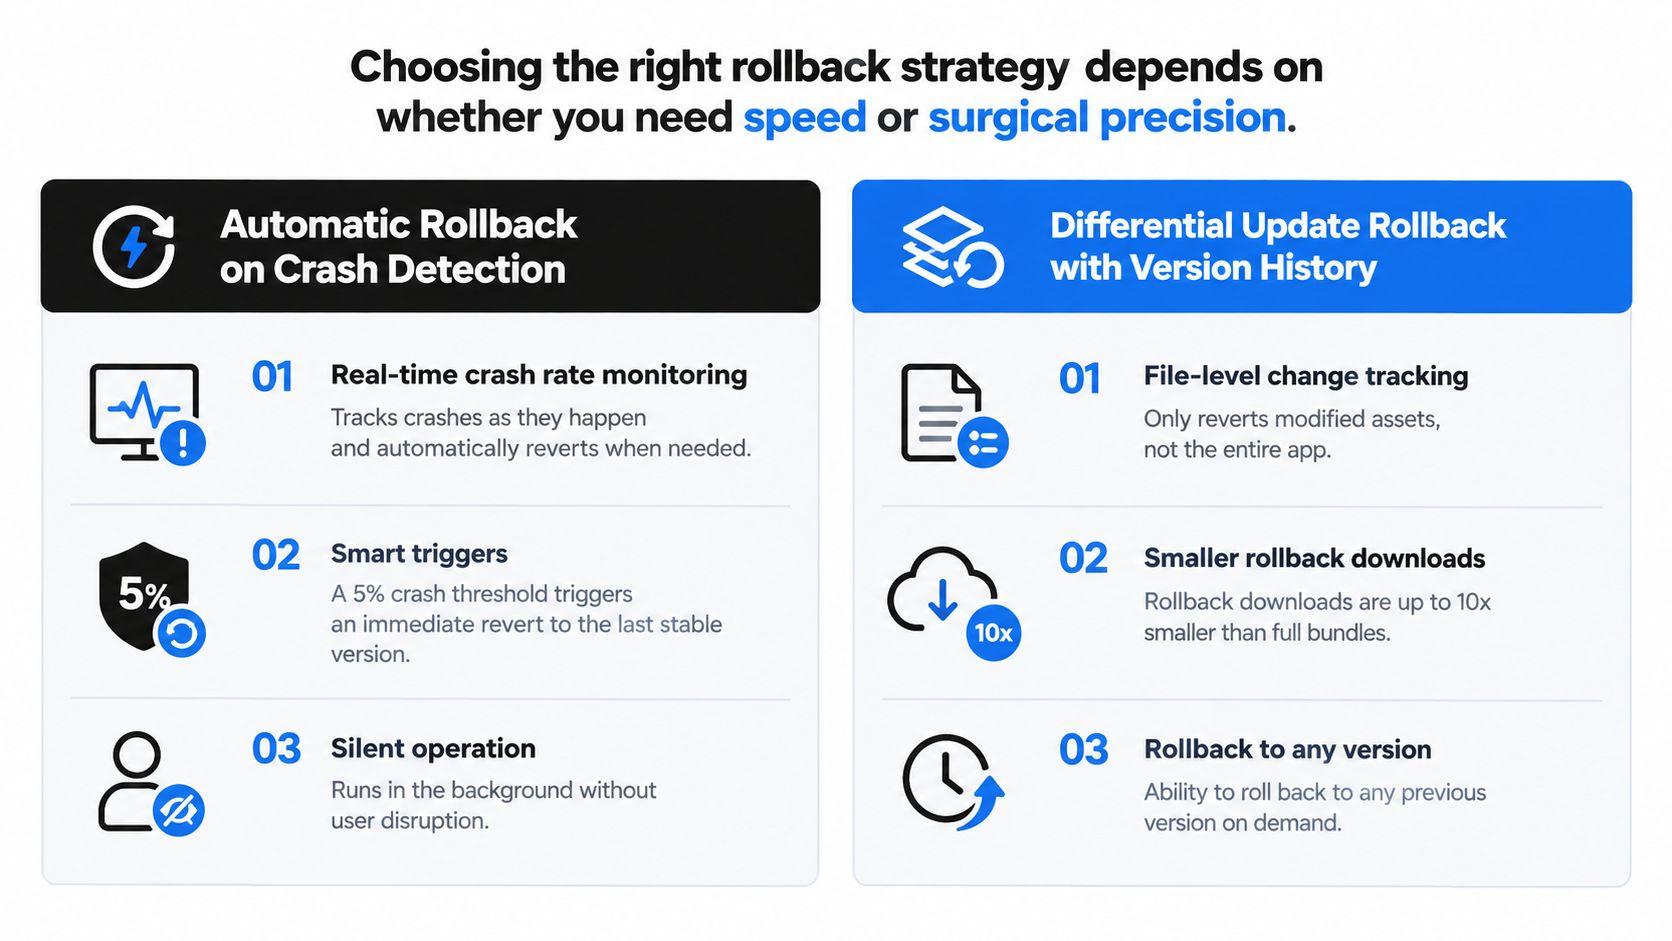
- 1. Automatischer Rollback bei Crash-Erkennung
- 2. Differential-Update-Rollback mit Versionshistorie
- 3. Staged Rollout mit automatischem Rollback bei verschlechterten Metriken
- 4. Configuration-Only-Rollback mit Feature Flags
- 5. Canary Rollback mit Nutzerzustimmung und manuellem Override
- 6. Rollback von Datenbankmigrationen mit Schema-Versioning
- 7. Incident-basierter Rollback mit automatisierter Observability und Post-Mortems
- 7 Rollback-Plan-Beispiele im Vergleich
- Übernimm diese Rollback-Plan-Beispiele in dein Runbook
1. Automatischer Rollback bei Crash-Erkennung
Ein automatischer Rollback ist die richtige erste Reaktion, wenn ein neues Web-Bundle zu einem offensichtlichen Startup-Fehler, einer JavaScript-Exception, einem Native-Plugin-Fehler oder einem Crash-Muster führt, das im vorherigen Release nicht auftrat. Der Trigger sollte maschinenlesbar sein und an eine Version, einen Channel, eine Device-Gruppe und ein Beobachtungsfenster gekoppelt werden. Ein Release-Controller kann die Distribution pausieren und das letzte funktionierende Bundle wiederherstellen, ohne dass ein Engineer erst das Dashboard prüfen muss.
Überwache bei einer Capacitor App mehr als nur Native Crashes. Verfolge, ob die App startet, ob die WebView lädt, ob notifyAppReady() sie vollständig lädt, ob kritische Plugins initialisiert werden und ob der erste User Flow erfolgreich ist. Electron-Teams sollten zudem Renderer-Prozess-Fehler, Main-Prozess-Exceptions, Fehler bei der Update-Installation und fehlgeschlagene IPC-Calls überwachen.
Praktische Regel: Ein automatischer Rollback sollte zuerst die Exposition stoppen und dann den Service wiederherstellen. Er sollte nicht versuchen, die Ursache zu diagnostizieren, während die Nutzer noch das verdächtige Bundle erhalten.
Ein praktischer Trigger könnte ein anhaltender Anstieg von Crashes oder fehlgeschlagenen Readiness-Checks über der Release-Baseline sein. Übernimm keine Schwellenwerte aus anderen Apps. Setze ein konservatives Limit für die Produktion, validiere es gegen die normale Geräte- und OS-Variation und verlange genügend Beobachtungen, um nicht auf ein einzelnes Gerät zu reagieren.
Trigger, Aktion und Fehlermodus
- Trigger: Crash-, Startup-, Readiness- oder Native-Plugin-Signale überschreiten das Release-Gate für den betroffenen Channel.
- Aktion: Channel-Expansion einfrieren, das Bundle als unhealthy markieren, das vorherige signierte Bundle redeployen und Startup sowie kritische Flows prüfen.
- Kompromiss: Die Wiederherstellung ist schnell, aber ein zu sensibler Trigger kann ein gesundes Release wegen eines unabhängigen Geräte- oder Backend-Problems reverten.
- Failure Mode: Das ältere Bundle hängt von einem geänderten API oder einer Konfiguration ab, sodass die App startet, aber später fehlschlägt. Kompatibilitätsprüfungen im Health Gate beibehalten.
Für die Diagnose pro Device und Crash-Korrelation nutzen Sie diesen Guide, um Firebase Crashlytics mit Capacitor Apps zu verbinden. Testen Sie den kompletten Pfad in einem Staging-Channel, inklusive Erkennung, Channel-Freeze, Redeployment, Client-Download, Aktivierung und der Bestätigung, dass die alte Version nutzbar bleibt.
2. Differential-Update-Rollback mit Versionshistorie
Ein differenzieller Rollback eignet sich für Fehler, die auf ein Stylesheet, ein Asset, einen Konfigurationswert oder ein JavaScript-Modul begrenzt sind. Der Updater überträgt nur Dateien, die sich zwischen dem aktiven Release und einem bekannt guten Ziel unterscheiden, was die Download-Last für Nutzer mit unzuverlässigen Verbindungen reduziert. Das Ziel muss trotzdem ein vollständiges Release rekonstruieren.
Der Auslöser ist ein bestätigter Fehler auf Dateiebene, der keine Änderung an der nativen Runtime erfordert. Bevor du handelst, vergleiche die aktiven und vorherigen Manifeste, prüfe die Capacitor- oder Electron-Runtime-Version und stelle sicher, dass der betroffene Channel ein kompatibles signiertes Bundle hat. Überschreitet der Fehler diese Grenze, deploye das vollständige vorherige Bundle, statt eine Reparatur nur auf Dateiebene zu versuchen.
Differential Delivery ist keine Teilwiederherstellung. Kombiniere niemals beliebige Dateien aus verschiedenen Releases. Speichere unveränderliche Manifeste, validiere Checksums und Signaturen, behalte das vollständige vorherige Artefakt und protokolliere die aktive Version in der Channel-Historie. Ein Mismatch zwischen JavaScript-Bundle und Native-Plugin kann dazu führen, dass die App zwar startet, aber ein kritischer Flow später fehlschlägt.
Capgos App-Versionshistorie hilft Ops dabei, vor einem Redeploy einen bekannt guten Build zu finden. Protokolliere für jedes Release die Bundle-ID, die native Runtime-Version, den Capgo Channel, die Konfigurationsrevision und Migrationshinweise.
Nutze dieses Runbook:
- Bestätige, dass der Fehler auf Web-Assets, die Konfiguration oder code beschränkt ist.
- Freeze den betroffenen Channel, damit keine weiteren Geräte die fehlerhafte Version erhalten.
- Wähle das letzte kompatible, signierte Bundle aus, nicht nur die nächstliegende ältere Datei.
- Generiere ein Differential-Update nur dann, wenn Client und Manifest eine sichere Rekonstruktion unterstützen.
- Teste den App-Start, die Integrity Checks, die API-Kompatibilität und den betroffenen User Flow.
- Überwache Downloads, Aktivierung und Rollback-Abschluss auf Capacitor und Electron-Clients.
Eine fehlgeschlagene Rekonstruktion, ein Checksum-Mismatch, eine inkompatible native Dependency oder eine Aktivierungsschleife sind Fehlerzustände. Stoppe Differential Delivery und deploye das vorgehaltene Full Bundle erneut. Die Versionshistorie beantwortet, was sich geändert hat und welches Release die Kompatibilitätsgrenze sicher überschreiten kann. Sie ersetzt keine getesteten Rollback-Artefakte oder Migrationshinweise.
3. Staged Rollout mit automatischem Rollback bei verschlechterten Metriken
Ein Release kann Startup-Checks bestehen und trotzdem einen Core-Workflow beschädigen. Nutze für einen Staged Rollout separate Capgo Channels für Beta, Staging, Production oder Kunden-Cohorts. Promote jeweils nur ein signiertes Bundle und halte die vorherige kompatible Version für jeden Channel bereit. Das begrenzt die Auswirkungen und sichert einen direkten Recovery-Pfad für Capacitor und Electron-Clients.
Setze das Release-Gate vor der Promotion. Überwache bei Checkout-Änderungen abgeschlossene Zahlungen, nicht nur Crashes. Bei Messaging prüfe die Zustellungsverzögerung und erfolgreiche Zustellung. Bei der Synchronisation im Gesundheitswesen validiere die Vollständigkeit der Datensätze. Vergleiche jedes Signal mit der Baseline für dasselbe Publikum, dieselbe Geräteverteilung und denselben Channel. Ein Release ist nur gesund, wenn die kritische Aktion korrekt abgeschlossen wird.
Nutze diese Reihenfolge während der Promotion:
- Benenne einen Owner, der technische und geschäftliche Signale prüft.
- Beobachte die definierte Kohorte für den vereinbarten Zeitraum.
- Stoppe die Promotion sofort, sobald eine überwachte Metrik ihren genehmigten Schwellenwert überschreitet.
- Freeze den betroffenen Capgo-Channel und bewahre die Release-ID, Client-Versionen, Konfiguration und Metrik-Nachweise auf.
- Deploye das letzte kompatible Bundle erneut für diese Kohorte.
- Verifiziere Start, Update-Aktivierung und den betroffenen Workflow auf repräsentativen Capacitor- und Electron-Geräten.
- Promotion erst nach Bestätigung der Wiederherstellung durch den Owner fortsetzen.
Der Guide zu gestaffelten Rollouts für Capacitor Live Updates bietet Deployment-Kontext für Channel-basierte Releases. Automatisierte Rollbacks sollten nur ausgeführt werden, wenn Metrik und Schwellenwert eindeutig sind. Ein Zahlungs-, Datenschutz-, Sicherheits- oder Datenintegritätsfehler kann sofortiges Handeln rechtfertigen, auch bevor statistische Konfidenz vorliegt.
Das Hauptproblem ist ein zu enges Dashboard. Die technische Gesundheit kann normal bleiben, während sich ein Geschäftsergebnis verschlechtert, und seltene Geräte-, Konto- oder Netzwerkbedingungen tauchen in der ersten Kohorte möglicherweise nie auf. Halten Sie diese Lücken vor dem nächsten Release im Runbook fest.
4. Configuration-Only-Rollback mit Feature Flags
Ein Konfigurations-Rollback eignet sich für Fehler, die auf eine einzelne Funktion beschränkt sind. Lassen Sie das neue Capacitor- oder Electron-Bundle installiert und schalten Sie den riskanten Pfad über einen Remote-Flag für den betroffenen Capgo-Channel oder die Zielgruppe aus. Die App kann Empfehlungslogik, eine Interface-Variante, optionale Synchronisierung, experimentelle Speicherung oder ein anderes abgesichertes Verhalten wiederherstellen, ohne unbeteiligte code zu ersetzen.
Der Fallback muss bereits existieren. Stelle sicher, dass er mit dem aktuellen API und dem Datenmodell kompatibel bleibt, weise einen Owner zu und dokumentiere den Scope sowie den Emergency-Default des Flags vor dem Release. Den alten Pfad zu entfernen und erst nach einem Incident ein Flag hinzuzufügen, lässt nichts zum Aktivieren übrig.
Führe den Flag-Rollback als klar begrenztes Playbook aus
- Trigger: Ein featurespezifischer Fehler, ein fehlgeschlagener Workflow, Datenschutzbedenken, Akkuprobleme oder eine geschäftliche Regression überschreiten den vereinbarten Schwellenwert des Teams.
- Aktion: Deaktiviere das Flag für den betroffenen Capgo Channel oder die entsprechende Audience. Bestätige, dass die Clients die Änderung erhalten, und teste den Fallback auf repräsentativen Capacitor und Electron-Geräten.
- Verifizierung: Prüfe den aktiven Flag-Status, relevante Events, das Startup-Verhalten und den betroffenen Workflow. Behalte das neue Bundle bei, während das Team den Fehler isoliert.
- Kompromiss: Die Änderung ist schnell und gezielt, kann aber keine geteilten Dependencies, inkompatible native code oder korrumpierte Daten reparieren.
- Failure Mode: Das Update kommt eventuell nicht an, wird beim Startup ignoriert oder bleibt eventuell im Cache. Logge den Flag-Status bei jedem relevanten Event und definiere die Cache-Expiry.
Nutze das Leitfaden zur Feature-Flag-Implementierung um diese Steuerung in einem Capgo Workflow zu strukturieren. Behalte für kritische Features einen lokalen Notfall-Standardwert bei. Falls die Konfiguration nicht abgerufen werden kann, muss der Zugriff verweigert werden (fail closed). Sicherheits- und datenschutzrelevante Features sollten den Zugriff bei einem Control-Plane-Ausfall deaktivieren, anstatt ihn aufrechtzuerhalten.
5. Canary Rollback mit Nutzerzustimmung und manuellem Override
Ein Canary Release kann in der Telemetrie gesund aussehen, während es für ein Enterprise-Konto, eine Benutzerrolle oder eine Integration fehlschlägt. Biete dieser Gruppe einen klaren Fallback und eine Möglichkeit, das Problem zu melden. Ihr Feedback kann Workflow- oder Usability-Fehler aufdecken, die in aggregierten Metriken untergehen.
Nutze getrennte Steuerungen für User und Operatoren. Die benutzerseitige Aktion sollte außerhalb des defekten Workflows verfügbar sein, erklären, was ein Revert bewirkt, und das aktive Bundle, die Native-App-Version, den Capgo Channel, das Gerät sowie den Zeitstempel erfassen. Verifiziere bei Capacitor Apps das vorherige Web-Bundle gegen die installierte Native Shell. Bestätige bei Electron, dass der Fallback mit der gepackten Desktop-Runtime kompatibel bleibt.
Setze den Canary-Trigger vor dem Release:
- Trigger: Friere den Channel ein, wenn ein Segment wiederholt Opt-outs meldet, Meldungen sich häufen oder eine technische Metrik ihren vereinbarten Schwellenwert überschreitet.
- User-Aktion: Zeige die Fallback-Auswahl an, erfasse Zustimmung und Diagnose-Kontext und bringe den User dann zurück zum vorherigen kompatiblen Bundle.
- Operator-Aktion: Weitere Exposition pausieren, Berichte prüfen und den Canary-Kanal auf den stabilen Build umleiten. Eine manuelle Override-Option bereitstellen, falls die Control Plane oder die Client-UI nicht verfügbar ist.
- Kompromiss: Consent verbessert die Transparenz und macht Probleme früh sichtbar, aber gemischte Versionen erhöhen den Support-Aufwand und erschweren Vergleiche.
- Failure Mode: Ein Nutzer kann zurückrollen, ohne Kontext zu übermitteln, oder der alte Client kann gegen ein geändertes Backend fehlschlagen. Behandeln Best Practices für Nutzerzustimmung bei OTA-Updates als Teil des Kommunikations- und Opt-out-Designs und um Serverkompatibilität zu erhalten oder Funktionen kontrolliert zurückzunehmen.
Präsentiere dieses Rollback nicht als Lösung für serverseitige Inkompatibilität. Wenn sich der Backend-Vertrag geändert hat, stelle zuerst die Kompatibilität wieder her oder deaktiviere den betroffenen Workflow.
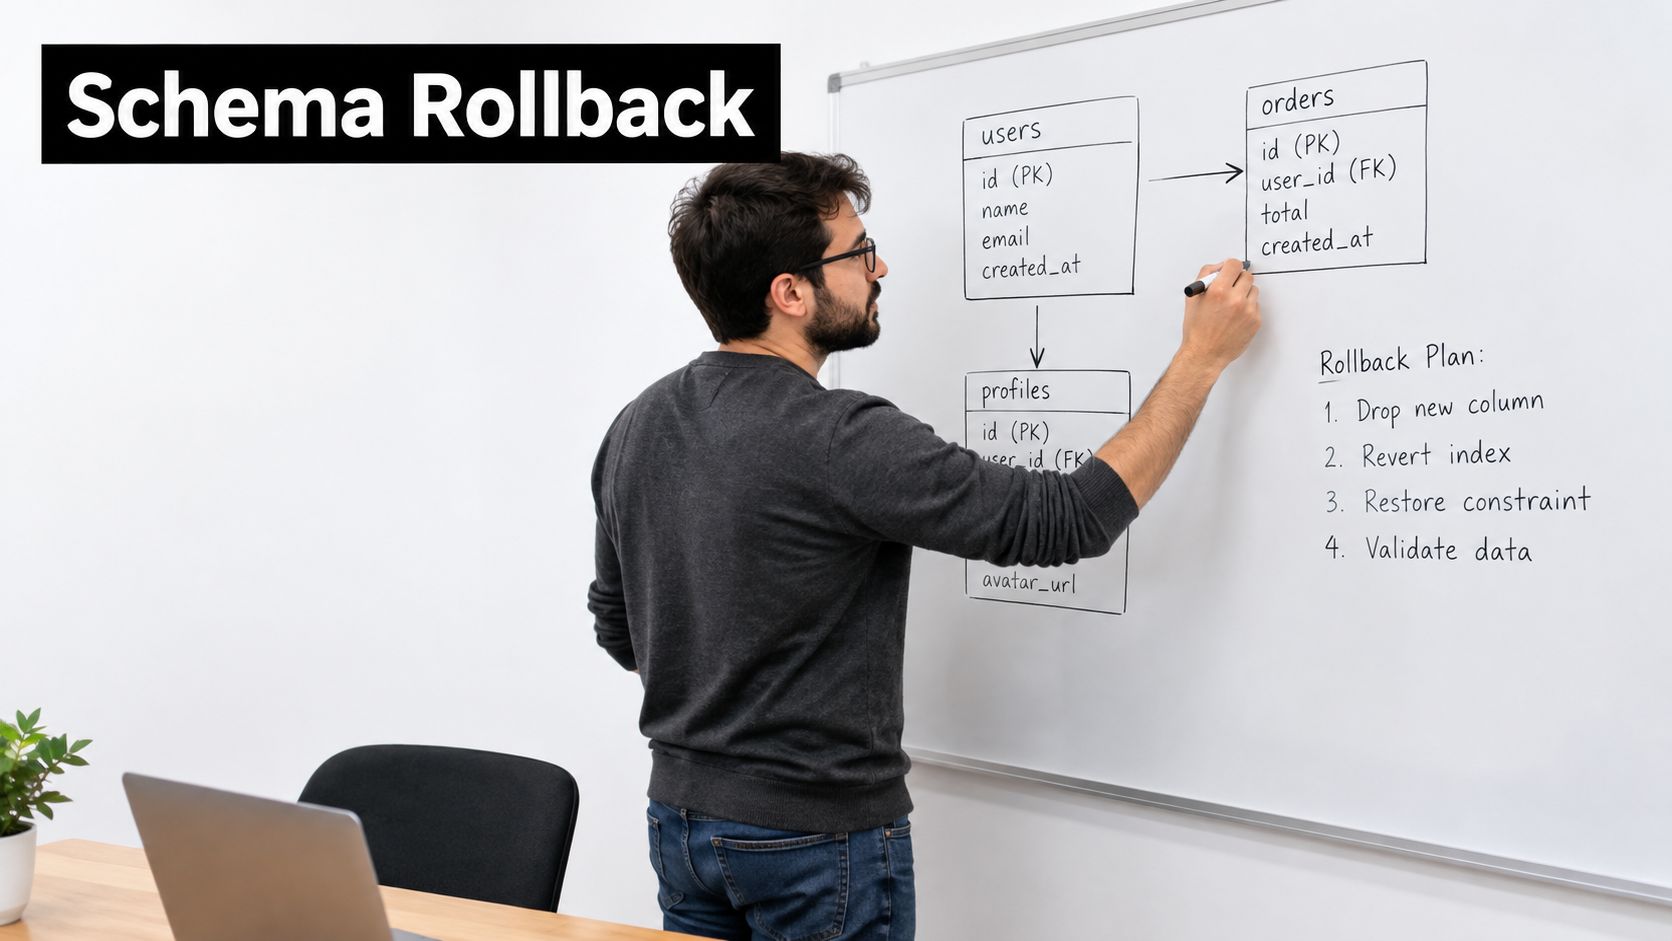
6. Rollback von Datenbankmigrationen mit Schema-Versioning
Ein Bundle-Rollback kann ein inkompatibles Schema nicht reparieren. Ein Capacitor- oder Electron-Client kann zu seinem vorherigen code zurückkehren, während das API oder die lokale Datenbank weiterhin neue Felder, geänderte Typen oder teilweise migrierte Daten erwartet. Das Ergebnis können fehlgeschlagene Lesevorgänge, abgelehnte Schreibvorgänge oder fehlerhafte Datensätze sein.
Behandle die Migration als eigenständiges Release mit einem Wiederherstellungspfad. Beginne mit einer Expand-Phase: Füge kompatible Felder oder Tabellen hinzu, ohne die alte Darstellung zu entfernen. Deploye code, das beide Formate liest und schreibt, und migriere dann bestehende Datensätze mit Validierung. Wechsle den Traffic gezielt. Entferne Legacy-Strukturen erst, wenn der vorherige Client nicht mehr benötigt wird. So bleibt ein Rollback des Capgo-Kanals möglich, während das neue Schema weiterhin deployed ist.
Der Review zu rollback-sicheren Datenbankmigrationen deckt transaktionale Migrationen, rückwärtskompatible Schemata und getrennte Deployments von Datenbank und Anwendung ab. Wende diese Maßnahmen auf Zahlungsdaten, Bestellungen, Patientendaten und andere Informationen an, die nicht sicher neu erstellt werden können.
Lege den Wiederherstellungspfad vor dem Release fest:
- Anwendungs-Rollback: Stelle das vorherige Capacitor Bundle oder Electron-Paket erst wieder her, nachdem du bestätigt hast, dass es das aktuelle Schema lesen kann.
- Feature-Rollback: Deaktiviere den neuen Schreibpfad oder das Feature Flag und behalte dabei die kompatiblen Schema-Änderungen bei.
- Migration-Recovery: Stoppe betroffene Schreibvorgänge, prüfe die Datensätze und führe ein geprüftes Forward-Fix- oder Recovery-Verfahren aus.
- Datenwiederherstellung: Nutze Backups oder Point-in-Time-Recovery, wenn ein code-Reversal die Datenkorrektheit nicht wiederherstellen kann.
Halte Forward- und Recovery-Skripte im Review. Teste sie mit produktionsnahen Daten und nutze Transaktionen oder Savepoints, falls unterstützt. Generiere während eines Incidents kein destruktives Rollback-SQL. Definiere Erfolgsbedingungen für App-Health, Datenvalidität und Schreibkompatibilität – mit jeweils eigenen Verantwortlichen für jede Entscheidung. Ein Migrationsplan, der nicht im Staging geübt wurde, ist kein verlässliches Beispiel für einen Rollback-Plan.
7. Incident-basierter Rollback mit automatisierter Observability und Post-Mortems
Ein Capgo Channel kann einen gesunden Rollout anzeigen, während eine bestimmte Capacitor- oder Electron-Kohorte nach dem Launch fehlschlägt. Definiere den Incident-Trigger vor dem Release, etwa anhaltende Crash-Signale, fehlgeschlagene Readiness-Checks, einen defekten API-Flow oder bestätigte Datenintegritätsfehler. Friere bei einem Alert die Channel-Expansion ein und protokolliere das aktive Bundle, die Native-Build-Version, den Channel, den Rollout-Status, die betroffene Kohorte, die Fehlerkategorie und die Zeitstempel. Erfasse diese Nachweise, bevor du den Deployment-Status änderst.
DORA-Empfehlungen zu Deployment- und Recovery-Metriken Rollen Sie Rollbacks sowohl als Signal für Fehlschläge bei Änderungen als auch als Recovery-Ereignis ein. Speichern Sie die Release-Kennung und das Rollback-Ergebnis und vergleichen Sie dann die Zeit von der Erkennung bis zur Wiederherstellung, die betroffenen Sessions oder Geräte sowie die Fehlerquoten nach der Wiederherstellung. Diese Kennzahlen zeigen, ob der wiederhergestellte Bundle den Fehler beseitigt hat.
Führen Sie den Vorfall als kurze, protokollierte Sequenz durch:
- Auslöser: Bestätigen Sie den Alarm anhand von Crash-, Readiness-, API-, Geschäfts- oder Daten-Signalen.
- Einfrieren: Stoppen Sie die Kanalerweiterung und deaktivieren Sie den Feature-Flag, wenn dies die Auswirkungen besser begrenzt als ein vollständiger Rollback.
- Sichern: Sichern Sie Logs, Traces, Versionshistorie, Adoptionsstatus und Details der betroffenen Segmente.
- Rollback: Letzte kompatible Bundle für Capacitor oder Electron neu deployen und native Versionskompatibilität berücksichtigen.
- Prüfen: Teste den Start und kritische Flows und bestätige dann, dass das Fehlersignal abnimmt.
- Prüfen: Ursache, fehlende Erkennung, Entscheidung und Runbook-Änderung dokumentieren.
Ein fehlgeschlagener Rollback ist selbst ein Trigger. Eskaliere zum letzten bekannt guten Channel oder zu einem manuellen Deployment-Pfad, falls die wiederhergestellte Version abstürzt, nicht startet oder denselben API-Fehler reproduziert. Nutze dazu Forge Reliability Root-Cause-Guide um die Untersuchung zu strukturieren. Führe das Blameless Post-mortem durch, solange Beweise verfügbar sind, weise jeder Korrekturmaßnahme einen Owner zu und teste den daraus resultierenden Readiness Check oder Channel-Guardrail.
7 Rollback-Plan-Beispiele im Vergleich
| Strategie | Implementierungsaufwand 🔄 | Ressourcenbedarf 💡 | Erwartete Ergebnisse 📊 / ⭐ | Ideale Anwendungsfälle 💡 | Hauptvorteile ⭐ / ⚡ |
|---|---|---|---|---|---|
| Automatischer Rollback bei Crash-Erkennung | Mittel 🔄🔄 | Echtzeit-Monitoring + Error-Tracking-Systeme | Schnelle Mitigation; niedrigere MTTR 📊 ⭐⭐⭐⭐ | Produktions-Apps mit hohem Stabilitätsbedarf (Fintech, Healthcare) | Stiller, automatischer Schutz; schnelle Recovery ⚡ ⭐ |
| Differential-Update-Rollback mit Versionshistorie | Hoch 🔄🔄🔄 | Versionsspeicherung, Diff-Engine, State Management | Bandbreiteneffiziente, präzise Rollbacks 📊 ⭐⭐⭐⭐ | Nutzer mit schlechtem Netz, große Assets, Indie-Teams | Präzision auf Dateiebene; deutlich kleinere Rollback-Downloads ⚡ ⭐ |
| Staged Rollout mit automatischem Rollback bei Metrikverschlechterung | Sehr hoch 🔄🔄🔄🔄 | Robuste Metrics-Infrastruktur, A/B-Frameworks, Targeting | Reduzierter Blast Radius; schützt Business-Metriken 📊 ⭐⭐⭐⭐ | E-Commerce, umsatzkritische Features, große Nutzerbasen | Datengetriebenes Vorgehen; erkennt Business-Impact frühzeitig ⭐ 📊 |
| Configuration-Only-Rollback mit Feature Flags | Niedrig 🔄 | Feature-Flagging/Config-Deployment (kein Rebuild) | Sofortiger Feature-Rollback; minimale Nutzerbeeinträchtigung 📊 ⭐⭐⭐ | Feature-Regressionen, schnelle Fixes, kleine Teams | Schnellster Rollback (Minuten); kein App-Store-Review ⚡ ⭐ |
| Canary-Rollback mit Nutzerzustimmung und manuellem Override | Hoch 🔄🔄🔄 | Canary-Targeting, In-App-UI, Feedback-Erfassung | Frühe Erkennung von Edge Cases; qualitative Insights 📊 ⭐⭐⭐ | Enterprise-Beta-Programme, Release auf Basis von User-Feedback | Nutzerautonomie + direktes Feedback; sichereres frühes Testing ⭐ 💡 |
| Datenbank-Migrations-Rollback mit Schema-Versionierung | Sehr hoch 🔄🔄🔄🔄 | DB-Expertise, Migration-Tooling, Staging-Daten | Sichert Datenintegrität; konforme Rollbacks 📊 ⭐⭐⭐⭐ | Regulierte Branchen, E-Commerce, Apps mit komplexen Daten | Sichere bidirektionale Migrationen; Audit-Trails und Validierung ⭐ |
| Incident-basiertes Rollback mit Observability & Post-Mortems | Sehr hoch 🔄🔄🔄🔄 | Fortgeschrittene Observability, Incident-Mgmt., Storage | Schnelle Reaktion mit Forensik-Kontext; Organisationslernen 📊 ⭐⭐⭐⭐ | Große Services mit Fokus auf Reliability und SRE-Praktiken | Auto-Rollback + vollständige Forensik-Daten für blameless Post-mortems ⭐ 📊 |
Übernimm diese Rollback-Plan-Beispiele in dein Runbook
Wähle nicht für jeden Incident denselben Rollback-Mechanismus. Beginne mit der kleinstmöglichen sicheren Aktion. Wenn ein Feature Flag den fehlerhaften Pfad deaktivieren kann, ohne die Datenintegrität zu gefährden, nutze es zuerst. Wenn das Release selbst instabil ist, stoppe die Channel-Expansion und nutze Staged-Channel-Controls mit automatisierten Crash- und Readiness-Gates. Wenn der Fehler gemeinsame code, Konfiguration oder inkompatible APIs betrifft, stelle das letzte kompatible Bundle wieder her und verifiziere den gesamten User Flow.
Die schwierigste Entscheidung betrifft die Daten. Ein Bundle-Rollback macht keine Schema-Migration, Partial Writes oder serverseitige Verhaltensänderungen rückgängig. Bei solchen Incidents sollten riskante Writes eingefroren, der Data Owner einbezogen und das migrationssichere Verfahren befolgt werden, anstatt anzunehmen, dass der vorherige Client automatisch sicherer ist. Der Ausfall von Knight Capital im Jahr 2012 zeigt, warum das Wiederherstellen einer älteren Binary nicht ausreicht: Ein Server behielt eine schlummernde Legacy-Funktionalität, ein wiederverwendetes Flag aktivierte diese, und der versuchte Rollback ließ das problematische Verhalten in der gesamten Umgebung aktiv. Der Vorfall verursachte etwa 397 Millionen fehlerhafte Aktienausführungen, eine Nominalposition von etwa $7 billion, und einen zunächst gemeldeten Vorsteuerverlust von etwa 440 Millionen Dollar, später in der Nähe platziert 460 Millionen Dollar in der breiteren Berichterstattung, wie dokumentiert in diesem Bericht über das gescheiterte Rollback von Knight Capital.
Spotifys Storm-Deployment bietet ein weiteres nützliches Prinzip für stateful Systeme. Zwei vollständige Topologieversionen verfügbar zu halten, Consumer-Positionen zu erhalten und reversible Aktivierung zu nutzen, ermöglicht es Operatoren, die vorherige Version wiederherzustellen, ohne den Stream zu verlieren, wie in Spotifys Apache-Storm-Deployment-Berichtbeschrieben. Das analoge Capgo-Design besteht darin, das vorherige signierte Bundle zu behalten, versionsspezifische Health-Gates beizubehalten und die Kompatibilität zu bestätigen, bevor das alte Release entfernt wird.
Wandeln Sie diese Ideen in einen kurzen Entscheidungsbaum um:
- Feature-spezifischer Fehler: Feature-Flag deaktivieren, Fallback prüfen und untersuchen.
- Instabile Releases: Channel einfrieren, das letzte kompatible Bundle neu deployen und die Recovery überwachen.
- Segment-spezifische Unsicherheit: Promotion stoppen, Canary-Feedback nutzen und manuellen Override verwenden.
- Schema- oder Datenrisiko: Rollback von code nicht blind durchführen. Änderungen einfrieren und den Migrations- oder Datenwiederherstellungsplan ausführen.
- Unklare Ursache: Zuerst Beweise sichern, die Auswirkungen begrenzen und dann die kleinste reversible Maßnahme wählen.
Wähle heute ein Playbook. Halte Trigger, Owner, den exakten Rollback-Befehl oder die Dashboard-Aktion, Verifizierungsschritte und den Eskalationspfad fest. Teste es vor dem nächsten Production-Release in einem Staging-Channel – inklusive fehlgeschlagenem Update, defektem Readiness-Signal, Konfigurations-Rollback und Kompatibilitätscheck. Teams erholen sich schneller, wenn Rollback eine geübte Operation ist und kein Absatz, der erst nach dem Incident geschrieben wird.
Capgo bietet signierte Live Updates für CapacitorJS- und Electron-Apps, mit gezielten Channels, Versionshistorie, Logs pro Gerät, Adoptions- und Failure-Metriken, Differential Delivery und automatischem Rollback-Schutz. Nutze Capgo um das Rollback-Plan-Beispiel, das zu deiner App passt, in einen getesteten Release- und Recovery-Workflow zu verwandeln.





