
Alle 16:00, un aggiornamento del web layer arriva in produzione. In pochi minuti, i crash report aumentano, arrivano ticket di supporto e il team scopre che il nuovo bundle JavaScript fallisce solo su un sottoinsieme di dispositivi. Aspettare la revisione di App Store o Google Play non è un'opzione, ma ripristinare un vecchio file non basta se sono cambiate anche configurazioni, API, feature flag o dati salvati. Un buon esempio di rollback plan deve indicare all'operatore cosa fa scattare la risposta, quale versione ripristinare, come verificare il recupero e quando il rollback di code potrebbe peggiorare l'incidente.
I sette playbook qui sotto associano le azioni di rollback a specifici tipi di errore in app Capacitor ed Electron, inclusi i rilasci distribuiti tramite canali Capgo. Usali come pattern di runbook, poi sostituisci i trigger di esempio con le baseline del tuo monitoraggio di crash, business e integrità dei dati.
Indice dei contenuti
- 1. Rollback automatico al rilevamento di crash
- 2. Rollback con Differential Update e cronologia delle versioni
- 3. Rollout graduale con rollback automatico al degrado delle metriche
- 4. Rollback della sola configurazione con feature flag
- 5. Rollback canary con consenso dell'utente e override manuale
- 6. Rollback della migrazione del database con versionamento dello schema
- 7. Rollback basato su incidenti con osservabilità automatizzata e post-mortem
- 7 esempi di piano di rollback a confronto
- Trasforma questi esempi di piano di rollback nel tuo runbook
1. Rollback automatico al rilevamento di crash
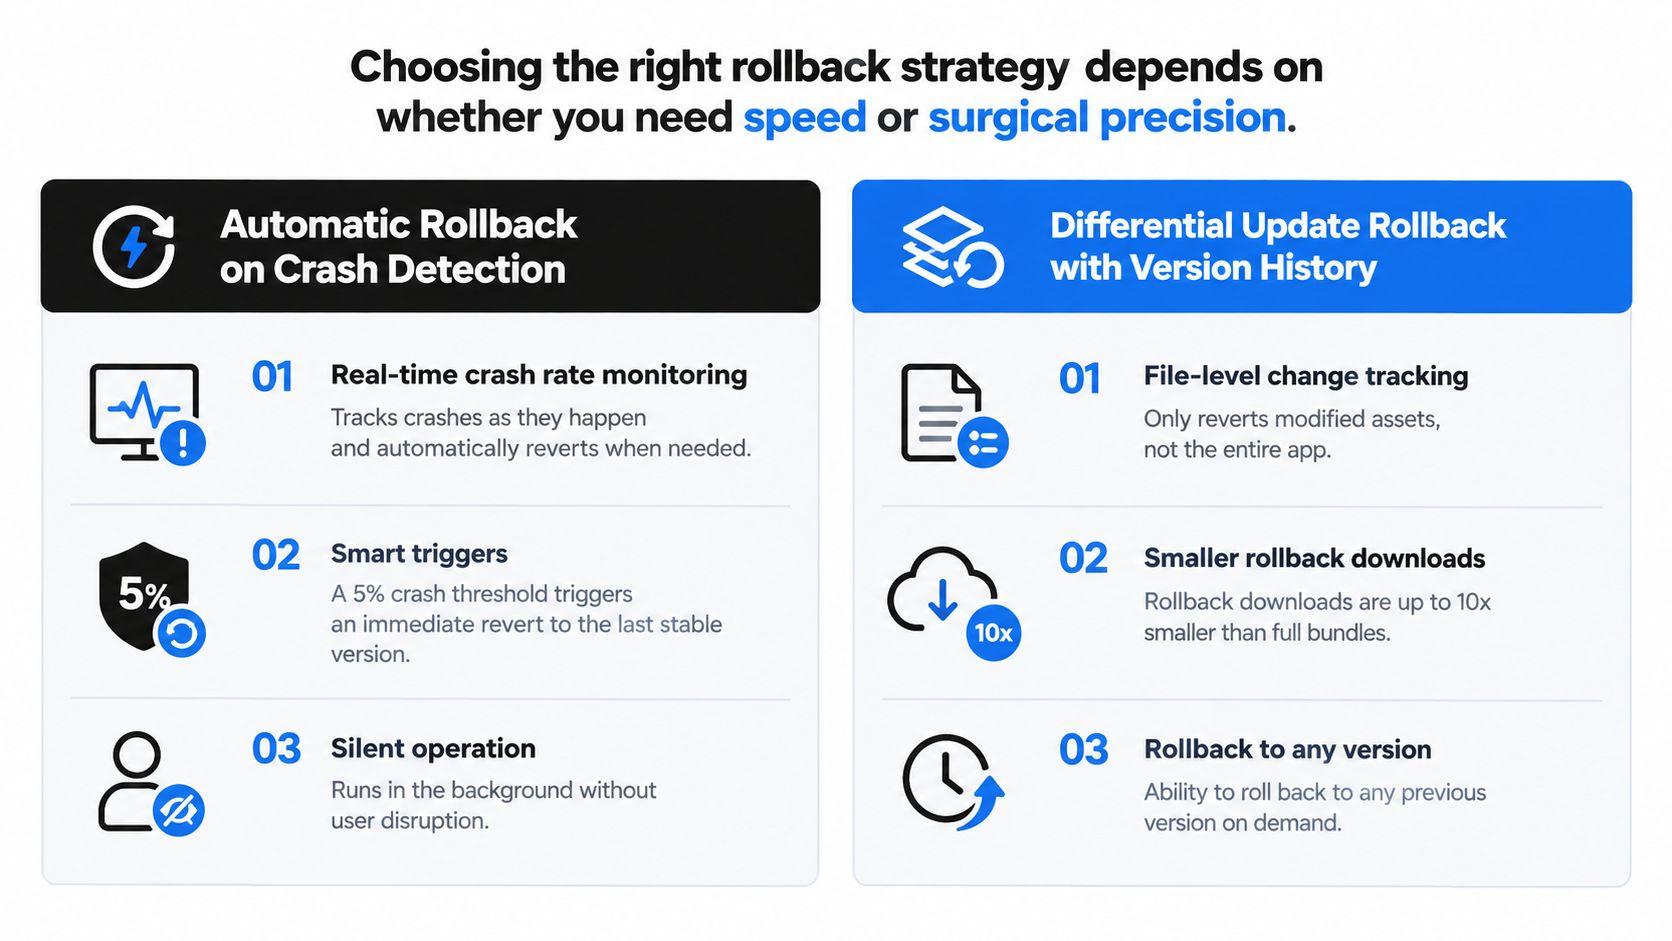
Il rollback automatico è la prima risposta corretta quando un nuovo web bundle causa un chiaro fallimento all'avvio, un'eccezione JavaScript, un errore di un plugin nativo o un pattern di crash assente nella release precedente. Il trigger deve essere machine-readable e legato a una versione, un channel, un gruppo di dispositivi e una finestra di osservazione. Un release controller può sospendere la distribuzione e ripristinare l'ultimo bundle funzionante senza aspettare che un ingegnere se ne accorga guardando la dashboard.
Per un'app Capacitor, monitora più dei soli crash nativi. Traccia se l'applicazione si avvia, se la web view carica, se notifyAppReady() si completa, se i plugin critici si inizializzano e se il primo user flow va a buon fine. I team Electron dovrebbero aggiungere anche gli errori del processo renderer, le eccezioni del processo main, gli errori di installazione degli update e le chiamate IPC fallite.
Regola pratica: Il rollback automatico deve prima interrompere l'esposizione e poi ripristinare il servizio. Non deve tentare di diagnosticare la root cause mentre gli utenti stanno ancora ricevendo il bundle sospetto.
Un trigger pratico potrebbe essere un aumento persistente di crash o di check di readiness falliti rispetto alla baseline della release. Non copiare una soglia da un'altra app. Imposta un limite conservativo per la produzione, validalo rispetto alle normali variazioni di dispositivi e OS, e richiedi un numero sufficiente di osservazioni per evitare di reagire a un singolo dispositivo isolato.
Trigger, azione e modalità di errore
- Trigger: Segnali di crash, startup, readiness o plugin nativi superano il release gate per il channel interessato.
- Azione: Congela l'espansione del canale, segna il bundle come unhealthy, ridistribuisci il precedente bundle firmato e verifica l'avvio e i flussi critici.
- Trade-off: Il ripristino è veloce, ma un trigger troppo sensibile può fare rollback di un rilascio sano per un problema del dispositivo o del backend non correlato.
- Modalità di errore: Il bundle precedente dipende da una API o configurazione modificata, quindi l'app si avvia ma fallisce in seguito. Mantieni i controlli di compatibilità nel health gate.
Per la diagnosi per singolo dispositivo e la correlazione dei crash, usa questa guida per connettere Firebase Crashlytics con le app Capacitor. Testa l'intero percorso in un canale di staging, inclusi rilevamento, freeze del canale, redeploy, download del client, attivazione e conferma che la vecchia versione resti utilizzabile.
2. Rollback con Differential Update e cronologia delle versioni
Un rollback differenziale è ideale per errori limitati a un foglio di stile, un asset, un valore di configurazione o un modulo JavaScript. L'updater trasferisce solo i file diversi tra il rilascio attivo e un target noto come funzionante, riducendo i dati da scaricare per gli utenti con connessioni instabili. Il target deve comunque ricostruire un rilascio completo.
Il trigger è un errore confermato a livello di file che non richiede modifiche al runtime nativo. Prima di agire, confronta il manifest attivo e quello precedente, controlla la versione di Capacitor o del runtime Electron e verifica che il canale interessato disponga di un bundle firmato compatibile. Se l'errore supera questo confine, distribuisci l'intero bundle precedente invece di tentare una riparazione solo sui file.
La consegna differenziale non è un ripristino parziale. Non combinare mai file arbitrari provenienti da release diversi. Conserva manifest immutabili, valida checksum e firme, mantieni l'artifact completo precedente e registra la versione attiva nella cronologia del canale. Un bundle JavaScript e un plugin nativo non allineati possono far avviare l'app e poi far fallire un flusso critico.
di Capgo cronologia versioni app aiuta gli operatori a individuare una build sicuramente funzionante prima di un nuovo deploy. Per ogni release, registra il bundle identifier, la versione del runtime nativo, il canale Capgo, la revisione della configurazione e le note di migrazione.
Usa questo runbook:
- Conferma che il problema sia limitato agli asset web, alla configurazione o a code.
- Blocca il canale interessato per evitare che altri dispositivi ricevano la versione sospetta.
- Seleziona l'ultimo bundle firmato compatibile, non solo il file precedente più vicino.
- Genera un aggiornamento differenziale solo se client e manifest supportano una ricostruzione sicura.
- Test di avvio, controlli di integrità, compatibilità con API e flusso degli utenti interessati.
- Monitora download, attivazione e completamento del rollback sui client Capacitor ed Electron.
Una ricostruzione fallita, un mismatch del checksum, una dipendenza nativa incompatibile o un loop di attivazione sono modalità di errore. Interrompi la delivery differenziale e ridistribuisci il bundle completo conservato. La cronologia delle versioni indica cosa è cambiato e quale release può superare in sicurezza il confine di compatibilità. Non sostituisce gli artifact di rollback testati o le note di migrazione.
3. Rollout graduale con rollback automatico al degrado delle metriche
Una release può superare i controlli di startup e danneggiare comunque un workflow critico. Per un rollout graduale, separa i cohort beta, staging, produzione o clienti in canali Capgo distinti. Promuovi un bundle firmato alla volta e mantieni disponibile la versione compatibile precedente per ogni canale. Questo limita l'esposizione preservando un percorso di recovery diretto per i client Capacitor ed Electron.
Imposta il release gate prima della promozione. Per una modifica al checkout, monitora i pagamenti completati invece dei soli crash. Per la messaggistica, controlla la latenza di consegna e le consegne andate a buon fine. Per la sincronizzazione sanitaria, valida la completezza dei record. Confronta ogni segnale con la baseline per lo stesso pubblico, mix di dispositivi e canale. Una release è sana solo quando l'azione critica viene completata correttamente.
Usa questa sequenza durante la promozione:
- Assegna un responsabile che riveda i segnali tecnici e di business.
- Osserva il cohort definito per il periodo concordato.
- Interrompi la promozione non appena una metrica monitorata supera la soglia approvata.
- Blocca il canale Capgo interessato e conserva l'ID del rilascio, le versioni client, la configurazione e le metriche.
- Fai di nuovo il deploy dell'ultimo bundle compatibile su quella cohort.
- Verifica l'avvio, l'attivazione dell'update e il workflow interessato su dispositivi rappresentativi Capacitor ed Electron.
- Riprendi la promozione solo dopo che l'owner conferma il ripristino.
Il guida ai rollout graduali per i live updates di Capacitor fornisce contesto di deployment per i rilasci basati su canale. Il rollback automatico deve avvenire solo quando la metrica e la soglia sono inequivocabili. Un fallimento su pagamenti, privacy, sicurezza o integrità dei dati può giustificare un'azione immediata anche senza certezza statistica.
La principale modalità di errore è una dashboard troppo limitata. La salute tecnica può restare normale mentre un risultato di business peggiora, e condizioni rare di dispositivo, account o rete potrebbero non emergere mai nella prima cohort. Documenta queste lacune nel runbook prima del prossimo rilascio.
4. Rollback della sola configurazione con feature flag
Un rollback della configurazione è adatto a fallimenti limitati a una singola funzionalità. Mantieni installato il nuovo bundle Capacitor o Electron, poi disattiva il percorso rischioso tramite un flag remoto per il canale Capgo o l'audience interessati. L'app può ripristinare la logica di raccomandazione, una variante dell'interfaccia, la sincronizzazione opzionale, lo storage sperimentale o un altro comportamento protetto senza sostituire code non correlati.
Il fallback deve già esistere. Verifica che sia compatibile con l'attuale API e il modello dati, assegna un owner e registra lo scope del flag e il default di emergenza prima del rilascio. Rimuovere il vecchio percorso e aggiungere un flag dopo un incidente non lascia nulla da attivare.
Esegui il rollback del flag come un playbook circoscritto
- Trigger: Un errore specifico di una feature, un workflow fallito, problemi di privacy, di batteria o una regressione di business superano la soglia concordata dal team.
- Azione: Disabilita il flag per il canale Capgo o l'audience interessata. Conferma che i client ricevano la modifica, quindi testa il fallback su dispositivi Capacitor ed Electron rappresentativi.
- Verifica: Controlla lo stato del flag attivo, gli eventi rilevanti, il comportamento all'avvio e il workflow interessato. Mantieni il nuovo bundle in uso mentre il team isola il guasto.
- Compromesso: La modifica è rapida e mirata, ma non può riparare una dipendenza condivisa, un code nativo incompatibile o dati corrotti.
- Modalità di errore: L'update potrebbe non arrivare, essere ignorato all'avvio o rimanere in cache. Logga lo stato del flag con ogni evento rilevante e definisci la scadenza della cache.
Usa il guida all'implementazione dei feature flag per strutturare questo controllo in un workflow Capgo. Mantieni un default di emergenza locale per le funzionalità critiche. Se la configurazione non può essere recuperata, applica fail closed. Le funzionalità sensibili a sicurezza e privacy dovrebbero disabilitare l'accesso durante un'interruzione del control plane, anziché mantenerlo.
5. Rollback canary con consenso dell'utente e override manuale
Un rilascio canary può sembrare sano nelle telemetrie ma fallire per un singolo account enterprise, ruolo utente o integrazione. Fornisci a quel gruppo un fallback chiaro e un modo per segnalare il problema. Il loro feedback può far emergere problemi di workflow o usabilità che le metriche aggregate non rilevano.
Usa controlli separati per utenti e operatori. L'azione rivolta all'utente deve essere disponibile al di fuori del flusso di lavoro interrotto, spiegare cosa comporta il rollback e raccogliere il bundle attivo, la versione dell'app nativa, il canale Capgo, il dispositivo e il timestamp. Per le app Capacitor, verifica il bundle web precedente rispetto alla shell nativa installata. Per Electron, conferma che il fallback rimanga compatibile con il runtime desktop imballato.
Imposta il trigger canary prima del rilascio:
- Trigger: Congela il canale dopo ripetuti opt-out da parte di un segmento, report raggruppati o un indicatore tecnico che supera la soglia concordata.
- Azione utente: Mostra la scelta del fallback, registra il consenso e il contesto diagnostico, quindi riporta l'utente al bundle compatibile precedente.
- Azione dell'operatore: Sospendi ulteriori esposizioni, esamina i report e reindirizza il canale canary alla build stabile. Mantieni disponibile un override manuale quando il control plane o la UI del client non sono disponibili.
- Compromesso: Il consenso migliora la trasparenza e fa emergere prima i problemi, ma versioni miste aumentano il carico del supporto e complicano i confronti.
- Modalità di errore: Un utente potrebbe eseguire il rollback senza trasmettere il contesto, oppure il vecchio client potrebbe non funzionare con un backend modificato. Considera migliori pratiche per il consenso utente sugli aggiornamenti OTA come parte del design per la comunicazione e l'opt-out, mantenendo la compatibilità del server o un rollback controllato delle funzionalità.
Non presentare questo rollback come una soluzione per l'incompatibilità lato server. Se il contratto del backend è cambiato, ripristina prima la compatibilità o lascia disabilitato il workflow interessato.
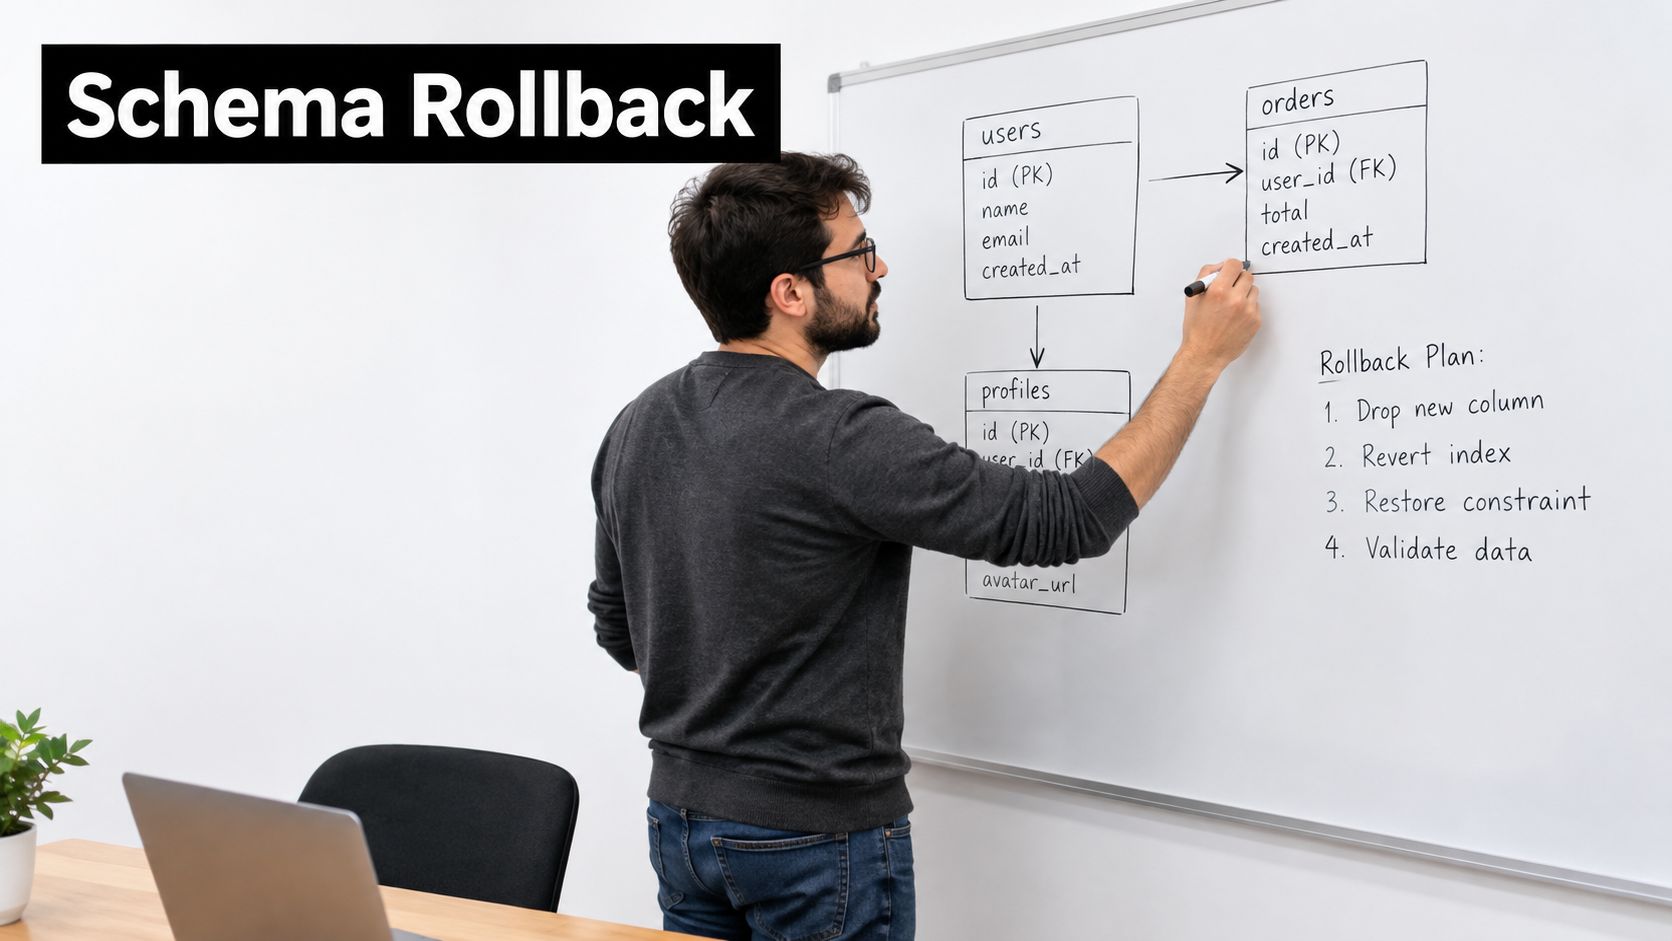
6. Rollback della migrazione del database con versionamento dello schema
Un rollback del bundle non può riparare uno schema incompatibile. Un client Capacitor o Electron può tornare alla precedente code, mentre il API o il database locale si aspettano ancora nuovi campi, tipi modificati o dati parzialmente migrati. Il risultato può essere letture non riuscite, scritture rifiutate o record errati.
Tratta la migrazione come un rilascio a sé stante con un percorso di recupero. Inizia con una fase di espansione: aggiungi campi o tabelle compatibili senza rimuovere la vecchia rappresentazione. Distribuisci code che legge e scrive entrambi i formati, quindi migra i record esistenti con validazione. Sposta il traffico in modo controllato. Rimuovi le strutture legacy solo dopo che il client precedente non è più necessario. Questo mantiene possibile un rollback del canale Capgo mentre il nuovo schema resta distribuito.
L'analisi su migrazioni database rollback-safe copre le migrazioni transazionali, gli schemi retrocompatibili e i deployment separati di database e applicazione. Applica questi controlli ai record di pagamento, agli ordini, alle informazioni dei pazienti e ad altri dati che non possono essere ricreati in sicurezza.
Assegna il percorso di recupero prima del rilascio:
- Rollback dell'applicazione: Ripristina il bundle Capacitor precedente o il pacchetto Electron solo dopo aver confermato che può leggere lo schema corrente.
- Rollback delle funzionalità: Disabilita il nuovo percorso di scrittura o la feature flag, preservando le modifiche allo schema compatibili.
- Recupero delle migrazioni: Interrompi le scritture interessate, ispeziona i record ed esegui una procedura di correzione o ripristino revisionata.
- Ripristino dei dati: Usa il backup o il recupero point-in-time quando il rollback di code non può garantire la correttezza dei dati.
Mantieni gli script di avanzamento e di recupero sotto revisione. Testali con dati simili a quelli di produzione e usa transazioni o savepoint dove supportato. Non generare SQL di rollback distruttivo durante un incidente. Definisci le condizioni di successo per la salute dell'applicazione, la validità dei dati e la compatibilità delle scritture, con proprietari distinti per ogni decisione. Un piano di migrazione non provato in staging non è un esempio di piano di rollback affidabile.
7. Rollback basato su incidenti con osservabilità automatizzata e post-mortem
Un canale Capgo può mostrare un rollout sano mentre un coorte specifico di Capacitor o Electron fallisce dopo il lancio. Definisci il trigger dell'incidente prima del rilascio, come un segnale di crash persistente, un readiness check fallito, un flusso API interrotto o un errore di integrità dei dati confermato. In caso di allarme, congela l'espansione del canale e registra il bundle attivo, la versione dell'app nativa, il canale, lo stato del rollout, il coorte interessato, la categoria di errore e i timestamp. Cattura queste prove prima di modificare lo stato di deployment.
Linee guida DORA su metriche di deployment e recovery Il rollback viene considerato sia come segnale di fallimento del cambio che come evento di recovery. Conserva l'identificativo della release e il risultato del rollback, poi confronta il tempo tra rilevazione e ripristino, le sessioni o i dispositivi interessati e i tassi di errore post-recovery. Queste misure indicano se il bundle ripristinato ha eliminato il guasto.
Gestisci l'incidente come una sequenza breve e documentata:
- Trigger: Conferma l'alert incrociando i segnali di crash, readiness, API, business o dati.
- Freeze: Blocca l'espansione del canale e disabilita la feature flag se limita l'impatto meglio di un rollback completo.
- Preserva: Salva log, trace, cronologia delle versioni, stato di adozione e dettagli sul segmento interessato.
- Rollback: Effettua il redeploy dell'ultimo bundle compatibile per Capacitor o Electron, verificando la compatibilità con la versione native.
- Controlla: Testa l'avvio e i flussi critici, quindi conferma che il segnale di errore stia diminuendo.
- Revisione: Registra la causa, la mancata rilevazione, la decisione e la modifica al runbook.
Un rollback fallito è a sua volta un trigger. Escala al canale precedente noto come funzionante o a un percorso di deployment manuale se la versione ripristinata va in crash, non riesce ad avviarsi o riproduce lo stesso errore di API. Usa questo Guida alle cause profonde di Forge Reliability per strutturare l'indagine. Tieni il post-mortem senza colpe mentre le prove sono ancora disponibili, assegna un owner a ogni azione correttiva e ripassa il resulting readiness check o il channel guardrail risultante.
7 esempi di piano di rollback a confronto
| Strategia | Complessità di implementazione 🔄 | Requisiti delle risorse 💡 | Risultati attesi 📊 / ⭐ | Casi d'uso ideali 💡 | Vantaggi chiave ⭐ / ⚡ |
|---|---|---|---|---|---|
| Rollback automatico in caso di crash | Medio 🔄🔄 | Monitoraggio in tempo reale + sistemi di error tracking | Mitigazione rapida; MTTR più basso 📊 ⭐⭐⭐⭐ | App in produzione che richiedono alta stabilità (fintech, sanità) | Protezione automatica silenziosa; recupero rapido ⚡ ⭐ |
| Rollback di Live Update differenziale con storico versioni | Alto 🔄🔄🔄 | Archiviazione versioni, motore diff, gestione dello stato | Rollback precisi e efficienti in banda 📊 ⭐⭐⭐⭐ | Utenti con rete debole, asset grandi, team indie | Precisione a livello di file; download di rollback molto più piccoli ⚡ ⭐ |
| Rollout graduale con rollback automatico in caso di degrado delle metriche | Molto alto 🔄🔄🔄🔄 | Infrastruttura di metriche robusta, framework A/B, targeting | Blast radius ridotto; protegge le metriche di business 📊 ⭐⭐⭐⭐ | E-commerce, feature critiche per i ricavi, grandi basi utenti | Progressione data-driven; intercetta subito l'impatto sul business ⭐ 📊 |
| Rollback solo tramite configurazione con Feature Flags | Basso 🔄 | Feature flagging/config deployment (senza rebuild) | Rollback istantaneo delle feature; impatto minimo sugli utenti 📊 ⭐⭐⭐ | Regressioni delle feature, fix rapidi, piccoli team | Rollback più veloce (minuti); no app store review ⚡ ⭐ |
| Canary Rollback con consenso utente e override manuale | Alto 🔄🔄🔄 | Targeting canary, UI in-app, raccolta feedback | Rilevamento precoce degli edge case; insight qualitativi 📊 ⭐⭐⭐ | Programmi beta enterprise, release basate sul feedback | Autonomia utente + feedback diretto; test precoci più sicuri ⭐ 💡 |
| Rollback delle migrazioni del database con schema versioning | Molto alto 🔄🔄🔄🔄 | Competenza DB, tooling di migrazione, dati di staging | Mantiene l'integrità dei dati; rollback conformi 📊 ⭐⭐⭐⭐ | Settori regolamentati, e-commerce, app con dati complessi | Migrazioni bidirezionali sicure; audit trail e validazione ⭐ |
| Rollback basato sugli incidenti con observability e post-mortem | Molto alto 🔄🔄🔄🔄 | Osservabilità avanzata, gestione incidenti, storage | Risposta rapida con contesto forense; apprendimento organizzativo 📊 ⭐⭐⭐⭐ | Grandi servizi che privilegiano affidabilità e pratiche SRE | Rollback automatico + dati forensi completi per post-mortem senza colpe ⭐ 📊 |
Trasforma questi esempi di piano di rollback nel tuo runbook
Non scegliere un unico meccanismo di rollback per ogni incidente. Inizia con l'azione più ristretta e sicura. Se un feature flag può disabilitare il percorso difettoso preservando l'integrità dei dati, usalo per primo. Se il rilascio è instabile, interrompi l'espansione del canale e usa i controlli a canali graduati con gate automatici di crash e readiness. Se il guasto riguarda code condivisi, configurazione o API incompatibili, ripristina l'ultimo bundle compatibile e verifica il flusso utente completo.
La decisione più difficile riguarda i dati. Un rollback del bundle non inverte una migrazione dello schema, una scrittura parziale o una modifica del comportamento lato server. Per questi incidenti, congela le scritture a rischio, coinvolgi il data owner e segui la procedura di migrazione sicura, invece di dare per scontato che il client precedente sia automaticamente più sicuro. Il fallimento di Knight Capital nel 2012 illustra perché ripristinare un binario precedente non basta: un server ha mantenuto una funzionalità legacy inattiva, un flag riutilizzato l'ha attivata e il rollback tentato ha lasciato il comportamento problematico attivo in tutto l'ambiente. L'incidente ha prodotto circa 397 milioni di esecuzioni di ordini errate, una posizione nozionale di circa $7 billion, e una perdita pre-imposta iniziale riportata di circa 440 milioni di dollari, successivamente stimata intorno a 460 milioni di dollari nelle relazioni più ampie, come documentato in questo resoconto del fallimento del rollback di Knight Capital.
Il deployment Storm di Spotify offre un altro principio utile per i sistemi stateful. Mantenere disponibili due versioni complete della topologia, preservare le posizioni dei consumer e utilizzare un'attivazione reversibile consente agli operatori di ripristinare la versione precedente senza perdere lo stream, come descritto in il resoconto del deployment Apache Storm di Spotify. Il design analogo di Capgo consiste nel mantenere il bundle firmato precedente, preservare i health gate specifici della versione e confermare la compatibilità prima di rimuovere la vecchia release.
Trasforma queste idee in un breve albero decisionale:
- Errore specifico di una feature: Disattiva la feature flag, verifica il fallback e indaga.
- Instabilità del rilascio: Congela il channel, ridistribuisci l'ultimo bundle compatibile e monitora il recupero.
- Incertezza su un segmento specifico: Ferma la promozione e usa il feedback canary e l'override manuale.
- Rischio su schema o dati: Non fare rollback di code alla cieca. Congela le modifiche ed esegui il piano di migrazione o recupero dati.
- Causa non chiara: Raccogli prima le prove, contieni l'esposizione, poi scegli l'azione reversibile più limitata.
Scegli un playbook oggi. Scrivi il trigger, il responsabile, il comando di rollback esatto o l'azione sul dashboard, i passi di verifica e il percorso di escalation. Eseguilo in un channel di staging prima del prossimo rilascio in produzione, includendo un aggiornamento fallito, un segnale di readiness non valido, un rollback di configurazione e un controllo di compatibilità. I team si riprendono più in fretta quando il rollback è un'operazione esercitata, non un paragrafo scritto dopo l'incidente.
Capgo fornisce live update firmate per app CapacitorJS ed Electron, con canali mirati, storico versioni, log per dispositivo, metriche di adozione e fallimento, delivery differenziale e protezione da rollback automatico. Usa Capgo per trasformare l'esempio di piano di rollback adatto alla tua app in un workflow di rilascio e recupero testato.





