
À 16 h, une mise à jour de la couche web atteint la production. En quelques minutes, les signalements de crash augmentent, les tickets de support affluent, et l’équipe découvre que le nouveau bundle JavaScript échoue uniquement sur une partie des appareils. Attendre la validation de l’App Store ou de Google Play n’est pas une option, mais restaurer un ancien fichier ne suffit pas si la configuration, les API, les feature flags ou les données stockées ont aussi changé. Un exemple utile de plan de rollback doit indiquer à l’opérateur ce qui déclenche la réaction, quelle version restaurer, comment vérifier le rétablissement, et dans quels cas revenir à code pourrait aggraver l’incident.
Les sept playbooks ci-dessous associent les actions de rollback à des types d’échec spécifiques dans Capacitor et les applications Electron, y compris les releases distribuées via canaux Capgo. Utilisez-les comme modèles de runbook, puis remplacez les déclencheurs d'exemple par vos propres seuils de monitoring de crashs, de business et d'intégrité des données.
Table des matières
- 1. Rollback automatique en cas de crash détecté
- 2. Rollback d'une mise à jour différentielle avec historique des versions
- 3. Déploiement progressif avec rollback automatique en cas de dégradation des métriques
- 4. Rollback par configuration avec des feature flags
- 5. Rollback canary avec consentement utilisateur et override manuel
- 6. Rollback de migration de base de données avec versioning du schéma
- 7. Rollback déclenché par les incidents avec observabilité automatisée et post-mortems
- 7 exemples de plans de rollback comparés
- Transformez ces exemples de plans de rollback en runbook
1. Rollback automatique en cas de crash détecté
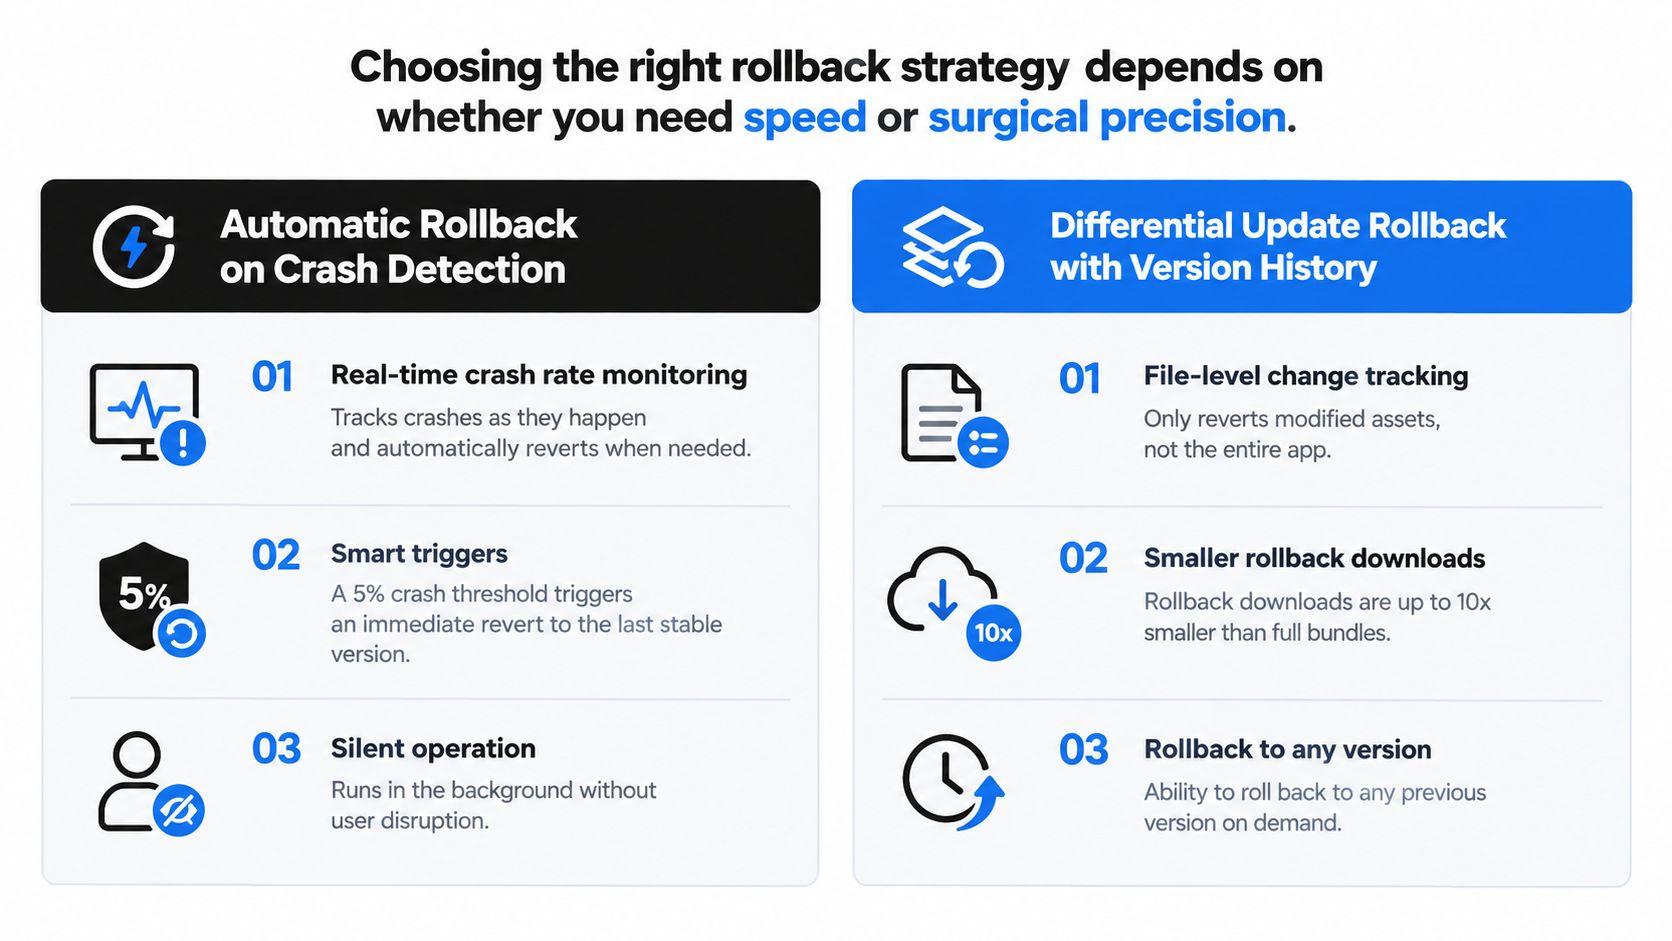
Le rollback automatique est la première réponse appropriée lorsqu'un nouveau bundle web provoque un échec de démarrage clair, une exception JavaScript, un défaut de plugin natif ou un motif de crash absent de la release précédente. Le déclencheur doit être lisible par machine et lié à une version, un canal, un groupe d'appareils et une fenêtre d'observation. Un contrôleur de release peut suspendre la distribution et restaurer le dernier bundle fonctionnel connu sans attendre qu'un ingénieur remarque le dashboard.
Pour une application Capacitor, surveillez plus que les crashes natifs. Suivez si l'application démarre, si la web view se charge, si notifyAppReady() se termine, si les plugins critiques s'initialisent et si le premier flux utilisateur réussit. Les équipes Electron doivent ajouter les échecs du processus renderer, les exceptions du processus main, les échecs d'installation de la mise à jour et les appels IPC ratés.
Règle pratique : Un rollback automatique doit d’abord limiter l’exposition, puis rétablir le service. Il ne doit pas tenter de diagnostiquer la cause racine pendant que les utilisateurs reçoivent encore le bundle suspect.
Un déclencheur concret pourrait être une augmentation soutenue des crashs ou des checks de readiness en échec par rapport à la baseline de la release. Ne copiez pas un seuil depuis une autre application. Définissez une limite prudente pour la production, validez-la par rapport à la variabilité normale des appareils et des OS, et exigez suffisamment d’observations pour éviter de réagir à un appareil isolé.
Déclencheur, action et mode de défaillance
- Déclencheur : Les signaux de crash, de démarrage, de readiness ou de plugins natifs ne respectent pas le release gate du canal concerné.
- Action : Geler l'expansion du canal, marquer le bundle comme instable, redéployer le précédent bundle signé, puis vérifier le démarrage et les flux critiques.
- Compromis : La récupération est rapide, mais un déclencheur trop sensible peut annuler une release saine à cause d'un problème de backend ou d'appareil sans rapport.
- Mode de défaillance : L'ancien bundle dépend d'un API ou d'une configuration modifiée, donc l'app démarre mais échoue plus tard. Gardez des contrôles de compatibilité dans le health gate.
Pour le diagnostic par appareil et la corrélation des crashs, utilisez ce guide pour connecter Firebase Crashlytics aux apps Capacitor. Testez le parcours complet dans un canal de staging : détection, gel du canal, redéploiement, téléchargement côté client, activation et confirmation que l'ancienne version reste utilisable.
2. Rollback d'une mise à jour différentielle avec historique des versions
Un rollback différentiel convient aux défaillances limitées à une feuille de style, un asset, une valeur de configuration ou un module JavaScript. L'updater ne transfère que les fichiers qui diffèrent entre la release active et une cible connue comme saine, ce qui réduit le volume à télécharger pour les utilisateurs sur des connexions instables. La cible doit tout de même reconstruire une release complète.
Le déclencheur est un défaut confirmé au niveau d’un fichier, qui ne nécessite pas de modification du runtime natif. Avant d’agir, comparez les manifestes actif et précédent, vérifiez la version du runtime Capacitor ou Electron, et confirmez que le canal concerné dispose d’un bundle signé compatible. Si le défaut dépasse cette limite, déployez le bundle complet précédent plutôt que de tenter une réparation limitée aux fichiers.
La livraison différentielle n’est pas une récupération partielle. Ne combinez jamais de fichiers arbitraires provenant de plusieurs releases. Stockez des manifestes immuables, validez les checksums et les signatures, conservez l’artefact complet précédent et enregistrez la version active dans l’historique du canal. Un bundle JavaScript et un plugin natif incompatibles peuvent laisser l’application démarrer alors qu’un flux critique échoue plus tard.
de Capgo historique des versions de l’application aide les opérateurs à retrouver un build validé avant un redéploiement. Notez l'identifiant du bundle, la version du runtime natif, le canal Capgo, la révision de configuration et les notes de migration pour chaque release.
Utilisez ce runbook :
- Confirmez que la panne est limitée aux assets web, à la configuration ou à code.
- Gelez le canal affecté pour que d'autres appareils ne reçoivent pas la version suspecte.
- Sélectionnez le dernier bundle signé compatible, et pas simplement le fichier antérieur le plus proche.
- Générez une mise à jour différentielle uniquement si le client et le manifeste prennent en charge une reconstruction sûre.
- Testez le démarrage, les vérifications d'intégrité, la compatibilité API et le flux utilisateur affecté.
- Surveillez les téléchargements, l'activation et la fin du rollback sur les clients Capacitor et Electron.
Une reconstruction échouée, une incohérence de checksum, une dépendance native incompatible ou une boucle d'activation constitue un mode de défaillance. Arrêtez la livraison différentielle et redéployez le bundle complet conservé. L'historique des versions permet de savoir ce qui a changé et quelle release peut franchir la limite de compatibilité en toute sécurité. Cela ne remplace pas les artefacts de rollback testés ni les notes de migration.
3. Déploiement progressif avec rollback automatique en cas de dégradation des métriques
Une release peut passer les tests de démarrage tout en endommageant un workflow critique. Pour un déploiement progressif, placez les cohortes bêta, staging, production ou clients dans des canaux Capgo distincts. Promouvez un seul bundle signé à la fois, et gardez la version compatible précédente disponible pour chaque canal. Cela limite l'exposition tout en préservant un chemin de récupération direct pour les clients Capacitor et Electron.
Définissez les critères de validation avant la promotion. Pour une modification du checkout, surveillez les paiements finalisés plutôt que les seuls crashs. Pour la messagerie, vérifiez la latence de livraison et le taux de livraison réussie. Pour la synchronisation de données de santé, validez l'exhaustivité des dossiers. Comparez chaque signal à la référence pour la même audience, la même répartition d'appareils et le même canal. Une release n'est saine que lorsque l'action critique aboutit correctement.
Utilisez cette séquence lors de la promotion :
- Désignez un responsable chargé d'analyser les signaux techniques et business.
- Observez la cohorte définie pendant la période convenue.
- Arrêtez la promotion dès qu'une métrique surveillée franchit son seuil validé.
- Gèle le canal Capgo concerné et conserve l’ID de la release, les versions client, la configuration et les preuves métriques.
- Redéployez le dernier bundle compatible à cette cohorte.
- Vérifiez le démarrage, l’activation de la mise à jour et le workflow concerné sur des appareils Capacitor et Electron représentatifs.
- Resume promotion only after the owner confirms recovery.
Le guide des déploiements progressifs pour les live updates Capacitor offre un contexte de déploiement pour les releases par canal. Le rollback automatisé ne doit s’exécuter que lorsque la métrique et le seuil sont non ambigus. Un échec de paiement, de confidentialité, de sécurité ou d’intégrité des données peut justifier une action immédiate, même avant d’avoir une confiance statistique.
Le principal mode de défaillance est un dashboard trop limité. La santé technique peut rester normale alors qu’un résultat métier se dégrade, et des conditions rares d’appareil, de compte ou de réseau peuvent ne jamais apparaître dans la première cohorte. Consignez ces lacunes dans le runbook avant la prochaine release.
4. Rollback par configuration avec des feature flags
Un rollback de configuration convient aux défaillances isolées à une seule fonctionnalité. Conservez le nouveau bundle Capacitor ou Electron installé, puis désactivez le chemin à risque via un flag distant pour le canal Capgo ou l’audience concernée. L’application peut ainsi restaurer la logique de recommandation, une variante d’interface, une synchronisation optionnelle, un stockage expérimental ou un autre comportement protégé, sans remplacer les code non concernés.
Le fallback doit déjà exister. Confirmez qu'il reste compatible avec l’API actuel et le modèle de données, désignez un responsable et enregistrez la portée du flag ainsi que sa valeur par défaut d'urgence avant la release. Supprimer l'ancien chemin et ajouter un flag après un incident ne laisse rien à activer.
Exécuter le rollback du flag comme un playbook encadré
- Déclencheur : Une erreur sur une fonctionnalité, un workflow échoué, un problème de confidentialité, de batterie ou une régression métier dépasse le seuil convenu par l'équipe.
- Action : Désactivez le flag pour le canal Capgo ou l'audience concernés. Confirmez que les clients reçoivent le changement, puis testez le fallback sur des appareils Capacitor et Electron représentatifs.
- Vérifier : Vérifiez l'état du flag actif, les événements pertinents, le comportement au démarrage et le workflow impacté. Maintenez le nouveau bundle en place pendant que l'équipe isole la faille.
- Compromis : Le changement est rapide et ciblé, mais il ne peut pas réparer une dépendance partagée, un code natif incompatible ou des données corrompues.
- Mode de défaillance : La mise à jour peut ne pas arriver, être ignorée au démarrage ou rester en cache. Loggez l'état du flag à chaque événement pertinent et définissez l'expiration du cache.
Utilisez le Guide d'implémentation des feature flags pour structurer ce contrôle dans un workflow Capgo. Conservez une valeur par défaut locale d'urgence pour les fonctionnalités critiques. Si la configuration ne peut pas être récupérée, échouez en mode fermé (fail closed). Les fonctionnalités sensibles en matière de sécurité et de confidentialité doivent désactiver l'accès pendant une panne du control plane plutôt que de le conserver.
5. Rollback canary avec consentement utilisateur et override manuel
Une release canary peut sembler saine dans la télémétrie tout en échouant pour un compte entreprise, un rôl’utilisateur ou une intégration spécifique. Offrez à ce groupe un fallback clair et un moyen de signaler le problème. Leurs retours peuvent révéler des problèmes de workflow ou d'ergonomie que les métriques agrégées ne détectent pas.
Utilisez des contrôles distincts pour les utilisateurs et les opérateurs. L'action côté utilisateur doit être disponible en dehors du workflow défectueux, expliquer ce que le rollback modifie, et collecter le bundle actif, la version de l'app native, le canal Capgo, l'appareil et l'horodatage. Pour les apps Capacitor, vérifiez le bundle web précédent par rapport au shell natif installé. Pour Electron, confirmez que le fallback reste compatible avec le runtime desktop packagé.
Configurez le déclencheur canary avant la release :
- Déclencheur : Gelez le canal après des opt-out répétés d'un même segment, des signalements groupés ou une métrique technique franchissant son seuil convenu.
- Action utilisateur : Affichez le choix du fallback, enregistrez le consentement et le contexte de diagnostic, puis renvoyez l'utilisateur vers le bundle compatible précédent.
- Action de l’opérateur : Mettez en pause l’exposition supplémentaire, examinez les rapports et redirigez le canal canary vers le build stable. Gardez un override manuel à disposition si le plan de contrôl’ou l’interface client est indisponible.
- Compromis : Le consentement améliore la transparence et fait émerger les problèmes tôt, mais les versions mixtes augmentent la charge de support et compliquent les comparaisons.
- Mode de défaillance : Un utilisateur peut effectuer un rollback sans transmettre de contexte, ou l’ancien client peut échouer face à un backend modifié. Traitez user consent best practices for OTA updates dans le cadre de la communication et de la conception de l’opt-out, et maintenir la compatibilité serveur ou un retour contrôlé d’une fonctionnalité.
Ne présentez pas ce rollback comme un correctif à une incompatibilité côté serveur. Si le contrat backend a changé, restaurez d’abord la compatibilité ou maintenez le workflow concerné désactivé.
6. Rollback de migration de base de données avec versioning du schéma
Un rollback de bundle ne peut pas réparer un schéma incompatible. Un client Capacitor ou Electron peut revenir à sa version précédente de code, tandis que l’API ou la base de données locale s’attend encore à de nouveaux champs, des types modifiés ou des données partiellement migrées. Le résultat peut être des lectures échouées, des écritures rejetées ou des enregistrements incorrects.
Considérez la migration comme une release à part entière avec un plan de secours. Commencez par une phase d'expansion : ajoutez des champs ou des tables compatibles sans supprimer l'ancienne représentation. Déployez code qui lit et écrit dans les deux formats, puis migrez les enregistrements existants avec validation. Basculez le trafic de façon contrôlée. Ne supprimez les structures héritées qu'une fois que l'ancien client n'est plus nécessaire. Cela permet un rollback du canal Capgo tant que le nouveau schéma reste déployé.
La revue sur les migrations de base de données réversibles couvre les migrations transactionnelles, les schémas rétrocompatibles et les déploiements séparés de la base de données et de l'application. Appliquez ces contrôles aux enregistrements de paiement, aux commandes, aux données patients et à toute autre donnée qui ne peut être recréée en toute sécurité.
Définissez le plan de secours avant de déployer :
- Rollback de l'application : Restaurez l'ancien bundle Capacitor ou le package Electron uniquement après avoir confirmé qu'il peut lire le schéma actuel.
- Rollback de fonctionnalité : Désactivez le nouveau chemin d'écriture ou le feature flag tout en conservant les changements de schéma compatibles.
- Récupération après migration : Arrêtez les écritures affectées, inspectez les enregistrements et exécutez une procédure de correction ou de récupération revue.
- Restauration des données : Utilisez une sauvegarde ou une restauration point-in-time si le rollback de code ne rétablit pas l'intégrité des données.
Gardez les scripts de migration forward et de récupération sous revue. Testez-les avec des données proches de la production, et utilisez des transactions ou des savepoints lorsque c'est pris en charge. Ne générez pas de SQL de rollback destructif pendant un incident. Définissez les conditions de succès pour l'état de santé de l'application, la validité des données et la compatibilité d'écriture, avec des responsables distincts pour chaque décision. Un plan de migration qui n'a pas été répété en staging n'est pas un exemple de plan de rollback fiable.
7. Rollback déclenché par les incidents avec observabilité automatisée et post-mortems
Un canal Capgo peut afficher un déploiement progressif sain alors qu'une cohorte spécifique de Capacitor ou Electron échoue après le lancement. Définissez le déclencheur d'incident avant la release, par exemple un signal de crash persistant, un échec du contrôle de préparation, un flux API défaillant ou une erreur d'intégrité des données confirmée. En cas d'alerte, gelez l'expansion du canal et enregistrez le bundle actif, la version de l'app native, le canal, l'état du déploiement, la cohorte affectée, la catégorie d'erreur et les horodatages. Recueillez ces preuves avant de modifier l'état du déploiement.
Recommandations DORA sur les métriques de déploiement et de récupération Considérez le rollback à la fois comme un signal d’échec de changement et comme un événement de rétablissement. Enregistrez l’identifiant de la release et le résultat du rollback, puis comparez le temps entre la détection et la restauration, les sessions ou appareils affectés, et les taux d’erreurs après rétablissement. Ces mesures indiquent si le bundle restauré a éliminé l’échec.
Pilotez l’incident comme une séquence courte et documentée :
- Déclencheur : Vérifiez l’alerte par rapport aux signaux de crash, de disponibilité, API, d’activité ou de données.
- Gel : Arrêtez l’expansion du canal et désactivez le feature flag si cela permet de mieux limiter l’impact qu’un rollback complet.
- Conservation : Conservez les logs, les traces, l’historique des versions, l’état d’adoption et les détails des segments affectés.
- Rollback : Redéployez le dernier bundle compatible pour Capacitor ou Electron, en tenant compte de la compatibilité des versions natives.
- Vérifiez : Testez le démarrage et les flux critiques, puis vérifiez que le signal d’échec diminue.
- Revue : Notez la cause, la détection manquée, la décision et la modification du runbook.
Un rollback échoué est en soi un déclencheur. Escaladez vers le dernier canal connu comme fiable ou vers une procédure de déploiement manuelle si la version restaurée plante, ne démarre pas ou reproduit le même échec API. Utilisez ce Guide des causes racines de Forge Reliability pour structurer l’investigation. Tenez le post-mortem sans blâme tant que les preuves sont disponibles, attribuez un responsable à chaque action corrective et répétez la vérification de préparation ou le garde-fou de canal qui en résulte.
7 exemples de plans de rollback comparés
| Stratégie | Complexité de mise en œuvre 🔄 | Ressources nécessaires 💡 | Résultats attendus 📊 / ⭐ | Cas d’usage idéaux 💡 | Avantages clés ⭐ / ⚡ |
|---|---|---|---|---|---|
| Rollback automatique en cas de crash | Moyen 🔄🔄 | Surveillance en temps réel + systèmes de suivi des erreurs | Atténuation rapide ; MTTR réduit 📊 ⭐⭐⭐⭐ | Apps de production exigeant une grande stabilité (fintech, santé) | Protection automatique silencieuse ; récupération rapide ⚡ ⭐ |
| Rollback de live update différentielle avec historique des versions | Élevé 🔄🔄🔄 | Stockage des versions, moteur de diff, gestion d'état | Économe en bande passante, rollbacks précis 📊 ⭐⭐⭐⭐ | Utilisateurs en réseau faible, gros assets, équipes indie | Précision au niveau du fichier ; téléchargements de rollback bien plus légers ⚡ ⭐ |
| Déploiement progressif avec rollback automatique en cas de dégradation des métriques | Très élevé 🔄🔄🔄🔄 | Infra de métriques robuste, frameworks A/B, ciblage | Rayon d'impact réduit ; protège les métriques métier 📊 ⭐⭐⭐⭐ | E-commerce, fonctionnalités sensibles aux revenus, grandes bases d’utilisateurs | Progression basée sur les données ; détecte tôt l'impact métier ⭐ 📊 |
| Rollback par configuration seule avec les feature flags | Faible 🔄 | Déploiement de feature flagging/config (sans rebuild) | Rollback instantané des fonctionnalités ; impact utilisateur minimal 📊 ⭐⭐⭐ | Régressions de fonctionnalités, correctifs rapides, petites équipes | Rollback le plus rapide (en minutes) ; sans validation des stores ⚡ ⭐ |
| Rollback canary avec consentement utilisateur et override manuel | Élevé 🔄🔄🔄 | Ciblage canary, UI in-app, collecte de feedback | Détection précoce des edge cases ; insights qualitatifs 📊 ⭐⭐⭐ | Programmes bêta entreprise, releases guidées par le feedback utilisateur | Contrôl’utilisateur + feedback direct ; tests précoces plus sûrs ⭐ 💡 |
| Rollback de migration de base de données avec versioning du schéma | Très élevé 🔄🔄🔄🔄 | Expertise DB, outils de migration, données de staging | Maintient l'intégrité des données ; rollbacks conformes 📊 ⭐⭐⭐⭐ | Secteurs régulés, e-commerce, apps avec données complexes | Migrations bidirectionnelles sûres ; journaux d’audit et validation ⭐ |
| Rollback basé sur les incidents avec observabilité et post-mortems | Très élevé 🔄🔄🔄🔄 | Observabilité sophistiquée, gestion d'incidents, stockage | Réponse rapide avec contexte forensique ; apprentissage organisationnel 📊 ⭐⭐⭐⭐ | Grands services privilégiant la fiabilité et les pratiques SRE | Auto rollback + données forensiques complètes pour des post-mortems sans blâme ⭐ 📊 |
Transformez ces exemples de plans de rollback en runbook
Ne choisissez pas un seul mécanisme de rollback pour tous les incidents. Commencez par l'action sécurisée la plus ciblée. Si un feature flag peut désactiver le chemin défaillant tout en préservant l'intégrité des données, utilisez-l’en priorité. Si la release elle-même est instable, arrêtez l'élargissement du canal et utilisez des contrôles de déploiement progressif par canal avec des seuils automatisés de crash et de readiness. Si la défaillance touche un code partagé, la configuration ou des API incompatibles, restaurez le dernier bundle compatible et vérifiez le parcours utilisateur complet.
La décision la plus difficile concerne les données. Un rollback de bundle n'annule pas une migration de schéma, une écriture partielle ou un changement de comportement côté serveur. Pour ces incidents, gélérez les écritures risquées, impliquez le propriétaire des données et suivez la procédure de migration sécurisée plutôt que de supposer que l'ancien client est automatiquement plus sûr. La défaillance de Knight Capital en 2012 illustre pourquoi restaurer un binaire antérieur ne suffit pas : un serveur conservait une fonctionnalité héritée dormante, un flag réutilisé l'a activée, et la tentative de rollback a laissé le comportement problématique actif dans tout l'environnement. L'incident a produit environ 397 millions d'exécutions d'actions erronées, une position notionnelle d'environ 7 milliards $, et une perte avant impôts initialement annoncée d'environ 440 millions de dollars, placé ensuite près de 460 millions de dollars dans une couverture plus large, comme documenté dans ce compte rendu de l’échec du rollback de Knight Capital.
Le déploiement Storm de Spotify offre un autre principe utile pour les systèmes à état. Conserver deux versions complètes de la topologie, préserver les positions des consommateurs et utiliser une activation réversible permet aux opérateurs de restaurer la version précédente sans perdre le flux, comme décrit dans Le compte de déploiement Apache Storm de Spotify. La conception analogue de Capgo consiste à conserver le bundle signé précédent, à préserver les gates de santé propres à chaque version et à confirmer la compatibilité avant de supprimer l’ancienne release.
Transformez ces idées en un arbre de décision concis :
- Défaillance propre à une fonctionnalité : Désactivez le feature flag, vérifiez le fallback et investiguez.
- Instabilité de la release : Gelez le canal, redéployez le dernier bundle compatible et surveillez le rétablissement.
- Incertitude sur un segment : Arrêtez la promotion et utilisez le feedback canary ainsi qu’un override manuel.
- Risque lié au schéma ou aux données : Ne faites pas de rollback de code à l’aveugle. Gélez les modifications et exécutez le plan de migration ou de récupération des données.
- Cause non identifiée : Collectez d’abord les preuves, limitez l’exposition, puis choisissez l’action réversible la plus ciblée.
Choisissez un playbook dès aujourd’hui. Rédigez son déclencheur, son responsable, la commande de rollback exacte ou l’action à faire dans le dashboard, les étapes de vérification et la procédure d’escalade. Exercez-le dans un canal de staging avant la prochaine release en production, avec une mise à jour échouée, un signal de readiness défaillant, un retour arrière de configuration et une vérification de compatibilité. Les équipes se rétablissent plus vite quand le rollback est une opération rodée, pas un paragraphe rédigé après l’incident.
Capgo fournit des live updates signées pour les applications CapacitorJS et Electron, avec des canaux ciblés, un historique des versions, des logs par appareil, des métriques d’adoption et d’échec, une livraison différentielle et une protection automatique contre les rollbacks. Utilisez Capgo pour transformer l’exemple de plan de rollback adapté à votre application en un workflow de release et de récupération testé.





