
A las 4 p. m., una actualización de la capa web llega a producción. En minutos, los informes de errores aumentan, llegan tickets de soporte y el equipo descubre que el nuevo bundle de JavaScript falla solo en un subconjunto de dispositivos. Esperar la revisión de App Store o Google Play no es una opción, pero restaurar un archivo anterior no es suficiente si también han cambiado la configuración, las APIs, las feature flags o los datos almacenados. Un ejemplo útil de plan de rollback debe indicar al operador qué desencadena la respuesta, qué versión restaurar, cómo verificar la recuperación y cuándo revertir code podría empeorar el incidente.
Los siete playbooks a continuación asocian acciones de rollback con tipos específicos de fallo en aplicaciones Capacitor y Electron, incluidos los releases distribuidos a través de canales de Capgo. Úsalos como patrones de runbook y luego sustituye los ejemplos de triggers por tus propias líneas base de monitoreo de crashes, negocio e integridad de datos.
Tabla de contenidos
- 1. Rollback automático al detectar un crash
- 2. Rollback de actualización diferencial con historial de versiones
- 3. Staged rollout con rollback automático por degradación de métricas
- 4. Rollback solo de configuración con feature flags
- 5. Canary rollback con consentimiento del usuario y override manual
- 6. Rollback de migración de DB con versionado de esquema
- 7. Rollback basado en incidentes con observabilidad automatizada y post-mortems
- Comparativa de 7 ejemplos de planes de rollback
- Convierte estos ejemplos de planes de rollback en tu runbook
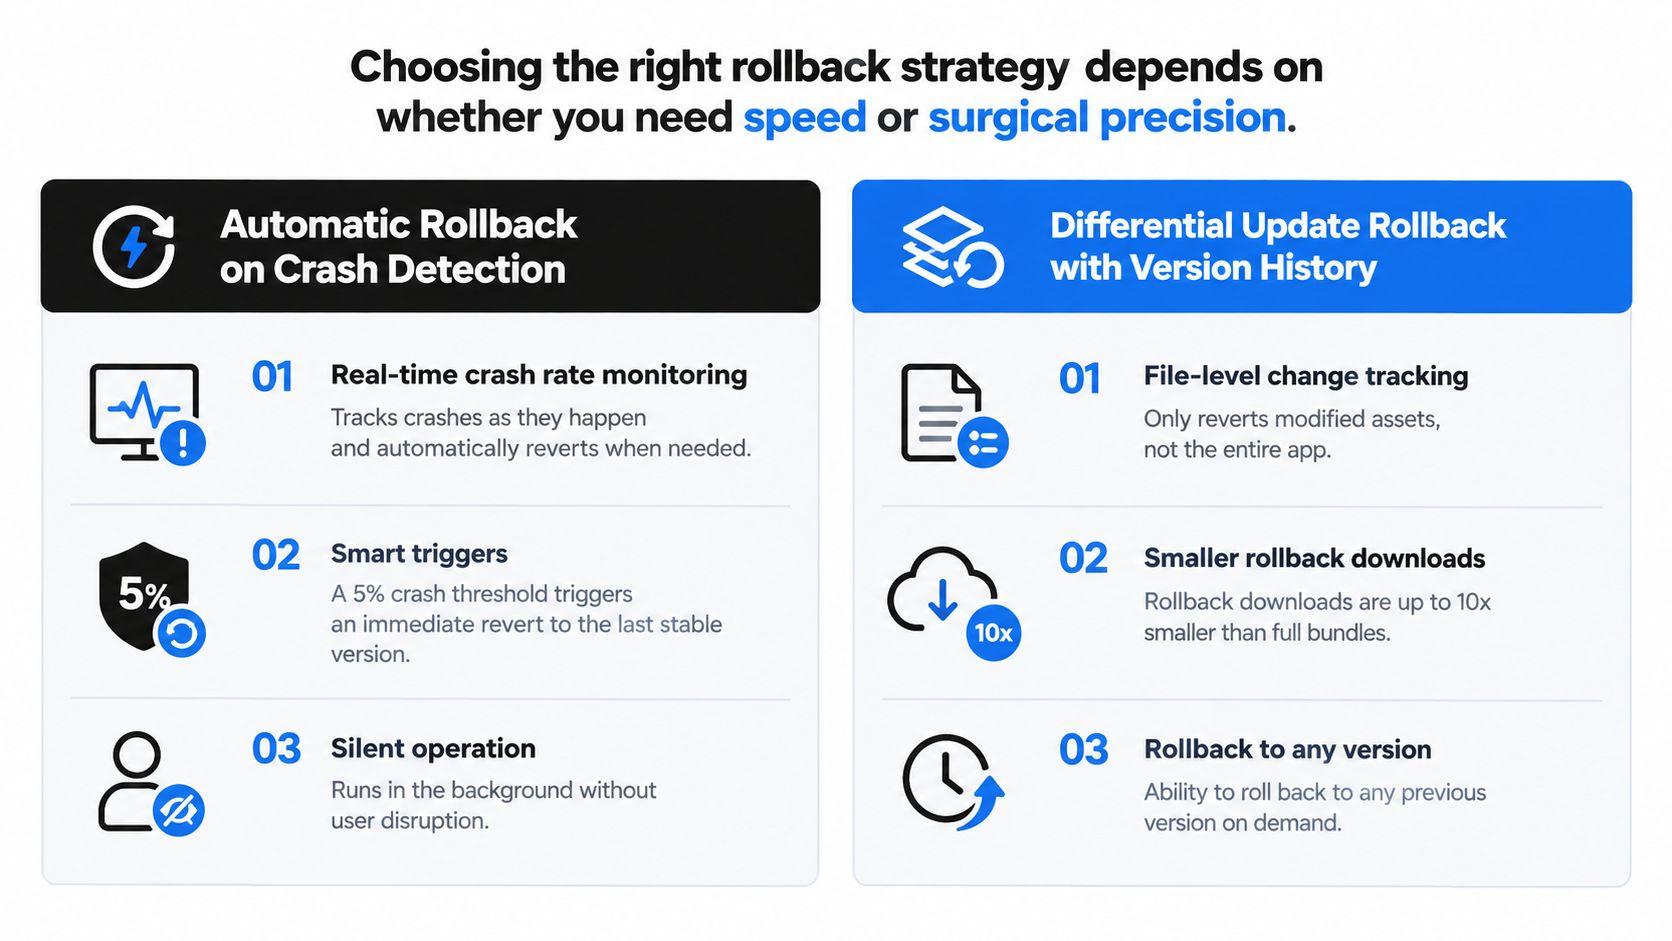
1. Rollback automático al detectar un crash
El rollback automático es la primera respuesta correcta cuando un nuevo web bundle causa un fallo de inicio evidente, una excepción de JavaScript, un fallo de un plugin nativo o un patrón de crash que no estaba presente en la versión anterior. El trigger debe ser legible por máquinas y estar vinculado a una versión, canal, grupo de dispositivos y ventana de observación. Un release controller puede pausar la distribución y restaurar el último bundle que funcionaba sin esperar a que un ingeniero lo detecte en el dashboard.
Para una app con Capacitor, monitorea más que los crashes nativos. Rastrea si la aplicación arranca, si la webview carga, si notifyAppReady() se completa, si los plugins críticos se inicializan y si el primer flujo de usuario funciona. Los equipos de Electron deberían añadir fallos del proceso renderer, excepciones del proceso principal, fallos al instalar updates y llamadas IPC fallidas.
Regla práctica: El rollback automático debe detener primero la exposición y luego restaurar el servicio. No debe intentar diagnosticar la causa raíz mientras los usuarios sigan recibiendo el bundle sospechoso.
Un trigger práctico podría ser un aumento sostenido de crashes o fallos en los checks de readiness por encima de la línea base del release. No copies el umbral de otra app. Establece un límite conservador para producción, valídalo frente a la variación normal de dispositivos y OS, y requiere suficientes observaciones para evitar reaccionar ante un solo dispositivo aislado.
Disparador, acción y modo de fallo
- Disparador: Señales de crash, startup, readiness o de plugins nativos que superan el release gate del canal afectado.
- Acción: Congela la expansión del canal, marca el bundle como no saludable, vuelve a desplegar el bundle firmado anterior y verifica el arranque y los flujos críticos.
- Contrapartida: La recuperación es rápida, pero un disparador demasiado sensible puede revertir una versión saludable debido a un problema de dispositivo o backend no relacionado.
- Modo de fallo: El bundle anterior depende de un API o configuración modificada, por lo que la app inicia pero falla después. Mantén las comprobaciones de compatibilidad en la health gate.
Para el diagnóstico por dispositivo y la correlación de crashes, usa esta guía para conectar Firebase Crashlytics con apps de Capacitor. Prueba la ruta completa en un canal de staging, incluyendo detección, congelación del canal, redespliegue, descarga del cliente, activación y confirmación de que la versión antigua sigue siendo usable.
2. Rollback de actualización diferencial con historial de versiones
Un rollback diferencial es adecuado para fallos aislados en una hoja de estilos, un asset, un valor de configuración o un módulo de JavaScript. El actualizador transfiere solo los archivos que difieren entre la versión activa y un objetivo conocido como estable, reduciendo la descarga para usuarios con conexiones inestables. El objetivo aún debe reconstruir una versión completa.
El disparador es un fallo a nivel de archivo confirmado que no requiere un cambio en el runtime nativo. Antes de actuar, compara los manifiestos activo y anterior, verifica la versión del runtime de Capacitor o Electron y confirma que el canal afectado tenga un bundle firmado compatible. Si el fallo cruza ese límite, despliega el bundle completo anterior en lugar de intentar una reparación solo de archivos.
La entrega diferencial no es una recuperación parcial. Nunca combines archivos arbitrarios de varias versiones. Almacena manifiestos inmutables, valida checksums y firmas, conserva el artefacto completo anterior y registra la versión activa en el historial del canal. Un bundle de JavaScript y un plugin nativo incompatibles pueden dejar la app iniciándose mientras un flujo crítico falla más tarde.
de Capgo historial de versiones de la app ayuda a los operadores a localizar un build válido conocido antes de redesplegar. Registra el identificador del bundle, la versión del runtime nativo, el canal de Capgo, la revisión de configuración y las notas de migración de cada release.
Usa este runbook:
- Confirma que el fallo se limita a assets web, configuración o code.
- Congela el canal afectado para que más dispositivos no reciban la versión sospechosa.
- Selecciona el último bundle firmado compatible, no solo el archivo anterior más cercano.
- Genera una actualización diferencial solo cuando el cliente y el manifest permitan una reconstrucción segura.
- Prueba el arranque, las verificaciones de integridad, la compatibilidad con API y el flujo de usuario afectado.
- Monitorea descargas, activaciones y finalización de rollbacks en Capacitor y clientes de Electron.
Una reconstrucción fallida, un checksum que no coincide, una dependencia nativa incompatible o un bucle de activación son modos de fallo. Detén la entrega diferencial y vuelve a desplegar el bundle completo retenido. El historial de versiones responde qué cambió y qué release puede cruzar el límite de compatibilidad de forma segura. No reemplaza los artefactos de rollback probados ni las notas de migración.
3. Staged rollout con rollback automático por degradación de métricas
Una release puede pasar las verificaciones de arranque y aun así romper un flujo de trabajo clave. Para un despliegue escalonado, coloca las cohortes de beta, staging, producción o clientes en canales de Capgo separados. Promueve un bundle firmado a la vez y mantén disponible la versión compatible anterior en cada canal. Esto limita la exposición y conserva una ruta de recuperación directa para Capacitor y los clientes de Electron.
Define la puerta de salida antes de la promoción. Para un cambio en el checkout, monitorea los pagos completados, no solo los crashes. Para mensajería, revisa la latencia de entrega y las entregas exitosas. Para la sincronización en salud, valida la completitud de los registros. Compara cada señal con la línea base para la misma audiencia, mezcla de dispositivos y canal. Un release está sano solo cuando la acción crítica se completa correctamente.
Usa esta secuencia durante la promoción:
- Asigna un responsable para revisar las señales técnicas y de negocio.
- Observa la cohorte definida durante el periodo acordado.
- Detén la promoción en cuanto una métrica monitoreada cruce su umbral aprobado.
- Congela el canal Capgo afectado y conserva el ID de la versión, las versiones de cliente, la configuración y las métricas de evidencia.
- Vuelve a desplegar el último bundle compatible para esa cohorte.
- Verifica el arranque, la activación de la actualización y el flujo de trabajo afectado en dispositivos Capacitor y Electron representativos.
- Reanuda la promoción solo después de que el responsable confirme la recuperación.
El guía para despliegues por fases de Capacitor live updates ofrece contexto de despliegue para releases basados en canales. El rollback automatizado debe ejecutarse solo cuando la métrica y el umbral sean inequívocos. Un fallo de pago, privacidad, seguridad o integridad de datos puede justificar una acción inmediata incluso antes de contar con confianza estadística.
El principal modo de fallo es un dashboard limitado. La salud técnica puede mantenerse normal mientras un resultado de negocio se deteriora, y las condiciones poco frecuentes de dispositivo, cuenta o red pueden no aparecer nunca en la primera cohorte. Registra esas brechas en el runbook antes del próximo release.
4. Rollback solo de configuración con feature flags
Un rollback de configuración sirve para fallos aislados en una funcionalidad. Mantén instalado el nuevo bundle de Capacitor o Electron y desactiva la ruta riesgosa mediante un flag remoto para el canal o la audiencia afectados de Capgo. La app puede restaurar la lógica de recomendaciones, una variante de interfaz, sincronización opcional, almacenamiento experimental u otro comportamiento protegido sin reemplazar code no relacionados con el problema.
El fallback ya debe existir. Confirma que sigue siendo compatible con el API actual y con el modelo de datos, asigna a un responsable y registra el alcance del flag y su valor por defecto de emergencia antes del release. Eliminar la ruta antigua y añadir un flag después de un incidente no deja nada que activar.
Ejecuta el rollback de flags como un playbook acotado
- Disparador: Un error en una funcionalidad, un workflow fallido, problemas de privacidad, de batería o una regresión de negocio superan el umbral acordado por el equipo.
- Acción: Desactiva el flag para el canal o la audiencia afectados de Capgo. Confirma que los clientes reciben el cambio y después prueba el fallback en dispositivos Capacitor y Electron representativos.
- Verificación: Revisa el estado del flag activo, los eventos relevantes, el comportamiento en el arranque y el workflow afectado. Mantén el nuevo bundle en su sitio mientras el equipo aísla el fallo.
- Contrapartida: El cambio es rápido y acotado, pero no puede reparar una dependencia compartida, un code nativo incompatible o datos corruptos.
- Modo de fallo: La actualización puede no llegar, ser ignorada en el arranque o quedarse en caché. Registra el estado del flag junto con cada evento relevante y define la expiración de la caché.
Usa la guía de implementación de feature flags para estructurar este control en un workflow de Capgo. Mantén un default local de emergencia para las funciones críticas. Si no se puede obtener la configuración, deniega el acceso (fail closed). Las funciones sensibles para la seguridad y la privacidad deben deshabilitar el acceso durante una caída del control plane en lugar de mantenerlo.
5. Canary rollback con consentimiento del usuario y override manual
Un canary release puede parecer saludable en la telemetría mientras falla para una cuenta enterprise, un rol de usuario o una integración específica. Ofrece a ese grupo un fallback claro y una forma de reportar el problema. Su feedback puede exponer fallos de workflow o usabilidad que las métricas agregadas pasan por alto.
Usa controles separados para usuarios y operadores. La acción para el usuario debe estar disponible fuera del workflow roto, explicar qué cambios se revierten y recopilar el bundle activo, la versión de la app nativa, el canal de Capgo, el dispositivo y el timestamp. Para apps con Capacitor, verifica el web bundle anterior contra el shell nativo instalado. Para Electron, confirma que el fallback siga siendo compatible con el runtime de escritorio empaquetado.
Configura el trigger del canary antes del release:
- Disparador: Congela el canal tras opt-outs repetidos de un segmento, reportes agrupados o si una métrica técnica cruza el umbral acordado.
- Acción del usuario: Muestra la opción de fallback, registra el consentimiento y el contexto de diagnóstico, y devuelve al usuario al bundle compatible anterior.
- Acción del operador: Pausa la exposición adicional, revisa los reportes y redirige el canal canary a la build estable. Mantén disponible un override manual cuando el control plane o la UI del cliente no estén disponibles.
- Contrapartida: El consentimiento mejora la transparencia y detecta problemas pronto, pero las versiones mixtas aumentan el esfuerzo de soporte y complican las comparaciones.
- Modo de fallo: Un usuario puede hacer rollback sin transmitir contexto, o el cliente antiguo puede fallar ante un backend modificado. Trata user consent best practices for OTA updates como parte del diseño de comunicación y opt-out, manteniendo la compatibilidad con el servidor o una reversión de funciones controlada.
No presentes este rollback como solución a la incompatibilidad del servidor. Si el contrato del backend cambió, restaura primero la compatibilidad o mantén deshabilitado el workflow afectado.
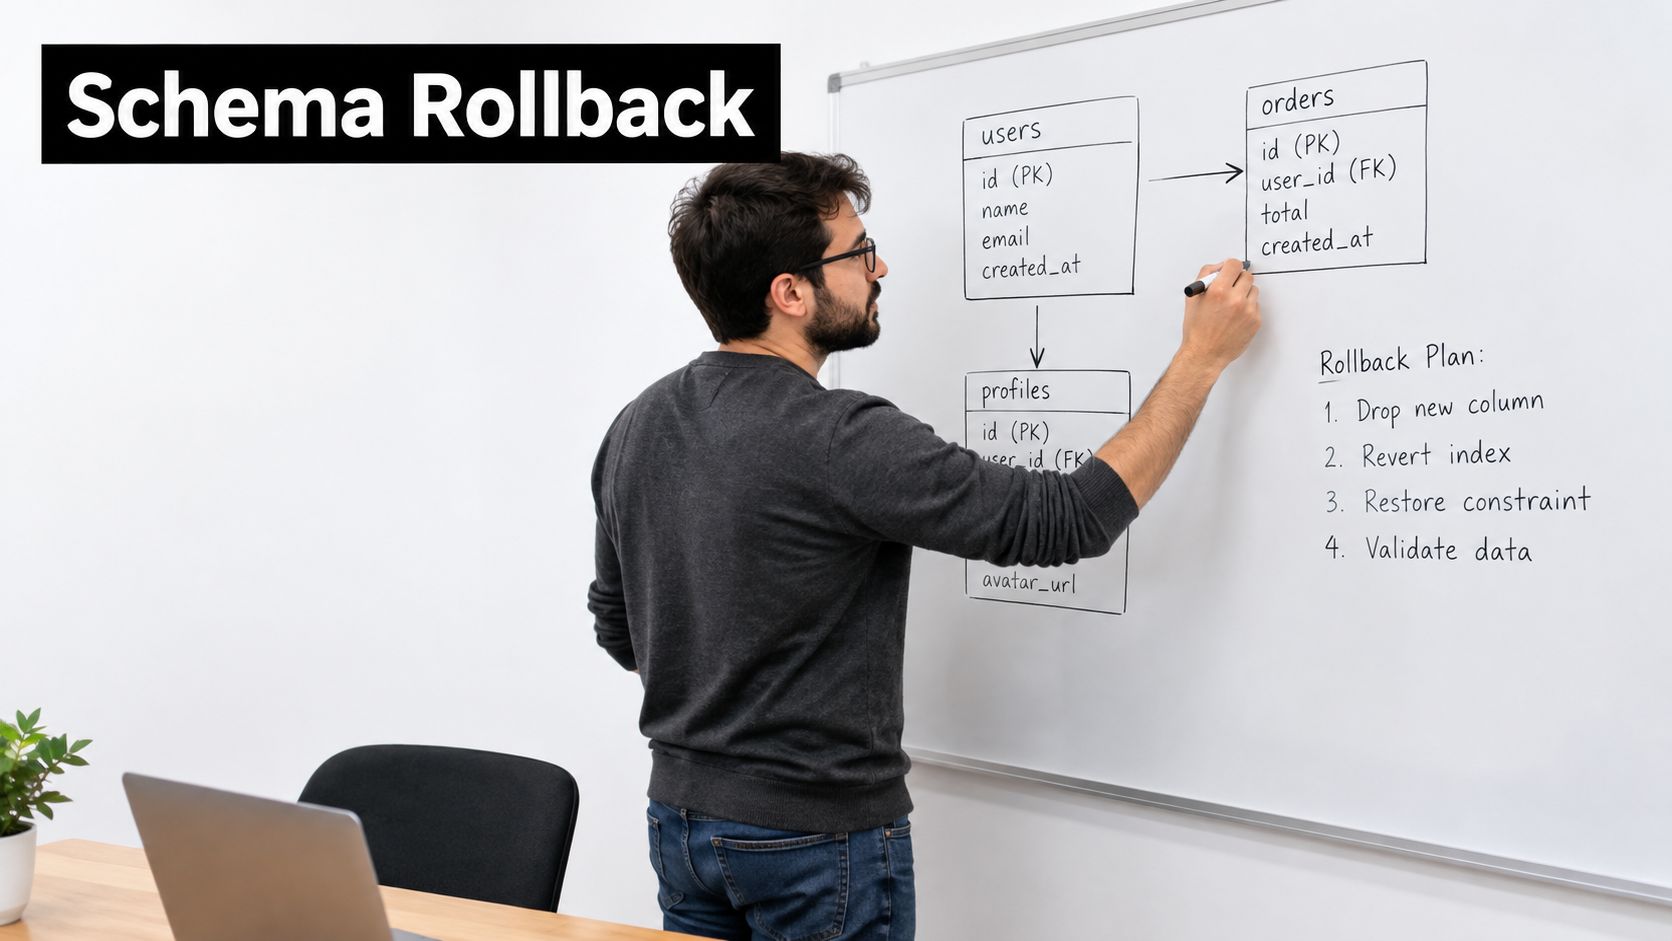
6. Rollback de migración de DB con versionado de esquema
Un rollback de bundle no puede reparar un schema incompatible. Un cliente Capacitor o Electron puede volver a su code anterior mientras el API o la base de datos local aún esperan nuevos campos, tipos modificados o datos parcialmente migrados. El resultado puede ser lecturas fallidas, escrituras rechazadas o registros incorrectos.
Trata la migración como un release propio con una ruta de recuperación. Empieza con una fase de expansión: añade campos o tablas compatibles sin eliminar la representación anterior. Despliega code que lea y escriba ambos formatos, y luego migra los registros existentes con validación. Cambia el tráfico de forma deliberada. Elimina las estructuras legacy solo cuando el cliente anterior ya no sea necesario. Así mantienes posible un rollback del canal Capgo mientras el nuevo esquema sigue desplegado.
La review en rollback-safe database migrations cubre migraciones transaccionales, esquemas compatibles hacia atrás y despliegues separados de base de datos y aplicación. Aplica esos controles a registros de pagos, pedidos, información de pacientes y otros datos que no se pueden recrear de forma segura.
Define la ruta de recuperación antes de publicar:
- Rollback de la aplicación: Restaura el bundle Capacitor anterior o el paquete de Electron solo después de confirmar que puede leer el esquema actual.
- Rollback de funcionalidad: Desactiva la nueva ruta de escritura o el feature flag, preservando los cambios de esquema compatibles.
- Recuperación de migración: Detén las escrituras afectadas, inspecciona los registros y ejecuta un procedimiento de corrección o recuperación revisado.
- Restauración de datos: Usa backup o point-in-time recovery cuando la reversión de code no pueda restaurar la integridad de los datos.
Mantén bajo revisión los scripts de forward y recovery. Pruébalos con datos similares a producción y usa transacciones o savepoints donde se soporten. No generes SQL de rollback destructivo durante un incidente. Define condiciones de éxito para la salud de la app, la validez de los datos y la compatibilidad de escritura, con responsables distintos para cada decisión. Un plan de migración que no se haya ensayado en staging no es un ejemplo confiable de plan de rollback.
7. Rollback basado en incidentes con observabilidad automatizada y post-mortems
Un canal de Capgo puede mostrar un rollout saludable mientras una cohorte específica de Capacitor o Electron falla tras el lanzamiento. Define el trigger del incidente antes del release, como una señal de crash sostenida, un readiness check fallido, un flujo de API roto o un error confirmado de integridad de datos. Ante una alerta, congela la expansión del canal y registra el bundle activo, la versión de la app nativa, el canal, el estado del rollout, la cohorte afectada, la categoría del error y los timestamps. Captura esta evidencia antes de cambiar el estado del deployment.
Guía DORA sobre métricas de deployment y recovery plantea el rollback tanto como una señal de fallo de cambio como un evento de recovery. Guarda el identificador del release y el resultado del rollback, y luego compara el tiempo desde la detección hasta la restauración, las sesiones o dispositivos afectados y las tasas de error post-recovery. Estas métricas muestran si el bundle restaurado eliminó el fallo.
Gestiona el incidente como una secuencia corta y registrada:
- Disparador: Confirma la alerta frente a señales de crash, readiness, API, negocio o datos.
- Congelar: Detén la expansión del canal y desactiva el feature flag si eso limita el impacto mejor que un rollback completo.
- Preservar: Guarda logs, traces, historial de versiones, estado de adopción y detalles del segmento afectado.
- Rollback: Vuelve a desplegar el último bundle compatible para Capacitor o Electron, considerando la compatibilidad con la versión native.
- Comprobación: Prueba el inicio y los flujos críticos, luego confirma que la señal de error esté disminuyendo.
- Revisión: Registra la causa, la detección omitida, la decisión y el cambio en el runbook.
Un rollback fallido es en sí mismo un disparador. Escala al canal anterior conocido como estable o a una ruta de despliegue manual si la versión restaurada se bloquea, no puede iniciar o reproduce el mismo fallo de API. Usa esto Guía de causa raíz de Forge Reliability para estructurar la investigación. Realiza la post-mortem sin culpas mientras la evidencia esté disponible, asigna un responsable a cada acción correctiva y ensaya la verificación de preparación o el guardarrail de canal resultante.
Comparativa de 7 ejemplos de planes de rollback
| Estrategia | Complejidad de implementación 🔄 | Requisitos de recursos 💡 | Resultados esperados 📊 / ⭐ | Casos de uso ideales 💡 | Ventajas clave ⭐ / ⚡ |
|---|---|---|---|---|---|
| Rollback automático al detectar crashes | Medio 🔄🔄 | Monitoreo en tiempo real + sistemas de error tracking | Mitigación rápida; menor MTTR 📊 ⭐⭐⭐⭐ | Apps en producción que requieren alta estabilidad (fintech, salud) | Protección automática silenciosa; recuperación rápida ⚡ ⭐ |
| Rollback de actualizaciones diferenciales con historial de versiones | Alto 🔄🔄🔄 | Almacenamiento de versiones, motor de diffs, gestión de estado | Rollbacks precisos y eficientes en ancho de banda 📊 ⭐⭐⭐⭐ | Usuarios con mala red, assets grandes, equipos indie | Precisión a nivel de archivo; descargas de rollback mucho más pequeñas ⚡ ⭐ |
| Despliegue gradual con rollback automático ante degradación de métricas | Muy alto 🔄🔄🔄🔄 | Infraestructura de métricas robusta, frameworks A/B, segmentación | Radio de impacto reducido; protege las métricas de negocio 📊 ⭐⭐⭐⭐ | E-commerce, funciones sensibles a ingresos, grandes bases de usuarios | Progresión basada en datos; detecta el impacto en el negocio a tiempo ⭐ 📊 |
| Rollback solo de configuración con feature flags | Bajo 🔄 | Despliegue de feature flags/configuración (sin rebuild) | Rollback instantáneo de funciones; mínima interrupción para el usuario 📊 ⭐⭐⭐ | Regresiones de funciones, correcciones rápidas, equipos pequeños | Rollback más rápido (minutos); sin revisión de la app store ⚡ ⭐ |
| Canary Rollback con consentimiento del usuario y anulación manual | Alto 🔄🔄🔄 | Canary targeting, UI in-app, recopilación de feedback | Detección temprana de casos límite; insights cualitativos 📊 ⭐⭐⭐ | Programas beta empresariales, releases guiados por feedback | Agencia del usuario + feedback directo; pruebas iniciales más seguras ⭐ 💡 |
| Rollback de migración de base de datos con versionado de esquema | Muy alto 🔄🔄🔄🔄 | Experiencia en BD, herramientas de migración, datos de staging | Mantiene la integridad de los datos; rollbacks conformes 📊 ⭐⭐⭐⭐ | Sectores regulados, e-commerce, apps con datos complejos | Migraciones bidireccionales seguras; registros de auditoría y validación ⭐ |
| Rollback basado en incidentes con observabilidad y post-mortems | Muy alto 🔄🔄🔄🔄 | Observabilidad avanzada, gestión de incidentes y almacenamiento | Respuesta rápida con contexto forense; aprendizaje organizacional 📊 ⭐⭐⭐⭐ | Servicios grandes que priorizan la fiabilidad y las prácticas SRE | Auto rollback + datos forenses completos para post-mortems sin culpa ⭐ 📊 |
Convierte estos ejemplos de planes de rollback en tu runbook
No elijas un único mecanismo de rollback para cada incidente. Empieza por la acción segura más acotada. Si un feature flag puede desactivar la ruta que falla sin comprometer la integridad de los datos, úsalo primero. Si el release en sí es inestable, detén la expansión del channel y usa los controles de staged-channel con gates automáticos de crash y readiness. Si el fallo afecta al code compartido, a la configuración o a APIs incompatibles, restaura el último bundle compatible y verifica el flujo de usuario completo.
La decisión más difícil tiene que ver con los datos. Un rollback de bundle no revierte una migración de schema, una escritura parcial ni un cambio de comportamiento del lado del servidor. En esos incidentes, congela las escrituras de riesgo, involucra al data owner y sigue el procedimiento de migración segura en lugar de asumir que el cliente anterior es automáticamente más seguro. El fallo de Knight Capital en 2012 ilustra por qué restaurar un binario anterior no basta: un servidor mantenía funcionalidad legacy latente, un flag reutilizado la activó y el rollback que se intentó dejó el comportamiento problemático activo en todo el entorno. El incidente produjo aproximadamente 397 millones de ejecuciones erróneas de acciones, una posición nocional de unos $7 mil millones, y una pérdida inicial reportada antes de impuestos de aproximadamente 440 millones de dólares, situado después cerca de 460 millones de dólares en informes más amplios, como se documenta en este relato del fallo de rollback de Knight Capital.
El despliegue de Storm de Spotify ofrece otro principio útil para sistemas con estado. Mantener dos versiones completas de la topología disponibles, preservar las posiciones de los consumidores y usar una activación reversible permite a los operadores restaurar la versión anterior sin perder el stream, como se describe en Cuenta de despliegue de Apache Storm de Spotify. El diseño análogo de Capgo consiste en conservar el bundle firmado anterior, mantener los health gates específicos de cada versión y confirmar la compatibilidad antes de eliminar la versión antigua.
Convierte estas ideas en un árbol de decisiones breve:
- Fallo específico de la función: Desactiva el feature flag, verifica el fallback e investiga.
- Inestabilidad del release: Congela el canal, vuelve a desplegar el último bundle compatible y monitorea la recuperación.
- Incertidumbre en segmentos específicos: Detén la promoción y usa el feedback de canary junto con un override manual.
- Riesgo de esquema o de datos: No hagas un rollback a ciegas de code. Congela los cambios y ejecuta el plan de migración o recuperación de datos.
- Causa poco clara: Captura evidencia primero, contén la exposición y luego elige la acción reversible más acotada.
Elige un playbook hoy mismo. Define su trigger, responsable, el comando de rollback o acción en el dashboard, pasos de verificación y ruta de escalación. Pruébalo en un canal de staging antes del próximo release a producción, incluyendo un update fallido, una señal de readiness rota, una reversión de configuración y un check de compatibilidad. Los equipos se recuperan más rápido cuando el rollback es una operación practicada y no un párrafo escrito tras el incidente.
Capgo ofrece Live Updates firmados para apps de CapacitorJS y Electron, con canales segmentados, historial de versiones, logs por dispositivo, métricas de adopción y fallos, entrega diferencial y protección de rollback automático. Usa Capgo para convertir este ejemplo de plan de rollback en un workflow de release y recuperación probado para tu app.





