
Pukul 4 sore, update web layer masuk ke produksi. Dalam hitungan menit, laporan crash melonjak, tiket support masuk, dan tim menemukan bahwa JavaScript bundle baru hanya gagal di sebagian perangkat. Menunggu review App Store atau Google Play bukan pilihan, tapi restore file lama saja tidak cukup jika konfigurasi, API, feature flags, atau data yang tersimpan juga ikut berubah. Contoh rencana rollback yang berguna harus memberi tahu operator apa yang memicu respons, versi mana yang harus di-restore, cara memverifikasi pemulihan, dan kapan me-revert code justru bisa memperburuk insiden.
Tujuh playbook di bawah ini memetakan tindakan rollback ke jenis kegagalan spesifik pada aplikasi Capacitor dan Electron, termasuk rilis yang didistribusikan melalui channel Capgo. Gunakan ini sebagai pola runbook, lalu ganti contoh trigger dengan baseline dari monitoring crash, bisnis, dan integritas data Anda sendiri.
Table of Contents
- 1. Rollback Otomatis saat Crash Terdeteksi
- 2. Rollback Update Diferensial dengan Riwayat Versi
- 3. Rollout Bertahap dengan Rollback Otomatis saat Metrik Menurun
- 4. Rollback Konfigurasi Saja dengan Feature Flags
- 5. Canary Rollback dengan Persetujuan User dan Manual Override
- 6. Rollback Migrasi Database dengan Versioning Skema
- 7. Rollback Berbasis Insiden dengan Observability Otomatis dan Post-Mortem
- Perbandingan 7 Contoh Rollback Plan
- Jadikan contoh rencana rollback ini sebagai runbook Anda
1. Rollback Otomatis saat Crash Terdeteksi
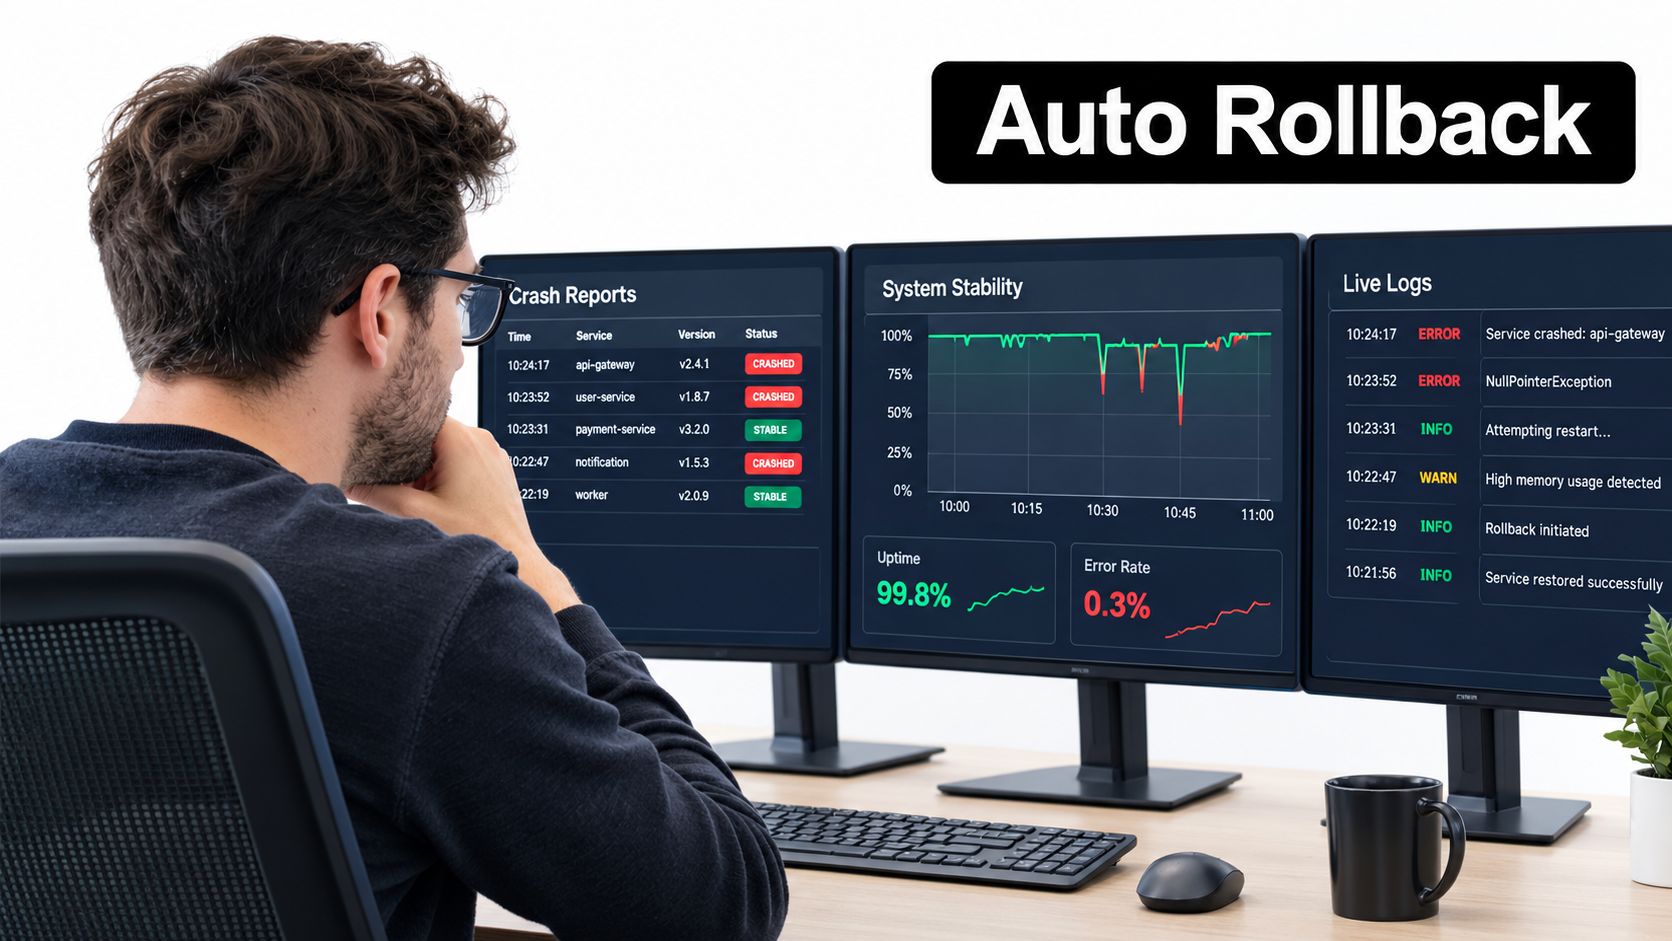
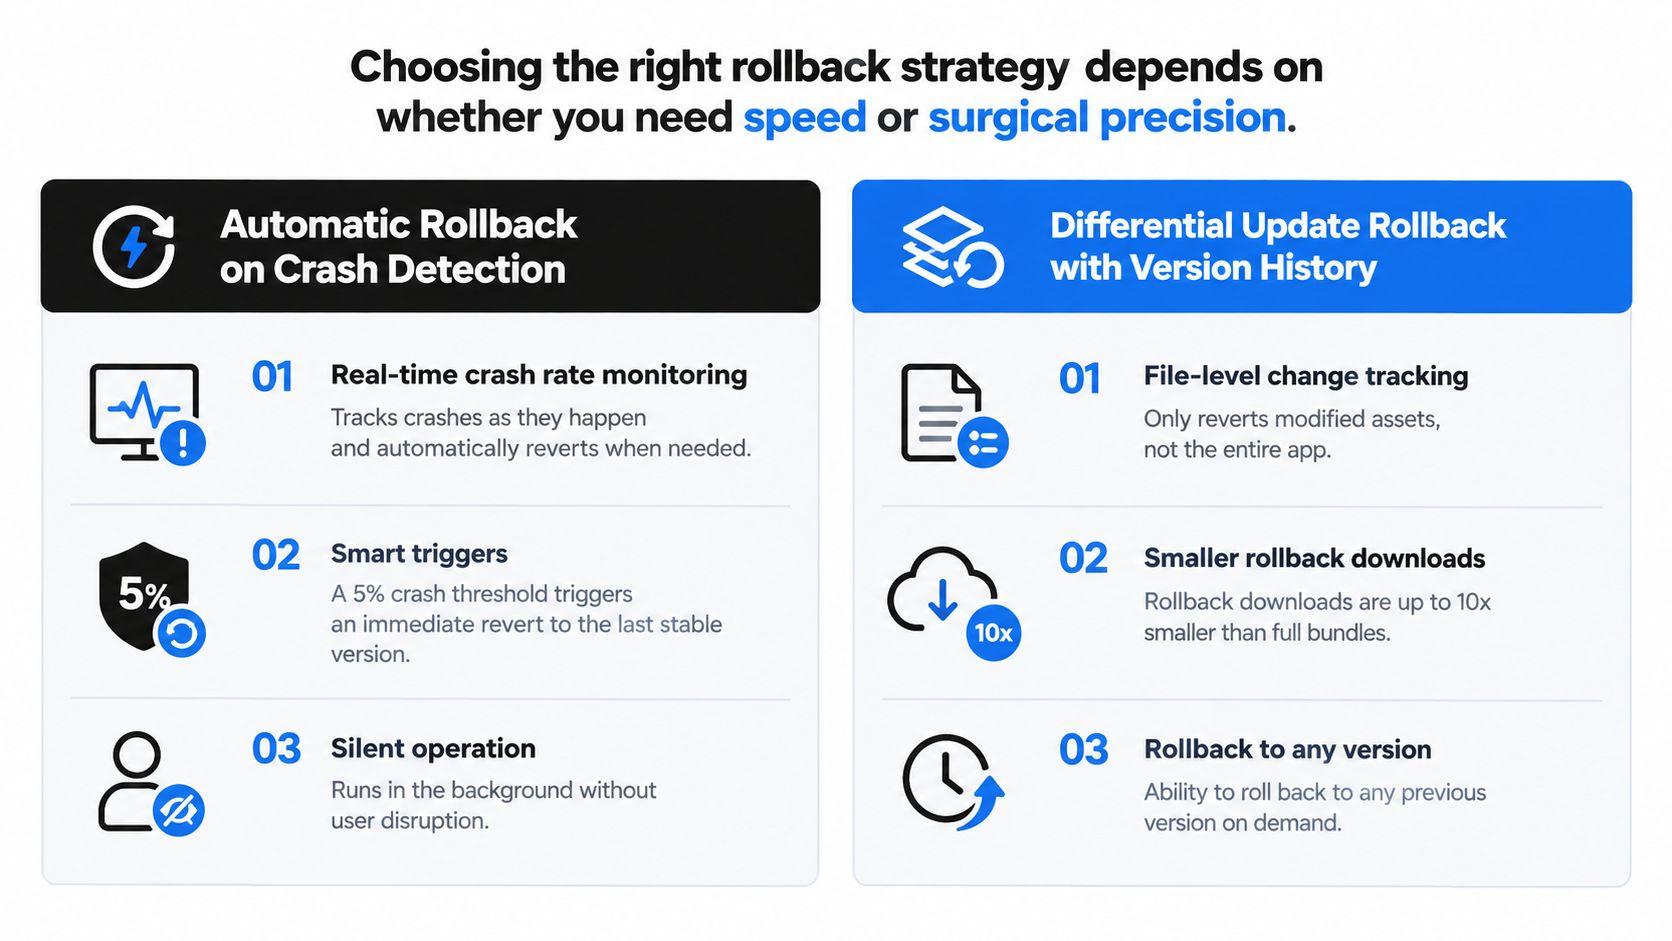
Rollback otomatis adalah respons pertama yang tepat ketika web bundle baru menyebabkan kegagalan startup yang jelas, exception JavaScript, kesalahan plugin native, atau pola crash yang tidak ada di rilis sebelumnya. Pemicunya harus machine-readable dan terikat pada versi, channel, grup perangkat, dan jendela observasi. Release controller dapat menjeda distribusi dan memulihkan bundle terakhir yang diketahui berfungsi tanpa menunggu engineer memeriksa dashboard.
Untuk aplikasi Capacitor, pantau lebih dari sekadar crash native. Lacak apakah aplikasi berhasil dimulai, apakah WebView dimuat, apakah notifyAppReady() selesai, apakah plugin kritis terinisialisasi, dan apakah alur pengguna pertama berhasil. Tim Electron harus menambahkan kegagalan renderer process, exception main process, kegagalan instalasi update, dan panggilan IPC yang gagal.
Aturan praktis: Rollback otomatis harus menghentikan paparan terlebih dahulu, lalu memulihkan layanan. Rollback otomatis tidak boleh mencoba mendiagnosis akar masalah saat pengguna masih menerima bundle yang dicurigai.
Pemicu praktis bisa berupa peningkatan berkelanjutan crash atau readiness check yang gagal di atas baseline rilis. Jangan salin threshold dari aplikasi lain. Tetapkan batas konservatif untuk produksi, validasi terhadap variasi perangkat dan OS normal, dan pastikan observasi cukup untuk menghindari reaksi terhadap satu perangkat terisolasi.
Trigger, aksi, dan mode kegagalan
- Pemicu: Sinyal crash, startup, readiness, atau native-plugin melanggar release gate untuk channel yang terdampak.
- Aksi: Bekukan ekspansi channel, tandai bundle sebagai tidak sehat, deploy ulang bundle bertanda tangan sebelumnya, dan verifikasi startup serta alur kritis.
- Trade-off: Pemulihan cepat, tetapi pemicu yang terlalu sensitif dapat membatalkan rilis sehat karena masalah perangkat atau backend yang tidak terkait.
- Mode kegagalan: Bundle lama bergantung pada API atau konfigurasi yang berubah, sehingga aplikasi bisa start tetapi gagal setelahnya. Pertahankan pemeriksaan kompatibilitas di health gate.
Untuk diagnosis per-perangkat dan korelasi crash, gunakan panduan ini untuk menghubungkan Firebase Crashlytics dengan aplikasi Capacitor. Uji seluruh alur di channel staging, termasuk deteksi, pembekuan channel, redeploy, download klien, aktivasi, dan konfirmasi bahwa versi lama tetap bisa digunakan.
2. Rollback Update Diferensial dengan Riwayat Versi
Rollback diferensial cocok untuk kegagalan yang terisolasi pada stylesheet, aset, nilai konfigurasi, atau modul JavaScript. Updater hanya mentransfer file yang berbeda antara rilis aktif dan target yang terverifikasi baik, mengurangi beban download bagi pengguna dengan koneksi tidak stabil. Target tetap harus merekonstruksi rilis lengkap.
Pemicunya adalah kesalahan tingkat file yang sudah dikonfirmasi dan tidak memerlukan perubahan runtime native. Sebelum bertindak, bandingkan manifest aktif dan sebelumnya, periksa versi runtime Capacitor atau Electron, dan pastikan channel terdampak punya bundle bertanda tangan yang kompatibel. Jika kesalahan melewati batas tersebut, deploy bundle lengkap sebelumnya daripada mencoba perbaikan file saja.
Pengiriman diferensial bukan pemulihan parsial. Jangan pernah menggabungkan file sembarangan dari beberapa rilis. Simpan manifest immutable, validasi checksum dan signature, pertahankan artefak lengkap sebelumnya, dan catat versi aktif di riwayat channel. Bundle JavaScript yang tidak cocok dengan plugin native bisa membuat aplikasi tetap bisa launch, tetapi alur kritis gagal belakangan.
Capgo riwayat versi aplikasi membantu operator menemukan build known-good sebelum deploy ulang. Catat bundle identifier, versi runtime native, channel Capgo, revisi konfigurasi, dan catatan migrasi untuk setiap rilis.
Gunakan runbook ini:
- Pastikan masalahnya hanya pada aset web, konfigurasi, atau code.
- Bekukan channel yang terdampak agar perangkat lain tidak menerima versi yang dicurigai.
- Pilih bundle bertanda tangan terakhir yang kompatibel, bukan sekadar file sebelumnya yang terdekat.
- Buat differential update hanya jika klien dan manifest mendukung rekonstruksi yang aman.
- Uji startup, pemeriksaan integritas, kompatibilitas API, dan alur pengguna yang terdampak.
- Pantau download, aktivasi, dan penyelesaian rollback pada klien Capacitor dan Electron.
Kegagalan rekonstruksi, mismatch checksum, dependensi native yang tidak kompatibel, atau loop aktivasi adalah failure mode. Hentikan differential delivery dan deploy ulang full bundle yang tersimpan. Riwayat versi menunjukkan apa yang berubah dan rilis mana yang bisa melewati batas kompatibilitas dengan aman. Ini bukan pengganti artifact rollback yang sudah diuji atau catatan migrasi.
3. Rollout Bertahap dengan Rollback Otomatis saat Metrik Menurun
Rilis bisa lolos startup check tapi tetap merusak workflow inti. Untuk staged rollout, pisahkan cohort beta, staging, production, atau customer ke dalam channel Capgo yang berbeda. Promote satu signed bundle dalam satu waktu, dan pastikan versi kompatibel sebelumnya tetap tersedia untuk setiap channel. Ini membatasi exposure sekaligus menjaga jalur recovery langsung untuk klien Capacitor dan Electron.
Tetapkan release gate sebelum promosi. Untuk perubahan checkout, pantau pembayaran yang berhasil, bukan hanya crash. Untuk messaging, cek latency dan keberhasilan pengiriman. Untuk sinkronisasi healthcare, validasi kelengkapan record. Bandingkan setiap sinyal dengan baseline untuk audiens, komposisi device, dan channel yang sama. Rilis dianggap sehat hanya jika aksi kritis selesai dengan benar.
Gunakan urutan ini saat promosi:
- Tunjuk penanggung jawab untuk meninjau sinyal teknis dan bisnis.
- Pantau cohort yang ditentukan selama periode yang disepakati.
- Hentikan promosi segera setelah metrik yang dipantau melewati threshold yang sudah disetujui.
- Bekukan Capgo channel yang terdampak dan simpan release ID, versi klien, konfigurasi, serta bukti metrik.
- Deploy ulang bundle yang kompatibel terakhir ke kohort tersebut.
- Verifikasi startup, aktivasi update, dan workflow yang terdampak pada perangkat Capacitor dan Electron yang representatif.
- Lanjutkan promosi hanya setelah owner mengonfirmasi pemulihan.
Panduan panduan phased rollout untuk Capacitor live updates menyediakan konteks deployment untuk rilis berbasis channel. Rollback otomatis hanya boleh dieksekusi setelah metrik dan ambang batasnya tidak ambigu. Kegagalan pembayaran, privasi, keselamatan, atau integritas data dapat membenarkan tindakan segera bahkan sebelum kepercayaan statistik tersedia.
Mode kegagalan utama adalah dashboard yang terlalu sempit. Kesehatan teknis bisa tetap normal sementara hasil bisnis memburuk, dan kondisi perangkat, akun, atau jaringan yang jarang terjadi mungkin tidak pernah muncul di kohort pertama. Catat celah-celah tersebut di runbook sebelum rilis berikutnya.
4. Rollback Konfigurasi Saja dengan Feature Flags
Rollback konfigurasi cocok untuk kegagalan yang terisolasi pada satu kemampuan. Biarkan Capacitor atau bundle Electron baru tetap terpasang, lalu matikan jalur berisiko melalui remote flag untuk Capgo channel atau audiens yang terdampak. Aplikasi dapat memulihkan logika rekomendasi, varian antarmuka, sinkronisasi opsional, penyimpanan eksperimental, atau perilaku terproteksi lainnya tanpa mengganti code yang tidak terkait.
Fallback harus sudah ada. Pastikan fallback tetap kompatibel dengan API dan model data saat ini, tentukan owner, serta catat scope flag dan default darurat sebelum rilis. Menghapus path lama lalu menambahkan flag setelah insiden tidak menyisakan apa pun untuk diaktifkan.
Jalankan rollback flag sebagai playbook dengan batas jelas
- Pemicu: Error spesifik fitur, workflow gagal, masalah privasi, masalah baterai, atau regresi bisnis melewati ambang batas yang disepakati tim.
- Aksi: Nonaktifkan flag untuk channel atau audience Capgo yang terdampak. Pastikan client menerima perubahan, lalu uji fallback pada perangkat Capacitor dan Electron yang representatif.
- Verifikasi: Cek status flag aktif, event terkait, perilaku startup, dan workflow yang terdampak. Biarkan bundle baru tetap terpasang sementara tim mengisolasi fault.
- Trade-off: Perubahan ini cepat dan terbatas, tetapi tidak bisa memperbaiki shared dependency, code native yang tidak kompatibel, atau data yang rusak.
- Mode kegagalan: Update mungkin tidak sampai, diabaikan saat startup, atau tetap tersimpan di cache. Log status flag pada setiap event terkait dan tentukan masa kedaluwarsa cache.
Gunakan panduan implementasi feature flag untuk menyusun kontrol ini dalam workflow Capgo. Pertahankan default darurat lokal untuk fitur kritis. Jika konfigurasi tidak bisa diambil, terapkan fail closed. Fitur yang sensitif terhadap keamanan dan privasi sebaiknya menonaktifkan akses selama control-plane mengalami gangguan, bukan mempertahankannya.
5. Canary Rollback dengan Persetujuan User dan Manual Override
Canary release bisa terlihat sehat di telemetri padahal gagal untuk satu akun enterprise, role pengguna, atau integrasi tertentu. Beri grup tersebut fallback yang jelas dan cara untuk melaporkan masalah. Feedback mereka bisa mengungkap kegagalan workflow atau usability yang tidak terlihat di metrik agregat.
Gunakan kontrol terpisah untuk user dan operator. Aksi sisi user harus tersedia di luar workflow yang rusak, menjelaskan apa yang berubah saat revert, serta mencatat bundle aktif, versi native app, channel Capgo, perangkat, dan timestamp. Untuk aplikasi Capacitor, verifikasi web bundle sebelumnya terhadap native shell yang terpasang. Untuk Electron, pastikan fallback tetap kompatibel dengan runtime desktop yang dipaketkan.
Atur canary trigger sebelum rilis:
- Pemicu: Bekukan channel setelah opt-out berulang dari satu segmen, laporan yang mengelompok, atau metrik teknis melewati threshold yang disepakati.
- Aksi user: Tampilkan pilihan fallback, catat persetujuan dan konteks diagnostik, lalu kembalikan user ke bundle kompatibel sebelumnya.
- Aksi operator: Jeda eksposur lebih lanjut, tinjau laporan, dan alihkan canary channel ke build stabil. Sediakan manual override saat control plane atau UI client tidak tersedia.
- Trade-off: Consent meningkatkan transparansi dan memunculkan masalah lebih awal, tetapi versi campuran menambah beban support dan mempersulit perbandingan.
- Mode kegagalan: Pengguna mungkin rollback tanpa mengirim konteks, atau client lama bisa gagal terhadap backend yang berubah. Perlakukan praktik terbaik persetujuan pengguna untuk pembaruan OTA sebagai bagian dari desain komunikasi dan opt-out, serta mempertahankan kompatibilitas server atau pembalikan fitur yang terkontrol.
Jangan menyajikan rollback ini sebagai perbaikan untuk ketidakkompatibilitas sisi server. Jika kontrak backend berubah, pulihkan kompatibilitas terlebih dahulu atau biarkan alur kerja yang terpengaruh tetap nonaktif.
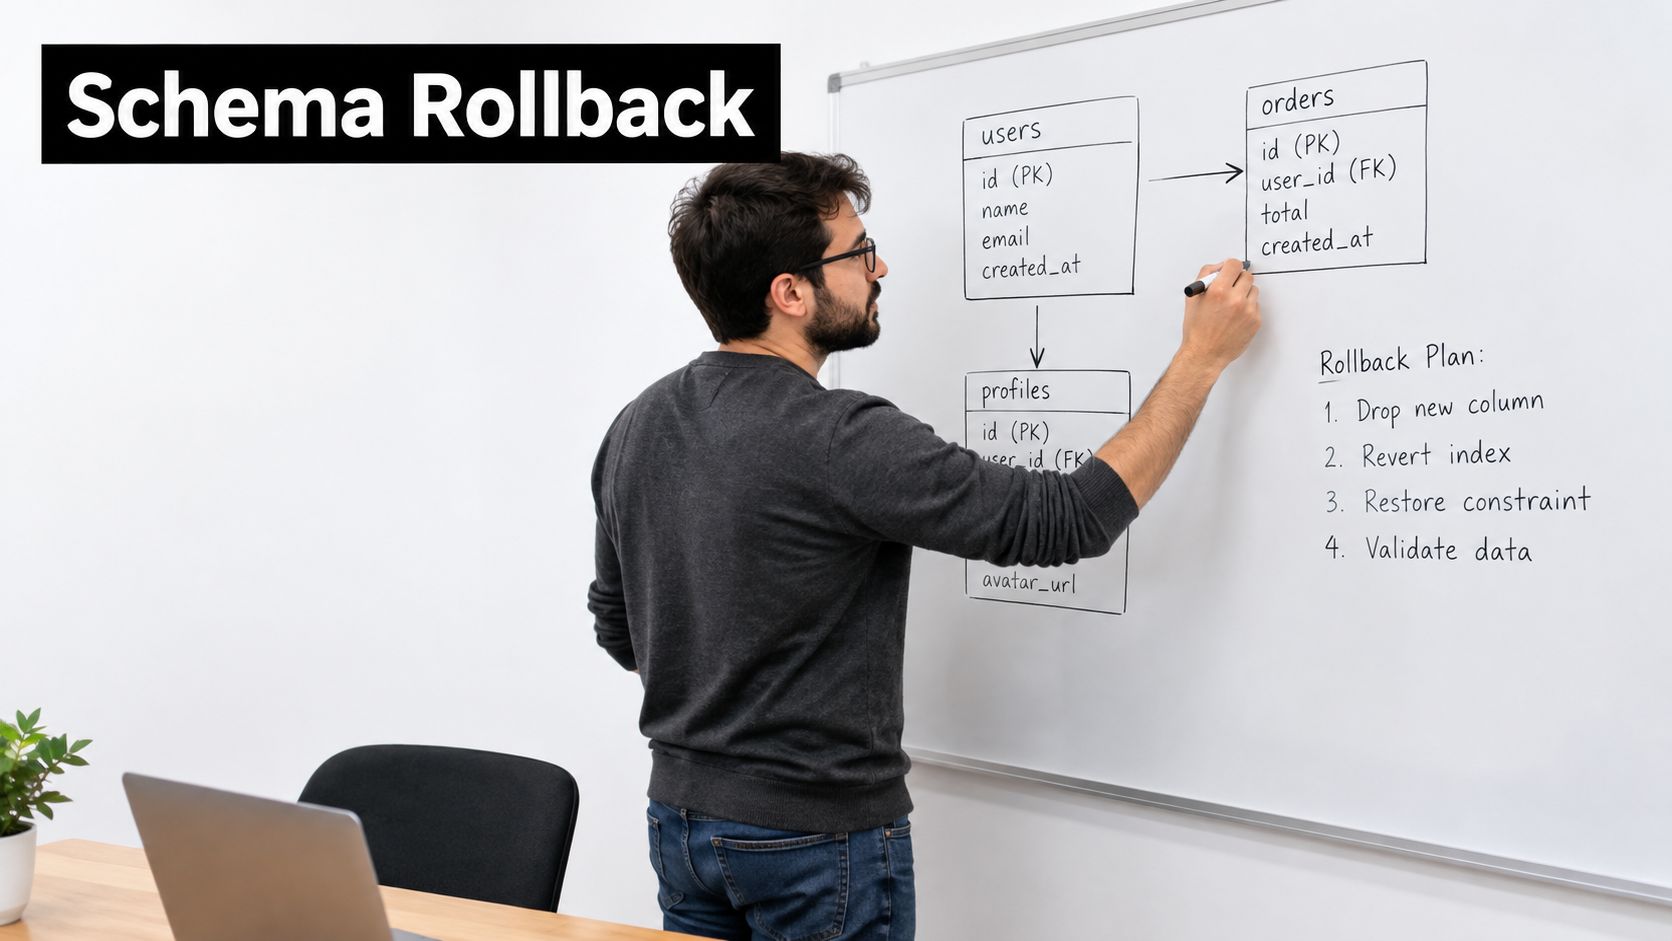
6. Rollback Migrasi Database dengan Versioning Skema
Rollback bundle tidak dapat memperbaiki skema yang tidak kompatibel. Klien Capacitor atau Electron mungkin kembali ke code sebelumnya, sementara API atau database lokal masih mengharapkan field baru, tipe yang diubah, atau data yang bermigrasi sebagian. Hasilnya bisa berupa pembacaan gagal, penulisan ditolak, atau catatan yang salah.
Perlakukan migrasi sebagai rilis tersendiri dengan jalur pemulihan. Mulai dengan fase expand: tambahkan field atau tabel yang kompatibel tanpa menghapus representasi lama. Deploy code yang membaca dan menulis kedua format, lalu migrasikan data yang ada dengan validasi. Alihkan traffic secara terencana. Hapus struktur lama hanya setelah client sebelumnya tidak lagi dibutuhkan. Ini menjaga rollback channel Capgo tetap mungkin selama skema baru masih ter-deploy.
Ulasan tentang migrasi database yang aman untuk rollback mencakup migrasi transaksional, skema backward-compatible, serta deployment database dan aplikasi secara terpisah. Terapkan kontrol tersebut pada catatan pembayaran, pesanan, informasi pasien, dan data lain yang tidak bisa dibuat ulang dengan aman.
Tentukan jalur pemulihan sebelum rilis:
- Rollback aplikasi: Restore bundle Capacitor atau paket Electron sebelumnya hanya setelah memastikan bundle atau paket itu dapat membaca skema saat ini.
- Rollback fitur: Nonaktifkan write path baru atau feature flag sambil tetap mempertahankan perubahan skema yang kompatibel.
- Pemulihan migrasi: Hentikan proses write yang terdampak, periksa record, dan jalankan forward-fix atau prosedur pemulihan yang telah ditinjau.
- Restorasi data: Gunakan backup atau point-in-time recovery ketika pembalikan code tidak bisa memulihkan kebenaran data.
Terus review skrip forward dan recovery. Uji dengan data yang mirip produksi, dan gunakan transaksi atau savepoint jika didukung. Jangan menghasilkan SQL rollback yang destruktif selama insiden. Definisikan kondisi sukses untuk kesehatan aplikasi, validitas data, dan kompatibilitas tulis, dengan pemilik terpisah untuk setiap keputusan. Rencana migrasi yang belum pernah diuji coba di staging bukanlah contoh rencana rollback yang bisa diandalkan.
7. Rollback Berbasis Insiden dengan Observability Otomatis dan Post-Mortem
Channel Capgo bisa menunjukkan rollout yang sehat sementara kohort Capacitor atau Electron tertentu gagal setelah peluncuran. Definisikan pemicu insiden sebelum rilis, seperti sinyal crash yang berkelanjutan, readiness check yang gagal, alur API yang rusak, atau error integritas data yang sudah dikonfirmasi. Saat alert muncul, bekukan ekspansi channel dan catat bundle aktif, versi aplikasi native, channel, status rollout, kohort yang terdampak, kategori error, dan timestamp. Kumpulkan bukti ini sebelum mengubah status deployment.
Panduan DORA tentang metrik deployment dan pemulihan Panduan ini menggambarkan rollback sebagai sinyal kegagalan perubahan sekaligus peristiwa pemulihan. Simpan identifier rilis dan hasil rollback, lalu bandingkan waktu dari deteksi hingga pemulihan, sesi atau perangkat yang terdampak, serta tingkat error setelah pemulihan. Metrik ini menunjukkan apakah bundle yang dipulihkan sudah menghilangkan kegagalan.
Jalankan insiden sebagai urutan singkat yang terekam:
- Pemicu: Konfirmasi alert dengan sinyal crash, readiness, API, bisnis, atau data.
- Bekukan: Hentikan ekspansi channel dan nonaktifkan feature flag jika itu lebih membatasi dampak daripada rollback penuh.
- Simpan: Simpan logs, traces, riwayat versi, status adopsi, dan detail segmen yang terdampak.
- Rollback: Deploy ulang bundle kompatibel terakhir untuk Capacitor atau Electron, dan pertimbangkan kompatibilitas versi native.
- Cek: Uji startup dan alur kritis, lalu pastikan sinyal kegagalan menurun.
- Tinjauan: Catat penyebab, deteksi yang terlewat, keputusan, dan perubahan runbook.
Rollback yang gagal adalah pemicu tersendiri. Eskalasi ke channel known-good sebelumnya atau jalur deployment manual jika versi yang dipulihkan crash, tidak bisa start, atau memunculkan kegagalan API yang sama. Gunakan ini Panduan root cause Forge Reliability untuk menyusun investigasi. Lakukan post-mortem blameless selagi bukti masih tersedia, tetapkan pemilik untuk setiap tindakan korektif, dan latih readiness check atau guardrail channel yang dihasilkan.
Perbandingan 7 Contoh Rollback Plan
| Strategi | Kompleksitas Implementasi 🔄 | Kebutuhan Resource 💡 | Ekspektasi Hasil 📊 / ⭐ | Kasus Penggunaan Ideal 💡 | Keunggulan Utama ⭐ / ⚡ |
|---|---|---|---|---|---|
| Rollback Otomatis saat Crash Terdeteksi | Menengah 🔄🔄 | Monitoring real-time + sistem pelacakan error | Mitigasi cepat; MTTR lebih rendah 📊 ⭐⭐⭐⭐ | Aplikasi produksi yang butuh stabilitas tinggi (fintech, healthcare) | Proteksi otomatis senyap; pemulihan cepat ⚡ ⭐ |
| Rollback Update Diferensial dengan Riwayat Versi | Tinggi 🔄🔄🔄 | Penyimpanan versi, diff engine, state management | Hemat bandwidth, rollback yang presisi 📊 ⭐⭐⭐⭐ | Pengguna dengan jaringan buruk, aset besar, tim indie | Presisi level file; download rollback jauh lebih kecil ⚡ ⭐ |
| Staged Rollout dengan Rollback Otomatis saat metrik menurun | Sangat tinggi 🔄🔄🔄🔄 | Infra metrik yang kuat, framework A/B, targeting | Memperkecil blast radius; melindungi metrik bisnis 📊 ⭐⭐⭐⭐ | E-commerce, fitur sensitif revenue, basis pengguna besar | Progres berbasis data; deteksi dampak bisnis lebih awal ⭐ 📊 |
| Rollback konfigurasi saja dengan feature flags | Rendah 🔄 | Feature flagging/deployment konfigurasi (tanpa rebuild) | Rollback fitur instan; gangguan pengguna minimal 📊 ⭐⭐⭐ | Regresi fitur, perbaikan cepat, tim kecil | Rollback tercepat (menit); tanpa review app store ⚡ ⭐ |
| Canary Rollback dengan Persetujuan Pengguna dan Override Manual | Tinggi 🔄🔄🔄 | Targeting canary, UI in-app, pengumpulan feedback | Deteksi edge-case lebih awal; wawasan kualitatif 📊 ⭐⭐⭐ | Program beta enterprise, rilis berbasis feedback pengguna | Kontrol pengguna + feedback langsung; testing awal lebih aman ⭐ 💡 |
| Rollback migrasi database dengan schema versioning | Sangat tinggi 🔄🔄🔄🔄 | Keahlian DB, tooling migrasi, data staging | Menjaga integritas data; rollback yang sesuai regulasi 📊 ⭐⭐⭐⭐ | Sektor teregulasi, e-commerce, aplikasi dengan data kompleks | Migrasi dua arah yang aman; audit trail dan validasi ⭐ |
| Rollback berbasis insiden dengan observability & post-mortem | Sangat tinggi 🔄🔄🔄🔄 | Observability canggih, manajemen insiden, penyimpanan | Respons cepat dengan konteks forensik; pembelajaran organisasi 📊 ⭐⭐⭐⭐ | Layanan skala besar yang mengutamakan reliabilitas dan praktik SRE | Auto rollback + data forensik lengkap untuk post-mortem tanpa menyalahkan ⭐ 📊 |
Jadikan contoh rencana rollback ini sebagai runbook Anda
Jangan pilih satu mekanisme rollback untuk setiap insiden. Mulailah dengan tindakan aman paling minimal. Jika feature flag dapat menonaktifkan jalur yang gagal sambil menjaga integritas data, gunakan itu lebih dulu. Jika rilisnya sendiri tidak stabil, hentikan perluasan channel dan gunakan kontrol staged-channel dengan gate crash dan readiness otomatis. Jika kegagalan memengaruhi code bersama, konfigurasi, atau API yang tidak kompatibel, restore bundle kompatibel terakhir dan verifikasi seluruh alur pengguna.
Keputusan tersulit berkaitan dengan data. Rollback bundle tidak membatalkan migrasi skema, partial write, atau perubahan perilaku sisi server. Untuk insiden tersebut, bekukan write yang berisiko, libatkan pemilik data, dan ikuti prosedur migrasi yang aman daripada berasumsi client sebelumnya otomatis lebih aman. Kegagalan Knight Capital tahun 2012 mengilustrasikan mengapa restore binary lama saja tidak cukup: sebuah server menyimpan fungsi legacy yang dorman, flag yang digunakan kembali mengaktifkannya, dan upaya rollback justru membiarkan perilaku bermasalah tersebut tetap aktif di seluruh environment. Insiden tersebut menghasilkan sekitar 397 juta eksekusi saham keliru, posisi notional sekitar $7 miliar, dan kerugian sebelum pajak awal yang dilaporkan sekitar $440 juta, kemudian ditempatkan di dekat $460 juta in broader reporting, as documented in this catatan kegagalan rollback Knight Capital.
Deployment Storm milik Spotify menawarkan prinsip berguna lainnya untuk sistem stateful. Menyediakan dua versi topologi lengkap, menjaga posisi consumer, dan menggunakan aktivasi yang dapat dibalik memungkinkan operator memulihkan versi sebelumnya tanpa kehilangan stream, seperti dijelaskan dalam catatan deployment Apache Storm milik Spotify. Desain Capgo yang serupa adalah mempertahankan bundle yang ditandatangani sebelumnya, menjaga health gate khusus versi, dan memastikan kompatibilitas sebelum menghapus rilis lama.
Ubah ide-ide ini menjadi decision tree singkat:
- Kegagalan spesifik fitur: Nonaktifkan feature flag, verifikasi fallback, dan investigasi.
- Instabilitas rilis: Bekukan channel, deploy ulang bundle kompatibel terakhir, dan pantau pemulihan.
- Ketidakpastian spesifik segmen: Hentikan promosi dan gunakan umpan balik canary plus override manual.
- Risiko skema atau data: Jangan rollback code secara buta. Bekukan perubahan dan jalankan rencana migrasi atau pemulihan data.
- Penyebab tidak jelas: Kumpulkan bukti terlebih dahulu, batasi paparan, lalu pilih tindakan reversibel yang paling sempit.
Pilih satu playbook hari ini. Tulis pemicunya, penanggung jawabnya, perintah rollback atau aksi dashboard yang tepat, langkah verifikasi, dan jalur eskalasi. Jalankan di channel staging sebelum rilis produksi berikutnya, termasuk update gagal, sinyal readiness rusak, pembalikan konfigurasi, dan pemeriksaan kompatibilitas. Tim pulih lebih cepat ketika rollback adalah operasi yang teruji, bukan paragraf yang ditulis setelah insiden.
Capgo menyediakan live update yang ditandatangani untuk aplikasi CapacitorJS dan Electron, dengan channel yang ditargetkan, riwayat versi, log per-perangkat, metrik adopsi dan kegagalan, pengiriman diferensial, serta perlindungan rollback otomatis. Gunakan Capgo untuk mengubah contoh rencana rollback yang sesuai dengan aplikasi Anda menjadi alur kerja rilis dan pemulihan yang telah diuji.





