
午後4時、Webレイヤーの更新が本番環境に反映されました。数分以内にクラッシュ報告が増加し、サポートチケットが殺到。チームは、新しいJavaScriptバンドルが一部のデバイスでのみ失敗していることを発見しました。App StoreやGoogle Playのレビューを待つことはできませんが、設定、API、機能フラグ、または保存データも変更されている場合、古いファイルを復元するだけでは不十分です。実用的なロールバック計画の例では、オペレーターに、対応のトリガーとなる条件、復元すべきバージョン、復旧の検証方法、そしてcodeの巻き戻しがインシデントを悪化させる可能性があるタイミングを明確に伝える必要があります。
以下の7つのプレイブックは、 Capacitor と Electron アプリ(を介して配布されるリリースを含む) Capgo チャネルをの特定の障害タイプにロールバックアクションを対応付けます。これらをランブックのパターンとして使用し、例示されたトリガーを、ご自身のクラッシュ、ビジネス、データ整合性モニタリングからのベースラインに置き換えてください。
目次
- 1. クラッシュ検知時の自動ロールバック
- 2. バージョン履歴を利用した差分アップデートのロールバック
- 3. メトリクス悪化時の自動ロールバックを伴う段階的ロールアウト
- 4. Feature Flags による設定のみのロールバック
- 5. ユーザーの同意と手動オーバーライドによるカナリアロールバック
- 6. スキーマバージョニングによるデータベースマイグレーションのロールバック
- 7. 自動化されたオブザーバビリティとポストモーテムを活用したインシデントベースのロールバック
- ロールバックプランの例7選を比較
- これらのロールバック計画例をランブックに取り入れよう
1. クラッシュ検知時の自動ロールバック
新しいWeb bundleが明確な起動失敗、JavaScript例外、ネイティブプラグインの障害、または前回リリースにはなかったクラッシュパターンを引き起こした場合、自動ロールバックが最初の対応として適切です。トリガーは機械可読で、バージョン、チャネル、デバイスグループ、観測ウィンドウに紐づける必要があります。リリースコントローラーは、エンジニアがダッシュボードで気づくのを待たずに配信を一時停止し、最後に正常動作していたbundleを復元できます。
Capacitor アプリでは、ネイティブクラッシュだけでなく、より広範な監視が必要です。アプリが起動するか、WebViewがロードされるか、あるいは notifyAppReady() 処理が完了するか、重要なプラグインが初期化されるか、最初のユーザーフローが成功するかを追跡します。Electronチームは、レンダラープロセスの失敗、メインプロセスの例外、アップデートのインストール失敗、IPC呼び出しの失敗も追加すべきです。
実践的なルール: 自動ロールバックは、まず問題のあるbundleへの露出を止めることを優先し、その後にサービスを復元すべきです。ユーザーが疑わしいbundleを受信している間に、根本原因の診断を試みてはいけません。
実用的なトリガーとしては、リリース時のベースラインと比較して、クラッシュやレディネスチェックの失敗が継続的に増加した場合などが挙げられます。他のアプリの閾値をそのままコピーしないでください。本番向けには保守的な閾値を設定し、通常のデバイスやOSのばらつきに対して検証し、単一のデバイスに反応しないよう十分な観測回数を要件にしてください。
トリガー、アクション、失敗モード
- トリガー: 対象チャネルで、クラッシュ、起動、レディネス、またはネイティブプラグインのシグナルがリリースゲートの閾値を超えた場合。
- アクション: チャネルの拡張を停止し、bundleをunhealthyとしてマークします。その後、以前の署名済みbundleを再デプロイし、起動と主要なフローが正常であることを確認します。
- トレードオフ: 復旧は迅速ですが、トリガーの感度が高すぎると、デバイスやバックエンドの無関係な問題によって正常なリリースをロールバックしてしまう可能性があります。
- 失敗パターン: 古いbundleが変更されたAPIや設定に依存している場合、アプリは起動しても後続の処理で失敗します。ヘルスゲートには互換性チェックを含めてください。
デバイスごとの診断やクラッシュとの相関分析には、このガイドに従って Firebase CrashlyticsをCapacitorアプリに連携させてください検知、チャネルの凍結、再デプロイ、クライアント側のダウンロード、アクティベーション、旧バージョンが引き続き利用できることの確認まで、ステージングチャネルで一連の流れをテストしてください。
2. バージョン履歴を利用した差分アップデートのロールバック
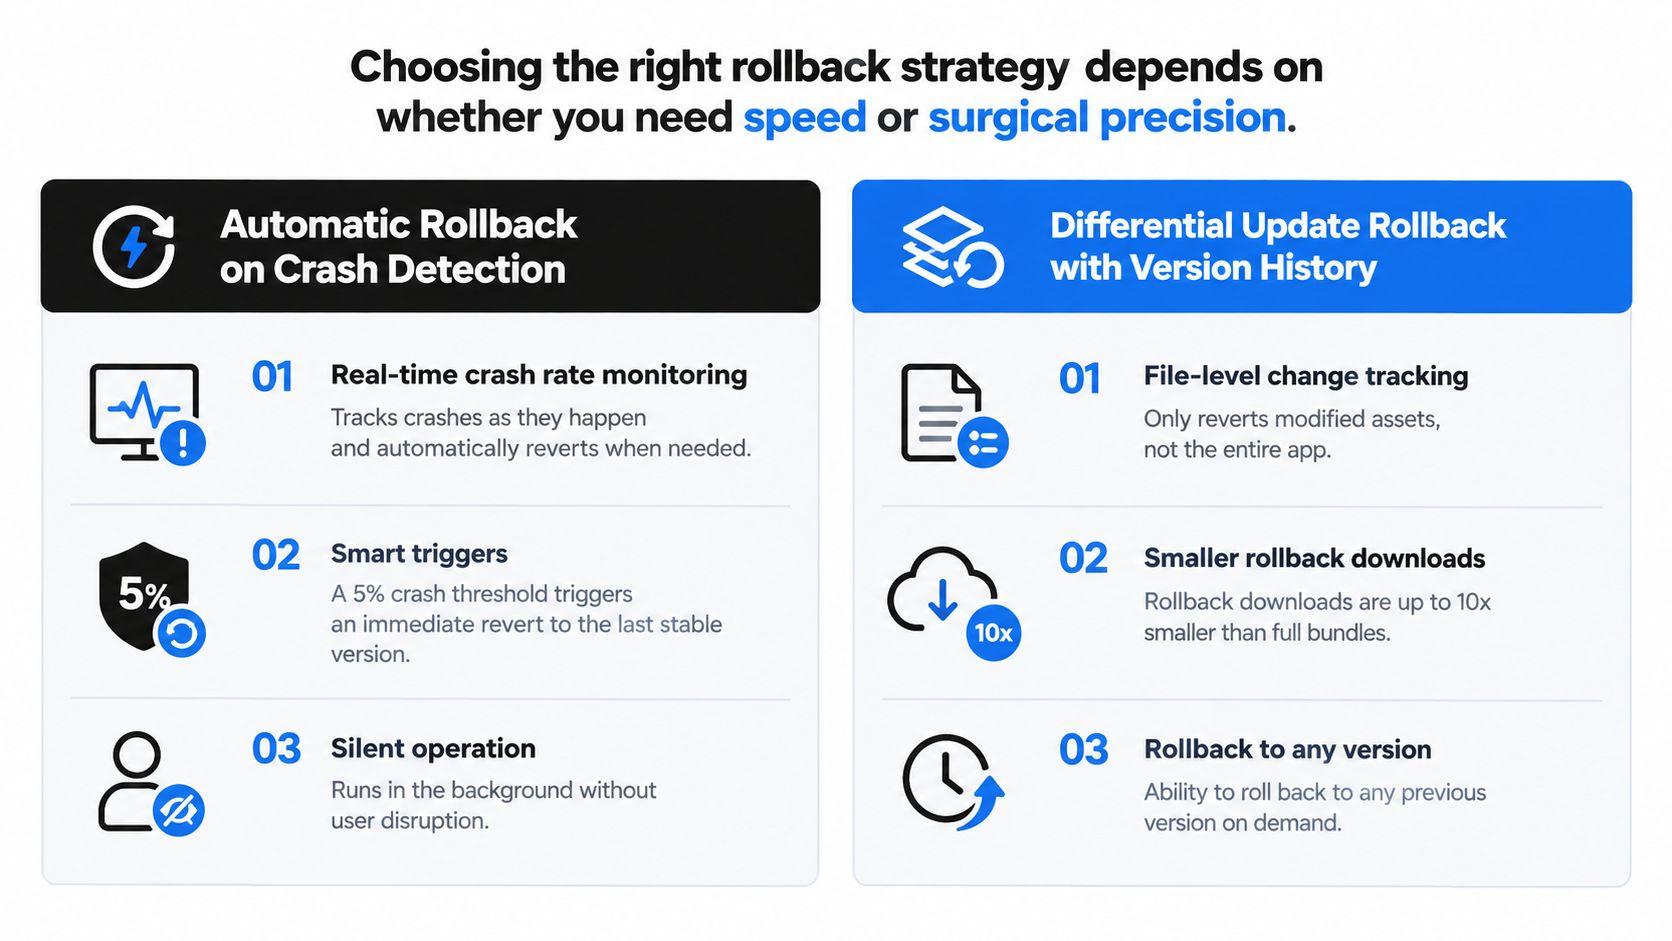
差分ロールバックは、スタイルシート、アセット、設定値、JavaScriptモジュールのいずれかに限定された障害に適しています。アップデーターは、アクティブなリリースと正常動作が確認されたターゲットの間で異なるファイルだけを転送するため、不安定な接続環境のユーザーのダウンロード負荷を軽減できます。ただし、ターゲットは完全なリリースを再構築できる必要があります。
トリガーは、ネイティブランタイムの変更を必要としない確認済みのファイルレベルの障害です。対応する前に、アクティブなマニフェストと前回のマニフェストを比較し、CapacitorまたはElectronランタイムのバージョンを確認し、影響を受けるチャネルに互換性のある署名済みバンドルが存在することを確認してください。障害がこの境界を越える場合は、ファイル単体の修復を試みるのではなく、完全な前回のバンドルをデプロイしてください。
差分配信は部分的な復旧ではありません。 複数のリリースから任意のファイルを組み合わせることは絶対にしないでください。不変のマニフェストを保存し、チェックサムと署名を検証し、完全な前回の成果物を保持し、アクティブなバージョンをチャネル履歴に記録してください。JavaScriptバンドルとネイティブプラグインが不一致の場合、アプリは起動するものの、重要なフローが後で失敗する可能性があります。
Capgo の アプリのバージョン履歴 再デプロイ前に既知の正常なビルドを特定するのを助けます。各リリースについて、バンドル識別子、ネイティブランタイムバージョン、Capgo チャンネル、設定リビジョン、マイグレーションメモを記録してください。
このランブックを使用してください:
- 障害が Web アセット、設定、または code に限定されていることを確認してください。
- 影響を受けたチャンネルを凍結し、疑わしいバージョンが追加のデバイスに配信されないようにしてください。
- 単に直前のファイルではなく、最後に互換性のある署名済みバンドルを選択してください。
- クライアントとマニフェストが安全な再構築をサポートする場合にのみ、差分更新を生成してください。
- 起動、整合性チェック、API 互換性、および影響を受けたユーザーフローをテストしてください。
- Capacitor と Electron クライアントで、ダウンロード、アクティベーション、ロールバック完了を監視します。
再構築の失敗、チェックサムの不一致、互換性のないネイティブ依存関係、アクティベーションループは失敗モードです。差分配信を停止し、保持しているフル bundle を再デプロイしてください。バージョン履歴は、何が変わったか、どのリリースが互換性の境界を安全に越えられるかに答えます。ただし、テスト済みのロールバック用アーティファクトや移行ノートの代わりにはなりません。
3. メトリクス悪化時の自動ロールバックを伴う段階的ロールアウト
リリースが起動チェックを通過しても、コアワークフローを損なうことがあります。段階的ロールアウトでは、ベータ、ステージング、本番、顧客コホートを別々の Capgo チャンネルに配置します。署名済み bundle を1つずつ昇格させ、各チャンネルで以前の互換バージョンを利用可能なままにします。これにより影響範囲を限定しつつ、Capacitor と Electron クライアントの直接的なリカバリパスを維持できます。
昇格前にリリースゲートを設定します。チェックアウトの変更なら、クラッシュだけでなく決済完了数を監視してください。メッセージングなら、配信レイテンシと配信成功率を確認します。ヘルスケアの同期なら、レコードの完全性を検証します。各シグナルは、同じオーディエンス、デバイス構成、チャンネルのベースラインと比較してください。重要なアクションが正しく完了して初めて、そのリリースは健全と言えます。
昇格時は次の順序で進めます:
- 技術面とビジネス面のシグナルをレビューするオーナーを割り当てます。
- 合意した期間、定義したコホートを観測します。
- 監視対象のメトリクスが承認済みの閾値を超えたら、直ちに昇格を停止します。
- 影響を受ける Capgo チャネルを凍結し、リリースID、クライアントバージョン、設定、メトリクスのエビデンスを保存します。
- そのコホートに、直近の互換性のある bundle を再デプロイします。
- 代表的な Capacitor および Electron デバイスで、起動、アップデートのアクティベーション、影響を受けたワークフローを確認します。
- オーナーが復旧を確認した後にのみ、プロモーションを再開してください。
この Capacitor Live Updates の段階的ロールアウトガイド これはチャネルベースのリリースにデプロイのコンテキストを提供します。自動ロールバックは、メトリクスと閾値が明確になってから初めて実行すべきです。ただし、決済、プライバシー、安全性、データ整合性の障害であれば、統計的な確度が得られる前でも即座の対応が正当化されます。
主な失敗パターンは、ダッシュボードの監視範囲が狭いことです。ビジネス上の成果が悪化していても、技術的なヘルス状態は正常なままに見えることがあります。また、稀なデバイス、アカウント、ネットワーク環境は最初のコホートには現れない可能性があります。次回のリリース前に、これらのギャップをランブックに記録してください。
4. Feature Flags による設定のみのロールバック
設定のロールバックは、特定の機能に限定された障害に適しています。新しい Capacitor または Electron bundle をインストールしたまま、リモートフラグで影響を受ける Capgo チャネルまたはオーディエンスに対してリスクのあるパスをオフにします。これにより、無関係な code を置き換えることなく、レコメンデーションロジック、UIバリエーション、オプションの同期、実験的なストレージ、その他のガードされた挙動をアプリ内で復元できます。
フォールバックは事前に用意しておく必要があります。現在のAPIとデータモデルとの互換性を確認し、オーナーを決め、リリース前にフラグのスコープと緊急時のデフォルト値を記録してください。インシデント発生後に古いパスを削除してフラグを追加しても、有効化できるものは残りません。
フラグのロールバックを、範囲を限定したプレイブックとして実行する
- トリガー: 機能固有のエラー、ワークフローの失敗、プライバシーの問題、バッテリー問題、またはビジネス上のリグレッションが、チームの合意した閾値を超えた場合。
- アクション: 対象となるCapgoのチャネルまたはオーディエンスに対してフラグを無効化します。クライアントが変更を受け取ったことを確認した後、代表的なCapacitorおよびElectronデバイスでフォールバックをテストしてください。
- 確認事項: アクティブなフラグの状態、関連するイベント、起動時の挙動、および影響を受けたワークフローをチェックします。チームが原因を切り分ける間、新しいbundleはそのまま保持してください。
- トレードオフ: 変更は迅速かつ限定的ですが、共有依存関係、互換性のないネイティブcode、または破損したデータの修復はできません。
- 失敗パターン: アップデートが届かない、起動時に無視される、またはキャッシュされたままになる可能性があります。関連する各イベントでフラグの状態をログに記録し、キャッシュの有効期限を定義しておいてください。
以下の フィーチャーフラグ実装ガイド Capgo のワークフローにこの制御を組み込むには。重要な機能については、ローカルに緊急用のデフォルト値を保持してください。設定を取得できない場合は、アクセスを拒否(fail closed)します。セキュリティやプライバシーに関わる機能は、コントロールプレーンの障害時にはアクセスを維持するのではなく、無効化すべきです。
5. ユーザーの同意と手動オーバーライドによるカナリアロールバック
カナリアリリースは、テレメトリ上は正常に見えても、特定のエンタープライズアカウント、ユーザーロール、インテグレーションで失敗していることがあります。そのグループには明確なフォールバックと、問題を報告する手段を用意してください。彼らのフィードバックから、集計メトリクスでは見えないワークフローやユーザビリティの不具合が見つかることがあります。
ユーザー用とオペレーター用で制御を分けてください。ユーザー向けの操作は、障害が発生しているワークフローの外から利用できるようにします。ロールバックで何が変わるのかを説明し、アクティブなbundle、ネイティブアプリのバージョン、Capgo チャネル、デバイス、タイムスタンプを収集します。Capacitor アプリの場合は、インストール済みのネイティブシェルに対して、以前のWeb bundleが適合するか確認してください。Electronの場合は、フォールバックがパッケージ化されたデスクトップランタイムと互換性を保っていることを確認してください。
リリース前にカナリアトリガーを設定します:
- トリガー: 特定のセグメントでオプトアウトが繰り返された場合、報告が集中した場合、または技術メトリクスが合意した閾値を超えた場合は、チャネルを凍結してください。
- ユーザー操作: フォールバックの選択肢を表示し、同意と診断コンテキストを記録した後、ユーザーを以前の互換性のあるbundleに戻します。
- オペレーターの対応: 新規配信を停止してレポートを確認し、canaryチャンネルを安定版ビルドへリダイレクトします。コントロールプレーンやクライアントUIが利用できない場合に備え、手動でのオーバーライド手段を確保しておいてください。
- トレードオフ: 同意を得ることで透明性は向上し、問題を早期に発見できますが、バージョンが混在するとサポートの手間が増え、比較も難しくなります。
- 失敗パターン: ユーザーがコンテキストを送信せずにロールバックする場合や、バックエンドの変更により旧クライアントが動作しなくなる場合があります。次のように扱ってください: OTAアップデートにおけるユーザー同意のベストプラクティス コミュニケーションとオプトアウト設計の一環として扱い、サーバー互換性または制御された機能の巻き戻しを維持してください。
このロールバックをサーバー側の互換性問題の解決策として提示しないでください。バックエンドの契約が変更された場合は、まず互換性を復元するか、影響を受けるワークフローを無効にしたままにしてください。
6. スキーマバージョニングによるデータベースマイグレーションのロールバック
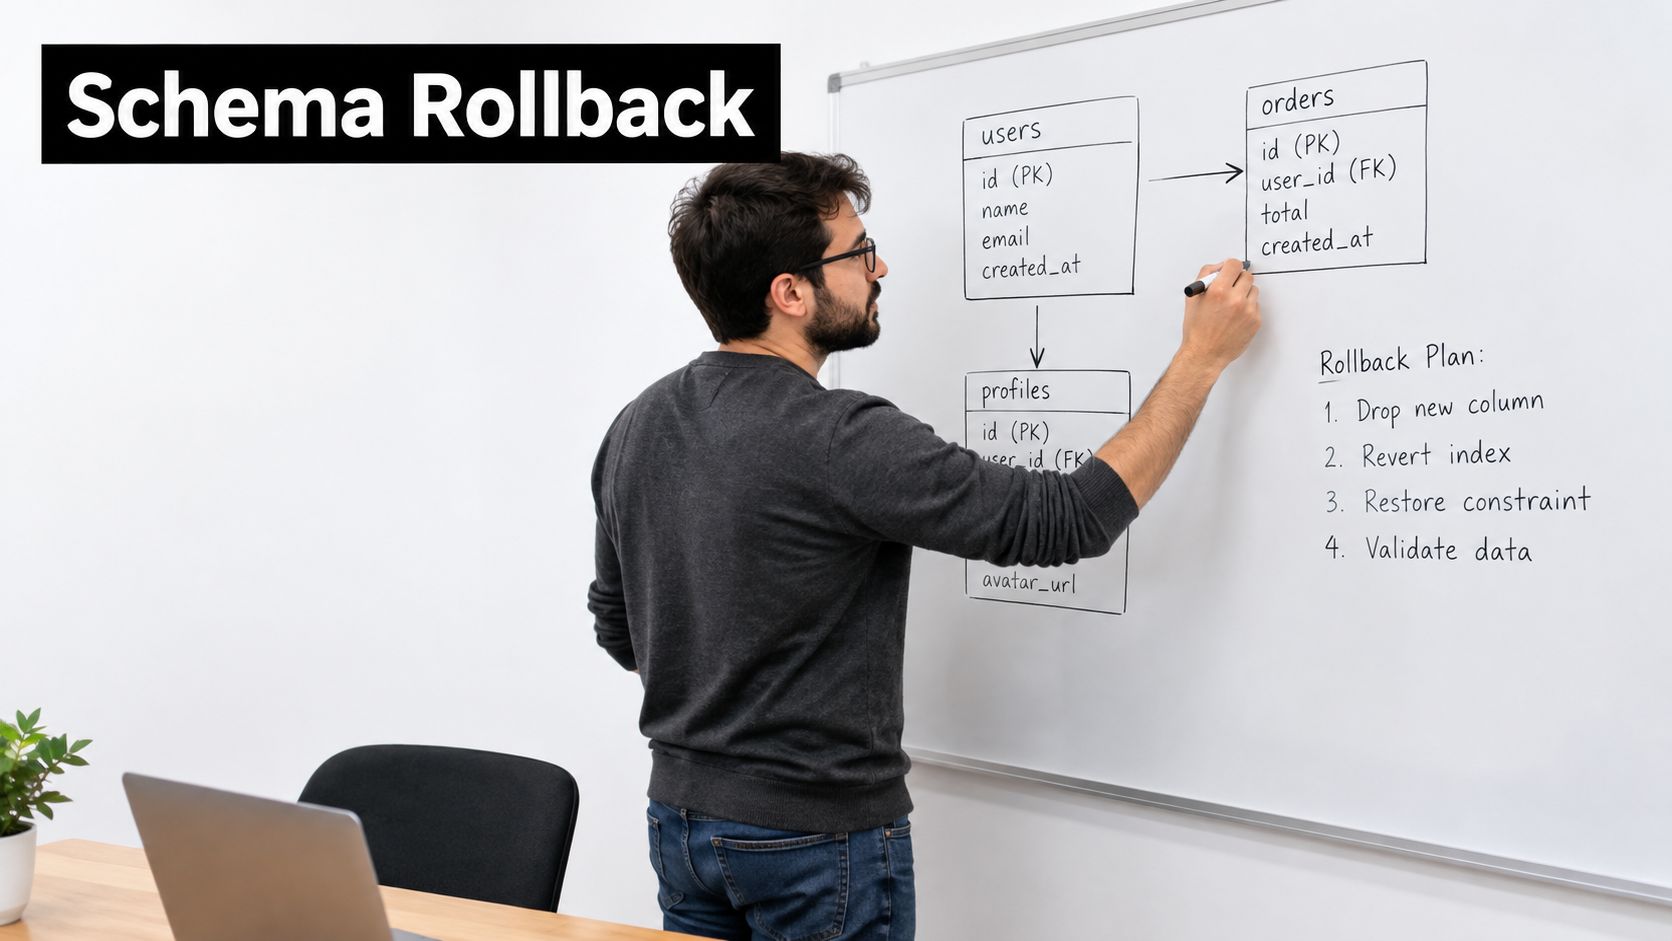
bundleのロールバックでは、互換性のないスキーマを修復することはできません。API やローカルデータベースが新しいフィールドや変更された型、あるいはマイグレーション途中のデータを期待している一方で、Capacitor やElectronクライアントが以前の code に戻ってしまう可能性があるためです。その結果、読み取りの失敗、書き込みの拒否、誤ったレコードが発生する恐れがあります。
移行を復旧パスを備えた独立したリリースとして扱います。まずexpandフェーズから開始し、旧表現を削除せずに互換性のあるフィールドやテーブルを追加します。両方の形式を読み書きするcodeをデプロイし、検証を伴って既存レコードを移行します。トラフィックの切り替えは意図的に行い、旧クライアントが不要になった後にのみレガシー構造を削除します。これにより、新スキーマがデプロイされた状態でもCapgoチャネルのロールバックが可能になります。
レビュー対象: ロールバック安全なデータベース移行 トランザクションベースの移行、後方互換スキーマ、データベースとアプリケーションのデプロイ分離を扱います。これらの制御を、安全に再作成できない決済記録、注文、患者情報などのデータに適用してください。
リリース前に復旧パスを割り当ててください:
- アプリケーションのロールバック: 現在のスキーマを読み取れることを確認してから、以前の Capacitor バンドルまたは Electron パッケージを復元してください。
- 機能のロールバック: 互換性のあるスキーマ変更を維持したまま、新しい書き込みパスや機能フラグを無効にします。
- マイグレーションの復旧: 影響を受けた書き込みを停止し、レコードを確認した上で、レビュー済みの前方修正または復旧手順を実行します。
- データの復元: code の逆転操作ではデータの正確性を復元できない場合、バックアップやポイントインタイムリカバリを使用します。
前方修正スクリプトと復旧スクリプトはレビュー下に置きます。本番環境に近いデータでテストし、サポートされている場合はトランザクションやセーブポイントを使用してください。インシデント発生中に破壊的なロールバック SQL を生成しないでください。アプリケーションの健全性、データの妥当性、書き込みの互換性について成功条件を定義し、各判断に担当者を割り当てます。ステージング環境でリハーサルされていないマイグレーション計画は、信頼できるロールバック計画の例ではありません。
7. 自動化されたオブザーバビリティとポストモーテムを活用したインシデントベースのロールバック
Capgo チャネルでは、健全なロールアウトが表示されている一方で、特定の Capacitor または Electron コホートがリリース後に失敗することがあります。リリース前にインシデントのトリガーを定義してください。例えば、持続的なクラッシュシグナル、レディネスチェックの失敗、破損した API フロー、または確認されたデータ整合性エラーなどです。アラートが発生したら、チャネルの展開を凍結し、アクティブなバンドル、ネイティブアプリのバージョン、チャネル、ロールアウト状態、影響を受けたコホート、エラーカテゴリ、タイムスタンプを記録してください。デプロイメント状態を変更する前に、この証拠を捕捉してください。
DORAによるデプロイとリカバリー指標のガイダンス ロールバックは、変更失敗のシグナルであり、同時にリカバリーイベントでもあります。リリース識別子とロールバック結果を保存し、検出から復旧までの時間、影響を受けたセッションまたはデバイス数、復旧後のエラー率を比較します。これらの指標により、復元されたbundleが失敗を解消したかどうかを確認できます。
インシデントは、記録に残る短いシーケンスとして進めます:
- トリガー: クラッシュ、レディネス、API、ビジネス、データの各シグナルでアラートを確認します。
- 凍結: チャネルの拡張を停止し、フルロールバックよりも影響を抑えられる場合はフィーチャーフラグを無効にします。
- 保全: ログ、トレース、バージョン履歴、適用状況、影響を受けたセグメントの詳細を保存します。
- ロールバック: Capacitor または Electron 向けの、最後に互換性のあった bundle を再デプロイし、ネイティブバージョンとの互換性も考慮します。
- 確認: 起動とクリティカルなフローをテストし、障害シグナルが減少していることを確認します。
- レビュー: 原因、見逃し、判断、ランブックの変更を記録します。
ロールバックの失敗自体がトリガーです。復元したバージョンがクラッシュする、起動できない、同じ API 障害を再現する場合は、以前の正常なチャネルまたは手動デプロイ経路にエスカレーションします。これを使用して Forge Reliability 根本原因ガイド 調査を構造化するために使用します。証拠が残っているうちにブレームレスなポストモーテムを実施し、各是正措置に担当者を割り当て、結果として得られるレディネスチェックまたはチャネルガードレールをリハーサルします。
ロールバック計画の例 7選 比較
| 戦略 | 実装の複雑さ 🔄 | リソース要件 💡 | 期待される成果 📊 / ⭐ | 最適なユースケース 💡 | 主な利点 ⭐ / ⚡ |
|---|---|---|---|---|---|
| クラッシュ検出時の自動ロールバック | 中程度 🔄🔄 | リアルタイム監視 + エラー追跡システム | 迅速な対応; MTTRの短縮 📊 ⭐⭐⭐⭐ | 高い安定性が求められる本番アプリ (フィンテック、ヘルスケア) | サイレントな自動保護; 高速な復旧 ⚡ ⭐ |
| バージョン履歴付きの差分更新ロールバック | 高 🔄🔄🔄 | バージョン保存、差分エンジン、状態管理 | 帯域幅効率の良い、正確なロールバック 📊 ⭐⭐⭐⭐ | 低速ネットワーク環境、大規模アセット、インディーチーム | ファイル単位の精度; ロールバックのダウンロードサイズが大幅に小型化 ⚡ ⭐ |
| 指標の劣化時に自動ロールバックを行う段階的ロールアウト | 非常に高い 🔄🔄🔄🔄 | 堅牢なメトリクス基盤、A/Bフレームワーク、ターゲティング | 影響範囲を縮小し、ビジネスメトリクスを保護 📊 ⭐⭐⭐⭐ | Eコマース、収益に直結する機能、大規模ユーザー基盤 | データドリブンな段階的展開。ビジネス影響を早期に検知 ⭐ 📊 |
| Feature Flagsによる設定のみのロールバック | 低い 🔄 | Feature Flag設定/構成デプロイ(再ビルド不要) | 機能の即時ロールバック。ユーザーへの影響を最小限に 📊 ⭐⭐⭐ | 機能のリグレッション、迅速な修正、小規模チーム | 最速のロールバック(数分以内)。アプリストア審査不要 ⚡ ⭐ |
| ユーザー同意と手動オーバーライドを伴うカナリアロールバック | 高 🔄🔄🔄 | カナリアターゲット、アプリ内UI、フィードバック収集 | 初期のエッジケース検出、定性的なインサイト 📊 ⭐⭐⭐ | エンタープライズベータプログラム、ユーザーフィードバック主導のリリース | ユーザーの主体性 + 直接フィードバック、より安全な初期テスト ⭐ 💡 |
| スキーマバージョニングによるデータベースマイグレーションのロールバック | 非常に高い 🔄🔄🔄🔄 | DBの専門知識、マイグレーションツール、ステージングデータ | データ整合性を維持、コンプライアンス対応のロールバック 📊 ⭐⭐⭐⭐ | 規制業界、EC、複雑なデータを扱うアプリ | 安全な双方向マイグレーション; 監査証跡と検証 ⭐ |
| インシデントベースのロールバックと可観測性、事後分析 | 非常に高い 🔄🔄🔄🔄 | 高度なオブザーバビリティ、インシデント管理、ストレージ | フォレンジック情報に基づく迅速な対応と組織学習 📊 ⭐⭐⭐⭐ | 信頼性とSREプラクティスを重視する大規模サービス | 自動ロールバック + blamelessポストモーテム向けの完全なフォレンジックデータ ⭐ 📊 |
これらのロールバック計画例をランブックに取り入れよう
すべてのインシデントに同じロールバック手法を選ぶべきではありません。まずは最も影響範囲の狭い安全なアクションから始めてください。データ整合性を保ったままフィーチャーフラグで障害が発生しているパスを無効化できるなら、まずそれを使います。リリース自体が不安定な場合は、チャネルの拡張を停止し、自動クラッシュゲートとレディネスゲートを備えたステージドチャネルの制御を使用してください。障害が共有のcode、設定、または互換性のないAPIに影響する場合は、最後に互換性のあったbundleをリストアし、ユーザーフロー全体を検証してください。
最も難しい判断はデータに関するものです。bundleのロールバックは、スキーママイグレーション、部分的な書き込み、サーバー側の挙動変更を元に戻すものではありません。そうしたインシデントでは、リスクの高い書き込みを停止し、データオーナーを巻き込み、以前のクライアントが自動的に安全だと決めつけずに、マイグレーションセーフな手順に従ってください。2012年のKnight Capitalの障害は、以前のバイナリをリストアするだけでは不十分な理由を示しています。サーバーに休眠状態のレガシー機能が残っており、再利用されたフラグがそれを有効化し、ロールバックを試みても問題の挙動が環境全体で有効なままだったのです。このインシデントにより、およそ 3億9700万件の誤った株式取引執行、想定ポジションは約 70億ドル、および当初報告された税引前損失は約 4億4,000万ドル、後に〜の近くに配置された 4億6,000万ドル より広範な報道では、この Knight Capitalのロールバック失敗に関する記録に記されている通り.
SpotifyのStormデプロイは、ステートフルなシステムにもう一つの有用な原則を示しています。2つの完全なトポロジーバージョンを利用可能に保ち、コンシューマーの位置を維持し、可逆的なアクティベーションを使うことで、オペレーターはストリームを失わずに以前のバージョンを復元できます。これは SpotifyのApache Stormデプロイ事例に詳述されています。同様の Capgo 設計では、以前の署名済みbundleを保持し、バージョン固有のヘルスゲートを維持し、古いリリースを削除する前に互換性を確認します。
これらの考え方を短い決定木にまとめると:
- 特定機能の障害: feature flagを無効化し、フォールバックを確認して調査する。
- リリースの不安定さ: チャネルをフリーズし、最後に互換性があったbundleを再デプロイして、復旧を監視します。
- セグメント固有の不確実性: プロモーションを停止し、canaryのフィードバックと手動オーバーライドを使用します。
- スキーマまたはデータリスク: codeを盲目的にロールバックしないでください。変更をフリーズし、マイグレーションまたはデータ復旧計画を実行します。
- 原因不明: まず証拠を確保し、影響範囲を限定してから、最も狭い範囲で可逆的なアクションを選択します。
今日、1つのプレイブックを選びましょう。トリガー、責任者、正確なロールバックコマンドまたはダッシュボード操作、検証手順、エスカレーション経路を記載します。次の本番リリース前に、stagingチャネルで実行してください。失敗したupdate、壊れたreadinessシグナル、設定の巻き戻し、互換性チェックを含めてください。ロールバックが事後に書かれた段落ではなく、実際に演習された操作である場合、チームはより速く復旧できます。
Capgo は CapacitorJS と Electron アプリに署名付きライブアップデートを提供し、ターゲットチャネル、バージョン履歴、デバイスごとのログ、採用率と失敗のメトリクス、差分配信、自動ロールバック保護を備えています。使用して Capgo アプリに合ったロールバック計画の例を、テスト済みのリリースと復旧ワークフローに変えるために。





