
Ein Rollback ist eine Recovery-Operation, die eine Software- oder Konfigurationsänderung rückgängig macht und einen früheren, bekannt funktionierenden Zustand wiederherstellt. In Kubernetes behält die Deployment-History standardmäßig 10 alte ReplicaSets, während PostgreSQL ROLLBACK verwirft die Änderungen der aktuellen Transaktion, nicht bereits committete Daten.
Ein Release geht live, die ersten Nutzer öffnen die App, und Support-Tickets trudeln ein, bevor das Produktteam mit Feiern fertig ist. Ein Checkout-Screen crasht, eine neue API-Antwort macht einen älteren Client unbrauchbar, oder eine Konfigurationsänderung schickt Requests auf den falschen Pfad. Das Team muss den Service wiederherstellen, ohne raten zu müssen, welche Dateien sich geändert haben, oder alle Nutzer zur Neuinstallation aufzufordern.
Dafür ist Rollback da. Es ist keine Prävention und kein magischer Undo-Button. Das neue Release wurde bereits angewendet. Rollback ist die kontrollierte Reaktion, wenn dieses Release Fehler, schlechtere Performance, Crashes oder unsicheres Verhalten verursacht. In der Praxis wird dabei meist die vorherige App-Version neu deployed oder eine versionierte Konfiguration wiederhergestellt, und dann geprüft, ob der Service wieder einen akzeptablen Zustand erreicht hat. Die Techniken zur Fehleranalyse dein Team danach nutzt, sind weiterhin entscheidend, denn Rollback stabilisiert den Vorfall, erklärt aber nicht seine Ursache.
Inhaltsverzeichnis
- Die Realität von Deployment-Fehlern
- Wie moderne Systeme die Release-Historie bewahren
- Die versteckte Gefahr bei Datenbank- und Daten-Rollbacks
- Die operative Entscheidung für ein Rollback
- Instant Recovery in Mobile- und Cross-Platform-Apps
- Eine resiliente Release-Strategie aufbauen
- Key Takeaways für sicherere Deployments
Die Realität von Deployment-Fehlern
Ein Mobile-Team veröffentlicht ein neues Bundle mit einer Navigationsänderung und einem Backend-Kompatibilitäts-Update. Das gestufte Publikum erhält es zuerst. Innerhalb weniger Minuten melden Nutzer, dass ein Hauptbildschirm nicht lädt. Das Monitoring zeigt steigende Fehler, aber das Team kann noch nicht sagen, ob das Problem vom Bundle, von API, einem Feature-Flag oder einer Abhängigkeit stammt.
Die sichere Reaktion besteht nicht darin, über die perfekte Diagnose zu debattieren, während das betroffene Publikum wächst. Wenn das Team ein bekanntes, funktionierendes Artefakt hat, kann es den Rollout stoppen und diese Version wiederherstellen. Die Anwendung kehrt in einen zuvor validierten Zustand zurück, während die Ingenieure den Defekt untersuchen und eine Korrektur vorbereiten.
Rollback ist Recovery, nicht Prävention
Prävention versucht, eine fehlerhafte Änderung zu stoppen, bevor sie die User erreicht. Tests, code Review, Dependency-Checks, Canary Releases und Approval Gates dienen diesem Zweck. Ein Rollback beginnt, nachdem die Prävention versagt hat oder eine unerwartete Interaktion in Produktion aufgetreten ist.
Ein Rollback kann verschiedene Teile des Delivery-Systems betreffen:
- Anwendungs-code: Das vorherige Executable oder Web Bundle erneut deployen.
- Konfiguration: Eine versionierte Einstellung, Routing-Regel oder Feature-Konfiguration wiederherstellen.
- Assets: Zurückkehren zu kompatiblen Images, Skripten oder Content-Dateien.
- Feature-Exposure: Deaktivieren Sie eine neue Funktion per Kill Switch oder Audience Control.
- Daten: Aktive Transaktion abbrechen oder Daten aus einem Backup wiederherstellen – unter deutlich strengeren Einschränkungen.
Die letzte Kategorie erfordert eine gesonderte Betrachtung. Das Revertieren von code ist oft unkompliziert, wenn Artefakte immutable sind und Abhängigkeiten kompatibel bleiben. Das Revertieren von committeten Daten kann zu Datenverlust, Korruption oder regulatorischen Problemen führen. Ein Release-Rollback sollte daher nicht implizieren, dass jede zugehörige Datenbankoperation sicher rückgängig gemacht werden kann.
Warum häufige Releases schnelle Recovery brauchen
Modernes Continuous Delivery führt zu häufigeren Releases. Daraus ergibt sich eine praktische Anforderung: Die operativen Kosten eines fehlgeschlagenen Changes müssen begrenzt bleiben. Ein Team, das schnell deployen kann, aber für die Recovery einen langen manuellen Prozess braucht, hat nur die Hälfte des Delivery-Prozesses optimiert.
Manuelles Zurückrollen bleibt möglich, hängt aber davon ab, dass Operatoren sich merken, welche Dateien geändert wurden, welche Server aktualisiert wurden und welche Konfiguration zum vorherigen Release gehörte. Dieser Prozess wird während eines Incidents fragil. Automatisierte Systeme verbessern den Weg, indem sie immutable Artefakte vorhalten, Health Signals überwachen und zurückrollen, sobald definierte Bedingungen erfüllt sind.
Praktische Regel: Betrachten Sie Rollback als eingeübte Production-Capability, nicht als Notfallknopf, den man erst während des Ausfalls bedienen lernt.
Ein Rollback ist außerdem keine dauerhafte Lösung. Er stellt den Service vorübergehend wieder her, der zugrunde liegende Fehler bleibt aber bestehen. Entwickler müssen weiterhin den Auslöser identifizieren, alle während des fehlgeschlagenen Releases geschriebenen Daten prüfen und eine korrigierte Version ausliefern oder eine andere bewusste Betriebsentscheidung treffen.
Wie moderne Systeme die Release-Historie bewahren
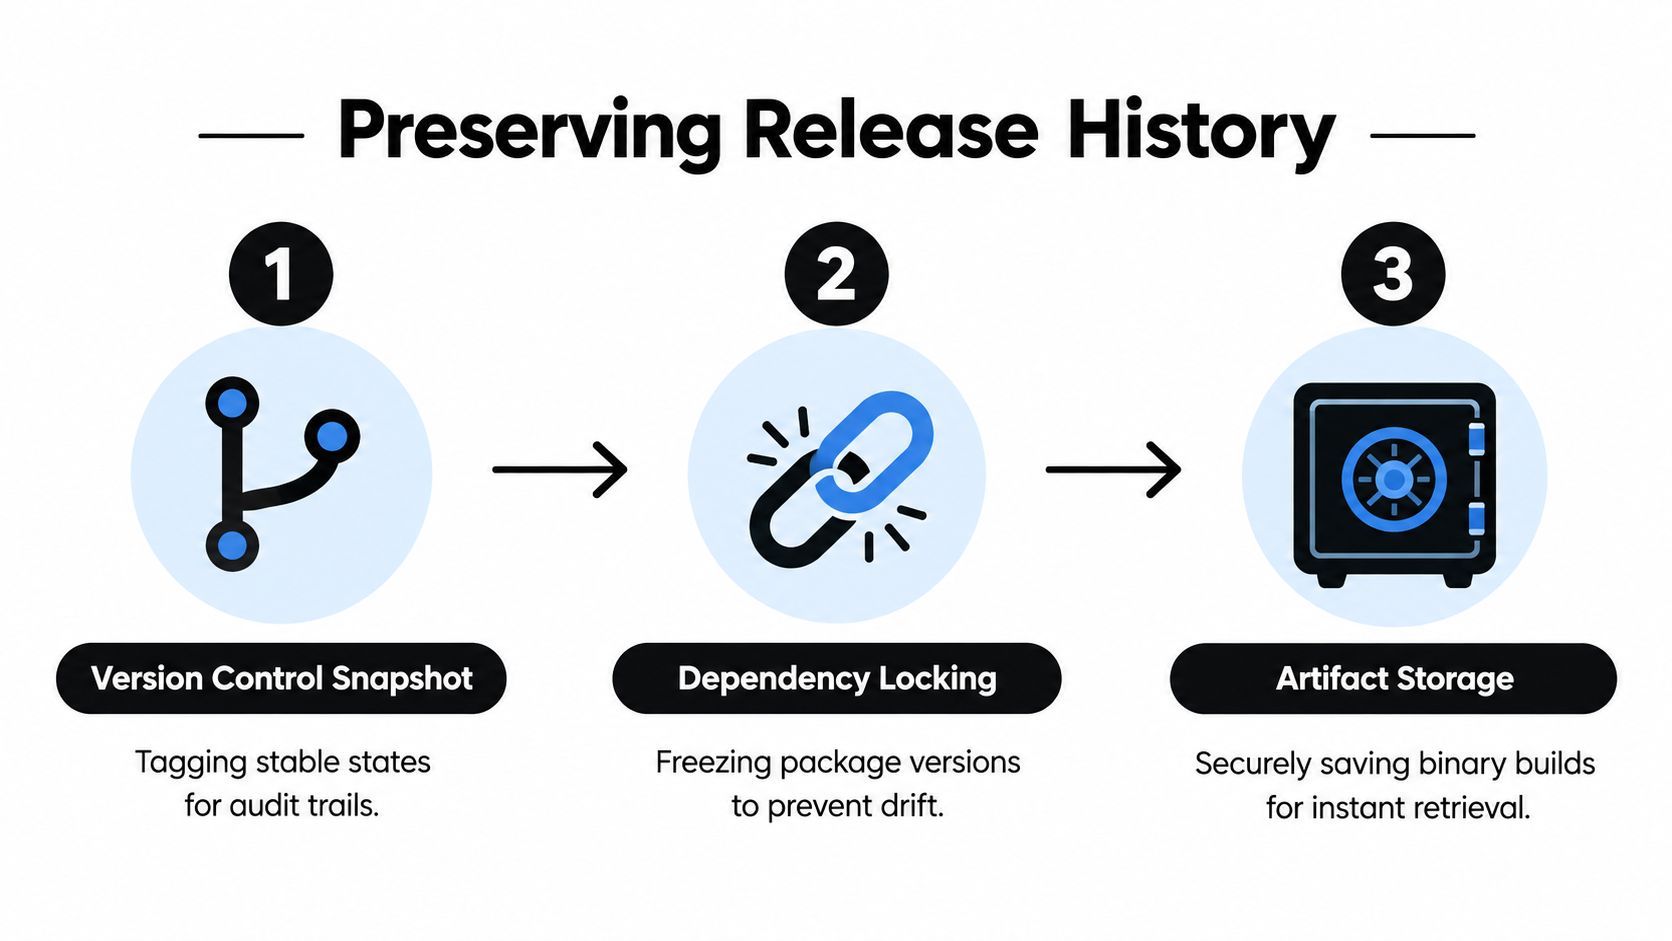
Ein Recovery-System kann nur das wiederherstellen, was es identifizieren und abrufen kann. Einen alten Source-Commit aufzubewahren reicht nicht, wenn der Build mit driftenden Dependencies erstellt wurde, das Binary überschrieben wurde oder die native Shell das Bundle nicht mehr unterstützt.
Moderne Release-Systeme lösen dies, indem sie eine Beweiskette von der Source bis zum deployten Artefakt bewahren. Das Team taggt eine stabile Revision, sperrt den Dependency-Graph, baut ein adressierbares Artefakt und hält fest, welches Artefakt welche Umgebung erreicht hat. Diese Aufzeichnung gibt Betreibern ein konkretes Ziel, statt einer vagen Anweisung wie „zur vorherigen Version zurückzugehen“.
Kubernetes als konkretes Modell
Kubernetes veranschaulicht die Struktur deutlich. Ein Deployment steuert ReplicaSets, und diese ReplicaSets bewahren die Deployment-Revisionen. Kubernetes behält standardmäßig 10 alte ReplicaSets, und Teams können diese Aufbewahrung mit spec.revisionHistoryLimitändern. Das Setzen des Wertes auf 0 deaktiviert den Rollback vollständig, wie dokumentiert in der Kubernetes Deployment Referenz.
Ein Operator kann zur unmittelbar vorherigen Revision zurückkehren oder eine bestimmte historische Revision auswählen. Der Rollback ändert die Pod-Template-Konfiguration der Deployment, einschließlich Felder wie das Container-Image und Labels. Er kehrt nicht automatisch unverwandte Felder wie die Replikatenanzahl um. Anschließend bestätigen Rollout-Status-Prüfungen, ob die Ziel-Revision gesund ist.
Diese Unterscheidung ist für die Auslieferung von Mobile- und Web-Bundles entscheidend. Ein System sollte erfassen:
- Die aktive Version: Welche Release welche Umgebung, welcher Channel oder welches Gerät erhalten hat.
- Die Identität des Artefakts: Ein content-addressable oder anderweitig unveränderliches Build, keine Datei, die an Ort und Stelle ersetzt werden kann.
- Abwärtskompatibilität der Abhängigkeiten: Ob das vorherige Bundle mit der aktuellen nativen Shell, APIs, Diensten und dem Daten-Schema funktioniert.
- Das Ergebnis der Wiederherstellung: Ob Geräte oder Instanzen die wiederhergestellte Release erfolgreich übernommen haben.
„Previous“ muss ein bestimmtes Artefakt meinen
Ein Label wie etwa previous ist nur sinnvoll, wenn es auf ein unveränderliches Release verweist. Wenn ein Team die Datei hinter diesem Label überschreibt, kann sich das Wiederherstellungsziel ändern, ohne dass es jemand merkt. Wenn das Artefakt im Storage abgelaufen ist, kennt das Deployment-System möglicherweise die Revisionsnummer, hat aber nicht die nötigen Bytes, um es wiederherzustellen.
Bei einer Capacitor App läuft das Web-Bundle auch in einer nativen Shell. Ein früheres JavaScript-Bundle kann von nativen Plugins, Berechtigungen oder Bridge-Verhalten abhängen, die die aktuelle Shell geändert hat. Eine Wiederherstellung ohne Kompatibilitätsprüfung kann einen Incident durch einen anderen ersetzen.
Der Der Capgo-Ansatz für Versionskontrolle und Rollbacks spiegelt ein übergeordnetes Prinzip wider: Die Release-Historie muss explizit, abrufbar und mit der Zielgruppe verknüpft sein, die den jeweiligen Build erhalten hat. Ein Rollback gelingt, wenn das Team drei Fragen schnell beantworten kann: Was war aktiv, was war stabil und was kann jetzt sicher mit dem umgebenden System laufen?
Die versteckte Gefahr bei Datenbank- und Daten-Rollbacks
Ein fehlgeschlagenes Deployment kann dem Team die dringende Anweisung hinterlassen: „Einfach die vorherige Version wiederherstellen.“ Das mag für ausführbares code funktionieren. Bei einer Datenbank kann das unsicher sein, denn bereits committete Kundenaktivität lässt sich möglicherweise nicht sauber rückgängig machen.
Anwendungs-Rollback und Daten-Rollback sind unterschiedliche Vorgänge mit unterschiedlichen Fehlermodi. Ein code-Release lässt sich oft durch ein anderes unveränderliches Artefakt ersetzen. Eine Schema-Migration kann ein Feld umbenannt oder entfernt, gespeicherte Werte transformiert oder die Annahmen späterer Schreibvorgänge geändert haben. Bestellungen, Zahlungen, Nachrichten, Datensätze und Einwilligungen sind gültige Nutzerdaten. Sie sollten nicht verschwinden, nur weil ein App-Release fehlgeschlagen ist.
Warum code und Schema auseinanderlaufen können
Angenommen, Release A versteht das alte Schema, während Release B eine Spalte hinzufügt oder ändert, wie ein Wert gespeichert wird. Nachdem B deployed wurde und seine Migration gelaufen ist, kann ein Restore von A dazu führen, dass die ältere code-Query Felder abfragt, die es nicht mehr gibt, oder neue Daten falsch interpretiert.
Der umgekehrte Fall erzeugt einen anderen Fehler. Ein Datenbank-Rollback, während Release-B-Prozesse noch aktiv sind, kann Schreibvorgänge fehlschlagen lassen oder einen partiellen Zustand hinterlassen. Ein Rollback sowohl von code als auch der Datenbank wirkt zwar sauberer, kann aber legitime Aktivität löschen, die nach dem Deployment entstanden ist. Die Unterschied zwischen Application- und Data-Rollback gehört in jeden Release-Plan, nicht nur in Datenbankoperationen.
PostgreSQL zeigt, was ein transaktionaler Rollback bewirkt. ROLLBACK bricht die aktuelle Transaktion ab und verwirft alle innerhalb dieser Transaktion gemachten Updates, damit eine teilweise angewendete Gruppe von Schreibvorgängen nicht dauerhaft wird. Er kann keine Änderungen rückgängig machen, die eine frühere Transaktion bereits committed hat. Das Ausführen von ROLLBACK außerhalb eines Transaktionsblocks macht gespeicherte Daten nicht rückgängig.
Migrationen vorwärtsgerichtet gestalten
Ein sicheres Release-Design stellt sicher, dass App-Versionen und Schema-Änderungen während des Übergangs kompatibel bleiben. Teams sollten zudem SQLite-Verschlüsselungspraktiken für Capacitor Apps neben Schema-Kompatibilität, Zugriffskontrollen und Recovery-Verfahren dokumentieren.
Eine Expand-and-Contract-Migration folgt üblicherweise dieser Reihenfolge:
- Erweitern: Füge die neue Schema-Funktion hinzu, ohne die alte zu entfernen.
- Übernehmen: Deploy code, das beide Repräsentationen lesen und schreiben kann, oder führe den neuen Pfad ein, während der alte erhalten bleibt.
- Migrieren: Verschiebe bestehende Datensätze durch einen kontrollierten Prozess mit Monitoring und Abgleich.
- Reduzieren: Entferne die alte Struktur erst, wenn abhängige Versionen sie nicht mehr benötigen.
Diese Abfolge macht einen code Rollback plausibler, da die ältere Anwendung weiterhin ein Schema nutzen kann, das ihren Vertrag unterstützt. Das macht nicht jeden Rollback sicher. Es senkt die Wahrscheinlichkeit, dass die Wiederherstellung eine neue Inkompatibilität einführt.
Fintech-, Healthcare- und E-Commerce-Systeme benötigen zudem Auditierbarkeit, Datenschutzkontrollen, die Behandlung von Zahlungsstatus und einen Reconciliationsplan. Ein Forward-Fix kann sicherer sein als das Rückgängigmachen gültiger Transaktionen oder das Wiederherstellen eines Snapshots, der spätere Nutzeraktivitäten entfernt.
Datenbankregel: Führe einen code Rollback nur dann frei durch, wenn seine Abhängigkeiten und der Datenvertrag diese Aktion unterstützen. Behandle committe Daten als vorwärtsgerichtete Aufzeichnung, es sei denn, ein separates, getestetes Wiederherstellungsverfahren beweist das Gegenteil.
Klassifiziere vor der Deployment jedes Release-Element nach seiner Rückholbarkeit. Code, Konfiguration, Feature-Exposure, Assets, Schema und Nutzerdaten unterliegen verschiedenen Wiederherstellungsregeln. Ein getestetes Backup kann nach katastrophaler Korruption helfen, aber die Wiederherstellung eines Backups ersetzt kein rückwärtskompatibles Migrationsdesign.
Die operative Entscheidung für ein Rollback
Rollback ist eine operative Entscheidung, nicht nur ein Deployment-Befehl. Jemand muss entscheiden, ob das beobachtete Problem vom Release stammt, ob der vorherige Zustand sicher ist, ob genug Nutzer betroffen sind, um eine Rücknahme zu rechtfertigen, und ob ein Forward-Fix das Risiko effektiver reduziert.
DORA betrachtet die Change-Failure-Rate als Deployments, die sofortiges Eingreifen erfordern – oft ein Rollback oder Hotfix – und trackt separat die Wiederherstellungszeit nach fehlgeschlagenen Deployments. Das macht ein Rollback sowohl zu einem Zuverlässigkeitsereignis als auch zu einem Ergebnis der Delivery-Performance, wie in der Historie der DORA-Metriken beschrieben wird..
Trigger vor dem Incident definieren
Gute Teams legen Rollback-Bedingungen fest, während das Release noch geplant wird. Ein Trigger könnte Crash-Signale, Error-Rates, fehlgeschlagene Health Checks, Support-Meldungen oder einen Canary-Vergleich kombinieren. Ein einzelnes verrauschtes Ereignis sollte nicht zwangsläufig ein Release rückgängig machen, aber ein klares Muster bei einer überwachten Nutzergruppe sollte eine definierte Reaktion auslösen.
Ein automatisches Rollback ist nur dann sinnvoll, wenn der Fehler gut verstanden, reversibel und durch zuverlässige Signale beobachtbar ist. Ein automatisiertes System, das auf jede Anomalie reagiert, kann einen Vorfall verschlimmern, indem es zwischen Versionen hin- und herspringt, den eigentlichen Fehler verschleiert oder wiederholt inkompatible Dependencies einführt.
Bei einer mobilen App braucht die Entscheidung zusätzlichen Kontext:
- Offline-Nutzer: Einige Geräte prüfen Updates nicht sofort.
- Gemischte Versionen: Alte und neue Clients können lange koexistieren.
- Stufenweise Freigabe: Ein Channel oder Canary kann ein Problem aufdecken, bevor es in der Produktion auftritt.
- Native-Kompatibilität: Ein wiederhergestelltes Web-Bundle muss mit der installierten Shell funktionieren.
- Datenauswirkungen: Ein code-Rollback kann bereits vom Backend akzeptierte Schreibvorgänge nicht rückgängig machen.
Rollback vs. Roll-forward
Ein Rollback stellt einen früheren Zustand wieder her. Ein Roll-forward liefert eine Korrektur. Keines von beiden ist universell sicherer.
Ein Rollback eignet sich meist für reversible Darstellungsfehler, eine fehlerhafte Konfiguration oder ein Release, das scheitert, bevor es persistenten State ändert. Roll-forward kann sicherer sein, wenn die Migration bereits gelaufen ist, User valide Datensätze erstellt haben oder die frühere App-Version das aktuelle Schema nicht unterstützt. Ein Kill Switch kann noch sicherer sein, wenn das fehlerhafte Feature isoliert werden kann, ohne das gesamte Release zu ersetzen.
Das Runbook sollte den Incident Commander benennen, die Person, die die Aktion ausführen darf, die Health Signals, die den Erfolg bestätigen, sowie den Kommunikationsweg für Produkt und Support. Außerdem sollte es festhalten, wann das Team aufhört, einen Revert zu versuchen, und zum Fix-forward übergeht.
Ein hilfreiches Runbook hält fest:
- Die Zielrevision und deren Artefakt-Speicherort.
- Die Kompatibilitätschecks für native Clients, Services, Dependencies und Schema.
- Die Blast-Radius-Kontrolle, wie etwa ein Channel, eine Kohorte oder ein Canary.
- Die Erfolgskriterien, einschließlich Recovery-Signalen und User-Impact.
- Der Follow-up-Owner, verantwortlich für das korrigierte Release und die Incident-Review.
Der Unterschied zwischen dem Pausieren eines Rollouts und einem Rollback ist operativ entscheidend. Eine Pause begrenzt die weitere Exposition. Ein Rollback ändert aktiv, was betroffene User erhalten. Teams sollten wissen, welche Aktion sie brauchen, bevor sie sich für eine der beiden entscheiden.
Instant Recovery in Mobile- und Cross-Platform-Apps
Die traditionelle Recovery bei Mobile-Releases hängt von der App-Store-Distribution ab. Liegt der Defekt in der nativen Binary, muss das Team eine korrigierte oder vorherige Binary vorbereiten, beim jeweiligen Store einreichen und warten, bis die Distribution die User erreicht. Das kann bei nativen Änderungen angemessen sein, erzeugt aber Reibung, wenn der Defekt nur in JavaScript, CSS, Konfiguration, Copy oder Web-Assets liegt.
Over-the-Air-Auslieferung verändert den Recovery-Pfad für Änderungen in der Web-Layer. Ein live update-System kann ein signiertes Bundle an eine kontrollierte Zielgruppe ausliefern, Geräte es beim nächsten Start oder Update-Check anwenden lassen und das vorherige Bundle als Fallback behalten. Es ersetzt keinen Store-Review, wenn sich native code oder Plattform-Berechtigungen ändern, und macht einen Daten-Rollback nicht sicher.
Store-Distribution und Live Updates lösen unterschiedliche Probleme
| Recovery-Bedarf | Binary-Release über den Store | Signiertes live update |
|---|---|---|
| Native Plugin- oder Berechtigungsänderung | Angemessen | Not a replacement |
| JavaScript- oder CSS-Fehler | Langsamerer Recovery-Pfad | Geeignet, wenn Richtlinien und Kompatibilität es zulassen |
| Zielgruppensteuerung | Channels und Rollout-Steuerung speichern | Gezielte Channels und gestaffelte Auslieferung |
| Recovery-Ziel | Veröffentlichtes Binary | Versioniertes Web-Bundle |
| Hauptabhängigkeit | Store-Distribution | Updater, Signing, Kompatibilität und Observability |
Eine Plattform wie Capgo unterstützt Capacitor Live Updates, indem signierte Web-Bundles an gezielte Channels ausgeliefert werden, die Versionshistorie beibehalten wird, Updates beim nächsten Launch oder Update-Check angewendet werden und ein Rollback-Schutz greift, wenn ein neues Bundle die konfigurierten Health Checks nicht besteht. Durch Differential Delivery werden nur geänderte Dateien gesendet, während Channels Beta-, Staging-, Production- oder kundenspezifische Zielgruppen trennen können. Diese Funktionen helfen Teams, die Auswirkungen eines fehlgeschlagenen Web-Layer-Releases zu begrenzen, machen jedoch die Prüfung der Kompatibilität mit der Native Shell oder den Backend-Datenverträgen nicht überflüssig.
Automatischer Fallback braucht ein verlässliches Health-Signal
Ein Updater sollte ein Bundle nicht allein deshalb als gesund markieren, weil der Download abgeschlossen wurde. Er sollte zwischen Abruf, Installation, Start und dem tatsächlichen Zustand der App unterscheiden. Wenn das neue Bundle abstürzt oder beim nächsten Start die Health Checks nicht besteht, kann das Gerät zur letzten stabilen Version zurückkehren, ohne ein komplettes App-Store-Binary herunterladen zu müssen.
Diese Wiederherstellung hat dennoch Grenzen. Ein Gerät kann offline sein, das fehlgeschlagene Update hat eventuell bereits serverseitige Daten geändert, oder das vorherige Bundle ist nicht mit der installierten Native Shell kompatibel. Logs pro Gerät und Daten zur Versionsadoption helfen dem Support zu bestimmen, welche Nutzer welches Bundle erhalten haben und ob der Fallback funktioniert hat.
Der Capacitor Leitfaden zur Rollback-Konfiguration von Updates Dies sollte neben einer Release-Policy stehen, nicht sie ersetzen. Signiere jedes Artefakt, schränke ein, wer in Production-Channels veröffentlichen darf, behalte die Fallback-Version bei und teste den Fehlerpfad auf echten Geräten. Schnelle Distribution ist nur dann wertvoll, wenn das System beweisen kann, dass das wiederhergestellte Bundle auch das beabsichtigte ist.
Eine resiliente Release-Strategie aufbauen
Rollback-Readiness ist eine Eigenschaft des gesamten Release-Systems. Ein alter Build im Object Storage bietet keinen echten Schutz, wenn das Team dessen Abhängigkeiten nicht identifizieren kann, nicht sieht, welche Geräte ihn übernommen haben, oder die Wiederherstellung nie mit produktionsnahen Daten getestet hat.
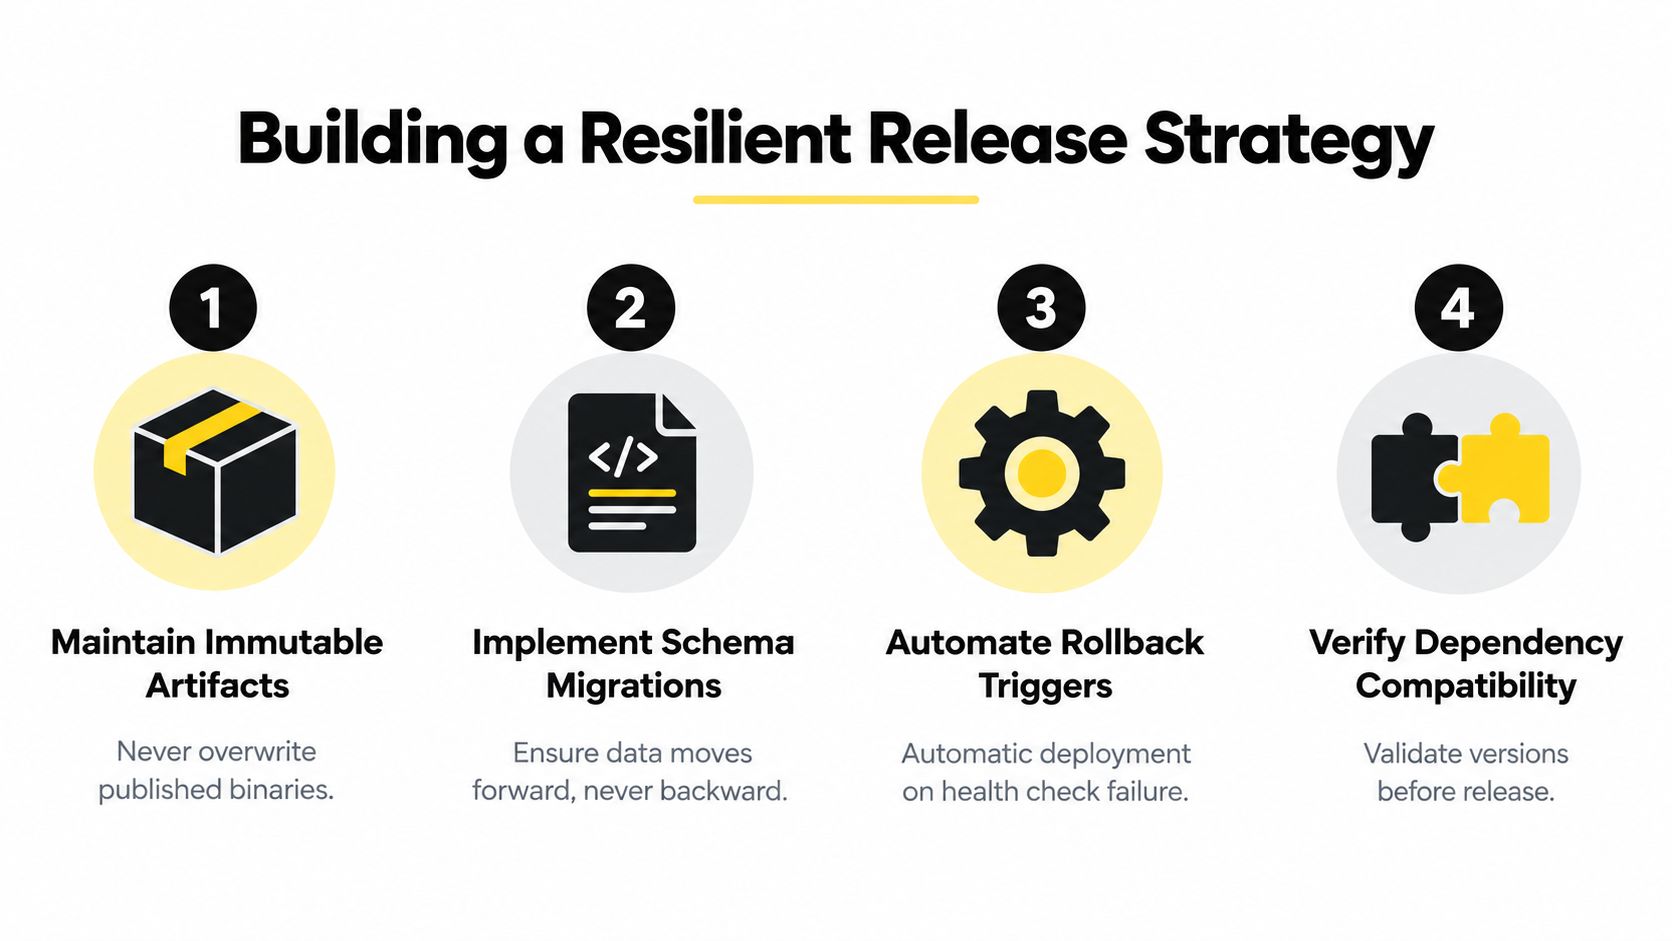
Beginnen Sie mit der Artefaktkette. Taggen Sie stabile Quellzustände, locken Sie Abhängigkeiten, bewahren Sie signierte Builds auf und überschreiben Sie niemals ein veröffentlichtes Release. Verknüpfen Sie dann jedes Artefakt mit einer Umgebung, einem Channel und einem Deployment-Event. Das Team sollte rekonstruieren können, was passiert ist, ohne auf den lokalen Rechner eines Entwicklers angewiesen zu sein.
Vier Kontrollen, die das Recovery-Risiko senken
- Immutable Artefakte: Speichern Sie jedes Produktions-Bundle unter einer eindeutigen Identität. Ein „previous“-Zeiger kann ein Release auswählen, darf das Release selbst aber nicht verändern.
- Kompatible Migrationen: Verwenden Sie Expand-and-Contract-Techniken, damit ältere und neuere App-Versionen während eines kontrollierten Übergangs koexistieren können.
- Abgesicherte Automatisierung: Automatisieren Sie den Fallback nur bei Signalen, die einen echten Release-Fehler von einem vorübergehenden Service-Problem unterscheiden.
- Abhängigkeitsvalidierung: Prüfen Sie die native Shell, Plugins, APIs, Services und das Schema, bevor eine Zielrevision aktiv wird.
Observability schließt den Kreis. Erfassen Sie die Version pro Gerät, das Launch-Ergebnis, den Update-Status, den Fehlergrund und den Adoptionsstatus. So kann der Support beantworten, ob ein Nutzer noch auf dem fehlerhaften Bundle ist, den Fallback bereits erhalten hat oder das Update nie heruntergeladen hat.
Teams sollten den Recovery-Pfad mit realistischen Daten und gemischten Client-Versionen durchspielen. Ein Test, der code gegen eine leere Entwicklungsdatenbank wiederherstellt, kann die Inkompatibilität übersehen, die durch echte Datensätze, alte Schema-Varianten, queued writes und teilweise abgeschlossene Migrationen entsteht. Der Wiederherstellungstest sollte außerdem Autorisierung, Signierung, Artefaktabruf, Channel-Targeting und den Kommunikationsplan prüfen.
Wiederherstellung misst sich nicht am Vorhandensein eines alten Builds. Sie misst sich daran, wie präzise das Team die Auswirkungen kontrollieren und einen kompatiblen Zustand wiederherstellen kann.
Die Release-Planung sollte eine explizite Zuständigkeit für die Koordination von Abhängigkeiten umfassen. Teams, die ein breiteres Framework für das Management von Abhängigkeiten in agilen Prozessen benötigen, können diese Planungsdisziplin nutzen, um Mobile-, Backend-, Datenbank- und Produktänderungen vor dem Deployment abzustimmen.
Ein praktischer Readiness-Check fragt:
- Kann das Team das exakte Artefakt identifizieren, das auf jedem Channel aktiv ist?
- Kann es die Auslieferung pausieren, ohne bereits installierte code zu verändern?
- Kann es ein signiertes, kompatibles Bundle wiederherstellen?
- Kann es nachweisen, dass die Datenbank nach einem App-Rollback sicher bleibt?
- Kann es Fehler pro Version erkennen, statt nur auf aggregierter Service-Ebene?
- Kann es Roll-forward wählen, wenn eine Rückabwicklung gültige Daten beschädigen würde?
Ist eine Antwort unklar, hat der Release-Prozess eine Lücke beim Recovery. Diese Lücke vor dem nächsten Vorfall zu schließen ist günstiger, als zu improvisieren, während Nutzer warten.
Key Takeaways für sicherere Deployments
Ein Rollback kehrt eine angewendete Software- oder Konfigurationsänderung um, um einen bekannt guten Zustand wiederherzustellen. Er verhindert keine Fehler, behebt nicht die eigentliche Ursache und macht committete Datenbankänderungen nicht automatisch rückgängig.
Halte Anwendungsartefakte unveränderlich und adressierbar. Verfolge die aktive Version, Abhängigkeiten, Native-Shell-Kompatibilität und Zielgruppe für jeden Release. Behandle Schema-Migrationen und Nutzerdaten als separate Recovery-Ziele, da ein code-Rollback die Datenbank geändert zurücklassen kann und ein Datenbank-Rollback gültige Datensätze zerstören kann.
Nutze gestaffelte Auslieferung, zuverlässige Health-Signale, explizite Autorisierung und ein getestetes Runbook. Für Mobile-Teams können signierte Over-the-Air-Bundles eine schnelle Wiederherstellung für kompatible Web-Layer-Änderungen bieten, während native Änderungen weiterhin den passenden Binary-Release-Pfad erfordern. Messe Recovery am reduzierten Blast Radius und der verifizierten Dienstwiederherstellung, nicht am Vorhandensein eines alten Builds.
Capgo bietet Capacitor- und Electron-Teams signierte Live-Update-Bundles, gezielte Kanäle, Versionshistorie, Observability pro Gerät und Rollback-Schutz für kompatible Web-Layer-Releases. Prüfe deinen aktuellen Recovery-Pfad und sieh, wie Capgo kann helfen, die Auslieferung zu pausieren, ein stabiles Bundle wiederherzustellen und die Incident-Response unter Kontrolle zu halten.





