
Rollback adalah operasi pemulihan yang membatalkan perubahan perangkat lunak atau konfigurasi dan mengembalikan kondisi known-good sebelumnya. Di Kubernetes, riwayat deployment menyimpan 10 ReplicaSet lama secara default, sedangkan PostgreSQL ROLLBACK membuang pembaruan dari transaksi saat ini, bukan data yang sudah di-commit sebelumnya.
Sebuah rilis live, pengguna pertama membuka aplikasi, dan tiket support masuk sebelum tim produk selesai merayakan. Layar checkout crash, respons API baru merusak klien lama, atau perubahan konfigurasi mengarahkan request ke jalur yang salah. Tim perlu memulihkan layanan tanpa menebak file mana yang berubah atau meminta semua pengguna menginstal ulang.
Itulah fungsi rollback. Bukan pencegahan, dan bukan tombol undo ajaib. Rilis baru sudah diterapkan. Rollback adalah respons terkontrol saat rilis itu menyebabkan error, penurunan performa, crash, atau perilaku tidak aman. Dalam praktiknya, biasanya ini men-deploy ulang versi aplikasi sebelumnya atau memulihkan konfigurasi ber-versi, lalu memverifikasi bahwa layanan kembali ke kondisi yang dapat diterima. teknik analisis kegagalan yang tim Anda gunakan setelahnya tetap penting, karena rollback menstabilkan insiden tetapi tidak menjelaskan penyebabnya.
Table of Contents
- Realita Kegagalan Deployment
- Cara Sistem Modern Menjaga Riwayat Release
- Bahaya Tersembunyi dari Pembalikan Database dan Data
- Mengambil Keputusan Operasional untuk Revert
- Pemulihan Instan di Aplikasi Mobile dan Cross-Platform
- Membangun Strategi Release yang Tangguh
- Poin Penting untuk Deployment yang Lebih Aman
Realita Kegagalan Deployment
Tim mobile merilis bundle baru berisi perubahan navigasi dan pembaruan kompatibilitas backend. Audiens bertahap menerimanya lebih dulu. Dalam hitungan menit, pengguna melaporkan layar utama tidak bisa dimuat. Monitoring menunjukkan error yang meningkat, tapi tim belum bisa memastikan apakah masalahnya dari bundle, API, feature flag, atau dependensi.
Respons yang aman bukan berdebat soal diagnosis sempurna sementara audiens terdampak makin bertambah. Jika tim punya artefak yang diketahui baik, mereka bisa menghentikan rollout dan memulihkan versi itu. Aplikasi kembali ke kondisi yang sudah tervalidasi sementara engineer menyelidiki cacat dan menyiapkan perbaikan.
Rollback adalah pemulihan, bukan pencegahan
Pencegahan berupaya menghentikan perubahan buruk sebelum sampai ke pengguna. Tes, review code, pemeriksaan dependensi, rilis canary, dan approval gate menjalankan fungsi itu. Rollback dimulai setelah pencegahan gagal atau setelah interaksi tak terduga muncul di produksi.
Rollback bisa menyasar beberapa bagian dari sistem pengiriman:
- Aplikasi code: Deploy ulang executable atau web bundle sebelumnya.
- Konfigurasi: Pulihkan pengaturan ber-versi, aturan routing, atau konfigurasi fitur.
- Aset: Kembali ke gambar, skrip, atau file konten yang kompatibel.
- Eksposur fitur: Nonaktifkan kemampuan baru melalui kill switch atau kontrol audiens.
- Data: Batalkan transaksi aktif atau pulihkan data dari backup, dengan batasan yang jauh lebih ketat.
Kategori terakhir memerlukan penanganan terpisah. Mengembalikan aplikasi code sering kali mudah jika artifact bersifat immutable dan dependensi tetap kompatibel. Mengembalikan data yang sudah di-commit dapat menyebabkan kehilangan, korupsi, atau masalah regulasi. Oleh karena itu, rollback rilis tidak boleh mengasumsikan bahwa setiap operasi database terkait dapat dengan aman mundur.
Mengapa frequent delivery butuh pemulihan cepat
Continuous delivery modern membuat rilis lebih sering. Hal ini menciptakan kebutuhan praktis: biaya operasional dari perubahan yang gagal harus tetap terbatas. Tim yang bisa deploy cepat tetapi membutuhkan proses manual yang panjang untuk pulih hanya mengoptimalkan setengah dari delivery.
Reversal manual masih mungkin, tetapi bergantung pada operator mengingat file mana yang berubah, server mana yang diperbarui, dan konfigurasi mana yang milik rilis sebelumnya. Proses ini menjadi rapuh selama insiden. Sistem otomatis meningkatkan jalur dengan mempertahankan artefak immutable, memantau sinyal kesehatan, dan melakukan revert ketika kondisi yang ditentukan sebelumnya terpenuhi.
Aturan praktis: Anggap rollback sebagai kemampuan produksi yang sudah dilatih, bukan sebagai tombol darurat yang akan difikirkan seseorang saat outage.
Rollback juga bukan solusi permanen. Ini memulihkan layanan untuk sementara, tetapi defect yang mendasarinya tetap ada. Engineer tetap harus mengidentifikasi pemicunya, menilai data yang ditulis selama release gagal, dan merilis versi yang diperbaiki atau mengambil keputusan operasional lain yang disengaja.
Cara Sistem Modern Menjaga Riwayat Release
Sistem recovery hanya bisa memulihkan apa yang bisa diidentifikasi dan diambil kembali. Menyimpan commit source lama saja tidak cukup jika build dibuat dengan dependency yang berubah, binary tertimpa, atau native shell tidak lagi mendukung bundle tersebut.
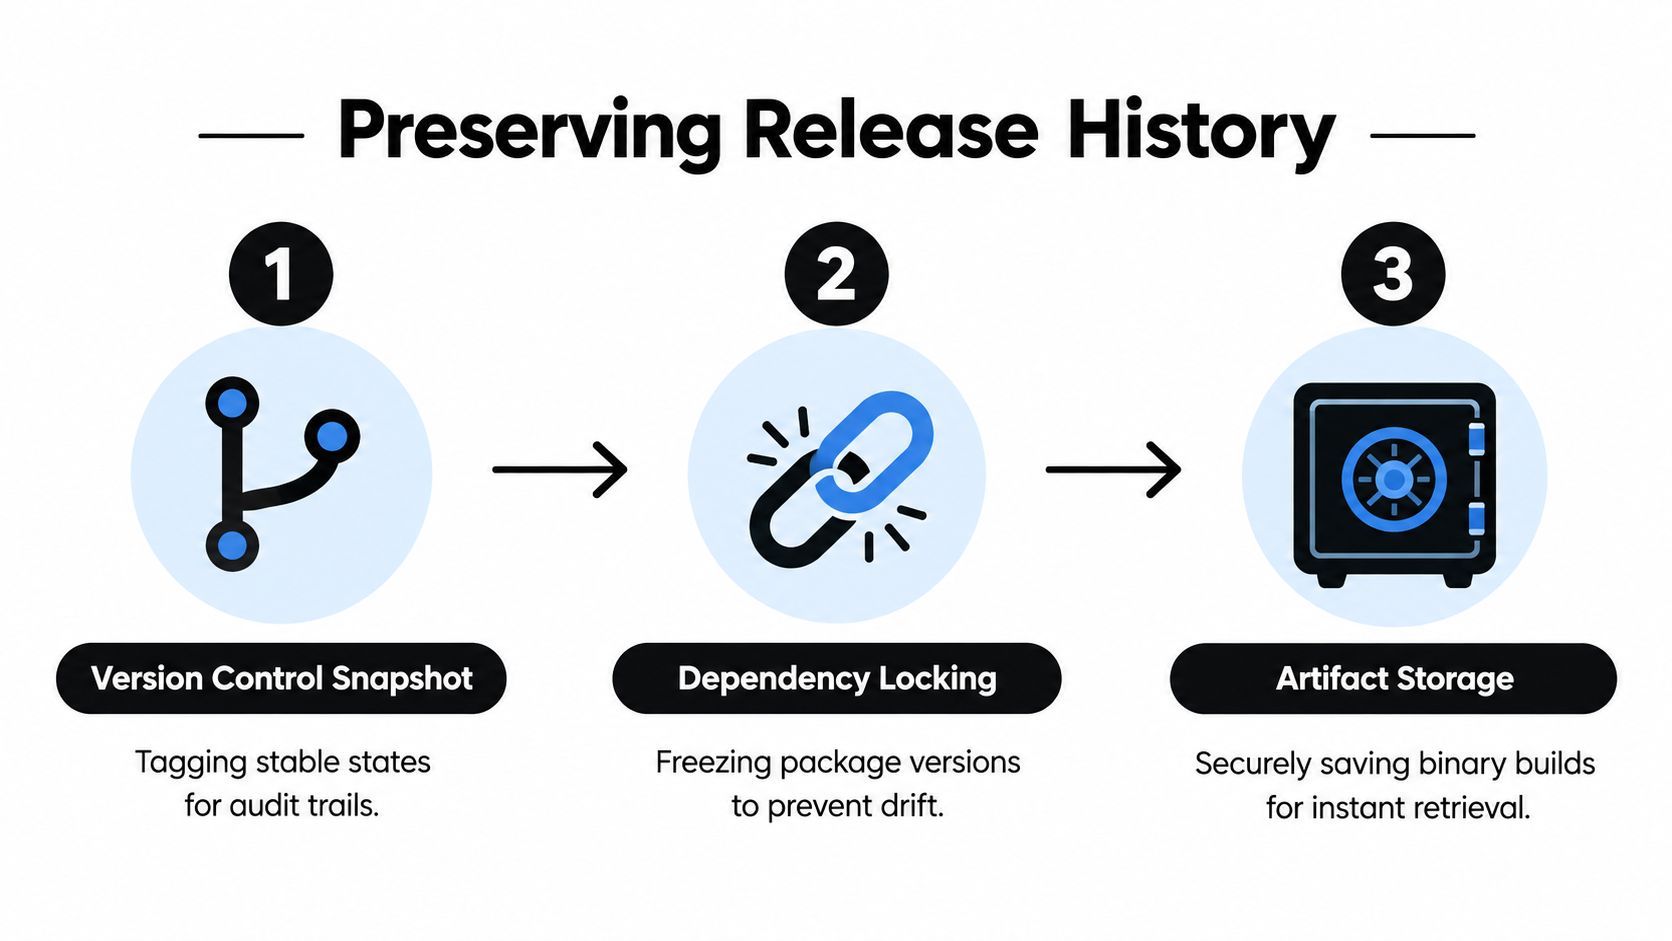
Sistem release modern mengatasi hal ini dengan menjaga rantai bukti dari source hingga artifact yang dideploy. Tim menandai revisi yang stabil, mengunci dependency graph, membuat artifact yang dapat dialamatkan, dan mencatat artifact mana yang mencapai setiap environment. Catatan tersebut memberi operator target yang spesifik, bukan instruksi ambigu seperti “kembali ke versi sebelumnya.”
Kubernetes sebagai model konkret
Kubernetes menggambarkan strukturnya dengan jelas. Deployment mengontrol ReplicaSet, dan ReplicaSet tersebut mempertahankan revisi deployment. Kubernetes menyimpan 10 ReplicaSet lama secara default, dan tim dapat mengubah retensi tersebut dengan spec.revisionHistoryLimit. Mengatur nilainya ke 0 menonaktifkan rollback sepenuhnya, sebagaimana didokumentasikan dalam Referensi Deployment Kubernetes.
Operator dapat kembali ke revisi tepat sebelumnya atau memilih revisi historis tertentu. Rollback mengubah konfigurasi template Pod pada Deployment, termasuk field seperti container image dan label. Rollback tidak otomatis membalikkan field yang tidak terkait seperti replica count. Setelah itu, pemeriksaan status rollout memastikan apakah revisi target sudah healthy.
Perbedaan ini penting untuk pengiriman mobile dan web-bundle. Sistem harus mencatat:
- The active version: Release mana yang diterima tiap environment, channel, atau device.
- Identitas artifact: Build yang bersifat content-addressable atau immutable, bukan file yang bisa diganti di tempat.
- Kompatibilitas dependensi: Apakah bundle sebelumnya kompatibel dengan native shell, API, service, dan skema data saat ini.
- Hasil pemulihan: Apakah device atau instance berhasil menerapkan release yang dipulihkan.
“Previous” harus berarti artifact tertentu
Label seperti previous hanya berguna jika merujuk pada rilis yang immutable. Jika tim menimpa file di balik label tersebut, target pemulihan bisa berubah tanpa disadari. Jika artefak sudah kedaluwarsa dari penyimpanan, sistem deployment mungkin tahu nomor revisinya tetapi tidak memiliki byte yang dibutuhkan untuk memulihkannya.
Untuk aplikasi Capacitor, web bundle juga berjalan di dalam native shell. JavaScript bundle sebelumnya mungkin bergantung pada native plugin, permission, atau perilaku bridge yang telah berubah pada shell saat ini. Melakukan restore tanpa mengecek kompatibilitas dapat mengganti satu insiden dengan insiden lainnya.
Panduan Pendekatan Capgo untuk version control dan rollback mencerminkan prinsip yang lebih luas: riwayat rilis harus eksplisit, dapat diambil kembali, dan terhubung dengan audiens yang menerima setiap build. Rollback berhasil jika tim dapat menjawab tiga pertanyaan dengan cepat: apa yang aktif sebelumnya, apa yang stabil, dan apa yang aman dijalankan dengan sistem di sekitarnya saat ini?
Bahaya Tersembunyi dari Pembalikan Database dan Data
Deployment yang gagal dapat membuat tim menerima instruksi mendesak: “Restore saja versi sebelumnya.” Hal itu mungkin berhasil untuk code yang executable. Namun, hal ini bisa tidak aman untuk database, di mana aktivitas customer yang sudah terkomit mungkin mustahil untuk di-reverse secara bersih.
Rollback aplikasi dan rollback data adalah operasi berbeda dengan mode kegagalan yang berbeda. Rilis code sering kali dapat diganti dengan artefak immutable lain. Migrasi skema mungkin telah mengganti nama atau menghapus field, mengubah nilai yang tersimpan, atau mengubah asumsi yang dipakai write berikutnya. Pesanan, pembayaran, pesan, catatan, dan persetujuan adalah data pengguna yang valid. Data tersebut tidak boleh hilang hanya karena rilis aplikasi gagal.
Mengapa code dan skema bisa tidak sinkron
Misalkan rilis A memahami skema lama, sementara rilis B menambah kolom atau mengubah cara penyimpanan nilai. Setelah B dideploy dan migrasinya berjalan, mengembalikan ke A dapat membuat query code lama mencari field yang sudah tidak ada atau salah menginterpretasikan data baru.
Sebaliknya, hal ini menciptakan kegagalan yang berbeda. Melakukan revert database saat proses rilis B masih aktif dapat membuat write gagal atau meninggalkan state parsial. Melakukan revert pada code sekaligus database mungkin terlihat lebih bersih, namun dapat menghapus aktivitas sah yang dibuat setelah deployment. perbedaan antara rollback aplikasi dan rollback data harus ada dalam setiap rencana rilis, bukan hanya pada operasi database.
PostgreSQL menunjukkan apa yang dilakukan transactional rollback. ROLLBACK membatalkan transaksi saat ini dan membuang update yang dibuat di dalam transaksi tersebut, sehingga kumpulan write yang diterapkan sebagian tidak menjadi permanen. Ini tidak bisa membatalkan perubahan yang sudah di-commit oleh transaksi sebelumnya. Menjalankan perintah ROLLBACK di luar blok transaksi tidak akan membalikkan data yang tersimpan.
Rancang migrasi agar bergerak maju
Desain rilis yang lebih aman menjaga kompatibilitas versi aplikasi dan perubahan skema selama transisi. Tim juga harus mendokumentasikan praktik enkripsi SQLite untuk aplikasi Capacitor bersama dengan kompatibilitas skema, kontrol akses, dan prosedur pemulihan.
Migrasi expand-and-contract umumnya mengikuti urutan ini:
- Expand: Tambahkan kemampuan skema baru tanpa menghapus yang lama.
- Adopsi: Deploy code yang bisa membaca dan menulis kedua representasi, atau tambahkan jalur baru sambil mempertahankan jalur lama.
- Migrasi: Pindahkan record yang ada lewat proses terkontrol, dengan monitoring dan rekonsiliasi.
- Kontrak: Hapus struktur lama hanya setelah versi yang bergantung padanya tidak lagi membutuhkannya.
Urutan ini membuat rollback code lebih mungkin berhasil karena aplikasi lama masih bisa memakai skema yang mendukung kontraknya. Ini tidak membuat semua rollback aman. Ini menurunkan kemungkinan pemulihan menimbulkan ketidakcocokan baru.
Sistem fintech, kesehatan, dan e-commerce juga butuh auditabilitas, kontrol privasi, penanganan status pembayaran, dan rencana rekonsiliasi. Forward fix mungkin lebih aman daripada membatalkan transaksi valid atau memulihkan snapshot yang menghapus aktivitas pengguna setelahnya.
Aturan database: Rollback code dengan bebas hanya jika dependensi dan kontrak datanya mendukung. Anggap data yang sudah di-commit sebagai record yang bergerak maju kecuali prosedur pemulihan terpisah yang sudah diuji membuktikan sebaliknya.
Sebelum deployment, klasifikasikan setiap komponen rilis berdasarkan reversibilitasnya. Code, konfigurasi, paparan fitur, aset, skema, dan data pengguna mengikuti aturan pemulihan yang berbeda. Backup yang sudah diuji bisa membantu setelah korupsi parah, tetapi memulihkan backup tidak menggantikan desain migrasi yang backward-compatible.
Mengambil Keputusan Operasional untuk Revert
Rollback adalah keputusan operasional, bukan sekadar perintah deployment. Seseorang harus memutuskan apakah masalah yang teramati berasal dari rilis, apakah kondisi sebelumnya aman, apakah cukup banyak pengguna terdampak untuk membenarkan pembalikan, dan apakah perbaikan ke depan lebih efektif menurunkan risiko.
DORA menganggap change-failure rate sebagai deployment yang memerlukan intervensi segera, sering kali rollback atau hotfix, dan secara terpisah melacak waktu pemulihan deployment yang gagal. Itu menjadikan rollback sebagai peristiwa reliabilitas sekaligus hasil performa pengiriman, seperti dijelaskan dalam sejarah metrik DORA.
Tentukan trigger sebelum insiden terjadi
Tim yang baik menyepakati kondisi rollback saat rilis masih didesain. Trigger bisa berupa kombinasi sinyal crash, error rate, health check yang gagal, laporan support, atau perbandingan canary. Satu event yang noisy tidak harus langsung membatalkan rilis, tetapi pola yang jelas pada audiens yang dipantau harus punya respons yang terdefinisi.
Rollback otomatis hanya tepat jika kegagalan dipahami dengan baik, dapat dibalik, dan dapat diamati lewat sinyal yang andal. Sistem otomatis yang merespons setiap anomali bisa memperburuk insiden dengan bolak-balik antarversi, menyembunyikan fault yang mendasari, atau berulang kali memasukkan kembali dependency yang tidak kompatibel.
Untuk aplikasi mobile, keputusan ini butuh konteks tambahan:
- Pengguna offline: Beberapa perangkat tidak akan langsung mengecek update.
- Versi campuran: Client lama dan baru bisa berdampingan dalam waktu lama.
- Eksposur bertahap: Channel atau canary bisa mengungkap masalah sebelum production.
- Kompatibilitas native: Web bundle yang dipulihkan harus bisa berjalan dengan shell yang terinstal.
- Efek data: Rollback code mungkin tidak membatalkan penulisan yang sudah diterima backend.
Rollback vs roll-forward
Rollback mengembalikan state sebelumnya. Roll-forward merilis perubahan korektif. Tidak ada yang selalu lebih aman.
Rollback biasanya cocok untuk bug tampilan yang bisa dibalik, konfigurasi yang salah, atau rilis yang gagal sebelum mengubah state persisten. Roll-forward mungkin lebih aman jika migrasi sudah dijalankan, pengguna sudah membuat record valid, atau versi aplikasi sebelumnya tidak mendukung schema saat ini. Kill switch bisa lebih aman lagi jika fitur bermasalah bisa diisolasi tanpa mengganti seluruh rilis.
Runbook harus mencantumkan incident commander, orang yang berwenang mengeksekusi tindakan, sinyal health yang mengonfirmasi keberhasilan, dan jalur komunikasi untuk product dan support. Runbook juga harus menyebutkan kapan tim berhenti mencoba revert dan mulai fix forward.
Runbook yang berguna mencantumkan:
- The target revision dan lokasi artifact-nya.
- Pengecekan kompatibilitas untuk klien native, layanan, dependensi, dan skema.
- Kontrol blast radius, seperti channel, cohort, atau canary.
- Kriteria keberhasilan, termasuk sinyal pemulihan dan dampak pada pengguna.
- Pemilik tindak lanjut, yang bertanggung jawab atas rilis perbaikan dan review insiden.
Panduan perbedaan antara menjeda rollout dan melakukan rollback penting secara operasional. Menjeda membatasi paparan lebih lanjut. Rollback secara aktif mengubah apa yang diterima pengguna terdampak. Tim harus tahu tindakan mana yang dibutuhkan sebelum memilih salah satunya.
Pemulihan Instan di Aplikasi Mobile dan Cross-Platform
Pemulihan rilis mobile tradisional bergantung pada distribusi app store. Jika cacat ada di biner native, tim harus menyiapkan biner yang diperbaiki atau biner sebelumnya, mengirimkannya ke store terkait, dan menunggu distribusi mencapai pengguna. Proses itu mungkin tepat untuk perubahan native, tetapi menimbulkan friksi ketika cacat terbatas pada JavaScript, CSS, konfigurasi, copy, atau aset web.
Pengiriman over-the-air mengubah jalur pemulihan untuk perubahan lapisan web tersebut. Sistem live update dapat menerbitkan bundle yang ditandatangani ke audiens yang terkendali, memungkinkan perangkat menerapkannya saat peluncuran berikutnya atau pemeriksaan pembaruan, dan mempertahankan bundle sebelumnya sebagai fallback. Ini tidak menghilangkan kebutuhan review store ketika code native atau izin platform berubah, dan tidak membuat rollback data menjadi aman.
Distribusi store dan live update menyelesaikan masalah yang berbeda
| Kebutuhan pemulihan | Rilis biner berbasis store | live update yang ditandatangani |
|---|---|---|
| Perubahan plugin native atau izin | Sesuai | Bukan pengganti |
| Kekurangan JavaScript atau CSS | Jalur pemulihan lebih lambat | Cocok jika kebijakan dan kompatibilitas mengizinkan |
| Kontrol audiens | Kanal store dan kontrol rollout | Kanal tertarget dan pengiriman bertahap |
| Target pemulihan | Binary yang dipublikasikan | Web bundle berversi |
| Dependensi utama | Distribusi store | Updater, penandatanganan, kompatibilitas, dan observabilitas |
Platform seperti Capgo mendukung Capacitor live updates dengan mengirimkan web bundle yang ditandatangani ke channel yang ditargetkan, mempertahankan riwayat versi, menerapkan update pada peluncuran berikutnya atau saat pengecekan update, serta menyediakan perlindungan rollback jika bundle baru gagal melewati health check yang dikonfigurasi. Pengiriman diferensial dapat mengirim hanya file yang berubah, sementara channel dapat memisahkan audiens beta, staging, produksi, atau khusus pelanggan. Kemampuan ini membantu tim mengurangi cakupan kegagalan rilis lapisan web, tetapi tidak menghilangkan kebutuhan untuk memvalidasi kompatibilitas native-shell atau kontrak data backend.
Fallback otomatis butuh sinyal health yang tepercaya
Updater tidak boleh menandai bundle sehat hanya karena unduhan selesai. Ia harus membedakan antara pengambilan, instalasi, peluncuran, dan kesehatan aplikasi yang sebenarnya. Jika bundle baru crash atau gagal health check saat peluncuran berikutnya, perangkat dapat kembali ke versi stabil terakhir tanpa mengunduh biner app store penuh.
Pemulihan itu tetap memiliki batasan. Perangkat mungkin offline, update yang gagal mungkin sudah mengubah data sisi server, atau bundle sebelumnya mungkin tidak kompatibel dengan native shell yang terinstal. Log per-perangkat dan data adopsi versi membantu tim support menentukan pengguna mana yang menerima bundle mana dan apakah fallback berhasil.
Panduan Panduan konfigurasi rollback update Capacitor harus berdampingan dengan kebijakan rilis, bukan menggantikannya. Tanda tangani setiap artefak, batasi siapa yang dapat menerbitkan ke channel produksi, simpan versi fallback, dan uji jalur kegagalan pada perangkat nyata. Distribusi cepat hanya bernilai jika sistem dapat membuktikan bahwa bundle yang dipulihkan adalah yang dimaksud.
Membangun Strategi Release yang Tangguh
Kesiapan rollback adalah properti dari seluruh sistem rilis. Build lama di object storage tidak memberikan perlindungan yang bermakna jika tim tidak dapat mengidentifikasi dependensinya, tidak dapat melihat perangkat mana yang mengadopsinya, atau belum pernah menguji pemulihan terhadap data mirip produksi.
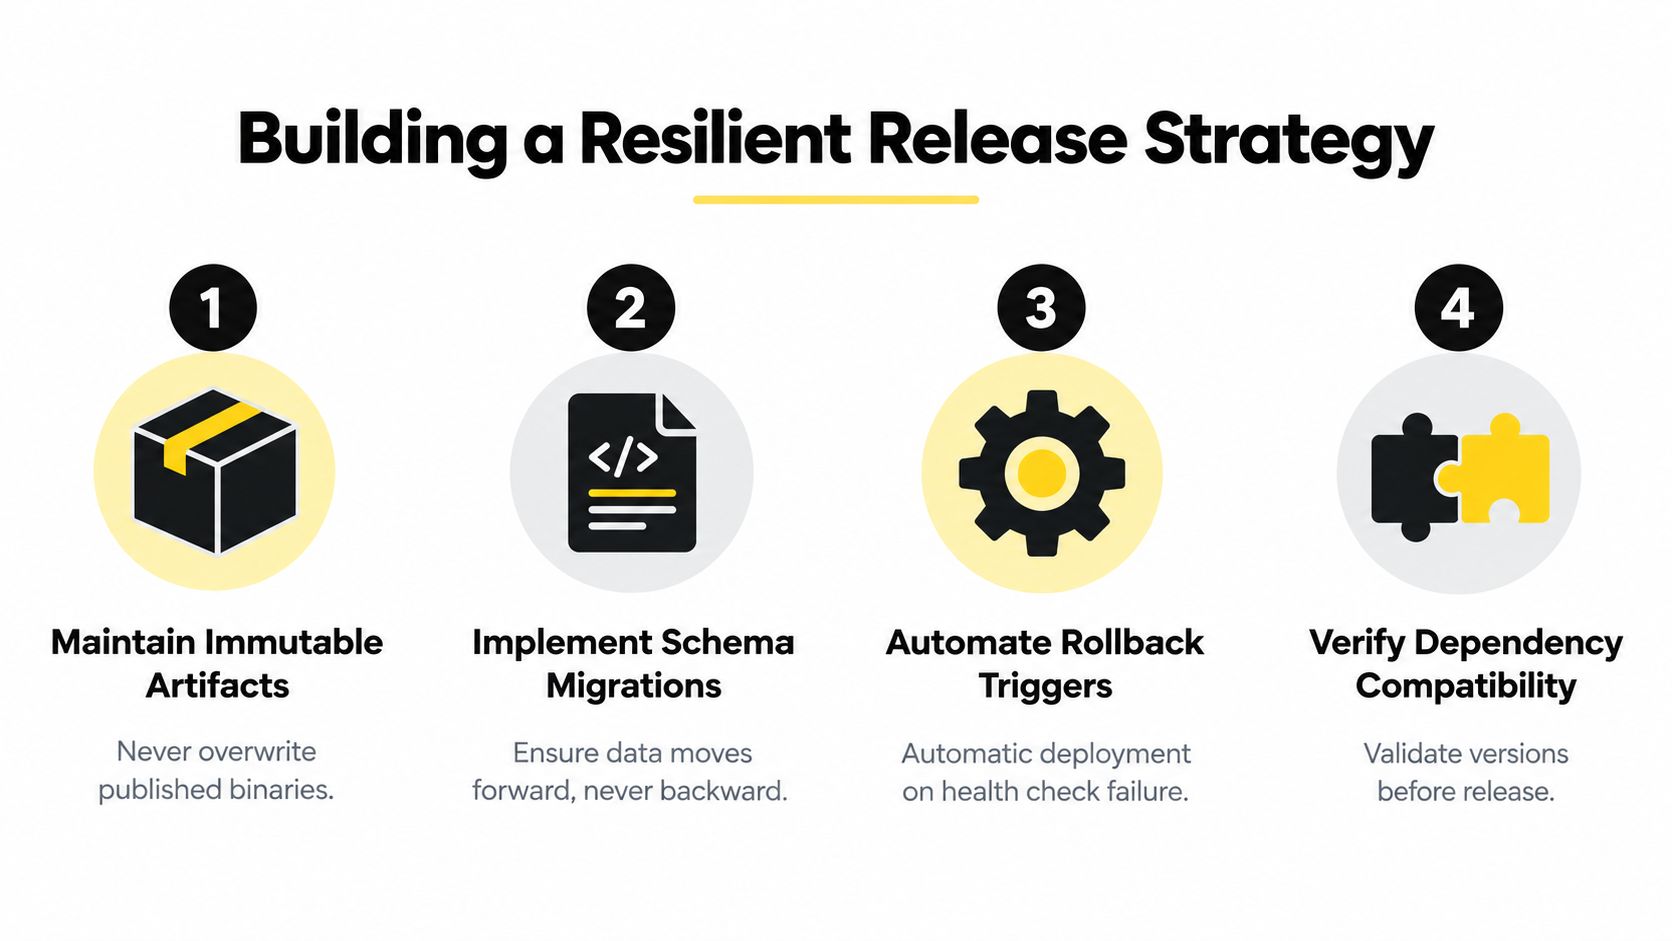
Mulai dari rantai artifact. Tag state sumber yang stabil, kunci dependensi, simpan build yang ditandatangani, dan jangan pernah menimpa rilis yang sudah dipublikasikan. Kemudian, hubungkan setiap artifact ke lingkungan, channel, dan event deployment. Tim harus mampu merekonstruksi apa yang terjadi tanpa bergantung pada mesin lokal developer.
Empat kontrol untuk mengurangi risiko recovery
- Artifact immutable: Simpan setiap bundle produksi di bawah identitas unik. Pointer “sebelumnya” dapat memilih rilis, tetapi tidak boleh mengubah rilis itu sendiri.
- Migrasi yang kompatibel: Gunakan teknik expand-and-contract agar versi aplikasi lama dan baru dapat coexist selama transisi yang terkontrol.
- Otomasi yang dijaga: Otomatiskan fallback hanya untuk sinyal yang membedakan kegagalan rilis nyata dari masalah layanan sementara.
- Validasi dependensi: Periksa native shell, plugin, API, layanan, dan skema sebelum mengizinkan revisi target menjadi aktif.
Observability menutup loop. Tangkap versi per perangkat, hasil launch, status update, alasan kegagalan, dan status adopsi. Catatan tersebut memungkinkan tim support menjawab apakah pengguna masih di bundle yang gagal, sudah menerima fallback, atau tidak pernah mengunduh update.
Tim harus melatih jalur pemulihan dengan data realistis dan versi client yang beragam. Pengujian yang memulihkan code pada database development yang kosong bisa melewatkan ketidakcocokan akibat data asli, varian schema lama, antrean write, dan migrasi yang belum selesai. Pengujian pemulihan juga harus memverifikasi otorisasi, signing, pengambilan artifact, targeting channel, dan rencana komunikasi.
Pemulihan tidak diukur dari adanya build lama. Pemulihan diukur dari seberapa presisi tim dapat mengontrol dampak dan mengembalikan state yang kompatibel.
Perencanaan rilis harus mencakup ownership yang eksplisit untuk koordinasi dependensi. Tim yang membutuhkan framework lebih luas untuk mengelola dependensi secara agile dapat menggunakan disiplin perencanaan tersebut untuk menyelaraskan perubahan mobile, backend, database, dan produk sebelum deployment.
Review kesiapan praktis akan menanyakan:
- Dapatkah tim mengidentifikasi artifact persis yang aktif di setiap channel?
- Dapatkah menghentikan exposure tanpa mengubah code yang sudah terinstal?
- Dapatkah memulihkan bundle yang sudah di-sign dan kompatibel?
- Dapatkah membuktikan bahwa database tetap aman setelah rollback aplikasi?
- Dapatkah mendeteksi kegagalan per versi, bukan hanya pada level layanan secara agregat?
- Dapatkah memilih roll-forward jika rollback akan merusak data yang valid?
Jika ada jawaban yang tidak jelas, proses rilis memiliki celah pemulihan. Memperbaiki celah itu sebelum insiden berikutnya lebih murah daripada mengimprovisasi saat pengguna menunggu.
Poin Penting untuk Deployment yang Lebih Aman
Rollback membatalkan perubahan perangkat lunak atau konfigurasi yang sudah diterapkan untuk mengembalikan ke kondisi yang diketahui baik. Ini tidak mencegah cacat, memperbaiki penyebab mendasar, atau secara otomatis membatalkan perubahan database yang sudah dikomit.
Jaga agar artefak aplikasi tetap imutabel dan dapat diidentifikasi. Lacak versi aktif, dependensi, kompatibilitas native-shell, dan audiens untuk setiap rilis. Perlakukan migrasi skema dan data pengguna sebagai target pemulihan terpisah, karena rollback code dapat meninggalkan database dalam keadaan berubah, dan rollback database dapat menghancurkan catatan valid.
Gunakan pengiriman bertahap, sinyal kesehatan yang andal, otorisasi eksplisit, dan runbook yang sudah diuji. Untuk tim mobile, bundle over-the-air yang ditandatangani dapat menyediakan pemulihan cepat untuk perubahan lapisan web yang kompatibel, sementara perubahan native masih memerlukan jalur rilis biner yang sesuai. Ukur pemulihan berdasarkan berkurangnya blast radius dan pemulihan layanan yang terverifikasi, bukan berdasarkan keberadaan build lama.
Capgo memberikan Capacitor dan tim Electron bundle live-update yang ditandatangani, channel tertarget, riwayat versi, observabilitas per-perangkat, dan perlindungan rollback untuk rilis web-layer yang kompatibel. Tinjau jalur pemulihan Anda saat ini dan lihat bagaimana Capgo dapat membantu Anda menjeda paparan, memulihkan bundle yang diketahui baik, dan menjaga respons insiden tetap terkendali.





