
Il rollback è un'operazione di recupero che annulla una modifica software o di configurazione e ripristina uno stato precedente noto e funzionante. In Kubernetes, la cronologia dei deployment conserva 10 vecchi ReplicaSet per impostazione predefinita, mentre PostgreSQL ROLLBACK scarta gli aggiornamenti effettuati dalla transazione corrente, non i dati già commitati.
Una release va live, i primi utenti aprono l'app e i ticket di supporto arrivano prima che il team di prodotto abbia finito di festeggiare. Uno screen di checkout va in crash, una nuova risposta API rompe un client più vecchio, o una modifica di configurazione invia le richieste lungo il percorso sbagliato. Il team deve ripristinare il servizio senza dover indovinare quali file sono cambiati o chiedere a ogni utente di reinstallare.
A questo serve il rollback. Non è prevenzione, né un pulsante magico per annullare. La nuova release è già stata applicata. Il rollback è la risposta controllata quando quella release causa errori, prestazioni degradate, crash o comportamenti non sicuri. In pratica, di solito ridispiega la versione precedente dell'applicazione o ripristina una configurazione versionata, poi verifica che il servizio sia tornato a uno stato accettabile. Il tecniche di analisi dei guasti che il tuo team usa in seguito contano ancora, perché il rollback stabilizza l'incidente ma non ne spiega la causa.
Indice dei contenuti
- La realtà dei fallimenti di deployment
- Come i sistemi moderni conservano la cronologia dei release
- Il pericolo nascosto dei rollback di database e dati
- Prendere la decisione operativa di fare il rollback
- Ripristino istantaneo in app mobile e cross-platform
- Costruire una strategia di rilascio resiliente
- Punti chiave per deployment più sicuri
La realtà dei fallimenti di deployment
Un team mobile rilascia un nuovo bundle con un cambio di navigazione e un aggiornamento di compatibilità backend. Il pubblico in staging lo riceve per primo. In pochi minuti, gli utenti segnalano che una schermata principale non si carica. Il monitoraggio mostra un aumento degli errori, ma il team non riesce ancora a capire se il problema derivi dal bundle, dal API, da un feature flag o da una dipendenza.
La risposta sicura non è discutere della diagnosi perfetta mentre il pubblico colpito aumenta. Se il team ha un artifact noto come funzionante, può interrompere il rollout e ripristinare quella versione. L'applicazione torna a uno stato precedentemente validato mentre gli ingegneri analizzano il difetto e preparano una correzione.
Il rollback è ripristino, non prevenzione
Prevenzione tenta di bloccare una modifica errata prima che raggiunga gli utenti. Test, revisione di code, controlli delle dipendenze, canary release e approvazioni servono a questo scopo. Il rollback inizia dopo che la prevenzione ha fallito o quando in produzione compare un'interazione inattesa.
Un rollback può interessare diverse parti di un sistema di delivery:
- code dell'applicazione: Ridistribuire l'eseguibile o il web bundle precedente.
- Configurazione: Ripristinare un'impostazione versionata, una regola di routing o una configurazione di feature.
- Asset: Tornare a immagini, script o file di contenuto compatibili.
- Esposizione delle feature: Disabilita una nuova funzionalità tramite kill switch o controllo dell'audience.
- Dati: Interrompi una transazione attiva o ripristina i dati da un backup, con vincoli molto più stringenti.
L'ultima categoria richiede un trattamento separato. Il rollback di code dell'applicazione è spesso semplice se gli artifact sono immutabili e le dipendenze rimangono compatibili. Il rollback dei dati committati può causare perdite, corruzione o problemi normativi. Un rollback del rilascio non deve quindi implicare che ogni operazione correlata sul database possa tornare indietro in sicurezza.
Perché il delivery frequente richiede un ripristino rapido
La moderna continuous delivery rende i rilasci più frequenti. Questo crea un requisito pratico: il costo operativo di un cambiamento fallito deve rimanere limitato. Un team che può deployare velocemente ma ha bisogno di un lungo processo manuale per recuperare ha ottimizzato solo metà della delivery.
Il rollback manuale rimane possibile, ma si basa sul fatto che gli operatori ricordino quali file sono cambiati, quali server sono stati aggiornati e quale configurazione apparteneva al rilascio precedente. Quel processo diventa fragile durante un incidente. I sistemi automatizzati migliorano il percorso conservando artifact immutabili, monitorando i segnali di stato e ripristinando quando vengono soddisfatte condizioni predefinite.
Regola pratica: Tratta il rollback come una capacità di produzione collaudata, non come un pulsante di emergenza che qualcuno capirà come usare durante l'outage.
Un rollback non è nemmeno una soluzione permanente. Ripristina il servizio temporaneamente, ma il difetto di base rimane. Gli ingegneri devono comunque identificare la causa, valutare i dati scritti durante il rilascio fallito e rilasciare una versione corretta o prendere un'altra decisione operativa deliberata.
Come i sistemi moderni conservano la cronologia dei release
Un sistema di recupero può ripristinare solo ciò che è in grado di identificare e recuperare. Conservare un vecchio commit del codice sorgente non basta se la build è stata prodotta con dipendenze in conflitto, se il binario è stato sovrascritto o se la shell nativa non supporta più il bundle.
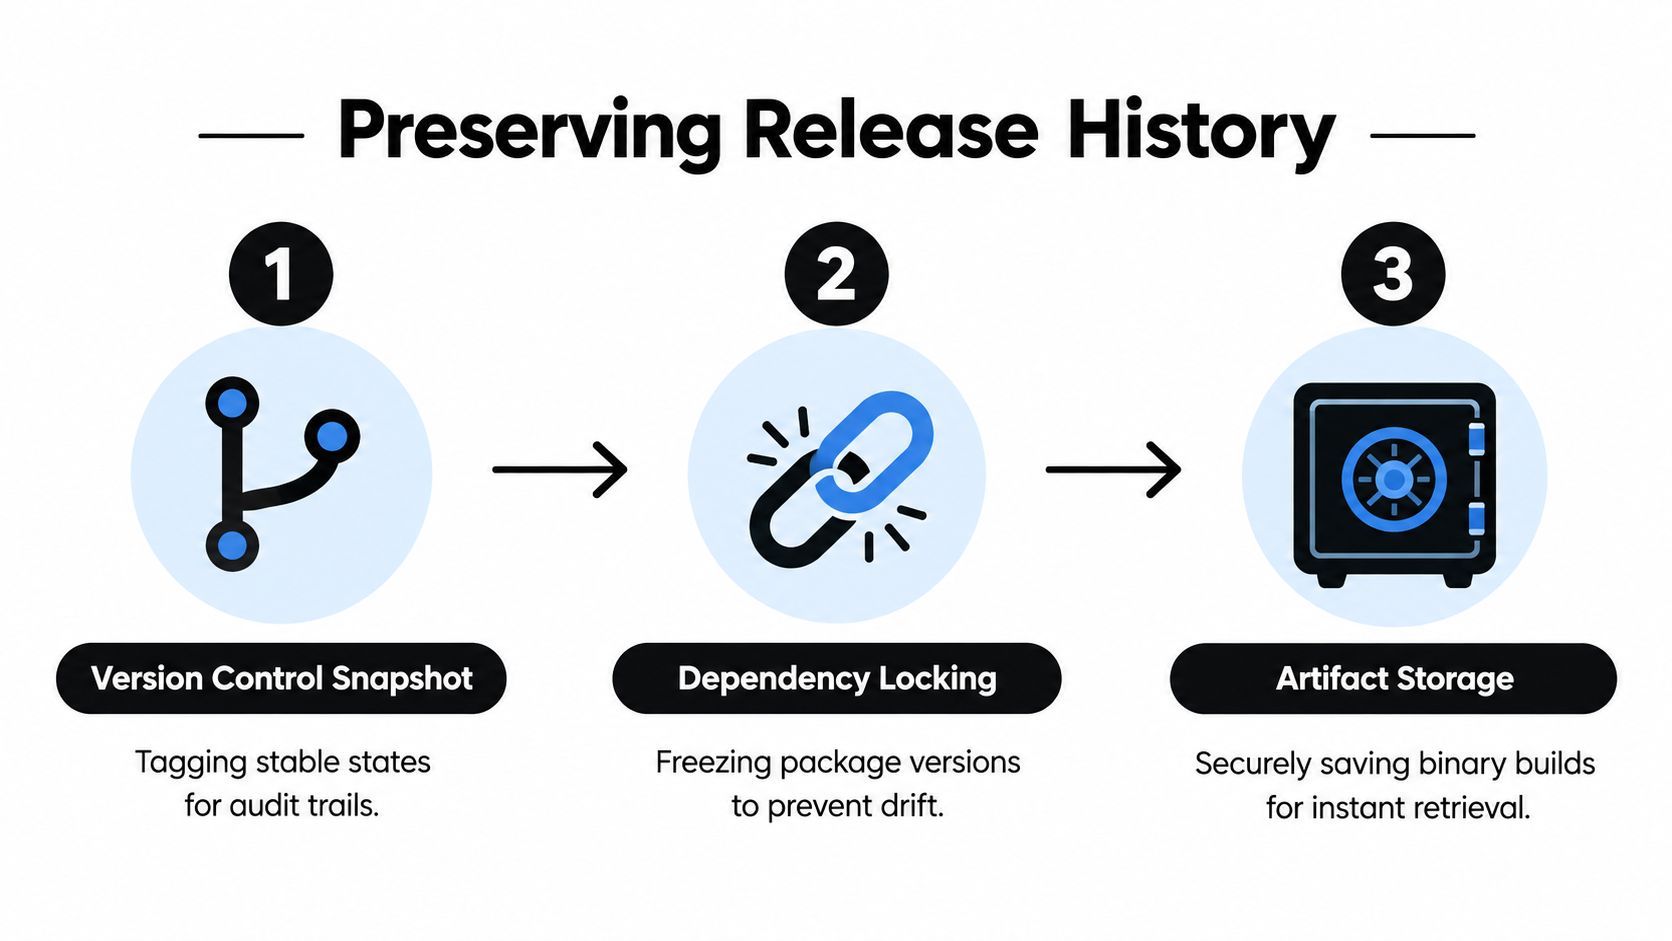
I sistemi di rilascio moderni risolvono questo problema preservando una catena di prove dal sorgente all'artefatto distribuito. Il team tagga una revisione stabile, blocca il grafo delle dipendenze, esegue il build di un artefatto indirizzabile e registra quale artefatto ha raggiunto ciascun ambiente. Quel registro dà agli operatori un target specifico invece di un'istruzione ambigua come "torna alla versione precedente".
Kubernetes come modello concreto
Kubernetes illustra chiaramente la struttura. Un Deployment controlla i ReplicaSet, e quei ReplicaSet preservano le revisioni del deployment. Kubernetes conserva 10 vecchi ReplicaSet per impostazione predefinita, e i team possono modificare questa retention con spec.revisionHistoryLimit. Impostando il valore a 0 si disabilita completamente il rollback, come documentato nel Riferimento al Deployment Kubernetes.
Un operatore può tornare alla revisione immediatamente precedente o selezionare una revisione storica specifica. Il rollback modifica la configurazione del template del Pod del Deployment, inclusi campi come l'immagine del container e le label. Non inverte automaticamente campi non correlati, come il numero di repliche. Dopodiché, i controlli di rollout status confermano se la revisione di destinazione è diventata healthy.
Questa distinzione è cruciale per la distribuzione di bundle mobile e web. Un sistema deve registrare:
- La versione attiva: Quale release ha ricevuto ciascun ambiente, canale o dispositivo.
- L'identità dell'artefatto: Una build indirizzabile per contenuto o comunque immutabile, non un file che può essere sostituito in place.
- Compatibilità delle dipendenze: Se il bundle precedente funziona con la shell nativa, le API, i servizi e lo schema dati attuali.
- Il risultato del ripristino: Se i dispositivi o le istanze hanno adottato con successo la release ripristinata.
“Precedente” deve riferirsi a un artifact specifico
Un'etichetta come previous è utile solo se punta a un rilascio immutabile. Se un team sovrascrive il file dietro quell'etichetta, l'obiettivo del ripristino può cambiare senza che nessuno se ne accorga. Se l'artifact è scaduto ed è stato rimosso dallo storage, il sistema di deployment può conoscere il numero di revisione ma non avere i byte necessari per ripristinarlo.
Per un'applicazione Capacitor, il web bundle gira anche dentro una native shell. Un bundle JavaScript precedente può dipendere da plugin nativi, permessi o dal comportamento del bridge che la shell attuale ha cambiato. Ripristinarlo senza verificare la compatibilità può trasformare un incidente in un altro.
Il Approccio Capgo al version control e ai rollback riflette un principio più ampio: la cronologia dei rilasci deve essere esplicita, recuperabile e collegata al pubblico che ha ricevuto ogni build. Un rollback riesce quando il team sa rispondere rapidamente a tre domande: cosa era attivo, cosa era stabile e cosa può girare in sicurezza con il resto del sistema, adesso?
Il pericolo nascosto dei rollback di database e dati
Un deployment fallito può lasciare il team con un'istruzione urgente: "Basta ripristinare la versione precedente". Può funzionare per l'eseguibile code. Può essere rischioso per un database, dove le operazioni dei clienti già committate potrebbero essere impossibili da annullare in modo pulito.
Il rollback dell'applicazione e il rollback dei dati sono operazioni diverse, con modalità di errore diverse. Una release code può spesso essere sostituita con un altro artefatto immutabile. Una migrazione dello schema potrebbe aver rinominato o rimosso un campo, trasformato i valori salvati o cambiato i presupposti su cui si basano le scritture successive. Ordini, pagamenti, messaggi, record e consensi sono dati utente validi. Non dovrebbero scomparire perché una release dell'applicazione è fallita.
Perché code e lo schema possono andare fuori sincrono
Supponiamo che la release A supporti il vecchio schema, mentre la release B aggiunge una colonna o cambia il modo in cui un valore viene salvato. Dopo il deployment di B e l'esecuzione della migrazione, ripristinare A può portare la vecchia query code a interrogare campi che non esistono più o a interpretare male i nuovi dati.
Il contrario crea un tipo diverso di errore. Ripristinare il database mentre i processi della release B sono ancora attivi può far fallire le scritture o lasciare uno stato parziale. Ripristinare sia code sia il database può sembrare più pulito, ma rischia di cancellare attività legittime create dopo il deployment. La distinzione tra rollback dell'applicazione e rollback dei dati va inserita in ogni piano di release, non solo nelle operazioni sul database.
PostgreSQL mostra cosa fa un rollback transazionale. ROLLBACK interrompe la transazione corrente e scarta gli aggiornamenti effettuati al suo interno, così che un gruppo di scritture applicato parzialmente non diventi persistente. Non può annullare modifiche committate da una transazione precedente. Eseguire comandi ROLLBACK al di fuori di un blocco transazionale non annulla i dati salvati.
Progetta le migrazioni per andare avanti
Un design di rilascio più sicuro mantiene compatibili le versioni dell'app e le modifiche allo schema durante una transizione. I team dovrebbero anche documentare le pratiche di crittografia SQLite per le app Capacitor oltre alla compatibilità dello schema, ai controlli di accesso e alle procedure di recovery.
Una migrazione di tipo expand-and-contract segue solitamente questa sequenza:
- Espandi: Aggiungi la nuova funzionalità allo schema senza rimuovere quella vecchia.
- Adotta: Distribuisci code in grado di leggere e scrivere entrambi i formati, o introduci il nuovo percorso mantenendo quello vecchio.
- Migra: Sposta i record esistenti tramite un processo controllato, con monitoraggio e riconciliazione.
- Contratto: Rimuovi la vecchia struttura solo quando le versioni dipendenti non ne avranno più bisogno.
Questa sequenza rende più plausibile un rollback di code, perché l'applicazione precedente può ancora usare uno schema che ne supporta il contratto. Non rende sicuro ogni rollback, ma riduce il rischio che il ripristino introduca una nuova incompatibilità.
Anche i sistemi fintech, sanitari ed e-commerce richiedono auditabilità, controlli sulla privacy, gestione dello stato dei pagamenti e un piano di riconciliazione. Un forward fix può essere più sicuro che annullare transazioni valide o ripristinare uno snapshot che elimini l'attività successiva degli utenti.
Regola del database: Esegui il rollback di code liberamente solo quando le sue dipendenze e il data contract supportano questa azione. Tratta i dati committati come un record che avanza solo in avanti, a meno che una procedura di ripristino separata e testata dimostri il contrario.
Prima del deployment, classifica ogni componente del rilascio in base alla sua reversibilità. Code, configurazione, esposizione delle feature, asset, schema e dati utente seguono regole di recovery diverse. Un backup testato aiuta dopo una corruzione catastrofica, ma ripristinare un backup non sostituisce una migrazione progettata per essere backward-compatible.
Prendere la decisione operativa di fare il rollback
Il rollback è una decisione operativa, non solo un comando di deployment. Qualcuno deve decidere se il problema riscontrato derivi dal rilascio, se lo stato precedente sia sicuro, se gli utenti coinvolti siano abbastanza da giustificare il rollback e se un forward fix ridurrebbe il rischio in modo più efficace.
DORA calcola il change-failure rate sui deployment che richiedono un intervento immediato, spesso un rollback o un hotfix, e traccia separatamente il tempo di recupero dei deployment falliti. Questo rende il rollback sia un evento di affidabilità sia un risultato di performance del delivery, come descritto nella storia delle metriche DORA.
Definisci il trigger prima dell'incidente
I team migliori concordano sulle condizioni di rollback mentre il rilascio è ancora in fase di progettazione. Un trigger potrebbe combinare segnali di crash, tassi di errore, health check falliti, segnalazioni del supporto o un confronto canary. Un singolo evento rumoroso non dovrebbe necessariamente far tornare indietro un rilascio, ma un pattern chiaro su un pubblico monitorato dovrebbe avere una risposta definita.
Il rollback automatico è appropriato solo quando il guasto è ben compreso, reversibile e osservabile tramite segnali affidabili. Un sistema automatizzato che risponde a ogni anomalia può aggravare un incidente oscillando tra le versioni, nascondendo il guasto sottostante o reintroducendo ripetutamente una dipendenza incompatibile.
Per un'app mobile, la decisione richiede un contesto aggiuntivo:
- Utenti offline: Alcuni dispositivi non cercano subito gli aggiornamenti.
- Versioni miste: Client vecchi e nuovi possono coesistere a lungo.
- Rilascio graduale: Un canale o una versione canary possono rivelare un problema prima della produzione.
- Compatibilità nativa: Un web bundle ripristinato deve funzionare con la shell installata.
- Effetti sui dati: Un rollback di code potrebbe non annullare le scritture già accettate dal backend.
Rollback vs roll-forward
Rollback ripristina uno stato precedente. Roll-forward rilascia una modifica correttiva. Nessuna delle due è universalmente più sicura.
Il rollback di solito è adatto a un difetto di presentazione reversibile, a una configurazione errata o a una release che fallisce prima di modificare lo stato persistente. Il roll-forward può essere più sicuro quando la migrazione è già stata eseguita, gli utenti hanno creato record validi o la versione precedente dell'app non supporta lo schema attuale. Un kill switch può essere ancora più sicuro quando la funzionalità difettosa può essere isolata senza sostituire l'intera release.
Il runbook dovrebbe indicare l'incident commander, la persona autorizzata a eseguire l'azione, i segnali di salute che confermano il successo e il canale di comunicazione per prodotto e supporto. Dovrebbe anche specificare quando il team smette di provare a fare rollback e inizia a correggere in avanti.
Un runbook utile registra:
- La revisione di destinazione e la posizione del suo artefatto.
- I controlli di compatibilità per client nativi, servizi, dipendenze e schema.
- Il controllo del blast radius, come un canale, una coorte o un canary.
- I criteri di successo, inclusi i segnali di recovery e l'impatto sugli utenti.
- Il responsabile del follow-up, responsabile del rilascio corretto e della revisione dell'incidente.
Il differenza tra mettere in pausa un rollout e fare rollback è importante a livello operativo. Mettere in pausa limita l'esposizione ulteriore. Il rollback cambia attivamente ciò che ricevono gli utenti impattati. I team devono sapere quale azione serve prima di scegliere l'una o l'altra.
Ripristino istantaneo in app mobile e cross-platform
Il recovery dei rilasci mobile tradizionali dipende dalla distribuzione degli app store. Se il difetto è nel binario nativo, il team deve preparare un binario corretto o precedente, inviarlo allo store competente e attendere la distribuzione. Questo processo può essere appropriato per le modifiche native, ma crea attrito quando il difetto riguarda solo JavaScript, CSS, configurazione, testi o asset web.
La distribuzione over-the-air modifica il percorso di recupero per le modifiche al livello web. Un sistema live update può pubblicare un bundle firmato a un pubblico controllato, consentire ai dispositivi di applicarlo al prossimo avvio o controllo aggiornamenti e mantenere il bundle precedente come fallback. Non elimina la necessità di revisione dello store quando cambiano i code nativi o i permessi della piattaforma, e non rende sicuro il rollback dei dati.
Distribuzione sugli store e live update risolvono problemi diversi
| Necessità di recupero | Rilascio binario basato su store | live update firmato |
|---|---|---|
| Modifica di plugin o permessi nativi | Adatto | Non è un sostituto |
| Difetto in JavaScript o CSS | Percorso di ripristino più lento | Adatto quando policy e compatibilità lo consentono |
| Controllo del pubblico | Canali store e controlli di rollout | Canali mirati e distribuzione graduale |
| Target di ripristino | Binario pubblicato | Bundle web versionato |
| Dipendenza principale | Distribuzione store | Updater, firma, compatibilità e osservabilità |
Una piattaforma come Capgo supporta gli aggiornamenti live di Capacitor consegnando bundle web firmati a canali mirati, mantenendo la cronologia delle versioni, applicando gli aggiornamenti al successivo avvio o controllo aggiornamenti e fornendo protezione rollback quando un nuovo bundle non supera gli health check configurati. La consegna differenziale può inviare solo i file modificati, mentre i canali possono separare i pubblici beta, staging, produzione o specifici per cliente. Queste funzionalità aiutano i team a ridurre la portata di un rilascio fallito del layer web, ma non eliminano la necessità di validare la compatibilità della shell nativa o i contratti dati del backend.
Il fallback automatico richiede un health signal affidabile
Un updater non dovrebbe considerare sano un bundle solo perché il download è andato a buon fine. Deve distinguere tra recupero, installazione, avvio e stato di salute effettivo dell'app. Se il nuovo bundle crasha o non supera gli health check al lancio successivo, il dispositivo può tornare all'ultima versione stabile senza scaricare un intero binario dall'app store.
Anche questo recupero ha dei limiti. Il dispositivo potrebbe essere offline, l'aggiornamento fallito potrebbe aver già modificato dati lato server, oppure il bundle precedente potrebbe non essere compatibile con la native shell installata. I log per dispositivo e i dati sull'adozione delle versioni aiutano il supporto a capire quali utenti hanno ricevuto quale bundle e se il fallback ha funzionato.
Il guida alla configurazione del rollback degli update Capacitor dovrebbe affiancare una release policy, non sostituirla. Firma ogni artifact, limita chi può pubblicare sui canali di produzione, conserva la versione di fallback e testa il percorso di fallimento su dispositivi reali. La distribuzione rapida è preziosa solo se il sistema può dimostrare che il bundle ripristinato è quello previsto.
Costruire una strategia di rilascio resiliente
La prontezza al rollback è una proprietà dell'intero sistema di rilascio. Una vecchia build nell'object storage non offre una protezione concreta se il team non riesce a identificarne le dipendenze, non vede quali dispositivi l'hanno adottata o non ha mai testato il recupero con dati simili a quelli di produzione.
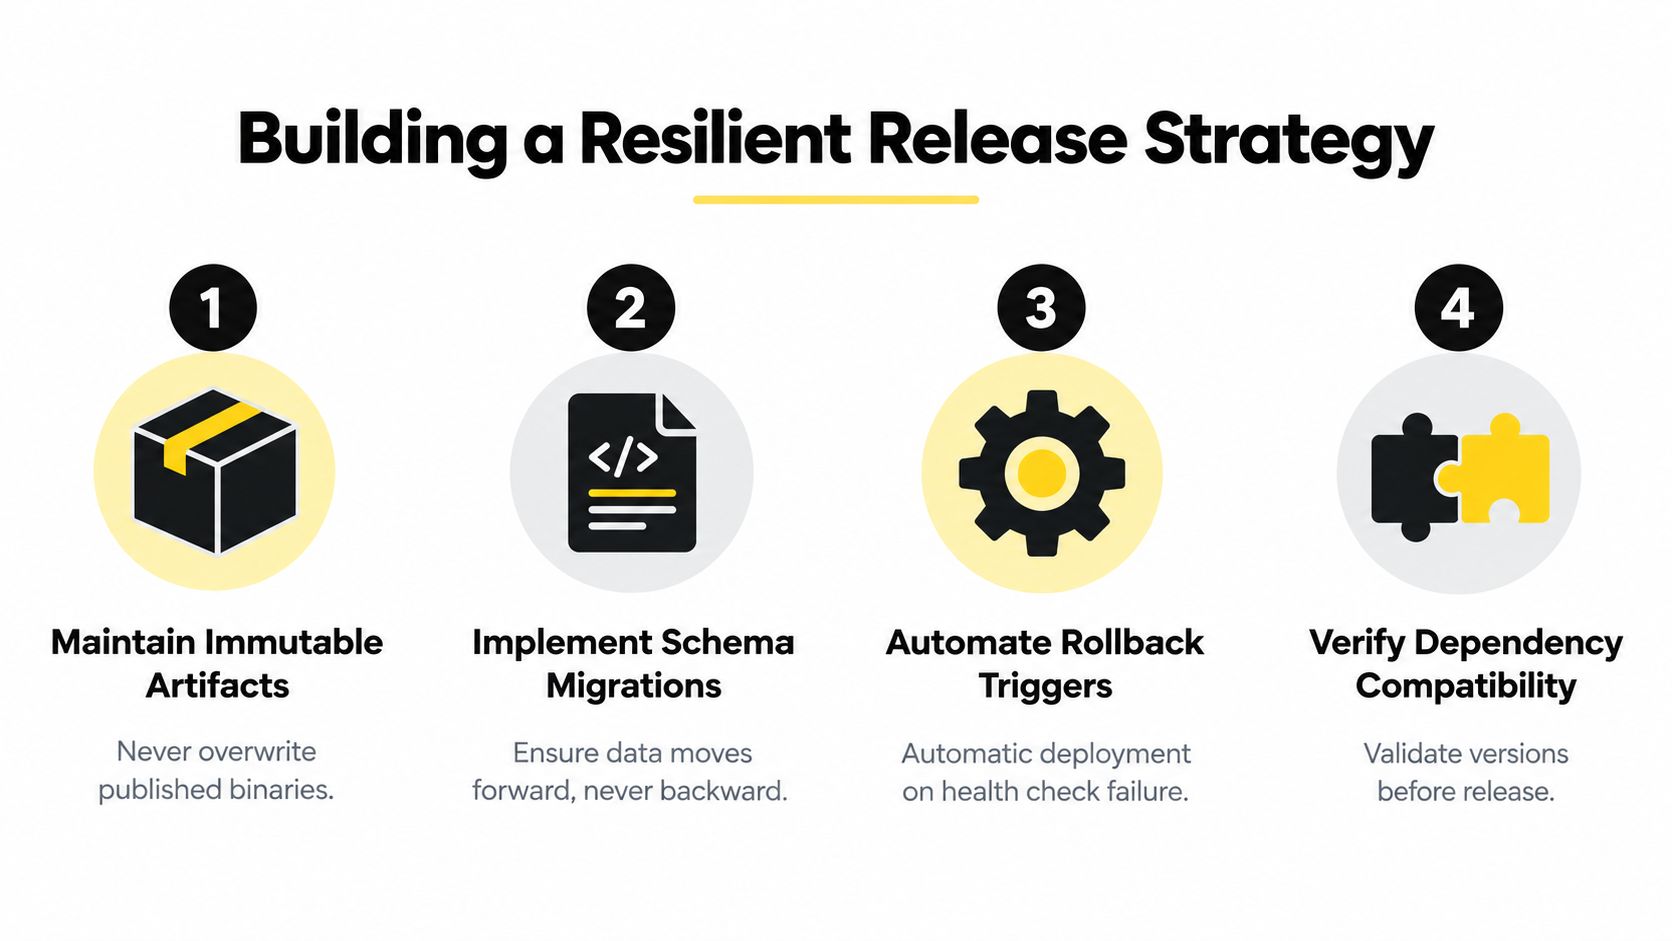
Parti dalla catena degli artefatti. Tagga gli stati stabili del codice sorgente, blocca le dipendenze, conserva le build firmate e non sovrascrivere mai una release pubblicata. Poi collega ogni artefatto a un ambiente, un canale e un evento di deployment. Il team deve poter ricostruire cosa è successo senza dipendere dalla macchina locale di uno sviluppatore.
Quattro controlli per ridurre il rischio di ripristino
- Artefatti immutabili: Archivia ogni bundle di produzione con un'identità univoca. Un puntatore "previous" può selezionare una release, ma non deve modificare la release stessa.
- Migrazioni compatibili: Usa tecniche expand-and-contract per far coesistere versioni precedenti e nuove dell'app durante una transizione controllata.
- Automazione protetta: Automatizza il fallback solo per i segnali che distinguono un vero fallimento del rilascio da un problema di servizio transitorio.
- Validazione delle dipendenze: Controlla la native shell, i plugin, le API, i servizi e lo schema prima di attivare una revisione target.
L'osservabilità chiude il cerchio. Registra la versione per dispositivo, l'esito dell'avvio, lo stato dell'update, il motivo del fallimento e lo stato di adozione. Questi record permettono al supporto di sapere se un utente è ancora sul bundle fallito, se ha già ricevuto il fallback o se non ha mai scaricato l'update.
I team dovrebbero provare il percorso di recovery con dati realistici e versioni client miste. Un test che ripristina code su un database di sviluppo vuoto può non rilevare l'incompatibilità causata da record reali, vecchie varianti di schema, scritture in coda e migrazioni completate solo in parte. Il test del recovery dovrebbe verificare anche autorizzazione, firma, recupero degli artifact, targeting dei channel e il piano di comunicazione.
Il recovery non si misura dall'esistenza di una vecchia build, ma da quanto precisamente il team riesce a controllare l'impatto e ripristinare uno stato compatibile.
La pianificazione del rilascio dovrebbe includere una responsabilità esplicita per il coordinamento delle dipendenze. I team che necessitano di un framework più ampio per gestire le dipendenze in agile può usare quella disciplina di pianificazione per allineare modifiche a mobile, backend, database e prodotto prima del deployment.
Una verifica pratica di readiness chiede:
- Il team riesce a identificare l'artifact esatto attivo su ogni channel?
- È possibile sospendere l'esposizione senza modificare i code già installati?
- È possibile ripristinare un bundle firmato e compatibile?
- È possibile dimostrare che il database resti integro dopo un rollback dell'app?
- È possibile rilevare i fallimenti per versione invece che solo a livello di servizio aggregato?
- È possibile scegliere il roll-forward quando un rollback danneggerebbe i dati validi?
Se una delle risposte non è chiara, il processo di rilascio presenta un gap di recovery. Correggere quel gap prima del prossimo incidente costa meno che improvvisare mentre gli utenti sono in attesa.
Punti chiave per deployment più sicuri
Il rollback annulla una modifica software o di configurazione applicata per ripristinare uno stato noto e funzionante. Non previene i difetti, non ripara la causa sottostante e non annulla automaticamente le modifiche al database già commit.
Mantieni gli artefatti dell'applicazione immutabili e indirizzabili. Traccia la versione attiva, le dipendenze, la compatibilità della shell nativa e il pubblico per ogni rilascio. Tratta le migrazioni dello schema e i dati utente come target di recovery separati, perché un rollback code può lasciare il database modificato e un rollback del database può distruggere record validi.
Usa la distribuzione a stadi, segnali di health affidabili, autorizzazione esplicita e un runbook testato. Per i team mobile, i bundle over-the-air firmati possono fornire un recovery rapido per modifiche compatibili al layer web, mentre le modifiche native richiedono ancora il percorso di rilascio binario appropriato. Misura il recovery in base alla riduzione del blast radius e al ripristino del servizio verificato, non alla presenza di un vecchio build.
Capgo offre ai team Capacitor ed Electron bundle live-update firmati, canali mirati, storico delle versioni, osservabilità per dispositivo e protezione rollback per le release compatibili del layer web. Valuta il tuo percorso di recovery attuale e scopri come Capgo può aiutarti a sospendere l'esposizione, ripristinare un bundle noto come funzionante e mantenere il controllo della risposta agli incidenti.





