
Un rollback es una operación de recuperación que revierte un cambio de software o configuración para restaurar un estado anterior estable. En Kubernetes, el historial de despliegue mantiene 10 ReplicaSets antiguos por defecto, mientras que PostgreSQL ROLLBACK descarta las actualizaciones de la transacción actual, no los datos ya confirmados.
Un release sale a producción, los primeros usuarios abren la app y los tickets de soporte llegan antes de que el equipo termine de celebrar. Una pantalla de checkout falla, una nueva respuesta de API rompe un cliente antiguo, o un cambio de configuración desvía las peticiones. El equipo necesita restaurar el servicio sin adivinar qué archivos cambiaron ni pedir a cada usuario que reinstale.
Para eso sirve el rollback. No es prevención, ni un botón mágico de deshacer. El nuevo release ya se aplicó. El rollback es la respuesta controlada cuando ese release causa errores, degradación de rendimiento, crashes o comportamientos inseguros. En la práctica, suele volver a desplegar la versión anterior de la app o restaurar una configuración versionada, y luego verifica que el servicio haya vuelto a un estado aceptable. El técnicas de análisis de fallos las decisiones que tome tu equipo después siguen importando, porque el rollback estabiliza el incidente pero no explica su causa.
Tabla de contenidos
- La realidad de los fallos en el deployment
- Cómo los sistemas modernos preservan el historial de releases
- El peligro oculto de los rollbacks de bases de datos y datos
- Tomar la decisión operativa de revertir
- Recuperación instantánea en apps móviles y multiplataforma
- Crear una estrategia de release resiliente
- Conclusiones clave para despliegues más seguros
La realidad de los fallos en el deployment
Un equipo móvil lanza un nuevo bundle con un cambio de navegación y una actualización de compatibilidad con el backend. Primero lo recibe la audiencia en staging. En minutos, los usuarios reportan que una pantalla principal no carga. El monitoreo muestra un aumento de errores, pero el equipo aún no sabe si el problema viene del bundle, del API, de un feature flag o de una dependencia.
La respuesta segura no es debatir el diagnóstico perfecto mientras crece la audiencia afectada. Si el equipo tiene un artefacto conocido como estable, puede detener el rollout y restaurar esa versión. La aplicación vuelve a un estado validado previamente mientras los ingenieros investigan el defecto y preparan una corrección.
Rollback es recuperación, no prevención
Prevención intentos de evitar que un cambio defectuoso llegue a los usuarios. Las pruebas, la revisión de code, las comprobaciones de dependencias, las releases canary y las puertas de aprobación cumplen ese propósito. El rollback comienza cuando la prevención ha fallado o cuando ha aparecido una interacción inesperada en producción.
Un rollback puede dirigirse a varias partes de un sistema de entrega:
- Aplicación code: Redespliega el ejecutable o bundle web anterior.
- Configuración: Restaura una configuración versionada, regla de enrutamiento o configuración de funcionalidad.
- Recursos: Vuelve a imágenes, scripts o archivos de contenido compatibles.
- Exposición de funcionalidades: Desactiva una nueva funcionalidad mediante un kill switch o control de audiencia.
- Datos: Abortar una transacción activa o restaurar datos desde un backup, con restricciones mucho más estrictas.
La última categoría requiere un tratamiento aparte. Revertir el code de la aplicación suele ser sencillo si los artefactos son inmutables y las dependencias siguen siendo compatibles. Revertir datos confirmados puede causar pérdida, corrupción o problemas regulatorios. Por tanto, un rollback de una release no debería implicar que cualquier operación de base de datos relacionada pueda retroceder de forma segura.
Por qué la entrega frecuente requiere una recuperación rápida
La continuous delivery moderna hace que las releases sean más frecuentes. Esto crea un requisito práctico: el coste operativo de un cambio fallido debe mantenerse limitado. Un equipo que puede desplegar rápido pero necesita un proceso manual largo para recuperarse solo ha optimizado la mitad del delivery.
La reversión manual sigue siendo posible, pero depende de que los operadores recuerden qué archivos cambiaron, qué servidores se actualizaron y qué configuración pertenecía a la release anterior. Ese proceso se vuelve frágil durante un incidente. Los sistemas automatizados mejoran el proceso al conservar artefactos inmutables, monitorizar señales de salud y revertir cuando se cumplen condiciones predefinidas.
Regla práctica: Trata el rollback como una capacidad de producción ensayada, no como un botón de emergencia que alguien tendrá que descifrar durante la caída.
Un rollback tampoco es una solución permanente. Restaura el servicio temporalmente, pero el defecto subyacente sigue ahí. Los ingenieros aún deben identificar el desencadenante, evaluar los datos que se hayan escrito durante el release fallido y lanzar una versión corregida o tomar otra decisión operativa deliberada.
Cómo los sistemas modernos preservan el historial de releases
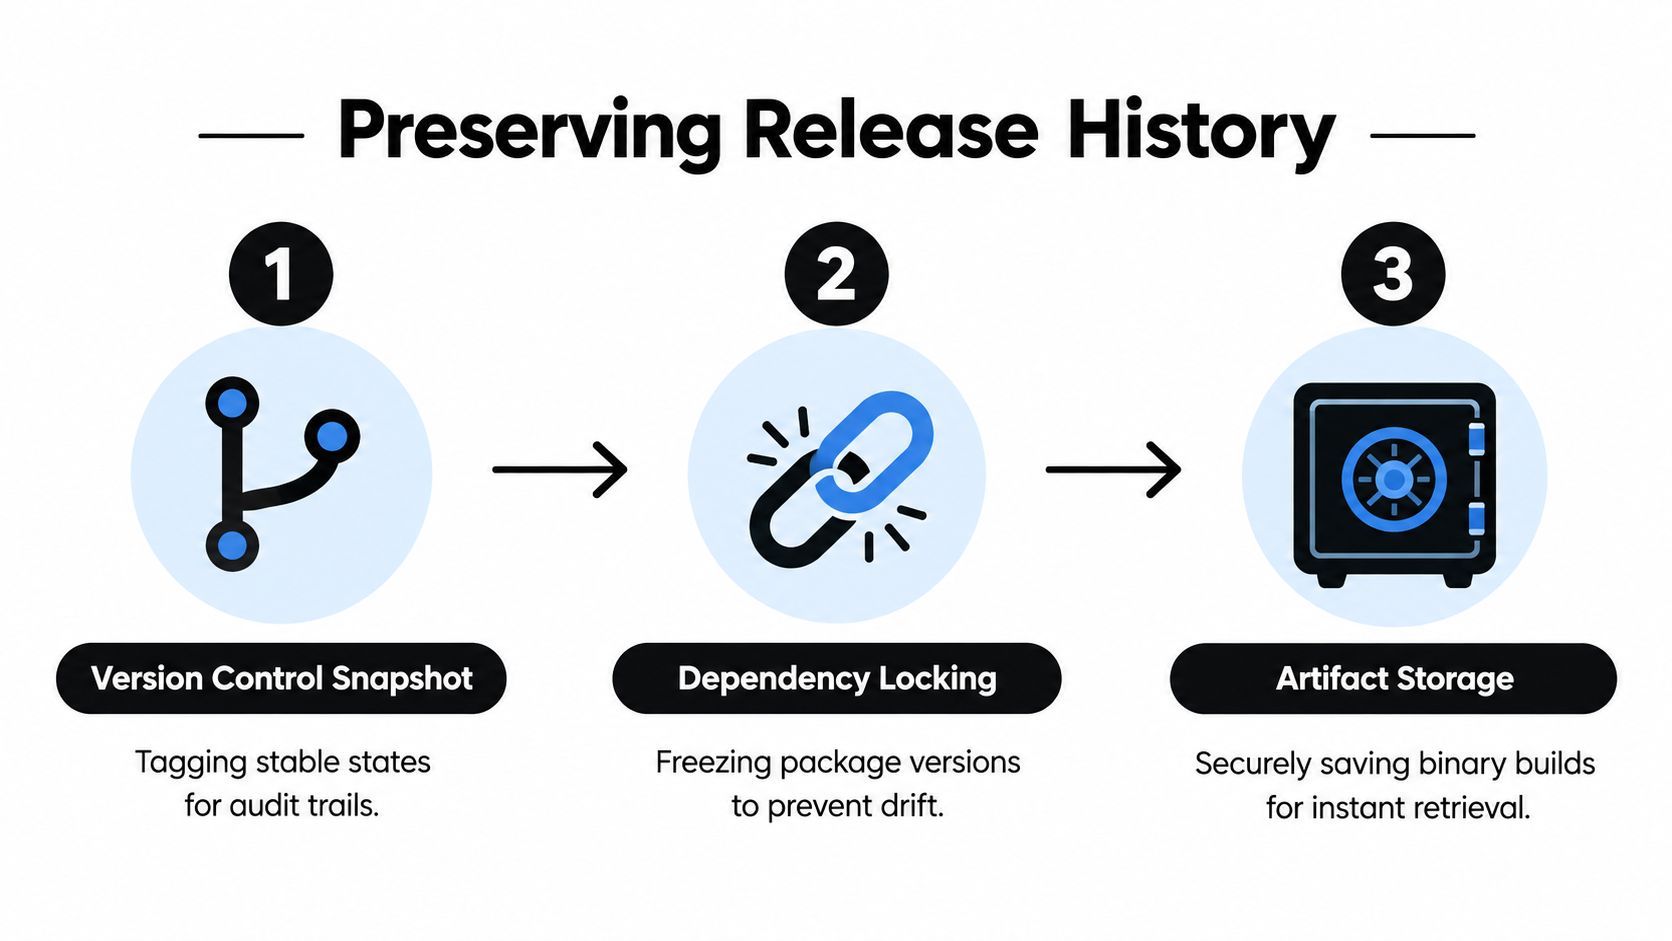
Un sistema de recuperación solo puede restaurar lo que puede identificar y recuperar. Mantener un commit de código fuente antiguo no es suficiente si el build se produjo con dependencias sin fijar, si el binario fue sobrescrito o si el shell nativo ya no soporta el bundle.
Los sistemas de release modernos resuelven esto preservando una cadena de evidencia desde el código fuente hasta el artefacto desplegado. El equipo etiqueta una revisión estable, bloquea el grafo de dependencias, construye un artefacto direccionable y registra qué artefacto llegó a cada entorno. Ese registro da a los operadores un objetivo concreto en lugar de una instrucción ambigua como "volver a la versión anterior".
Kubernetes como modelo concreto
Kubernetes ilustra la estructura claramente. Un Deployment controla ReplicaSets, y esos ReplicaSets preservan las revisiones de despliegue. Kubernetes retiene 10 ReplicaSets antiguos por defecto, y los equipos pueden cambiar esa retención con spec.revisionHistoryLimit. Establecer el valor en 0 deshabilita el rollback por completo, como se documenta en la Referencia de Deployment de Kubernetes.
Un operador puede volver a la revisión inmediatamente anterior o seleccionar una revisión histórica concreta. El rollback cambia la configuración de la plantilla de Pod del Deployment, incluidos campos como la imagen del contenedor y las labels. No revierte automáticamente campos no relacionados, como el número de réplicas. Después, las comprobaciones de rollout status confirman si la revisión de destino quedó saludable.
Esa distinción importa para la entrega de bundles en móvil y web. Un sistema debería registrar:
- La versión activa: Qué release recibió cada entorno, channel o dispositivo.
- La identidad del artifact: Un build inmutable o direccionable por contenido, no un archivo que pueda reemplazarse in situ.
- Compatibilidad de dependencias: Si el bundle anterior funciona con el native shell, las APIs, los servicios y el esquema de datos actuales.
- El resultado de la recuperación: Si los dispositivos o las instancias adoptaron correctamente el release restaurado.
«Anterior» debe referirse a un artifact concreto
Una etiqueta como previous es útil solo cuando resuelve a un release inmutable. Si un equipo sobrescribe el archivo detrás de esa etiqueta, el objetivo de recuperación puede cambiar sin que nadie se dé cuenta. Si el artefacto ha caducado en el almacenamiento, el sistema de despliegue puede conocer el número de revisión pero carecer de los bytes necesarios para restaurarlo.
Para una aplicación Capacitor, el bundle web también se ejecuta dentro de un shell nativo. Un bundle de JavaScript anterior puede depender de plugins nativos, permisos o del comportamiento del bridge que el shell actual haya cambiado. Restaurarlo sin verificar la compatibilidad puede sustituir un incidente por otro.
El Enfoque de Capgo para control de versiones y rollbacks refleja el principio más amplio: el historial de releases debe ser explícito, recuperable y estar vinculado a la audiencia que recibió cada build. El rollback funciona cuando el equipo puede responder rápidamente tres preguntas: ¿qué estaba activo?, ¿qué era estable? y ¿qué puede ejecutarse de forma segura con el resto del sistema actual?
El peligro oculto de los rollbacks de bases de datos y datos
Un deployment fallido puede dejar al equipo con una instrucción urgente: “Solo restaura la versión anterior”. Eso puede funcionar para un code ejecutable, pero puede ser inseguro para una base de datos, donde la actividad ya confirmada de los clientes puede ser imposible de revertir limpiamente.
El rollback de la aplicación y el de datos son operaciones distintas con modos de fallo diferentes. Un release de code a menudo se puede sustituir por otro artefacto inmutable. Una migración de esquema puede haber renombrado o eliminado un campo, transformado los valores almacenados o cambiado las suposiciones de escrituras posteriores. Pedidos, pagos, mensajes, registros y consentimiento son datos de usuario válidos. No deberían desaparecer porque haya fallado un release de la aplicación.
Por qué code y el esquema pueden quedar desincronizados
Supongamos que el release A entiende el esquema antiguo, mientras que el release B añade una columna o cambia cómo se almacena un valor. Tras desplegar B y ejecutar su migración, restaurar A puede hacer que la consulta antigua de code busque campos que ya no existen o interprete mal los datos nuevos.
Lo contrario genera un fallo distinto. Revertir la base de datos mientras los procesos del release B siguen activos puede hacer que fallen las escrituras o dejar estado parcial. Revertir tanto code como la base de datos puede parecer más limpio, pero puede borrar actividad legítima creada tras el despliegue. La distinción entre rollback de aplicación y rollback de datos debe estar en cada plan de release, no solo en las operaciones de base de datos.
PostgreSQL muestra lo que hace un rollback transaccional. ROLLBACK aborta la transacción actual y descarta las actualizaciones realizadas en ella, para que un grupo de escrituras aplicado parcialmente no se vuelva duradero. No puede deshacer cambios confirmados por una transacción anterior. Ejecutarlo ROLLBACK fuera de un bloque de transacción no revierte los datos almacenados.
Diseña migraciones para avanzar
Un diseño de release más seguro mantiene compatibles las versiones de la app y los cambios de esquema durante una transición. Los equipos también deben documentar Prácticas de cifrado de SQLite para apps Capacitor junto con la compatibilidad de esquemas, controles de acceso y procedimientos de recuperación.
Una migración de tipo expand-and-contract suele seguir esta secuencia:
- Expandir: Añade la nueva capacidad al esquema sin eliminar la anterior.
- Adoptar: Despliega code que pueda leer y escribir en ambas representaciones, o introduce la nueva ruta manteniendo la antigua.
- Migrar: Mueve los registros existentes mediante un proceso controlado, con monitoreo y conciliación.
- Contraer: Elimina la estructura antigua solo cuando las versiones dependientes ya no la requieran.
Esta secuencia hace que un rollback de code sea más plausible, ya que la aplicación anterior aún puede usar un esquema que respalda su contrato. No hace que todos los rollbacks sean seguros. Reduce la probabilidad de que la recuperación introduzca una nueva incompatibilidad.
Los sistemas de fintech, salud y comercio electrónico también requieren auditabilidad, controles de privacidad, gestión del estado de pagos y un plan de conciliación. Una corrección hacia adelante puede ser más segura que revertir transacciones válidas o restaurar una instantánea que elimine la actividad posterior del usuario.
Regla de base de datos: Haz rollback de code libremente solo cuando sus dependencias y el contrato de datos lo permitan. Trata los datos comprometidos como un registro de avance hacia adelante, a menos que un procedimiento de restauración separado y probado demuestre lo contrario.
Antes del despliegue, clasifica cada componente de la liberación según su reversibilidad. Code, configuración, exposición de funciones, assets, esquema y datos de usuario siguen reglas de recuperación diferentes. Una copia de seguridad probada puede ayudar tras una corrupción catastrófica, pero restaurar una copia de seguridad no reemplaza el diseño de migraciones compatibles hacia atrás.
Tomar la decisión operativa de revertir
Rollback es una decisión operativa, no solo un comando de despliegue. Alguien debe decidir si el problema observado proviene de la release, si el estado anterior es seguro, si hay suficientes usuarios afectados para justificar la reversión y si una corrección hacia adelante reduciría el riesgo de manera más efectiva.
DORA trata la tasa de fallos en cambios como despliegues que requieren intervención inmediata, a menudo un rollback o hotfix, y rastrea por separado el tiempo de recuperación de despliegues fallidos. Esto hace que el rollback sea a la vez un evento de fiabilidad y un resultado de rendimiento de entrega, como se describe en la historia de las métricas DORA.
Define el trigger antes del incidente
Los buenos equipos acuerdan las condiciones de rollback mientras el release aún se está diseñando. Un trigger puede combinar señales de crash, tasas de error, health checks fallidos, reportes de soporte o una comparación canary. Un evento ruidoso no debería revertir necesariamente un release, pero un patrón claro en una audiencia monitoreada debería tener una respuesta definida.
El rollback automático solo es apropiado cuando el fallo se entiende bien, es reversible y se puede observar mediante señales fiables. Un sistema automatizado que responde a cada anomalía puede empeorar un incidente al oscilar entre versiones, ocultar el fallo subyacente o reintroducir repetidamente una dependencia incompatible.
Para una aplicación móvil, la decisión requiere contexto adicional:
- Usuarios offline: Algunos dispositivos no buscarán actualizaciones de inmediato.
- Versiones mixtas: Los clientes antiguos y nuevos pueden coexistir durante mucho tiempo.
- Exposición escalonada: Un canal o canary puede revelar un problema antes de que lo haga producción.
- Compatibilidad nativa: El web bundle restaurado debe funcionar con el shell instalado.
- Efectos en los datos: Un rollback de code podría no revertir las escrituras ya aceptadas por el backend.
Rollback vs. roll-forward
El rollback restaura un estado anterior. El roll-forward lanza un cambio correctivo. Ninguno es universalmente más seguro.
El rollback suele encajar bien cuando hay un defecto de presentación reversible, una mala configuración o un release que falla antes de cambiar el estado persistente. El roll-forward puede ser más seguro cuando la migración ya se ha ejecutado, los usuarios han creado registros válidos o la versión anterior de la aplicación no admite el esquema actual. Un kill switch puede ser incluso más seguro cuando la funcionalidad defectuosa se puede aislar sin reemplazar todo el release.
El runbook debe designar al incident commander y a la persona autorizada para ejecutar la acción, definir las señales de salud que confirman el éxito y la vía de comunicación para producto y soporte. También debe indicar cuándo el equipo deja de intentar revertir y empieza a aplicar un fix forward.
Un runbook útil registra:
- La revisión de destino y la ubicación de su artifact.
- Los checks de compatibilidad para clientes nativos, servicios, dependencias y esquema.
- El control del radio de impacto, como un canal, una cohorte o un canary.
- Los criterios de éxito, incluyendo señales de recuperación e impacto en usuarios.
- El responsable del seguimiento, encargado del release corregido y de la revisión del incidente.
El la diferencia entre pausar un rollout y hacer un rollback es operativamente importante. Pausar limita la exposición adicional. El rollback cambia activamente lo que reciben los usuarios afectados. Los equipos deben saber qué acción necesitan antes de elegir una.
Recuperación instantánea en apps móviles y multiplataforma
La recuperación tradicional de releases móviles depende de la distribución de la app store. Si el defecto está en el binario nativo, el equipo debe preparar un binario corregido o anterior, enviarlo a la tienda correspondiente y esperar a que la distribución llegue a los usuarios. Ese proceso puede ser adecuado para cambios nativos, pero genera fricción cuando el defecto se limita a JavaScript, CSS, configuración, copy o assets web.
La entrega over-the-air cambia la ruta de recuperación para esos cambios en la capa web. Un sistema live update puede publicar un bundle firmado a una audiencia controlada, permitir que los dispositivos lo apliquen en el próximo inicio o comprobación de actualización, y conservar el bundle anterior como fallback. No elimina la necesidad de revisión en la tienda cuando cambian los code nativos o los permisos de la plataforma, y no hace que el rollback de datos sea seguro.
La distribución en tiendas y las live updates resuelven problemas distintos
| Necesidad de recuperación | Publicación de binario en la tienda | live update firmado |
|---|---|---|
| Cambio en plugin o permiso nativo | Adecuado | No es un reemplazo |
| Defecto en JavaScript o CSS | Ruta de recuperación más lenta | Adecuado cuando la política y la compatibilidad lo permiten |
| Control de audiencia | Canales de la tienda y controles de rollout | Canales segmentados y entrega escalonada |
| Objetivo de recuperación | Binario publicado | Web bundle versionado |
| Dependencia principal | Distribución de la tienda | Updater, firma, compatibilidad y observabilidad |
Una plataforma como Capgo admite Capacitor live updates entregando web bundles firmados a canales específicos, manteniendo el historial de versiones, aplicando actualizaciones en un lanzamiento posterior o al comprobar actualizaciones, y ofreciendo protección de rollback cuando un nuevo bundle no supera los health checks configurados. La entrega diferencial puede enviar solo los archivos cambiados, mientras que los canales permiten separar audiencias beta, staging, producción o clientes específicos. Estas capacidades ayudan a los equipos a reducir el alcance de un release fallido en la capa web, pero no eliminan la necesidad de validar la compatibilidad con el shell nativo o los contratos de datos del backend.
El fallback automático requiere una señal de salud fiable
Un updater no debería marcar un bundle como saludable solo porque la descarga terminó. Debe distinguir entre la descarga, la instalación, el lanzamiento y la salud real de la app. Si el nuevo bundle se cae o no pasa sus health checks en el siguiente inicio, el dispositivo puede volver a la última versión estable sin descargar un binario completo de la App Store.
Esa recuperación también tiene límites. El dispositivo puede estar offline, la actualización fallida puede haber cambiado ya datos del lado del servidor, o el bundle anterior puede ser incompatible con el native shell instalado. Los logs por dispositivo y los datos de adopción de versiones ayudan al soporte a determinar qué usuarios recibieron qué bundle y si el fallback funcionó.
El Guía de configuración del rollback de actualizaciones de Capacitor debe acompañar a una política de release, no reemplazarla. Firma cada artefacto, restringe quién puede publicar en canales de producción, conserva la versión de fallback y prueba la ruta de fallo en dispositivos reales. La distribución rápida solo vale algo si el sistema puede demostrar que el bundle restaurado es el previsto.
Crear una estrategia de release resiliente
La preparación para el rollback es una propiedad de todo el sistema de release. Un build antiguo en object storage no protege de verdad si el equipo no puede identificar sus dependencias, no ve qué dispositivos lo adoptaron o nunca ha probado la recuperación con datos similares a producción.
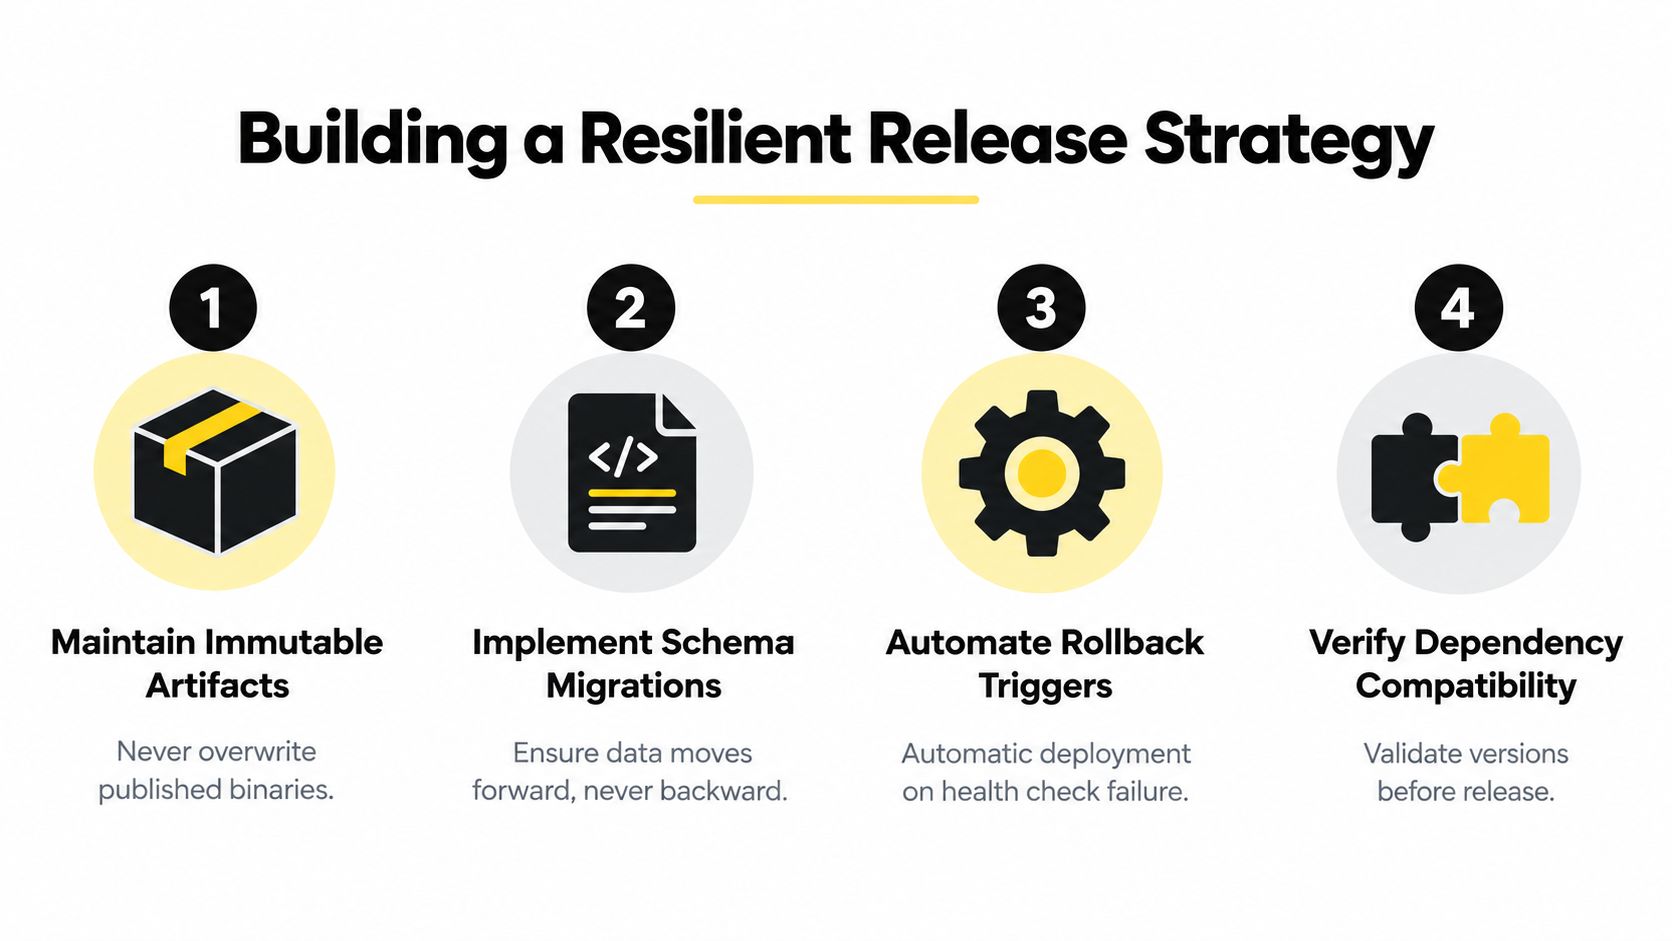
Comienza con la cadena de artefactos. Etiqueta estados estables del código fuente, bloquea dependencias, conserva builds firmados y no sobrescribas nunca una release publicada. Luego, conecta cada artefacto con un entorno, un canal y un evento de despliegue. El equipo debe poder reconstruir lo ocurrido sin depender de la máquina local de un desarrollador.
Cuatro controles para reducir el riesgo de recuperación
- Artefactos inmutables: Almacena cada bundle de producción bajo una identidad única. Un puntero «anterior» puede seleccionar una release, pero no debe modificar la release en sí.
- Migraciones compatibles: Usa técnicas expand-and-contract para que las versiones antiguas y nuevas de la aplicación puedan coexistir durante una transición controlada.
- Automatización protegida: Automatiza el fallback solo para señales que distinguen una falla real de la versión de un problema transitorio del servicio.
- Validación de dependencias: Verifica el shell nativo, plugins, APIs, servicios y esquema antes de permitir que una revisión objetivo se active.
La observabilidad cierra el ciclo. Captura la versión por dispositivo, resultado del lanzamiento, estado de la actualización, motivo de la falla y estado de adopción. Esos registros permiten al soporte responder si un usuario sigue en el bundle fallido, ya recibió el fallback o nunca descargó la actualización.
Los equipos deben ensayar la ruta de recuperación con datos realistas y versiones de cliente mixtas. Una prueba que restaura code contra una base de datos de desarrollo vacía puede pasar por alto la incompatibilidad causada por registros reales, variantes antiguas del esquema, escrituras en cola y migraciones parcialmente completadas. La prueba de recuperación también debe verificar la autorización, la firma, la recuperación de artefactos, el targeting de canales y el plan de comunicación.
La recuperación no se mide por la existencia de un build antiguo. Se mide por la precisión con la que el equipo puede controlar el impacto y restaurar un estado compatible.
La planificación de releases debe incluir una propiedad explícita para la coordinación de dependencias. Los equipos que necesitan un framework más amplio para gestionar dependencias en ágil pueden usar esa disciplina de planificación para alinear cambios en móvil, backend, base de datos y producto antes del despliegue.
Una revisión práctica de preparación pregunta:
- ¿Puede el equipo identificar el artefacto exacto activo en cada canal?
- ¿Puede pausar la exposición sin cambiar los code ya instalados?
- ¿Puede restaurar un bundle firmado y compatible?
- ¿Puede demostrar que la base de datos sigue a salvo tras un rollback de la aplicación?
- ¿Puede detectar fallos por versión y no solo a nivel agregado del servicio?
- ¿Puede optar por un roll-forward si revertir dañaría datos válidos?
Si alguna respuesta no está clara, el proceso de release tiene un vacío de recuperación. Corregir ese vacío antes del próximo incidente es más barato que improvisar mientras los usuarios esperan.
Conclusiones clave para despliegues más seguros
Un rollback revierte un cambio de software o de configuración aplicado para restaurar un estado válido conocido. No evita defectos, no repara la causa subyacente ni deshace automáticamente los cambios confirmados en la base de datos.
Mantén los artifacts de la aplicación inmutables y direccionables. Rastrea la versión activa, las dependencias, la compatibilidad con el shell nativo y el público de cada release. Trata las migraciones de esquema y los datos de usuario como objetivos de recuperación separados, porque un rollback de code puede dejar la base de datos modificada y un rollback de base de datos puede destruir registros válidos.
Usa entregas escalonadas, señales de salud fiables, autorización explícita y un runbook probado. Para equipos móviles, los bundles firmados vía OTA pueden permitir una recuperación rápida en cambios compatibles de la capa web, mientras que los cambios nativos siguen requiriendo la ruta de release del binario adecuada. Mide la recuperación por la reducción del radio de impacto y la restauración verificada del servicio, no por la presencia de un build antiguo.
Capgo ofrece a los equipos de Capacitor y Electron bundles firmados de live-update, canales segmentados, historial de versiones, observabilidad por dispositivo y protección de rollback para releases compatibles de la capa web. Revisa tu ruta de recuperación actual y mira cómo Capgo puede ayudarte a pausar la exposición, restaurar un bundle estable y mantener el control durante la respuesta a incidentes.





