
Le rollback est une opération de récupération qui annule un changement de logiciel ou de configuration pour restaurer un état antérieur stable. Dans Kubernetes, l'historique de déploiement conserve 10 anciens ReplicaSets par défaut, tandis que PostgreSQL ROLLBACK annule les mises à jour de la transaction en cours, et non les données précédemment validées.
Une release est déployée, les premiers utilisateurs ouvrent l'app, et les tickets de support arrivent avant même que l'équipe produit n'ait fini de fêter ça. Un écran de paiement plante, une nouvelle réponse API casse un client plus ancien, ou un changement de configuration envoie les requêtes sur le mauvais chemin. L'équipe doit rétablir le service sans deviner quels fichiers ont changé ni demander à chaque utilisateur de réinstaller l'app.
C'est là qu'intervient le rollback. Ce n'est pas de la prévention, ni un bouton « annuler » magique. La nouvelle release a déjà été appliquée. Le rollback est la réponse maîtrisée quand cette release provoque des erreurs, des performances dégradées, des crashs ou un comportement dangereux. En pratique, il redéploie généralement la version précédente de l'application ou restaure une configuration versionnée, puis vérifie que le service est revenu à un état acceptable. Le techniques d'analyse des défaillances les pratiques de votre équipe après l’incident comptent toujours, car le rollback stabilise la situation sans en expliquer la cause.
Table des matières
- La réalité des échecs de déploiement
- How Modern Systems Preserve Release History
- Le danger caché des rollbacks de bases de données et données
- Prendre la décision opérationnelle de rollback
- Récupération instantanée pour les apps mobiles et multiplateformes
- Construire une stratégie de release résiliente
- Points clés pour des déploiements plus sûrs
La réalité des échecs de déploiement
Une équipe mobile déploie un nouveau bundle contenant une modification de navigation et une mise à jour de compatibilité backend. Le public en déploiement progressif le reçoit en premier. En quelques minutes, les utilisateurs signalent qu’un écran principal ne se charge plus. La surveillance montre une hausse des erreurs, mais l’équipe ne peut pas encore déterminer si le problème provient du bundle, de API, d’un feature flag ou d’une dépendance.
La réponse prudente n’est pas de débattre du diagnostic parfait pendant que le public affecté s’agrandit. Si l’équipe dispose d’un artefact connu bon, elle peut arrêter le déploiement progressif et restaurer cette version. L’application revient à un état précédemment validé pendant que les ingénieurs investiguent le défaut et préparent une correction.
Le rollback sert à récupérer, pas à prévenir
Prévention vise à empêcher un changement problématique d'atteindre les utilisateurs. Les tests, la revue de code, les vérifications des dépendances, les canary releases et les étapes d'approbation servent cet objectif. Le rollback intervient après l'échec de la prévention ou après l'apparition d'une interaction inattendue en production.
Un rollback peut cibler plusieurs parties d'un système de déploiement :
- code de l'application : Redéployer l'exécutable ou le bundle web précédent.
- Configuration : Restaurer un paramètre versionné, une règle de routage ou une configuration de fonctionnalité.
- Assets : Revenir à des images, scripts ou fichiers de contenu compatibles.
- Exposition des fonctionnalités : Désactivez une nouvelle fonctionnalité via un kill switch ou un contrôle d'audience.
- Données : Annulez une transaction active ou restaurez des données à partir d'une sauvegarde, sous des contraintes bien plus strictes.
La dernière catégorie nécessite un traitement distinct. Revenir à un code applicatif est souvent simple lorsque les artefacts sont immuables et les dépendances compatibles. Revenir sur des données commitées peut causer des pertes, des corruptions ou des problèmes réglementaires. Un rollback de release ne doit donc pas laisser entendre que toute opération de base de données associée peut être annulée sans risque.
Pourquoi la livraison fréquente exige une récupération rapide
La livraison continue moderne rend les releases plus fréquentes. Cela crée une exigence pratique : le coût opérationnel d'un changement échoué doit rester limité. Une équipe capable de déployer rapidement mais qui a besoin d'un long processus manuel pour récupérer n'a optimisé que la moitié de sa livraison.
Le retour arrière manuel reste possible, mais il repose sur la capacité des opérateurs à se souvenir des fichiers modifiés, des serveurs mis à jour et de la configuration de la release précédente. Ce processus devient fragile lors d'un incident. Les systèmes automatisés fiabilisent le parcours en conservant des artefacts immuables, en surveillant les signaux de santé et en effectuant un rollback lorsque des conditions prédéfinies sont remplies.
Règle pratique : Considérez le rollback comme une capacité de production rodée, pas comme un bouton d'urgence que quelqu'un devra improviser pendant la panne.
Un rollback n'est pas non plus une solution permanente. Il restaure le service temporairement, mais le défaut sous-jacent persiste. Les ingénieurs doivent encore identifier le déclencheur, évaluer les données écrites pendant la release qui a échoué, et déployer une version corrigée ou prendre une autre décision opérationnelle délibérée.
How Modern Systems Preserve Release History
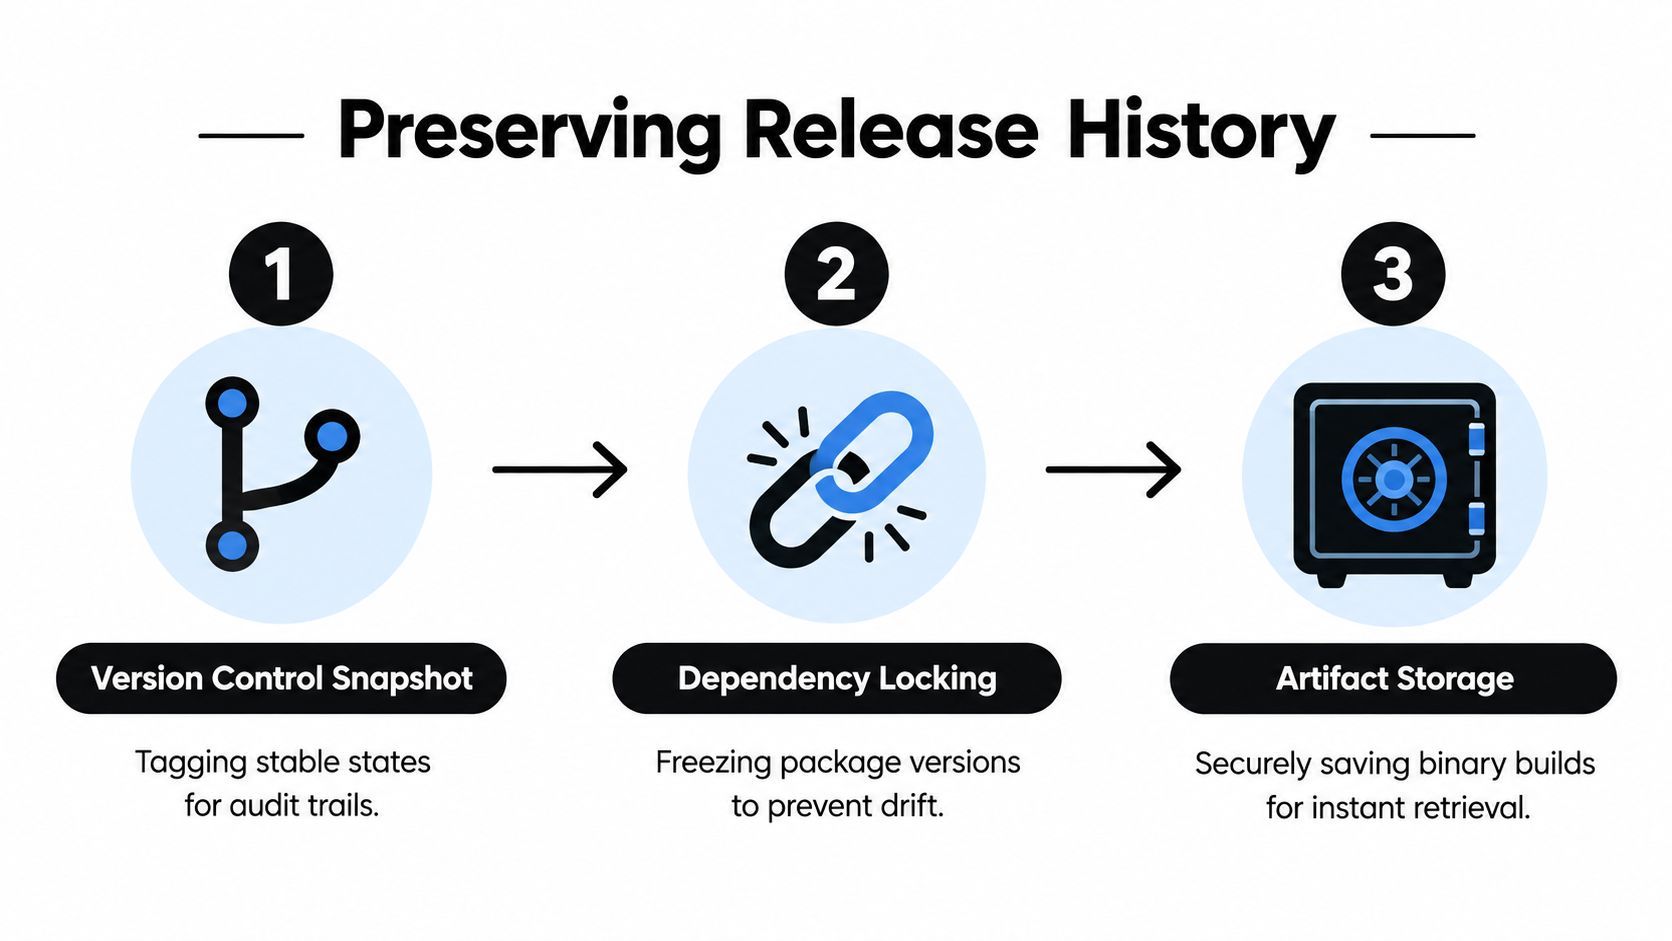
Un système de récupération ne peut restaurer que ce qu'il peut identifier et récupérer. Conserver un ancien commit source ne suffit pas si le build a été produit avec des dépendances qui ont dérivé, si le binaire a été écrasé ou si le shell natif ne prend plus en charge le bundle.
Les systèmes de release modernes résolvent ce problème en préservant une chaîne de preuves, de la source jusqu'à l'artefact déployé. L'équipe pose un tag sur une révision stable, verrouille le graphe de dépendances, produit un artefact adressable et enregistre quel artefact a atteint chaque environnement. Cet enregistrement donne aux opérateurs une cible précise plutôt qu'une instruction ambiguë telle que « revenez à la version précédente ».
Kubernetes comme modèle concret
Kubernetes illustre clairement cette structure. Un Deployment contrôle les ReplicaSets, et ces ReplicaSets préservent les révisions de déploiement. Kubernetes conserve 10 anciens ReplicaSets par défaut, et les équipes peuvent modifier cette rétention avec spec.revisionHistoryLimit. En réglant la valeur sur 0, le rollback est entièrement désactivé, comme documenté dans le Référence du Deployment Kubernetes.
Un opérateur peut revenir à la révision immédiatement précédente ou sélectionner une révision historique précise. Le rollback modifie la configuration du template de Pod du Deployment, notamment des champs comme l'image du conteneur et les labels. Il ne rétablit pas automatiquement les champs sans rapport, comme le nombre de réplicas. Ensuite, les contrôles de rollout status confirment si la révision cible est devenue saine.
Cette distinction est cruciale pour la livraison de bundles web et mobiles. Un système doit enregistrer :
- La version active : Quelle release chaque environnement, canal ou appareil a reçue.
- L'identité de l'artefact : Un build adressable par le contenu ou autrement immuable, et non un fichier pouvant être remplacé sur place.
- La compatibilité des dépendances : Si le bundle précédent fonctionne avec le shell natif, les API, les services et le schéma de données actuels.
- Le résultat de la récupération : Si les appareils ou instances ont adopté avec succès la release restaurée.
« Précédent » doit désigner un artefact spécifique
Un label tel que previous n'est utile que s'il correspond à une release immuable. Si une équipe écrase le fichier associé à ce label, la cible de récupération peut changer sans que personne ne s'en aperçoive. Si l'artefact a expiré et n'est plus disponible dans le stockage, le système de déploiement peut connaître le numéro de révision mais ne pas avoir les octets nécessaires pour le restaurer.
Pour une application Capacitor, le bundle web s'exécute également à l'intérieur d'un shell natif. Un bundle JS précédent peut dépendre de plugins natifs, de permissions ou d'un comportement du bridge que le shell actuel a modifié. Le restaurer sans vérifier la compatibilité peut remplacer un incident par un autre.
Le L'approche de Capgo pour le versionnage et les rollbacks reflète un principe plus large : l'historique des releases doit être explicite, récupérable et lié à l'audience ayant reçu chaque build. Un rollback réussit lorsque l'équipe peut répondre rapidement à trois questions : qu'est-ce qui était actif, qu'est-ce qui était stable, et qu'est-ce qui peut s'exécuter en toute sécurité avec le système environnant actuel ?
Le danger caché des rollbacks de bases de données et données
Un déploiement échoué peut laisser l'équipe face à une instruction urgente : « Restaurez simplement la version précédente. » Cela peut fonctionner pour du code exécutable. Cela peut être risqué pour une base de données, où l'activité client validée peut s'avérer impossible à annuler proprement.
Le rollback d'application et le rollback de données sont des opérations différentes avec des modes d'échec distincts. Une release code peut souvent être remplacée par un autre artefact immuable. Une migration de schéma peut avoir renommé ou supprimé un champ, transformé des valeurs stockées ou modifié les hypothèses utilisées par les écritures ultérieures. Les commandes, paiements, messages, enregistrements et consentements sont des données utilisateur valides. Ces données ne doivent pas disparaître parce qu'une release applicative a échoué.
Pourquoi code et le schéma peuvent se désynchroniser
Supposons que la release A comprenne l'ancien schéma, tandis que la release B ajoute une colonne ou modifie la façon dont une valeur est stockée. Une fois B déployée et sa migration exécutée, revenir à A peut amener l'ancienne code à interroger des champs qui n'existent plus ou à mal interpréter les nouvelles données.
L'inverse provoque un autre type d'échec. Revenir à la version précédente de la base de données alors que les processus de la release B restent actifs peut faire échouer les écritures ou laisser un état partiel. Faire un rollback de code et de la base de données peut sembler plus net, mais peut effacer l'activité légitime créée après le déploiement. La distinction entre rollback d'application et rollback de données fait partie de tout plan de release, pas seulement des opérations en base de données.
PostgreSQL illustre le fonctionnement d'un rollback transactionnel. ROLLBACK annule la transaction en cours et abandonne les mises à jour effectuées dans cette transaction, afin qu'un groupe d'écritures partiellement appliqué ne devienne pas durable. Il ne peut pas annuler les changements validés par une transaction précédente. L'exécution ROLLBACK en dehors d'un bloc de transaction n'inverse pas les données stockées.
Concevez des migrations pour aller de l'avant
Une conception de release plus sûre garantit la compatibilité des versions d'application et des changements de schéma pendant une transition. Les équipes doivent également documenter Pratiques de chiffrement SQLite pour les apps Capacitor ainsi que la compatibilité des schémas, les contrôles d'accès et les procédures de récupération.
Une migration de type « expand-and-contract » suit généralement cette séquence :
- Étendre : Ajoutez la nouvelle capacité du schéma sans supprimer l'ancienne.
- Adopter : Déployez code en mesure de lire et d'écrire les deux représentations, ou introduisez le nouveau chemin tout en conservant l'ancien.
- Migrer : Déplacez les enregistrements existants via un processus contrôlé, avec monitoring et réconciliation.
- Réduire : Supprimez l'ancienne structure uniquement lorsque les versions dépendantes n'en ont plus besoin.
Cette séquence rend un rollback code plus envisageable, car l’ancienne application peut encore s’appuyer sur un schéma qui prend en charge son contrat. Cela ne rend pas chaque rollback sûr pour autant. Cela réduit le risque que la récupération introduise une nouvelle incompatibilité.
Les systèmes fintech, de santé et e-commerce ont aussi besoin d’auditabilité, de contrôles de confidentialité, d’une gestion de l’état des paiements et d’un plan de réconciliation. Un correctif en avant peut être plus sûr qu’annuler des transactions valides ou restaurer un snapshot qui supprime l’activité utilisateur ultérieure.
Règle de base de données : Vous ne pouvez faire un rollback code librement que si ses dépendances et son contrat de données le permettent. Considérez les données commitées comme un enregistrement qui ne fait qu’avancer, sauf si une procédure de restauration distincte et testée prouve le contraire.
Avant le déploiement, classez chaque composant de la release selon sa réversibilité. Code, la configuration, l’exposition des fonctionnalités, les assets, le schéma et les données utilisateur suivent des règles de récupération différentes. Une sauvegarde testée peut aider après une corruption catastrophique, mais restaurer une sauvegarde ne remplace pas une conception de migration rétrocompatible.
Prendre la décision opérationnelle de rollback
Le rollback est une décision opérationnelle, pas simplement une commande de déploiement. Quelqu’un doit décider si le problème observé vient de la release, si l’état précédent est sûr, si assez d’utilisateurs sont affectés pour justifier un retour en arrière, et si un correctif en avant réduirait plus efficacement le risque.
Pour DORA, le taux d’échec des changements correspond aux déploiements qui nécessitent une intervention immédiate, souvent un rollback ou un hotfix, et le temps de récupération après un déploiement échoué est suivi séparément. Le rollback est donc à la fois un événement de fiabilité et un indicateur de performance de livraison, comme décrit dans l’ historique des métriques DORA.
Définir le déclencheur avant l’incident
Les bonnes équipes définissent les conditions de rollback dès la conception de la release. Un déclencheur peut combiner des signaux de crash, des taux d’erreur, des health checks en échec, des retours du support ou une comparaison canary. Un événement isolé ne doit pas forcément annuler une release, mais un motif clair sur un public surveillé doit avoir une réponse définie.
Le rollback automatique n’est approprié que lorsque l’échec est bien compris, réversible et observable via des signaux fiables. Un système automatisé qui réagit à chaque anomalie peut aggraver un incident en oscillant entre les versions, en masquant le défaut sous-jacent ou en réintroduisant à répétition une dépendance incompatible.
Pour une application mobile, la décision demande un contexte supplémentaire :
- Utilisateurs hors ligne : Certains appareils ne vérifient pas immédiatement les mises à jour.
- Versions mixtes : Les anciens et nouveaux clients peuvent coexister longtemps.
- Exposition progressive : Un canal ou un canary peut révéler un problème avant la production.
- Compatibilité native : Un bundle web restauré doit fonctionner avec le shell installé.
- Effets sur les données : Un rollback code peut ne pas annuler les écritures déjà acceptées par le backend.
Rollback ou roll-forward
Le rollback restaure un état antérieur. Le roll-forward déploie un correctif. Aucun n'est universellement plus sûr.
Le rollback convient généralement à un défaut d'affichage réversible, une mauvaise configuration ou une release qui échoue avant de modifier l'état persistant. Le roll-forward peut être plus sûr si la migration a déjà été exécutée, si les utilisateurs ont créé des enregistrements valides, ou si la version précédente de l'application ne prend pas en charge le schéma actuel. Un kill switch peut être encore plus sûr si la fonctionnalité défectueuse peut être isolée sans remplacer toute la release.
Le runbook doit nommer le responsable de l'incident, la personne autorisée à exécuter l'action, les signaux de santé confirmant le succès, et le canal de communication pour le produit et le support. Il doit également préciser quand l'équipe cesse de tenter un rollback pour commencer à corriger en mode roll-forward.
Un runbook utile enregistre :
- La révision cible et l'emplacement de son artefact.
- Les vérifications de compatibilité pour les clients natifs, les services, les dépendances et le schéma.
- Le contrôle du rayon d'impact, comme un canal, une cohorte ou un canary.
- Les critères de succès, y compris les signaux de récupération et l'impact utilisateur.
- Le responsable du suivi, chargé de la release corrigée et de la revue d'incident.
Le la différence entre mettre en pause un déploiement et faire un rollback est cruciale sur le plan opérationnel. La mise en pause limite l'exposition supplémentaire. Le rollback modifie activement ce que reçoivent les utilisateurs affectés. Les équipes doivent savoir quelle action elles doivent prendre avant de choisir l'une ou l'autre.
Récupération instantanée pour les apps mobiles et multiplateformes
La récupération classique d'une release mobile dépend de la distribution via les stores. Si le défaut est dans le binaire natif, l'équipe doit préparer un binaire corrigé ou précédent, le soumettre au store concerné et attendre que la distribution atteigne les utilisateurs. Ce processus peut convenir aux changements natifs, mais il crée des frictions lorsque le défaut est limité au JavaScript, au CSS, à la configuration, au texte ou aux assets web.
La diffusion OTA modifie le chemin de récupération pour les modifications de la couche web. Un système live update peut publier un bundle signé auprès d'une audience contrôlée, permettre aux appareils de l'appliquer au prochain lancement ou à la prochaine vérification de mise à jour, et conserver le bundle précédent comme solution de repli. Cela ne dispense pas d'une validation par les stores lorsque les code natifs ou les permissions de la plateforme changent, et ne rend pas un rollback de données sûr.
Distribution via les stores et live updates : des problèmes distincts
| Besoin de récupération | Release binaire via les stores | live update signé |
|---|---|---|
| Modification d'un plugin natif ou d'une permission | Approprié | Pas un remplacement |
| Bug JavaScript ou CSS | Processus de récupération plus lent | Adapté si la politique et la compatibilité le permettent |
| Contrôle de l'audience | Canaux des stores et contrôles de déploiement | Canaux ciblés et déploiement progressif |
| Cible de récupération | Binaire publié | Bundle web versionné |
| Dépendance principale | Distribution via les stores | Updater, signature, compatibilité et observabilité |
Une plateforme telle que Capgo prend en charge les live updates Capacitor en livrant des bundles web signés vers des canaux ciblés, en conservant l'historique des versions, en appliquant les mises à jour lors d'un lancement ultérieur ou d'une vérification de mise à jour, et en offrant une protection contre le rollback lorsqu'un nouveau bundle échoue aux health checks configurés. La livraison différentielle peut n'envoyer que les fichiers modifiés, tandis que les canaux permettent de séparer les audiences bêta, staging, production ou spécifiques à un client. Ces fonctionnalités aident les équipes à réduire la portée d'une release défaillante de la couche web, mais elles ne dispensent pas de valider la compatibilité du shell natif ou les contrats de données du backend.
Le fallback automatique nécessite un signal de santé fiable
Un système de mise à jour ne devrait pas considérer un bundle comme sain simplement parce que le téléchargement est terminé. Il doit distinguer la récupération, l'installation, le lancement et l'état de santé réel de l'application. Si le nouveau bundle plante ou échoue à ses contrôles de santé au lancement suivant, l'appareil peut revenir à la dernière version stable sans télécharger un binaire complet depuis le store.
Cette récupération a tout de même des limites. Un appareil peut être hors ligne, la mise à jour échouée peut avoir déjà modifié des données côté serveur, ou l'ancien bundle peut être incompatible avec le shell natif installé. Les logs par appareil et les données d'adoption des versions aident le support à déterminer quels utilisateurs ont reçu quel bundle et si le fallback a fonctionné.
Le Guide de configuration du rollback de mise à jour Capacitor doit accompagner une politique de release, et non la remplacer. Signez chaque artefact, limitez qui peut publier sur les canaux de production, conservez la version de fallback et testez le scénario d'échec sur de vrais appareils. Une distribution rapide n'est précieuse que si le système peut prouver que le bundle restauré est bien celui prévu.
Construire une stratégie de release résiliente
La préparation au rollback est une propriété de l'ensemble du système de release. Un ancien build dans un object storage n'offre pas de protection réelle si l'équipe ne peut pas identifier ses dépendances, ne voit pas quels appareils l'ont adopté, ou n'a jamais testé la récupération avec des données proches de la production.
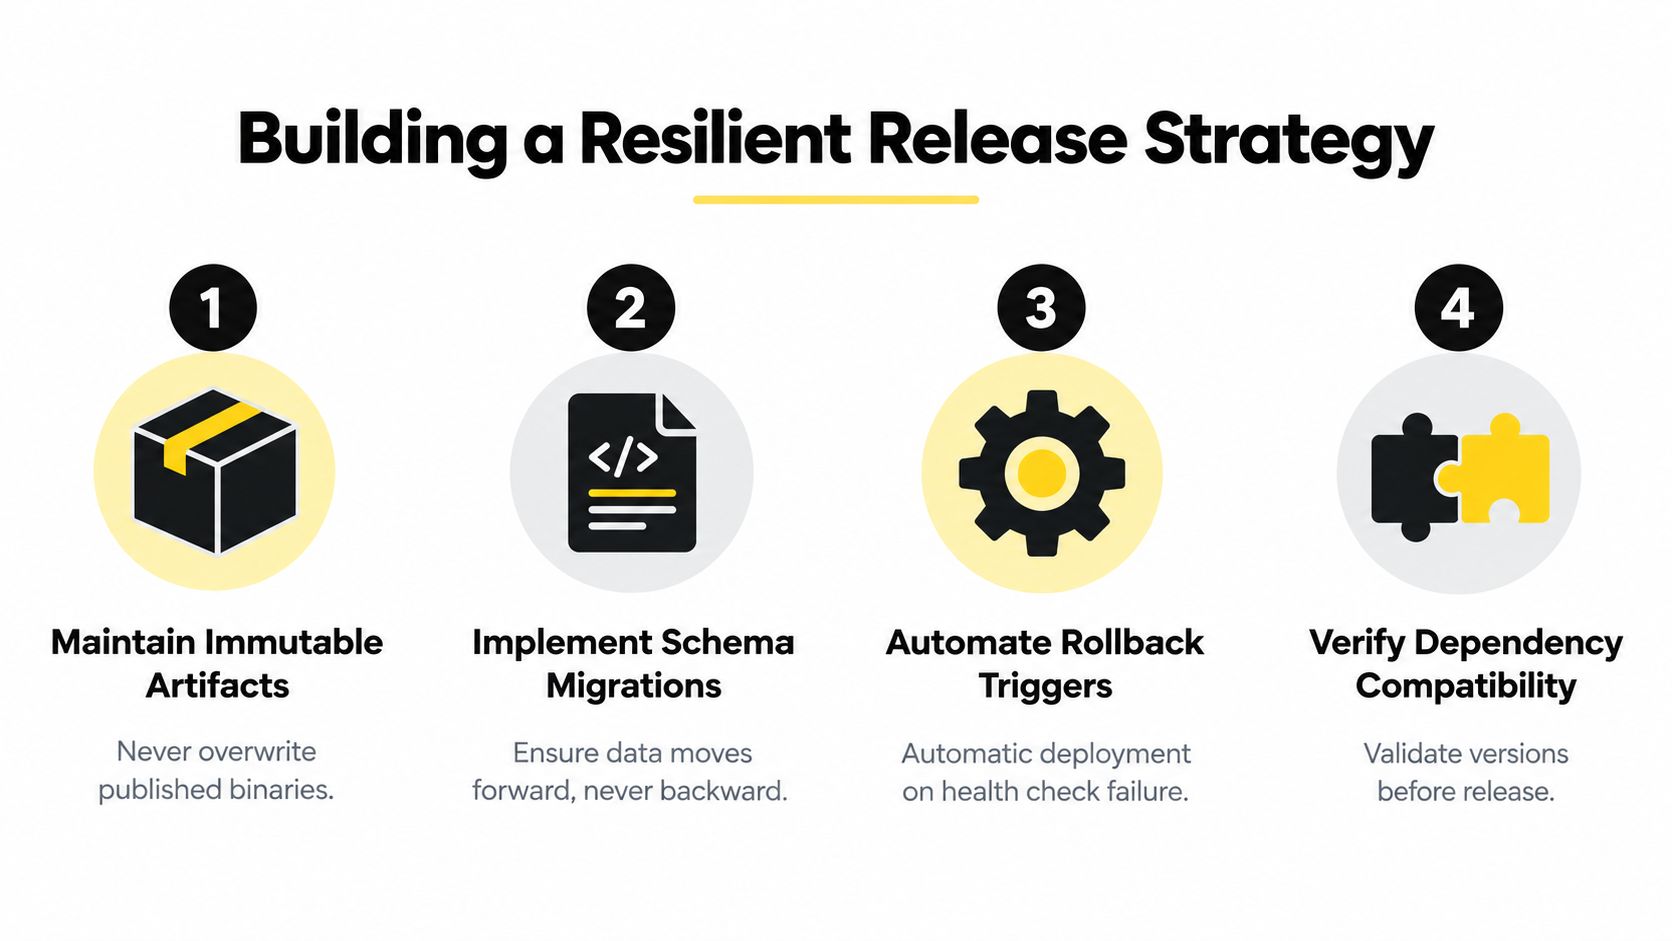
Commencez par la chaîne d'artefacts. Taguez les états stables du code source, verrouillez les dépendances, conservez les builds signés et n'écrasez jamais une release publiée. Connectez ensuite chaque artefact à un environnement, un canal et un événement de déploiement. L'équipe doit pouvoir reconstituer ce qui s'est passé sans dépendre de la machine locale d'un développeur.
Quatre contrôles pour réduire le risque de récupération
- Artefacts immuables : Stockez chaque bundle de production sous une identité unique. Un pointeur « précédent » peut sélectionner une release, mais il ne doit pas modifier la release elle-même.
- Migrations compatibles : Utilisez des techniques d'expand-and-contract pour permettre la coexistence des anciennes et nouvelles versions de l'application lors d'une transition contrôlée.
- Automatisation encadrée : Automatisez le fallback uniquement pour les signaux qui distinguent l'échec d'une réelle release d'un problème de service passager.
- Validation des dépendances : Vérifiez le shell natif, les plugins, les API, les services et le schéma avant d'autoriser l'activation d'une révision cible.
L'observabilité referme la boucle. Capturez la version par appareil, le résultat du lancement, le statut de la mise à jour, la raison de l'échec et l'état d'adoption. Ces enregistrements permettent au support de savoir si un utilisateur est toujours sur le bundle défectueux, s'il a déjà reçu le fallback ou s'il n'a jamais téléchargé la mise à jour.
Les équipes doivent répéter le parcours de récupération avec des données réalistes et des versions client hétérogènes. Un test qui restaure code sur une base de développement vide peut passer à côté des incompatibilités dues aux enregistrements réels, aux anciennes variantes de schéma, aux écritures en file d'attente et aux migrations partiellement terminées. Les tests de récupération doivent aussi vérifier l'autorisation, la signature, la récupération des artefacts, le ciblage des canaux et le plan de communication.
La capacité de récupération ne se mesure pas à l'existence d'un ancien build. Elle se mesure à la précision avec laquelle l'équipe peut contrôler l'impact et restaurer un état compatible.
La planification des releases doit inclure une responsabilité explicite pour la coordination des dépendances. Les équipes qui ont besoin d'un framework plus large pour gérer les dépendances en agile peut utiliser cette discipline de planification pour aligner les changements mobiles, backend, base de données et produit avant le déploiement.
Un bilan de préparation concret pose la question :
- L'équipe peut-elle identifier l'artefact exact actif sur chaque canal ?
- Peut-elle suspendre l'exposition sans modifier les code déjà installés ?
- Peut-elle restaurer un bundle signé et compatible ?
- Peut-elle prouver que la base de données reste intacte après un rollback de l'application ?
- Peut-elle détecter les échecs par version plutôt qu'au seul niveau global du service ?
- Peut-elle choisir un roll-forward quand un retour en arrière endommagerait des données valides ?
Si une réponse reste floue, le processus de release présente une faille de récupération. Combler cette faille avant le prochain incident coûte moins cher que d'improviser pendant que les utilisateurs attendent.
Points clés pour des déploiements plus sûrs
Le rollback annule une modification logicielle ou de configuration appliquée pour restaurer un état stable connu. Il n'empêche pas les défauts, ne corrige pas la cause sous-jacente et n'annule pas automatiquement les changements validés en base de données.
Gardez les artefacts d'application immuables et adressables. Suivez la version active, les dépendances, la compatibilité avec le shell natif et l'audience pour chaque release. Traitez les migrations de schéma et les données utilisateur comme des cibles de récupération distinctes, car un rollback code peut laisser la base de données modifiée, tandis qu'un rollback de base de données peut détruire des enregistrements valides.
Utilisez un déploiement progressif, des signaux de santé fiables, une autorisation explicite et un runbook testé. Pour les équipes mobiles, des bundles OTA signés permettent une récupération rapide des changements compatibles de la couche web, tandis que les changements natifs nécessitent toujours le circuit de publication binaire adapté. Mesurez la récupération par la réduction du périmètre d'impact et la restauration vérifiée du service, et non par la simple présence d'un ancien build.
Capgo offre aux équipes Capacitor et Electron des bundles live update signés, des canaux ciblés, l'historique des versions, l'observabilité par appareil et une protection contre les rollbacks pour les releases compatibles de la couche web. Passez en revue votre processus de récupération actuel et voyez comment Capgo peut vous aider à limiter l'exposition, à restaurer un bundle stable et à garder le contrôle lors de la gestion d'incidents.





