
ロールバックは、ソフトウェアまたは設定の変更を元に戻し、以前に正常だった状態を復元する回復操作です。Kubernetes では、デプロイ履歴が保持されます 10個の古いReplicaSetを保持し、、一方 PostgreSQL は ROLLBACK 、以前にコミットされたデータではなく、現在のトランザクションで行われた更新を破棄します。
リリースが公開され、最初のユーザーがアプリを開いた瞬間、プロダクトチームが祝杯を上げる前にサポートチケットが届きます。チェックアウト画面がクラッシュしたり、新しい API レスポンスが旧クライアントを壊したり、設定変更がリクエストを誤ったパスに送ったりします。チームは、どのファイルが変更されたかを推測したり、すべてのユーザーに再インストールを求めたりすることなく、サービスを復元する必要があります。
ロールバックはまさにそのために存在します。これは予防策でも、魔法の元に戻すボタンでもありません。新しいリリースはすでに適用されています。ロールバックは、そのリリースがエラー、パフォーマンス低下、クラッシュ、または安全でない動作を引き起こした場合の制御された対応です。実際には、通常は以前のアプリケーションバージョンを再デプロイするか、バージョン管理された設定を復元し、その後、サービスが許容可能な状態に戻ったことを確認します。 障害解析の手法 ロールバックはインシデントを収束させますが、原因を解明するわけではないため、その後にチームが行う解析手法が重要になります。
目次
- デプロイ失敗の現実
- モダンなシステムにおけるリリース履歴の保持方法
- データベースとデータの切り戻りに潜む危険性
- リバートを決断する運用判断
- モバイル・クロスプラットフォームアプリにおける即時リカバリ
- レジリエントなリリース戦略の構築
- より安全なデプロイの要点
デプロイ失敗の現実
モバイルチームが、ナビゲーションの変更とバックエンドの互換性アップデートを含む新しいbundleをリリースしました。まずステージング配信の対象ユーザーに配信されます。数分後には、主要画面が読み込めないという報告がユーザーから寄せられます。モニタリングではエラーが増加していますが、チームは原因がbundleなのか、APIなのか、フィーチャーフラグなのか、依存関係なのかをまだ判断できません。
影響を受けるユーザーが増え続ける中で、完璧な原因診断をめぐって議論するのは安全な対応ではありません。正常動作が確認済みのアーティファクトがあれば、ロールアウトを停止してそのバージョンに戻せます。エンジニアが不具合を調査して修正を準備する間、アプリは以前の検証済み状態に戻ります。
ロールバックは「予防」ではなく「復旧」である
予防 不具合のある変更がユーザーに届く前に阻止する試みです。テスト、codeによるレビュー、依存関係のチェック、カナリアリリース、承認ゲートなどがこれに当たります。 ロールバックは、予防策が失敗した後、または本番環境で予期しない動作が発生した後に開始されます。
ロールバックは、デリバリーシステムの複数の部分を対象にできます:
- アプリケーションの code: 以前の実行ファイルまたはWeb bundleを再デプロイする。
- 設定: バージョン管理された設定、ルーティングルール、または機能設定を復元する。
- アセット: 互換性のある画像、スクリプト、またはコンテンツファイルに戻す。
- 機能の公開範囲: キルスイッチやオーディエンス制御で新しい機能を無効化します。
- データ: 実行中のトランザクションを中断するか、はるかに厳しい制約の下でバックアップからデータを復元します。
最後のカテゴリは別扱いが必要です。アーティファクトが不変で依存関係に互換性がある場合、アプリケーションの code を戻すのは多くの場合簡単です。しかし、コミット済みのデータを戻すと、データ損失、破損、規制上の問題を引き起こす可能性があります。したがって、リリースのロールバックは、関連するすべてのデータベース操作を安全に巻き戻せることを意味するべきではありません。
頻繁なデリバリーに迅速なリカバリが必要な理由
現代の継続的デリバリーでは、リリースの頻度が高まります。そこから実用的な要件が生まれます。失敗した変更の運用コストは限定的に保つ必要があるのです。迅速にデプロイできても、復旧に長い手動プロセスを要するチームは、デリバリーの半分しか最適化できていません。
手動での切り戻しも可能ですが、どのファイルが変更され、どのサーバーが更新され、どの設定が前回のリリースのものだったかを、オペレーターが覚えている必要があります。このプロセスはインシデント発生時には脆くなります。自動化されたシステムは、不変のアーティファクトを保持し、ヘルスシグナルを監視し、定義済みの条件を満たしたときにロールバックすることで、このプロセスを改善します。
実践的なルール: ロールバックは、障害時に誰かがなんとかする緊急ボタンではなく、リハーサル済みの本番機能として扱ってください。
ロールバックも恒久的な解決策ではありません。一時的にサービスを復旧させるだけで、根本的な欠陥は残ります。エンジニアは引き続き、トリガーを特定し、失敗したリリース中に書き込まれたデータを評価し、修正版をリリースするか、別の意図的な運用判断を下す必要があります。
モダンなシステムにおけるリリース履歴の保持方法
リカバリシステムは、特定して取得できるものしか復元できません。依存関係がずれた状態でビルドされていたり、バイナリが上書きされていたり、ネイティブシェルがそのbundleをサポートしなくなっていたりする場合、古いソースコミットを保持しているだけでは不十分です。
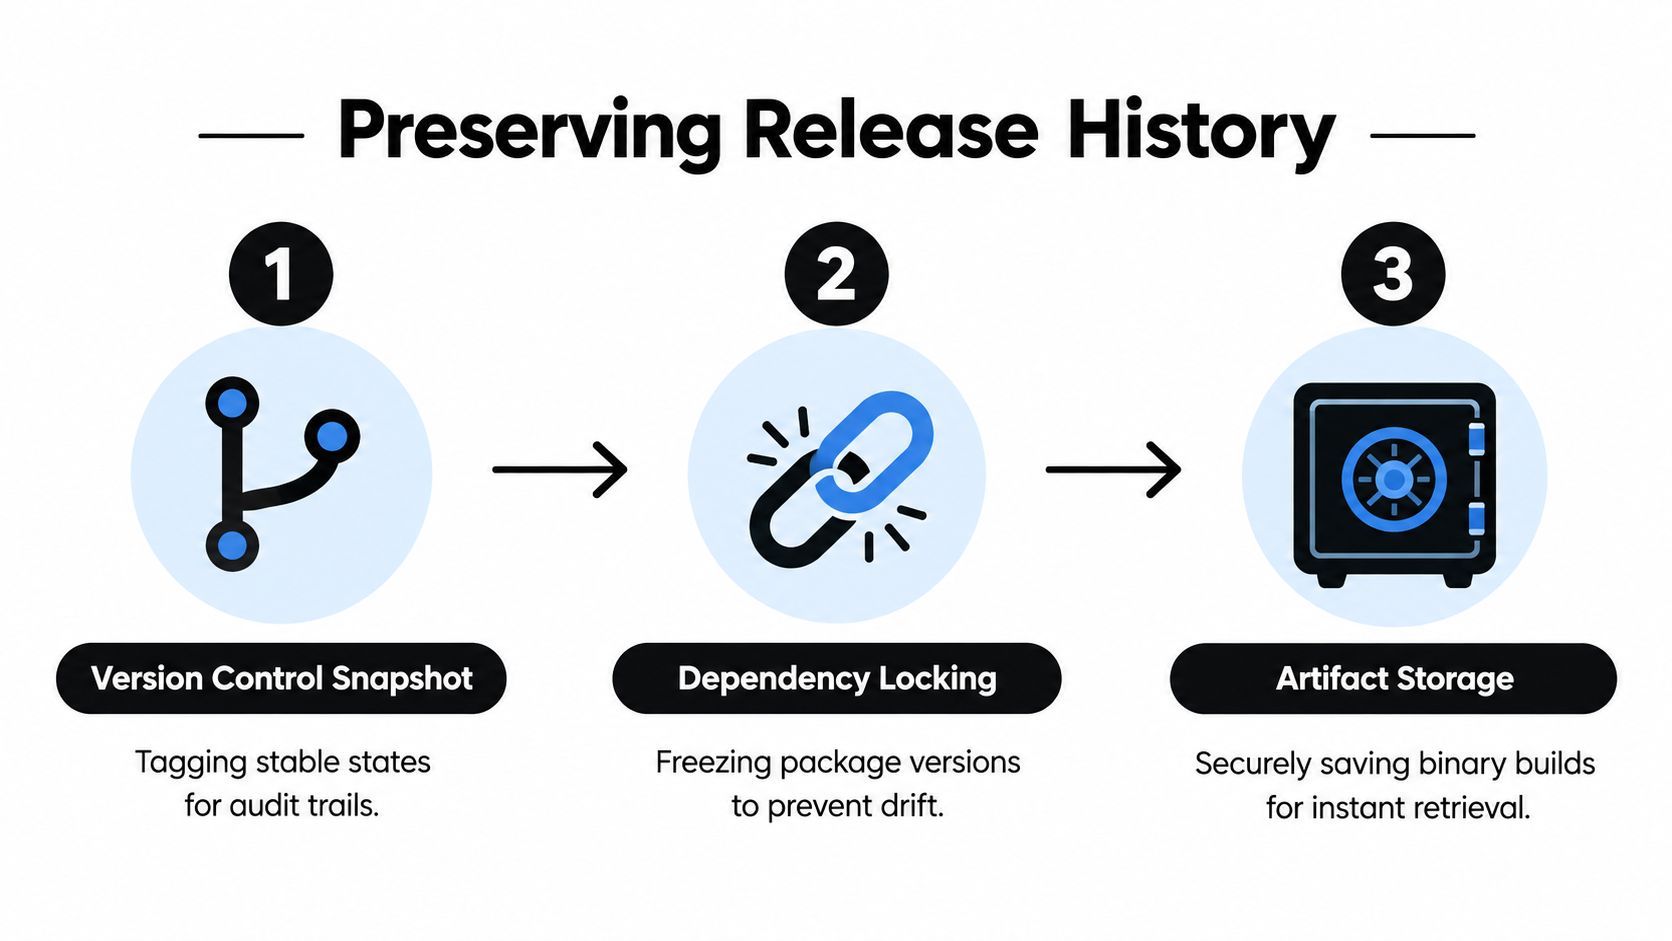
現代のリリースシステムは、ソースからデプロイされたアーティファクトまでの証跡の連鎖を保持することで、この問題を解決します。チームは安定したリビジョンにタグを付け、依存関係グラフをロックし、アドレス指定可能なアーティファクトをビルドして、どのアーティファクトが各環境に到達したかを記録します。この記録により、運用担当者は「前のバージョンに戻す」といった曖昧な指示ではなく、具体的なターゲットを指定できるようになります。
具体的なモデルとしてのKubernetes
Kubernetesは、この構造を明確に示しています。DeploymentがReplicaSetを制御し、そのReplicaSetがデプロイのリビジョンを保持します。Kubernetesはデフォルトで 10個の古いReplicaSetを保持し、チームは spec.revisionHistoryLimitによってその保持数を変更できます。値を 0に設定すると、ロールバックは完全に無効になりますです。これは、 Kubernetes デプロイメントの参照.
オペレーターは直前のリビジョンに戻すか、特定の過去のリビジョンを選択できます。ロールバックは、コンテナイメージやラベルなどのフィールドを含む Deployment の Pod テンプレート設定を変更します。レプリカ数など、無関係なフィールドを自動的に元に戻すことはありません。その後、rollout-status のチェックにより、対象のリビジョンが正常に動作しているかを確認します。
この違いは、モバイルおよび Web バンドルの配信において重要です。システムは以下を記録する必要があります:
- アクティブなバージョン: 各環境、チャネル、またはデバイスが受け取ったリリース。
- アーティファクトのアイデンティティ: コンテンツアドレス可能、またはその他の不変なビルドであり、その場で置き換え可能なファイルではない。
- 依存関係の互換性: 以前のバンドルが、現在のネイティブシェル、API、サービス、データスキーマと動作するか。
- 復旧の結果: デバイスやインスタンスが、復元されたリリースに正常に移行したか。
「以前のバージョン」は特定のアーティファクトを指すべきである
のようなラベルは previous 不変なリリースに解決される場合のみ有用です。チームがそのラベルの背後にあるファイルを上書きすると、誰も気づかずに復旧ターゲットが変わる可能性があります。アーティファクトがストレージから期限切れになっている場合、デプロイシステムはリビジョン番号を知っていても、復元に必要なバイト列が欠落している可能性があります。
Capacitor アプリケーションでは、Webバンドルはネイティブシェル内でも実行されます。以前のJavaScriptバンドルは、現在のシェルで変更されたネイティブプラグイン、権限、またはブリッジの動作に依存している可能性があります。互換性を確認せずに復元すると、1つのインシデントを別のインシデントに置き換えることになります。
この Capgoによるバージョン管理とロールバックのアプローチ より広範な原則を反映しています。リリース履歴は明示的で、取得可能であり、各ビルドを受信した対象と結びついている必要があります。ロールバックが成功するのは、チームが3つの質問に素早く答えられるときです。何がアクティブだったか、何が安定していたか、そして今、周囲のシステムと安全に動作できるのは何か、です。
データベースとデータの切り戻りに潜む危険性
デプロイの失敗は、チームに緊急の指示を残す可能性があります。「前のバージョンに戻して」。実行可能なcodeであれば、それで機能するかもしれません。しかし、データベースでは、コミットされた顧客のアクティビティをクリーンに逆転させることが不可能な場合があり、安全ではありません。
アプリケーションのロールバックとデータのロールバックは、異なる失敗モードを持つ異なる操作です。 codeのリリースは、多くの場合、別の不変のアーティファクトに置き換えることができます。スキーママイグレーションでは、フィールドの名前を変更または削除し、保存された値を変換し、または後続の書き込みで使用される前提条件を変更した可能性があります。注文、支払い、メッセージ、レコード、同意は、有効なユーザーデータです。アプリケーションのリリースが失敗したからといって、それらが消えるべきではありません。
code とスキーマの同期が崩れる理由
リリースAが古いスキーマを理解し、リリースBがカラムを追加したり値の保存方法を変更したりすると仮定します。Bがデプロイされ、そのマイグレーションが実行された後、Aを復元すると、古いcodeが存在しなくなったフィールドをクエリしたり、新しいデータを誤って解釈したりする可能性があります。
逆の操作は別の失敗を招きます。リリース B の処理がアクティブなままデータベースをロールバックすると、書き込みが失敗したり、部分的な状態が残ったりする可能性があります。code とデータベースの両方をロールバックする方がクリーンに見えますが、デプロイ後に生まれた正当なアクティビティを消してしまう恐れがあります。 アプリケーションのロールバックとデータロールバックの区別 は、データベース操作だけでなく、すべてのリリース計画に含めるべきです。
PostgreSQL は、トランザクションのロールバックが何をするかを示しています。 ROLLBACK は現在のトランザクションを中断し、そのトランザクション内の更新を破棄するため、部分的に適用された書き込みのまとまりが永続化されることはありません。以前のトランザクションでコミット済みの変更は元に戻せません。 ROLLBACK をトランザクションブロックの外で実行しても、保存済みのデータは元に戻りません。
前進するためのマイグレーション設計
より安全なリリース設計では、移行期間中にアプリのバージョンとスキーマ変更の互換性を保ちます。チームはまた、 Capacitor アプリの SQLite 暗号化の実践 をスキーマ互換性、アクセス制御、復旧手順とあわせて文書化すべきです。
Expand-and-contract 移行は通常、次の順序で進みます:
- Expand: 旧スキーマを削除せずに、新しいスキーマの機能を追加します。
- 採用: 両方の表現を読み書きできる code をデプロイするか、旧パスを保持したまま新しいパスを導入します。
- 移行: 監視と照合を行いながら、管理されたプロセスで既存レコードを移行します。
- 契約: 依存するバージョンがもはやそれを必要としなくなった後で、初めて旧構造を削除します。
この順序により、旧バージョンのアプリケーションがその契約をサポートするスキーマをまだ使用できるため、code のロールバックがより現実的になります。ただし、すべてのロールバックが安全になるわけではありません。復旧時に新しい非互換性が導入される可能性を低減します。
フィンテック、ヘルスケア、ECシステムでは、監査可能性、プライバシー制御、決済状態の処理、および照合計画も必要です。有効な取引を巻き戻したり、後続のユーザーアクティビティを削除するスナップショットを復元したりするよりも、前方修正の方が安全な場合があります。
データベースルール: 依存関係とデータ契約がその操作をサポートしている場合のみ、code を自由にロールバックしてください。個別にテストされた復元手順がそれ以外であることを証明しない限り、コミットされたデータは前方に進む記録として扱います。
デプロイ前に、各リリースコンポーネントを可逆性に基づいて分類してください。Code、設定、機能公開、アセット、スキーマ、ユーザーデータは、それぞれ異なる復旧ルールに従います。テスト済みのバックアップは重大な破損後に役立つかもしれませんが、バックアップの復元は後方互換性のある移行設計の代わりにはなりません。
リバートを決断する運用判断
ロールバックは単なるデプロイコマンドではなく、運用上の判断です。観測された問題がリリース起因かどうか、前の状態が安全かどうか、巻き戻しを正当化できるほど多くのユーザーに影響しているかどうか、そしてフォワードフィックスの方がリスクを効果的に低減できるかどうかを、誰かが判断しなければなりません。
DORAは、変更失敗率を即時の介入(多くの場合ロールバックやホットフィックス)を必要とするデプロイとして扱い、デプロイ失敗からの復旧時間を別途追跡します。これにより、ロールバックは信頼性のイベントであると同時に、デリバリーのパフォーマンス結果ともなります。これは DORAメトリクスの歴史.
インシデント発生前にトリガーを定義しておく
優れたチームは、リリースがまだ設計段階にあるうちにロールバックの条件について合意します。トリガーは、クラッシュシグナル、エラー率、ヘルスチェックの失敗、サポートからの報告、またはカナリア比較の組み合わせかもしれません。ノイジーな単発イベントだけでリリースを巻き戻すべきとは限りませんが、監視対象のユーザー間で明確なパターンが見られた場合、定義された対応が必要です。
自動ロールバックは、失敗が十分に理解されており、可逆的で、信頼できるシグナルを通じて観測可能な場合にのみ適切です。すべての異常に反応する自動化システムは、バージョン間で振動し、根本的な障害を隠蔽したり、互換性のない依存関係を繰り返し再導入したりすることで、インシデントを悪化させる可能性があります。
モバイルアプリケーションの場合、判断には追加のコンテキストが必要です:
- オフラインユーザー: 一部のデバイスは、すぐにアップデートを確認しません。
- バージョン混在: 古いクライアントと新しいクライアントが長期間共存できます。
- 段階的な公開: チャネルやカナリアリリースにより、本番環境で問題が発覚する前に検出できます。
- ネイティブ互換性: 復元されたWeb bundleは、インストール済みのシェルで動作する必要があります。
- データへの影響: codeのロールバックでは、バックエンドがすでに受け付けた書き込みを元に戻せない場合があります。
ロールバック vs ロールフォワード
ロールバックは以前の状態に戻すもので、ロールフォワードは修正変更を配信するものです。どちらも常に安全というわけではありません。
ロールバックは通常、可逆的な表示上の不具合、設定ミス、永続的な状態を変更する前に失敗するリリースに適しています。マイグレーションが実行済み、ユーザーが有効なレコードを作成済み、以前のアプリバージョンが現在のスキーマをサポートしていない場合は、ロールフォワードの方が安全な場合があります。不具合のある機能をリリース全体を入れ替えずに切り離せるなら、キルスイッチの方がさらに安全な場合があります。
ランブックには、インシデントコマンダー、実行権限を持つ担当者、成功を確認するヘルスシグナル、プロダクトとサポートの連絡経路を明記すべきです。また、チームがロールバックをやめて fix forward に切り替えるタイミングも定めておく必要があります。
役立つランブックには次のことを記録します:
- 対象のリビジョン およびそのアーティファクトの場所。
- 互換性チェック ネイティブクライアント、サービス、依存関係、スキーマ向け。
- 影響範囲の制御チャネル、コホート、カナリアなど。
- 成功基準復旧シグナルやユーザーへの影響を含みます。
- フォローアップ担当者修正リリースとインシデントレビューを担当します。
この ロールアウトの一時停止とロールバックの違い は運用上重要です。一時停止はそれ以上の影響拡大を抑えます。ロールバックは、影響を受けたユーザーが受け取る内容を実際に変更します。どちらかを選ぶ前に、チームは必要なアクションを把握しておくべきです。
モバイル・クロスプラットフォームアプリにおける即時リカバリ
従来のモバイルリリースの復旧は、アプリストア経由の配信に依存します。欠陥がネイティブバイナリにある場合、チームは修正版または以前のバイナリを用意し、該当ストアに提出して、ユーザーに届くまで待つ必要があります。このプロセスはネイティブの変更には適していますが、欠陥がJavaScript、CSS、設定、コピー、Webアセットに限定されている場合は摩擦が生じます。
OTA配信は、こうしたWebレイヤーの変更におけるリカバリパスを変えます。live update システムなら、署名済みbundleを限定された対象に公開し、次回の起動時またはアップデートチェック時にデバイスへ適用させ、以前のbundleをフォールバックとして保持できます。ネイティブの code やプラットフォーム権限が変わったときにストア審査が不要になるわけではなく、データロールバックが安全になるわけでもありません。
ストア配信とLive Updatesは、解決する問題が異なります
| リカバリの必要性 | ストア経由のバイナリリリース | 署名済み live update |
|---|---|---|
| ネイティブプラグインまたは権限の変更 | 適切 | 代替手段ではない |
| JavaScriptまたはCSSの不具合 | 遅いリカバリパス | ポリシーと互換性が許す場合に適切 |
| オーディエンス制御 | ストアチャネルとロールアウト制御 | ターゲット指定チャネルと段階的配信 |
| リカバリー対象 | 公開済みバイナリ | バージョン管理されたWebバンドル |
| 主要な依存関係 | ストア配信 | アップデータ、署名、互換性、オブザーバビリティ |
例えば、次のようなプラットフォームがあります。 Capgo Capacitor は、署名付きの Web バンドルを対象チャネルに配信し、バージョン履歴を保持し、次回起動または更新チェック時に適用することでライブアップデートをサポートします。新しいバンドルが設定されたヘルスチェックに失敗した場合、ロールバック保護が機能します。差分配信により変更されたファイルのみを送信でき、チャネルによってベータ、ステージング、本番、または顧客固有のオーディエンスを分離できます。これらの機能は、Web レイヤーのリリース失敗の影響範囲を縮小するのに役立ちますが、ネイティブシェルとの互換性やバックエンドのデータ契約を検証する必要性を回避するものではありません。
自動フォールバックには信頼できるヘルスシグナルが必要
アップデータは、ダウンロードが完了しただけでバンドルを健全と判断すべきではありません。取得、インストール、起動、実際のアプリケーションの健全性を区別する必要があります。新しいバンドルが次の起動時にクラッシュしたりヘルスチェックに失敗したりした場合、デバイスが App Store のバイナリをフルダウンロードせずに、最後に安定していたバージョンに戻ることができます。
この復旧には限界があります。デバイスがオフラインである場合、失敗した更新がサーバー側のデータを既に変更している場合、または以前のバンドルがインストールされたネイティブシェルと互換性がない場合があります。デバイスごとのログとバージョン採用データは、どのユーザーがどのバンドルを受け取り、フォールバックが機能したかをサポートチームが判断するのに役立ちます。
この Capacitor 更新ロールバック設定ガイド リリースポリシーを置き換えるのではなく、それを補完するものとして位置づけるべきです。すべての成果物に署名を施し、本番環境への公開権限を制限し、フォールバックバージョンを保持し、実機で障害時の経路をテストしてください。復元されたバンドルが意図されたものであることをシステムが証明できる場合のみ、高速な配布は価値を持ちます。
レジリエントなリリース戦略の構築
ロールバックの準備態勢は、リリースシステム全体に求められる特性です。チームが依存関係を特定できない、どのデバイスが採用したか確認できない、本番環境に近いデータでの復旧テストを一度も実施していない場合、オブジェクトストレージに古いビルドがあっても、意味のある保護にはなりません。
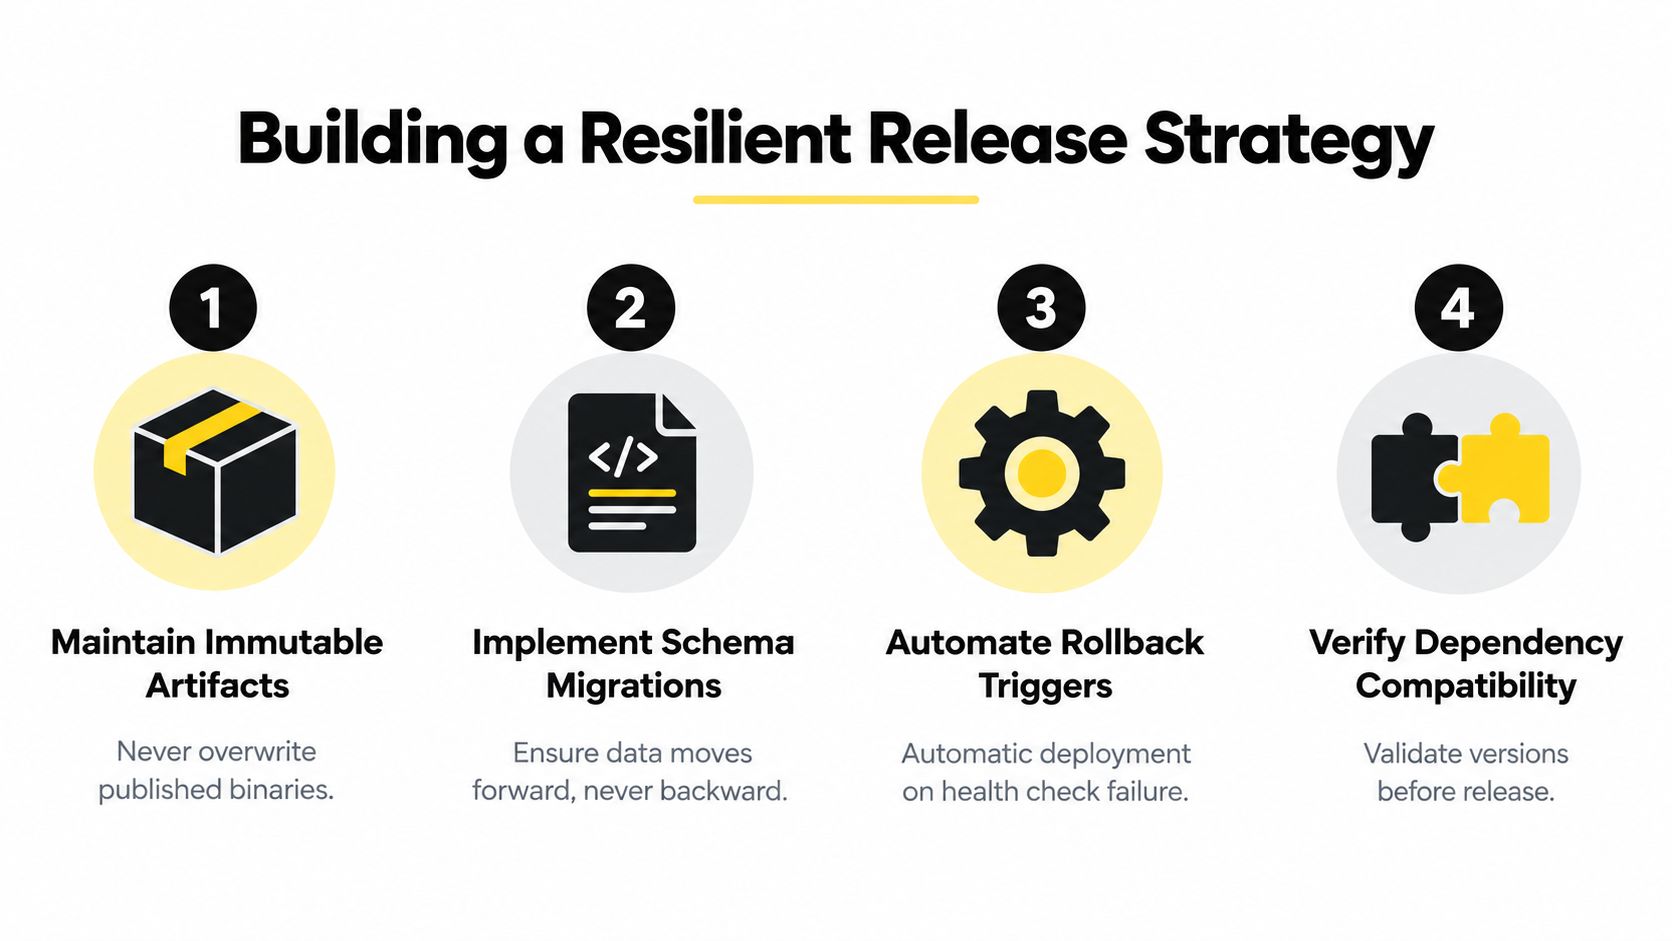
まずはアーティファクトチェーンから始めましょう。安定したソース状態にタグを付け、依存関係をロックし、署名済みビルドを保持します。公開済みリリースは上書きしません。次に、各アーティファクトを環境、チャネル、デプロイイベントに紐付けます。チームは、開発者のローカルマシンに頼らずに何が起きたかを再現できるようにします。
リカバリのリスクを軽減する4つのコントロール
- イミュータブルなアーティファクト: すべての本番bundleを一意のIDで保存します。「previous」ポインタでリリースを選択できますが、リリース自体を変更してはいけません。
- 互換性のあるマイグレーション: expand-and-contract手法を活用し、制御された移行期間中に新旧のアプリケーションバージョンが共存できるようにします。
- ガード付き自動化: 実際のリリース失敗と一時的なサービス障害を区別できるシグナルに対してのみ、フォールバックを自動化します。
- 依存関係の検証: 対象リビジョンを有効化する前に、ネイティブシェル、プラグイン、API、サービス、スキーマを確認します。
オブザーバビリティがフィードバックループを完結させます。デバイスごとのバージョン、起動結果、アップデートのステータス、失敗理由、適用状況を収集します。これらの記録により、サポートチームは、ユーザーがまだ失敗したbundleを使っているのか、すでにフォールバックを受け取ったのか、アップデートを一度もダウンロードしていないのかを判断できます。
チームは、実際のデータとクライアントバージョンが混在する環境で、リカバリ手順をリハーサルすべきです。空の開発用データベースに対して code を復元するだけのテストでは、実際のレコード、古いスキーマバージョン、キューに溜まった書き込み、途中までしか完了していないマイグレーションが原因の互換性問題を見逃す可能性があります。リカバリテストでは、認可、署名、アーティファクトの取得、チャネルのターゲティング、コミュニケーションプランも検証すべきです。
リカバリは、古いビルドが存在するかどうかでは測れません。チームがどれだけ正確に影響を制御し、互換性のある状態へ復元できるかで測られます。
リリース計画には、依存関係の調整に関する明確なオーナーシップを含めるべきです。より広範なフレームワークが必要なチームは、 アジャイルでの依存関係管理において その計画の規律を活用して、デプロイ前にモバイル、バックエンド、データベース、プロダクトの変更を揃えられます。
実践的な準備状況レビューでは、次の点を確認します:
- 各チャネルでアクティブなアーティファクトを正確に特定できるか?
- インストール済みの code を変更せずに、配信を一時停止できるか?
- 署名済みで互換性のあるbundleを復元できるか?
- アプリのロールバック後も、データベースが安全なままであることを証明できるか?
- サービス全体の集計レベルだけでなく、バージョンごとに失敗を検知できるか?
- 切り戻しが有効なデータを損なう場合に、ロールフォワードを選べるか?
回答が不明確なら、リリースプロセスにリカバリのギャップがあります。次のインシデント前にそのギャップを埋める方が、ユーザーを待たせながら場当たり対応するより安く済みます。
より安全なデプロイの要点
ロールバックは、適用済みのソフトウェアや設定の変更を戻し、正常動作が確認された状態に復元します。不具合の防止、根本原因の修復、コミット済みのデータベース変更の自動取り消しは行いません。
アプリケーションのアーティファクトは不変かつアドレス可能な状態に保ちます。各リリースのアクティブバージョン、依存関係、ネイティブシェル互換性、配信対象を追跡します。スキーママイグレーションとユーザーデータは別々のリカバリ対象として扱います。code のロールバックではデータベースが変更されたままになり、データベースのロールバックでは有効なレコードが破壊され得るためです。
段階的配信、信頼できるヘルスシグナル、明示的な承認、テスト済みのランブックを使います。モバイルチームでは、署名済みのOTAバンドルが互換性のあるWebレイヤー変更の迅速なリカバリを可能にする一方、ネイティブ変更には適切なバイナリリリース経路が依然として必要です。リカバリは、古いビルドの有無ではなく、影響範囲の縮小とサービス復旧の確認で測ります。
Capgo は Capacitor と Electron チームに、署名付きライブアップデートバンドル、ターゲットチャネル、バージョン履歴、デバイス別オブザーバビリティ、互換性のあるWebレイヤーリリース向けのロールバック保護を提供します。現在のリカバリ経路を確認し、どのように Capgo 露出を一時停止し、正常動作が確認されたバンドルを復元し、インシデント対応を制御下に保つのに役立つかをご覧ください。





