
Una correzione critica viene pubblicata martedì mattina. La pipeline di deployment diventa verde, le release notes sembrano a posto, eppure il supporto continua a ricevere segnalazioni sul bug che la correzione avrebbe dovuto eliminare. Questo divario è il problema principale. Un release può essere spedito, installato e comunque non raggiungere gli utenti in modo significativo.
Ecco perché esempi di metriche di adozione fondamentali per gli aggiornamenti live in Capacitor e sistemi di rilascio simili. Metriche diverse rispondono a domande diverse sullo stesso bundle. Alcune indicano se l'aggiornamento ha raggiunto i dispositivi, altre mostrano quanto velocemente si è diffuso, altre rivelano se ha migliorato la stabilità e altre ancora se il rollout è stato controllato.
L'elenco seguente raggruppa le metriche più utili per copertura, velocità, qualità e controllo. Ognuna include una formula, una vista della dashboard, un esempio di aggiornamento live, un failure mode e una soglia pratica da usare in una riunione di rilascio.
Indice dei contenuti
- 1. Tasso di adozione degli update
- 2. Distribuzione delle versioni
- 3. Tempo per raggiungere l'X% di adozione
- 4. Curva di adozione del rollout graduale
- 5. Tasso di successo dell'installazione degli update
- 6. Tasso di rollback
- 7. Tasso di dispositivi obsoleti
- 8. Differential Update Efficiency Ratio
- 9. Sessioni senza crash nel coorte aggiornato
- 10. Distribuzione dell'adozione per canale
- Confronto di 10 metriche di adozione
- Trasformare queste metriche di adozione in una routine di rilascio
1. Tasso di adozione degli update
Tasso di adozione degli aggiornamenti è il numero chiave per un live update. Misura la percentuale di dispositivi attivi che eseguono il bundle o la versione target all'interno di una finestra temporale definita dopo il rilascio. In pratica, significa dispositivi sulla nuova versione divisi per il totale dei dispositivi attivi nello stesso periodo. Per un fix live, risponde a una domanda diretta: l'update è arrivato sui dispositivi che contano?
Un team fintech può usarlo per capire se una patch di login sta sostituendo il vecchio bundle. Un team e-commerce può confrontare l'adozione a 24 ore su iOS e Android dopo un fix al checkout. La dashboard dovrebbe mostrare la versione target, il pool di dispositivi idonei e la quota che è già passata alla nuova versione. Per un contesto più ampio sugli strumenti di adozione, esplora i vantaggi e i KPI di DAP to see how platform-level adoption metrics compare.
Regola pratica: definisci per iscritto cosa si intende per “dispositivo attivo” prima del rilascio. Se il denominatore cambia tra un rilascio e l'altro, la metrica non è più comparabile.
La soglia deve riflettere la gravità. Un fix di sicurezza merita un target più stringente di un tweak della UI, e il team dovrebbe metterlo per iscritto prima che parta il rollout. Monitora questa metrica insieme al numero di dispositivi che controllano gli update, perché un polling lento può far sembrare lento un rilascio sano. Osserva lo stesso pattern in Guida di Capgo al monitoraggio del successo OTA per app Capacitor, dove la vista del rilascio è collegata al reale progresso dell'installazione.
Se la definizione di adozione cambia ogni settimana, la metrica smette di essere utile per le decisioni di rilascio.
2. Distribuzione delle versioni
La distribuzione delle versioni mostra come gli utenti attivi sono distribuiti tra tutti i bundle live in un dato momento. Pensala come una mappa della frammentazione. Se troppe persone sono ancora sparse su versioni vecchie, il tuo team di supporto sta gestendo più percorsi code del dovuto.
Un'app healthcare potrebbe scoprire che un bundle legacy è ancora attivo su una fetta significativa di dispositivi e decidere che un aggiornamento forzato merita il disagio. Un'agenzia che gestisce diversi build di clienti può usare la stessa vista per decidere quali versioni dei plugin Capacitor si possono ritirare senza rischi. Il punto non è solo l'età, ma quante diverse realtà di runtime il tuo team deve ancora supportare.
Cosa dovrebbe mostrare la dashboard
Il grafico dovrebbe suddividere bundle attuale, bundle precedente, e bundle vecchi ancora in uso. Aggiungi i conteggi dei crash accanto a ogni versione, così il team può capire se una vecchia release è solo diffusa o attivamente rischiosa. Se una versione è vecchia e instabile, è una forte candidata alla deprecazione.
Usa il semantic versioning sia per i bundle native sia per quelli web, così il report resta leggibile. Una policy di supporto come "solo le ultime tre versioni del bundle" dà alla dashboard un chiaro pass o fail. Senza una policy, la cronologia delle versioni diventa un museo invece di uno strumento operativo.
Per una visione pratica dell'implementazione, Capgo’s app version history guide è il complemento giusto. La decisione utile qui è semplice: se la frammentazione è alta e il rischio delle vecchie versioni di code cresce, il team deve smettere di trattare ogni versione come ugualmente meritevole di supporto.
3. Tempo per raggiungere l'X% di adozione
Il tempo per raggiungere una quota X% di adozione trasforma la copertura in velocità. Invece di chiedersi se gli utenti hanno prima o poi aggiornato, misura quanto tempo serve per arrivare a una quota target, come 50%, 80% o 95%. Per un fix live la velocità conta, perché il problema continua a colpire gli utenti finché il nuovo bundle non è attivo.
Un team che gestisce l'incident response può porsi l'obiettivo di raggiungere una soglia scelta entro una finestra fissa e riportare la mediana ogni mese. Un product team può confrontare due release del checkout e vedere quale è stata adottata più in fretta. La vista in dashboard dovrebbe essere una curva, non un singolo numero, perché la coda ti dice dove l'adozione si blocca.
Usa insieme mediana e comportamento della coda
Le medie nascondono i ritardatari. La mediana mostra la velocità di rollout tipica, mentre un percentile più alto mette in luce i gruppi più lenti, che potrebbero essere bloccati su vecchie release o su aperture dell'app poco frequenti. Se riporti solo la media, rischi di perdere il gruppo che sta ancora aspettando il fix.
Questa metrica è particolarmente utile per le app che si aggiornano al prossimo avvio. Se gli utenti non riaprono spesso l'app, il tuo rilascio può essere tecnicamente disponibile ma funzionalmente ritardato. Capgo’s real-time update metrics guide è un'ottima scelta in questo caso, perché la dashboard deve riflettere l'orario di arrivo effettivo, non solo l'orario di pubblicazione.
La soglia va definita per livello di gravità. Le fix critiche richiedono un target più stretto rispetto alle modifiche cosmetiche, e il team deve deciderlo prima che parta il rollout. Se la release sta ancora salendo ma il problema è urgente, sai già che l'update pipeline è il collo di bottiglia.
4. Curva di adozione del rollout graduale
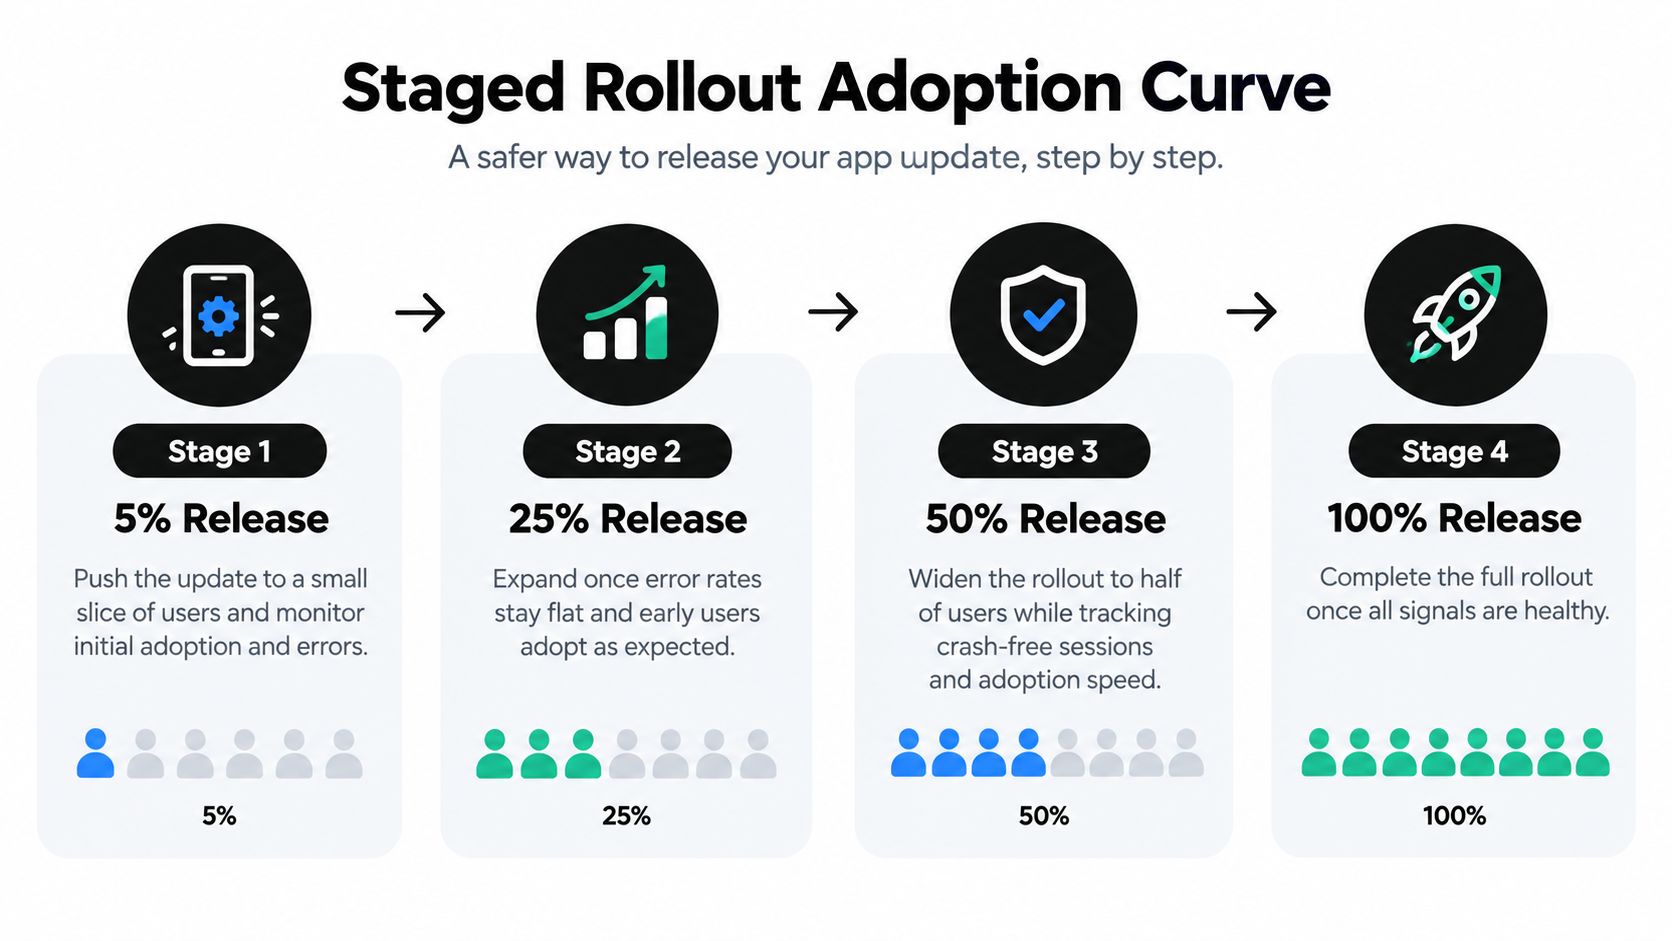
Una curva di adozione di un rollout graduale mostra come l'esposizione si allarga da un piccolo gruppo all'intera base utenti. Traccia l'adozione a ogni soglia di rilascio, ad esempio 5%, 25%, 50% e 100%. Questa curva dà ai responsabili del rilascio evidenze prima di allargare il raggio d'impatto. Usa il dashboard per confrontare l'adozione di ogni coorte, l'andamento degli errori e quello dei crash, così la decisione go/no-go si basa ogni volta sulla stessa vista.
Un team del settore sanitario può rilasciare prima a un pubblico ristretto, verificare che i tassi di errore restino stabili e poi espandere. Un team enterprise può indirizzare uno stream specifico per un cliente a un singolo account prima di portare lo stesso bundle in produzione. Ogni fase richiede un unico responsabile e un punto decisionale. Se la coorte successiva si comporta diversamente dalla precedente, ferma il rollout. Espandersi su un problema è esposizione, non progresso.
Il dashboard dovrebbe mostrare la fase corrente, il livello di adozione raggiunto e l'andamento dello stato di salute osservato in quella fase. Aggiungi un'etichetta go/no-go chiara, così la revisione resta inequivocabile. Per i team che cercano un playbook per il rollout degli aggiornamenti live, Guida al rollout graduale di Capgo per gli aggiornamenti live di Capacitor è un riferimento pratico. Per visualizzare il comportamento delle coorti tra le fasi, consulta la guida alla curva di retention del team di attribution. Un rollout graduale sano è ponderato. Impedisce al team di trattare la velocità come successo quando l'obiettivo è un'espansione sicura.
5. Tasso di successo dell'installazione degli update
L'update install success rate misura la percentuale di tentativi di aggiornamento che completano con successo download, verifica e applicazione sul dispositivo. Non è la stessa cosa dell'adoption. Un bundle può essere disponibile per tutti e fallire comunque durante il download o la verifica.
Un team che riscontra un basso tasso di successo su una build Android specifica potrebbe risalire a problemi di compressione o di firma. Un'app e-commerce potrebbe notare che i download falliti si concentrano in una regione e spostare quindi il traffico di delivery verso un edge più vicino. La dashboard ha bisogno di una vista step-by-step del ciclo di vita per non confondere i problemi di delivery con quelli di runtime.
Suddividi la pipeline in fasi
Logga separatamente le fasi principali, come download started, download complete, signature verified e bundle applied. Se una fase cala, il problema è lì. Se l'intera catena è debole, il problema potrebbe essere la rete, il packaging o la compatibilità del dispositivo.
Imposta degli alert quando il success rate scende sotto la baseline di cui ti fidi. I team spesso tengono la soglia alta perché un live update dovrebbe essere routine, non fragile. La guida al monitoraggio OTA di Capgo per app Capacitor è utile per strutturare quella observability.
Una buona soglia è quella che fa scattare un'azione prima che gli utenti notino il pattern di errore. Se gli errori di verifica compaiono in CI, la release non dovrebbe mai arrivare in produzione. La decisione pratica è semplice: separare i difetti di delivery dai difetti dell'applicazione, altrimenti ogni incident review confonderà la causa alla base.
6. Tasso di rollback
Il tasso di rollback misura con quale frequenza una release viene annullata dopo la comparsa di un problema. Può essere tracciato per release o per dispositivo, e entrambe le viste sono importanti. Per i live update, il rollback è la valvola di sicurezza, quindi questa metrica ti dice quanto spesso la valvola ha dovuto aprirsi.
Un team fintech potrebbe vedere un trigger automatico di rollback quando i tassi di crash aumentano bruscamente all'inizio di un rollout. Un'agenzia può usare le tendenze di rollback tra le app dei clienti per decidere dove la QA deve essere più severa. La dashboard dovrebbe separare rollback automatico da Rollback manuale perché quelle cause dicono cose diverse sul processo.
Cosa analizzare dopo ogni rollback
- Origine del trigger: Attivato da crash, supporto o azione manuale?
- Tempo per il rollback: Il sistema si è ripreso abbastanza in fretta da ridurre l'impatto sugli utenti?
- Raggio d'azione: Quanti dispositivi sono stati esposti prima che il rollback fosse completato?
La soglia qui non è un numero universale fisso. È una questione di policy. Se un release viene spesso rollback, il team dovrebbe cercare lacune nei controlli pre-release, nella copertura dei dispositivi o nella logica di rollout graduale.
Un rollback non è automaticamente un fallimento. A volte è l'esito corretto, soprattutto quando il release è chiaramente peggiore della build precedente. Il fallimento è lasciare che il rollback diventi una sostituzione routinaria della disciplina di release.
7. Tasso di dispositivi obsoleti
Il tasso di dispositivi obsoleti mostra la percentuale di dispositivi attivi che non si sono aggiornati entro una finestra definita, come 30 o 60 giorni. È importante perché i dispositivi obsoleti perdono fix, patch di sicurezza e nuove funzionalità. In ambienti regolamentati, quel ritardo può diventare un problema di conformità.
Un'app sanitaria potrebbe inviare un prompt in-app quando i dispositivi sono troppo indietro. Un cliente enterprise potrebbe richiedere che tutti i dispositivi sul campo vengano aggiornati entro una finestra stabilita, e il team di release traccia la conformità settimanalmente. Il dashboard dovrebbe separare i dispositivi attivamente utilizzati da eccezioni note come hardware offline o kiosk.
Un grafico dei dispositivi obsoleti è utile solo se il team può agire su di esso. Se la metrica include dispositivi che non possono aggiornarsi per design, il segnale diventa rapidamente rumoroso.
La soglia dovrebbe variare in base al tipo di release. Gli aggiornamenti legati alla sicurezza richiedono limiti di obsolescenza più stretti rispetto alle modifiche alle funzionalità. Se la coorte di utenti obsoleti cresce dopo una release, il problema potrebbe essere l'attrito nel rollout, prompt deboli o utenti che aprono l'app troppo raramente per cogliere la finestra di aggiornamento.
Usa notifiche in-app prima di forzare l'aggiornamento. Questo offre agli utenti un percorso chiaro senza trasformare ogni promemoria in un blocco totale. La decisione pratica dipende dall'obiettivo del team: migliorare la conformità, ridurre il rischio di supporto o spingere una nuova funzionalità. La metrica dovrebbe riflettere questo obiettivo.
8. Differential Update Efficiency Ratio
Il rapporto di efficienza degli aggiornamenti differenziali misura quanti byte hai risparmiato inviando solo i file modificati invece di un bundle completo. È una metrica di banda, ma influisce anche sui tempi di installazione e sui costi dati. Aggiornamenti più piccoli significano generalmente meno attrito per l'utente, soprattutto su connessioni a consumo.
Un team che modifica principalmente CSS e testi potrebbe notare risparmi significativi e usarli per giustificare release frequenti e piccole. Un altro team di prodotto potrebbe separare le immagini in un canale asset distinto per mantenere i delta di code snelli. La dashboard dovrebbe confrontare la dimensione dei delta per tipo di release, non solo in aggregato.
Perché questa metrica cambia il comportamento di adozione
Gli aggiornamenti più piccoli tendono a sembrare meno pesanti agli utenti. Questo non garantisce l'adozione, ma può eliminare un motivo ovvio di ritardo. Se gli utenti sono su reti lente, un bundle compatto ha molte più probabilità di essere applicato prima che desistano.
Questo è uno dei punti più chiari in cui le scelte tecniche influenzano il comportamento del rilascio. Tieni gli asset statici separati dai code che cambiano rapidamente. Poi confronta correzioni ai testi, modifiche di configurazione e bundle di funzionalità per capire quale tipo di rilascio sta appesantendo il delta.
Se il delta rimane piccolo, il rilascio ha meno ostacoli da superare. È proprio questo il punto.
Questa metrica non ha bisogno di una soglia complessa, ma di una baseline. Il team dovrebbe sapere qual è il "normale" per ogni tipo di rilascio e indagare quando una piccola modifica produce un payload sproporzionato. Di solito significa che la struttura del bundle va ripulita.
9. Crash-free sessions sulla coorte aggiornata
Le crash-free sessions sulla coorte aggiornata misurano la percentuale di sessioni sul nuovo rilascio che non vanno in crash. È una metrica di qualità, ma anche una metrica di adozione, perché un rilascio che va in crash troppo spesso non può essere considerato un'adozione sana. Confrontare il gruppo aggiornato con la versione precedente aiuta a isolare l'effetto della modifica.
Un team potrebbe vedere le sessioni crash-free calare sul nuovo bundle e attivare un rollback. Uno sviluppatore indie può confrontare la build aggiornata con quella precedente nelle prime 48 ore e cercare regressioni. La dashboard dovrebbe mostrare la nuova coorte e quella precedente affiancate, perché il contesto conta più del solo numero grezzo.
Cosa includere nel confronto
Includi crash nativi, errori JavaScript e caricamenti falliti per le app Capacitor. Un tasso di crash nativi basso può comunque nascondere problemi al front-end se il layer web è instabile. Se la coorte aggiornata è peggiore della baseline, il rilascio non dovrebbe restare attivo solo perché l'adozione è alta.
Questa metrica richiede anche una dimensione minima del campione prima di trarre conclusioni definitive. Le coorti piccole possono oscillare troppo per essere affidabili. La soglia dovrebbe essere impostata come regola di regressione relativa, non solo come numero assoluto fisso.
Usa questa metrica insieme al tasso di rollback, non al suo posto. Una ti dice come si è comportato il rilascio, l'altro ti dice come ha reagito il sistema. Insieme, ti aiutano a capire molto meglio se l'update debba restare live.
10. Distribuzione dell'adozione per canale
La distribuzione dell'adozione dei canali mostra come i dispositivi attivi siano ripartiti tra beta, staging, produzione o stream specifici per i clienti. Ti permette di capire se le persone giuste stanno ricevendo la release corretta al momento giusto. Aiuta anche a individuare uno degli errori più comuni: il traffico di test che finisce in produzione o utenti di produzione che si trovano in un canale di test.
Un team e-commerce in un settore regolamentato può confermare che nessun dispositivo di produzione sia finito accidentalmente in beta dopo una release. Un'agenzia può monitorare i canali dedicati ai clienti e dismettere quelli che nessuno usa più. La dashboard dovrebbe mostrare l'appartenenza ai canali in modo così chiaro che eventuali errori di instradamento siano evidenti a colpo d'occhio.
Usa i canali come guardrail, non come etichette
I canali sono utili solo se vengono applicati. Se tester, staff interno e piloti clienti finiscono tutti nello stesso flusso, il processo di rilascio perde il suo confine di sicurezza. Mantieni i canali documentati e verifica la distribuzione prima di ogni rilascio importante.
Configura avvisi per membri inattesi, in particolare dispositivi beta che appaiono in produzione o viceversa. Questo singolo controllo può catturare un'esposizione accidentale prima che diventi un problema di supporto. Una mappa dei canali chiara rende anche i post-mortem più rapidi, perché il team può vedere chi ha ricevuto cosa e quando.
La soglia pratica è se la distribuzione corrisponde all'intento. Se non lo fa, il processo di rilascio sta perdendo. In un sistema di Live Update, non è un problema estetico, è un problema di controllo.
Confronto di 10 metriche di adozione
| Metrica | 🔄 Complessità di implementazione | ⚡ Requisiti di risorse | 📊 Risultati attesi | 💡 Casi d'uso ideali | ⭐ Vantaggio chiave |
|---|---|---|---|---|---|
| Tasso di adozione degli aggiornamenti | Bassa, verifica delle versioni e definizione dei dispositivi attivi | Bassa, aggregazione e segmentazione periodiche | % di dispositivi attivi sulla versione target nel tempo | Decisioni go/no-go, monitoraggio hotfix, controlli cross-platform | Indicatore chiaro e univoco della salute del rilascio |
| Distribuzione delle versioni (Indice di frammentazione) | Media, conteggi per versione e visualizzazione time-series | Media, archiviazione storica e segmentazione | Visibilità sulla distribuzione degli utenti per versione e carico di supporto | Prioritizzazione di compatibilità/test e aggiornamenti forzati | Indica quali versioni vecchie richiedono supporto |
| Time to X% Adoption (Adoption Velocity) | Media, eventi con timestamp e curve cumulative | Moderata, calcoli dei percentili e grafici | Metriche di velocità (mediana/p90) per raggiungere le soglie di adozione | Gestione incidenti, benchmarking della velocità di rilascio | Misura quanto rapidamente gli utenti ricevono le correzioni |
| Curva di adozione del rollout graduale | Alta, orchestrazione delle percentuali di rollout e delle regole di gating | Alta, monitoraggio per fase, controlli di pausa/espansione | Controllata, esposizione graduale con segnali di pausa/arresto | Rilasci rischiosi, ambienti regolamentati, rollout con audit | Limita il raggio d'impatto e consente un'espansione sicura |
| Tasso successo installazione update | Moderata, strumentazione delle fasi download/verifica/applicazione | Medio–Alto, log per dispositivo, tracciamento della fase di errore | % di installazioni riuscite; dettaglio per fase di errore | Risoluzione dei problemi di delivery o verifica | Individua dove falliscono gli update per un debugging più rapido |
| Tasso di rollback | Basso–Medio, traccia i rollback e classifica le cause automatiche/manuali | Basso, tracciamento degli eventi e record post-mortem | % di release/dispositivi ripristinati e tempo di rollback | Validazione dei safety net, misurazione della qualità release | Misura diretta dei problemi di release ed efficacia del rollback |
| Tasso di dispositivi non aggiornati | Basso, calcola l'età dell'ultimo update per dispositivo attivo | Basso, timestamp di ultimo accesso/aggiornamento e segmentazione | % di dispositivi attivi non aggiornati negli ultimi N giorni | Reporting su sicurezza/conformità, outreach o aggiornamenti forzati | Identifica i dispositivi privi di patch o funzionalità |
| Differential Update Efficiency Ratio | Alto, calcolo dei byte delta rispetto al bundle completo per release | Moderato, creazione di diff e telemetria per release | Rapporto dei byte risparmiati; risparmio medio per release/dispositivo | Reti a consumo, piccole release frequenti, modifiche architetturali | Quantifica il risparmio di banda e giustifica i piccoli aggiornamenti |
| Sessioni senza crash nella coorte aggiornata | Moderata, con coorti di sessioni e attribuzione dei crash | Moderata, crash reporting, segmentazione, controlli statistici | Crash-free % per coorti nuove vs baseline; rilevamento regressioni | Alert regressioni, staged rollouts, health check di release | Isola l'impatto della release sulla stabilità per le decisioni di rollback |
| Distribuzione adozione per canale | Bassa–Moderata, tracciamento assegnazioni e modifiche ai canali | Basso, monitoraggio di metadati e membership dei canali | Quota di dispositivi per canale; esposizioni impreviste | Validazione beta, pilot enterprise, governance dei canali | Valida le regole di targeting ed evita esposizioni accidentali |
Trasformare queste metriche di adozione in una routine di rilascio
La migliore dashboard di rilascio non mostra tutto subito. Inizia con la distribuzione dell'adozione dei canali e il tasso di successo dell'installazione degli update così saprai se il bundle è rivolto al pubblico giusto e arriva sui dispositivi. Poi monitora la curva di adozione del rollout graduale e tempo per raggiungere l'X% di adozione per mostrare quanto rapidamente si diffonde il rilascio.
Dopo di che, subentrano i controlli di qualità. Sessioni senza crash nel coorte aggiornato ti dice se la nuova build si comporta correttamente, mentre tasso di rollback mostra se la rete di sicurezza ha dovuto intervenire. Distribuzione delle versioni e tasso di dispositivi non aggiornati completano il quadro mostrando quanto è frammentata la flotta e quanti dispositivi sono in ritardo.
La revisione di un rilascio diventa molto più semplice quando il team sceglie un piccolo set di metriche e ne scrive le definizioni prima di rilasciare. Scegli tre metriche per il prossimo rilascio, definisci il denominatore, imposta la soglia e rivedile nella stessa riunione ogni volta. Se stai lavorando in un flusso di live-update di Capacitor, questo ritmo è spesso ciò che trasforma i dati grezzi di adozione in un processo di rilascio in cui le persone possono fidarsi.
Per i team che necessitano anche di solide pratiche di retention e governance dei dati, la guida di Sift sulle policy di retention dei dati per i team social è un utile promemoria che la misurazione funziona solo quando i dati sottostanti restano puliti e utilizzabili. L'abitudine al rilascio conta più della dashboard stessa. Una volta che il team sa spiegare cosa significa "buono", ogni aggiornamento diventa più facile da rilasciare, difendere e migliorare.
Capgo offre ai team di Capacitor ed Electron un percorso di live-update per rilasciare fix di JavaScript, CSS, copy, config e asset senza aspettare la revisione degli store. Se vuoi che i dati del rilascio corrispondano al processo di rilascio, visita Capgo e scopri come bundle firmati, guardrail dei canali, protezione dal rollback e metriche di adozione si integrano in un unico workflow.





