
Perbaikan kritis dirilis Selasa pagi. Deployment pipeline sudah hijau, release notes sudah rapi, tapi tim support tetap banjir komplain soal bug yang seharusnya sudah diperbaiki. Celah itulah masalah utamanya. Sebuah rilis bisa saja terkirim dan terinstal, namun tetap gagal menjangkau pengguna secara efektif.
Itulah mengapa contoh metrik adopsi sangat penting untuk live update di Capacitor dan sistem rilis serupa. Metrik berbeda menjawab pertanyaan berbeda tentang bundle yang sama. Ada yang menunjukkan apakah update sampai ke device, seberapa cepat penyebarannya, apakah stabilitas membaik, dan apakah rollout terkendali.
Daftar di bawah ini mengelompokkan metrik paling berguna berdasarkan jangkauan, kecepatan, kualitas, dan kontrol. Masing-masing dilengkapi dengan rumus, tampilan dashboard, contoh Live Update, mode kegagalan, dan ambang batas praktis yang bisa Anda gunakan dalam rapat rilis.
Table of Contents
- 1. Tingkat Adopsi Update
- 2. Distribusi versi
- 3. Waktu Mencapai Adopsi X%
- 4. Kurva Adopsi Staged Rollout
- 5. Tingkat Keberhasilan Install Update
- 6. Tingkat Rollback
- 7. Tingkat Perangkat Stale
- 8. Rasio Efisiensi Differential Update
- 9. Sesi Tanpa Crash pada Cohort Terupdate
- 10. Distribusi Adopsi Channel
- Perbandingan 10 Metrik Adopsi
- Mengubah metrik adopsi ini menjadi rutinitas release
1. Tingkat Adopsi Update
Tingkat adopsi update adalah metrik utama untuk live update. Ini mengukur persentase perangkat aktif yang menjalankan bundle atau versi target dalam jangka waktu tertentu setelah rilis. Praktiknya, ini berarti perangkat di versi baru dibagi total perangkat aktif pada periode yang sama. Untuk live fix, ini menjawab pertanyaan langsung: apakah update sudah sampai ke perangkat yang penting?
Tim fintech bisa memakai ini untuk menilai apakah patch login sudah menggantikan bundle lama. Tim e-commerce bisa membandingkan adopsi 24 jam di iOS dan Android setelah perbaikan checkout. Dashboard harus menampilkan versi target, pool perangkat yang memenuhi syarat, dan persentase yang sudah beralih. Untuk konteks lebih luas tentang tooling adopsi, jelajahi manfaat dan KPI DAP untuk melihat perbandingan metrik adopsi di level platform.
Aturan praktis: tentukan definisi “active device” secara tertulis sebelum rilis diluncurkan. Jika penyebutnya berubah dari satu rilis ke rilis berikutnya, metriknya tidak lagi bisa dibandingkan.
Threshold harus sesuai tingkat keparahan. Perbaikan keamanan butuh target lebih ketat daripada tweak UI, dan tim harus mencatatnya sebelum rollout dimulai. Pantau metrik ini bersamaan dengan jumlah perangkat yang mengecek update, karena polling yang lambat bisa membuat rilis yang sehat terlihat lamban. Perhatikan pola yang sama di panduan pelacakan keberhasilan OTA Capgo untuk aplikasi Capacitor, di mana tampilan rilis terhubung dengan progres instalasi yang sebenarnya.
Jika definisi adopsi berubah setiap minggu, metriknya tidak lagi berguna untuk mengambil keputusan rilis.
2. Distribusi versi
Distribusi versi menunjukkan bagaimana pengguna aktif Anda tersebar di seluruh bundle live pada satu waktu tertentu. Anggap saja ini sebagai peta fragmentasi. Jika terlalu banyak orang masih tersebar di versi lama, tim dukungan Anda menangani lebih banyak jalur code daripada yang seharusnya.
Aplikasi kesehatan mungkin menemukan bahwa bundle legacy masih aktif di porsi perangkat yang signifikan dan memutuskan pembaruan paksa layak dilakukan meskipun ada gesekan. Agensi yang mengelola beberapa build klien bisa memakai tampilan yang sama untuk memutuskan versi plugin Capacitor mana yang aman untuk dihentikan. Intinya bukan sekadar usia, melainkan berapa banyak kondisi runtime berbeda yang masih harus didukung tim Anda.
Apa yang harus ditampilkan dashboard
Grafik harus memisahkan bundle saat ini, bundle sebelumnya, dan bundle lama yang masih beredar. Tambahkan jumlah crash di samping setiap versi agar tim bisa membedakan apakah rilis lama hanya umum atau benar-benar berisiko. Jika versi lama dan tidak stabil, itu kandidat kuat untuk didepresiasi.
Gunakan semantic versioning untuk bundle native dan web agar laporan tetap mudah dibaca. Kebijakan dukungan seperti “hanya tiga versi bundle terakhir” memberi dashboard kriteria lolos atau gagal yang jelas. Tanpa kebijakan, riwayat versi menjadi museum, bukan alat operasional.
Untuk melihat implementasi praktisnya, panduan riwayat versi aplikasi Capgo adalah pelengkap yang tepat. Keputusan pentingnya sederhana. Jika fragmentasi tinggi dan risiko dari versi lama code meningkat, tim sebaiknya tidak lagi menganggap semua versi layak didukung secara setara.
3. Waktu Mencapai Adopsi X%
Waktu adopsi X% mengubah jangkauan menjadi kecepatan. Alih-alih bertanya apakah pengguna akhirnya melakukan update, metrik ini menanyakan berapa lama waktu yang dibutuhkan untuk mencapai persentase target, seperti 50%, 80%, atau 95%. Untuk perbaikan live, kecepatan itu penting karena masalah terus memengaruhi pengguna sampai bundle baru aktif.
Tim yang menangani incident response dapat menetapkan target untuk mencapai ambang batas tertentu dalam jendela waktu tetap, lalu melaporkan median setiap bulannya. Tim produk dapat membandingkan dua rilis checkout dan melihat mana yang lebih cepat diadopsi pengguna. Tampilan dashboard sebaiknya berupa kurva, bukan satu angka, karena ekor kurva menunjukkan di mana adopsi macet.
Gunakan median dan perilaku tail bersamaan
Nilai rata-rata menyembunyikan pengguna yang tertinggal. Median menunjukkan kecepatan rollout yang tipikal, sementara persentil lebih tinggi mengungkap cohort yang lebih lambat yang mungkin masih tertahan di rilis lama atau jarang membuka aplikasi. Jika hanya melaporkan rata-rata, Anda bisa melewatkan kelompok yang masih menunggu perbaikan.
Metrik ini sangat berguna untuk aplikasi yang melakukan update saat peluncuran berikutnya. Jika pengguna jarang membuka kembali aplikasi, rilis Anda mungkin sudah tersedia secara teknis, tetapi tertunda secara fungsional. Panduan metrik update real-time dari Capgo sangat cocok di sini, karena dashboard harus mencerminkan waktu kedatangan yang sebenarnya, bukan sekadar waktu publish.
Threshold harus ditetapkan berdasarkan tingkat keparahan. Perbaikan kritis butuh target yang lebih ketat dibanding perubahan kosmetik, dan tim harus memutuskannya sebelum rollout dimulai. Jika adopsi rilis masih naik tetapi masalahnya mendesak, Anda sudah tahu bahwa pipeline update adalah bottleneck-nya.
4. Kurva Adopsi Staged Rollout
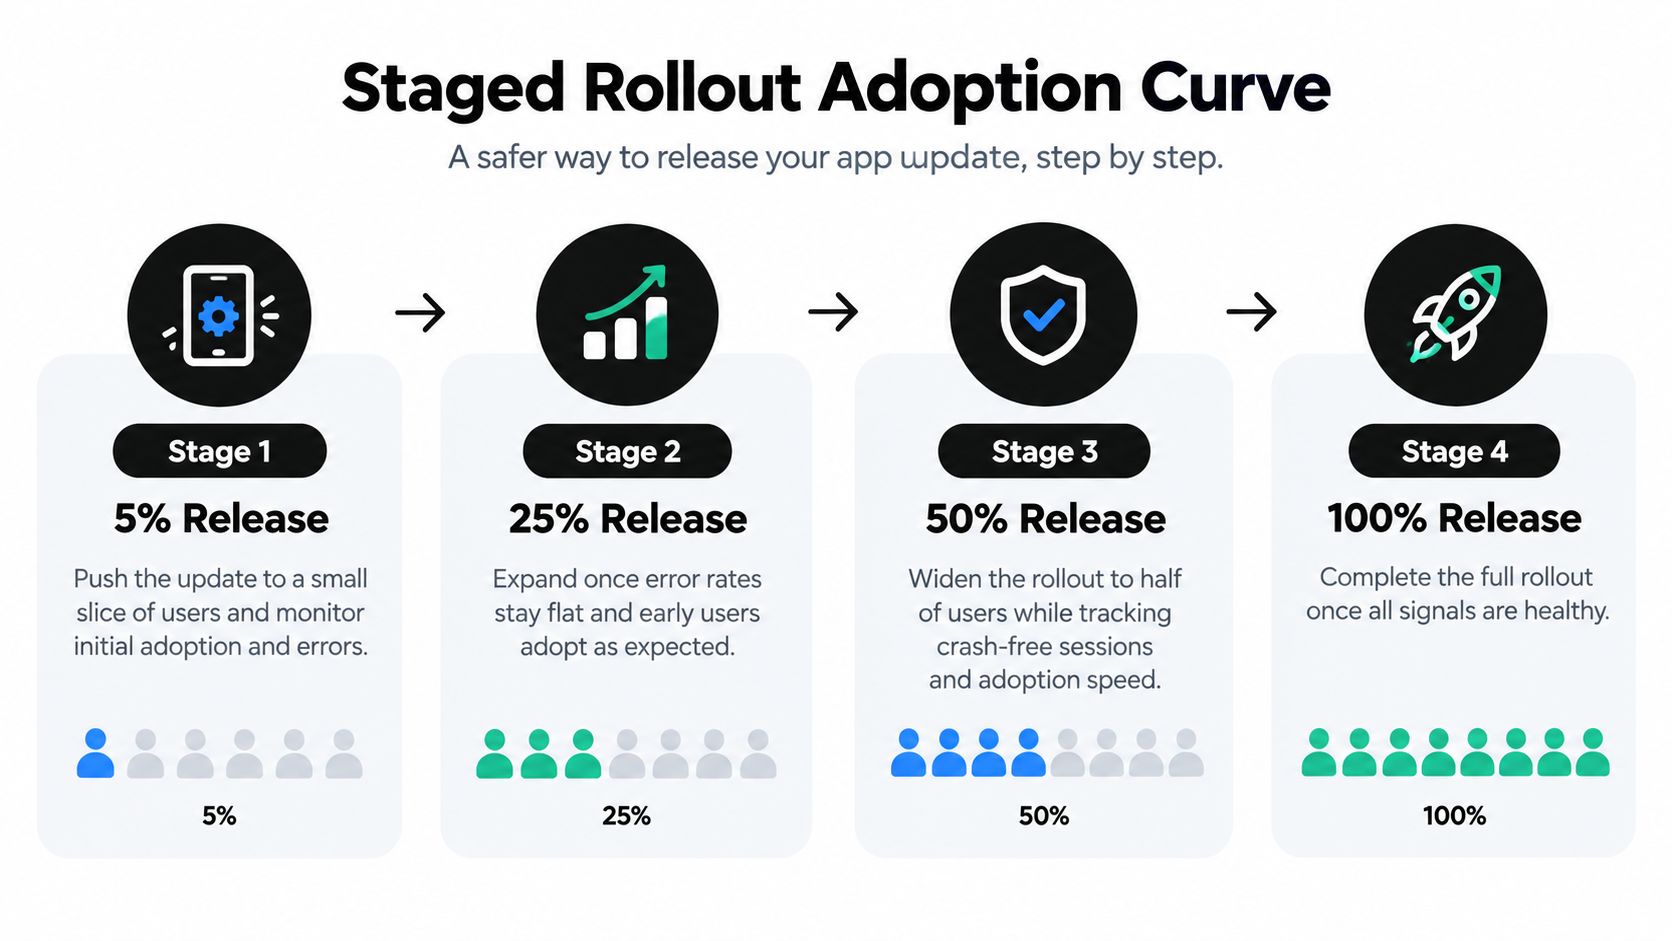
Kurva adopsi staged rollout menunjukkan bagaimana eksposur meluas dari kohort kecil ke seluruh basis pengguna. Ini melacak adopsi di setiap release gate, seperti 5%, 25%, 50%, dan 100%. Kurva tersebut memberi bukti bagi pemilik rilis sebelum mereka memperluas blast radius. Gunakan dashboard untuk membandingkan tingkat adopsi, tren error, dan tren crash tiap kohort, agar keputusan go/no-go selalu didasarkan pada tampilan yang sama.
Tim layanan kesehatan bisa merilis ke audiens kecil terlebih dahulu, memastikan tingkat error tetap stabil, lalu memperluasnya. Tim enterprise bisa mengarahkan stream khusus pelanggan ke satu akun sebelum memindahkan bundle yang sama ke produksi. Setiap tahap butuh satu owner dan satu titik keputusan. Jika kohort berikutnya berperilaku berbeda dari sebelumnya, hentikan rollout. Memperluas rilis ke arah masalah adalah eksposur, bukan progres.
Dashboard harus menampilkan tahap saat ini, tingkat adopsi yang tercapai, dan tren kesehatan yang diamati pada tahap tersebut. Tambahkan label go/no-go yang jelas agar review tetap tidak ambigu. Untuk tim yang membutuhkan playbook rollout live-update, panduan rollout bertahap Capgo untuk live updates Capacitor adalah referensi praktis. Untuk memvisualisasikan perilaku kohort antar tahap, lihat panduan kurva retensi tim atribusi. Rollout bertahap yang sehat bersifat disengaja. Ini mencegah tim menganggap kecepatan sebagai keberhasilan ketika tujuannya adalah ekspansi yang aman.
5. Tingkat Keberhasilan Install Update
Update install success rate mengukur proporsi upaya update yang berhasil diunduh, diverifikasi, dan diterapkan di perangkat. Ini berbeda dari adopsi. Sebuah bundle bisa tersedia untuk semua orang tetapi tetap gagal pada tahap unduhan atau verifikasi.
Tim yang melihat tingkat keberhasilan rendah pada build Android tertentu mungkin melacaknya ke pengaturan kompresi atau masalah penandatanganan. Aplikasi e-commerce bisa menemukan bahwa unduhan yang gagal terkonsentrasi di satu wilayah, lalu mengalihkan lalu lintas pengiriman ke edge yang lebih dekat. Dashboard memerlukan tampilan siklus hidup langkah demi langkah agar masalah pengiriman tidak tertukar dengan masalah runtime.
Bagi pipeline menjadi beberapa tahap
Catat setiap langkah utama secara terpisah, seperti download dimulai, download selesai, signature terverifikasi, dan bundle diterapkan. Jika satu tahap gagal, perbaikannya ada di sana. Jika seluruh rantai bermasalah, penyebabnya bisa jadi jaringan, packaging, atau kompatibilitas perangkat.
Pasang alert saat success rate turun di bawah baseline yang Anda percayai. Tim biasanya menetapkan standar tinggi di sini karena live update seharusnya menjadi rutinitas, bukan sesuatu yang rapuh. Panduan monitoring OTA Capgo untuk aplikasi Capacitor berguna untuk menyusun observability tersebut.
Threshold yang baik adalah yang memicu tindakan sebelum pengguna menyadari pola kegagalan. Jika error verifikasi muncul di CI, rilis tersebut tidak boleh sampai ke production. Keputusan praktisnya sederhana: pisahkan fault delivery dari fault aplikasi, kalau tidak, setiap review insiden akan mengaburkan penyebab utamanya.
6. Tingkat Rollback
Rollback rate mengukur seberapa sering sebuah rilis dibatalkan setelah masalah muncul. Ini bisa dilacak per rilis atau per perangkat, dan kedua tampilan tersebut penting. Untuk live updates, rollback adalah katup pengaman, jadi metrik ini memberi tahu seberapa sering katup tersebut harus terbuka.
Tim fintech mungkin melihat trigger rollback otomatis saat crash rate melonjak di awal rollout. Agensi dapat menggunakan tren rollback di berbagai aplikasi klien untuk menentukan di mana QA perlu diperketat. Dashboard harus memisahkan rollback otomatis dari rollback manual karena kedua penyebab itu menunjukkan hal yang berbeda tentang prosesnya.
Apa yang perlu ditinjau setelah rollback
- Sumber pemicu: Apakah berbasis crash, berbasis dukungan, atau diinisiasi secara manual?
- Waktu rollback: Apakah sistem pulih cukup cepat untuk mengurangi dampak pada pengguna?
- Radius dampak: Berapa banyak perangkat yang terpapar sebelum rollback selesai?
Ambang batas di sini bukan angka universal yang tetap. Ini soal kebijakan. Kalau rilis sering di-rollback, tim harus mencari celah di pemeriksaan pra-rilis, cakupan perangkat, atau logika staged rollout.
Rollback tidak otomatis berarti gagal. Kadang itu justru hasil yang benar, terutama saat rilis jelas lebih buruk daripada build sebelumnya. Kegagalan sebenarnya adalah membiarkan rollback jadi pengganti rutin bagi disiplin rilis.
7. Tingkat Perangkat Stale
Stale device rate menunjukkan persentase perangkat aktif yang belum diperbarui dalam jendela waktu tertentu, seperti 30 atau 60 hari. Ini penting karena perangkat yang tertinggal akan melewatkan perbaikan, patch keamanan, dan fitur baru. Di lingkungan teregulasi, keterlambatan itu bisa jadi masalah kepatuhan.
Aplikasi kesehatan mungkin mengirim prompt in-app ketika perangkat terlalu tertinggal. Pelanggan enterprise mungkin mewajibkan semua perangkat lapangan diperbarui dalam jendela waktu tertentu, dan tim rilis melacak kepatuhan secara mingguan. Dashboard harus memisahkan perangkat yang digunakan secara aktif dari pengecualian yang diketahui seperti perangkat offline atau kiosk.
Grafik stale-device hanya berguna jika tim bisa menindaklanjutinya. Jika metrik tersebut menyertakan perangkat yang memang tidak bisa di-update, sinyalnya akan cepat jadi noise.
Threshold harus berbeda tiap tipe rilis. Update terkait keamanan butuh batas staleness yang lebih ketat dibanding tweak fitur. Jika cohort stale meningkat setelah rilis, masalahnya mungkin ada pada friksi rollout, prompting yang lemah, atau pengguna yang jarang membuka aplikasi sehingga melewatkan jendela update.
Gunakan in-app notice sebelum memaksa update. Ini memberi pengguna opsi tanpa membuat setiap pengingat menjadi hard stop. Keputusan praktisnya adalah apakah tim ingin meningkatkan kepatuhan, mengurangi risiko support, atau mendorong fitur. Metrik harus mencerminkan tujuan tersebut.
8. Rasio Efisiensi Differential Update
Rasio efisiensi differential update mengukur berapa banyak byte yang dihemat dengan hanya mengirim file yang berubah alih-alih full bundle. Ini adalah metrik bandwidth, tapi juga memengaruhi waktu instalasi dan biaya data. Update yang lebih kecil biasanya mengurangi friksi pengguna, terutama pada koneksi berkuota.
Tim yang mayoritas mengubah CSS dan copy mungkin melihat penghematan besar dan memakainya untuk membenarkan rilis kecil yang sering. Tim produk lain mungkin memisahkan gambar ke asset channel tersendiri agar delta code tetap ramping. Dashboard harus membandingkan ukuran delta berdasarkan tipe rilis, bukan hanya secara agregat.
Mengapa metrik ini mengubah perilaku adopsi
Update yang lebih kecil cenderung terasa lebih ringan bagi pengguna. Hal ini tidak menjamin adopsi, tetapi dapat menghilangkan satu alasan penundaan yang jelas. Jika pengguna berada di jaringan lambat, bundle yang ringkas jauh lebih mungkin diterapkan sebelum mereka menyerah.
Ini adalah salah satu tempat paling jelas di mana pilihan engineering memengaruhi perilaku rilis. Pisahkan aset statis dari code yang bergerak cepat. Lalu bandingkan perbaikan copy, perubahan config, dan feature bundle agar Anda bisa mengetahui jenis rilis mana yang membuat delta membengkak.
Jika delta tetap kecil, rilis memiliki lebih sedikit hal yang harus diatasi. Itulah intinya.
Metrik ini tidak memerlukan threshold yang kompleks, melainkan baseline. Tim harus tahu seperti apa "normal" untuk setiap jenis rilis dan menyelidiki ketika perubahan kecil menghasilkan payload yang terlalu besar. Itu biasanya berarti struktur bundle perlu dibersihkan.
9. Sesi Tanpa Crash pada Cohort Terupdate
Crash-free sessions pada kohort yang diperbarui mengukur proporsi sesi pada rilis baru yang tidak crash. Ini adalah metrik kualitas, tetapi juga metrik adopsi karena rilis yang terlalu sering crash tidak bisa dianggap sebagai adopsi yang sehat. Membandingkan grup yang diperbarui dengan versi sebelumnya membantu mengisolasi efek dari perubahan tersebut.
Tim mungkin melihat crash-free sessions turun pada bundle baru dan memicu rollback. Developer indie bisa membandingkan build yang diperbarui dengan build lama selama 48 jam pertama dan mencari regresi. Dashboard harus menampilkan cohort baru dan cohort sebelumnya secara berdampingan, karena konteks lebih penting daripada sekadar angka mentah.
Apa saja yang perlu dibandingkan
Sertakan native crash, error JavaScript, dan failed load untuk aplikasi Capacitor. Native crash rate yang bersih tetap bisa menyembunyikan kerusakan front-end jika layer web tidak stabil. Jika cohort terbaru lebih buruk dari baseline, rilis tidak boleh tetap berjalan hanya karena angka adopsi tinggi.
Metrik ini juga butuh ukuran sampel minimum sebelum menarik kesimpulan pasti. Cohort kecil bisa sangat fluktuatif sehingga sulit dipercaya. Threshold harus ditetapkan sebagai aturan regresi relatif, bukan hanya sebagai angka absolut statis.
Gunakan metrik ini bersama rollback rate, bukan sebagai penggantinya. Satu metrik menunjukkan bagaimana rilis berperilaku, yang lain menunjukkan apa yang dilakukan sistem sebagai respons. Keduanya memberikan gambaran yang jauh lebih baik apakah update tersebut layak tetap live.
10. Distribusi Adopsi Channel
Distribusi adopsi channel menunjukkan sebaran perangkat aktif di beta, staging, production, atau stream khusus pelanggan. Ini membantu Anda memastikan orang yang tepat menerima rilis yang tepat pada waktu yang tepat. Metrik ini juga mendeteksi salah satu kesalahan yang paling mudah terjadi: trafik testing bocor ke production atau pengguna production malah berada di channel test.
Tim e-commerce yang teregulasi dapat memastikan tidak ada perangkat production yang tidak sengaja masuk ke beta setelah rilis. Agensi dapat melacak channel khusus pelanggan dan menonaktifkan channel yang sudah tidak dipakai. Dashboard harus menampilkan keanggotaan channel cukup jelas agar salah rute langsung terlihat.
Gunakan channel sebagai guardrail, bukan label
Channel hanya berguna jika diterapkan dengan ketat. Jika tester, staf internal, dan pilot customer semuanya bergeser ke stream yang sama, proses rilis akan kehilangan batas keamanannya. Dokumentasikan channel dengan baik, dan tinjau distribusinya sebelum setiap rilis besar.
Pasang alert untuk keanggotaan yang tidak terduga, terutama jika perangkat beta muncul di production atau sebaliknya. Satu pengecekan ini dapat mendeteksi paparan tidak sengaja sebelum menjadi masalah support. Pemetaan channel yang rapi juga mempercepat post-mortem karena tim bisa melihat siapa menerima apa dan kapan.
Ambang batas praktisnya adalah apakah distribusi sesuai dengan tujuan. Jika tidak, proses rilisnya bocor. Dalam sistem live update, ini bukan masalah kosmetik, melainkan masalah kontrol.
Perbandingan 10 Metrik Adopsi
| Metrik | 🔄 Kompleksitas Implementasi | ⚡ Kebutuhan Sumber Daya | 📊 Hasil yang Diharapkan | 💡 Kasus Penggunaan Ideal | ⭐ Keunggulan Utama |
|---|---|---|---|---|---|
| Tingkat Adopsi Update | Rendah, pengecekan versi dan definisi perangkat aktif | Rendah, agregasi dan segmentasi periodik | % perangkat aktif pada versi target seiring waktu | Keputusan go/no-go, pemantauan hotfix, pemeriksaan lintas platform | Indikator kesehatan rilis yang jelas dalam satu angka |
| Distribusi Versi (Indeks Fragmentasi) | Sedang, jumlah per versi dan visualisasi time-series | Sedang, penyimpanan historis dan segmentasi | Visibilitas sebaran pengguna antar versi dan beban dukungan | Prioritas kompatibilitas/pengujian dan pemaksaan update | Menunjukkan versi lama mana yang memerlukan dukungan |
| Waktu hingga Adopsi X% (Kecepatan Adopsi) | Sedang, event bertimestamp dan kurva kumulatif | Sedang, perhitungan persentil dan plot | Metrik kecepatan (median/p90) untuk mencapai ambang adopsi | Respons insiden, benchmarking kecepatan rilis | Benchmark seberapa cepat pengguna menerima perbaikan |
| Kurva Adopsi Staged Rollout | Tinggi, orkestrasi persentase bertahap dan aturan gating | Tinggi, monitoring per tahap, kontrol pause/expand | Eksposur bertahap terkendali dengan sinyal pause/halt | Rilis berisiko, lingkungan teregulasi, rollout teraudit | Membatasi blast radius dan memungkinkan ekspansi aman |
| Tingkat Keberhasilan Instalasi Update | Moderat, instrumentasi tahap download/verify/apply | Moderat–Tinggi, log per perangkat, pelacakan tahap kegagalan | % instalasi berhasil; breakdown tahap kegagalan | Troubleshooting kegagalan pengiriman atau verifikasi | Menunjukkan lokasi kegagalan update untuk debugging lebih cepat |
| Tingkat Rollback | Rendah–Moderat, lacak rollback dan klasifikasikan penyebab otomatis/manual | Rendah, event tracking dan catatan post-mortem | % rilis/perangkat yang di-revert dan waktu rollback | Memvalidasi safety net, mengukur kualitas rilis | Ukuran langsung masalah rilis dan efektivitas rollback |
| Tingkat Perangkat Tidak Terkini | Rendah, hitung umur update terakhir per perangkat aktif | Rendah, timestamp terakhir dilihat/diperbarui dan segmentasi | % perangkat aktif yang tidak diperbarui dalam N hari | Pelaporan keamanan/kepatuhan, outreach, atau pembaruan paksa | Mengidentifikasi perangkat yang kehilangan patch atau fitur |
| Rasio Efisiensi Differential Update | Tinggi, hitung delta byte vs bundle penuh per rilis | Sedang, build diffs dan telemetri per rilis | Rasio byte yang dihemat; rata-rata penghematan per rilis/perangkat | Jaringan terukur, rilis kecil yang sering, perubahan arsitektur | Mengkuantifikasi penghematan bandwidth dan membenarkan pembaruan kecil |
| Crash-Free Sessions pada Kohort yang Diperbarui | Sedang, kohort sesi dan atribusi crash | Sedang, crash reporting, segmentasi, pemeriksaan statistik | Crash-free % untuk kohort baru vs baseline; deteksi regresi | Alert regresi, staged rollouts, pemeriksaan kesehatan rilis | Memisahkan dampak rilis terhadap stabilitas untuk keputusan rollback |
| Distribusi Adopsi Channel | Rendah–Sedang, lacak penugasan dan perubahan channel | Rendah, pemantauan metadata channel dan membership | Proporsi perangkat per channel; paparan yang tidak terduga | Validasi beta testing, pilot enterprise, tata kelola channel | Memvalidasi aturan targeting dan mencegah paparan tidak sengaja |
Mengubah metrik adopsi ini menjadi rutinitas release
Dashboard rilis terbaik tidak mencoba menampilkan segalanya sekaligus. Dashboard tersebut dimulai dengan distribusi adopsi channel dan tingkat keberhasilan instalasi update sehingga Anda tahu bahwa bundle tersebut ditujukan ke audiens yang tepat dan sampai ke perangkat tujuan. Kemudian, ia melacak kurva adopsi staged rollout dan waktu mencapai adopsi X% untuk menunjukkan seberapa cepat rilis menyebar.
Setelah itu, pengecekan kualitas mengambil alih. Sesi bebas crash pada kohort yang diperbarui memberi tahu Anda apakah build baru berjalan lancar, sementara tingkat rollback menunjukkan apakah safety net harus turun tangan. Distribusi versi dan tingkat perangkat usang lengkapi gambaran tersebut dengan menunjukkan seberapa terfragmentasi fleet Anda dan berapa banyak perangkat yang tertinggal.
Review rilis jadi jauh lebih mudah jika tim memilih beberapa metrik saja dan mencatat definisinya sebelum shipping. Pilih tiga metrik untuk rilis berikutnya, tentukan penyebutnya, tetapkan threshold, dan tinjau semuanya di meeting yang sama setiap kali. Jika Anda bekerja dalam alur live-update Capacitor, ritme itulah yang sering mengubah data adopsi mentah menjadi proses rilis yang bisa dipercaya.
Bagi tim yang juga butuh praktik retensi dan tata kelola data yang kuat, Panduan Sift tentang kebijakan retensi data untuk tim media sosial adalah pengingat penting bahwa pengukuran hanya berhasil jika data di baliknya tetap bersih dan bisa dipakai. Kebiasaan merilis lebih penting daripada dashboard itu sendiri. Begitu tim bisa menjelaskan seperti apa “baik” itu, setiap update jadi lebih mudah dirilis, dipertahankan, dan ditingkatkan.
Capgo memberi tim Capacitor dan Electron jalur live-update untuk merilis perbaikan JavaScript, CSS, copy, config, dan asset tanpa menunggu review store. Jika Anda ingin data rilis selaras dengan proses rilis, kunjungi Capgo dan lihat bagaimana signed bundles, channel guardrails, rollback protection, dan metrik adopsi menyatu dalam satu workflow.





