
火曜日の朝、重要な修正がリリースされます。デプロイパイプラインはグリーンになり、リリースノートも問題なさそう。それでもサポートには、修正で解消されるはずだったバグへの苦情が殺到します。このギャップこそが問題のすべてです。リリースを出してインストールされても、ユーザーに意味のある形で届かなければ失敗なのです。
だからこそ アダプションメトリクスの例 Capacitor や同様のリリースシステムにおけるライブアップデートでは、メトリクスが重要です。同じ bundle でも、指標が違えば答える問いも違います。アップデートがデバイスに届いたか、どれだけ速く広がったか、安定性が向上したか、ロールアウトが制御されていたか——それぞれを教えてくれます。
以下に、最も有用なメトリクスを リーチ、スピード、品質、コントロール別に分類しますそれぞれに、計算式、ダッシュボード表示、Live Update の例、失敗モード、リリース会議で使える実用的な閾値があります。
目次
- 1. アップデート採用率
- 2. バージョン分布
- 3. X% 採用までの時間
- 4. ステージドロールアウトの採用曲線
- 5. アップデートインストール成功率
- 6. ロールバック率
- 7. 古いデバイス率
- 8. 差分アップデート効率比
- 9. アップデート済みコホートのCrash-Free Sessions
- 10. チャネル採用率の分布
- 導入指標10項目の比較
- これらの導入指標をリリースルーチンに落とし込む
1. アップデート採用率
アップデート適用率 は live update の中核となる指標です。リリース後、定義された期間内にターゲットの bundle またはバージョンを実行しているアクティブなデバイスの割合を測定します。具体的には、次のことを意味します。 新バージョン上のデバイス数を全アクティブデバイス数で割った値 同じ期間内の数値です。ライブ修正では「重要なデバイスにアップデートが届いたか」という問いに直接答えてくれます。
フィンテックチームなら、ログインパッチが古いbundleに置き換わっているかを判断するのに使えます。ECチームなら、決済修正後のiOSとAndroidの24時間普及率を比較できます。ダッシュボードには、ターゲットバージョン、対象デバイスプール、切り替え済みの割合を表示すべきです。普及率計測ツールの詳細については、 DAPのメリットとKPIを見る プラットフォームレベルの普及率指標を比較できます。
実践的なルール: リリース前に「アクティブデバイス」の定義を文書化しておきましょう。分母がリリースごとに変わると、指標として比較できなくなります。
閾値は重要度に合わせるべきです。セキュリティ修正にはUIの微調整より厳しい目標を設定すべきで、チームはロールアウト開始前にそれを明文化しておく必要があります。アップデートを確認するデバイス数と併せてこの指標を追跡してください。ポーリングが遅いと、健全なリリースでも遅れて見えることがあるためです。同じパターンは、 Capacitor アプリ向け Capgo のOTA成功トラッキングガイドでも確認できます。ここではリリース画面が実際のインストール進捗と紐付いています。
普及率の定義が毎週変わってしまうと、リリース判断に使える指標ではなくなります。
2. バージョン分布
バージョン分布は、ある時点におけるアクティブユーザーが、すべてのライブ bundle にどのように分散しているかを示します。これは「断片化マップ」と考えると分かりやすいでしょう。もし多くのユーザーが古いバージョンに分散したままであれば、サポートチームは本来よりも多くの code パスに対応しなければならないことになります。
例えばヘルスケアアプリの場合、レガシーな bundle がかなりの割合のデバイスでまだ稼働していることが判明すれば、摩擦を考慮しても強制アップデートを行う価値があると判断できます。また、複数のクライアントの build を管理するエージェンシーであれば、このビューを使用して、どの Capacitor プラグインのバージョンを廃止しても安全かを判断できます。重要なのは単なる「古さ」ではなく、チームがサポートしなければならない「実行環境の種類の多さ」です。
ダッシュボードに表示すべき内容
チャートでは以下を分けて表示します 現在の bundle, 前の bundleや 現在も利用されている古い bundle. 各バージョンの横にクラッシュ数を表示すると、古いリリースが単に広く使われているだけなのか、実際にリスクがあるのかをチームが判断できます。バージョンが古く不安定なら、非推奨化の有力候補です。
レポートの可読性を保つため、ネイティブと Web の両方の bundle にセマンティックバージョニングを使用してください。「最新の3つの bundle バージョンのみをサポートする」といったサポートポリシーを定めることで、ダッシュボードで明確な合否判定が可能になります。ポリシーがなければ、バージョン履歴は運用ツールではなく、単なる「展示品」になってしまいます。
実装の実践的な観点では、 Capgoのアプリのバージョン履歴ガイド を併せてご覧ください。判断はシンプルです。断片化が進み、古いcodeによるリスクが高まっているなら、すべてのバージョンを等しくサポート対象にするのはやめるべきです。
3. X% 採用までの時間
「X%到達までの時間」は、リーチをスピードに変えます。ユーザーが最終的にアップデートしたかどうかではなく、50%、80%、95%といった目標シェアに到達するまでの時間を測ります。ライブ修正では、新しいbundleが有効になるまで問題がユーザーに影響し続けるため、スピードが重要です。
インシデント対応チームは、一定期間内に特定の閾値に達することを目標に設定し、毎月中央値を報告できます。プロダクトチームは2つのチェックアウトリリースを比較し、ユーザーがどちらをより早く採用したかを確認できます。ダッシュボードの表示は単一の数字ではなく曲線であるべきです。なぜなら、裾野(テール)が採用が停滞している箇所を示してくれるからです。
中央値とテールの挙動を組み合わせて見る
平均値は遅れているユーザーを隠してしまいます。中央値は典型的なロールアウト速度を示し、高いパーセンタイルは古いリリースに留まっているか、アプリを開く頻度が低い遅いコホートを浮き彫りにします。平均値のみを報告すると、まだ修正を待っているグループを見逃す可能性があります。
この指標は、次回起動時に更新されるアプリに特に有用です。ユーザーが頻繁にアプリを再開しない場合、リリースは技術的には利用可能であっても、機能的には遅延していることになります。 Capgoのリアルタイム更新メトリクスガイド がここでは適しています。ダッシュボードには公開時刻ではなく、実際の到着時刻を反映させる必要があるためです。
閾値は重大度レベルごとに定義すべきです。クリティカルな修正は外観変更よりも厳しい目標が必要です。チームはロールアウト開始前にこれを決定すべきです。リリースがまだ上昇中だが問題が緊急の場合、更新パイプラインがボトルネックであることがすでにわかります。
4. ステージドロールアウトの採用曲線
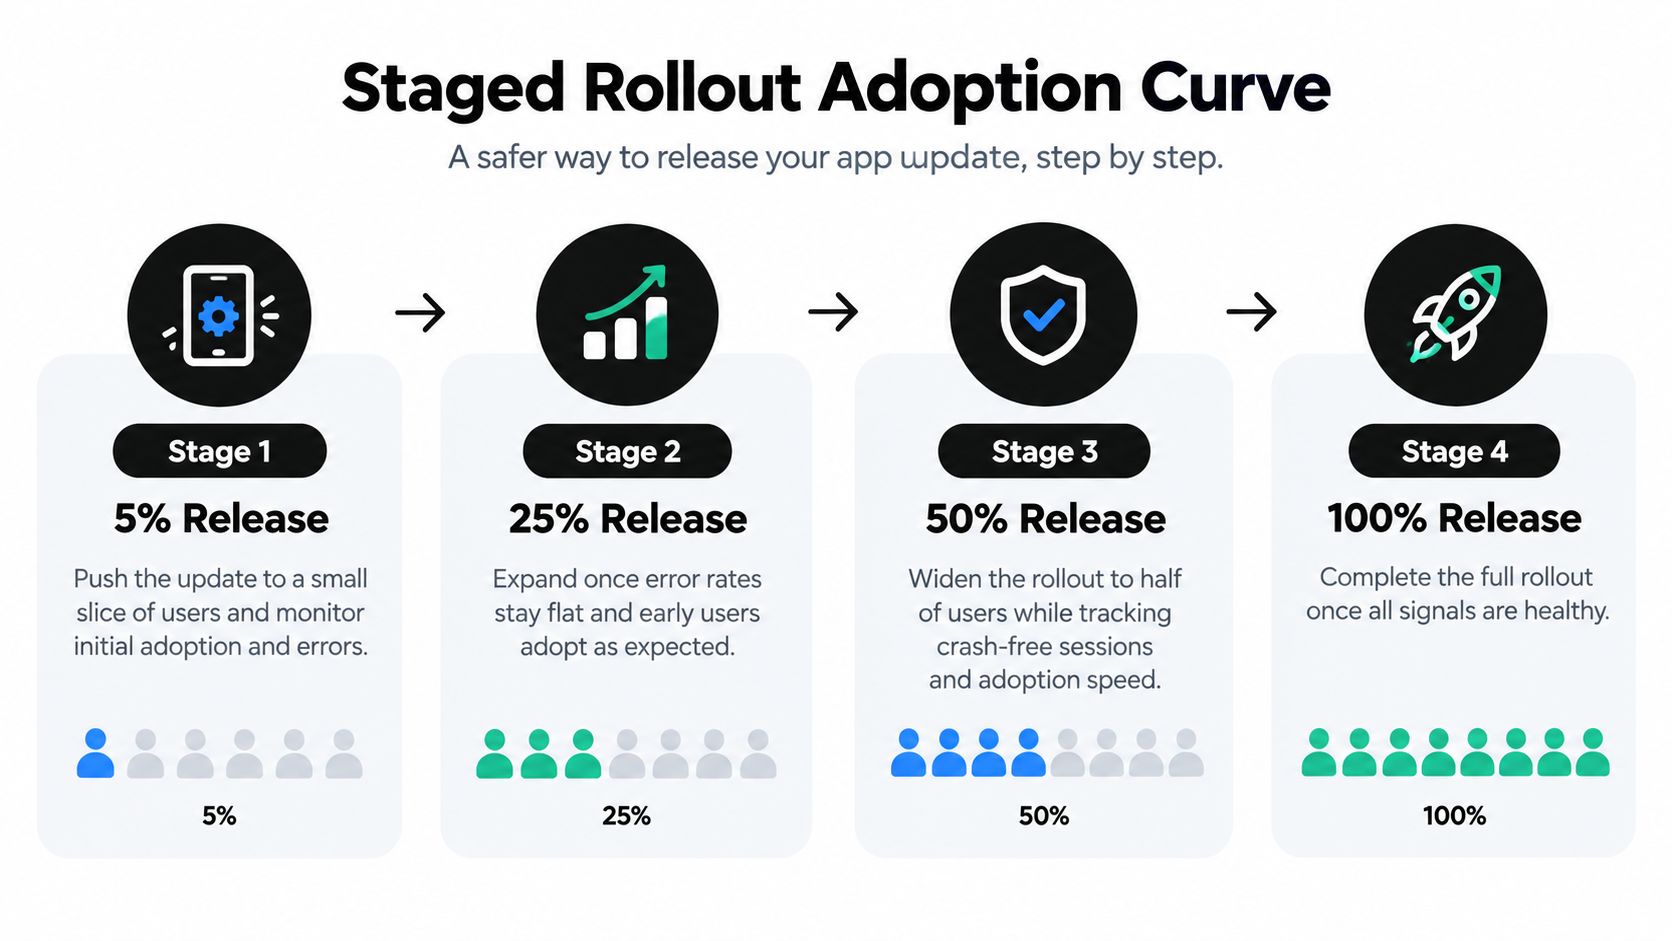
段階的ロールアウトの採用曲線は、小さなコホートから全ユーザーベースへと公開範囲が広がる様子を示します。5%、25%、50%、100%などの各リリースゲートで採用状況を追跡します。この曲線により、リリース担当者は影響範囲を広げる前に根拠を得られます。ダッシュボードで各コホートの採用率、エラー傾向、クラッシュ傾向を比較し、Go/No-Go判断を毎回同じビューに基づいて行えます。
ヘルスケアチームは、まずごく小規模なオーディエンスにリリースし、エラー率が横ばいであることを確認してから拡大できます。エンタープライズチームは、同じバンドルを本番環境に移す前に、顧客固有のストリームを1つのアカウントに向けられます。各段階には1人のオーナーと1つの判断ポイントが必要です。次のコホートが前回と異なる挙動を示したら、ロールアウトを停止してください。問題が起きている状態へ範囲を広げるのは前進ではなく、露出を増やすだけです。
ダッシュボードには、現在の段階、到達した採用レベル、その段階で観測された健全性トレンドを表示すべきです。レビューが曖昧にならないよう、明確なGo/No-Goラベルを追加してください。Live Updatesのロールアウトプレイブックが必要なチームには、 CapgoのCapacitor Live Updates向け段階的ロールアウトガイド が実用的な参考資料です。ステージ間のコホートの挙動を可視化するには、 アトリビューションチームのリテンション曲線ガイドを参照してください。健全な段階的ロールアウトは意図的に行うものです。目標が安全な拡大であるとき、チームがスピードを成功と取り違えないようにします。
5. アップデートインストール成功率
Update install success rate は、デバイス上でダウンロード、検証、適用がすべて成功した更新試行の割合を測定します。これは採用率とは異なります。バンドルが全ユーザーに利用可能であっても、ダウンロードや検証の段階で失敗する可能性があります。
特定のAndroidビルドで成功率が低下しているチームは、圧縮設定や署名の問題に原因を特定できる場合があります。ECアプリでは、ダウンロード失敗が特定の地域に集中していることが判明し、より近いエッジへの配信トラフィックの切り替えを行うこともできます。ダッシュボードには、配信上の問題とランタイム上の問題を混同しないよう、ライフサイクルの段階を追ったビューが必要です。
パイプラインをステージごとに分割する
ダウンロード開始、ダウンロード完了、署名検証、バンドル適用といった主要なステップを個別にログ出力してください。特定の段階で失敗が集中している場合、修正箇所はそこです。チェーン全体が不安定な場合は、ネットワーク、パッケージング、デバイス互換性が原因である可能性があります。
信頼できる基準値を下回った際にアラートを設定してください。live update は脆いものではなく、ルーティンであるべきなので、チームはここで高い基準を設けることが多いです。 CapgoによるCapacitorアプリ向けOTAモニタリングガイド その可観測性を構造化するために有用です。
良い閾値とは、ユーザーが障害パターンに気づく前にアクションをトリガーするものです。CIで検証エラーが発生した場合、リリースは本番環境に到達すべきではありません。実務的な判断はシンプルです。配信上の障害とアプリケーション上の障害を区別しなければ、すべてのインシデントレビューで根本原因が曖昧になります。
6. ロールバック率
ロールバック率は、問題発生後にリリースが巻き戻される頻度を測定します。リリース単位でもデバイス単位でも追跡でき、両方の視点が必要です。Live Updateではロールバックが安全弁となるため、このメトリクスは安全弁が開く頻度を示します。
フィンテックチームは、ロールアウト初期にクラッシュ率が急上昇した際に自動ロールバックがトリガーされるのを確認するかもしれません。エージェンシーは、クライアントアプリ全体のロールバック傾向を分析して、QAを厳格化するべき箇所を判断できます。ダッシュボードは以下を分離すべきです 自動ロールバック と 手動ロールバック これらの原因は、プロセスについて異なることを示しているためです。
ロールバック後にレビューすべき項目
- トリガーソース: クラッシュベース、サポートベース、それとも手動で開始されたものですか?
- ロールバックまでの時間: ユーザーへの影響を軽減するために、システムは十分に速く復旧したか?
- 影響範囲: ロールバックが完了するまでに、何台のデバイスが影響を受けたか?
ここでの閾値は固定された普遍的な数値ではありません。これはポリシーの問題です。リリースが頻繁にロールバックされる場合、チームはリリース前のチェック、デバイスカバレッジ、または段階的ロールアウトロジックのギャップを調査すべきです。
ロールバックは自動的に失敗を意味しません。リリースが以前のビルドよりも明らかに劣っている場合、ロールバックは正しい結果であることもあります。失敗とは、ロールバックをリリース規律の常態的な代替手段として許容することです。
7. 古いデバイス率
古いデバイス率は、定義された期間(例:30日または60日)内に更新されていないアクティブデバイスの割合を示します。古いデバイスは修正、セキュリティパッチ、新機能を逃すため重要です。規制の厳しい環境では、この遅れがコンプライアンス問題になり得ます。
ヘルスケアアプリでは、デバイスが大幅に遅れている場合にアプリ内プロンプトを送信することがあります。エンタープライズ顧客は、フィールドデバイスのすべてが一定期間内に更新されることを要求し、リリースチームが週次でコンプライアンスを追跡することがあります。ダッシュボードでは、アクティブに使用されているデバイスと、オフラインやキオスクハードウェアのような既知の例外を区別すべきです。
「古いデバイス」のチャートは、チームがそれに基づいてアクションを起こせなければ意味がありません。設計上アップデートできないデバイスが指標に含まれていると、シグナルはすぐにノイズだらけになってしまいます。
しきい値はリリースタイプごとに変えるべきです。セキュリティ関連のアップデートは、機能の微調整よりも厳しい鮮度制限が必要です。リリース後に古いデバイスの層が増える場合、原因はロールアウトの摩擦、プロンプトの弱さ、あるいはアップデートのタイミングを逃すほどアプリの起動頻度が低いユーザーかもしれません。
強制アップデートの前に、アプリ内通知を活用しましょう。そうすれば、すべてのリマインダーを強制的な中断にすることなく、ユーザーに次のステップを提示できます。実務上の判断は、チームがコンプライアンスの向上、サポートリスクの軽減、機能の推進のどれを目指しているかです。指標はその目的を反映すべきです。
8. 差分アップデート効率比
差分アップデート効率比は、フルバンドルではなく変更されたファイルだけを送信することで、何バイト節約できたかを測る指標です。帯域幅の指標ですが、インストール時間やデータコストにも影響します。アップデートが小さいほどユーザーの摩擦は減り、特に従量制接続では重要です。
CSSやコピーの変更が中心のチームは、高い節約効果を得て、それを頻繁な小規模リリースの根拠にできるでしょう。一方、code のデルタを軽く保つために、画像を別のアセットチャネルに分けるプロダクトチームもあります。ダッシュボードでは、合計値だけでなくリリースタイプごとにデルタサイズを比較すべきです。
この指標がアップデート適用行動を変える理由
小さいアップデートほど、ユーザーには軽く感じられます。それだけで採用が保証されるわけではありませんが、遅延の明らかな理由を一つ排除できます。低速ネットワークにいるユーザーの場合、コンパクトなバンドルであれば、諦める前に適用される可能性がはるかに高くなります。
エンジニアリング上の選択がリリース挙動に影響する、最も分かりやすい場面の一つです。静的アセットは、変化の速い code と切り離して管理しましょう。その上で、文言修正、設定変更、機能bundleを比較すれば、どのリリースタイプがdeltaを肥大化させているかが分かります。
deltaが小さく保たれていれば、リリースの負担も小さくなります。それが狙いです。
この指標に必要なのは、複雑なしきい値ではなくベースラインです。チームは各リリースタイプの「正常な状態」を把握し、わずかな変更でペイロードが大きくなりすぎたときは調査すべきです。通常、それはbundle構造の整理が必要だということを意味します。
9. アップデート済みコホートのCrash-Free Sessions
アップデート済みコホートのCrash-Free Sessionsは、新しいリリースでクラッシュしなかったセッションの割合を測ります。これは品質指標であると同時に導入指標でもあります。クラッシュが多すぎるリリースは健全な導入とは言えないからです。アップデート済みグループを前バージョンと比較すると、変更の影響を切り分けやすくなります。
新しいbundleでクラッシュフリーセッションの低下に気づき、チームがロールバックを発動するかもしれません。個人開発者なら、最初の48時間は更新後のbuildを以前のbuildと比較してリグレッションを確認できます。ダッシュボードでは新しいコホートと前回のコホートを並べて表示すべきです。生の数値だけでなくコンテキストの方が重要だからです。
比較に含めるべき項目
Capacitor アプリでは、ネイティブクラッシュ、JavaScriptエラー、読み込み失敗を含めます。Webレイヤーが不安定だと、ネイティブクラッシュ率が良好でもフロントエンドの不具合が隠れることがあります。更新後のコホートがベースラインより悪化しているなら、採用率が高くてもリリースを継続すべきではありません。
この指標には、確定的な結論を出す前の最小サンプルサイズも必要です。小さいコホートは変動が大きすぎて信頼できません。しきい値は静的な絶対値だけでなく、相対的なリグレッションルールとして設定すべきです。
この指標はロールバック率の代わりではなく、ロールバック率と組み合わせて使ってください。一方はリリースの挙動を、もう一方はシステムがそれにどう反応したかを示します。両者を合わせれば、アップデートを公開したままにすべきかがよりよく判断できます。
10. チャネル採用率の分布
チャネル採用分布は、beta、staging、production、顧客別チャネルにアクティブデバイスがどう分散しているかを示します。適切なユーザーが適切なタイミングで適切なリリースを受け取れているかを確認できます。また、テストトラフィックがproductionに漏れたり、productionユーザーがテストチャネルに残っていたりする、よくあるミスを検知できます。
規制の厳しいECチームは、リリース後にproductionデバイスが誤ってbetaに紛れ込んでいないことを確認できます。代理店は顧客別チャネルを追跡し、使われなくなったチャネルを廃止できます。ダッシュボードでは、誤ルーティングが一目で分かるよう、チャネルメンバーシップを明確に表示すべきです。
ラベルではなく、ガードレールとしてチャンネルを活用する
チャネルは厳格に運用されて初めて役立ちます。テスター、社内スタッフ、顧客パイロットが同じストリームに流れ込むと、リリースプロセスの安全境界が失われます。チャネルをドキュメント化し、主要リリースの前に分布を確認してください。
予期しないメンバーシップ、特にproductionにbetaデバイスが現れたりその逆が起きたりした場合にアラートを設定しましょう。このチェックだけで、サポート問題になる前に意図しない公開を防げます。チャネルマップが整理されていれば、誰がいつ何を受け取ったかをチームが確認できるため、ポストモーテムも迅速になります。
実用的な判断基準は、分布が意図と一致しているかどうかです。一致していなければ、リリースプロセスに漏れがあります。Live Updateシステムでは、これは表面的な問題ではなく、制御上の問題です。
導入指標10項目の比較
| メトリクス | 🔄 実装の複雑さ | ⚡ リソース要件 | 📊 期待される成果 | 💡 最適なユースケース | ⭐ 主な利点 |
|---|---|---|---|---|---|
| アップデート適用率 | 低、バージョンチェックとアクティブデバイスの定義 | 低コスト、定期的な集計とセグメンテーション | 対象バージョン上のアクティブデバイス比率(時系列) | Go/No-Go 判断、ホットフィックス監視、クロスプラットフォーム確認 | 明確な単一数値によるリリース健全性指標 |
| バージョン分布(フラグメンテーション指数) | 中程度のコスト、バージョン別カウントと時系列可視化 | 中程度:履歴の保存とセグメンテーション | バージョン間のユーザー分布とサポート負荷の可視化 | 互換性・テストの優先順位付けと強制アップデート | サポートが必要な旧バージョンの特定 |
| X%採用までの時間(採用速度) | 中程度:タイムスタンプ付きイベントと累積曲線 | 中程度:パーセンタイル計算とプロット | 採用しきい値に達するまでの速度指標(中央値/p90) | インシデント対応、リリース速度のベンチマーク | ユーザーへの修正適用スピードのベンチマーク |
| 段階的ロールアウトの採用曲線 | 高:段階的配信の割合とゲートルールのオーケストレーション | 高、ステージ別モニタリング、pause/expand コントロール | 一時停止・停止シグナルによる制御された段階的公開 | リスクの高いリリース、規制環境、監査が必要なロールアウト | 影響範囲(blast radius)を抑え、安全な拡大を可能にする |
| アップデートのインストール成功率 | 中程度、download/verify/apply 各ステージの計測 | 中〜高、デバイスごとのログ、失敗ステージの追跡 | インストール成功率(%)、失敗ステージの内訳 | 配信または検証の失敗に関するトラブルシューティング | Update の失敗箇所を特定し、デバッグを高速化 |
| ロールバック率 | 低〜中程度、ロールバックを追跡し、自動/手動の原因を分類 | 低コスト:イベントトラッキングとポストモーテム記録 | ロールバックされたリリース/デバイスの割合とロールバックまでの時間 | セーフティネットの検証、リリース品質の測定 | リリース問題とロールバックの有効性を直接測定 |
| 未更新デバイス率 | 低コスト:アクティブデバイスごとに最終更新からの経過時間を計算 | 低コスト:最終確認/更新タイムスタンプとセグメンテーション | N日以内に更新されていないアクティブデバイスの割合 | セキュリティ/コンプライアンスレポート、通知または強制アップデート | パッチや機能が適用されていないデバイスを特定 |
| 差分更新効率比 | 高コスト:リリースごとにフルbundleに対する差分バイト数を算出 | 中程度、ビルド差分とリリースごとのテレメトリ | 節約されたバイト数比率; リリース/デバイスあたりの平均節約量 | メーターリングネットワーク、高頻度の小規模リリース、アーキテクチャ変更 | 帯域幅の節約を定量化し、小規模アップデートの正当性を示す |
| 更新済みコホートのクラッシュフリーセッション | 中程度、セッションのコホート化とクラッシュの帰属 | 中程度、クラッシュレポート、セグメンテーション、統計的チェック | 新規コホートとベースラインコホートのクラッシュフリー率; レグレッション検出 | レグレッションアラート、段階的ロールアウト、リリース健全性チェック | ロールバック判断のために、リリースが安定性に与える影響を分離 |
| チャネル採用分布 | 低〜中程度、チャネル割り当てと変更の追跡 | 低、チャネルメタデータとメンバーシップの監視 | チャネルごとのデバイス割合; 予期しない露出 | ベータテスト検証、エンタープライズパイロット、チャネルガバナンス | ターゲティングルールの検証と、意図しない露出の防止 |
これらの導入指標をリリースルーチンに落とし込む
最適なリリースダッシュボードは、一度にすべてを表示しようとはしません。まず チャネル採用率の分布 と アップデートインストール成功率 bundleが正しいターゲット層に届き、デバイスに適用されていることを確認できます。次に、 段階的ロールアウトの採用曲線 と X%到達までの時間 リリースがどれだけ早く広がるかを示します。
その後は、品質チェックに移ります。 アップデート済みコホートのクラッシュフリーセッション率 は、新しいビルドが正常に動作しているかを示し、一方で ロールバック率 は、セーフティネットが介入する必要があったかを示します。 バージョン分布 と 未更新デバイスの割合 は、デバイス群がどれだけ断片化しているか、どれだけのデバイスが遅れているかを示し、全体像を補完します。
チームが少数のメトリクスを選び、リリース前にその定義を書き留めておけば、リリースレビューは格段に楽になります。次のリリースでは3つのメトリクスを選び、分母を定義し、しきい値を設定して、毎回同じ会議でレビューしましょう。Capacitor の Live Update フローで運用しているなら、このリズムこそが生の導入データを信頼できるリリースプロセスに変える鍵になります。
強固なデータ保持とデータガバナンスの実践も必要とするチームにとっては、 Siftの「ソーシャルチーム向けデータ保持ポリシー」ガイドは、 測定が機能するには、基盤となるデータがクリーンで使える状態に保たれていることが欠かせない、という良いリマインダーになります。ダッシュボードそのものより、リリースを習慣にすることの方が重要です。チームが「良い状態」を説明できるようになれば、あらゆるアップデートをリリースし、説明し、改善するのが楽になります。
Capgo は、Capacitor や Electron のチームに、ストア審査を待たずに JavaScript、CSS、テキスト、設定、アセットの修正を配信できる Live Updates の手段を提供します。リリースデータをリリースプロセスと一致させたい方は、こちらをご覧ください: Capgo 署名済み bundle、チャネルのガードレール、ロールバック保護、導入メトリクスが一つのワークフローにどう組み込まれるかを確認できます。





