
Un correctif critique est déployé un mardi matin. Le pipeline de déploiement passe au vert, les notes de version sont impeccables, et le support continue de recevoir des plaintes sur le bug que le correctif était censé éliminer. C’est tout le problème. Une release peut être livrée, installée, et ne pas vraiment atteindre les utilisateurs.
C'est pourquoi exemples de métriques d’adoption sont importantes pour les live updates dans Capacitor et les systèmes de release similaires. Différentes métriques répondent à différentes questions sur le même bundle. Certaines indiquent si la mise à jour a atteint les appareils, d'autres à quelle vitesse elle s'est propagée, d'autres encore si elle a amélioré la stabilité, et d'autres enfin si le déploiement progressif a été maîtrisé.
La liste ci-dessous regroupe les métriques les plus utiles par portée, vitesse, qualité et contrôle. Chacune est accompagnée d'une formule, d'une vue dashboard, d'un exemple de live update, d'un mode d'échec et d'un seuil pratique à utiliser lors d'une réunion de release.
Table des matières
- 1. Taux d'adoption des mises à jour
- 2. Distribution des versions
- 3. Délai pour atteindre X % d'adoption
- 4. Courbe d'adoption du déploiement progressif
- 5. Taux de succès d'installation
- 6. Taux de rollback
- 7. Taux d'appareils obsolètes
- 8. Ratio d'efficacité des mises à jour différentielles
- 9. Sessions sans crash sur la cohorte mise à jour
- 10. Répartition de l'adoption par canal
- Comparaison de 10 métriques d'adoption
- Transformer ces métriques d’adoption en routine de release
1. Taux d'adoption des mises à jour
Taux d'adoption des mises à jour est le chiffre clé pour un live update. Il mesure le pourcentage d'appareils actifs exécutant le bundle ou la version cible dans un intervalle défini après la release. En pratique, cela signifie appareils sur la nouvelle version divisé par le total d'appareils actifs sur la même période. Pour un correctif OTA, cela répond à une question simple : la mise à jour a-t-elle atteint les appareils qui comptent ?
Une équipe fintech peut s'en servir pour vérifier si un correctif de connexion remplace bien l'ancien bundle. Une équipe e-commerce peut comparer l'adoption sur 24 heures entre iOS et Android après un correctif de checkout. Le dashboard doit afficher la version cible, le pool d'appareils éligibles et la part qui a déjà basculé. Pour plus de contexte sur les outils d'adoption, consultez les avantages et KPIs de DAP pour comparer les métriques d'adoption au niveau de la plateforme.
Règle pratique : définissez par écrit ce qu'est un « appareil actif » avant de déployer la release. Si le dénominateur change d'une release à l'autre, la métrique n'est plus comparable.
Le seuil doit correspondre à la sévérité. Un correctif de sécurité mérite une cible plus stricte qu'un ajustement d'UI, et l'équipe doit le consigner avant le début du déploiement progressif. Suivez cette métrique en parallèle du nombre d'appareils qui vérifient les mises à jour, car un polling lent peut faire paraître lente une release pourtant saine. Observez le même schéma dans le guide de suivi du succès OTA de Capgo pour les apps Capacitor, où la vue de la release est liée à la progression réelle de l'installation.
Si la définition de l'adoption change chaque semaine, la métrique n'est plus exploitable pour décider des releases.
2. Distribution des versions
La distribution des versions montre comment vos utilisateurs actifs sont répartis sur l'ensemble des bundles live à un instant T. Voyez cela comme une carte de fragmentation. Si trop d'utilisateurs sont encore éparpillés sur d'anciennes versions, votre équipe support gère plus de code que nécessaire.
Une application de santé pourrait découvrir qu'un bundle legacy est encore actif sur une part importante d'appareils et décider qu'une mise à jour forcée vaut la peine malgré la friction. Une agence gérant plusieurs builds clients peut utiliser cette même vue pour décider quelles versions de plugins Capacitor peuvent être retirées sans risque. L'enjeu n'est pas seulement l'âge, mais le nombre d'environnements d'exécution distincts que votre équipe doit encore gérer.
Ce que le dashboard devrait afficher
Le graphique devrait distinguer bundle actuel, bundle précédent, et bundles plus anciens encore en circulation. Ajoutez le nombre de crashs à côté de chaque version pour que l'équipe puisse déterminer si une ancienne release est simplement répandue ou réellement risquée. Si une version est ancienne et instable, c'est une bonne candidate à la dépréciation.
Utilisez le versioning sémantique pour les bundles natifs et web afin que le rapport reste lisible. Une politique de support telle que « uniquement les trois dernières versions de bundles » donne au dashboard un critère clair de réussite ou d'échec. Sans politique, l'historique des versions devient un musée plutôt qu'un outil opérationnel.
Pour une approche pratique, Guide de l’historique des versions d’app de Capgo est le complément idéal. La décision à prendre est simple : si la fragmentation est élevée et que le risque lié aux anciennes code augmente, l'équipe ne doit plus considérer chaque version comme méritant le même niveau de support.
3. Délai pour atteindre X % d'adoption
Le délai pour atteindre X % d'adoption transforme la portée en vitesse. Au lieu de se demander si les utilisateurs ont fini par faire la mise à jour, on cherche à savoir combien de temps il a fallu pour atteindre une part cible, comme 50 %, 80 % ou 95 %. Pour un correctif live, la vitesse compte, car le problème continue d'affecter les utilisateurs tant que le nouveau bundle n'est pas actif.
Une équipe qui gère les incidents peut se fixer comme objectif d'atteindre un seuil donné dans une fenêtre définie, puis communiquer la médiane chaque mois. Une équipe produit peut comparer deux releases de checkout et voir laquelle les utilisateurs ont adoptée le plus vite. La vue du dashboard doit être une courbe, pas un chiffre unique, car la queue de distribution indique où l'adoption stagne.
Combinez médiane et comportement de la queue
Les moyennes cachent les retardataires. La médiane montre la vitesse de déploiement typique, tandis qu'un percentile plus élevé met en évidence les cohortes plus lentes, qui peuvent être bloquées sur d'anciennes versions ou des ouvertures d'app peu fréquentes. Si vous ne communiquez que la moyenne, vous risquez de passer à côté du groupe qui attend encore le correctif.
Cette métrique est particulièrement utile pour les apps qui se mettent à jour au prochain lancement. Si les utilisateurs ne rouvrent pas souvent l'app, votre release peut être techniquement disponible mais retardée en pratique. Guide des métriques de mise à jour en temps réel de Capgo est tout indiqué ici, car le dashboard doit refléter l'heure d'arrivée réelle, pas seulement l'heure de publication.
Le seuil doit être défini par niveau de sévérité. Les correctifs critiques exigent une cible plus stricte que les changements cosmétiques, et l'équipe doit trancher avant le début du déploiement progressif. Si la release progresse encore mais que le problème est urgent, vous savez déjà que le pipeline de mise à jour est le goulot d'étranglement.
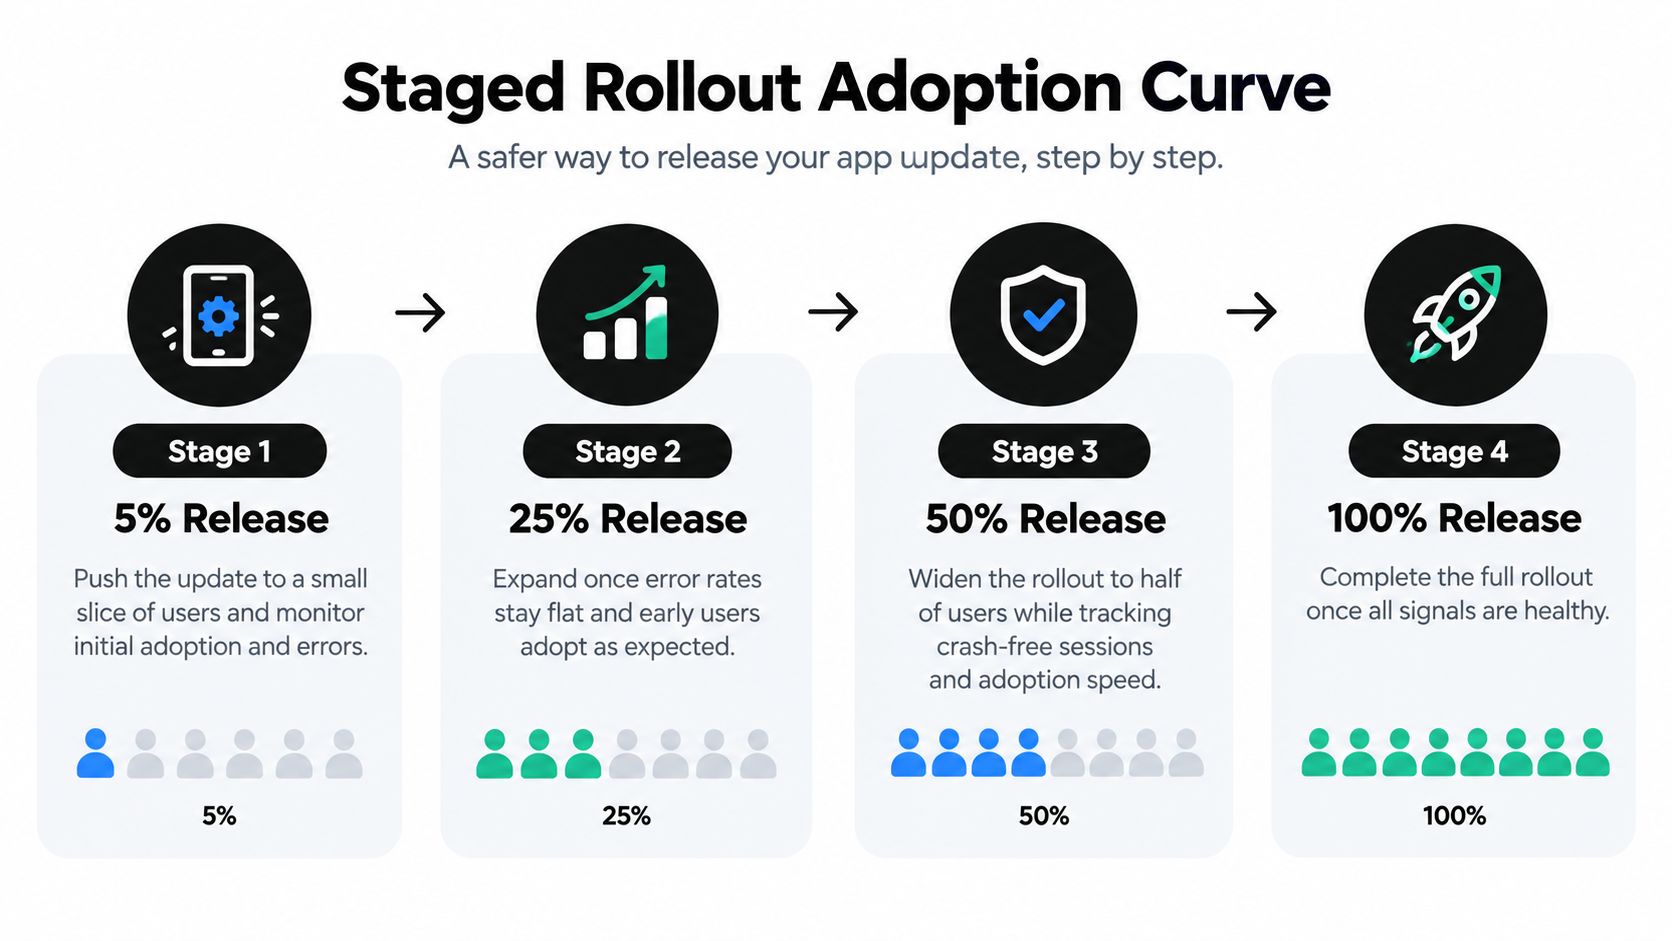
4. Courbe d'adoption du déploiement progressif
Une courbe d'adoption du déploiement progressif montre comment l'exposition s'étend d'une petite cohorte à l'ensemble de la base d'utilisateurs. Elle suit l'adoption à chaque palier de la release, comme 5 %, 25 %, 50 % et 100 %. Cette courbe donne aux responsables de la release des preuves avant d'élargir le périmètre d'exposition. Utilisez le dashboard pour comparer le taux d'adoption, la tendance des erreurs et la tendance des crashs de chaque cohorte, afin qu'une décision go/no-go repose sur la même vue à chaque fois.
Une équipe du secteur de la santé peut d'abord publier auprès d'une audience minuscule, vérifier que les taux d'erreur restent stables, puis étendre. Une équipe entreprise peut diriger un canal dédié à un client vers un seul compte avant de passer le même bundle en production. Chaque étape nécessite un responsable et un point de décision. Si la cohorte suivante se comporte différemment de la précédente, stoppez le déploiement. Élargir vers un problème, c'est de l'exposition, pas du progrès.
Le dashboard doit afficher l’étape actuelle, le niveau d’adoption atteint et la tendance de santé observée à cette étape. Ajoutez un libellé go/no-go clair pour que la revue reste sans ambiguïté. Pour les équipes qui ont besoin d’un playbook de déploiement progressif de live updates, Guide de déploiement progressif de Capgo pour les live updates Capacitor est une référence pratique. Pour visualiser le comportement des cohortes à travers les étapes, consultez guide de courbe de rétention de l’équipe d’attribution. Un déploiement progressif sain est délibéré. Il empêche l’équipe de confondre rapidité et succès, alors que l’objectif est une expansion maîtrisée.
5. Taux de succès d'installation
Le taux de réussite de l’installation des mises à jour mesure la part des tentatives de mise à jour qui parviennent à télécharger, vérifier et appliquer le bundle sur un appareil. Ce n’est pas la même chose que l’adoption. Un bundle peut être disponible pour tout le monde et échouer tout de même à l’étape du téléchargement ou de la vérification.
Une équipe constatant un faible taux de réussite sur un build Android spécifique pourrait en trouver la cause dans les paramètres de compression ou un problème de signature. Une application e-commerce pourrait découvrir que les téléchargements échoués se concentrent dans une région, puis basculer le trafic de livraison vers un edge plus proche. Le dashboard doit offrir une vue étape par étape du cycle de vie afin que les problèmes de livraison ne soient pas confondus avec les problèmes d’exécution.
Découper le pipeline en étapes
Loggez les étapes majeures séparément, comme le début du téléchargement, le téléchargement terminé, la signature vérifiée et le bundle appliqué. Si une étape échoue, le correctif se trouve là. Si toute la chaîne est fragile, le problème peut venir du réseau, du packaging ou de la compatibilité de l'appareil.
Configurez des alertes lorsque le taux de réussite passe sous le seuil de référence auquel vous faites confiance. Les équipes placent souvent la barre haut ici, car un live update devrait être routinier, pas fragile. Le guide de monitoring OTA de Capgo pour les apps Capacitor est utile pour structurer cette observabilité.
Un bon seuil est celui qui déclenche une action avant que les utilisateurs ne remarquent le motif de défaillance. Si des erreurs de vérification apparaissent en CI, la release ne devrait jamais atteindre la production. La décision pratique est simple : séparez les défauts de livraison des défauts applicatifs, sinon chaque revue d'incident brouillera la cause sous-jacente.
6. Taux de rollback
Le taux de rollback mesure la fréquence à laquelle une release est annulée après l'apparition d'un problème. Il peut être suivi par release ou par appareil, et ces deux vues sont importantes. Pour les live updates, le rollback est la soupape de sécurité ; cette métrique vous indique donc la fréquence à laquelle la soupape a dû s'ouvrir.
Une équipe fintech peut voir un rollback automatique se déclencher lorsque les taux de crash augmentent en début de déploiement progressif. Une agence peut utiliser les tendances de rollback sur les apps de ses clients pour décider où la QA doit être plus stricte. Le dashboard doit séparer le rollback automatique depuis rollback manuel car ces causes révèlent des choses différentes sur le processus.
Ce qu’il faut vérifier après chaque rollback
- Source du déclenchement : Était-elle basée sur les crashs, le support ou une action manuelle ?
- Temps de rollback : Le système s’est-il rétabli assez vite pour limiter l’impact sur les utilisateurs ?
- Périmètre d'impact : Combien d’appareils étaient exposés avant la fin du rollback ?
Le seuil n’est pas un chiffre universel fixe. C’est une question de politique interne. Si une release fait souvent l’objet d’un rollback, l’équipe doit chercher des lacunes dans les vérifications avant release, la couverture des appareils ou la logique de déploiement progressif.
Un rollback n’est pas automatiquement un échec. Parfois, c’est le bon résultat, surtout si la release est clairement moins bonne que le build précédent. L’échec, c’est de laisser le rollback devenir un substitut routinier à la discipline de release.
7. Taux d'appareils obsolètes
Le taux d’appareils non à jour indique la part des appareils actifs qui n’ont pas été mis à jour dans une fenêtre définie, comme 30 ou 60 jours. C’est important, car ces appareils passent à côté des correctifs, des patchs de sécurité et des nouvelles fonctionnalités. Dans les environnements réglementés, ce retard peut devenir un problème de conformité.
Une application de santé peut envoyer un prompt in-app lorsque les appareils sont trop en retard. Un client entreprise peut exiger que tous les appareils de terrain soient mis à jour dans une fenêtre donnée, et l’équipe de release suit la conformité chaque semaine. Le dashboard doit séparer les appareils activement utilisés des exceptions connues, comme le matériel hors ligne ou en mode kiosque.
Un graphique des appareils non à jour n’est utile que si l’équipe peut agir dessus. Si la métrique inclut des appareils qui ne peuvent pas être mis à jour par conception, le signal devient vite bruité.
Le seuil doit varier selon le type de release. Les mises à jour de sécurité nécessitent des limites d'ancienneté plus strictes que les ajustements de fonctionnalités. Si la cohorte obsolète augmente après une release, le problème peut venir de frictions de déploiement, de prompts peu efficaces ou d'utilisateurs qui ouvrent trop rarement l'app pour profiter de la fenêtre de mise à jour.
Utilisez des messages in-app avant d'imposer la mise à jour. Cela donne aux utilisateurs une solution pour avancer sans transformer chaque rappel en blocage forcé. La vraie question est de savoir si l'équipe cherche à améliorer la conformité, à réduire le risque de support ou à mettre en avant une fonctionnalité. La métrique doit refléter l'objectif.
8. Ratio d'efficacité des mises à jour différentielles
Le ratio d'efficacité des mises à jour différentielles mesure le nombre d'octets économisés en envoyant uniquement les fichiers modifiés au lieu d'un bundle complet. C'est une métrique de bande passante, mais elle affecte aussi le temps d'installation et le coût des données. Des mises à jour plus petites impliquent généralement moins de friction pour l'utilisateur, surtout sur les connexions facturées.
Une équipe qui modifie principalement le CSS et les textes peut constater des économies importantes et s'en servir pour justifier des releases petites et fréquentes. Une autre équipe produit pourrait séparer les images dans un canal d'assets distinct afin que les deltas code restent légers. Le dashboard doit comparer la taille des deltas par type de release, pas seulement en agrégé.
Pourquoi cette métrique influence le comportement d'adoption
Les mises à jour plus petites ont tendance à paraître plus légères aux utilisateurs. Cela ne garantit pas l'adoption, mais peut éliminer une raison évidente de reporter. Si les utilisateurs sont sur des réseaux lents, un bundle compact a beaucoup plus de chances d'être appliqué avant qu'ils n'abandonnent.
C'est l'un des endroits les plus parlants où les choix d'ingénierie influencent le comportement des releases. Séparez les assets statiques des code qui évoluent vite. Comparez ensuite les corrections de texte, les changements de config et les bundles de fonctionnalités pour savoir quel type de release fait gonfler le delta.
Si le delta reste faible, la release a moins d'obstacles à surmonter. C'est tout l'intérêt.
Cette métrique n'a pas besoin d'un seuil complexe, il lui faut une baseline. L'équipe doit savoir à quoi ressemble un état « normal » pour chaque type de release et creuser quand un changement minime produit un payload surdimensionné. Cela veut généralement dire que la structure du bundle doit être nettoyée.
9. Sessions sans crash sur la cohorte mise à jour
Le taux de sessions sans crash sur la cohorte mise à jour mesure la part des sessions de la nouvelle release qui ne plantent pas. C'est une métrique de qualité, mais aussi d'adoption, car une release qui plante trop ne peut pas être considérée comme une adoption saine. Comparer le groupe mis à jour avec la version précédente aide à isoler l'effet du changement.
Une équipe peut voir les sessions sans crash chuter sur le nouveau bundle et déclencher un rollback. Un développeur indépendant peut comparer le nouveau build à l'ancien pendant les 48 premières heures pour détecter des régressions. Le dashboard doit afficher la nouvelle cohorte et la précédente côte à côte, car le contexte compte plus que le chiffre brut seul.
Ce qu'il faut inclure dans la comparaison
Incluez les crashs natifs, les erreurs JavaScript et les échecs de chargement pour les applications Capacitor. Un taux de crash natif nul peut quand même masquer des cassures front-end si la couche web est instable. Si la cohorte ayant reçu la mise à jour est moins bonne que la référence, la release ne doit pas rester en déploiement simplement parce que l'adoption est élevée.
Cette métrique nécessite aussi une taille d'échantillon minimale avant d'en tirer des conclusions fermes. Les petites cohortes peuvent trop varier pour être fiables. Le seuil doit être défini comme une règle de régression relative, et pas seulement comme un nombre absolu statique.
Utilisez cette métrique avec le taux de rollback, pas à sa place. L'une vous dit comment la release s'est comportée, l'autre ce que le système a fait en réponse. Ensemble, elles vous donnent une bien meilleure idée de si la mise à jour doit rester active.
10. Répartition de l'adoption par canal
La répartition de l'adoption par canal montre comment les appareils actifs se répartissent entre les canaux bêta, staging, production ou propres à un client. Elle vous indique si les bonnes personnes voient la bonne release au bon moment. Elle permet aussi de repérer l'une des erreurs les plus faciles à commettre : du trafic de test qui fuit vers la production ou des utilisateurs de production qui restent sur un canal de test.
Une équipe e-commerce soumise à réglementation peut confirmer qu'aucun appareil de production ne s'est retrouvé par erreur en bêta après une release. Une agence peut suivre les canaux propres à chaque client et retirer ceux que plus personne n'utilise. Le dashboard doit afficher l'appartenance aux canaux assez clairement pour que les erreurs d'aiguillage sautent aux yeux.
Use channels as guardrails, not labels
Les canaux ne sont utiles que s'ils sont appliqués. Si les testeurs, le personnel interne et les pilotes clients finissent tous dans le même canal, le processus de release perd sa barrière de sécurité. Documentez les canaux et vérifiez la répartition avant chaque release majeure.
Configurez des alertes pour les appartenances inattendues, en particulier les appareils bêta qui apparaissent en production, ou l'inverse. Ce simple contrôle peut détecter une exposition accidentelle avant qu'elle ne devienne un problème de support. Une cartographie claire des canaux accélère aussi les post-mortems, car l'équipe peut voir qui a reçu quoi, et quand.
Le seuil pratique est de savoir si la distribution correspond à l'intention. Si ce n'est pas le cas, le processus de release fuit. Dans un système de live update, ce n'est pas un problème cosmétique, c'est un problème de contrôle.
Comparaison de 10 métriques d'adoption
| Indicateur | 🔄 Complexité d'implémentation | ⚡ Ressources nécessaires | 📊 Résultats attendus | 💡 Cas d’usage idéaux | ⭐ Avantage clé |
|---|---|---|---|---|---|
| Taux d'adoption des mises à jour | Faible, vérifications de version et définition des appareils actifs | Faible, agrégation et segmentation périodiques | % d’appareils actifs sur la version cible dans le temps | Décisions go/no-go, suivi des hotfix, vérifications cross-platform | Indicateur de santé de la release en un seul chiffre |
| Répartition des versions (indice de fragmentation) | Modérée, compteurs par version et visualisation en série temporelle | Modéré : stockage historique et segmentation | Visibilité sur la répartition des utilisateurs par version et charge de support | Prioriser la compatibilité/tests et les mises à jour forcées | Révèle quelles anciennes versions nécessitent un support |
| Temps pour atteindre X % d'adoption (vitesse d'adoption) | Modéré : événements horodatés et courbes cumulatives | Modéré : calculs de percentiles et graphiques | Métriques de vitesse (médiane/p90) pour atteindre les seuils d'adoption | Réponse aux incidents, benchmarking de la vitesse de release | Benchmarks how quickly users receive fixes |
| Courbe d'adoption du déploiement progressif | Élevé : orchestration des pourcentages progressifs et des règles de gating | Élevé, monitoring par étape, contrôles de pause/élargissement | Exposition contrôlée et progressive avec signaux de pause/arrêt | Releases risquées, environnements réglementés, déploiements audités | Limite le rayon d'impact et permet un élargissement sûr |
| Taux d'installation réussie des mises à jour | Modéré, instrumentation des étapes de téléchargement/vérification/application | Modéré–élevé, logs par appareil, suivi des étapes d'échec | % d'installations réussies ; répartition des échecs par étape | Dépannage des échecs de livraison ou de vérification | Repère où les mises à jour échouent pour déboguer vite |
| Taux de rollback | Faible–modéré, suivi des rollbacks et classification auto/manuelle des causes | Faible, suivi des événements et rapports post-mortem | % de releases/appareils rollbackés et délai de rollback | Valider les garde-fous, mesurer la qualité des releases | Mesure directe des problèmes de release et de l'efficacité du rollback |
| Taux d'appareils obsolètes | Faible, calcule l'âge de la dernière mise à jour par appareil actif | Faiblesse des métriques, horodatages de dernière activité et segmentation | % d'appareils actifs non mis à jour depuis N jours | Reporting sécurité/conformité, relance ou mises à jour forcées | Identifie les appareils sans correctifs ou fonctionnalités |
| Ratio d'efficacité des mises à jour différentielles | Élevé, calculer les octets delta vs le bundle complet par release | Modéré, diffs de build et télémétrie par release | Ratio d’octets économisés ; économies moyennes par release/appareil | Réseaux à data limitée, petites releases fréquentes, changements d’architecture | Quantifie les économies de bande passante et justifie les petites mises à jour |
| Sessions sans crash sur la cohorte mise à jour | Modéré, segmentation des sessions et attribution des crashs | Modéré, rapport de crash, segmentation, vérifications statistiques | Taux de crash-free des nouveaux vs cohortes de référence ; détection des régressions | Alertes de régression, déploiements progressifs, vérifications de santé des releases | Isole l’impact d’une release sur la stabilité pour les décisions de rollback |
| Répartition de l’adoption par canal | Faible à modéré, suivi des affectations et modifications de canaux | Faible, suivi des métadonnées et des appartenances par canal | Part des appareils par canal ; expositions imprévues | Validation des tests bêta, pilotes entreprise, gouvernance des canaux | Valide les règles de ciblage et évite les expositions accidentelles |
Transformer ces métriques d’adoption en routine de release
Le meilleur dashboard de release n’essaie pas de tout montrer d’un coup. Il commence par la distribution de l’adoption par canal et le taux de succès d’installation des mises à jour pour s’assurer que le bundle cible la bonne audience et atteint les appareils. Ensuite, il suit la courbe d’adoption du déploiement progressif et temps pour atteindre X % d’adoption pour montrer à quelle vitesse la release se propage.
Ensuite, les contrôles qualité prennent le relais. Sessions sans crash sur la cohorte mise à jour indique si le nouveau build se comporte bien, tandis que taux de rollback indique si le filet de sécurité a dû intervenir. Distribution des versions et taux d'appareils non à jour complètent le tableau en montrant la fragmentation du parc et le nombre d'appareils à la traîne.
La revue de release devient bien plus simple quand l'équipe choisit un petit ensemble de métriques et en documente les définitions avant de déployer. Choisissez trois métriques pour la prochaine release, définissez le dénominateur, fixez le seuil, et examinez-les à chaque fois dans la même réunion. Si vous travaillez dans un flux de live update Capacitor, ce rythme est souvent ce qui transforme des données d'adoption brutes en un processus de release auquel on peut se fier.
Pour les équipes qui ont également besoin de solides pratiques de rétention et de gouvernance des données, Sift’s guide on data retention policies for social teams est un rappel utile : la mesure n'est efficace que si les données sous-jacentes restent propres et exploitables. L'habitude de la release importe plus que le dashboard lui-même. Une fois que l'équipe peut expliquer à quoi ressemble un « bon » résultat, chaque mise à jour devient plus facile à déployer, à défendre et à améliorer.
Capgo offre aux équipes Capacitor et Electron un flux de live update pour livrer des correctifs JavaScript, CSS, de contenu, de config et d'assets sans attendre la revue des stores. Si vous voulez que vos données de release correspondent à votre processus de release, visitez Capgo et découvrez comment les bundles signés, les garde-fous de canal, la protection contre le rollback et les métriques d'adoption s'intègrent dans un seul workflow.





