
Ein kritischer Fix geht am Dienstagmorgen live. Die Deployment-Pipeline steht auf Grün, die Release Notes sehen sauber aus, und trotzdem gehen im Support weiter Beschwerden über den Bug ein, den der Fix beseitigen sollte. Genau diese Lücke ist das eigentliche Problem. Ein Release kann ausgeliefert und installiert werden und die Nutzer trotzdem nicht wirklich erreichen.
Deshalb sind Beispiele für Adoption-Metriken für Live Updates in Capacitor und ähnlichen Release-Systemen. Verschiedene Metriken beantworten unterschiedliche Fragen zum selben Bundle. Einige zeigen, ob das Update die Geräte erreicht hat, andere, wie schnell es sich verbreitet hat, wieder andere, ob es die Stabilität verbessert hat, und einige decken auf, ob der Rollout kontrolliert abgelaufen ist.
Die folgende Liste gruppiert die nützlichsten Metriken nach Reichweite, Geschwindigkeit, Qualität und Kontrolle. Jede Metrik wird mit einer Formel, einer Dashboard-Ansicht, einem Live-Update-Beispiel, einem Fehlermodus und einem praktischen Schwellenwert geliefert, den du in einem Release-Meeting verwenden kannst.
Inhaltsverzeichnis
- 1. Update-Adoptionsrate
- 2. Versionsverteilung
- 3. Zeit bis zu X % Adoption
- 4. Staged-Rollout-Adoptionskurve
- 5. Erfolgsrate bei Update-Installationen
- 6. Rollback-Rate
- 7. Rate veralteter Geräte
- 8. Effizienz-Ratio bei Differential Updates
- 9. Crash-freie Sessions in der aktualisierten Kohorte
- 10. Channel-Adoption-Verteilung
- 10 Adoption-Metrics im Vergleich
- Diese Adoption-Metriken in eine Release-Routine verwandeln
1. Update-Adoptionsrate
Update-Adoptionsrate ist die zentrale Kennzahl für ein live update. Sie misst den Anteil der aktiven Geräte, die innerhalb eines definierten Zeitfensters nach dem Release das Ziel-Bundle oder die Zielversion ausführen. In der Praxis bedeutet das Geräte auf der neuen Version geteilt durch alle aktiven Geräte im selben Zeitraum. Bei einem Live-Fix beantwortet das eine direkte Frage: Kam das Update bei den Geräten an, auf die es ankommt?
Ein Fintech-Team kann damit beurteilen, ob ein Login-Patch das alte Bundle ersetzt. Ein E-Commerce-Team kann nach einem Checkout-Fix die 24-Stunden-Adoption über iOS und Android hinweg vergleichen. Das Dashboard sollte die Zielversion, den Pool der berechtigten Geräte und den Anteil der bereits umgestellten Geräte zeigen. Für mehr Kontext zu Adoption-Tooling, DAP-Vorteile und KPIs ansehen um zu sehen, wie Adoptionsmetriken auf Plattformebene abschneiden.
Praktische Regel: definiert „aktives Gerät“ schriftlich, bevor das Release rausgeht. Wenn sich der Nenner von Release zu Release ändert, ist die Metrik nicht mehr vergleichbar.
Der Schwellenwert sollte zur Schwere passen. Ein Security-Fix verdient ein engeres Ziel als ein UI-Tweak, und das Team sollte das vor dem Rollout festhalten. Verfolgt diese Metrik zusammen mit der Anzahl der Geräte, die nach Updates suchen, denn langsames Polling kann ein gesundes Release träge aussehen lassen. Dasselbe Muster zeigt sich in Capgos Leitfaden zum OTA-Erfolgs-Tracking für Capacitor-Apps, wo die Release-Ansicht direkt am tatsächlichen Installationsfortschritt hängt.
Wenn sich die Definition von Adoption jede Woche ändert, ist die Metrik für Release-Entscheidungen nicht mehr brauchbar.
2. Versionsverteilung
Die Versionsverteilung zeigt, wie sich deine aktiven Nutzer zu einem bestimmten Zeitpunkt auf alle Live-Bundles verteilen. Betrachte es als Fragmentierungs-Map. Wenn zu viele Nutzer noch auf alten Versionen verteilt sind, muss dein Support-Team mehr code Pfade stemmen, als nötig wäre.
Eine Healthcare-App könnte feststellen, dass ein Legacy-Bundle noch auf einem relevanten Anteil der Geräte aktiv ist, und entscheiden, dass ein erzwungenes Update die Reibung wert ist. Eine Agentur, die mehrere Client-Builds betreut, kann dieselbe Ansicht nutzen, um zu entscheiden, welche Capacitor Plugin-Versionen sie gefahrlos einstellen kann. Es geht nicht nur ums Alter, sondern darum, wie viele verschiedene Runtime-Realitäten dein Team noch unterstützen muss.
Was das Dashboard zeigen sollte
Das Diagramm sollte getrennt ausweisen: aktuelles Bundle, vorheriges Bundle, und ältere, noch aktive Bundles. Füge neben jeder Version die Crash-Zahlen hinzu, damit das Team erkennt, ob ein alter Release nur häufig ist oder aktiv riskant. Wenn eine Version alt und instabil ist, ist sie ein starker Kandidat für Deprecation.
Nutze Semantic Versioning sowohl für Native- als auch für Web-Bundles, damit der Report lesbar bleibt. Eine Support-Policy wie „nur die letzten drei Bundle-Versionen“ gibt dem Dashboard ein klares Pass/Fail. Ohne eine solche Policy wird die Versionshistorie zum Museum statt zum operativen Tool.
Für eine praktische Umsetzung ist der App-Versionsverlauf-Guide von Capgo die ideale Ergänzung. Die nützliche Entscheidung ist hier einfach: Wenn die Fragmentierung hoch ist und das Risiko durch alte code steigt, sollte das Team aufhören, jede Version als gleichwertig unterstützenswert zu behandeln.
3. Zeit bis zu X % Adoption
Die Zeit bis X % Adoption macht aus Reichweite Geschwindigkeit. Statt zu fragen, ob Nutzer irgendwann aktualisiert haben, wird gemessen, wie lange es dauerte, einen Zielanteil wie 50 %, 80 % oder 95 % zu erreichen. Bei einem Live-Fix zählt Geschwindigkeit, denn das Problem trifft Nutzer weiter, bis das neue Bundle aktiv ist.
Ein Team für Incident Response kann sich das Ziel setzen, einen Schwellenwert innerhalb eines festen Zeitfensters zu erreichen, und monatlich den Median melden. Ein Produktteam kann zwei Checkout-Releases vergleichen und sehen, welches die Nutzer schneller angenommen haben. Die Dashboard-Ansicht sollte eine Kurve sein, keine einzelne Zahl, weil der Tail zeigt, wo die Adoption stockt.
Median und Tail-Verhalten zusammen betrachten
Durchschnittswerte verstecken die Nachzügler. Der Median zeigt die typische Rollout-Geschwindigkeit, ein höheres Perzentil legt die langsameren Kohorten offen, die vielleicht noch auf alten Launches festsitzen oder die App nur selten öffnen. Wer nur den Durchschnitt meldet, übersieht die Gruppe, die noch auf den Fix wartet.
Diese Metrik ist besonders nützlich für Apps, die sich beim nächsten Start aktualisieren. Wenn Nutzer die App nicht oft wieder öffnen, ist das Release technisch verfügbar, aber funktional verzögert. Capgo: Leitfaden für Echtzeit-Update-Metriken passt hier gut, da das Dashboard die tatsächliche Ankunftszeit und nicht nur den Veröffentlichungszeitpunkt abbilden muss.
Der Schwellenwert sollte nach Schweregrad festgelegt werden. Kritische Fixes brauchen ein engeres Ziel als kosmetische Änderungen; das Team sollte das vor dem Rollout festlegen. Wenn das Release noch im Anstieg ist, das Problem aber dringend ist, wissen Sie bereits, dass die Update-Pipeline der Flaschenhals ist.
4. Staged-Rollout-Adoptionskurve
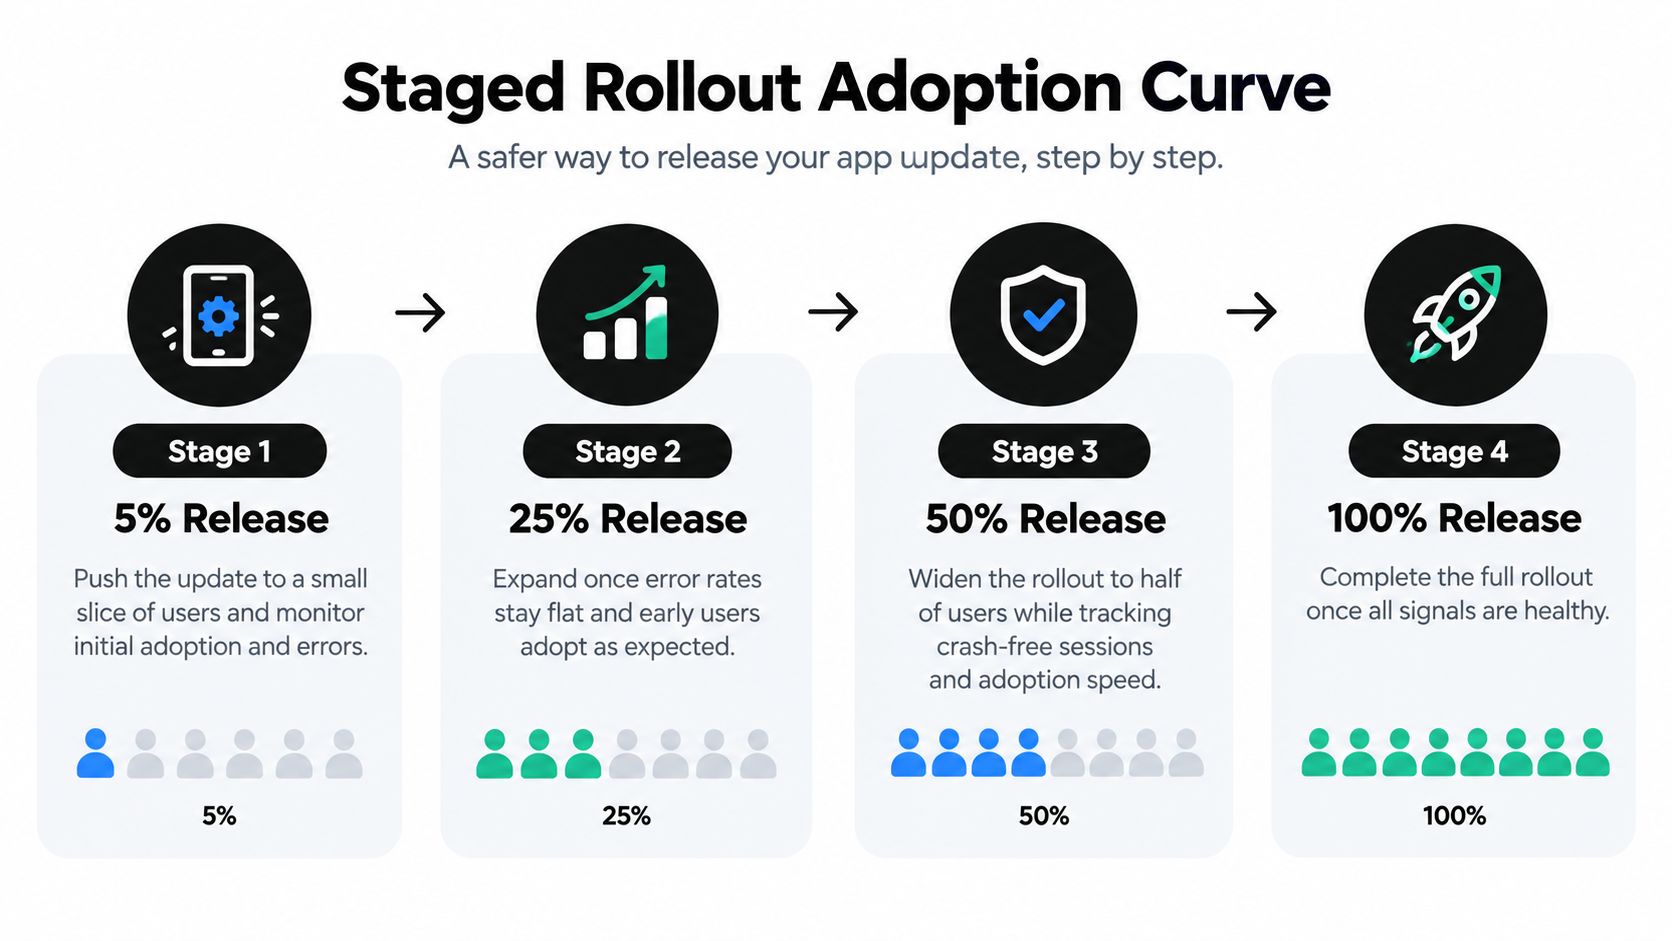
Eine Staged-Rollout-Adoptionskurve zeigt, wie sich die Reichweite von einer kleinen Kohorte auf die gesamte Nutzerbasis ausweitet. Sie trackt die Adoption bei jedem Release-Gate, z. B. 5 %, 25 %, 50 % und 100 %. Diese Kurve liefert Release-Verantwortlichen den Beleg, bevor sie den Blast Radius vergrößern. Nutzen Sie das Dashboard, um die Adoption, den Fehlertrend und den Crash-Trend jeder Kohorte zu vergleichen, damit eine Go/No-Go-Entscheidung immer auf derselben Basis getroffen wird.
Ein Healthcare-Team kann zuerst an eine kleine Zielgruppe releasen, prüfen, ob die Fehlerraten stabil bleiben, und dann erweitern. Ein Enterprise-Team kann einen kundenspezifischen Stream für ein Konto nutzen, bevor dasselbe Bundle in die Produktion geht. Jede Phase braucht einen Verantwortlichen und einen Entscheidungspunkt. Verhält sich die nächste Kohorte anders als die vorherige, stoppen Sie den Rollout. In ein Problem hinein zu erweitern ist Exposure, kein Fortschritt.
Das Dashboard sollte die aktuelle Phase, das erreichte Adoptionslevel und den auf dieser Phase beobachteten Health-Trend anzeigen. Füge ein klares Go/No-Go-Label hinzu, damit das Review eindeutig bleibt. Für Teams, die ein Live-Update-Rollout-Playbook brauchen, Phasen-Rollout-Guide von Capgo für Capacitor Live Updates dient als praktische Referenz. Um das Kohortenverhalten über die Phasen hinweg zu visualisieren, siehe den Retention-Curve-Guide des Attribution-Teams. Ein gesunder stufenweiser Rollout erfolgt bewusst. Er hindert das Team daran, Geschwindigkeit mit Erfolg zu verwechseln, wenn das Ziel eine sichere Expansion ist.
5. Erfolgsrate bei Update-Installationen
Die Erfolgsrate bei Update-Installationen misst den Anteil der Update-Versuche, die auf einem Gerät erfolgreich heruntergeladen, verifiziert und angewendet werden. Das ist nicht dasselbe wie Adoption. Ein Bundle kann für alle verfügbar sein und trotzdem beim Download oder der Verifizierung scheitern.
Ein Team, das bei einem bestimmten Android-Build schlechte Erfolgsraten sieht, könnte dies auf Kompressionseinstellungen oder Signing-Probleme zurückführen. Eine E-Commerce-App könnte feststellen, dass sich fehlgeschlagene Downloads in einer Region häufen, und den Delivery-Traffic zu einem näher gelegenen Edge verschieben. Das Dashboard braucht eine schrittweise Lifecycle-Ansicht, damit Delivery-Probleme nicht mit Runtime-Problemen verwechselt werden.
Pipeline in Phasen unterteilen
Logge die wichtigsten Schritte separat, wie z. B. Download gestartet, Download abgeschlossen, Signatur verifiziert und Bundle angewendet. Wenn eine Stufe ausfällt, liegt dort der Fix. Wenn die gesamte Kette schwach ist, liegt das Problem eventuell beim Netzwerk, beim Packaging oder bei der Gerätekompatibilität.
Richte Alerts ein, wenn die Erfolgsrate unter die Baseline fällt, der du vertraust. Teams setzen hier oft eine hohe Messlatte an, weil ein live update Routine sein sollte und nicht fragil. OTA-Monitoring-Guide von Capgo für Capacitor-Apps hilft dabei, diese Observability zu strukturieren.
Ein guter Schwellenwert löst Maßnahmen aus, bevor Nutzer das Fehlermuster bemerken. Wenn Verifizierungsfehler in der CI auftreten, sollte das Release nie die Produktion erreichen. Die Entscheidung in der Praxis ist einfach: Trenne Delivery-Fehler von App-Fehlern, sonst verschwimmt bei jeder Incident-Analyse die eigentliche Ursache.
6. Rollback-Rate
Die Rollback-Rate misst, wie oft ein Release nach einem Problem rückgängig gemacht wird. Man kann dies pro Release oder pro Gerät tracken; beide Ansichten sind wichtig. Bei Live Updates ist das Rollback das Sicherheitsventil – diese Metrik zeigt dir also, wie oft das Ventil geöffnet werden musste.
Ein Fintech-Team sieht eventuell einen automatischen Rollback-Trigger, wenn die Crash-Raten früh in einem Rollout steigen. Eine Agentur kann Rollback-Trends über verschiedene Client-Apps hinweg nutzen, um zu entscheiden, wo die QA strenger werden muss. Das Dashboard sollte unterscheiden zwischen automatischem Rollback von manuellem Rollback denn diese Ursachen sagen Unterschiedliches über den Prozess aus.
Was nach jedem Rollback zu prüfen ist
- Trigger-Quelle: Wurde es durch Crashes, Support-Anfragen oder manuell ausgelöst?
- Zeit bis zum Rollback: Did the system recover fast enough to reduce user impact?
- Blast Radius: Wie viele Geräte waren betroffen, bevor das Rollback abgeschlossen war?
Der Schwellenwert ist hier keine feste universelle Zahl, sondern eine Policy-Frage. Wenn ein Release häufig zurückgerollt wird, sollte das Team nach Lücken bei Pre-Release-Checks, Geräteabdeckung oder der Staged-Rollout-Logik suchen.
Ein Rollback ist nicht automatisch ein Fehler. Manchmal ist es das richtige Ergebnis, besonders wenn das Release deutlich schlechter ist als der vorherige Build. Das eigentliche Problem ist, wenn Rollback zur Routine wird und Release-Disziplin ersetzt.
7. Rate veralteter Geräte
Die Stale Device Rate zeigt den Anteil aktiver Geräte, die sich innerhalb eines definierten Zeitraums (z. B. 30 oder 60 Tage) nicht aktualisiert haben. Das ist wichtig, weil veraltete Geräte Fixes, Security-Patches und neue Features verpassen. In regulierten Umgebungen kann dieser Rückstand zu Compliance-Problemen führen.
Eine Healthcare-App könnte einen In-App-Prompt senden, wenn Geräte zu weit zurückliegen. Ein Enterprise-Kunde verlangt eventuell, dass alle Field-Devices innerhalb eines Zeitfensters aktualisiert werden, wobei das Release-Team die Compliance wöchentlich trackt. Das Dashboard sollte aktiv genutzte Geräte von bekannten Ausnahmen wie Offline-Geräten oder Kiosk-Hardware trennen.
Ein Chart zu veralteten Geräten ist nur nützlich, wenn das Team darauf reagieren kann. Enthält die Metrik Geräte, die sich per Design nicht aktualisieren lassen, wird das Signal schnell verrauscht.
Der Schwellenwert sollte je nach Release-Typ variieren. Sicherheitsrelevante Updates brauchen strengere Staleness-Limits als Feature-Tweaks. Wächst die Gruppe veralteter Geräte nach einem Release, kann das an Rollout-Reibung liegen, an schwachen Prompts oder an Nutzern, die die App zu selten öffnen, um das Update-Fenster zu erwischen.
Nutze In-App-Notices, bevor du das Update erzwingst. Das gibt Nutzern einen Weg nach vorn, ohne dass jede Erinnerung zum harten Stopp wird. Praktisch geht es um die Entscheidung, ob das Team Compliance verbessern, Support-Risiken senken oder ein Feature pushen will. Die Metrik sollte dieses Ziel widerspiegeln.
8. Effizienz-Ratio bei Differential Updates
Das Differential Update Efficiency Ratio misst, wie viele Bytes du gespart hast, indem du nur geänderte Dateien statt eines kompletten Bundles sendest. Es ist eine Bandbreiten-Metrik, beeinflusst aber auch Installationszeit und Datenkosten. Kleinere Updates bedeuten meist weniger Reibung für den Nutzer, besonders bei getakteten Verbindungen.
Ein Team, das vor allem CSS und Copy ändert, sieht hohe Einsparungen und kann damit häufige kleine Releases rechtfertigen. Ein anderes Produktteam lagert Bilder vielleicht in einen separaten Asset-Channel aus, damit die code-Deltas schlank bleiben. Das Dashboard sollte die Delta-Größe nach Release-Typ vergleichen, nicht nur aggregiert.
Warum diese Metrik das Adoptionsverhalten verändert
Kleinere Updates fühlen sich für Nutzer oft leichter an. Das garantiert zwar keine Adoption, kann aber einen offensichtlichen Grund für Verzögerungen beseitigen. Wenn Nutzer auf langsameren Netzwerken unterwegs sind, wird ein kompaktes Bundle mit viel höherer Wahrscheinlichkeit angewendet, bevor sie aufgeben.
Hier zeigen sich die Auswirkungen technischer Entscheidungen auf das Release-Verhalten am deutlichsten. Trenne statische Assets von schnelllebigen code. Vergleiche dann Textkorrekturen, Config-Änderungen und Feature-Bundles, um zu sehen, welcher Release-Typ das Delta aufbläht.
Bleibt das Delta klein, hat das Release weniger Gegenwind. Genau darum geht es.
Diese Metrik braucht keinen komplexen Schwellenwert, sondern eine Baseline. Das Team sollte wissen, wie „normal“ für jeden Release-Typ aussieht, und nachhaken, wenn eine winzige Änderung ein überdimensioniertes Payload erzeugt. Meist heißt das: Die Bundle-Struktur muss aufgeräumt werden.
9. Crash-freie Sessions in der aktualisierten Kohorte
Die Crash-free Sessions in der aktualisierten Kohorte messen den Anteil der Sessions im neuen Release, die nicht abstürzen. Das ist eine Qualitäts-, aber auch eine Adoption-Metrik, denn ein Release, das zu oft abstürzt, kann nicht als gesunde Adoption gelten. Der Vergleich der aktualisierten Gruppe mit der Vorversion hilft, den Effekt der Änderung zu isolieren.
Ein Team bemerkt eventuell sinkende crashfreie Sessions beim neuen Bundle und löst einen Rollback aus. Ein Indie-Entwickler kann den aktualisierten Build in den ersten 48 Stunden mit dem alten vergleichen, um Regressionen zu finden. Das Dashboard sollte die neue und die vorherige Kohorte nebeneinander zeigen, da der Kontext wichtiger ist als die reine Zahl.
Was in den Vergleich gehört
Berücksichtige native Crashes, JavaScript-Fehler und fehlgeschlagene Ladevorgänge für Capacitor Apps. Eine saubere native Crash-Rate kann Frontend-Probleme verbergen, wenn der Web-Layer instabil ist. Wenn die aktualisierte Kohorte schlechter als der Baseline-Wert ist, sollte das Release nicht aktiv bleiben, nur weil die Adoption hoch ist.
Diese Metrik benötigt zudem eine Mindeststichprobengröße, bevor man definitive Schlüsse zieht. Kleine Kohorten können zu stark schwanken, um verlässlich zu sein. Der Schwellenwert sollte als relative Regressionsregel definiert werden, nicht nur als statische absolute Zahl.
Nutze diese Metrik zusammen mit der Rollback-Rate, nicht an ihrer Stelle. Die eine zeigt, wie sich das Release verhalten hat, die andere, wie das System darauf reagiert hat. Zusammen geben sie ein viel besseres Bild davon, ob das Update live bleiben sollte.
10. Channel-Adoption-Verteilung
Die Channel-Adoption-Verteilung zeigt, wie aktive Geräte über Beta-, Staging-, Production- oder kundenspezifische Streams verteilt sind. Sie zeigt dir, ob die richtigen Leute das richtige Release zur richtigen Zeit sehen. Und sie deckt einen der einfachsten Fehler auf: Test-Traffic, der in Production leakt, oder Production-User, die in einem Test-Channel hängen.
Ein E-Commerce-Team in einem regulierten Umfeld kann bestätigen, dass nach einem Release keine Production-Geräte versehentlich auf Beta gelandet sind. Eine Agentur kann kundenspezifische Channels tracken und ungenutzte stilllegen. Das Dashboard sollte die Channel-Zugehörigkeit so klar anzeigen, dass Fehlroutings auf einen Blick auffallen.
Nutze Channels als Guardrails, nicht als Labels
Channels helfen nur, wenn sie durchgesetzt werden. Wenn Tester, interne Mitarbeiter und Pilotkunden alle im selben Stream landen, verliert der Release-Prozess seine Sicherheitsgrenze. Halte die Channels dokumentiert und prüfe die Verteilung vor jedem Major-Release.
Richte Alerts für unerwartete Zugehörigkeiten ein, besonders wenn Beta-Geräte in Production auftauchen oder umgekehrt. Dieser eine Check kann versehentliche Exposition abfangen, bevor daraus ein Support-Problem wird. Eine saubere Channel-Map macht auch Post-Mortems schneller, weil das Team sieht, wer wann was bekommen hat.
Die praktische Schwelle ist, ob die Verteilung der Absicht entspricht. Wenn nicht, leckt der Release-Prozess. In einem Live-Update-System ist das kein kosmetisches Problem, sondern ein Kontrollproblem.
10 Adoption-Metrics im Vergleich
| Metrik | 🔄 Implementierungskomplexität | ⚡ Ressourcenbedarf | 📊 Erwartete Ergebnisse | 💡 Ideale Anwendungsfälle | ⭐ Hauptvorteil |
|---|---|---|---|---|---|
| Update-Adoptionsrate | Niedrig, Versionschecks und Definition aktiver Geräte | Niedrig, periodische Aggregation und Segmentierung | % aktiver Geräte auf Zielversion im Zeitverlauf | Go/No-Go-Entscheidungen, Hotfix-Monitoring, Cross-Platform-Checks | Klarer Release-Health-Indikator als einzelne Kennzahl |
| Versionsverteilung (Fragmentierungsindex) | Mittel, Zählungen pro Version und Zeitreihenvisualisierung | Mittlere, historische Speicherung und Segmentierung | Einblick in die Verteilung der Nutzer über Versionen und den Support-Aufwand | Priorisierung von Kompatibilität/Tests und erzwungenen Updates | Zeigt, welche alten Versionen Support benötigen |
| Zeit bis X % Adoption (Adoption Velocity) | Mittlere, zeitgestempelte Ereignisse und kumulative Kurven | Mittel, Prozentilberechnungen und Diagramme | Geschwindigkeitsmetriken (Median/p90) für Adoptions-Schwellenwerte | Incident Response, Benchmarking der Release-Geschwindigkeit | Benchmark, wie schnell Nutzer Fixes erhalten |
| Adoptionskurve für gestaffelte Rollouts | Hoch, Orchestrierung gestaffelter Prozentsätze und Gating-Regeln | Hoch, Monitoring pro Stufe, Pause/Expand-Steuerung | Kontrollierte, gestaffelte Exposition mit Pause/Stop-Signalen | Risikoreiche Releases, regulierte Umgebungen, auditierte Rollouts | Begrenzt den Blast Radius und ermöglicht sichere Ausweitung |
| Erfolgsrate der Update-Installation | Mittel, Instrumentierung der Download/Verify/Apply-Stufen | Mittel–Hoch, Logs pro Gerät, Tracking der Fehlerstufe | Anteil erfolgreicher Installationen; Aufschlüsselung nach Fehlerstufe | Fehlerbehebung bei Auslieferungs- oder Verifikationsfehlern | Zeigt genau, wo Updates fehlschlagen, für schnelleres Debugging |
| Rollback-Rate | Niedrig–Mittel, Rollbacks verfolgen und automatische/manuelle Ursachen klassifizieren | Niedrig, Event-Tracking und Post-Mortem-Protokolle | % der zurückgerollten Releases/Devices und Time-to-Rollback | Sicherheitsnetze validieren, Release-Qualität messen | Direktes Maß für Release-Probleme und Rollback-Effektivität |
| Rate veralteter Devices | Niedrig, Alter des letzten Updates pro aktivem Device berechnen | Niedrig, Last-Seen/Update-Timestamps und Segmentierung | % der aktiven Devices ohne Update seit N Tagen | Security/Compliance-Reporting, Outreach oder Forced Updates | Identifiziert Devices ohne Patches oder Features |
| Effizienzrate von Differential Updates | Hoch, Delta-Bytes vs. Full Bundle pro Release berechnen | Mittel, Build-Diffs und Telemetrie pro Release | Verhältnis der gesparten Bytes; durchschnittliche Einsparung pro Release/Device | Metered Networks, häufige kleine Releases, Architekturänderungen | Quantifiziert Bandbreiteneinsparungen und rechtfertigt kleine Updates |
| Crash-Free Sessions im aktualisierten Kohorte | Mittel, Kohortenbildung von Sessions und Crash-Attribution | Mittel, Crash-Reporting, Segmentierung, statistische Prüfungen | Crash-freier Anteil neuer vs. Baseline-Kohorten; Regressions-Erkennung | Regressions-Alerts, gestaffelte Rollouts, Release-Health-Checks | Isoliert den Release-Einfluss auf die Stabilität für Rollback-Entscheidungen |
| Channel-Adoption-Verteilung | Niedrig–Mittel, Channel-Zuweisungen und Änderungen tracken | Niedrig, Channel-Metadaten und Membership-Monitoring | Geräteanteil pro Channel; unerwartete Expositionen | Validierung von Beta-Tests, Enterprise-Piloten, Channel-Governance | Validiert Targeting-Regeln und verhindert versehentliche Exposition |
Diese Adoption-Metriken in eine Release-Routine verwandeln
Das beste Release-Dashboard versucht nicht, alles auf einmal zu zeigen. Es beginnt mit der Channel-Adoptionsverteilung und der Update-Installationserfolgsrate damit du weißt, dass das Bundle die richtige Zielgruppe anspricht und auf Geräten ankommt. Dann trackt es die Staged-Rollout-Adoptionskurve und Zeit bis zu X % Adoption um die Verbreitungsgeschwindigkeit des Releases zu zeigen.
Danach übernehmen die Qualitätsprüfungen. Crash-freie Sessions der aktualisierten Kohorte zeigen dir, ob der neue Build stabil läuft, während Rollback-Rate zeigt, ob das Sicherheitsnetz eingreifen musste. Versionsverteilung und Stale-Device-Rate runden das Bild ab, indem sie zeigen, wie fragmentiert die Flotte ist und wie viele Geräte im Rückstand sind.
Eine Release-Review wird deutlich einfacher, wenn das Team vor dem Shipment einen kleinen Satz an Metriken auswählt und die Definitionen festhält. Wähle drei Metriken für das nächste Release, definiere den Nenner, setze den Schwellenwert und bespreche sie jedes Mal im selben Meeting. Wenn du in einem Capacitor Live-Update-Flow arbeitest, ist genau dieser Rhythmus oft der Schlüssel, um rohe Adoptionsdaten in einen Release-Prozess zu verwandeln, dem man vertrauen kann.
Für Teams, die auch starke Retention- und Data-Governance-Praktiken benötigen, Sifts Guide zu Data-Retention-Policies für Social-Teams ist eine nützliche Erinnerung daran, dass Messungen nur funktionieren, wenn die zugrunde liegenden Daten sauber und nutzbar bleiben. Die Release-Gewohnheit ist wichtiger als das Dashboard selbst. Sobald das Team erklären kann, wie „gut“ aussieht, wird jedes Update leichter zu shippen, zu verteidigen und zu verbessern.
Capgo bietet Capacitor- und Electron-Teams einen Live-Update-Pfad, um JavaScript-, CSS-, Copy-, Config- und Asset-Fixes zu shippen, ohne auf die Store-Review warten zu müssen. Wenn du möchtest, dass die Release-Daten zum Release-Prozess passen, besuche Capgo und sieh dir an, wie signierte Bundles, Channel-Guardrails, Rollback-Schutz und Adoptionsmetriken in einen Workflow integriert werden.





