
Una corrección crítica se publica el martes por la mañana. El pipeline de despliegue pasa a verde, las notas de versión parecen limpias, y el soporte sigue recibiendo quejas sobre el bug que la corrección debía eliminar. Esa brecha es el problema central. Una release puede publicarse, instalarse y aun así no llegar a los usuarios de forma significativa.
Por eso ejemplos de métricas de adopción importan para Live Update en Capacitor y sistemas de release similares. Métricas distintas responden a preguntas diferentes sobre el mismo bundle. Algunas indican si la actualización llegó a los dispositivos, otras muestran qué tan rápido se propagó, algunas revelan si mejoró la estabilidad y otras exponen si el rollout estuvo controlado.
La lista siguiente agrupa las métricas más útiles por alcance, velocidad, calidad y control. Cada una incluye una fórmula, una vista en el dashboard, un ejemplo de Live Update, un modo de fallo y un umbral práctico que puedes usar en una reunión de release.
Tabla de contenidos
- 1. Tasa de adopción de actualizaciones
- 2. Distribución de versiones
- 3. Tiempo hasta el X% de adopción
- 4. Curva de adopción del staged rollout
- 5. Tasa de éxito de instalación de actualizaciones
- 6. Tasa de rollback
- 7. Tasa de dispositivos desactualizados
- 8. Ratio de eficiencia de actualización diferencial
- 9. Sesiones sin fallos en la cohorte actualizada
- 10. Distribución de adopción por canal
- Comparativa de 10 métricas de adopción
- Cómo convertir estas métricas de adopción en una rutina de release
1. Tasa de adopción de actualizaciones
Tasa de adopción de actualizaciones es la métrica clave para live update. Mide el porcentaje de dispositivos activos que ejecutan el bundle o la versión objetivo dentro de un periodo definido tras el lanzamiento. En la práctica, esto significa dispositivos en la nueva versión divididos por el total de dispositivos activos en el mismo período. Para una corrección en vivo, responde a una pregunta directa: ¿la actualización llegó a los dispositivos que importan?
Un equipo de fintech puede usar esto para determinar si un parche de inicio de sesión está reemplazando el bundle anterior. Un equipo de comercio electrónico puede comparar la adopción de 24 horas entre iOS y Android después de una corrección en el checkout. El dashboard debe mostrar la versión objetivo, el grupo de dispositivos elegibles y la proporción que ya ha cambiado. Para un contexto más amplio sobre herramientas de adopción, explora los beneficios y KPIs de DAP para ver cómo se comparan las métricas de adopción a nivel de plataforma.
Regla práctica: define “dispositivo activo” por escrito antes de que el release se publique. Si el denominador cambia de un release a otro, la métrica deja de ser comparable.
El umbral debe coincidir con la gravedad. Un parche de seguridad merece un objetivo más estricto que un ajuste de UI, y el equipo debe documentarlo antes de iniciar el despliegue. Sigue esta métrica junto con el número de dispositivos que buscan actualizaciones, porque un polling lento puede hacer que una versión sana parezca lenta. Observa el mismo patrón en la guía de seguimiento de éxito OTA de Capgo para apps de Capacitor, donde la vista de la versión está vinculada al progreso real de instalación.
Si la definición de adopción cambia cada semana, la métrica deja de ser útil para tomar decisiones de lanzamiento.
2. Distribución de versiones
La distribución de versiones muestra cómo se reparten tus usuarios activos entre todos los bundles activos en un momento dado. Piénsalo como un mapa de fragmentación. Si demasiada gente sigue dispersa en versiones antiguas, tu equipo de soporte está cargando con más rutas de code de las que debería.
Una app de salud podría descubrir que un bundle heredado sigue activo en una parte significativa de los dispositivos y decidir que una actualización forzada merece la fricción. Una agencia que gestiona varios builds de clientes puede usar esta misma vista para decidir qué versiones de plugins de Capacitor es seguro retirar. El punto no es solo la antigüedad, sino cuántas realidades de runtime distintas tu equipo todavía tiene que soportar.
Qué debería mostrar el dashboard
El gráfico debería desglosar bundle actual, bundle anterior, y bundles antiguos aún en circulación. Añade el número de crashes junto a cada versión para que el equipo sepa si una versión vieja es solo común o realmente riesgosa. Si una versión es antigua e inestable, es una fuerte candidata a deprecarse.
Usa versionado semántico tanto para bundles nativos como web para que el informe sea legible. Una política de soporte como “solo las últimas tres versiones de bundle” le da al dashboard un claro pasa o no pasa. Sin una política, el historial de versiones se convierte en un museo en lugar de una herramienta operativa.
Para una visión práctica de la implementación, Guía de historial de versiones de apps de Capgo es la pieza complementaria ideal. La decisión útil aquí es simple. Si la fragmentación es alta y el riesgo de las versiones antiguas de code está aumentando, el equipo debe dejar de tratar cada versión como igualmente digna de soporte.
3. Tiempo hasta el X% de adopción
El tiempo hasta alcanzar el X% de adopción convierte el alcance en velocidad. En lugar de preguntar si los usuarios acabaron actualizando, pregunta cuánto se tardó en alcanzar un porcentaje objetivo, como el 50%, 80% o 95%. Para una corrección en vivo, la velocidad importa porque el problema sigue afectando a los usuarios hasta que el nuevo bundle esté activo.
Un equipo que se encarga de la respuesta a incidentes puede fijar como objetivo alcanzar un umbral elegido dentro de una ventana de tiempo fija y reportar la mediana cada mes. Un equipo de producto puede comparar dos versiones del checkout y ver cuál adoptaron los usuarios más rápido. La vista del dashboard debe ser una curva, no un solo número, porque la cola indica dónde se estanca la adopción.
Combina la mediana y el comportamiento de la cola
Los promedios ocultan a los rezagados. La mediana muestra la velocidad típica del despliegue, mientras que un percentil más alto deja al descubierto a las cohortes más lentas, que pueden estar atascadas en versiones antiguas o abrir la app con poca frecuencia. Si solo reportas el promedio, puedes pasar por alto al grupo que aún espera la corrección.
Esta métrica es especialmente útil para apps que se actualizan en el siguiente arranque. Si los usuarios no reabren la app a menudo, tu release puede estar disponible técnicamente pero retrasado funcionalmente. Guía de métricas de actualización en tiempo real de Capgo es ideal aquí, ya que el dashboard debe reflejar el momento real de llegada, no solo el de publicación.
El umbral debe definirse por nivel de severidad. Los fixes críticos necesitan un objetivo más ajustado que los cambios cosméticos, y el equipo debe decidirlo antes de empezar el rollout. Si el release sigue subiendo pero el problema es urgente, ya sabes que el pipeline de actualizaciones es el cuello de botella.
4. Curva de adopción del staged rollout
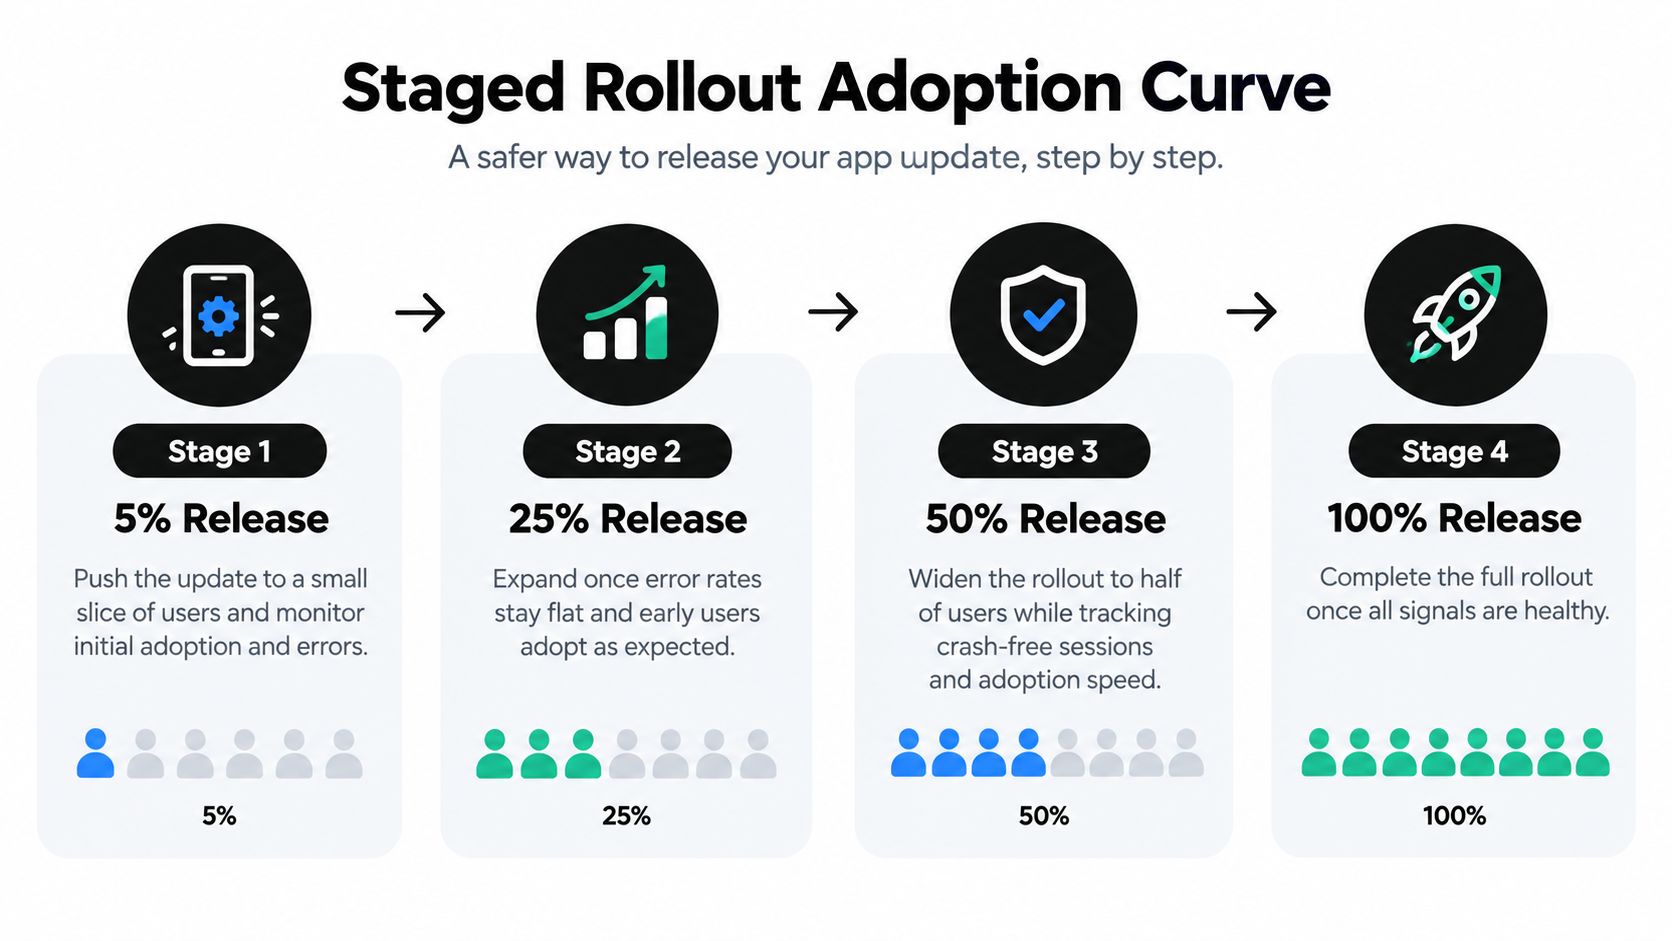
Una curva de adopción de staged rollout muestra cómo la exposición se expande desde un grupo pequeño hasta toda la base de usuarios. Rastrea la adopción en cada gate del release, como 5%, 25%, 50% y 100%. Esa curva da evidencia a los responsables del release antes de ampliar el blast radius. Usa el dashboard para comparar la adopción, la tendencia de errores y la de crashes de cada cohorte, para que cada decisión de go/no-go se base en la misma vista.
Un equipo de salud puede lanzar primero a una audiencia pequeña, comprobar que las tasas de error se mantienen estables y luego ampliar. Un equipo enterprise puede dirigir un stream específico de un cliente a una cuenta antes de pasar el mismo bundle a producción. Cada etapa necesita un responsable y un punto de decisión. Si la siguiente cohorte se comporta distinto de la anterior, detén el rollout. Ampliar el alcance hacia un problema es exposición, no progreso.
El dashboard debe mostrar la etapa actual, el nivel de adopción alcanzado y la tendencia de salud observada en esa etapa. Añade una etiqueta clara de go/no-go para que la revisión sea inequívoca. Para los equipos que necesiten un playbook de despliegue de live updates, Guía de despliegue gradual de Capgo para actualizaciones en vivo de Capacitor es una referencia práctica. Para visualizar el comportamiento de las cohortes entre etapas, consulta la guía de curvas de retención del equipo de atribución. Un despliegue por fases saludable es deliberado. Evita que el equipo trate la velocidad como éxito cuando el objetivo es una expansión segura.
5. Tasa de éxito de instalación de actualizaciones
La tasa de éxito de instalación de actualizaciones mide el porcentaje de intentos de actualización que se descargan, verifican y aplican correctamente en un dispositivo. Esto no es lo mismo que la adopción. Un bundle puede estar disponible para todos y aun así fallar en el paso de descarga o verificación.
Un equipo que vea una tasa de éxito baja en una build concreta de Android podría atribuirlo a la configuración de compresión o a problemas de firma. Una app de comercio electrónico podría descubrir que las descargas fallidas se concentran en una región y pasar a dirigir el tráfico de entrega a un edge más cercano. El dashboard necesita una vista del ciclo de vida paso a paso para que los problemas de entrega no se confundan con problemas de runtime.
Divide el pipeline en etapas
Registra las etapas principales por separado, como inicio de descarga, descarga completada, firma verificada y bundle aplicado. Si una etapa cae, la solución está ahí. Si toda la cadena es débil, el problema puede ser de red, empaquetado o compatibilidad del dispositivo.
Configura alertas para cuando la tasa de éxito baje por debajo de la línea base en la que confías. Los equipos suelen poner el listón alto aquí, porque una live update debería ser rutinaria, no frágil. Guía de monitoreo OTA de Capgo para apps de Capacitor es útil para estructurar esa observabilidad.
Un buen umbral es aquel que activa una acción antes de que los usuarios noten el patrón de fallo. Si aparecen errores de verificación en CI, la release nunca debería llegar a producción. La decisión práctica es simple: separa los fallos de entrega de los fallos de la aplicación, o cada revisión de incidentes difuminará la causa subyacente.
6. Tasa de rollback
La tasa de rollback mide con qué frecuencia se revierte una release tras aparecer un problema. Se puede rastrear por release o por dispositivo, y ambas vistas importan. Para Live Update, el rollback es la válvula de seguridad, así que esta métrica te dice con qué frecuencia tuvo que abrirse la válvula.
Un equipo de fintech puede ver un rollback automático activarse cuando las tasas de crash aumentan al inicio de un rollout. Una agencia puede usar las tendencias de rollback entre apps de clientes para decidir dónde necesita ser más estricto el QA. El dashboard debe separar rollback automático de los rollback manual porque esas causas dicen cosas diferentes sobre el proceso.
Qué revisar tras cada rollback
- Fuente del trigger: ¿Fue basado en crashes, en soporte o iniciado manualmente?
- Tiempo hasta el rollback: Did the system recover fast enough to reduce user impact?
- Radio de impacto: ¿Cuántos dispositivos estuvieron expuestos antes de que terminara el rollback?
El umbral aquí no es un número universal fijo. Es una cuestión de política. Si un release se revierte con frecuencia, el equipo debe buscar brechas en las comprobaciones previas al lanzamiento, la cobertura de dispositivos o la lógica de despliegue gradual.
Un rollback no es automáticamente un fracaso. A veces es el resultado correcto, especialmente cuando el release es claramente peor que el build anterior. El fracaso es permitir que el rollback se convierta en un sustituto rutinario de la disciplina de lanzamiento.
7. Tasa de dispositivos desactualizados
La tasa de dispositivos obsoletos muestra el porcentaje de dispositivos activos que no se han actualizado dentro de una ventana definida, como 30 o 60 días. Importa porque los dispositivos obsoletos se pierden correcciones, parches de seguridad y nuevas funciones. En entornos regulados, ese retraso puede convertirse en un problema de cumplimiento.
Una app de salud podría enviar un prompt en la app cuando los dispositivos se queden demasiado atrás. Un cliente empresarial puede requerir que todos los dispositivos de campo se actualicen dentro de una ventana establecida, y el equipo de release rastrea el cumplimiento semanalmente. El dashboard debe separar los dispositivos en uso activo de las excepciones conocidas, como hardware offline o quiosco.
Un gráfico de dispositivos desactualizados solo es útil si el equipo puede actuar sobre él. Si la métrica incluye dispositivos que no pueden actualizarse por diseño, la señal se vuelve ruidosa enseguida.
El umbral debe variar según el tipo de release. Las actualizaciones de seguridad necesitan límites de obsolescencia más estrictos que los ajustes de features. Si el grupo de dispositivos desactualizados crece tras un release, el problema puede ser fricción en el rollout, prompts poco efectivos o usuarios que abren la app con tan poca frecuencia que no llegan a la ventana de actualización.
Usa avisos in-app antes de forzar la actualización. Eso da al usuario una vía para continuar sin convertir cada recordatorio en un bloqueo total. La decisión práctica es si el equipo busca mejorar el cumplimiento, reducir el riesgo de soporte o impulsar una feature. La métrica debe reflejar ese objetivo.
8. Ratio de eficiencia de actualización diferencial
El ratio de eficiencia de actualización diferencial mide cuántos bytes ahorraste al enviar solo los archivos cambiados en lugar de un bundle completo. Es una métrica de ancho de banda, pero también afecta al tiempo de instalación y al coste de datos. Las actualizaciones más pequeñas suelen implicar menos fricción para el usuario, especialmente en conexiones con tarifa de datos.
Un equipo que cambia sobre todo CSS y textos puede ver ahorros considerables y usarlos para justificar releases pequeños y frecuentes. Otro equipo de producto podría separar las imágenes en un canal de assets distinto para que los deltas de code se mantengan ligeros. El dashboard debe comparar el tamaño del delta por tipo de release, no solo en conjunto.
Por qué esta métrica cambia el comportamiento de adopción
Las actualizaciones más pequeñas suelen sentirse más ligeras para los usuarios. Eso no garantiza la adopción, pero puede eliminar una razón obvia de retraso. Si los usuarios están en redes más lentas, es mucho más probable que un bundle compacto se aplique antes de que se rindan.
Este es uno de los lugares más claros donde las decisiones de ingeniería afectan el comportamiento de los lanzamientos. Mantén los assets estáticos separados de los code de cambio rápido. Luego, compara correcciones de texto, cambios de configuración y bundles de funciones para identificar qué tipo de lanzamiento está inflando el delta.
Si el delta se mantiene pequeño, el lanzamiento tiene menos obstáculos. Ese es el objetivo principal.
Esta métrica no necesita un umbral complejo, necesita una línea base. El equipo debe saber cómo se ve lo «normal» para cada tipo de lanzamiento e investigar cuando un cambio mínimo genera un payload desproporcionado. Eso suele significar que la estructura del bundle necesita limpieza.
9. Sesiones sin fallos en la cohorte actualizada
Las sesiones sin crash en la cohorte actualizada miden el porcentaje de sesiones en el nuevo lanzamiento que no sufren crash. Es una métrica de calidad, pero también de adopción, ya que un lanzamiento con demasiados crashes no puede considerarse una adopción saludable. Comparar el grupo actualizado con la versión anterior ayuda a aislar el efecto del cambio.
Un equipo podría notar una caída en las sesiones sin crashes con el nuevo bundle y hacer rollback. Un desarrollador indie puede comparar el build actualizado con el anterior durante las primeras 48 horas y buscar regresiones. El dashboard debería mostrar la cohorte nueva y la anterior lado a lado, porque el contexto importa más que el número por sí solo.
Qué incluir en la comparación
Incluye crashes nativos, errores de JavaScript y cargas fallidas en las apps de Capacitor. Una tasa limpia de crashes nativos aún puede ocultar fallos en el front-end si la capa web es inestable. Si la cohorte actualizada es peor que la línea base, el release no debería seguir activo solo porque la adopción sea alta.
Esta métrica también necesita un tamaño de muestra mínimo antes de sacar conclusiones firmes. Las cohortes pequeñas pueden fluctuar demasiado como para confiar en ellas. El umbral debería definirse como una regla de regresión relativa, no solo como un número absoluto estático.
Usa esta métrica junto con la tasa de rollback, no en vez de ella. Una indica cómo se comportó el release; la otra, qué hizo el sistema en respuesta. Juntas te dan una idea mucho mejor de si la actualización debe seguir activa.
10. Distribución de adopción por canal
La distribución de adopción por canal muestra cómo se distribuyen los dispositivos activos entre beta, staging, producción o flujos específicos de cliente. Indica si las personas adecuadas ven la versión correcta en el momento adecuado. También detecta uno de los errores más comunes: tráfico de pruebas que se filtra a producción o usuarios de producción que permanecen en un canal de prueba.
Un equipo de comercio electrónico regulado puede confirmar que ningún dispositivo de producción terminó accidentalmente en beta tras un lanzamiento. Una agencia puede rastrear canales específicos de cliente y descontinuar los que nadie usa. El dashboard debe mostrar la membresía de canal con suficiente claridad para que las rutas incorrectas sean evidentes de un vistazo.
Usa los canales como límites, no como etiquetas
Los canales solo son útiles si se aplican. Si los testers, el personal interno y los pilotos de clientes terminan en el mismo flujo, el proceso de release pierde su límite de seguridad. Documenta los canales y revisa la distribución antes de cada release importante.
Configura alertas para miembros inesperados, sobre todo dispositivos beta en producción o viceversa. Esa comprobación puede detectar una exposición accidental antes de que se convierta en un problema de soporte. Un mapa de canales limpio también acelera los post-mortems, ya que el equipo puede ver quién recibió qué y cuándo.
El umbral práctico es si la distribución coincide con la intención. Si no es así, el proceso de release tiene fugas. En un sistema de live updates, no es un problema cosmético, es un problema de control.
Comparativa de 10 métricas de adopción
| Métrica | 🔄 Complejidad de implementación | ⚡ Requisitos de recursos | 📊 Resultados esperados | 💡 Casos de uso ideales | ⭐ Ventaja clave |
|---|---|---|---|---|---|
| Tasa de adopción de actualizaciones | Baja, verificaciones de versión y definición de dispositivos activos | Bajo, agregación y segmentación periódicas | % de dispositivos activos en la versión objetivo a lo largo del tiempo | Decisiones de go/no-go, monitoreo de hotfixes, verificaciones entre plataformas | Indicador de salud de la versión con un solo número |
| Distribución de versiones (Índice de fragmentación) | Moderado, conteos por versión y visualización de series temporales | Moderado, almacenamiento histórico y segmentación | Visibilidad de la dispersión de usuarios entre versiones y carga de soporte | Priorización de compatibilidad/pruebas y actualizaciones forzadas | Revela qué versiones antiguas requieren soporte |
| Tiempo hasta X% de adopción (Velocidad de adopción) | Moderado, eventos con marca de tiempo y curvas acumulativas | Moderada, cálculos y gráficos de percentiles | Métricas de velocidad (mediana/p90) para alcanzar umbrales de adopción | Respuesta a incidentes, benchmarking de velocidad de release | Mide la rapidez con la que los usuarios reciben correcciones |
| Curva de adopción de despliegue gradual | Alta, orquestación de porcentajes graduales y reglas de gating | Alto, monitoreo por etapa, controles de pausa/expansión | Exposición controlada por etapas con señales de pausa/parada | Lanzamientos riesgosos, entornos regulados y rollouts auditados | Limita el radio de impacto y permite una expansión segura |
| Tasa de éxito de instalación de updates | Moderada, instrumentación de las etapas download/verify/apply | Moderado–Alto, logs por dispositivo, seguimiento de etapas de fallo | % de instalaciones exitosas; desglose por etapa de fallo | Resolución de fallos en la entrega o verificación | Identifica dónde fallan los updates para un debugging más rápido |
| Tasa de rollback | Baja–Moderada, trackea rollbacks y clasifica causas automáticas/manuales | Bajo, tracking de eventos y registros post-mortem | % de releases/dispositivos revertidos y tiempo de rollback | Validar salvaguardas, medir la calidad del release | Medición directa de problemas de release y efectividad del rollback |
| Tasa de dispositivos desactualizados | Low, compute last-update age per active device | Bajo, timestamps de última conexión/actualización y segmentación | % de dispositivos activos sin actualizar en N días | Reportes de seguridad/compliance, comunicación proactiva o actualizaciones forzadas | Identifica dispositivos sin parches o nuevas features |
| Ratio de eficiencia de actualizaciones diferenciales | Alto, calcular bytes del delta vs bundle completo por release | Moderado, diffs de build y telemetría por release | Ratio de bytes ahorrados; ahorro medio por release/dispositivo | Redes limitadas, releases pequeñas y frecuentes, cambios de arquitectura | Cuantifica el ahorro de ancho de banda y justifica las actualizaciones pequeñas |
| Sesiones sin crashes en la cohorte actualizada | Moderado, segmentación de sesiones y atribución de crashes | Moderado, reporte de crashes, segmentación, verificaciones estadísticas | % sin crashes para cohortes nuevas vs. línea base; detección de regresiones | Alertas de regresión, despliegues escalonados, chequeos de salud del release | Aísla el impacto del release en la estabilidad para decidir rollbacks |
| Distribución de adopción por canal | Bajo–Moderado, seguimiento de asignaciones y cambios de canal | Bajo, monitoreo de metadatos y membresía de canales | Proporción de dispositivos por canal; exposiciones inesperadas | Validación de beta testing, pilotos enterprise, gobernanza de canales | Valida las reglas de targeting y evita exposiciones accidentales |
Cómo convertir estas métricas de adopción en una rutina de release
El mejor dashboard de release no intenta mostrarlo todo a la vez. Empieza con la distribución de adopción por canal y tasa de éxito de instalación de actualizaciones para saber que el bundle está dirigido al público correcto y llega a los dispositivos. Luego rastrea la curva de adopción del staged rollout y tiempo hasta el X% de adopción para mostrar lo rápido que se propaga el release.
Después de eso, entran en juego los controles de calidad. Sesiones sin crashes en la cohorte actualizada te indica si el nuevo build funciona correctamente, mientras que tasa de rollback muestra si la red de seguridad tuvo que intervenir. Distribución de versiones y tasa de dispositivos desactualizados completan el panorama mostrando qué tan fragmentada está la flota y cuántos dispositivos se están quedando atrás.
Una revisión de release es mucho más fácil cuando el equipo elige un conjunto pequeño de métricas y deja por escrito las definiciones antes de lanzar. Elige tres métricas para el próximo release, define el denominador, establece el umbral y revísalas en la misma reunión cada vez. Si trabajas con un flujo de live updates de Capacitor, ese ritmo suele ser lo que convierte los datos de adopción sin procesar en un proceso de release en el que se puede confiar.
Para equipos que también necesitan prácticas sólidas de retención y gobernanza de datos, Guía de Sift sobre políticas de retención de datos para equipos de social media es un recordatorio útil de que la medición solo funciona si los datos subyacentes se mantienen limpios y utilizables. El hábito de release importa más que el dashboard en sí. Una vez que el equipo puede explicar cómo se ve un “buen” resultado, cada update es más fácil de lanzar, defender y mejorar.
Capgo ofrece a los equipos de Capacitor y Electron una vía de actualizaciones en vivo para enviar correcciones de JavaScript, CSS, textos, config y assets sin esperar la revisión de la tienda. Si quieres que los datos de release coincidan con el proceso de release, visita Capgo y descubre cómo los bundles firmados, los guardrails de canales, la protección contra rollback y las métricas de adopción encajan en un mismo workflow.





