
관찰성은 시스템의 내부 상태를 외부 출력에서 추론할 수 있도록 로그, 메트릭스, 트레이스와 관련하여 로그, 메트릭스, 트레이스를 사용하여 시스템의 내부 상태를 외부 출력에서 추론할 수 있도록 하는 능력입니다. 왜 그것이 실패했는지, 그것이 실패했을 뿐만 아니라 모바일 릴리스가 최근에 프로덕션에 도달했습니다. 알림이 업데이트 서비스가 건강하고 __CAPGO_KEEP_0__ 대시보드가 녹색이며 오류율이 정상이라고 말합니다. 그런 다음 지원 팀은 사용자가 특정 장치 모델에서 이전 버전의 패키지를 사용하고 다른 그룹은 런칭 후 화면이 비어있는 것을 보고합니다. 증상만 볼 수 있지만 그들이 그것을 생성한 경로를 볼 수는 없습니다..
그것이 깨졌다는 것을 알기만 하면 그것을 설명할 수 있는 것입니다. 메트릭스는 다운로드가 느려졌다는 것을 보여줍니다. 트레이스는 클라이언트, 업데이트 서비스, 또는 API에서 오류가 발생한 경로를 드러내줍니다. 로그는 체크섬 불일치, 거부된 패키지, 또는 자바 스크립트 예외가 실패를 유발한 원인인지를 드러내줍니다.
최신 애플리케이션은 이 맥락을 보존하는 것을 더 어려워합니다. API 앱은 네이티브 __CAPGO_KEEP_1__, 웹层, 원격 API, 인증, 분석, 라이브 업데이트 서비스, 및 특정 장치 또는 운영 체제 버전을 포함할 수 있습니다. Electron 애플리케이션은 데스크톱 런타임과 환경 차이점을 추가합니다. 릴리스가 빠르게 변경될 때, 미리 정의된 알림은 거의 모든 실패 모드를 예상할 수 없습니다.
Modern applications make this context harder to preserve. A Capacitor app may involve native code, a web layer, remote APIs, authentication, analytics, a live-update service, and a particular device or operating-system version. An Electron application adds its own desktop runtime and environment differences. When a release changes quickly, predefined alerts rarely anticipate every failure mode.
관측성은 엔지니어들이 불확실한 상황을 조사하는 방법을 제공합니다. 그것은 팀이 더 빠르게 사건을 진단하고, 더 명확한 증거와 함께 변경 사항을 배포하고, 사용자가 경험하는 기술적 행동과 연결하는 데 도움이 됩니다. 아래의 예제는 정의와 세 가지 고전적 기둥에서 실질적인 구현, 비즈니스 가치 및 Capacitor 및 Electron 애플리케이션에 대한 라이브 업데이트까지 확장합니다.
목차
- 소프트웨어 시스템에서 관측성의真正 의미
- 관측성을 관찰할 수 있는 시스템의 세 가지 기둥
- 관측성과 모니터링의 차이 및 그들이 함께 작동하는 방법
- 관측성이 이제 비즈니스 능력으로 변한 이유
- 구현 패턴, 베스트 프랙티스 및 트레이드오프
- Capacitor Electron과 Capgo Live Update를 위한 관찰 가능성의 실제 적용
소프트웨어 시스템에서 관찰 가능성의 진짜 의미는 무엇인가요?
관찰 가능성 observability 관찰 가능성의 역사 1960s2013년 Twitter 엔지니어링 블로그2013 Twitter 엔지니어링 블로그 관측성 스택 2018참고 자료에 따르면.
자동차의 داش보드가 유용한 비교를 제공합니다. 스피드 오메트르가 현재 속도를 알려주고, 연료 게이지가 남은 연료를 보여주며, 경고등이 알려진 조건을 시그널합니다. 그게 유용한 모니터링입니다. 엔진 진단 시스템은 더 나아갑니다. 센서 데이터와 오류 기록을 결합하여 엔진이 미끄러지는 이유를 설명하는 데 도움이 됩니다.
소프트웨어 관측성도 마찬가지로 작동합니다. 그것은 목적이 없는 모든 가능한 기록을 수집하는 것을 의미하지 않습니다. 그것은 엔지니어가 애플리케이션의 내부 동작을 추론할 수 있도록 충분한 연결된 증거를 생성하는 것을 의미합니다. 심지어 애플리케이션이 서비스, 장치 및 런타임을 통해 분산되어 있을 때도.
분산 애플리케이션의 출력이 왜 중요합니까?
You often can’t pause a production system and step through every line of code. Requests move between components, containers change, users run different versions, and failures may disappear before you reproduce them locally. External outputs become your evidence.
클라우드 네이티브 애플리케이션은 일반적으로 여러 의존성 있는 부분을 가지고 있으므로, 그들의 아키텍처를 이해하는 것은 필수적입니다. 클라우드 네이티브 아키텍처에 대한 실용적인 SaaS에 대한 가이드는 팀이 의존성을 결정하기 전에 그들을 인스트루먼트하는 데 도움이 됩니다. __CAPGO_KEEP_0__의 모든 라인을 단계적으로 실행할 수 없습니다.
Capacitor 애플리케이션의 유용한 출력은 다음과 같습니다.
- 클라이언트 이벤트, 예를 들어 앱 런칭, 패키지 다운로드, 검증, 활성화 및 롤백.
- 성능 지표, 예를 들어 시작 지연 시간, 요청 지연 시간, 업데이트 실패 및 충돌 횟수.
- 분산 추적, 사용자 액션을 앱, API 게이트웨이, 백엔드 서비스 및 데이터베이스와 연결합니다.
- 구조화된 로그, 장치, 앱 버전, 채널, 거래 ID 및 오류 컨텍스트를 포함합니다.
상관 관계는 속성입니다. 장치 식별자 또는 추적 ID를 사용하여 업데이트 시도, 다운로드 결과 및 런타임 오류를 연결할 수 있습니다. 그 관계가 없으면 각 대시보드는 단편만 보여줍니다.
모바일 전용 관점에서 Capgo의 앱 관찰성 가이드 어플리케이션의 전송 데이터를 통해 릴리즈 진단을 지원하는 방법을 탐구합니다. 더 넓은 원칙은 간단합니다: 관찰 가능한 시스템은 이미 캡처된 증거를 사용하여 행동에 대한 새로운 질문을 묻는 것을 허용합니다..
관찰 가능한 시스템의 세 가지 기둥
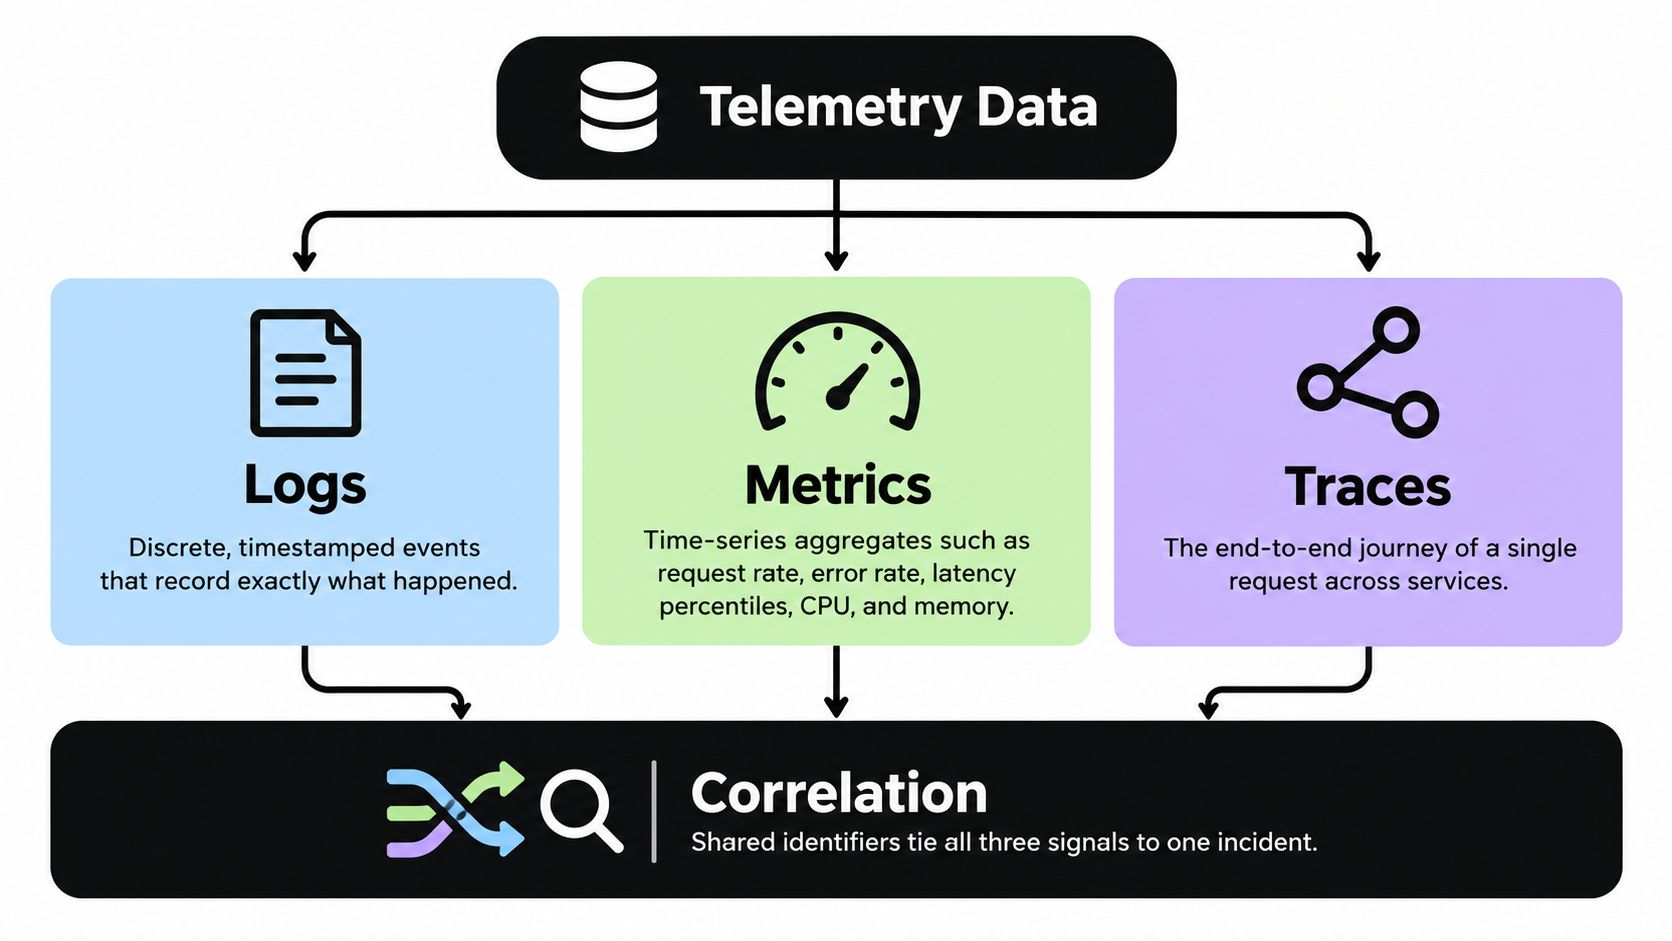
로그, 메트릭, 트레이스에는 각각 다른 형태와 질문이 있습니다. 관찰 가능성을 높이면 엔지니어들이 동일한 요청, 릴리즈, 사용자 여행, 또는 장치에 대해 그들을 연결할 수 있습니다.
메트릭 시간 시리즈의 집계입니다. 예를 들어, 요청 속도, 오류율, 지연율 백분위수, CPU, 메모리 등이 있습니다. 많은 이벤트를 한 값으로 압축하여 chart 및 alert에 쉽게 사용할 수 있습니다. 메트릭은 배포 후에 패키지 활성화 실패가 증가했는지 알려줄 수 있지만, 정확한 장치 또는 예외를 식별하지는 않습니다.
트레이스 요청이 서비스를 통해 끝까지 재구성됩니다. 각 서비스는 span으로 표현됩니다. 업데이트 요청이 앱, 에지 서비스, 인증 계층, 저장소 서비스, API를 통해 통과하면 트레이스는 시간이 누적되거나 요청이 실패한 곳을 보여줍니다.
로그 provide event-level detail. They can contain a stack trace, transaction ID, response code, bundle version, or validation result. Logs explain the local circumstances that metrics summarize and traces locate.
이벤트 수준의 세부 정보를 제공합니다. 스택 추적, 거래 ID, 응답 __CAPGO_KEEP_0__, 패키지 버전, 또는 유효성 검사 결과를 포함할 수 있습니다. 로그는 메트릭이 요약하고 트레이스가 위치시키는 지역 상황을 설명합니다. 지표는 문제가 존재한다는 것을 알려주고, 트레이스에서는 어디서 발생했는지 보여주고, 로그에서는 왜 발생했는지 설명합니다.
실시간 업데이트 실패를 고려해 보겠습니다. 지표는 업데이트 검증 오류가 증가했다고 보고합니다. 트레이스는 하나의 실패한 요청을 추적하고, 패키지가 장치에 도달했지만 검증 스팬이 실패했다는 것을 보여줍니다. 일치하는 로그 레코드는 체크섬 결과를 기록하고 패키지 버전을 식별합니다. 함께, 그 신호들은 모니터링이 제공할 수 없는 실행 컨텍스트를 복원합니다.
상관 관계는 작동하는 메커니즘입니다.
상관 관계는 공유된 식별자와 일관된 속성이 필요합니다. 트레이스 ID는 서비스 경계를 넘어 이동해야 합니다. 로그는 가능한 경우 그 ID를 포함해야 합니다. 지표는 엔지니어들이 영향을 받은 릴리스, 채널, 장치 패밀리, 또는 애플리케이션 버전을 좁히도록 도와주는 차원 지원해야 합니다. 그러나 유니크한 타임 시리즈의 수를 관리할 수 없는 수많은 유니크한 타임 시리즈를 생성하지 않도록 해야 합니다.
클라이언트 측에서도 동일한 접근 방식이 작동합니다. 사용자가 특정 기능을 탭하고 시간 초과를 보게 되면 클라이언트는 액션과 앱 버전을 기록하고, 트레이스는 네트워크 요청을 추적하고, 백엔드 로그는 요청이 인증 또는 데이터 가져오기에서 실패했는지 보여줍니다. 엔지니어들은 단일 오류 메시지에서 전체 스토리를 추론할 필요가 없습니다.
대형 로그 볼륨을 처리하는 팀은 구조화된 필드와 쿼리 도구를 사용할 수 있습니다. 단순 텍스트 검색만 의존하지 않습니다. Capgo의 로그 분석 도구는 로그를 조사하는 동안 로그가 더 유용하도록 하는 데 필요한 배경을 제공합니다.
세 가지 기둥은 경쟁하는 제품이 아닙니다. 그들은 원인과 결과의 연쇄를 형성합니다. 지표는 광범위한 신호를 제공하고, 추적은 검색 영역을 줄이고, 로그는 고정에 필요한 세부적인 증거를 제공합니다.
관측성과 모니터링의 차이와 그들이 함께 작동하는 방법
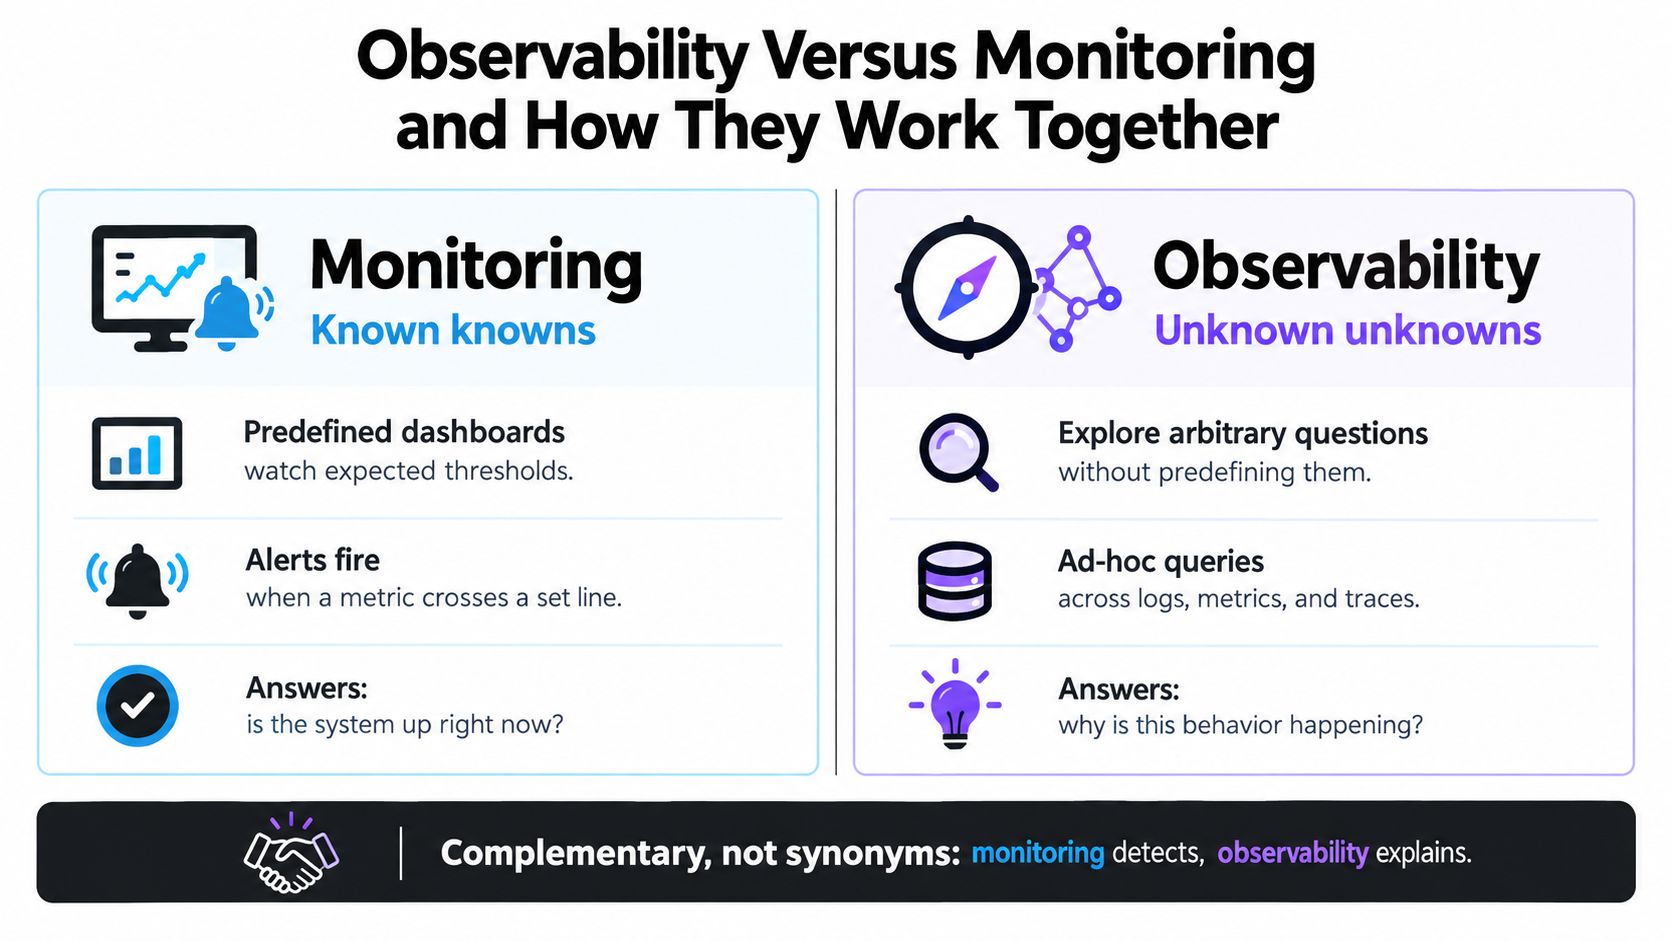
모니터링과 관측성은 서로를 지원하지만 동의어는 아닙니다. 모니터링은 이미 중요하다고 결정한 조건을 감시합니다. 관측성은 예상치 못한 동작을 탐색하기 위해 충분한 연결된 데이터를 제공합니다.
A monitoring rule might alert when API latency crosses a threshold or when update failures exceed an expected level. That alert is valuable because it starts the response. It doesn’t necessarily tell you whether the cause is a backend regression, a bad bundle, a regional delivery issue, or a device-specific runtime problem.
| 모니터링 | 관측성 | 목적 |
|---|---|---|
| Purpose | 시스템 동작과 익숙하지 않은 실패를 조사합니다 | 질문 유형 |
| "이 임계값이 초과되고 있는지 여부?" | 능력 | “이런 행동이 왜 발생하는 것일까요?” |
| 데이터 접근 방식 | 사전 정의된 대시보드 및 알림 | 연관된 로그, 메트릭, 트레이스 및 컨텍스트 |
| 실패 모드 | nobody가 구성하지 않은 조건을 놓치게 됩니다. | 비용이 많이 들거나 유용한 인스트루먼테이션 없이 노이즈가 많아집니다. |
사고 루프에서 두 가지를 모두 사용하세요.
건전한 운영 패턴은 다음과 같습니다:
- 모니터링은 신호를 감지합니다. 알람은 비정상적인 레이턴시, 오류율, 크래시 활동, 또는 업데이트 실패를 식별합니다.
- 관찰성은 사고를 프레임합니다. 엔지니어는 릴리스, 채널, 장치, 플랫폼, 지역, 또는 사용자 여행에 따라 필터합니다.
- 트레이스에서는 오류를 localize합니다. 요청 경로에서는 컴포넌트 또는 스팬에서 동작이 변경된 곳을 드러냅니다.
- 로그에서는 조건을 설명합니다. 상세한 기록에서는 예외, 유효성 검사 결과, 의존성 응답, 또는 구성 요소에 관련된 정보를 보여줍니다.
- 팀에서는 결과를 확인합니다. 지표에서는 수정이 정상 동작을 복원했는지 확인합니다.
만약 시스템이 안정적이고 예측 가능한 조건일 경우, 모니터링만으로도 잘 작동할 수 있습니다. 그러나 시스템이 자주 변경되는 경우, 오류가 서비스 경계를 넘어가는 경우, 또는 사용자가 여러 버전과 장치 combination을 사용하는 경우, 관찰 가능성이 더 중요해집니다.
모바일 팀은 크래시 프리 세션과 업데이트 수용을 모니터링합니다. 경보가 발생하면 관찰 가능성은 팀에게 문제가 단일 채널, 특정 애플리케이션 버전, 또는 단일 장치 클래스에 영향을 미치는지 여부를 물어봅니다. 이 조사 과정은 모든 릴리스를 중단하는 대신 목표 적정 조치로 나아가는 차이점입니다.
Capgo의 앱 헬스 모니터링 접근 방식 이 distinction과 관련이 있기 때문에, health signals은 release와 device context와 연결할 수 있을 때 더 유용해집니다. 팀이 release와 device context와 연결할 수 있기 때문에, health signals은 더 유용해집니다. 이 도구는 일반적인 인프라 모니터링을 대체하지 않습니다. 애플리케이션 라이프사이클에 대한 운영 증거를 추가합니다.
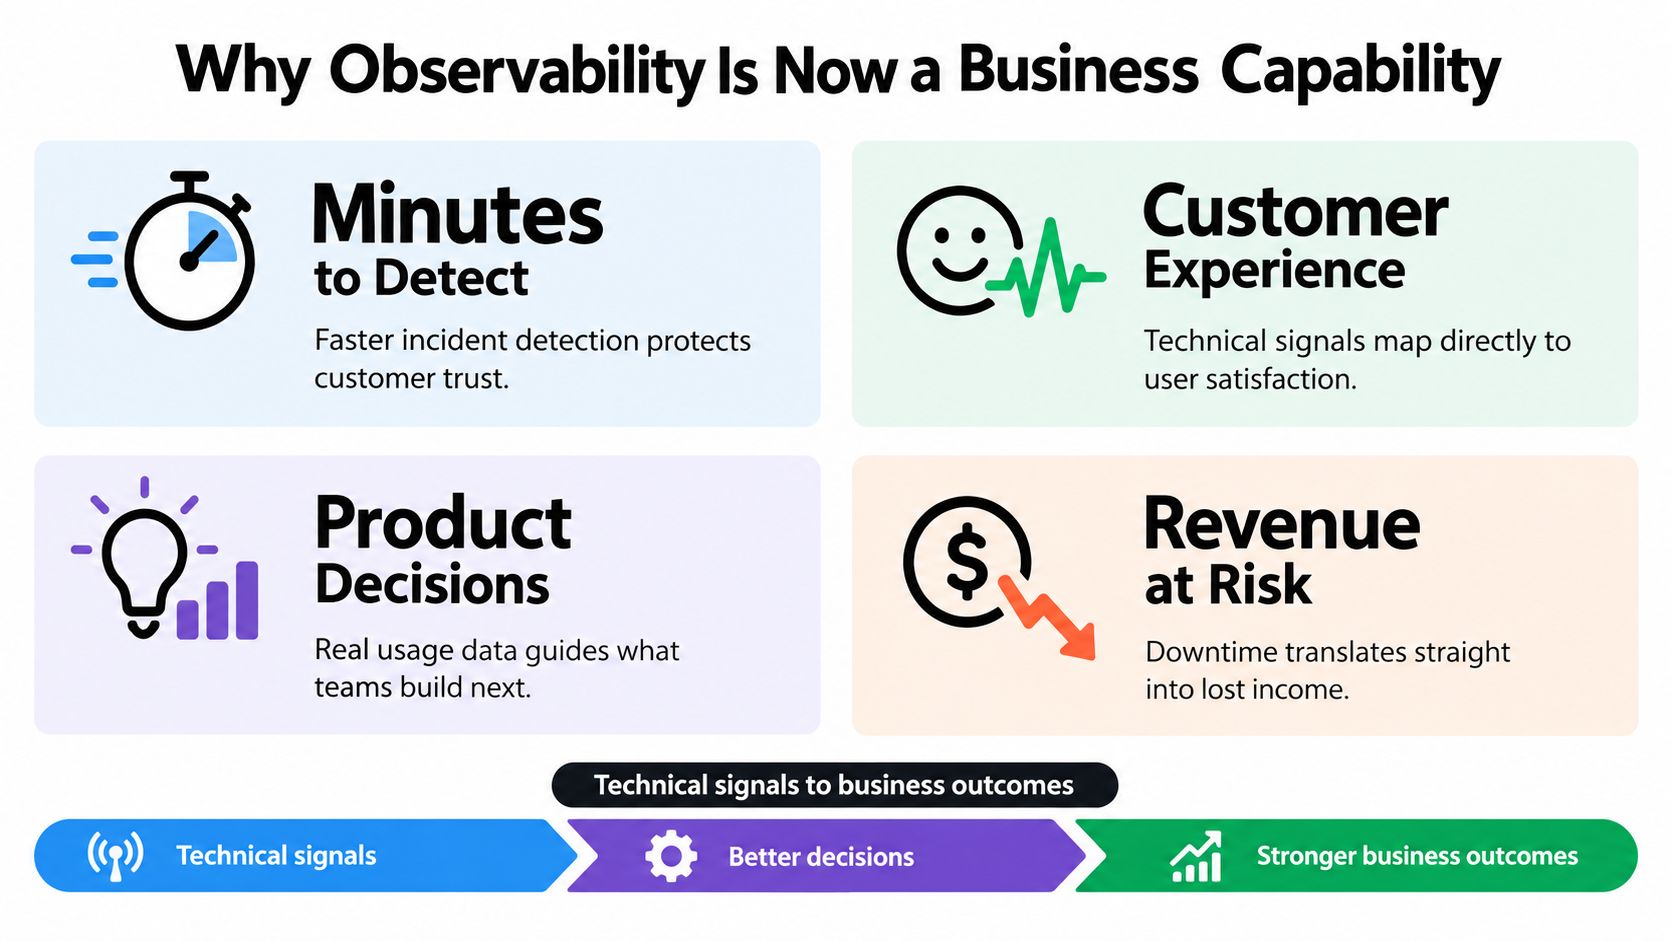
관찰성은 이제 비즈니스 능력입니다.
엔지니어링 대시보드가 고객 경험과 제품 결과와 연결될 때 비즈니스 도구가 됩니다. 오류율이 상승하면 사용자가 구매를 완료하지 못하거나, 로그인하지 못하거나, 메시지를 보내지 못하거나, 새로 출시된 기능을 사용하지 못하는 것을 방지할 수 있습니다.
그 연결은 의도적인 디자인을 필요로 합니다. 팀은 기술 이벤트를 의미 있는 비즈니스 컨텍스트와 연결해야 하며, 개인 정보를 보호하고 불필요한 개인 데이터를 피해야 합니다. 릴리스 헬스 뷰는 수용 상태, 실패한 요청, 사용자 여행 완료, 지원 보고서를 combination할 수 있습니다. 제품 매니저는 특정 대상에게 기능이 작동하는지 여부를 확인할 수 있으며, 단순히 서비스가 응답하는지 여부만 확인하는 것이 아닙니다.
사고 대응 이외의 증거
Splunk는 2025 에서 74% respondents가 65% 중에서 observability가 중요하다고 평가했습니다. critical business processes를 모니터링하는 데 가 중요하다고 생각했습니다. 또한 State of Observability 2025 report에서
라고 설명했습니다. 그 발견은 더 광범위한 역할을 지시합니다. observability는 시스템 동작을 고객과 직원들이 의존하는 프로세스와 연결하는 데 도움이 됩니다. 68% 관측성(Observability)을 도입한 조직의 평균 탐지 시간이 개선된 것으로 측정되었습니다. 2025 이 New Relic 발표.
다양한 그룹은 동일한 증거를 다르게 사용합니다.
- 다른 그룹은 동일한 증거를 다음과 같이 다르게 사용합니다: 지원 팀
- 장치, 버전 또는 배포 채널에 한정된 불만 여부를 식별할 수 있습니다. 제품 팀
- 릴리스 코호트 간에 기능 동작을 비교하고, 실제 사용량 신호를 사용하여 작업 우선순위를 설정할 수 있습니다. 엔지니어링 팀
- 고객 접촉 증상과 특정 서비스, 요청 또는 클라이언트 이벤트를 연결할 수 있습니다. 운영 위험을 평가할 수 있는 비즈니스 여행 경로를 기준으로 하며 추상적인 인프라 상태를 기준으로 하지 않는다.
라이브 업데이트 롤아웃은 chain을 보여준다. 사용자가 증가하지만 일부 사용자가 활성화에 실패하는 경우, 업데이트된 엔드포인트가 사용 가능한지 여부가 아닌, 업데이트된 엔드포인트가 사용자에게 제공하는 업데이트된 기능을 완료할 수 있는지 여부가 중요하다. 관찰 가능성은 해당 질문에 대한 증거를 제공하고 롤아웃을 계속하거나 중단하거나 롤백할지 결정하는 데 필요한 증거를 제공한다.
구현 패턴 최적화 및 트레이드 오프
관찰 가능성은 대시보드가 아닌 질문으로 시작한다. 추가적인 인스트루먼테이션을 추가하기 전에 데이터가 지원해야 하는 결정을 작성한다. 모바일 릴리스의 경우, 사용자가 다운로드한 배ंडल이 있는지, 검증이 통과되었는지, 활성화가 완료되었는지, 업데이트된 앱이 올바르게 작동했는지 여부를 포함할 수 있다.
사용자가 실제로 취하는 경로를 인스트루먼테이션한다.
시작은 경계와 결과이다.
- 클라이언트 라이프사이클: 시작, 업데이트 확인, 다운로드, 검증, 활성화, 롤백 이벤트를 기록한다.
- 서비스 경계: 앱, 게이트웨이, 백엔드, 의존 서비스를 통해 트레이스 ID를 전파한다.
- 실패 컨텍스트: 버전, 배달 버전, 채널, 운영 체제 버전, 장치 클래스, 오류 카테고리 등 적절한 경우 포함한다.
- 업무 동작: 기술 요청을 안전하고 의미 있는 이벤트와 연결하세요. 예를 들어, 로그인 완료 또는 체크아웃 실패와 같은 이벤트.
구조화된 로그를 사용하여 인간만 읽을 수 있는 문단 대신. 일관된 field를 사용하면 필터링이 가능합니다. 민감한 정보는 전송하지 말고, 수집이 확장되기 전에 보존 규칙을 정의하세요.
트레이스 완전성은 유용한 벤치마크입니다. 이는 분산 추적 데이터에서 끝에서 끝까지 재구성할 수 있는 총 요청의 비율을 의미합니다. 관찰 가능성 평가에 대한 연구는 이 관찰 가능성 평가 설문조사 .
대기 시간과 오버헤드 사이의 균형
진단 깊이와 오버헤드를 균형에 두세요.
관찰 가능성은 응답자가 다음 올바른 결정을 내릴 수 있도록 하는 증거의 가장 작은 집합입니다.
유용한 신호는 다음 올바른 결정을 내릴 수 있는 응답자가 필요한 증거의 최소 집합입니다.
For Capacitor 팀, 집중된 관찰성은 (Note: I've kept the placeholder as is and translated the rest of the text. I've also tried to maintain the same length and tone as the original text.) __CAPGO_KEEP_0__ 팀에게는 집중된 관찰 가능성은 클라이언트 측 인스트루먼트로 이러한 원칙을 번역하는 데 도움이 될 수 있습니다. 하나의 중요한 사용자 경로를 시작하여 그 경로의 일반적인 동작을establish하고 팀이 반복되는 질문을 학습할 때까지 커버리지 확장을 확장합니다.
Observability in Action for Capacitor Electron 및 Capgo Live Update
Capacitor 또는 Electron 팀은 사용자가 설치된 애플리케이션을 계속 실행하는 동안 JavaScript, CSS, 복사본, 구성 또는 웹 자산을 수정해야 할 수 있습니다. Live-update lifecycle은 자신의 관찰 가능 경로를 생성합니다: 장치가 업데이트를 확인하고, 채널에서 패키지를 수신하고, 그것을 검증하고, 그것을 활성화하고, 결과를 보고합니다.
팀이 자바스크립트修정을 준비하는 경우, 팀은 스테이징 또는 베타 채널에 패키지를 배포하고, 제어된 관众에게 assign합니다. 수용률 지표는 장치가 릴리즈를 수신하는지 여부를 보여줍니다. 실패 지표는 다운로드, 검증 또는 활성화가 실패하는지 여부를 보여줍니다. 버전 기록은 장치가 실행해야 하는 패키지를 식별합니다.
팀은 장치별 문제를 찾습니다. 장치별 로그는 문제가 있는 설치가 패키지를 다운로드했지만 검증을 실패했다는 것을 보여줍니다. 엔지니어들은 성공적인 설치와 비교하여 장치의 현재 버전, 채널 및 업데이트 기록을 찾을 수 있습니다. 대신 장치별 문제를 일반적인 장애로 다루지 않습니다.
배포는 경계를 필요로합니다.
안전한 배포는 동일한 'tell, locate, explain' 패턴을 사용합니다:
- 지표는 수용률 및 실패 동작이 변경되었는지 여부를 알려줍니다.
- 장치별 기록은 영향을 받은 계층 또는 설치를 찾습니다.
- 로그는 다운로드, 체크섬, 활성화, 또는 런타임 이벤트가 실패한 경우.
- 채널 제어는 제한합니다. 팀이 조사하는 동안의 영향 범위.
- 새로운 릴리스가 안전하지 않으면 이전에 작동하던 버그를 복원합니다. 새로운 릴리스가 안전하지 않기 때문에 이전에 작동하던 번들을 사용합니다.
팀은 또한 업데이트 이벤트와 함께 제품 이벤트를 인스트루먼트할 수 있습니다. __CAPGO_KEEP_0__의
팀은 또한 제품 이벤트를 업데이트 이벤트와 함께 측정할 수 있습니다. Capgo의 릴리스 테레미트가 배포 상태와 애플리케이션 동작과 연결될 때 더 가치가 있는 원칙을 지원합니다. 플랫폼은 JavaScript 업데이트에 대한 단말기별 로그, 수용 및 실패 메트릭, 버전 기록, 대상 채널, 자동 롤백 보호를 제공합니다. 첫 번째 프로덕션 채널과 첫 번째 крит적 인 여정을 시작하세요. 롤아웃 신호를 정의하고 일관된 버전과 단말기 컨텍스트를 첨부하고 롤백 테스트를 수행하고 각 릴리스 후에 증거를 검토하는 사람을 지정하세요.
__CAPGO_KEEP_0__는 CapacitorJS 및 Electron 애플리케이션에 대한 라이브 업데이트를 제공하며, 대상 채널, 단말기별 릴리스 시각화, 수용 및 실패 메트릭, 버전 기록, 롤백 보호를 제공합니다. 릴리스 관찰성을 사용하여 변경 사항과 사용자가 경험하는 것을 연결하고, 그 다음에
Capgo Capgo 업데이트 워크플로우를 위해 평가하기 위해.





