
Observability ist die Fähigkeit, den internen Zustand eines Systems anhand externer Ausgaben durch die Korrelation von Logs, Metriken und Traces abzuleiten. Sie beantwortet warum etwas fehlgeschlagen ist, nicht nur dass etwas fehlgeschlagen ist.
Dein Mobile Release ist gerade in der Production gelandet. Ein Alert besagt, dass der Update-Service gesund ist, das API Dashboard grün leuchtet und die Error Rate normal aussieht. Dann meldet der Support, dass Nutzer eines bestimmten Gerätemodells bei einem alten Bundle feststecken, während eine andere Gruppe nach dem Launch nur einen Blank Screen sieht. Du siehst die Symptome, aber nicht den Weg, der zu ihnen geführt hat.
Das ist der Unterschied zwischen dem Wissen, dass etwas kaputt ist, und der Fähigkeit, es zu erklären. Eine Metric kann zeigen, dass die Downloads langsamer wurden. Ein Trace kann offenlegen, ob die Verzögerung vom Client, dem Update-Service oder API kam. Ein Log kann den Checksum-Mismatch, das abgelehnte Bundle oder die JavaScript-Exception aufdecken, die den Fehler verursacht hat.
Moderne Anwendungen erschweren die Wahrung dieses Kontextes. Eine Capacitor App umfasst oft native code, einen Web-Layer, Remote-APIs, Authentifizierung, Analytics, einen Live Update Service sowie eine spezifische Geräte- oder Betriebssystemversion. Eine Electron-Anwendung bringt zudem eigene Desktop-Runtimes und Umgebungsvariablen mit. Wenn sich Releases schnell ändern, können vordefinierte Alerts selten alle Fehlermodi vorhersehen.
Observability ermöglicht es Engineers, solche unbekannten Situationen ohne Raten zu untersuchen. Sie hilft Teams, Incidents schneller zu diagnostizieren, Änderungen mit klareren Belegen auszurollen und technisches Verhalten mit der User Experience zu verknüpfen. Die folgenden Beispiele führen von der Definition und den drei klassischen Säulen über die praktische Implementierung und den Business Value bis hin zu Live Updates für Capacitor und Electron-Anwendungen.
Inhaltsverzeichnis
- Was Observability in Softwaresystemen wirklich bedeutet
- Die drei Säulen für die Observability von Systemen
- Observability vs. Monitoring und ihr Zusammenspiel
- Warum Observability heute eine Business Capability ist
- Implementierungsmuster: Best Practices und Tradeoffs
- Observability in Action für Capacitor Electron und Capgo Live Updates
Was Observability in Softwaresystemen wirklich bedeutet
Der Begriff Observability entstand außerhalb der Software. In den 1960ernnutzte Rudolf Kálmán ihn in der Regelungstechnik, um zu beschreiben, wie gut ein Ingenieur den internen Zustand eines Systems aus dessen Outputs ableiten kann, wie in dieser Geschichte der ObservabilitySpäter fand die Idee durch Arbeiten an verteilten Systemen Einzug in die Softwarepraxis, unter anderem durch eine viel zitierte 2013 Twitter-Engineering-Blog beschrieb einen „Observability-Stack“. Das Drei-Säulen-Modell aus Logs, Metriken und Traces wurde zum Standard in 2018, laut derselben Quelle.
Ein Armaturenbrett im Auto ist ein guter Vergleich. Der Tacho zeigt, wie schnell man fährt, die Tankanzeige den verbleibenden Kraftstoff, und eine Warnleuchte signalisiert einen bekannten Zustand. Das ist nützliches Monitoring. Ein Motordiagnosesystem geht noch weiter: Es kombiniert Sensorwerte und Fehlerprotokolle, um zu erklären, warum der Motor Fehlzündungen hat.
Software-Observability funktioniert genauso. Es bedeutet nicht, jeden möglichen Datensatz ohne Grund zu sammeln. Es bedeutet, genügend zusammenhängende Nachweise zu erzeugen, damit ein Entwickler ableiten kann, was die Anwendung intern tut – selbst wenn sie über verschiedene Services, Geräte und Runtimes verteilt ist.
Warum Outputs in verteilten Anwendungen entscheidend sind
Du kannst ein Produktionssystem oft nicht anhalten, um jede Zeile von code durchzugehen. Requests wandern zwischen Komponenten, Container ändern sich, User nutzen verschiedene Versionen, und Fehler können verschwinden, bevor du sie lokal reproduzierst. Externe Outputs werden so zu deinen Belegen.
Eine Cloud-native Anwendung besteht meist aus mehreren voneinander abhängigen Teilen, daher liefert das Verständnis ihrer Architektur wichtigen Kontext. Ein praktischer Leitfaden zur Cloud-native-Architektur für SaaS hilft Teams dabei, diese Abhängigkeiten zu verstehen, bevor sie entscheiden, was instrumentiert werden soll.
Für eine Capacitor App könnten nützliche Outputs sein:
- Client-Events, wie App-Launch, Bundle-Download, Verifizierung, Aktivierung und Rollback.
- Performance-Metriken, wie Startup-Latenz, Request-Latenz, fehlgeschlagene Updates und Crash-Counts.
- Distributed Traces, die eine User-Aktion mit der App, dem API Gateway, dem Backend-Service und der Datenbank verknüpfen.
- Strukturierte Logs, die Device, App-Version, Channel, Transaction-ID und den Error-Context enthalten.
Die entscheidende Eigenschaft ist die Korrelation. Eine Device-ID oder Trace-ID kann einen Update-Versuch, das Download-Ergebnis und den darauf folgenden Runtime-Error miteinander verknüpfen. Ohne diese Verbindung zeigt jedes Dashboard nur ein Fragment.
Für eine mobile-spezifische Perspektive bietet Capgo Guide zur App-Observability erklärt, wie App-Telemetrie die Fehlerdiagnose bei Releases unterstützen kann. Das Grundprinzip bleibt einfach: Observable Systeme ermöglichen es, anhand bereits erfasster Daten neue Fragen zum Systemverhalten zu stellen.
Die drei Säulen der Observability
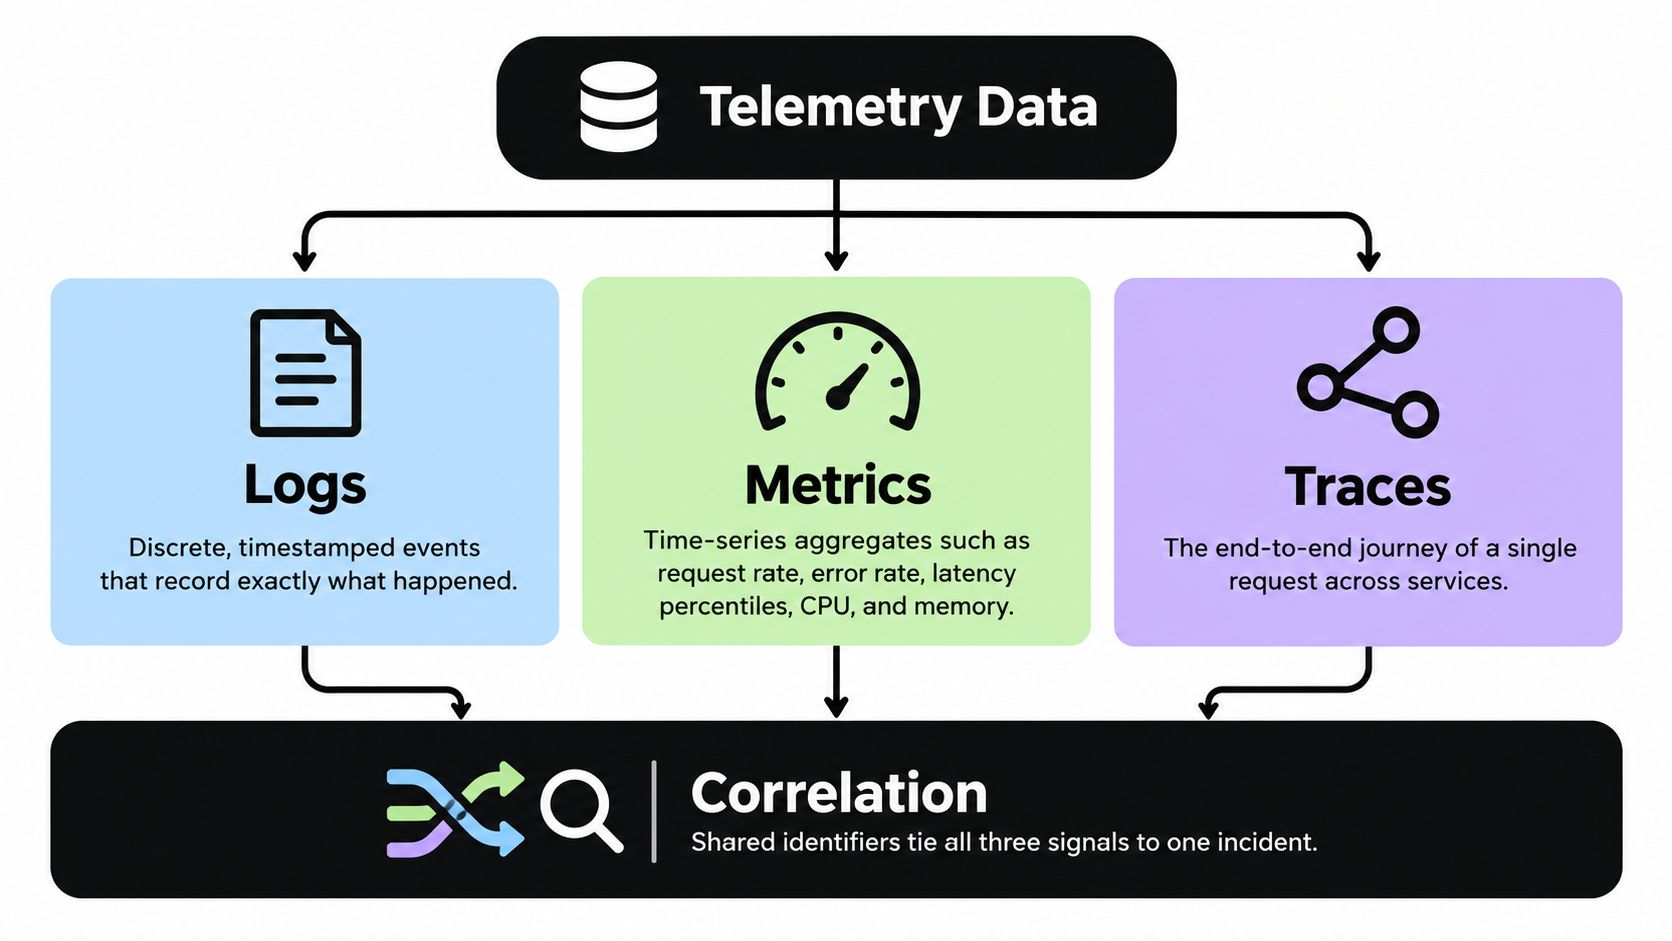
Logs, Metrics und Traces haben unterschiedliche Formen und beantworten verschiedene Fragen. Observability wird erst dann nützlich, wenn Engineers sie im Kontext desselben Requests, Releases, User Journeys oder Geräts korrelieren.
Metrics sind Zeitreihen-Aggregate. Beispiele sind Request-Rate, Error-Rate, Latenz-Perzentile, CPU und Memory. Sie komprimieren viele Events in einen Wert, der sich leicht visualisieren und überwachen lässt. Eine Metric zeigt dir vielleicht, dass die Bundle-Aktivierungsfehler nach einem Deployment gestiegen sind, identifiziert aber nicht das exakte Gerät oder die Exception.
Traces rekonstruieren den End-to-End-Pfad eines Requests über verschiedene Services hinweg. Jeder Teil dieses Pfads wird durch einen Span repräsentiert. Wenn ein Update-Request durch eine App, einen Edge-Service, den Authentication-Layer, einen Storage-Service und API läuft, zeigt der Trace, wo Zeit verloren ging oder der Request fehlgeschlagen ist.
Logs liefern Details auf Event-Ebene. Sie können einen Stack Trace, eine Transaction ID, eine code Response, die Bundle-Version oder ein Validierungsergebnis enthalten. Logs erklären die lokalen Umstände, die Metrics zusammenfassen und Traces lokalisieren.
Praktische Regel: Metrics zeigen dir, dass ein Problem existiert, Traces zeigen, wo es auftritt, und Logs erklären, warum es aufgetreten ist.
Nehmen wir einen Live Update Fehler an. Eine Metric meldet, dass die Fehler bei der Update-Verifizierung gestiegen sind. Ein Trace verfolgt eine fehlgeschlagene Anfrage und zeigt, dass das Bundle das Gerät erreicht hat, aber der Verification-Span fehlgeschlagen ist. Das passende Log protokolliert das Checksum-Ergebnis und identifiziert die Bundle-Version. Zusammen stellen diese Signale den Ausführungskontext wieder her, den isoliertes Monitoring nicht liefern kann.
Korrelation ist der entscheidende Mechanismus
Korrelation erfordert gemeinsame Identifikatoren und konsistente Attribute. Eine Trace ID sollte über Service-Grenzen hinweg übertragen werden. Logs sollten diese ID nach Möglichkeit enthalten. Metrics sollten Dimensionen unterstützen, die es Engineers ermöglichen, das betroffene Release, den Channel, die Device-Familie oder die App-Version einzugrenzen, ohne eine unhandliche Anzahl an Zeitreihen zu erzeugen.
Derselbe Ansatz funktioniert auf der Client-Seite. Angenommen, ein User tippt auf ein Feature und sieht einen Timeout. Der Client kann die Aktion und die App-Version aufzeichnen, der Trace kann die Netzwerk-Anfrage verfolgen und das Backend-Log kann zeigen, ob die Anfrage bei der Authentifizierung oder beim Datenabruf fehlgeschlagen ist. Engineers müssen die gesamte Story nicht aus einer einzigen Fehlermeldung ableiten.
Teams, die mit großen Log-Volumina arbeiten, können strukturierte Felder und Query-Tools nutzen, anstatt sich nur auf die Freitextsuche zu verlassen. Capgo’s Log-Analyse-Tools helfen dabei, den relevanten Hintergrund zu liefern, um Logs während einer Untersuchung nützlicher zu machen.
Die drei Säulen sind keine Konkurrenzprodukte, sondern bilden eine Ursache-Wirkungs-Kette. Metrics liefern das grobe Signal, Traces grenzen den Suchbereich ein und Logs liefern die detaillierten Beweise, die für einen Fix nötig sind.
Observability vs. Monitoring: Wie sie zusammenarbeiten
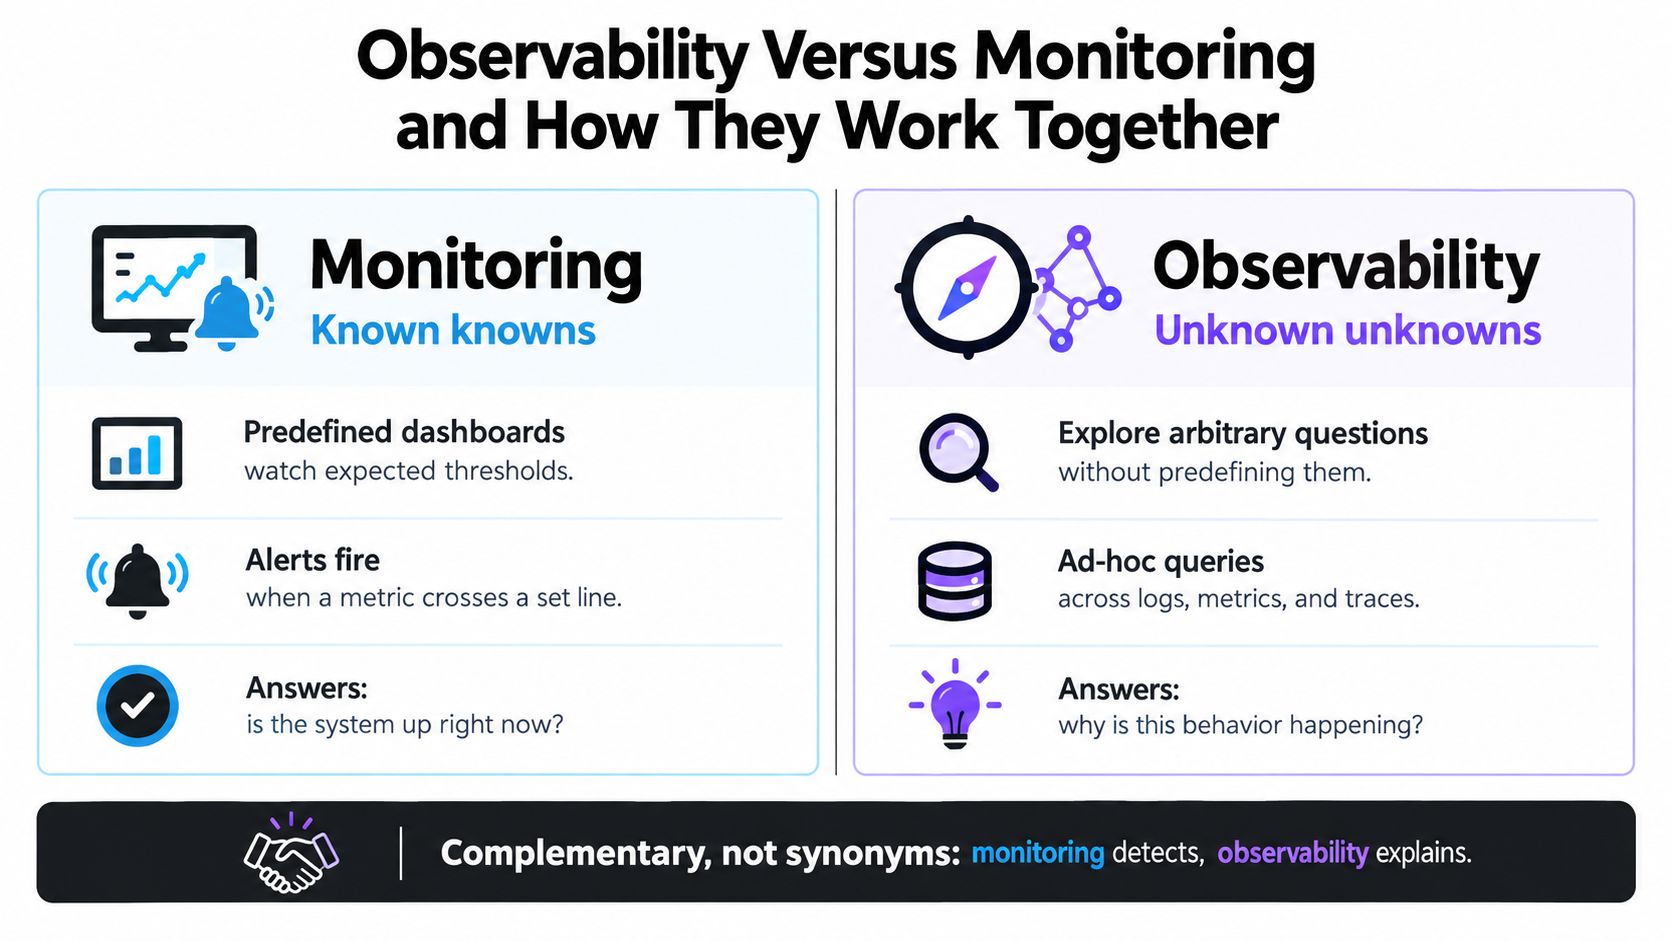
Monitoring und Observability ergänzen sich, sind aber keine Synonyme. Monitoring überwacht Zustände, von denen du bereits weißt, dass sie wichtig sind. Observability liefert dir genügend vernetzte Daten, um Verhalten zu untersuchen, das du nicht vorhergesehen hast.
Eine Monitoring-Regel könnte alarmieren, wenn die API Latenz einen Schwellenwert überschreitet oder Update-Fehler ein erwartetes Maß übersteigen. Dieser Alert ist wertvoll, weil er die Reaktion einleitet. Er sagt dir jedoch nicht zwangsläufig, ob die Ursache eine Backend-Regression, ein fehlerhaftes Bundle, ein regionales Auslieferungsproblem oder ein gerätespezifisches Runtime-Problem ist.
| Fähigkeit | Monitoring | Observability |
|---|---|---|
| Zweck | Bekannte Health-Indikatoren überwachen | Systemverhalten und unbekannte Fehler untersuchen |
| Question type | „Wird dieser Schwellenwert überschritten?“ | „Warum passiert das gerade?“ |
| Datenbasierter Ansatz | Vordefinierte Dashboards und Alerts | Korrelierte Logs, Metriken, Traces und Kontext |
| Fehlermodus | Übersieht Bedingungen, die niemand konfiguriert hat | Wird ohne nützliche Instrumentierung teuer oder unübersichtlich |
Beides im Incident-Loop nutzen
Ein gesundes Betriebsmuster ist simpel:
- Monitoring erkennt das Signal. Ein Alert identifiziert ungewöhnliche Latenz, Error Rate, Crashes oder Update-Fehler.
- Observability liefert den Kontext zum Incident. Engineers filtern nach Release, Channel, Gerät, Plattform, Region oder User Journey.
- Traces lokalisieren den Fehler. Der Request-Pfad zeigt die Komponente oder den Span, in dem sich das Verhalten geändert hat.
- Logs erklären die Ursache. Detaillierte Records zeigen die Exception, das Validierungsergebnis, die Dependency-Response oder die betroffene Konfiguration.
- Das Team verifiziert das Ergebnis. Metrics bestätigen, ob der Fix das normale Verhalten wiederhergestellt hat.
Monitoring allein funktioniert gut bei stabilen, vorhersehbaren Bedingungen. Observability wird wichtiger, wenn sich Systeme oft ändern, Fehler Service-Grenzen überschreiten oder Nutzer viele Kombinationen aus Versionen und Geräten nutzen.
Ein Mobile-Team überwacht eventuell crash-freie Sessions und die Update-Adoption. Wenn ein Alert ausgelöst wird, ermöglicht Observability dem Team zu prüfen, ob das Problem einen einzelnen Channel, eine bestimmte App-Version oder eine bestimmte Geräteklasse betrifft. Diese Untersuchung entscheidet darüber, ob man alle Releases pausieren muss oder gezielt korrigierend eingreifen kann.
Capgo’s Ansatz zur App-Health-Überwachung ist für diese Unterscheidung entscheidend, da Health-Signale wertvoller werden, wenn Teams sie mit Release- und Device-Kontext verknüpfen können. Das Tool ersetzt kein allgemeines Infrastruktur-Monitoring, sondern liefert operative Belege über den gesamten Application Lifecycle hinweg.
Warum Observability jetzt eine Business Capability ist
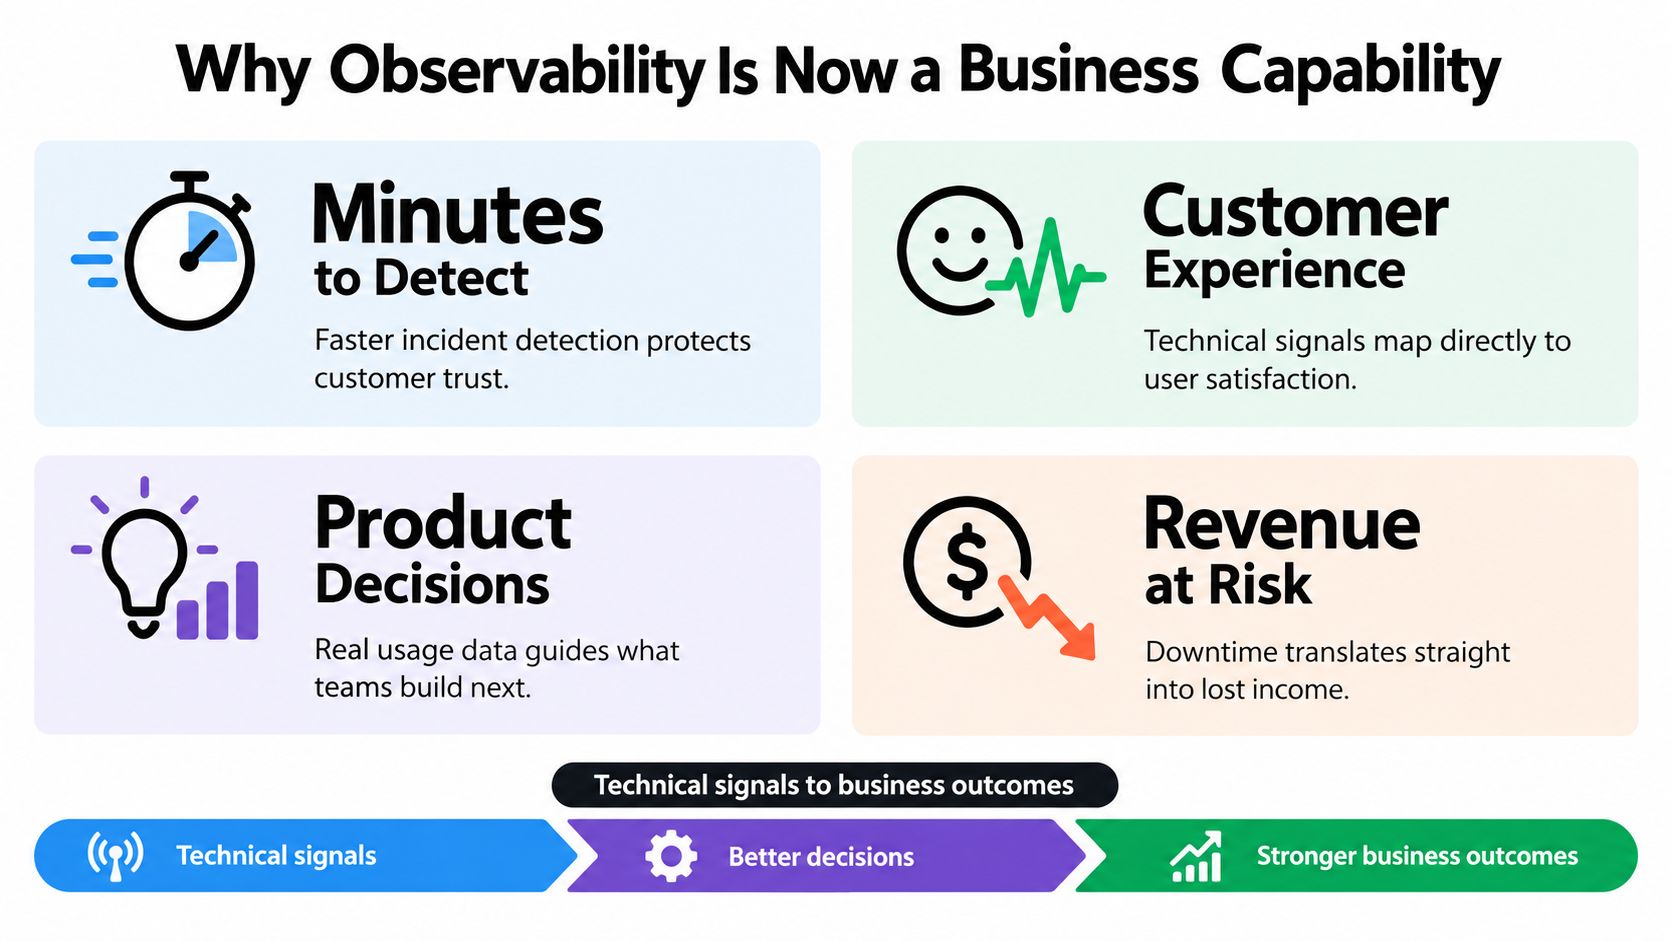
Ein Engineering-Dashboard wird zum Business-Tool, wenn seine Signale mit der Customer Experience und Produkt-Ergebnissen verknüpft sind. Eine steigende Error Rate ist kritisch, da sie verhindern kann, dass Nutzer einen Kauf abschließen, sich anmelden, Nachrichten senden oder ein neues Feature nutzen.
Diese Verbindung erfordert gezieltes Design. Teams sollten technische Events mit relevantem Business-Kontext verknüpfen, dabei aber die Privatsphäre wahren und unnötige personenbezogene Daten vermeiden. Eine Release-Health-Ansicht könnte Adoption-Status, fehlgeschlagene Requests, den Abschluss von User-Journeys und Support-Reports kombinieren. Product Manager sehen so, ob ein Feature bei der Zielgruppe funktioniert, statt nur zu prüfen, ob der Service antwortet.
Belege über die Incident Response hinaus
Splunk berichtete in 2025 dass 74% der Befragten Observability für das Monitoring kritischer Geschäftsprozesse als wichtig einstuften und 65% angaben, dass dies entscheidend für das Verständnis von User-Journeys sei, wie im State of Observability 2025 Report beschrieben. Diese Ergebnisse deuten auf eine umfassendere Rolle hin. Observability hilft Teams, das Systemverhalten mit den Prozessen zu verknüpfen, auf die Kunden und Mitarbeiter angewiesen sind.
New Relic berichtete, dass 68% von Unternehmen, die nach der Einführung von Observability ihre mittlere Erkennungszeit (MTTD) verbessert haben, laut diesem 2025 Bericht, verfügbar in dieser New Relic Ankündigung. Eine schnellere Erkennung ist operativ nützlich, aber der geschäftliche Mehrwert entsteht, wenn Teams zeigen können, welches Problem erkannt wurde und ob die Reaktion das Ergebnis beeinflusst hat.
Verschiedene Teams nutzen dieselben Daten unterschiedlich:
- Support-Teams können feststellen, ob eine Beschwerde auf ein bestimmtes Gerät, eine Version oder einen Rollout-Channel begrenzt ist.
- Produkt-Teams können das Feature-Verhalten über Release-Kohorten hinweg vergleichen und Aufgaben anhand echter Nutzungssignale priorisieren.
- Engineering-Teams können ein sichtbares Symptom beim Kunden direkt einem spezifischen Service, Request oder Client-Event zuordnen.
- Management-Teams kann operationelle Risiken anhand kritischer User Journeys statt abstrakter Infrastruktur-Status bewerten.
Ein Live Update Rollout verdeutlicht die Kette. Steigt die Adoption, aber ein Teil der Nutzer scheitert bei der Aktivierung, ist die entscheidende Business-Frage nicht, ob der Update-Endpoint verfügbar ist. Es geht darum, ob die betroffenen Nutzer die Aufgabe abschließen können, die das Release verbessern sollte. Observability liefert die nötigen Daten, um diese Frage zu beantworten und zu entscheiden, ob man den Rollout fortsetzen, pausieren oder zurückrollen sollte.
Implementierungsmuster: Best Practices und Trade-offs
Gute Observability beginnt mit Fragen, nicht mit Dashboards. Bevor du Instrumentierung hinzufügst, schreibe auf, welche Entscheidungen die Daten unterstützen sollen. Bei einem Mobile-Release könnten diese Fragen lauten: Hat das Gerät das Bundle heruntergeladen, war die Verifizierung erfolgreich, wurde die Aktivierung abgeschlossen und hat die aktualisierte App danach korrekt funktioniert?
Instrumentiere den tatsächlichen User-Pfad
Beginne mit Grenzen und Ergebnissen:
- Client-Lifecycle: Erfasse Events für Launch, Update-Check, Download, Verifizierung, Aktivierung und Rollback.
- Service-Grenzen: Reiche eine Trace-ID durch die App, das Gateway, das Backend und abhängige Services weiter.
- Fehler-Kontext: Fügen Sie nach Bedarf App-Version, Bundle-Version, Channel, Betriebssystem-Version, Gerätetyp und Fehlerkategorie hinzu.
- Business-Aktionen: Verknüpfe technische Requests mit aussagekräftigen Events wie dem Login-Abschluss oder einem Checkout-Fehler.
Nutze strukturierte Logs statt reiner Textwüsten für Menschen. Konsistente Felder ermöglichen effizientes Filtern. Halte sensible Daten aus der Telemetrie fern und definiere Retention-Regeln, bevor die Datenmenge explodiert.
Die Trace-Vollständigkeit ist ein wichtiger Benchmark. Sie gibt an, welcher Anteil der Requests anhand von Distributed-Tracing-Daten lückenlos rekonstruiert werden kann. Die Forschung zur Observability-Evaluierung nennt zudem Latenz bei der Fehlererkennung, Resource-Overhead, False-Positive- und False-Negative-Raten sowie Kosten als wichtige Metriken, wie in dieser Umfrage zur Observability-Evaluierung.
Diagnosetiefe gegen Overhead abwägen
Mehr Telemetrie ist nicht automatisch besser. Das Sammeln verbraucht CPU, RAM, Bandbreite und Speicher, besonders auf Mobile-Geräten oder bei High-Volume-Services. Sampling hilft bei der Volumenkontrolle, aber wähle gezielt aus. Speichere detaillierte Traces für Fehler, ungewöhnliche Latenzen, Rollout-Kohorten und kritische Workflows, während du für Trends auf kostengünstige Metriken setzt.
Das nützliche Signal ist die kleinste Menge an Informationen, die es einem Responder ermöglicht, die nächste richtige Entscheidung zu treffen.
Analysiere die Daten nach einem Incident. Wenn ein Feld nie abgefragt wurde, entferne es oder ändere seinen Zweck. Wenn Engineers das Problem immer noch manuell reproduzieren mussten, füge den fehlenden Kontext hinzu, anstatt einfach alle Log-Level hochzuschrauben.
Für Capacitor Teams ein gezielter Guide zum Performance-Monitoring-Setup kann dabei helfen, diese Prinzipien in clientseitiges Instrumentation zu übersetzen. Beginne mit einem kritischen User Journey, definiere das normale Verhalten und erweitere die Abdeckung, sobald das Team lernt, welche Fragen immer wieder auftauchen.
Observability in Aktion für Capacitor Electron und Capgo Live Updates
Ein Capacitor oder Electron-Team muss eventuell JavaScript, CSS, Copy, Konfigurationen oder Web-Assets korrigieren, während Nutzer die installierten Apps bereits verwenden. Ein Live-Update-Lifecycle schafft seinen eigenen beobachtbaren Pfad: Ein Gerät sucht nach einem Update, erhält ein Bundle von einem Channel, verifiziert es, aktiviert es und meldet das Ergebnis.
Stell dir ein Team vor, das einen JavaScript-Fix vorbereitet. Es veröffentlicht das Bundle in einem Staging- oder Beta-Channel und weist es einer kontrollierten Zielgruppe zu. Adoption-Metriken zeigen, ob die Geräte das Release erhalten. Failure-Metriken zeigen, ob Downloads, die Verifizierung oder die Aktivierung fehlschlagen. Die Versionshistorie identifiziert, welches Bundle jedes Gerät ausführen sollte.
Das Team stößt dann auf ein gerätespezifisches Problem. Per-Device-Logs zeigen, dass die betroffene Installation das Bundle zwar heruntergeladen, aber die Verifizierung nicht bestanden hat. Die Engineers können die aktuelle Version, den Channel und die Update-Historie des Geräts mit erfolgreichen Installationen vergleichen, anstatt das Problem als allgemeinen Ausfall zu behandeln.
Rollouts brauchen Guardrails
Ein sicheres Rollout folgt demselben Muster aus Erkennen, Lokalisieren und Erklären:
- Metriken sagen (Tell) ob sich Adoption und Failure-Verhalten geändert haben.
- Per-Device-Records lokalisieren (Locate) die betroffene Kohorte oder Installation.
- Logs erklären (Explain) den fehlgeschlagenen Download, Checksummen-, Aktivierungs- oder Runtime-Event.
- Channel-Kontrolllimit den Blast Radius, während das Team ermittelt.
- Rollback-Protection stellt wieder her das letzte funktionierende Bundle wieder her, wenn das neue Release unsicher ist.
Dieser Workflow gilt sowohl für Electron als auch für mobile Apps. Desktop-Nutzer haben oft unterschiedliche Betriebssysteme, Berechtigungen, Netzwerkbedingungen und installierte Versionen. Eine Release-Ansicht, die das exakte aktive Bundle identifiziert, liefert Support und Engineering eine gemeinsame Antwort auf die Frage: „Was genau nutzt dieser User gerade?“
Teams können zudem Produkt-Events parallel zu Update-Events tracken. Das Capgo Custom Event Tracking Plugin unterstützt das Prinzip, dass Release-Telemetrie wertvoller wird, wenn sie Deployment-Status mit App-Verhalten verknüpft. Die Plattform bietet pro Gerät Logs, Adoption- und Failure-Metriken, die Versionshistorie, gezielte Channels und automatischen Rollback-Schutz für JavaScript-Updates.
Beginne mit einem Production-Channel und einem kritischen User Journey. Definiere Rollout-Signale, füge konsistenten Versions- und Device-Kontext hinzu, teste den Rollback vor einem Incident und bestimme eine verantwortliche Person für die Analyse der Daten nach jedem Release.
Capgo bietet Live Updates für CapacitorJS- und Electron-Apps mit gezielten Channels, Release-Visibility pro Gerät, Adoption- und Failure-Metriken, Versionshistorie und Rollback-Protection. Nutze diese Release-Observability, um Änderungen mit der User Experience zu verknüpfen. Besuche dann Capgo um es für deinen nächsten Update-Workflow zu bewerten.





