
L'observabilité est la capacité à inférer l'état interne d'un système à partir de sorties externes en corrélant les journaux, les métriques et les traces. pourquoi quelque chose a échoué, et non que cela a échoué.
Votre mise à jour mobile a tout juste atteint la production. Un avertissement indique que le service d'actualisation est en bonne santé, le tableau de bord API est vert, et le taux d'erreur semble normal. Puis le support rapporte que les utilisateurs sur un modèle de téléphone sont bloqués sur une ancienne version, tandis qu'un autre groupe voit une page blanche après le lancement. Vous pouvez voir les symptômes, mais pas la voie qui les a produits.
C'est la différence entre savoir que quelque chose a cassé et être capable d'en expliquer la raison. Une métrique peut montrer que les téléchargements ont ralenti. Une trace peut révéler si le retard est venu du client, du service d'actualisation ou de API. Un journal peut exposer la différence de checksum, le bundle rejeté ou l'exception JavaScript qui a causé l'échec.
Les applications modernes rendent ce contexte plus difficile à conserver. Une application Capacitor peut impliquer un code natif code, une couche web, des APIs distantes, une authentification, des analyses, un service d'actualisation en temps réel et une version particulière de l'appareil ou du système d'exploitation. Une application Electron ajoute son propre runtime et ses différences d'environnement. Lorsqu'une mise à jour change rapidement, les avertissements préétablis ne peuvent rarement anticiper tous les modes d'échec.
La visibilité donne aux ingénieurs un moyen d'enquêter sur ces situations inconnues sans deviner. Elle aide les équipes à diagnostiquer les incidents plus rapidement, à livrer des mises à jour avec des preuves plus claires, et à relier le comportement technique à l'expérience des utilisateurs. Les exemples ci-dessous construisent à partir de la définition et des trois piliers classiques à une mise en œuvre pratique, à une valeur commerciale et à des mises à jour en direct pour Capacitor et les applications Electron.
Table des matières
- Ce que signifie vraiment la visibilité dans les systèmes logiciels
- Les trois piliers qui rendent les systèmes observables
- Observabilité contre Suivi et Comment Ils Travailent Ensemble
- Pourquoi la visibilité est maintenant une capacité commerciale
- Modèles de mise en œuvre, bonnes pratiques et compromis
- L'observabilité en action pour Capacitor Electron et Capgo Mises à jour en direct
Ce que signifie vraiment l'observabilité dans les systèmes logiciels
Le mot observabilité est né en dehors du logiciel. Dans les années 1960, Rudolf Kálmán l'a utilisé en théorie de contrôle pour décrire comment bien un ingénieur pouvait inférer l'état interne d'un système à partir de ses sorties, comme documenté dans cette histoire de l'observabilitéL'idée est ensuite entrée dans la pratique du logiciel à travers le travail sur les systèmes distribués, notamment un travail largement cité 2013 blog d'ingénierie Twitter La description d'une "pile d'observabilité." Le modèl’à trois piliers des journaux, des métriques et des traces est devenu standard dans 2018selon la même référence.
Un tableau de bord de voiture offre une comparaison utile. Le compteur de vitesse vous indique à quel rythme vous vous déplacez, l'indicateur de carburant montre le carburant restant, et une lumière d'avertissement signale une condition connue. C'est une surveillance utile. Un système de diagnostic de moteur va plus loin. Il combine les lectures de capteurs et les enregistrements d'erreurs pour aider à expliquer pourquoi le moteur est en panne.
La visibilité logicielle fonctionne de la même manière. Cela ne signifie pas collecter tous les enregistrements possibles sans but. Cela signifie produire suffisamment d'évidence connectée pour que l'ingénieur puisse inférer ce que l'application fait à l'intérieur, même lorsque l'application est répartie sur plusieurs services, appareils et environnements d'exécution.
Why outputs matter in distributed applications
Vous ne pouvez souvent pas mettre en pause un système de production et passer en revue chaque ligne de code. Les requêtes se déplacent entre les composants, les conteneurs changent, les utilisateurs exécutent différentes versions, et les erreurs peuvent disparaître avant que vous puissiez les reproduire localement. Les sorties externes deviennent votre preuve.
Une application native cloud a généralement plusieurs parties interdépendantes, donc comprendre son architecture fournit un contexte essentiel. Un exemple pratique guide à l'architecture cloud-native pour SaaS Puisque les équipes peuvent raisonner sur ces dépendances avant de décider quoi instrumenter.
Pour une application Capacitor, les sorties utiles pourraient inclure :
- Événements du client, comme lancement d'applications, téléchargement de bundles, vérification, activation et annulation.
- Mesures de performancedes performances au démarrage, des temps de requête, des mises à jour échouées et des comptes de crash.
- Traces distribuées, connecter une action utilisateur à l'application, l’API gateway, le service backend et la base de données.
- Journaux structurésportant le dispositif, la version de l'application, le canal, l'ID de transaction et le contexte d'erreur.
La propriété est la corrélation. Un identifiant de dispositif ou un ID de trace peut relier une tentative d'actualisation, son résultat de téléchargement et l'erreur de runtime qui a suivi. Sans cette relation, chaque tableau de bord montre seulement un fragment.
Pour une perspective mobile spécifique, Capgo’s guide d'observabilité d'application mobile Analyse comment l'application telemetry peut soutenir le diagnostic des lancements. Le principe plus large reste simple : Les systèmes observables vous permettent de poser de nouvelles questions sur le comportement en utilisant des preuves déjà capturées.
Les Trois Piliers Qui Font Les Systèmes Observables
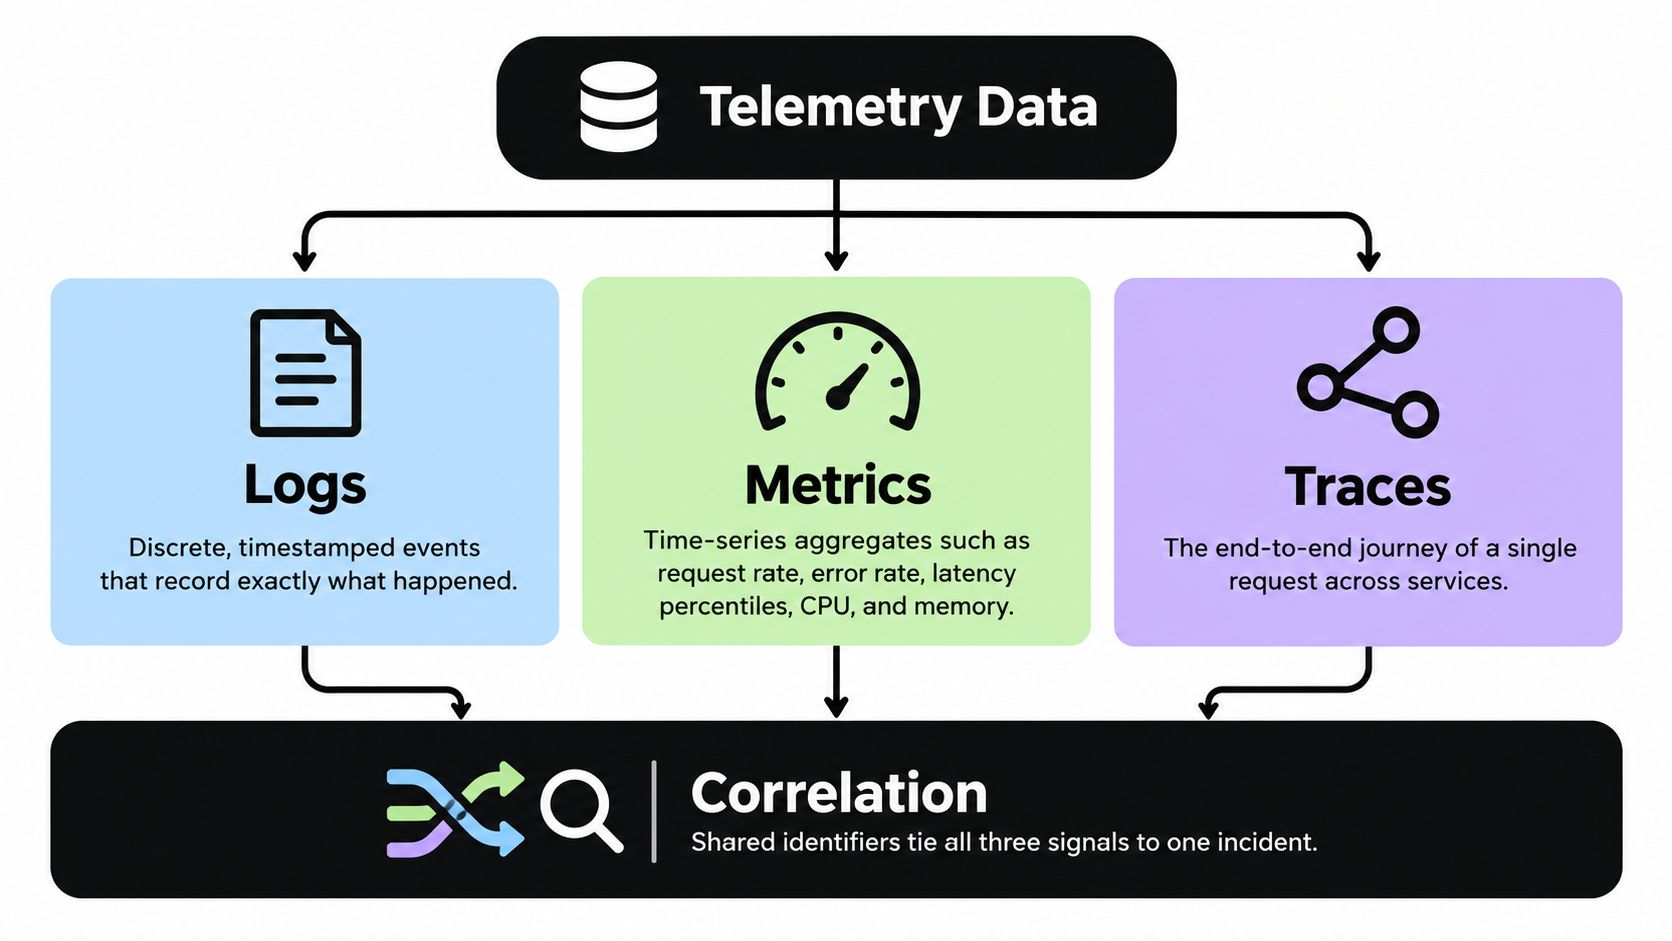
Les journaux, les métriques et les traces ont des formes différentes et répondent à des questions différentes. L'observabilité devient utile lorsque les ingénieurs les corréleraient autour de la même demande, de la même mise à jour, du même parcours utilisateur ou du même appareil.
Métriques sont des agrégats de séries temporelles. Exemples incluent le taux de requêtes, le taux d'erreurs, les déciles de latence, le CPU et la mémoire. Ils compressent de nombreux événements en une valeur facile à afficher et à alerter. Une métrique pourrait vous dire que les échecs d'activation de bundle ont augmenté après un déploiement, mais elle ne vous identifiera pas l'appareil ou l'exception exacts.
Traces reconstituent le chemin end-to-end d'une demande à travers les services. Chaque partie de ce chemin est représentée par une span. Si une mise à jour passe par une application, un service Edge, un niveau d'authentification, un service de stockage et API, la trace montre où le temps s'est accumulé ou où la demande a échoué.
Journaux provide event-level detail. They can contain a stack trace, transaction ID, response code, bundle version, or validation result. Logs explain the local circumstances that metrics summarize and traces locate.
Règle pratique : Les métriques vous disent qu'un problème existe, les traces montrent où il se produit, et les journaux expliquent pourquoi il s'est produit.
Considérez une erreur de mise à jour en temps réel. Une métrique signale que les erreurs de vérification de mise à jour ont augmenté. Une trace suit une requête échouée et montre que le bundle a atteint le dispositif, mais l'étape de vérification a échoué. Les journaux correspondants enregistrent le résultat du checksum et identifient la version du bundle. Ensemble, ces signaux restituent le contexte d'exécution qui ne peut pas être fourni par la surveillance isolée.
La corrélation est le mécanisme de travail
La corrélation nécessite des identifiants partagés et des attributs cohérents. Un ID de trace devrait voyager à travers les limites de service. Les journaux devraient inclure cet ID là où possible. Les métriques devraient supporter des dimensions qui aident les ingénieurs à réduire la version de mise en production, le canal, la famille de dispositifs ou la version de l'application sans produire un nombre unique de séries temporelles gérables.
La même approche fonctionne du côté client. Supposons que l'utilisateur appuie sur une fonctionnalité et voit un temps d'attente. Le client peut enregistrer l'action et la version de l'application, la trace peut suivre la requête réseau, et le journal de serveur peut montrer si la requête a échoué à l'authentification ou à la récupération de données. Les ingénieurs n'ont pas besoin d'inférer l'ensemble de l'histoire à partir d'un seul message d'erreur.
Les équipes travaillant avec de grandes volumes de journaux peuvent utiliser des champs structurés et des outils de requête plutôt que de se fier uniquement à la recherche de texte libre. Capgo Les outils d'analyse de journaux de __CAPGO_KEEP_0__ fournit un contexte pertinent pour rendre les journaux plus utiles lors de l'enquête.
Les trois piliers ne sont pas des produits concurrents. Ils forment une chaîne cause-à-effet. Les métriques fournissent le signal large, les traces réduisent la zone de recherche et les journaux fournissent les preuves détaillées nécessaires pour une correction.
Observabilité versus Suivi et Comment Ils S'entraînent Mutuellement
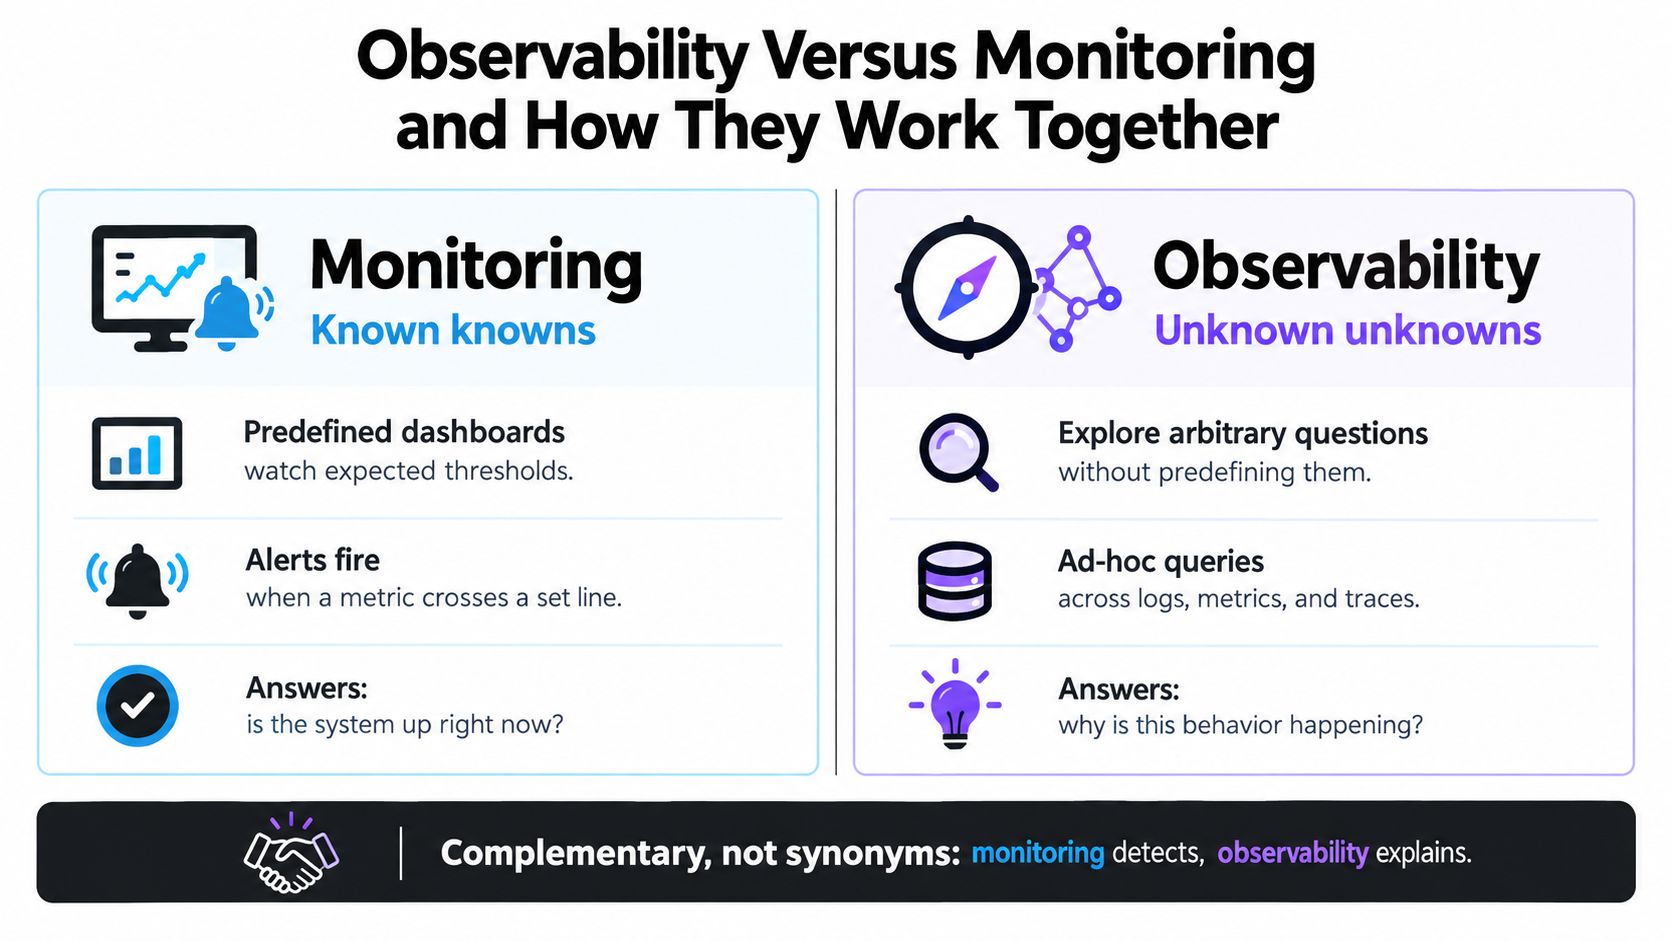
Le suivi et l'observabilité se soutiennent mutuellement, mais ils ne sont pas des synonymes. Le suivi surveille les conditions que vous avez déjà décidées être importantes. L'observabilité vous donne suffisamment de données connectées pour explorer le comportement que vous n'aviez pas anticipé.
Une règle de suivi pourrait avertir lorsque la latence API franchit un seuil ou lorsque les échecs d'actualisation dépassent un niveau attendu. Cet avertissement est précieux car il déclenche la réponse. Il ne vous dit pas nécessairement si la cause est une régression de l'arrière-plan, un paquet mauvais, un problème de livraison régional ou un problème spécifique au runtime du dispositif.
| Capacité | Suivi | Observabilité |
|---|---|---|
| Objectif | Surveiller les indicateurs de santé connus | Investiguer le comportement du système et les échecs inconnus |
| Type de question | ‘Est-ce que ce seuil est dépassé ?’ | “Pourquoi se produit ce comportement ?” |
| Approche de données | Tableaux de bord et alertes prédéfinis | Journaux, métriques, traces et contexte corrélés |
| Mode de panne | Conditions manquantes que personne n'a configurées | Devenu coûteux ou bruyant sans instrumentation utile |
Utilisez les deux dans le cycle d'incident
Un modèle d'exploitation sain est simple :
- La surveillance détecte le signal. Une alerte identifie une latence anormale, un taux d'erreur, une activité de crash ou une échec d'actualisation.
- L'observabilité encadre l'incident. Les ingénieurs filtrent par version, canal, appareil, plateforme, région ou parcours utilisateur.
- Les traces localisent la faille. Le chemin de requête révèle le composant ou l'élément où le comportement a changé.
- Les journaux expliquent la condition. Enregistrements détaillés montrent l'exception, le résultat de validation, la réponse de dépendance ou la configuration impliquée.
- L'équipe vérifie le résultat. Les métriques confirment si la correction a restauré le comportement normal.
La surveillance seule peut fonctionner bien pour des conditions stables et prévisibles. L'observabilité devient plus importante lorsque les systèmes changent souvent, lorsque les erreurs franchissent les limites de service ou lorsque les utilisateurs exécutent de nombreuses combinaisons de versions et d'appareils.
Un équipe mobile pourrait surveiller les sessions sans crash et l'adoption de mise à jour. Lorsqu'un avertissement se déclenche, l'observabilité permet à l'équipe de demander si le problème affecte un seul canal, une version d'application particulière ou une classe d'appareil. Cette investigation est la différence entre suspendre chaque mise à jour et prendre une action corrective ciblée.
Capgo’s surveillance de l'état de l'application est pertinent à cette distinction car les signaux de santé deviennent plus utiles lorsque les équipes peuvent les connecter au contexte de la mise en production et du matériel. L'outil ne remplace pas le suivi général de l'infrastructure. Il ajoute des preuves opérationnelles autour du cycle de vie de l'application.
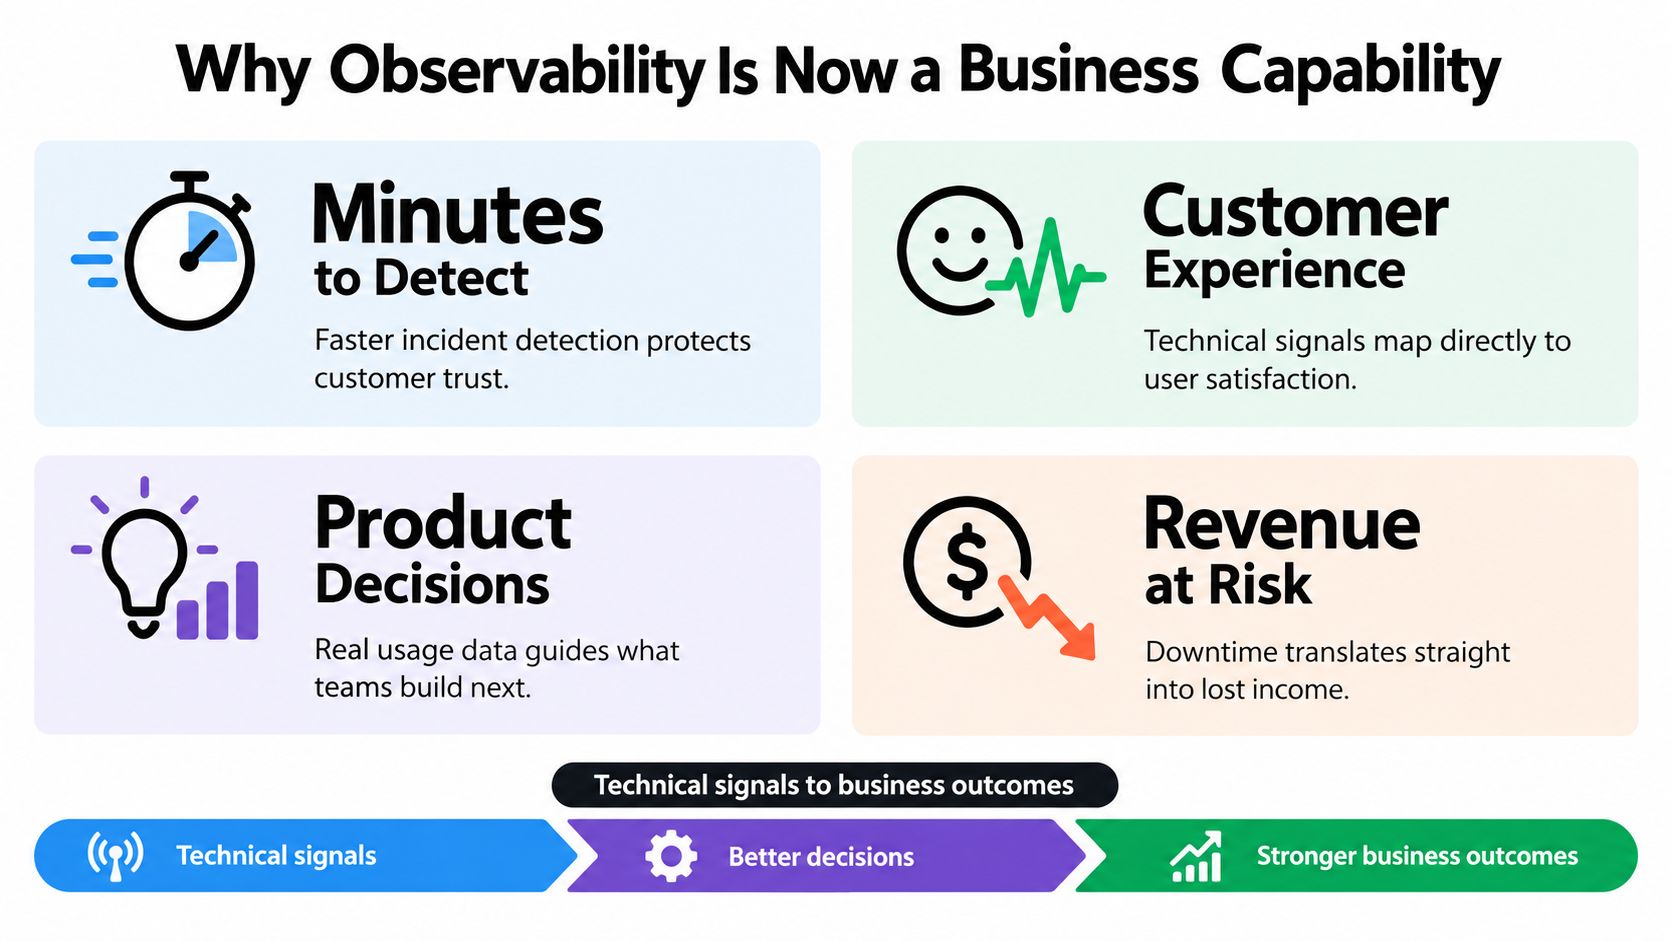
Pourquoi l'observabilité est devenue une capacité métier
Un tableau de bord d'ingénierie devient un outil commercial lorsque ses signaux se connectent à l'expérience du client et aux résultats du produit. Un taux d'erreur en hausse compte car il peut empêcher un utilisateur de terminer une commande, de s'inscrire, d'envoyer un message ou d'utiliser une nouvelle fonctionnalité.
Cette connexion nécessite un design délibéré. Les équipes doivent associer les événements techniques à un contexte commercial significatif, tout en respectant la vie privée et en évitant les données personnelles inutiles. Une vue de la santé de la mise en production pourrait combiner l'état d'adoption, les requêtes échouées, la fin de parcours utilisateur et les rapports de support. Les responsables de produit peuvent alors voir si une fonctionnalité fonctionne pour le public visé, et non simplement si le service répond.
Preuves au-delà de la réponse aux incidents
Splunk a signalé en 2025 que 74% de répondants ont considéré l'observabilité comme essentielle pour surveiller les processus commerciaux critiques et 65% ont affirmé que c'était clé pour comprendre les parcours utilisateur, comme le décrit son État de l'observabilité 2025 Ces constats suggèrent un rôle plus large. L'observabilité aide les équipes à relier le comportement du système aux processus sur lesquels les clients et les employés dépendent.
New Relic a rapporté que 68% de nombreuses organisations ont constaté une amélioration du temps moyen de détection après avoir adopté l'observabilité. 2025 rapport, disponible dans ce annonce de New Relic. Une détection plus rapide est utile opérationnellement, mais la valeur commerciale apparaît lorsque les équipes peuvent montrer ce que l'incident détecté a affecté et si la réponse a modifié ce résultat.
Diverses équipes utilisent la même preuve de manière différente :
- Les équipes de support peuvent déterminer si une plainte est isolée à un appareil, une version ou un canal de lancement.
- Les équipes de produits can compare feature behavior across release cohorts and prioritize work using real usage signals.
- Les équipes d'ingénierie peuvent relier un symptôme face aux clients à un service, une demande ou un événement client spécifique.
- Les équipes de direction Peut évaluer le risque opérationnel en termes de parcours critiques plutôt que de l'état de l'infrastructure abstraite.
Un déploiement de mise à jour en temps réel illustre la chaîne. Si l'adoption augmente mais qu'un sous-ensemble d'utilisateurs échoue à l'activation, la question commerciale pertinente n'est pas de savoir si l'endpoint de mise à jour est disponible. C'est savoir si les utilisateurs affectés peuvent terminer la tâche pour laquelle la mise à jour était censée améliorer. L'observabilité fournit les preuves nécessaires pour répondre à cette question et décider de continuer, de suspendre ou de rembobiner le déploiement.
Modèles d'implémentation, Bonnes pratiques et compromis
Une bonne observabilité commence par des questions, pas par des tableaux de bord. Avant d'ajouter des instruments, écrivez les décisions que les données doivent soutenir. Pour une mise à jour mobile, ces questions pourraient inclure : le dispositif a-t-il téléchargé le bundle, a-t-il passé la vérification, a-t-il terminé l'activation et a-t-il fonctionné correctement l'application mise à jour ultérieurement ?
Suivez le chemin réel emprunté par les utilisateurs
Commencez par les limites et les résultats :
- Cycle de vie du client : Enregistrement de lancement, vérification de mise à jour, téléchargement, vérification, activation et annulation d'événements.
- Liaisons de service : Propagez un ID de trace à travers l'application, le gateway, le backend et les services dépendants.
- Contexte d'erreur : Incluez la version de l'application, la version du bundle, le canal, la version du système d'exploitation, la classe de périphérique et la catégorie d'erreur selon les besoins.
- Actions commerciaux : Reliez les demandes techniques aux événements sûrs et significatifs comme la connexion ou l'erreur de paiement.
Utiliser des journaux structurés au lieu de paragraphes destinés uniquement à la lecture humaine. Les champs cohérents permettent le filtrage. Éviter les informations sensibles dans la télémétrie et définir les règles de conservation avant la collecte.
La complétude des traces est un bon indicateur. Cela signifie la fraction des demandes totales qui peuvent être reconstruites de bout en bout à partir des données de suivi distribué. La recherche sur l'évaluation de l'observabilité identifie également la latence de détection des fautes, l'overhead des ressources, les taux de faux positifs et faux négatifs, et les coûts comme des mesures importantes, comme discuté dans ce sondage d'évaluation de l'observabilité.
Équilibrer la profondeur diagnostique avec l'overhead
Plus de télémétrie n'est pas automatiquement mieux. La collecte peut consommer de la CPU, de la mémoire, de la bande passante et de l'espace de stockage, en particulier sur les appareils mobiles ou les services à haut volume. L'échantillonnage aide à contrôler le volume, mais échantillonner avec intention. Conserver les traces détaillées pour les erreurs, les latences anormales, les cohortes de déploiement et les flux de travail importants, tout en conservant des métriques plus larges et à faible coût pour la visibilité des tendances.
Le signal utile est l'ensemble minimal d'évidence qui permet à un répondant de prendre la décision correcte suivante.
Réviser les données après un incident. Si personne n'a interrogé un champ, le supprimer ou changer son but. Si les ingénieurs ont toujours besoin de reproduire manuellement l'incident, ajouter le contexte manquant plutôt que d'augmenter chaque niveau de journal.
Pour les équipes Capacitor, un approche centrée sur performance monitoring setup guide peut aider à traduire ces principes en instrumentation côté client. Commencez par un voyage critique de l'utilisateur, établissez son comportement normal et étendez la couverture à mesure que l'équipe apprend les questions qui se répètent.
L'observabilité en action pour Capacitor Electron et Capgo Mises à jour en direct
Un Capacitor ou une équipe Electron peut avoir besoin de corriger JavaScript, CSS, le texte, la configuration ou les actifs web tout en continuant à faire fonctionner les applications installées. Un cycle de mise à jour en temps réel crée son propre chemin observable : un appareil vérifie une mise à jour, reçoit un paquet d'un canal, le vérifie, l'active et signale le résultat.
Considérez une équipe préparant une correction JavaScript. Elle publie le paquet dans un canal de pré-production ou de bêta, puis affecte un public contrôlé. Les indicateurs d'adoption montrent si les appareils reçoivent la mise en production. Les indicateurs de failure révèlent si les téléchargements, la vérification ou l'activation échouent. L'historique de version identifie le paquet que chaque appareil doit exécuter.
L'équipe trouve ensuite un problème spécifique à un appareil. Les journaux par appareil montrent que l'installation affectée a téléchargé le paquet mais a échoué à la vérification. Les ingénieurs peuvent comparer la version actuelle de l'appareil, le canal et l'historique de mise à jour avec les installations réussies au lieu de traiter le problème comme une panne générale.
Les déploiements nécessitent des garde-fous
Un déploiement sécurisé utilise le même modèle de dire, localiser, expliquer :
- Les indicateurs disent si le comportement d'adoption et d'échec a changé.
- Les enregistrements par appareil localisent le groupe ou l'installation affecté.
- Les journaux expliquent le téléchargement échoué, le checksum, l'activation ou l'événement de runtime.
- les contrôles de canal limitent le rayon d'explosion pendant que l'équipe enquête.
- La protection de reversion restaure le bundle précédent fonctionnel lorsqu'une nouvelle version est dangereuse.
Cette workflow compte également pour les applications Electron ainsi que pour les applications mobiles. Les utilisateurs de bureau peuvent avoir des environnements d'exploitation système différents, des permissions, des conditions de réseau et des versions installées. Une vue de la version qui identifie l'emballage actif exact donne à l'assistance et à l'ingénierie une réponse partagée à « Quel est l'utilisateur qui exécute cela ? »
Teams can also instrument product events alongside update events. Capgo’s plugin de suivi d'événements personnalisé soutient le principe plus large selon lequel la telemétrie de la version devient plus précieuse lorsqu'elle relie l'état de déploiement avec le comportement de l'application. La plateforme peut fournir des journaux par appareil, des métriques d'adoption et de failure, une histoire de version, des canaux ciblés et une protection de reversion automatique pour les mises à jour JavaScript.
Commencez par un canal de production et un parcours critique. Définissez les signaux de lancement, attachez une version cohérente et un contexte de dispositif, testez la reversion avant un incident, et faites quelqu'un responsable de la revue des preuves après chaque mise à jour.
Capgo fournit des mises à jour en direct pour les applications CapacitorJS et Electron, avec des canaux ciblés, une visibilité de version par appareil, des métriques d'adoption et de failure, une histoire de version et une protection de reversion. Utilisez cette observabilité de version pour relier ce qui a changé avec ce que les utilisateurs expérimentent, puis visitez Capgo pour l'évaluer pour votre flux de mise à jour suivant.





