
La observabilidad es la capacidad de inferir el estado interno de un sistema a partir de salidas externas correlacionando registros, métricas y trazas. Responde por qué algo fallóy no solo que no funcionó.
Su lanzamiento móvil ha llegado a producción. Un alerta dice que el servicio de actualización es saludable, el panel de API está verde y la tasa de errores parece normal. Luego, el soporte informa que los usuarios de un modelo de dispositivo están atascados en una versión anterior, mientras que otro grupo ve una pantalla en blanco después del arranque. Puede ver los síntomas, pero no el camino que los produjo.
Eso es la diferencia entre saber que algo se rompió y poder explicarlo. Una métrica puede mostrar que las descargas se ralentizaron. Una traza puede revelar si el retraso vino del cliente, el servicio de actualización o API. Un registro puede exponer el error de suma de comprobación, el paquete rechazado o la excepción de JavaScript que causó el fallo.
Las aplicaciones modernas hacen que este contexto sea más difícil de preservar. Una aplicación Capacitor puede involucrar código nativo code, una capa web, APIs remotos, autenticación, análisis, un servicio de actualización en vivo y una versión particular de dispositivo o sistema operativo. Una aplicación de Electron agrega su propio entorno de tiempo de ejecución de escritorio y diferencias de entorno. Cuando una versión cambia rápidamente, los alertas predefinidos rara vez anticipan todos los modos de fallo.
La observabilidad da a los ingenieros una forma de investigar esas situaciones desconocidas sin adivinar. Ayuda a los equipos a diagnosticar incidentes más rápido, enviar cambios con evidencia más clara y conectar el comportamiento técnico con la experiencia de los usuarios. Los ejemplos a continuación construyen a partir de la definición y los tres pilares clásicos a una implementación práctica, valor empresarial y actualizaciones en vivo para Capacitor y aplicaciones de Electron.
Contenido de la Tabla
- ¿Qué significa realmente la Observabilidad en Sistemas de Software?
- Los Tres Pilares que Hacen que los Sistemas sean Observables
- Observabilidad Versus Monitoreo y Cómo Funcionan Juntos
- ¿Por qué la Observabilidad es Ahora una Capacidad Empresarial?
- Patrones de Implementación, Buenas Prácticas y Compromisos
- Observabilidad en Acción para Capacitor Electron y Capgo Actualizaciones en Vivo
¿Qué significa realmente la Observabilidad en Sistemas de Software?
La palabra observabilidad comenzó fuera de software. En la 1960s, Rudolf Kálmán la utilizó en teoría de control para describir hasta qué punto un ingeniero podía inferir el estado interno de un sistema a partir de sus salidas, como se documenta en esta historia de observabilidadLa idea más tarde entró en la práctica de software a través del trabajo en sistemas distribuidos, incluido un trabajo ampliamente citado 2013 blog de ingeniería de Twitter El modelo de tres pilares de registros, métricas y trazas se convirtió en estándar en 2018según la misma referencia.
Una pantalla de instrumentos de un automóvil ofrece una comparación útil. El velocímetro te dice cuán rápido estás moviéndote, el indicador de combustible muestra el combustible restante, y una luz de advertencia señala una condición conocida. Eso es una buena monitorización. Un sistema de diagnóstico de motor va más allá. Combina lecturas de sensores y registros de errores para ayudar a explicar por qué el motor está fallando.
La observabilidad de software funciona de la misma manera. No significa recopilar cada posible registro sin propósito. Significa producir suficiente evidencia conectada para que un ingeniero pueda inferir qué está haciendo la aplicación internamente, incluso cuando la aplicación está distribuida entre servicios, dispositivos y runtimes.
Por qué los resultados importan en aplicaciones distribuidas
Muchas veces no puedes pausar un sistema de producción y pasar por cada línea de code. Las solicitudes se mueven entre componentes, los contenedores cambian, los usuarios ejecutan versiones diferentes, y los errores pueden desaparecer antes de que los reproducas localmente. Los resultados externos se convierten en tu evidencia.
Una aplicación nativa de la nube suele tener varias partes interdependientes, por lo que comprender su arquitectura proporciona un contexto esencial. Una práctica para la arquitectura nativa de la nube para SaaS puede ayudar a los equipos a razonar sobre esas dependencias antes de decidir qué instrumentar.
Para una aplicación Capacitor, los resultados útiles podrían incluir:
- Eventos del clientecomo la carga de la aplicación, la descarga del paquete, la verificación, la activación y el deshacer.
- Métricas de rendimiento, como la latencia de arranque, la latencia de solicitud, actualizaciones fallidas y conteos de crash.
- Rastros distribuidos, que conectan una acción de usuario con la aplicación, el gateway API, el servicio de backend y la base de datos.
- Registros estructuradoscon el dispositivo, versión de la aplicación, canal, ID de transacción y contexto de error.
La propiedad es la correlación. Un identificador de dispositivo o un ID de rastro pueden conectar un intento de actualización, su resultado de descarga y el error de ejecución que siguió. Sin esa relación, cada panel de control muestra solo una parte.
Para una perspectiva específica de móviles, Capgo’s Guía de observabilidad de aplicaciones explora cómo la telemetría de aplicaciones puede apoyar el diagnóstico de lanzamientos. El principio más amplio sigue siendo simple: Los sistemas observables te permiten hacer nuevas preguntas sobre el comportamiento utilizando la evidencia ya capturada.
Los Tres Pilares Que Hacen a los Sistemas Observables
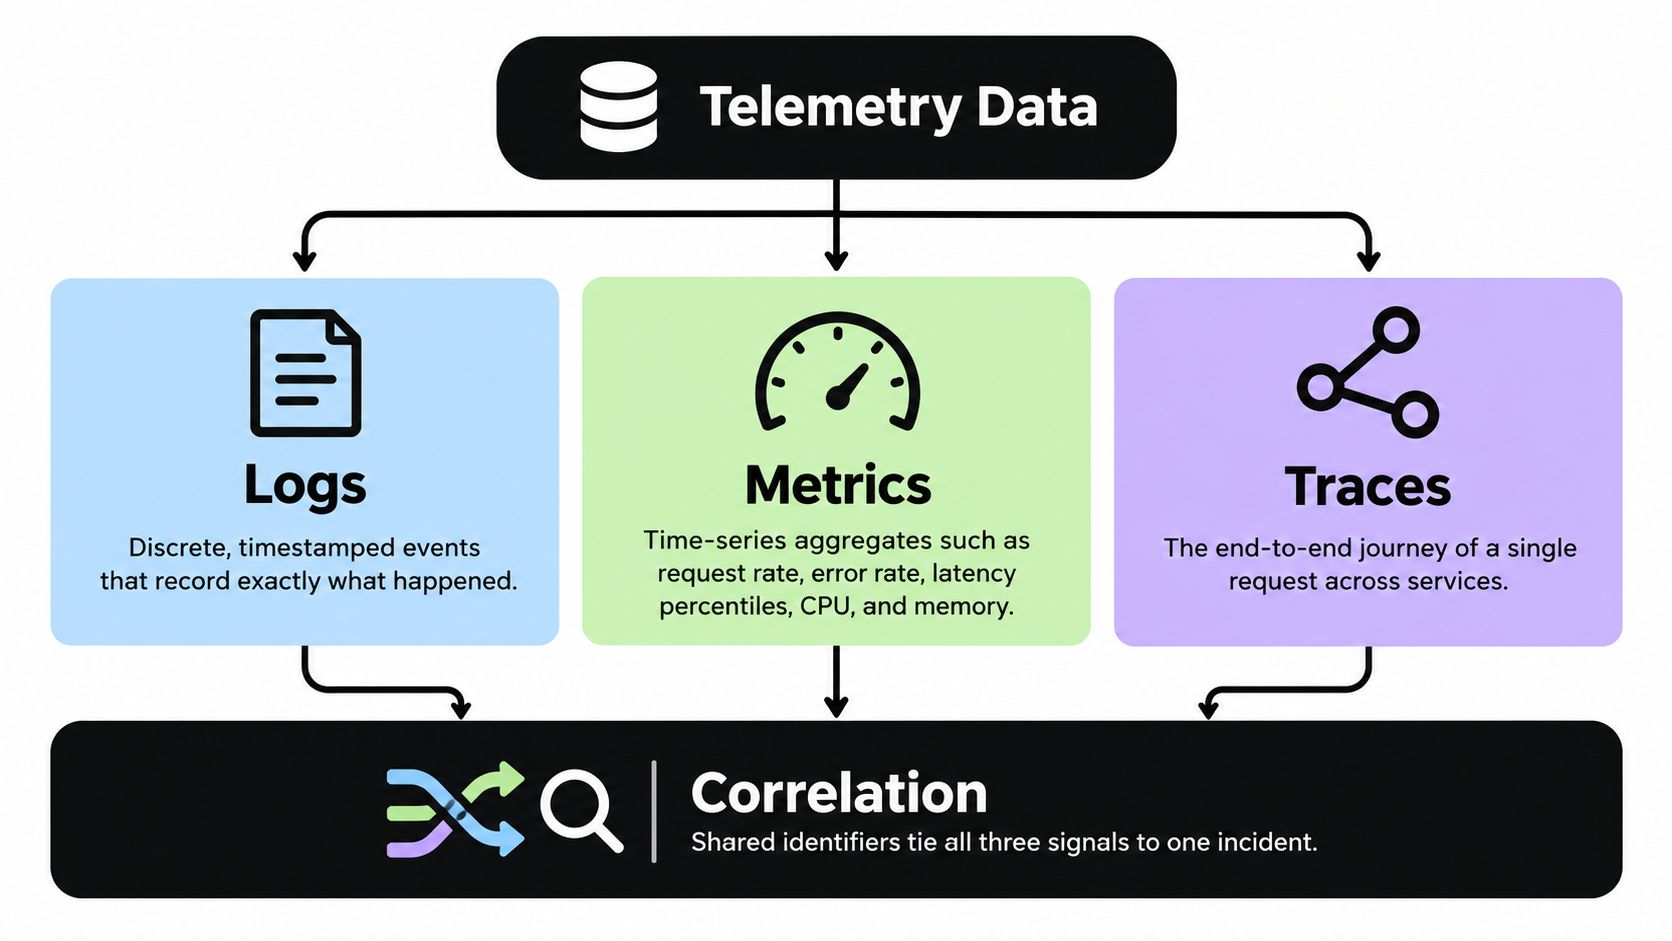
Los registros, las métricas y las trazas tienen formas diferentes y responden a preguntas diferentes. La observabilidad se vuelve útil cuando los ingenieros correlacionan entre sí alrededor de la misma solicitud, lanzamiento, recorrido del usuario o dispositivo.
Métricas son agregados de series temporales. Ejemplos incluyen la tasa de solicitudes, la tasa de errores, los percentiles de latencia, el CPU y la memoria. Comprimen muchos eventos en un valor que es fácil de graficar y alertar. Una métrica podría decir que los fallos de activación de paquetes aumentaron después de un despliegue, pero no identificará el dispositivo exacto o la excepción.
Trazas reconstruyen el camino end-to-end de una solicitud a través de servicios. Cada parte de ese camino se representa por una span. Si una solicitud de actualización pasa por una aplicación, un servicio de borde, un nivel de autenticación, un servicio de almacenamiento y API, la traza muestra dónde se acumuló el tiempo o dónde la solicitud falló.
Registros provide event-level detail. They can contain a stack trace, transaction ID, response code, bundle version, or validation result. Logs explain the local circumstances that metrics summarize and traces locate.
Regla práctica: Las métricas te dicen que existe un problema, las trazas muestran dónde ocurre y los registros explican por qué ocurrió.
Considera un error de actualización en vivo. Una métrica informa que los errores de verificación de actualización aumentaron. Una traza sigue una solicitud fallida y muestra que el paquete llegó al dispositivo, pero la verificación de la span falló. Los registros correspondientes registran el resultado del checksum y identifican la versión del paquete. Juntos, esos señales restauran el contexto de ejecución que la monitorización aislada no puede proporcionar.
La correlación es el mecanismo de trabajo
La correlación requiere identificadores compartidos y atributos consistentes. Un ID de traza debe viajar por límites de servicio. Los registros deben incluir ese ID donde sea posible. Las métricas deben apoyar dimensiones que ayuden a los ingenieros a reducir el lanzamiento afectado, el canal, la familia de dispositivos o la versión de la aplicación sin producir un número único de series temporales manejables.
El mismo enfoque funciona en el lado del cliente. Supongamos que un usuario presiona una función y ve un tiempo de espera. El cliente puede registrar la acción y la versión de la aplicación, la traza puede seguir la solicitud de red y el registro del servidor puede mostrar si la solicitud falló en la autenticación o la recuperación de datos. Los ingenieros no necesitan inferir toda la historia a partir de un mensaje de error único.
Teams working with large log volumes can use structured fields and query tools rather than relying on free-text searching alone. Capgo’s guián a los ingenieros proporcionan información relevante para hacer que los registros sean más útiles durante la investigación.
Los tres pilares no son productos competitivos. Forman una cadena causa-efecto. Las métricas proporcionan la señal general, las trazas reducen el área de búsqueda y los registros suministran la evidencia detallada necesaria para una solución.
Observabilidad Versus Monitoreo y Cómo Funcionan Juntos
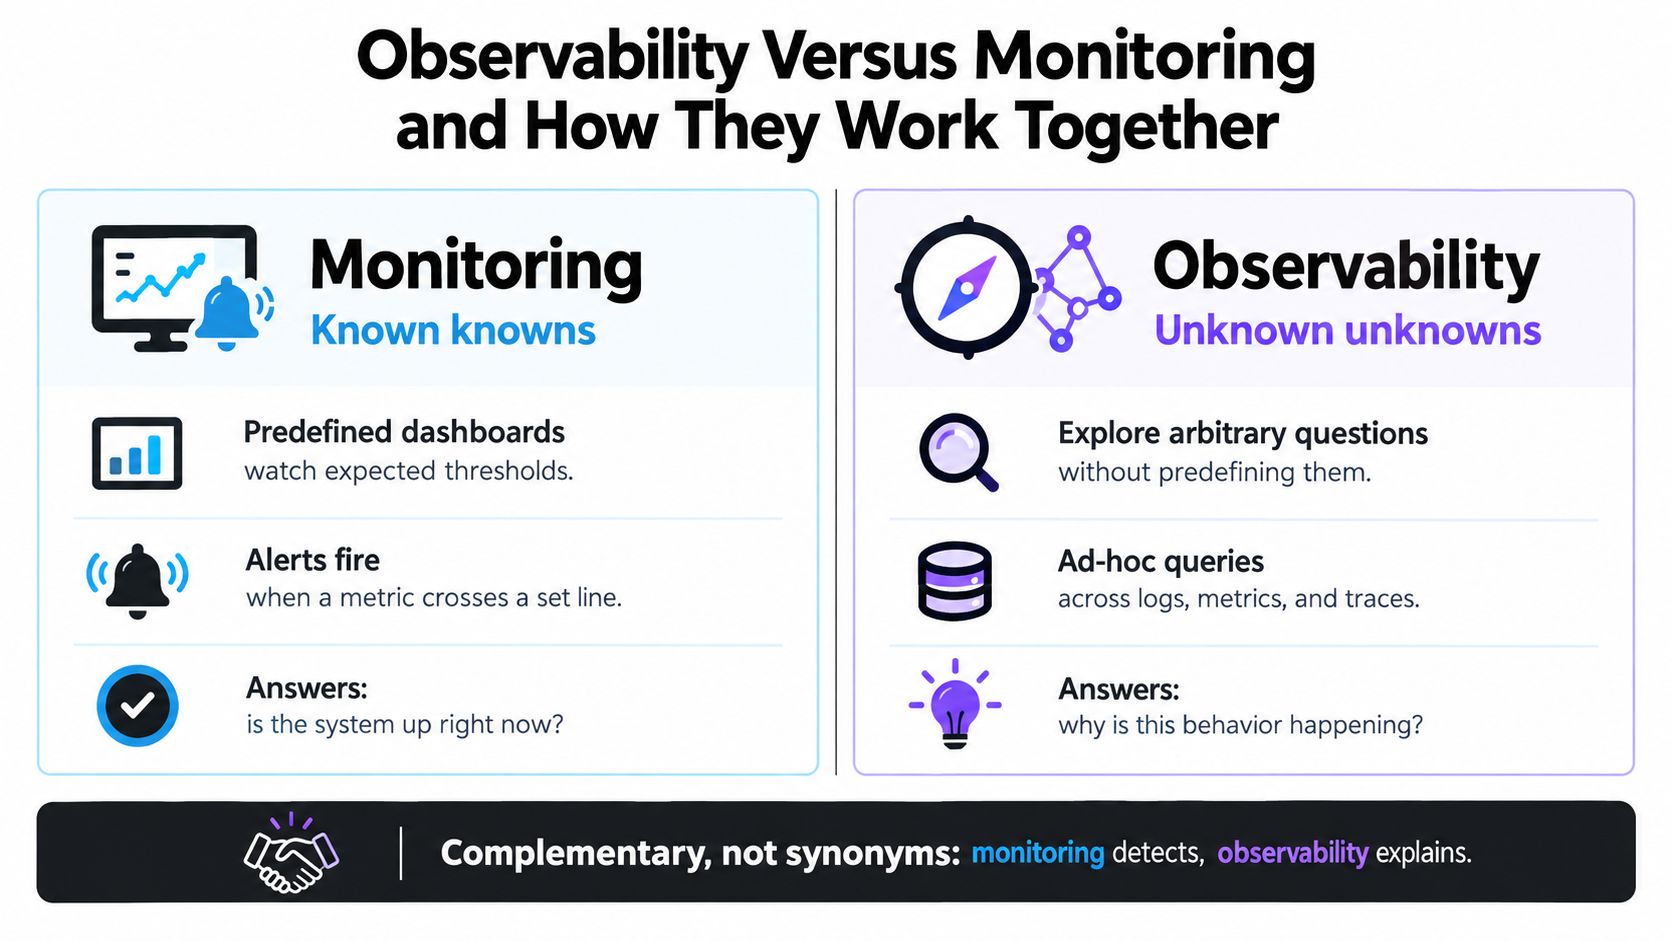
El monitoreo y la observabilidad se apoyan mutuamente, pero no son sinónimos. El monitoreo observa condiciones que ya has decidido que importan. La observabilidad te da suficiente datos conectados para explorar el comportamiento que no anticipaste.
Una regla de monitoreo podría alertar cuando API la latencia supere un umbral o cuando los errores de actualización excedan un nivel esperado. Esa alerta es valiosa porque inicia la respuesta. No necesariamente te dice si la causa es una regresión de backend, un paquete malo, un problema de entrega regional o un problema específico del dispositivo en tiempo de ejecución.
| Capacidad | Monitoreo | Observabilidad |
|---|---|---|
| Propósito | Ver indicadores de salud conocidos | Investigar el comportamiento del sistema y fallas inusuales |
| Tipo de pregunta | ¿Se está excediendo este umbral? | “¿Por qué está sucediendo este comportamiento?” |
| Enfoque de datos | Tableros y alertas predefinidos | Registros, métricas, trazas y contexto correlacionados |
| Modo de falla | Condiciones que nadie configuró | Se vuelve costoso o ruidoso sin instrumentación útil |
Usa ambos en el ciclo de incidentes
Un patrón de operación saludable es sencillo:
- La supervisión detecta el señal. Un alerta identifica una latencia inusual, una tasa de errores, actividad de bloqueo o falla de actualización.
- La observabilidad delinea el incidente. Ingenieros filtran por versión, canal, dispositivo, plataforma, región o recorrido del usuario.
- Las trazas localizan el fallo. El camino de la solicitud revela el componente o span donde cambió el comportamiento.
- Los registros explican la condición. Registros detallados muestran la excepción, el resultado de validación, la respuesta de dependencia o la configuración involucrada.
- El equipo verifica el resultado. Las métricas confirman si la corrección restauró el comportamiento normal.
La supervisión sola puede funcionar bien para condiciones estables y predecibles. La observabilidad se vuelve más importante cuando los sistemas cambian con frecuencia, cuando los fallos cruzan límites de servicio o cuando los usuarios ejecutan muchas combinaciones de versiones y dispositivos.
Un equipo móvil podría monitorear sesiones sin crash y la adopción de actualizaciones. Cuando dispara una alerta, la observabilidad permite al equipo preguntar si el problema afecta un solo canal, una versión de aplicación particular o una clase de dispositivos. Esa investigación es la diferencia entre pausar cada lanzamiento y tomar una acción correctiva dirigida.
Capgo’s monitoreo de salud de la aplicación es relevante para esta distinción porque los señales de salud se vuelven más útiles cuando los equipos pueden conectarlas al contexto de liberación y dispositivo. La herramienta no reemplaza la supervisión de la infraestructura general. Agrega evidencia operativa al ciclo de vida de la aplicación.
¿Por qué la Observabilidad es ahora una Capacidad Empresarial
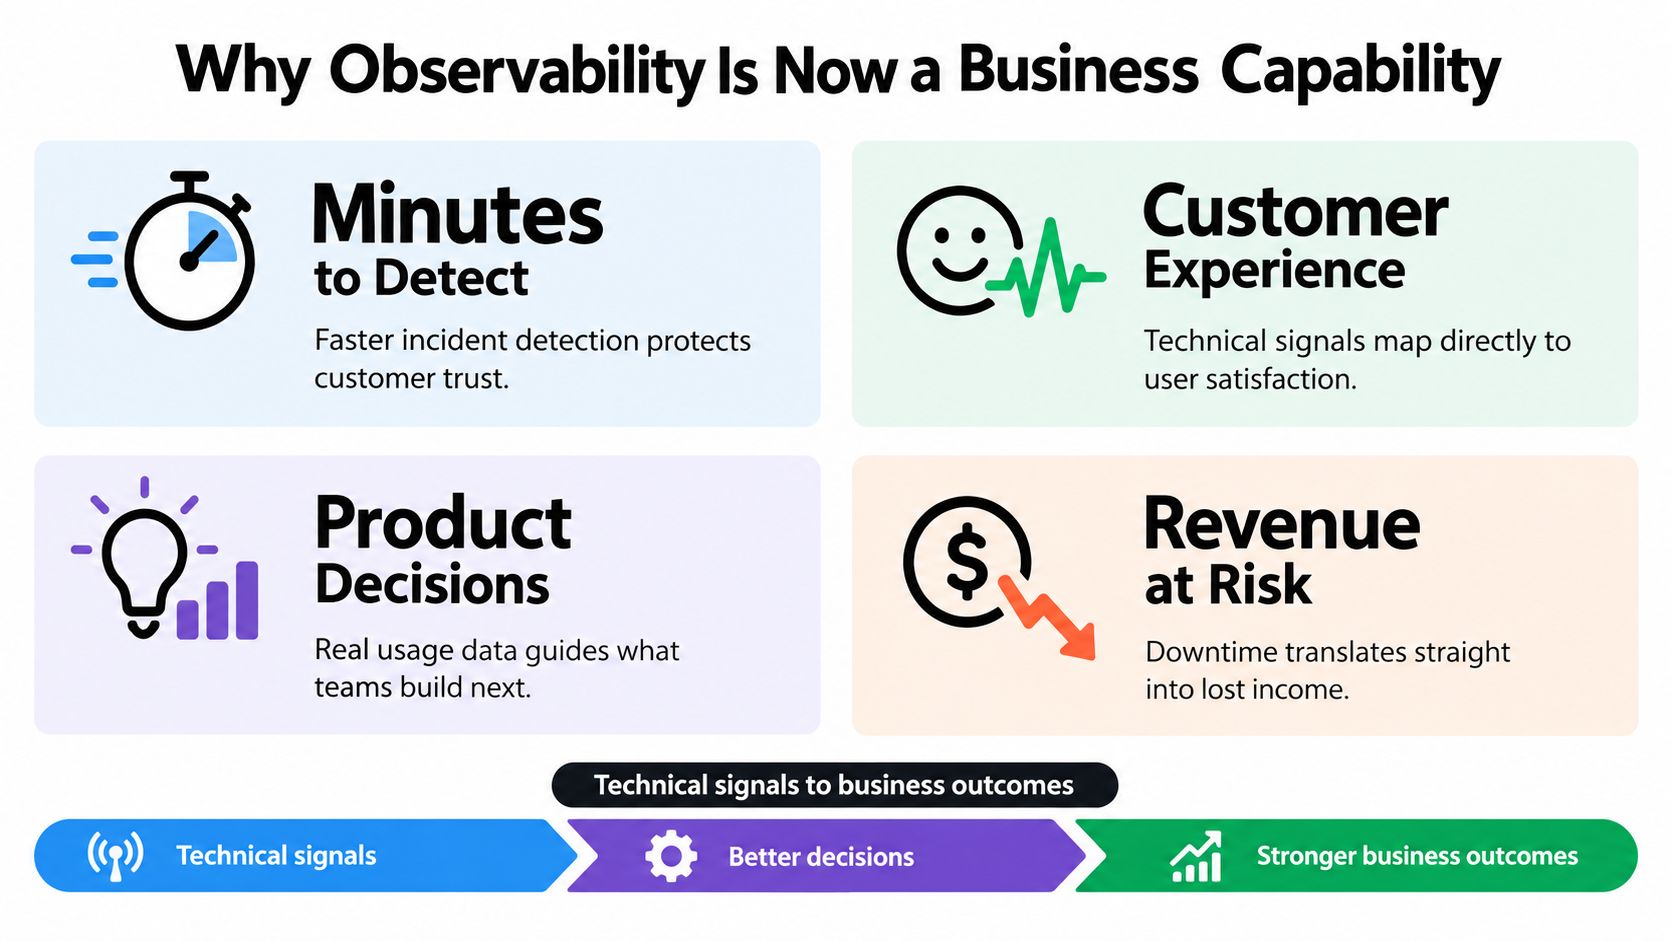
Un panel de control de ingeniería se convierte en una herramienta de negocio cuando sus señales se conectan a la experiencia del cliente y a los resultados del producto. Una tasa de errores en aumento importa porque puede impedir que un usuario complete una compra, inicie sesión, envíe un mensaje o utilice una función recién lanzada.
Que conexión requiere un diseño deliberado. Los equipos deben asociar eventos técnicos con contexto empresarial significativo, respetando la privacidad y evitando datos personales innecesarios. Una vista de salud de liberación podría combinar el estado de adopción, solicitudes fallidas, completación de la jornada del usuario y informes de soporte. Los gerentes de producto pueden ver entonces si una función funciona para el público objetivo, no solo si el servicio responde.
Pruebas más allá de la respuesta a incidentes
Splunk informó en 2025 que 74% de los encuestados calificaron la observabilidad como importante para el monitoreo de procesos comerciales críticos y 65% dijeron que era clave para comprender las jornadas del usuario, como se describe en su Estado de Observabilidad 2025 reporteObservabilidad ayuda a los equipos a conectar el comportamiento del sistema con los procesos en los que los clientes y los empleados confían.
New Relic informó que 68% de las organizaciones medido mejor tiempo de detección después de adoptar la observabilidad en ella 2025 informe, disponible en este anuncio de New RelicFaster detection es útil operacionalmente, pero el valor comercial aparece cuando los equipos pueden mostrar qué el problema detectado afectó y si la respuesta cambió ese resultado.
Grupos diferentes utilizan la misma evidencia de manera diferente:
- Los equipos de soporte pueden identificar si una queja está aislada a un dispositivo, versión o canal de lanzamiento.
- Los equipos de producto Puede comparar el comportamiento de características entre cohortes de lanzamiento y priorizar el trabajo utilizando señales de uso real.
- Los equipos de ingeniería Puede conectar un síntoma de cara al cliente a un servicio, solicitud o evento de cliente específico.
- Los equipos de liderazgo puede evaluar el riesgo operativo en términos de viajes críticos en lugar de un estado de infraestructura abstracto.
Un lanzamiento de actualización en vivo ilustra la cadena. Si el crecimiento de la adopción pero un subconjunto de usuarios falla la activación, la pregunta comercial relevante no es si el punto de actualización está disponible. Es si los usuarios afectados pueden completar la tarea para la que se liberó la actualización. La observabilidad proporciona la evidencia necesaria para responder a esa pregunta y decidir si continuar, pausar o retroceder el lanzamiento.
Patrones de implementación, mejores prácticas y compensaciones
Una buena observabilidad comienza con preguntas, no con tableros. Antes de agregar instrumentación, escribe las decisiones que el dato debe apoyar. Para una liberación móvil, esas preguntas podrían incluir: ¿se descargó el dispositivo el paquete, ¿pasó la verificación, ¿se completó la activación y ¿funcionó correctamente la aplicación actualizada después de eso?
Instrumente el camino que los usuarios toman en realidad
Comienza con límites y resultados:
- Ciclo de vida del cliente: Registro de lanzamiento, verificación de actualizaciones, descarga, verificación, activación y eventos de deshacer.
- Límites de servicio: Propaga un ID de seguimiento a través de la aplicación, la puerta de enlace, el backend y los servicios dependientes.
- Contexto de falla: Incluye la versión de la aplicación, la versión del paquete, el canal, la versión del sistema operativo, la clase de dispositivo y la categoría de error donde corresponda.
- Acciones comerciales: Conecta solicitudes técnicas a eventos seguros y significativos como la finalización de inicio de sesión o el fracaso en el pago.
Usa registros estructurados en lugar de párrafos destinados solo a la lectura humana. Los campos consistentes hacen posible la filtración. Mantén la información sensible fuera de la telemetría y define reglas de retención antes de que la recolección se expanda.
La completitud de las trazas es un buen indicador. Significa la fracción de solicitudes totales que se pueden reconstruir de principio a fin a partir de datos de trazas distribuidas. La investigación sobre la evaluación de la observabilidad también identifica la latencia de detección de errores, el sobrecoste de recursos, las tasas de falsos positivos y falsos negativos, y el costo como medidas importantes, como se discute en este encuesta de evaluación de la observabilidad.
Equilibra la profundidad diagnóstica con el sobrecoste
La telemetría adicional no es automáticamente mejor. La recolección puede consumir CPU, memoria, ancho de banda y almacenamiento, especialmente en dispositivos móviles o servicios de alta volumen. La muestra ayuda a controlar el volumen, pero muestra con intención. Mantén trazas detalladas para errores, latencia anormal, cohortes de lanzamiento y flujos de trabajo importantes, mientras retienes métricas más amplias y de bajo costo para la visibilidad de tendencias.
El señal útil es el conjunto más pequeño de evidencia que permite a un respondiente tomar la decisión correcta siguiente.
Revisa los datos después de un incidente. Si nadie consultó un campo, elimínalo o cambia su propósito. Si los ingenieros todavía necesitaban reproducir el problema manualmente, agrega el contexto faltante en lugar de aumentar cada nivel de registro.
Para equipos Capacitor, un enfoque Guía de configuración de monitoreo de rendimiento puede ayudar a traducir estos principios a instrumentación del lado del cliente. Comience con una jornada crítica del usuario, establezca su comportamiento normal y amplíe la cobertura a medida que el equipo aprenda cuáles son las preguntas recurrentes.
Observabilidad en Acción para Capacitor Electron y Capgo Actualizaciones en Vivo
Un equipo de Capacitor o Electron puede necesitar corregir JavaScript, CSS, copia, configuración o activos web mientras los usuarios continúen ejecutando aplicaciones instaladas. Un ciclo de actualización en vivo crea su propio camino observable: un dispositivo verifica una actualización, recibe un paquete de un canal, lo verifica, lo activa y informa el resultado.
Consideren un equipo que prepara una corrección de JavaScript. Publica el paquete en un canal de pruebas o beta, luego asigna un público controlado. Los métricas de adopción muestran si los dispositivos están recibiendo la versión. Las métricas de falla revelan si los descargas, la verificación o la activación están fallando. La historia de versiones identifica qué paquete cada dispositivo debe ejecutar.
El equipo encuentra entonces un problema específico de dispositivo. Los registros por dispositivo muestran que la instalación afectada descargó el paquete pero falló la verificación. Los ingenieros pueden comparar la versión actual del dispositivo, el canal y la historia de actualizaciones con las instalaciones exitosas en lugar de tratar el problema como una interrupción general.
Los despliegues necesitan barreras de seguridad
Un despliegue seguro utiliza el mismo patrón de decir, ubicar, explicar:
- Los métricas dicen si el comportamiento de adopción y falla cambió.
- Los registros por dispositivo ubican la cohorte o instalación afectada.
- Los registros explican el evento de descarga fallida, checksum, activación o evento de ejecución en tiempo real.
- los controles del canal limitan el radio de explosión mientras el equipo investiga.
- La protección de rollback restaura el paquete de trabajo anterior cuando la nueva versión es insegura.
Ese flujo es importante tanto para Electron como para aplicaciones móviles. Los usuarios de escritorio pueden tener diferentes entornos de sistema operativo, permisos, condiciones de red y versiones instaladas. Una vista de la versión que identifica el paquete activo exacto da a los soportes y a los ingenieros una respuesta compartida a “¿qué versión está ejecutando este usuario?”
Los equipos también pueden instrumentar eventos de producto junto con eventos de actualización. Capgo’s plugin de seguimiento de eventos personalizado apoya el principio más amplio de que la telemetría de la versión se vuelve más valiosa cuando conecta el estado de la implementación con el comportamiento de la aplicación. La plataforma puede proporcionar registros por dispositivo, métricas de adopción y fracaso, historia de versiones, canales dirigidos y protección automática de rollback para actualizaciones de JavaScript.
Inicie con un canal de producción y un viaje crítico. Defina los señales de lanzamiento, adjunte una versión y contexto de dispositivo consistentes, pruebe el rollback antes de un incidente y haga que alguien responsable revise la evidencia después de cada lanzamiento.
Capgo proporciona actualizaciones en vivo para aplicaciones de CapacitorJS y Electron, con canales dirigidos, visibilidad de lanzamiento por dispositivo, métricas de adopción y fracaso, historia de versiones y protección de rollback. Utilice esa observabilidad de lanzamiento para conectar lo que cambió con lo que los usuarios experimentan, luego visite Capgo para evaluarlo para tu próximo flujo de actualización.



