
L'osservabilità è la capacità di inferire lo stato interno di un sistema dai suoi output esterni, correlando log, metriche e trace. Risponde a perché qualcosa è fallito, non solo che è fallito.
Il tuo rilascio mobile è appena arrivato in produzione. Un alert dice che il servizio di update è sano, la dashboard API è verde e il tasso di errore sembra normale. Poi l'assistenza segnala che gli utenti di un modello di dispositivo sono bloccati su un bundle vecchio, mentre un altro gruppo vede una schermata bianca all'avvio. Vedi i sintomi, ma non il percorso che li ha generati.
Questa è la differenza tra sapere che qualcosa si è rotto e poterlo spiegare. Una metrica può mostrare che i download sono rallentati. Una trace può rivelare se il ritardo è derivato dal client, dal servizio di update o da API. Un log può esporre il mismatch del checksum, il bundle rifiutato o l'eccezione JavaScript che ha causato il fallimento.
Le applicazioni moderne rendono difficile preservare questo contesto. Un'app Capacitor può includere code native, uno strato web, API remote, autenticazione, analytics, un servizio di live-update e una specifica versione del dispositivo o del sistema operativo. Un'applicazione Electron aggiunge il proprio runtime desktop e differenze di ambiente. Quando un rilascio cambia rapidamente, gli alert predefiniti raramente anticipano ogni possibile modalità di errore.
L'osservabilità offre agli ingegneri un modo per investigare situazioni sconosciute senza tirare a indovinare. Aiuta i team a diagnosticare gli incidenti più velocemente, rilasciare modifiche con prove più chiare e collegare il comportamento tecnico all'esperienza dell'utente. Gli esempi seguenti partono dalla definizione e dai tre pilastri classici per arrivare all'implementazione pratica, al valore di business e alle live updates per applicazioni Capacitor ed Electron.
Indice dei contenuti
- Cosa significa davvero l'osservabilità nei sistemi software
- I tre pilastri che rendono i sistemi osservabili
- Osservabilità vs Monitoring: come lavorano insieme
- Perché l'osservabilità è oggi una capacità di business
- Pattern di implementazione: best practice e compromessi
- Osservabilità in azione per Capacitor Electron e Capgo Live Updates
Cosa significa davvero l'osservabilità nei sistemi software
Il termine osservabilità nasce fuori dal software. Negli anni '60, Rudolf Kálmán lo usava nella teoria del controllo per descrivere quanto bene un ingegnere riuscisse a dedurre lo stato interno di un sistema dai suoi output, come documentato in questa storia dell'osservabilità. L'idea è poi arrivata nella pratica del software grazie ai lavori sui sistemi distribuiti, tra cui un celebre Blog di ingegneria di Twitter, 2013 descrivendo uno “stack di osservabilità”. Il modello a tre pilastri di log, metriche e tracce è diventato standard in 2018, secondo la stessa fonte.
Il cruscotto di un'auto è un ottimo paragone. Il tachimetro indica la velocità, l'indicatore del carburante mostra quanto ne resta e una spia segnala una condizione nota. Questo è monitoring utile. Un sistema di diagnostica del motore va oltre: combina letture dei sensori e record di errore per aiutare a spiegare perché il motore perde colpi.
L'osservabilità del software funziona allo stesso modo. Non significa raccogliere ogni singolo record senza uno scopo, ma produrre prove sufficientemente correlate affinché un ingegnere possa dedurre cosa stia facendo l'applicazione internamente, anche quando è distribuita tra servizi, dispositivi e runtime.
Perché gli output sono fondamentali nelle applicazioni distribuite
Spesso non puoi mettere in pausa un sistema in produzione per analizzare ogni riga di code. Le richieste si muovono tra i componenti, i container cambiano, gli utenti usano versioni diverse e i bug potrebbero sparire prima che tu riesca a riprodurli localmente. Gli output esterni diventano le tue prove.
Un'applicazione cloud-native di solito ha diverse parti interdipendenti, quindi capirne l'architettura fornisce un contesto essenziale. Una guida pratica all'architettura cloud-native per SaaS può aiutare i team ad analizzare queste dipendenze prima di decidere cosa strumentare.
Per un'applicazione Capacitor, gli output utili potrebbero includere:
- Eventi client, come avvio dell'app, download del bundle, verifica, attivazione e rollback.
- Metriche di performance, come latenza di startup, latenza delle richieste, update falliti e crash.
- Tracce distribuite, che collegano l'azione dell'utente all'app, al gateway API, al backend e al database.
- Log strutturati, contenenti dispositivo, versione app, channel, ID transazione e contesto dell'errore.
La chiave è la correlazione. Un ID dispositivo o una trace ID possono collegare un tentativo di update, il relativo download e l'errore di runtime successivo. Senza questa relazione, ogni dashboard mostra solo un frammento.
Per una prospettiva specifica per il mobile, quella di Capgo guida all'osservabilità delle app esplora come la telemetria applicativa possa supportare la diagnosi dei rilasci. Il principio di base è semplice: i sistemi osservabili permettono di porre nuove domande sul comportamento usando le evidenze già raccolte.
I tre pilastri dell'osservabilità dei sistemi
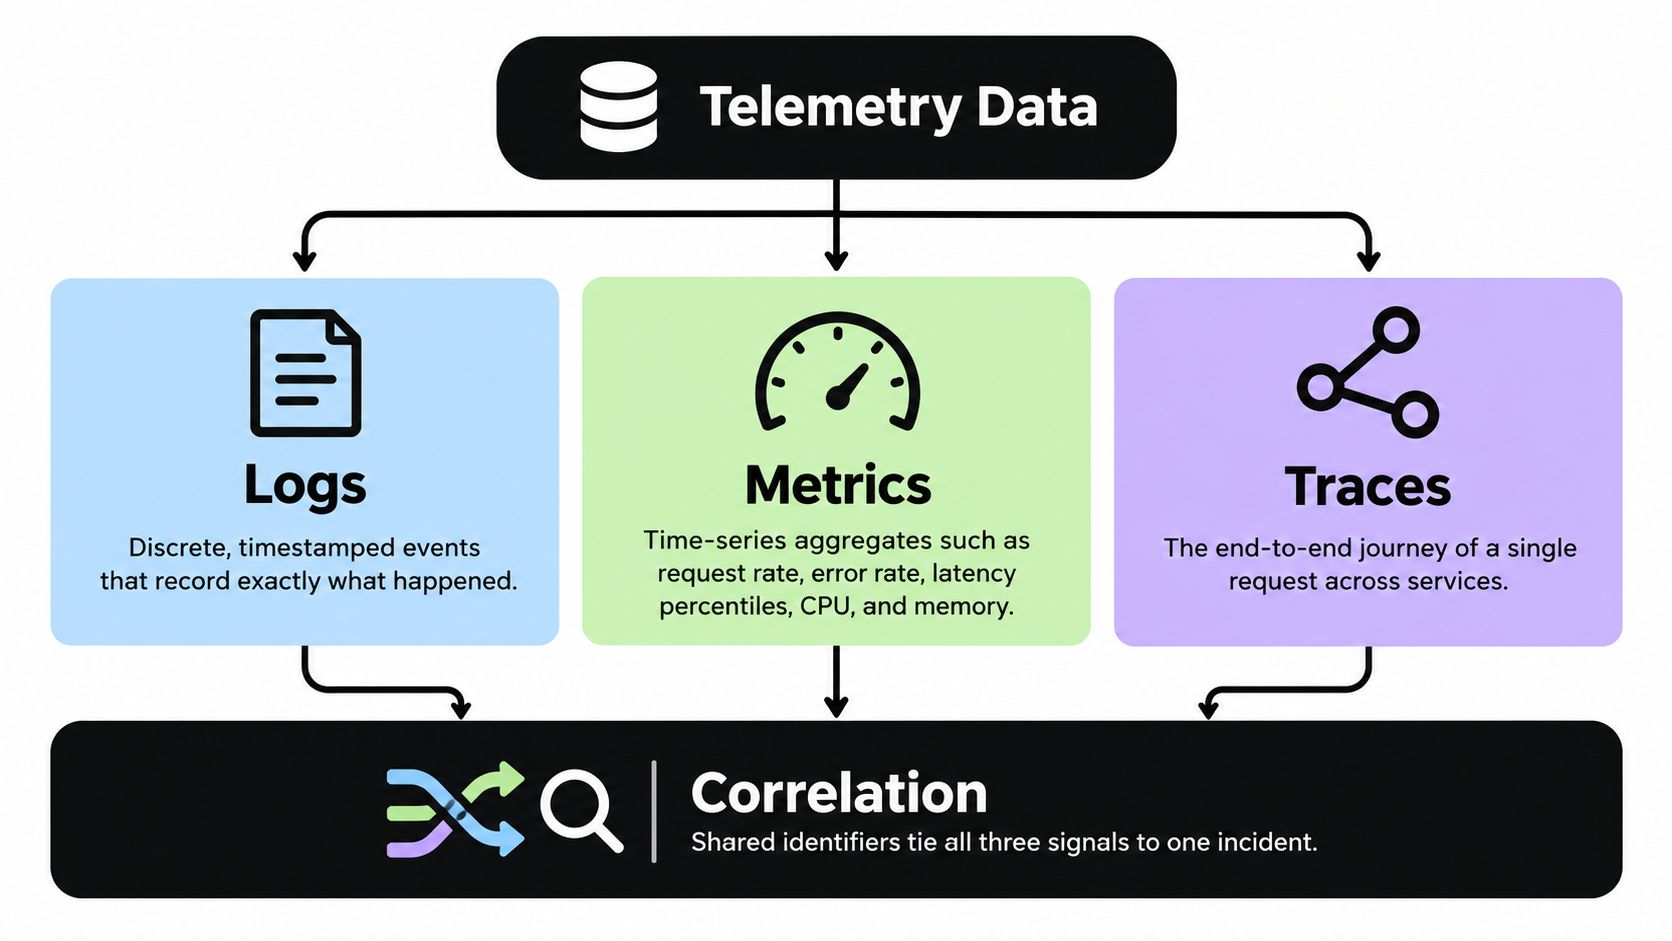
Log, metriche e tracce hanno forme diverse e rispondono a domande differenti. L'osservabilità diventa utile quando gli ingegneri le correlano alla stessa richiesta, release, user journey o dispositivo.
Metriche sono aggregati di serie temporali. Esempi includono il tasso di richieste, il tasso di errore, i percentili di latenza, CPU e memoria. Comprimono molti eventi in un valore facile da monitorare con grafici e alert. Una metrica può indicare che i fallimenti di attivazione del bundle sono aumentati dopo un deployment, ma non identificherà il dispositivo o l'eccezione esatta.
Tracce ricostruiscono il percorso end-to-end di una richiesta tra i vari servizi. Ogni parte del percorso è rappresentata da uno span. Se una richiesta di update passa attraverso un'app, un servizio edge, il layer di autenticazione, un servizio di storage e API, la traccia mostra dove si è accumulato il tempo o dove la richiesta è fallita.
Log forniscono dettagli a livello di evento. Possono contenere uno stack trace, un ID transazione, la risposta code, la versione del bundle o il risultato della validazione. I log spiegano le circostanze locali che le metriche riassumono e le tracce localizzano.
Regola pratica: Le metriche ti dicono che esiste un problema, i trace mostrano dove si verifica e i log spiegano perché è accaduto.
Considera un fallimento di un Live Update. Una metrica segnala un aumento degli errori di verifica. Un trace segue una richiesta fallita e mostra che il bundle è arrivato al dispositivo, ma lo span di verifica è fallito. Il log corrispondente registra il risultato del checksum e identifica la versione del bundle. Insieme, questi segnali ripristinano il contesto di esecuzione che il monitoraggio isolato non può fornire.
La correlazione è il meccanismo operativo
La correlazione richiede identificatori condivisi e attributi coerenti. Un trace ID dovrebbe attraversare i confini dei servizi. I log dovrebbero includere quell'ID dove possibile. Le metriche dovrebbero supportare dimensioni che aiutino gli ingegneri a restringere il campo su release, channel, famiglia di dispositivi o versione dell'app interessati, senza generare un numero ingestibile di serie temporali uniche.
Lo stesso approccio funziona sul lato client. Supponiamo che un utente clicchi su una feature e veda un timeout. Il client può registrare l'azione e la versione dell'app, il trace può seguire la richiesta di rete e il log del backend può mostrare se la richiesta è fallita durante l'autenticazione o il recupero dati. Gli ingegneri non devono dedurre l'intera storia da un singolo messaggio di errore.
I team che gestiscono grandi volumi di log possono utilizzare campi strutturati e strumenti di query invece di affidarsi solo alla ricerca testuale libera. Di Capgo l'analisi dei log guidano forniscono il contesto rilevante per rendere i log più utili durante un'investigazione.
I tre pilastri non sono prodotti in competizione, ma formano una catena di causa-effetto. Le metriche forniscono il segnale generale, i trace riducono l'area di ricerca e i log forniscono le prove dettagliate necessarie per il fix.
Observability vs Monitoring: come lavorano insieme
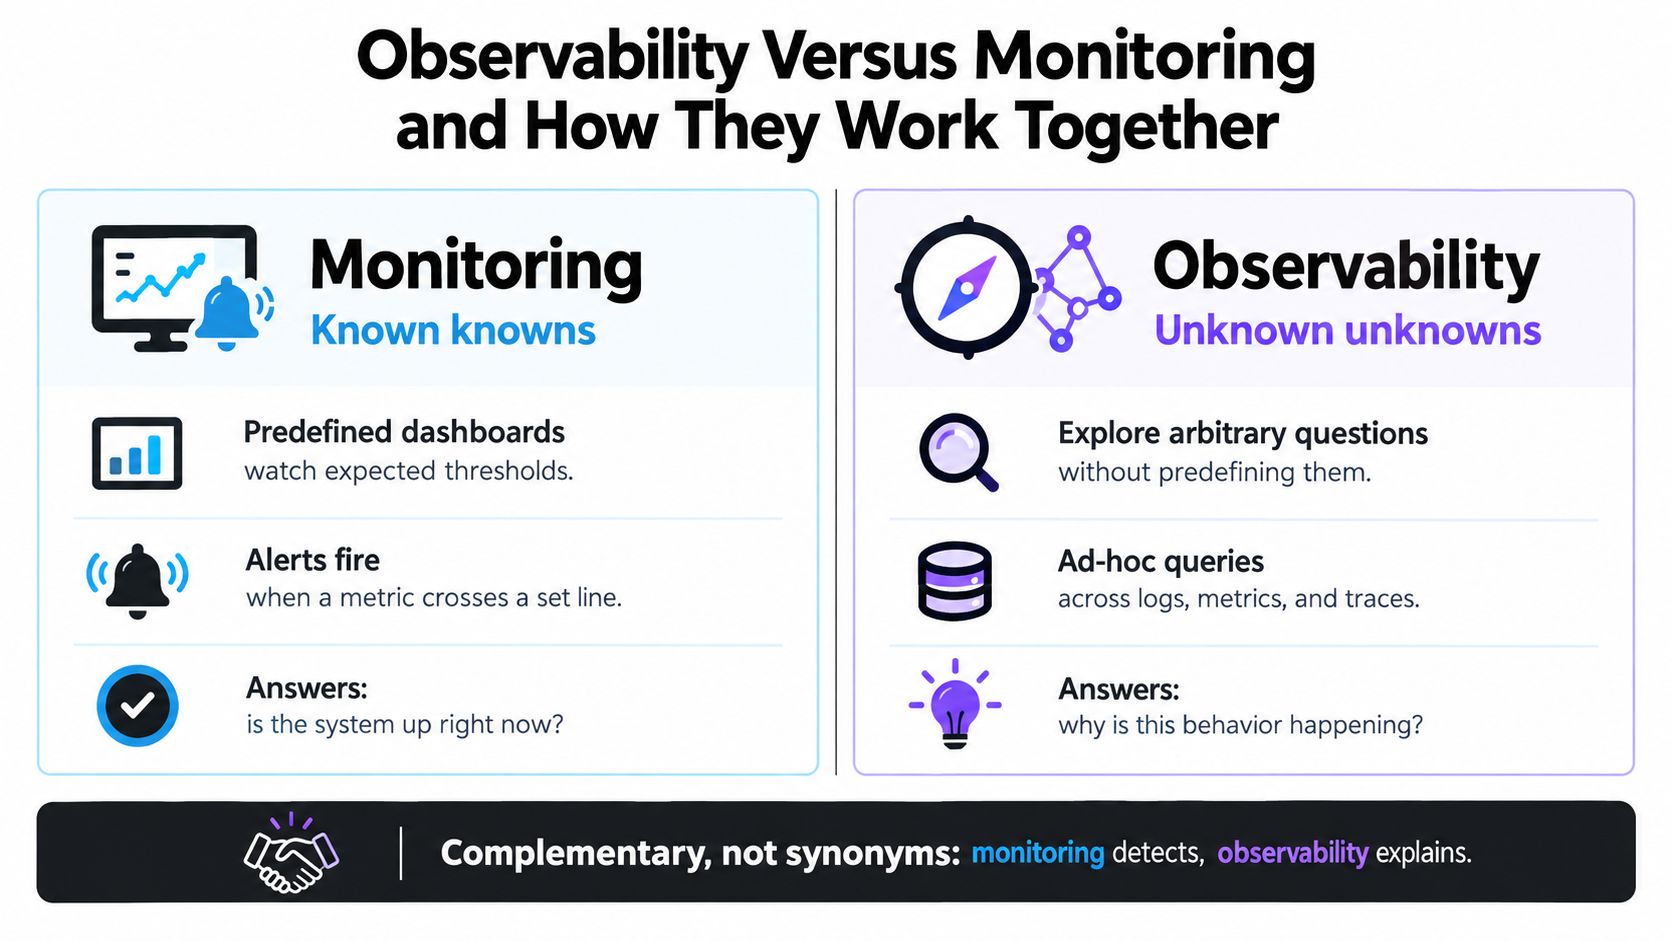
Monitoring e observability si supportano a vicenda, ma non sono sinonimi. Il monitoring monitora condizioni che hai già stabilito siano importanti. L'observability ti fornisce dati connessi per esplorare comportamenti imprevisti.
Una regola di monitoring potrebbe inviare un alert quando la latenza di API supera una soglia o quando i fallimenti degli update superano un livello atteso. L'alert è prezioso perché avvia la risposta, ma non ti dice necessariamente se la causa è una regressione del backend, un bundle errato, un problema di distribuzione regionale o un errore di runtime specifico di un dispositivo.
| Capacità | Monitoraggio | Observability |
|---|---|---|
| Scopo | Monitorare indicatori di salute noti | Indagare il comportamento del sistema e guasti sconosciuti |
| Tipo di domanda | “Questa soglia è stata superata?” | “Perché sta succedendo questo?” |
| Approccio basato sui dati | Dashboard e alert predefiniti | Log, metriche, trace e contesto correlati |
| Modalità di errore | Non rileva condizioni non configurate | Diventa costoso o rumoroso senza strumentazione utile |
Usali entrambi nel ciclo di incident management
Un pattern operativo sano è semplice:
- Il monitoring rileva il segnale. Un alert identifica latenza insolita, error rate, crash o fallimento dell'update.
- L'osservabilità contestualizza l'incidente. Gli ingegneri filtrano per release, channel, dispositivo, piattaforma, regione o user journey.
- Le tracce localizzano il guasto. Il percorso della richiesta rivela il componente o lo span in cui il comportamento è cambiato.
- I log spiegano la condizione. I log dettagliati mostrano l'eccezione, il risultato della validazione, la risposta della dipendenza o la configurazione coinvolta.
- Il team verifica l'esito. Le metriche confermano se il fix ha ripristinato il comportamento normale.
Il solo monitoring può funzionare bene in condizioni stabili e prevedibili. L'osservabilità diventa più importante quando i sistemi cambiano spesso, quando i guasti attraversano i confini dei servizi o quando gli utenti usano molte combinazioni di versioni e dispositivi.
Un team mobile potrebbe monitorare le sessioni crash-free e l'adozione degli update. Quando scatta un alert, l'osservabilità permette al team di capire se il problema riguarda un singolo channel, una specifica versione dell'app o una classe di dispositivi. Questa analisi fa la differenza tra bloccare ogni release e intervenire con un'azione correttiva mirata.
di Capgo approccio al monitoraggio della salute dell'app è rilevante per questa distinzione, poiché i segnali di health diventano più utili quando i team possono collegarli al contesto di release e del dispositivo. Lo strumento non sostituisce il monitoraggio dell'infrastruttura generale, ma aggiunge prove operative attorno al ciclo di vita dell'applicazione.
Perché l'Observability è ormai una business capability
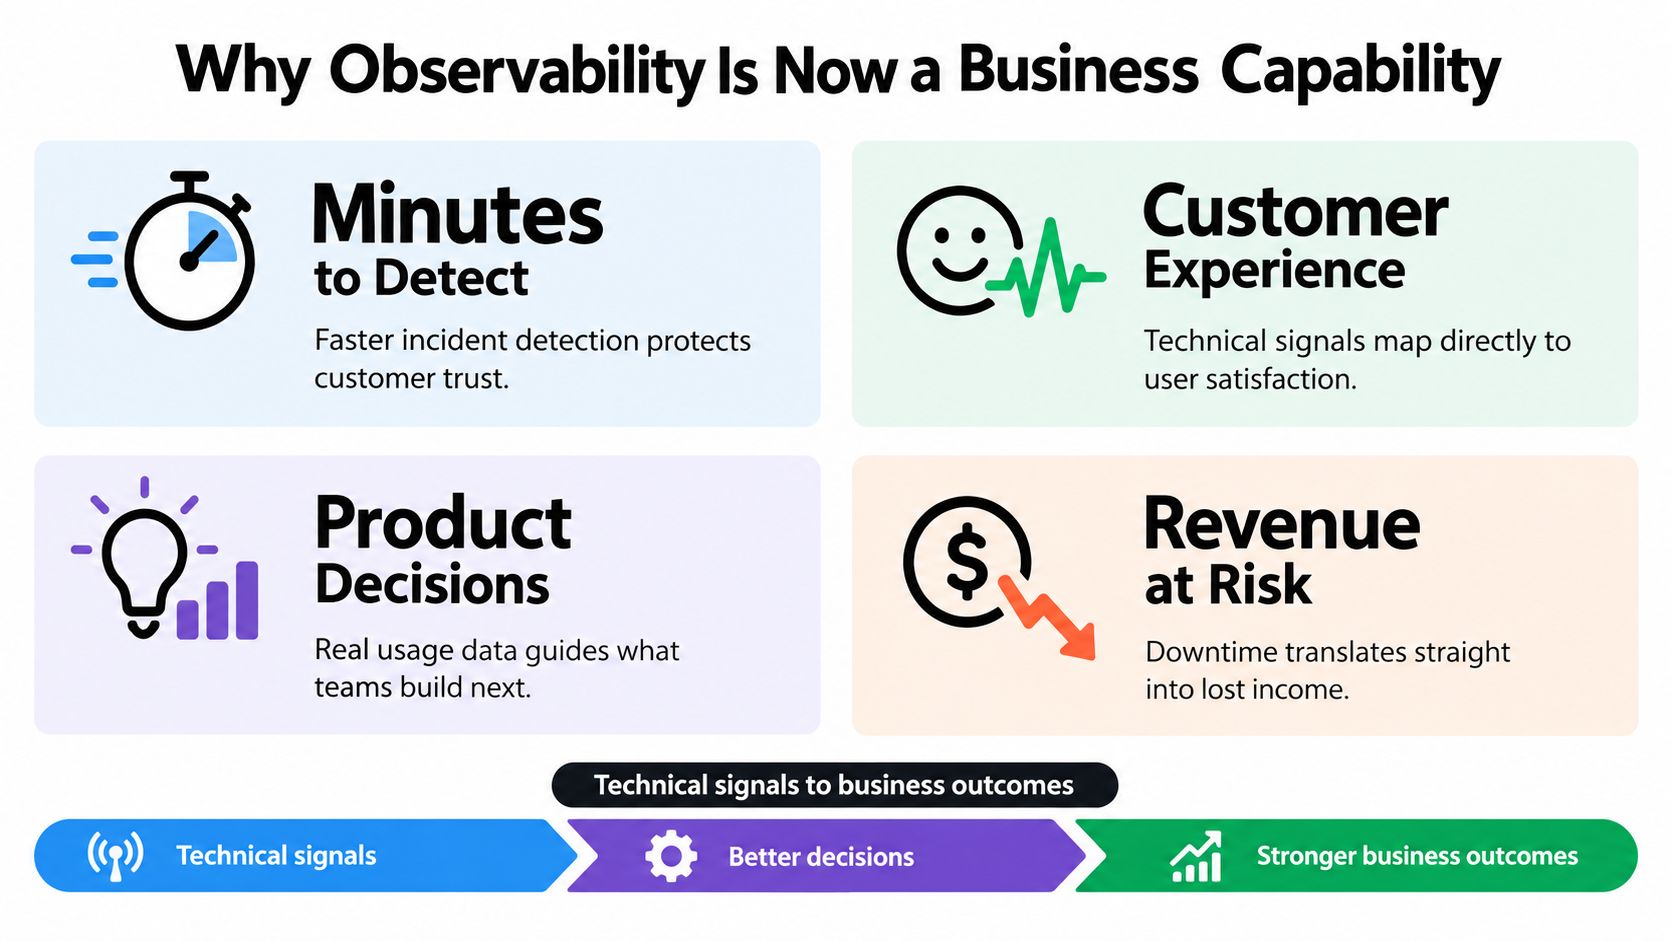
Un dashboard di engineering diventa uno strumento di business quando i suoi segnali si collegano alla customer experience e ai risultati del prodotto. Un aumento del tasso di errore è critico perché può impedire a un utente di completare un acquisto, effettuare il login, inviare un messaggio o usare una nuova feature.
Questo collegamento richiede un design deliberato. I team dovrebbero associare gli eventi tecnici a un contesto di business significativo, rispettando la privacy ed evitando dati personali non necessari. Una vista sulla health di una release potrebbe combinare lo stato di adozione, le richieste fallite, il completamento della user journey e i report del supporto. I product manager possono così capire se una feature funziona per il target previsto, non solo se il servizio risponde.
Evidenze oltre l'incident response
Splunk ha riferito in 2025 che 74% degli intervistati ha ritenuto l'osservabilità fondamentale per il monitoraggio dei processi aziendali critici e 65% ha dichiarato che è fondamentale per comprendere le user journey, come descritto nel suo report State of Observability 2025Questi risultati indicano un ruolo più ampio. L'osservabilità aiuta i team a collegare il comportamento del sistema ai processi di cui dipendono clienti e dipendenti.
New Relic ha riferito che 68% di organizzazioni ha registrato una riduzione del tempo medio di rilevamento (MTTD) dopo aver adottato l'osservabilità nei propri 2025 report, disponibile in questo annuncio di New Relic. Un rilevamento più rapido è utile a livello operativo, ma il valore per il business emerge quando i team possono mostrare cosa ha influenzato il problema rilevato e se la risposta ha cambiato l'esito.
Diversi gruppi utilizzano le stesse evidenze in modi differenti:
- I team di Support possono identificare se un reclamo è isolato a un dispositivo, una versione o un canale di rollout.
- I team di Product possono confrontare il comportamento delle feature tra i vari cohort di rilascio e dare priorità al lavoro usando segnali di utilizzo reali.
- I team di Engineering possono collegare un sintomo lato utente a un servizio, una richiesta o un evento client specifico.
- I team di Leadership permette di valutare il rischio operativo in base ai percorsi critici piuttosto che allo stato astratto dell'infrastruttura.
Il rollout di un Live Update illustra questa catena. Se l'adozione cresce ma un sottoinsieme di utenti non riesce l'attivazione, la domanda di business non è se l'endpoint dell'update sia disponibile. È se gli utenti interessati riescano a completare il task che il rilascio doveva migliorare. L'osservabilità fornisce le prove per rispondere e decidere se continuare, mettere in pausa o fare il rollback del rollout.
Pattern di implementazione: Best practice e compromessi
Una buona osservabilità parte dalle domande, non dalle dashboard. Prima di aggiungere strumentazione, scrivi quali decisioni devono supportare i dati. Per un rilascio mobile, le domande potrebbero essere: il dispositivo ha scaricato il bundle, la verifica è passata, l'attivazione è completata e l'app aggiornata si è comportata correttamente?
Strumenta il percorso che gli utenti seguono davvero
Inizia dai confini e dai risultati:
- Ciclo di vita del client: Registra eventi di lancio, controllo update, download, verifica, attivazione e rollback.
- Confini del servizio: Propaga un trace ID attraverso l'app, il gateway, il backend e i servizi dipendenti.
- Contesto del fallimento: Includi versione app, versione bundle, channel, versione OS, classe del dispositivo e categoria dell'errore dove opportuno.
- Azioni di business: Collega le richieste tecniche a eventi sicuri e significativi, come il completamento del login o un errore nel checkout.
Usa log strutturati invece di paragrafi pensati solo per la lettura umana. Campi coerenti permettono il filtraggio. Escludi informazioni sensibili dalla telemetria e definisci le regole di retention prima che la raccolta si espanda.
La completezza del trace è un benchmark utile. Indica la frazione di richieste totali che possono essere ricostruite end-to-end dai dati di distributed tracing. La ricerca sull'osservabilità identifica anche la latenza di fault-detection, l'overhead delle risorse, i tassi di falsi positivi e negativi e i costi come metriche chiave, come discusso in questo survey sull'osservabilità.
Bilancia la profondità diagnostica con l'overhead
Più telemetria non significa automaticamente migliore. La raccolta può consumare CPU, memoria, banda e storage, specialmente su dispositivi mobile o servizi ad alto volume. Il sampling aiuta a controllare il volume, ma campiona con criterio. Mantieni trace dettagliati per errori, latenze insolite, cohort di rollout e workflow critici, conservando metriche più ampie e low-cost per la visibilità dei trend.
Il segnale utile è il set minimo di evidenze che permette a chi interviene di prendere la decisione corretta successiva.
Analizza i dati dopo un incidente. Se nessuno ha interrogato un campo, rimuovilo o cambiane lo scopo. Se gli engineer hanno dovuto ancora riprodurre il problema manualmente, aggiungi il contesto mancante invece di aumentare ogni log level.
Per i team Capacitor, una guida focalizzata sul monitoraggio delle performance può aiutare a tradurre questi principi in strumentazione client-side. Inizia con un percorso utente critico, stabilisci il suo comportamento normale ed espandi la copertura man mano che il team capisce quali domande ricorrono più spesso.
Osservabilità in azione per Capacitor Electron e Capgo Live Updates
Un team Capacitor o Electron potrebbe dover correggere JavaScript, CSS, testi, configurazioni o asset web mentre gli utenti continuano a usare le app installate. Il ciclo di vita di un live-update crea un proprio percorso osservabile: un dispositivo cerca un aggiornamento, riceve un bundle da un channel, lo verifica, lo attiva e ne riporta il risultato.
Immagina un team che prepara una fix in JavaScript. Pubblica il bundle su un channel di staging o beta, assegnandolo poi a un pubblico controllato. Le metriche di adoption mostrano se i dispositivi stanno ricevendo il rilascio. Le metriche di failure rivelano se i download, la verifica o l'attivazione stanno fallendo. La cronologia delle versioni identifica quale bundle deve eseguire ogni dispositivo.
Il team individua quindi un problema specifico di un dispositivo. I log per singolo dispositivo mostrano che l'installazione interessata ha scaricato il bundle ma la verifica è fallita. Gli ingegneri possono confrontare la versione attuale, il channel e la cronologia degli update del dispositivo con le installazioni che funzionano, invece di trattare il problema come un outage generale.
I rollout richiedono guardrail
Un rollout sicuro segue lo stesso pattern tell, locate, explain:
- Le metriche dicono (tell) se il comportamento di adoption e failure è cambiato.
- I record per dispositivo individuano (locate) la cohort o l'installazione interessata.
- I log spiegano (explain) il download fallito, il checksum, l'attivazione o l'evento di runtime.
- Limite controlli del Channel il blast radius mentre il team indaga.
- La protezione del rollback ripristina il precedente bundle funzionante quando la nuova release non è sicura.
Quel workflow è fondamentale sia per Electron che per le applicazioni mobile. Gli utenti desktop possono avere diversi ambienti di sistema operativo, permessi, condizioni di rete e versioni installate. Una vista delle release che identifica l'esatto bundle attivo fornisce a supporto e engineering una risposta condivisa alla domanda: “cosa sta eseguendo questo utente?”
I team possono anche strumentare gli eventi di prodotto insieme agli eventi di aggiornamento. Capgo’s il tracciamento degli eventi personalizzati supporta il principio secondo cui la telemetria delle release diventa più preziosa quando connette lo stato del deployment con il comportamento dell'applicazione. La piattaforma può fornire log per singolo dispositivo, metriche di adozione e fallimento, cronologia delle versioni, channel mirati e protezione automatica del rollback per gli update JavaScript.
Inizia con un channel di produzione e un percorso critico. Definisci i segnali di rollout, allega un contesto coerente di versione e dispositivo, testa il rollback prima di un incidente e assegna a qualcuno la responsabilità di revisionare le evidenze dopo ogni release.
Capgo fornisce Live Update per applicazioni CapacitorJS ed Electron, con channel mirati, visibilità delle release per singolo dispositivo, metriche di adozione e fallimento, cronologia delle versioni e protezione del rollback. Usa quella release observability per connettere ciò che è cambiato con ciò che gli utenti sperimentano, poi visita Capgo per valutarlo nel tuo prossimo workflow di update.





