
Observabilitas adalah kemampuan untuk menerka keadaan internal sistem dari keluaran eksternal dengan menghubungkan log, metrik, dan jejak. Ini menjawab mengapa sesuatu gagalbukan hanya bahwa sesuatu gagal.
Rilis aplikasi mobile Anda baru saja mencapai produksi. Peringatan mengatakan bahwa layanan pembaruan sehat, dashboard API hijau, dan tingkat kesalahan terlihat normal. Lalu, dukungan melaporkan bahwa pengguna pada satu model perangkat tertentu terjebak pada bundle yang lebih tua, sementara kelompok lain melihat layar kosong setelah peluncuran. Anda dapat melihat gejala, tetapi tidak dapat melihat jalur yang menghasilkannya.
Itu perbedaan antara mengetahui sesuatu gagal dan dapat menjelaskannya. Sebuah metrik dapat menunjukkan bahwa unduhan berkurang. Sebuah jejak dapat menunjukkan apakah gangguan datang dari klien, layanan pembaruan, atau API. Sebuah log dapat mengekspos kesalahan checksum, bundle yang ditolak, atau kejadian JavaScript yang menyebabkan gagal.
Aplikasi modern membuat konteks ini lebih sulit dipertahankan. Aplikasi Capacitor mungkin melibatkan kode native code, lapisan web, API jarak jauh, autentikasi, analitik, layanan pembaruan hidup, dan versi perangkat atau sistem operasi tertentu. Aplikasi Electron menambahkan runtime desktop dan perbedaan lingkungan sendiri. Ketika rilis berubah dengan cepat, peringatan yang telah ditentukan jarang dapat menangkap setiap mode gagal.
Observabilitas memberikan para insinyur cara untuk menyelidiki situasi yang tidak dikenal tanpa menebak. Ini membantu tim untuk menemukan insiden lebih cepat, mengirimkan perubahan dengan bukti yang lebih jelas, dan menghubungkan perilaku teknis dengan apa yang dialami oleh pengguna. Contoh di bawah ini membangun dari definisi dan tiga pilar klasik ke implementasi yang lebih praktis, nilai bisnis, dan pembaruan hidup untuk Capacitor dan aplikasi Electron.
Isi Kandungan
- Apa Itu Observabilitas di Sistem Perangkat Lunak
- Tiga Pilar yang Membuat Sistem Terobservasi
- Observabilitas Versus Monitoring dan Bagaimana Mereka Berinteraksi
- Mengapa Observabilitas Sekarang adalah Kemampuan Bisnis
- Polanya Implementasi yang Baik, Praktis, dan Perbandingan
- Observabilitas dalam Aksi untuk Capacitor Electron dan Capgo Live Update
Apa Itu Observabilitas dalam Sistem Perangkat Lunak
Kata observabilitas mulai di luar perangkat lunak. Pada tahun 1960-anRudolf Kálmán menggunakan istilah ini dalam teori kendali untuk menggambarkan seberapa baik seorang insinyur dapat menebak keadaan internal sistem dari keluarannya, seperti yang terdokumentasi dalam sejarah observabilitas ini Sejarah ObservabilitasIdea ini kemudian diterapkan dalam praktek perangkat lunak melalui pekerjaan sistem terdistribusi, termasuk sebuah referensi yang luas. 2013 blog Teknik Twitter menggambarkan sebuah "stack observabilitas." Model tiga pilar log, metrik, dan jejak menjadi standar dalam 2018menurut referensi yang sama.
Sebuah dashboard mobil menawarkan perbandingan yang berguna. Indikator kecepatan memberitahu Anda berapa cepat Anda bergerak, indikator bahan bakar menunjukkan bahan bakar yang tersisa, dan lampu peringatan menandakan kondisi yang diketahui. Itu monitoring yang berguna. Sistem diagnostik mesin lebih lanjut. Ia menggabungkan bacaan sensor dan catatan kesalahan untuk membantu menjelaskan mengapa mesin mengalami kebocoran.
Pengamatan software bekerja dengan cara yang sama. Ini tidak berarti mengumpulkan setiap catatan yang mungkin tanpa tujuan. Ini berarti menghasilkan bukti yang cukup terkait sehingga seorang insinyur dapat menggambarkan apa yang dilakukan aplikasi secara internal, bahkan ketika aplikasi terdistribusi di antara layanan, perangkat, dan runtime.
Mengapa output penting dalam aplikasi terdistribusi
You often can’t pause a production system and step through every line of code. Requests move between components, containers change, users run different versions, and failures may disappear before you reproduce them locally. External outputs become your evidence.
Aplikasi native cloud biasanya memiliki beberapa bagian yang saling tergantung, jadi memahami arsitektur aplikasinya memberikan konteks yang sangat penting. Sebuah Petunjuk Arsitektur Cloud-Native untuk SaaS dapat membantu tim memahami ketergantungan tersebut sebelum memutuskan apa yang perlu diinstrument.
Untuk sebuah aplikasi Capacitor, output yang berguna mungkin termasuk:
- Event klien, seperti peluncuran aplikasi, download paket, verifikasi, aktivasi, dan rollback.
- Metrik kinerja, seperti latensi startup, latensi permintaan, update gagal, dan hitungan crash.
- Jejak distribusi, menghubungkan aksi pengguna ke aplikasi, API gateway, layanan backend, dan database.
- Log struktur, membawa perangkat, versi aplikasi, saluran, ID transaksi, dan konteks kesalahan.
Sifatnya adalah korelasi. Sebuah identifier perangkat atau ID jejak dapat menghubungkan upaya update, hasil download, dan kesalahan runtime yang mengikuti. Tanpa hubungan itu, setiap dashboard hanya menampilkan fragmen.
Untuk perspektif khusus mobile, Capgo’s petunjuk observabilitas aplikasi menggambarkan bagaimana telemetri aplikasi dapat mendukung diagnosis rilis. Prinsip yang lebih luas tetap sederhana: Sistem yang dapat dilihat memungkinkan Anda untuk bertanya pertanyaan baru tentang perilaku menggunakan bukti yang telah dikapung..
Tiga Pilar yang Membuat Sistem Dapat Diamati
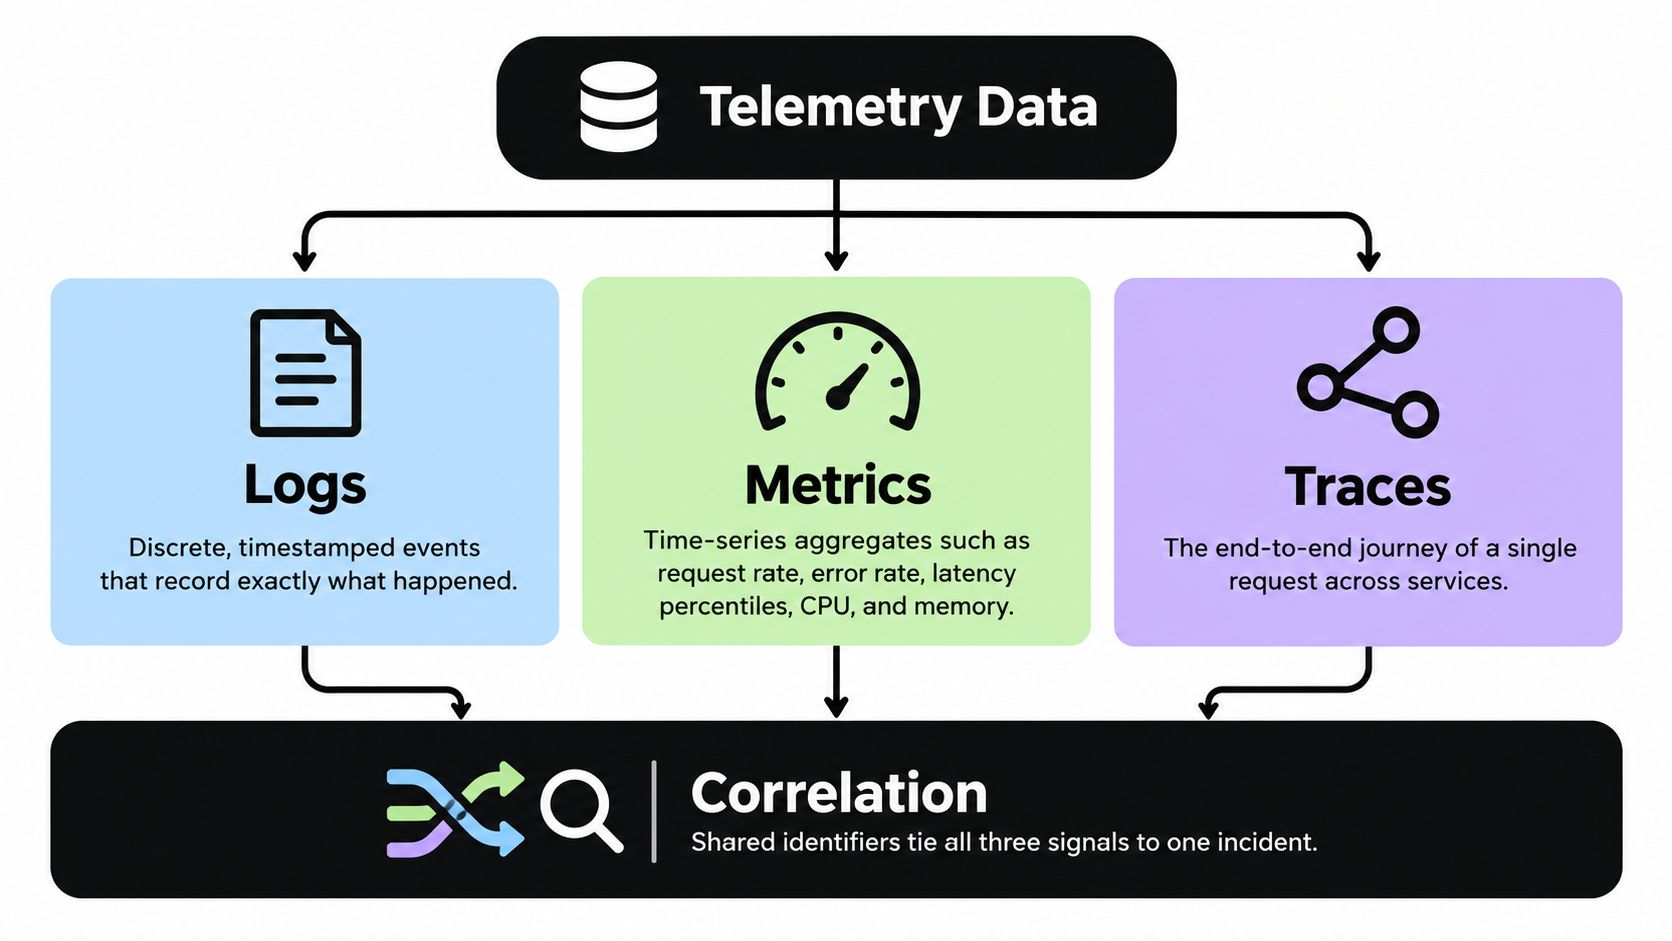
Log, metrik, dan jejak memiliki bentuk yang berbeda dan menjawab pertanyaan yang berbeda. Dapat diamati menjadi berguna ketika insinyur menghubungkannya sekitar permintaan, rilis, perjalanan pengguna, atau perangkat.
Metrik adalah agregat waktu-seri. Contoh termasuk tingkat permintaan, tingkat kesalahan, persentil waktu, CPU, dan memori. Mereka mengompresi banyak event menjadi nilai yang mudah untuk ditampilkan dan diingatkan. Sebuah metrik mungkin memberitahu Anda bahwa gagal aktivasi paket meningkat setelah pengembangan, tetapi tidak akan mengidentifikasi perangkat atau kejadian yang tepat.
Jejak mengulangi jalur akhir-ke-akhir permintaan melintasi layanan. Setiap bagian dari jalur tersebut diwakili oleh sebuah span. Jika permintaan update melewati aplikasi, layanan edge, lapisan autentikasi, layanan penyimpanan, dan API, jejak menunjukkan di mana waktu terkumpul atau di mana permintaan gagal.
Log provide event-level detail. They can contain a stack trace, transaction ID, response code, bundle version, or validation result. Logs explain the local circumstances that metrics summarize and traces locate.
Aturan nyata: Metrik menunjukkan bahwa masalah ada, jejak menunjukkan di mana terjadi, dan log menjelaskan mengapa terjadi.
Ketika update live gagal, metrik melaporkan bahwa kesalahan verifikasi update meningkat. Jejak mengikuti permintaan yang gagal dan menunjukkan bahwa paket telah mencapai perangkat, tetapi verifikasi span gagal. Log yang sesuai merekam hasil cek dan mengidentifikasi versi paket. Bersama-sama, tanda-tanda tersebut memulihkan konteks eksekusi yang tidak dapat disediakan oleh pemantauan yang terisolasi.
Korrelasi adalah mekanisme kerja
Korrelasi memerlukan identifikasi bersama dan atribut konsisten. ID jejak harus dapat berpindah di antara batasan layanan. Log harus mencakup ID tersebut di mana-mana. Metrik harus mendukung dimensi yang membantu insinyur mempersempit rilis yang terkena, saluran, keluarga perangkat, atau versi aplikasi tanpa menghasilkan jumlah seri waktu unik yang tidak dapat diatur.
Pendekatan yang sama berlaku di sisi klien. Bayangkan pengguna mengetuk fitur dan melihat timeout. Klien dapat merekam aksi dan versi aplikasi, jejak dapat mengikuti permintaan jaringan, dan log backend dapat menunjukkan apakah permintaan gagal di autentikasi atau pengambilan data. Insinyur tidak perlu menginferrasi seluruh cerita dari pesan kesalahan tunggal.
Tim yang bekerja dengan volume log besar dapat menggunakan bidang struktur dan alat pencarian daripada bergantung pada pencarian teks bebas saja. Capgo’s Alat analisis log menyediakan latar belakang yang relevan untuk membuat log lebih berguna selama penyelidikan.
Pilar-pilar tiga bukanlah produk yang bersaing. Mereka membentuk rantai sebab-akibat. Metrik menyediakan signal yang luas, jejak mengurangi area pencarian, dan log menyediakan bukti rinci yang diperlukan untuk memperbaiki masalah.
Observabilitas Versus Monitoring dan Bagaimana Mereka Berinteraksi
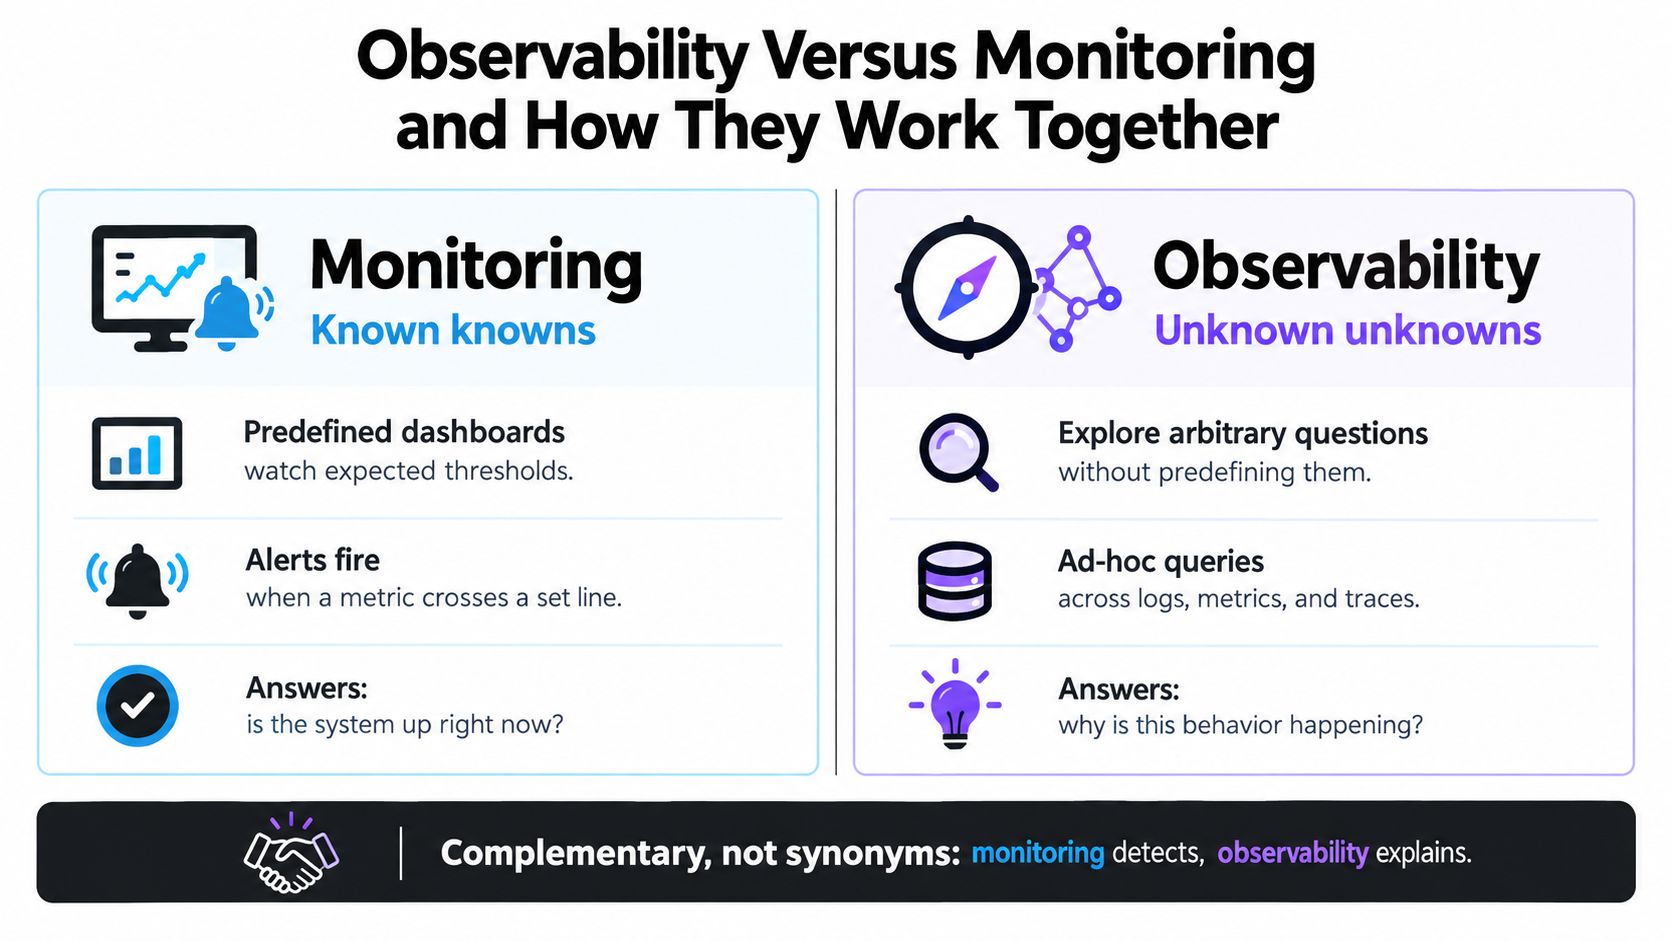
Pengawasan dan observabilitas mendukung satu sama lain, tetapi mereka bukanlah sinonim. Pengawasan memantau kondisi yang sudah Anda tentukan penting. Observabilitas memberikan Anda cukup data yang terhubung untuk menjelajahi perilaku yang tidak Andaantisipasi.
Sebuah aturan pengawasan mungkin mengirimkan peringatan ketika API latency melintasi ambang batas atau ketika gagal update melebihi tingkat yang diharapkan. Peringatan tersebut berharga karena memulai respons. Namun, peringatan tersebut tidak secara langsung memberitahu Anda apakah penyebabnya adalah regresi backend, bundle yang buruk, masalah pengiriman regional, atau masalah runtime perangkat khusus.
| Kemampuan | Pengawasan | Observabilitas |
|---|---|---|
| Tujuan | Tonton indikator kesehatan yang diketahui | Amati indikator kesehatan yang diketahui |
| Tipe Pertanyaan | Apakah batasan ini telah melebihi? | “Mengapa perilaku ini terjadi?” |
| Pendekatan data | Dashboard dan peringatan yang telah ditentukan | Log, metrik, jejak, dan konteks yang terkait |
| Modus gagal | Kondisi yang tidak dikonfigurasi oleh siapa pun | Becomes mahal atau berisik tanpa instrumen yang berguna |
Gunakan kedua-duanya dalam siklus kejadian
Polanya operasional yang sehat adalah sederhana:
- Pengawasan mendeteksi sinyal. Peringatan mengidentifikasi latensi yang tidak biasa, tingkat kesalahan, aktivitas crash, atau gagal update.
- Observabilitas membentuk kejadian. Para insinyur memfilter berdasarkan rilis, saluran, perangkat, platform, wilayah, atau perjalanan pengguna.
- Jejak acara memperjelas kegagalan. Jalan permintaan mengungkapkan komponen atau span di mana perilaku berubah.
- Log menjelaskan kondisi. Catatan rinci menampilkan kesalahan, hasil validasi, respons dependensi, atau konfigurasi yang terlibat.
- Tim memverifikasi hasilnya. Metrik memastikan apakah perbaikan telah memulihkan perilaku normal.
Pengawasan sendiri dapat berfungsi dengan baik untuk kondisi stabil dan prediktif. Observabilitas menjadi lebih penting ketika sistem berubah sering, ketika kegagalan melintasi batas layanan, atau ketika pengguna menjalankan banyak kombinasi versi dan perangkat.
Tim mobile mungkin memantau sesi tanpa crash dan adopsi pembaruan. Ketika peringatan terjadi, observabilitas memungkinkan tim bertanya apakah masalah mempengaruhi saluran tunggal, versi aplikasi tertentu, atau kelas perangkat tunggal. Investigasi tersebut adalah perbedaan antara menghentikan setiap rilis dan mengambil tindakan perbaikan yang sasaran.
Capgo’s pendekatan pengawasan kesehatan aplikasi Relevan dengan perbedaan ini karena signal kesehatan menjadi lebih berguna ketika tim dapat menghubungkannya dengan konteks rilis dan perangkat. Alat ini tidak menggantikan pemantauan infrastruktur umum. Ia menambahkan bukti operasional sepanjang siklus aplikasi.
Mengapa Observabilitas Sekarang Mampu Membangun Bisnis
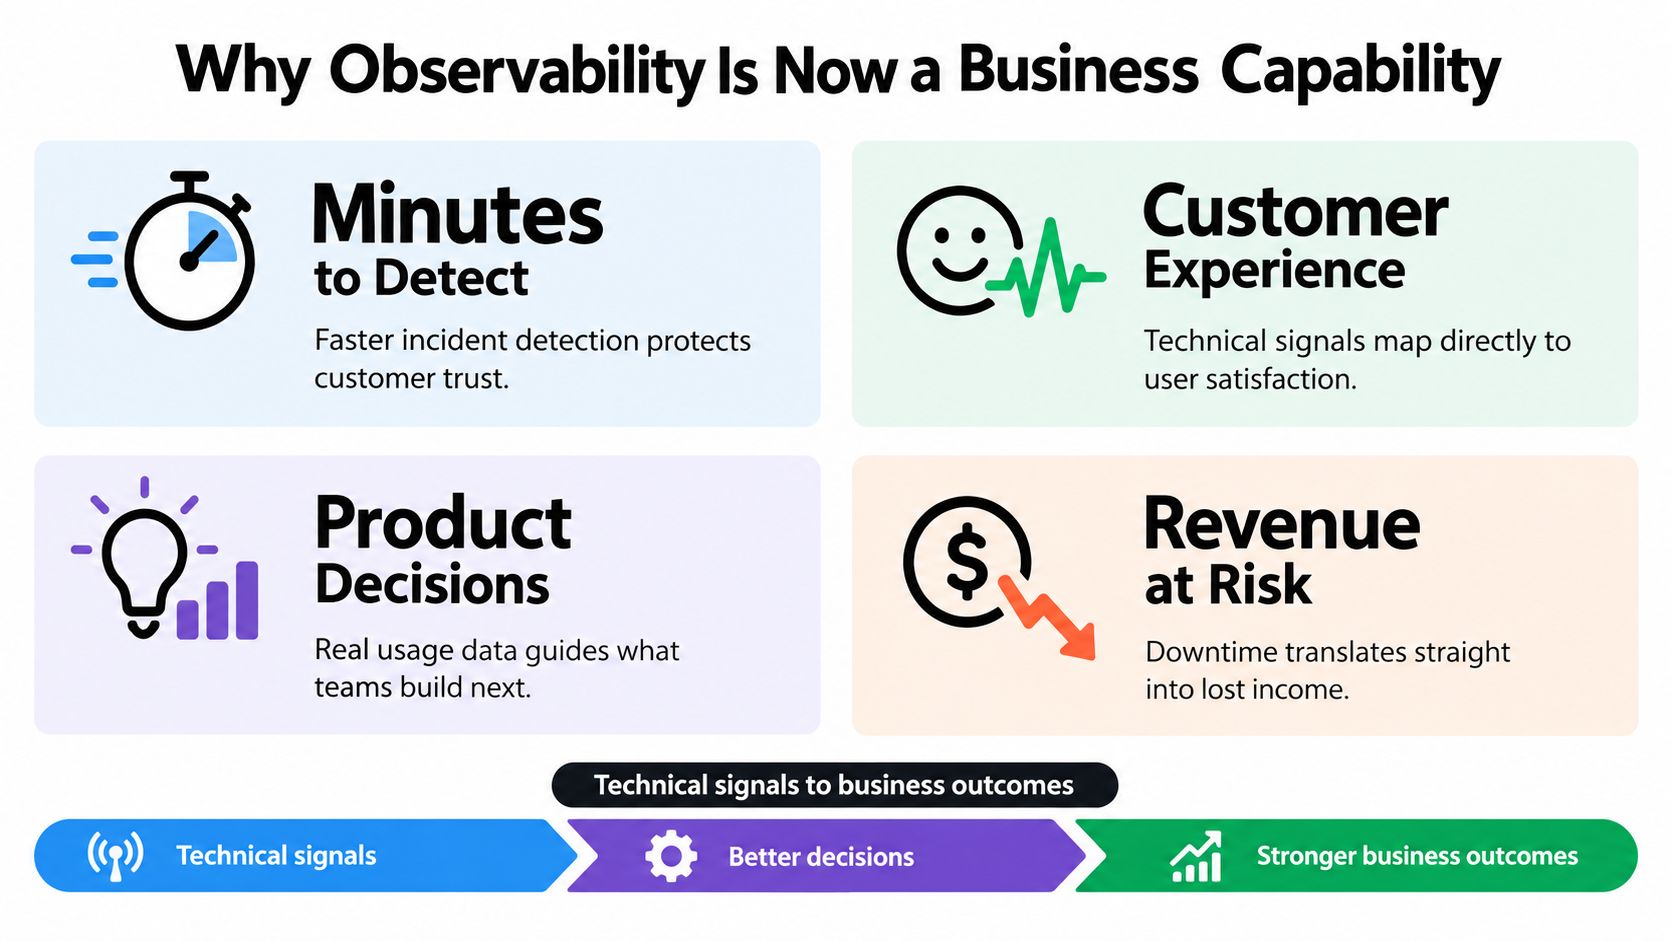
Dashboard teknik menjadi alat bisnis ketika signalnya terhubung dengan pengalaman pelanggan dan hasil produk. Tingkat kesalahan yang meningkat berarti karena dapat mencegah pengguna menyelesaikan pembelian, masuk, mengirim pesan, atau menggunakan fitur baru.
Koneksi tersebut memerlukan perancangan sengaja. Tim harus menghubungkan event teknis dengan konteks bisnis yang bermakna, sambil menghormati privasi dan menghindari data pribadi yang tidak perlu. Tampilan kesehatan rilis mungkin menggabungkan status adopsi, permintaan gagal, penyelesaian perjalanan pengguna, dan laporan dukungan. Manajer produk kemudian dapat melihat apakah fitur tersebut berfungsi untuk audiens yang dimaksud, bukan hanya apakah layanan tersebut berfungsi.
Bukti di luar tanggapan insiden
Splunk melaporkan dalam 2025 bahwa 74% responden menganggap observabilitas penting untuk memantau proses bisnis kritis dan 65% dijelaskannya penting untuk memahami perjalanan pengguna, seperti yang dijelaskan di dalamnya State of Observability 2025. Temuan tersebut menunjukkan peran yang lebih luas. Observabilitas membantu tim menghubungkan perilaku sistem dengan proses yang digunakan oleh pelanggan dan karyawan.
New Relic melaporkan bahwa 68% organisasi yang diukur telah meningkatkan waktu rata-rata untuk mendeteksi setelah menerapkan observabilitas di dalamnya 2025 laporan, tersedia di sini Pengumuman New Relic. Deteksi yang lebih cepat adalah berguna secara operasional, tetapi nilai bisnis muncul ketika tim dapat menunjukkan apa yang masalah yang terdeteksi mempengaruhi dan apakah tanggapan mengubah hasil tersebut.
Dewan pengguna menggunakan bukti yang sama secara berbeda:
- Dewan dukungan Dapat mengidentifikasi apakah keluhan tersebut hanya terjadi pada perangkat, versi, atau saluran peluncuran.
- Dewan produk menggunakan perilaku fitur di antara kelompok rilis dan memprioritaskan pekerjaan menggunakan signal penggunaan nyata.
- Dewan teknis menghubungkan gejala yang terlihat oleh pelanggan ke layanan, permintaan, atau acara klien tertentu.
- Dewan pemimpin Apakah dapat menilai risiko operasional dalam hal perjalanan kritis daripada status infrastruktur abstrak.
A rollout pembaruan live menunjukkan rantai. Jika peningkatan adopsi tetapi sebagian pengguna gagal aktivasi, pertanyaan bisnis relevan bukanlah apakah endpoint pembaruan tersedia. Apakah pengguna yang terkena dampak dapat menyelesaikan tugas yang dirilis untuk memperbaiki. Observabilitas menyediakan bukti yang diperlukan untuk menjawab pertanyaan tersebut dan memutuskan apakah harus melanjutkan, menunda, atau mengembalikan rollout.
Polanya Implementasi, Praktik Terbaik, dan Kompromi
Observabilitas yang baik dimulai dengan pertanyaan, bukan dashboard. Sebelum menambahkan instrumentasi, tuliskan keputusan yang data harus mendukung. Untuk rilis mobile, pertanyaan tersebut mungkin termasuk: apakah perangkat mengunduh bundle, apakah verifikasi berhasil, apakah aktivasi selesai, dan apakah aplikasi yang diperbarui berfungsi dengan benar setelahnya?
Alami jalur pengguna yang sebenarnya
Mulai dengan batasan dan hasil:
- Lifecycle klien: Rekam peluncuran, cek pembaruan, download, verifikasi, aktivasi, dan event rollback.
- Batasan layanan: Propagasi ID trase melalui aplikasi, gateway, backend, dan layanan terkait.
- Konteks gagal: Termasuk versi aplikasi, versi bundle, saluran, versi sistem operasi, kelas perangkat, dan kategori kesalahan di mana diperlukan.
- Aksi bisnis: Hubungkan permintaan teknis dengan kejadian aman dan bermakna seperti penyelesaian login atau gagal checkout.
Gunakan log struktur daripada paragraf yang hanya dimaksudkan untuk dibaca oleh manusia. Bidang yang konsisten memungkinkan penyaringan. Hindari informasi sensitif dari telemetri, dan tentukan aturan penyimpanan sebelum pengumpulan membesar.
Kemampuan tracing adalah benchmark yang berguna. Ini berarti bagian dari permintaan total yang dapat direkonstruksi dari awal hingga akhir dari data tracing yang terdistribusi. Penelitian evaluasi observability juga mengidentifikasi latensi deteksi kerusakan, biaya sumber daya, tingkat positif palsu dan negatif palsu, dan biaya sebagai ukuran penting, seperti yang dibahas dalam survei evaluasi observabilitas ini. evaluasi observabilitas.
Perbandingkan kedalaman diagnostik dengan biaya overhead
Telemetri yang lebih banyak tidak secara otomatis lebih baik. Pengumpulan dapat mengonsumsi CPU, memori, bandwidth, dan penyimpanan, terutama pada perangkat mobile atau layanan dengan volume tinggi. Sampling membantu mengontrol volume, tetapi sampel dengan sengaja. Simpan rincian tracing untuk kesalahan, latency yang tidak biasa, kelompok peluncuran, dan alur kerja penting, sementara mempertahankan metrik yang lebih luas dan lebih murah untuk visibilitas tren.
Signal yang berguna adalah set kecil bukti yang memungkinkan seorang responsif membuat keputusan yang benar berikutnya.
Ulas data setelah insiden. Jika tidak ada yang mengajukan lapangan, hapus atau ubah tujuan lapangan tersebut. Jika insinyur masih perlu mereproduksi masalah secara manual, tambahkan konteks yang hilang daripada meningkatkan setiap tingkat log.
Untuk tim Capacitor, sebuah fokus Panduan pengaturan pemantauan kinerja membantu menerjemahkan prinsip-prinsip ini ke dalam instrumen sisi klien. Mulai dengan satu perjalanan pengguna kritis, tentukan perilaku normalnya, dan perluas penutupan sebagai tim belajar pertanyaan yang berulang.
Observabilitas dalam Aksi untuk Capacitor Electron dan Capgo Live Update
Sebuah Capacitor atau tim Electron mungkin perlu memperbaiki JavaScript, CSS, salinan, konfigurasi, atau aset web sambil pengguna melanjutkan menjalankan aplikasi yang diinstal. Siklus live-update menciptakan jalur observabilitasnya sendiri: perangkat memeriksa pembaruan, menerima bundle dari saluran, memverifikasi, mengaktifkan, dan melaporkan hasilnya.
Pertimbangkan sebuah tim yang mempersiapkan perbaikan JavaScript. Mereka menerbitkan bundle ke saluran pengujian atau beta, kemudian menugaskan audiens yang dikendalikan. Metrik adopsi menunjukkan apakah perangkat menerima rilis. Metrik gagal menunjukkan apakah download, verifikasi, atau aktivasi gagal. Riwayat versi mengidentifikasi bundle mana yang setiap perangkat harus menjalankan.
Tim kemudian menemukan masalah yang spesifik per perangkat. Log per perangkat menunjukkan bahwa instalasi yang terkena mengunduh bundle tetapi gagal verifikasi. Para insinyur dapat membandingkan versi perangkat saat ini, saluran, dan riwayat pembaruan dengan instalasi yang sukses daripada menganggap masalah sebagai kegagalan umum.
Rollout memerlukan penghalang
Rollout yang aman menggunakan pola yang sama: tell, locate, dan explain
- Metrik mengatakan apakah perilaku adopsi dan gagal berubah.
- Catatan per perangkat menemukan kelompok atau instalasi yang terkena.
- Log menjelaskan kesalahan download, ceksum, aktivasi, atau kejadian waktu eksekusi.
- kontrol saluran membatasi radius ledakan saat tim menyelidiki.
- proteksi rollback memulihkan saluran sebelumnya yang berfungsi ketika rilis baru tidak aman.
Alur kerja itu penting untuk aplikasi Electron maupun aplikasi mobile. Pengguna desktop mungkin memiliki lingkungan sistem operasi yang berbeda, izin, kondisi jaringan, dan versi yang terpasang. Tampilan rilis yang mengidentifikasi bundle aktif yang tepat memberikan jawaban bersama kepada 'apa yang user ini jalankan?'
Tim juga dapat menginstrument acara produk di samping acara pembaruan. Capgo's plugin pengukuran acara kustom mendukung prinsip yang lebih luas bahwa pemantauan rilis menjadi lebih berharga ketika menghubungkan keadaan pengiriman dengan perilaku aplikasi. Platform dapat menyediakan log per-device, metrik adopsi dan gagal, riwayat versi, saluran yang ditargetkan, dan proteksi rollback otomatis untuk pembaruan JavaScript.
Mulai dengan satu saluran produksi dan satu perjalanan kritikal. Tentukan signal perluasan, pasang versi konsisten dan konteks perangkat, uji rollback sebelum insiden, dan buat seseorang bertanggung jawab untuk meninjau bukti setelah setiap rilis.
Capgo menyediakan pembaruan hidup untuk aplikasi CapacitorJS dan Electron, dengan saluran yang ditargetkan, visibilitas rilis per-device, metrik adopsi dan gagal, riwayat versi, dan proteksi rollback. Gunakan observabilitas rilis itu untuk menghubungkan apa yang berubah dengan apa yang pengguna alami, kemudian kunjungi Capgo untuk mengevaluasinya untuk alur kerja pembaruan berikutnya.



